


Managed Service for Apache Spark 自動調整功能可讓您最佳化週期性批次工作負載,提升效能和韌性,不需手動設定。自動調整功能會分析先前的執行作業 (稱為「同類群組」),並根據 Spark 最佳做法自動套用設定,您不必評估複雜的 Spark 參數。
本文說明如何自動調整 Managed Service for Apache Spark 批次工作負載。Spark 設定選項眾多,且難以評估這些選項對工作負載的影響,因此要最佳化 Spark 工作負載的效能和彈性,可能相當困難。Managed Service for Apache Spark 自動調整功能可根據 Spark 最佳化最佳做法和工作負載執行分析 (稱為「同類群組」),自動將 Spark 設定套用至週期性 Spark 工作負載,不必手動設定工作負載。
申請使用 Managed Service for Apache Spark 自動調整功能
如要申請使用本頁所述的 Managed Service for Apache Spark 自動調整預先發布版,請填寫並提交 Managed Service for Apache Spark 預先發布版存取權要求申請表單。表單通過核准後,表單中列出的專案就能使用預先發布版功能。
優點
Managed Service for Apache Spark 自動調整功能可提供下列優點:
- 自動最佳化:自動調整效率不彰的 Managed Service for Apache Spark 批次和 Spark 設定,加快工作執行時間。
- 歷來學習:從週期性執行作業中學習,套用專為工作負載量身打造的最佳化建議。
自動調整同類群組
自動調整功能會套用至批次工作負載的週期性執行作業 (同類群組)。
提交批次工作負載時指定的同類群組名稱,會將其識別為週期性工作負載的其中一個連續執行作業。
自動調整功能會套用至批次工作負載群組,如下所示:
系統會計算自動調整功能,並套用至工作負載的第二個及後續同類群組。自動調整功能不會套用至週期性工作負載的首次執行,因為 Managed Service for Apache Spark 自動調整功能會使用工作負載記錄進行最佳化。
自動調整功能不會追溯套用至執行中的工作負載,只會套用至新提交的工作負載。
自動調整功能會分析同類群組統計資料,隨著時間推移學習並改善。為讓系統收集足夠的資料,建議您至少執行五次自動調整功能。
同類群組名稱:建議使用有助於識別週期性工作負載類型的同類群組名稱。舉例來說,您可以將 daily_sales_aggregation 做為排定工作負載的同類群組名稱,用於執行每日銷售匯總工作。
自動調整情境
在適用情況下,自動調整功能會自動選取並執行下列 scenarios 或目標,將批次工作負載最佳化:
- 資源調度:Spark 自動調度資源設定。
- Join 最佳化:Spark 設定,可最佳化 SQL 廣播 join 效能。
- 重組分區:用於調整重組分區的 Spark 設定。
使用 Managed Service for Apache Spark 自動調整功能
您可以使用 Google Cloud 控制台、Google Cloud CLI、Dataproc API 或 Cloud 用戶端程式庫,為批次工作負載啟用 Managed Service for Apache Spark 自動調整功能。
控制台
如要在每次提交週期性批次工作負載時,啟用 Managed Service for Apache Spark 自動調整功能,請按照下列步驟操作:
在 Google Cloud 控制台中,前往 Managed Service for Apache Spark 的「Batches」(批次) 頁面。
如要建立批次工作負載,請按一下「Create」(建立)。
在「Autotuning」(自動調整) 部分:
切換「啟用」按鈕,為 Spark 工作負載啟用自動調整功能。
Cohort:填寫同類群組名稱,將批次作業識別為一系列週期性工作負載之一。自動調整功能會套用至使用這個同類群組名稱提交的第二個及後續工作負載。舉例來說,如果排定的批次工作負載會執行每日銷售匯總工作,請將同類群組名稱指定為
daily_sales_aggregation。
視需要填寫「Create batch」(建立批次) 頁面的其他部分,然後按一下「Submit」(提交)。如要進一步瞭解這些欄位,請參閱「提交批次工作負載」。
gcloud
如要在每次提交週期性批次工作負載時,啟用 Managed Service for Apache Spark 自動調整功能,請在本機終端機視窗或 Cloud Shell 執行下列 gcloud CLI gcloud dataproc batches submit 指令。
gcloud dataproc batches submit COMMAND \
    --region=REGION \
    --cohort=COHORT \
    --autotuning-scenarios=auto  \
    other arguments ...
更改下列內容:
API
如要在每次提交週期性批次工作負載時,啟用 Managed Service for Apache Spark 自動調整功能,請提交 batches.create 要求,並加入下列欄位:
RuntimeConfig.cohort:同類群組名稱,用於將批次作業識別為一系列週期性工作負載之一。自動調整功能會套用至使用這個同類群組名稱提交的第二個及後續工作負載。舉例來說,如果排定的批次工作負載會執行每日銷售匯總工作,請將同類群組名稱指定為daily_sales_aggregation。AutotuningConfig.scenarios:指定AUTO,在 Spark 批次工作負載上啟用自動調整功能。
範例:
...
runtimeConfig:
  cohort: COHORT_NAME
  autotuningConfig:
    scenarios:
    - AUTO
...
Java
在試用這個範例之前,請先按照「使用用戶端程式庫的 Managed Service for Apache Spark 快速入門導覽課程」中的 Java 設定說明操作。詳情請參閱 Managed Service for Apache Spark Java API 參考文件。
如要向 Managed Service for Apache Spark 進行驗證,請設定應用程式預設憑證。詳情請參閱「為本機開發環境設定驗證機制」。
如要在每次提交週期性批次工作負載時,啟用 Managed Service for Apache Spark 自動調整功能,請呼叫 BatchControllerClient.createBatch,並使用包含下列欄位的 CreateBatchRequest:
Batch.RuntimeConfig.cohort:同類群組名稱,用於將批次識別為一系列週期性工作負載之一。自動調整功能會套用至使用這個同類群組名稱提交的第二個及後續工作負載。舉例來說,您可以將daily_sales_aggregation指定為排定批次工作負載的同類群組名稱,該工作負載會執行每日銷售匯總工作。Batch.RuntimeConfig.AutotuningConfig.scenarios:指定AUTO,啟用 Spark 批次工作負載的自動調整功能。
範例:
...
Batch batch =
  Batch.newBuilder()
    .setRuntimeConfig(
      RuntimeConfig.newBuilder()
        .setCohort("daily_sales_aggregation")
        .setAutotuningConfig(
          AutotuningConfig.newBuilder()
            .addScenarios(Scenario.AUTO))
    ...
  .build();

batchControllerClient.createBatch(
    CreateBatchRequest.newBuilder()
        .setParent(parent)
        .setBatchId(batchId)
        .setBatch(batch)
        .build());
...
如要使用 API,您必須使用 google-cloud-dataproc 用戶端程式庫 4.43.0 以上版本。您可以使用下列其中一種設定,將程式庫新增至專案。
Maven
<dependencies>
 <dependency>
   <groupId>com.google.cloud</groupId>
   <artifactId>google-cloud-dataproc</artifactId>
   <version>4.43.0</version>
 </dependency>
</dependencies>
Gradle
implementation 'com.google.cloud:google-cloud-dataproc:4.43.0'
SBT
libraryDependencies += "com.google.cloud" % "google-cloud-dataproc" % "4.43.0"
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 Managed Service for Apache Spark 快速入門導覽課程」中的 Python 設定說明操作。詳情請參閱 Managed Service for Apache Spark Python API 參考文件。
如要向 Managed Service for Apache Spark 進行驗證,請設定應用程式預設憑證。詳情請參閱「為本機開發環境設定驗證機制」。
如要在每次提交週期性批次工作負載時,啟用 Managed Service for Apache Spark 自動調整功能,請呼叫 BatchControllerClient.create_batch,並使用包含下列欄位的 Batch:
batch.runtime_config.cohort:同類群組名稱,用於將批次識別為一系列週期性工作負載之一。自動調整功能會套用至使用這個同類群組名稱提交的第二個及後續工作負載。舉例來說,您可以將daily_sales_aggregation指定為排定批次工作負載的同類群組名稱,該工作負載會執行每日銷售匯總工作。batch.runtime_config.autotuning_config.scenarios:指定AUTO,啟用 Spark 批次工作負載的自動調整功能。
範例:
# Create a client
client = dataproc_v1.BatchControllerClient()

# Initialize request argument(s)
batch = dataproc_v1.Batch()
batch.pyspark_batch.main_python_file_uri = "gs://bucket/run_tpcds.py"
batch.runtime_config.cohort = "daily_sales_aggregation"
batch.runtime_config.autotuning_config.scenarios = [
    Scenario.AUTO
]

request = dataproc_v1.CreateBatchRequest(
    parent="parent_value",
    batch=batch,
)

# Make the request
operation = client.create_batch(request=request)
如要使用 API,您必須使用 google-cloud-dataproc 用戶端程式庫 5.10.1 以上版本。如要將其新增至專案,可以使用下列需求:
google-cloud-dataproc>=5.10.1
Airflow
您可以使用 Airflow 排定提交每個週期性批次工作負載,不必手動提交每個自動調整批次同類群組。方法是呼叫 BatchControllerClient.create_batch,並使用包含下列欄位的 Batch:
batch.runtime_config.cohort:同類群組名稱,用於將批次識別為一系列週期性工作負載之一。自動調整功能會套用至使用這個同類群組名稱提交的第二個及後續工作負載。舉例來說,您可以將daily_sales_aggregation指定為排定批次工作負載的同類群組名稱,該工作負載會執行每日銷售匯總工作。batch.runtime_config.autotuning_config.scenarios:指定AUTO,啟用 Spark 批次工作負載的自動調整功能。
範例:
create_batch = DataprocCreateBatchOperator(
    task_id="batch_create",
    batch={
        "pyspark_batch": {
            "main_python_file_uri": PYTHON_FILE_LOCATION,
        },
        "environment_config": {
            "peripherals_config": {
                "spark_history_server_config": {
                    "dataproc_cluster": PHS_CLUSTER_PATH,
                },
            },
        },
        "runtime_config": {
            "cohort": "daily_sales_aggregation",
            "autotuning_config": {
                "scenarios": [
                    Scenario.AUTO,
                ]
            }
        },
    },
    batch_id="BATCH_ID",
)
如要使用 API,您必須使用 google-cloud-dataproc 用戶端程式庫 5.10.1 以上版本。您可以使用下列 Airflow 環境需求:
google-cloud-dataproc>=5.10.1
如要在 Managed Service for Apache Airflow 中更新套件,請參閱「安裝 Managed Airflow 的 Python 依附元件 」。
查看自動調整變更
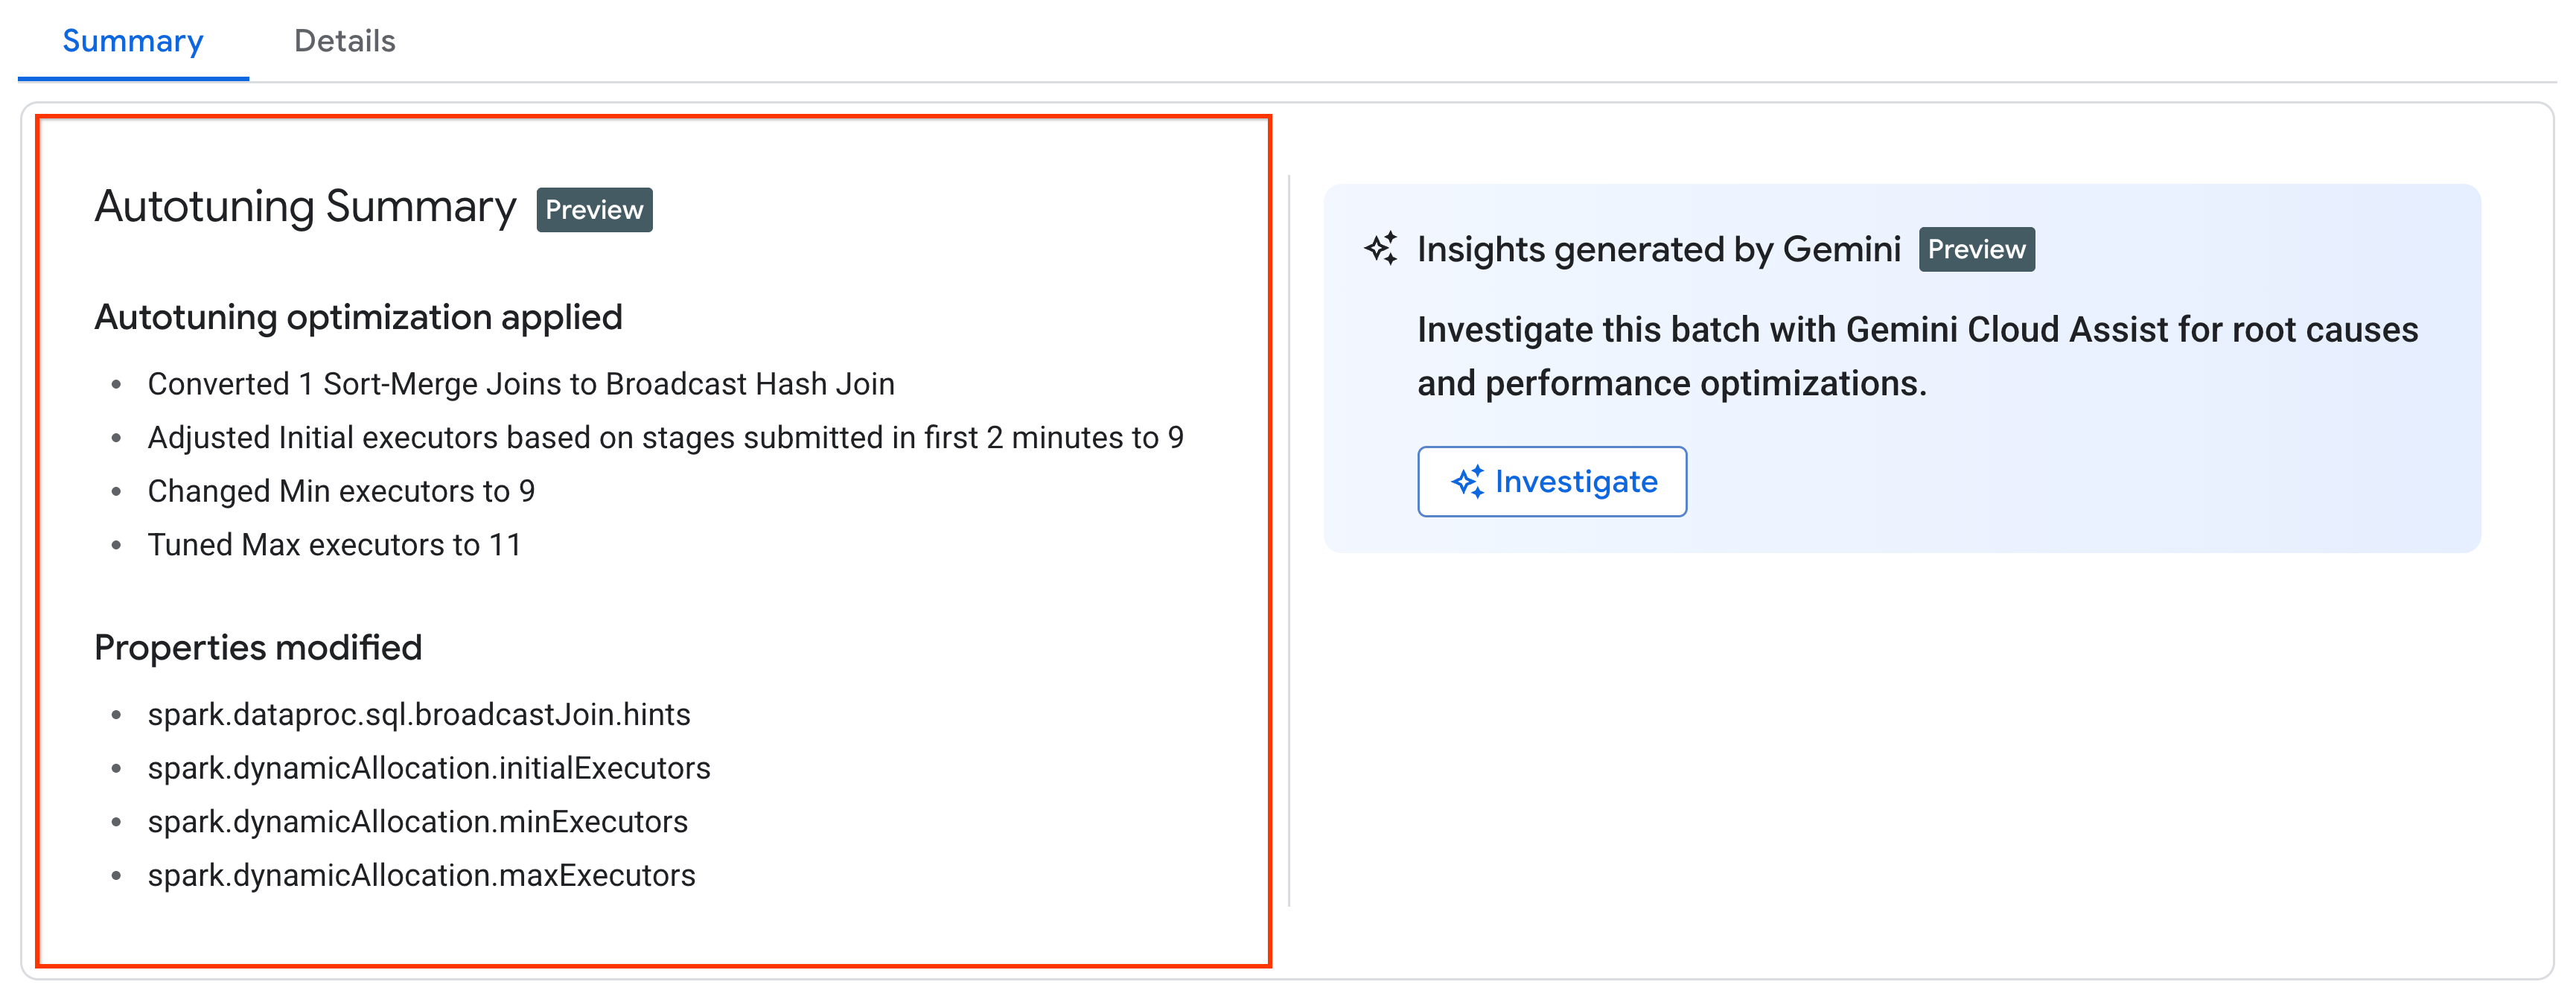
如要查看 Managed Service for Apache Spark 自動調整功能對批次工作負載所做的變更,請執行 gcloud dataproc batches describe 指令。
範例:gcloud dataproc batches describe 輸出內容大致如下:
...
runtimeInfo:
  propertiesInfo:
    # Properties set by autotuning.
    autotuningProperties:
      spark.dataproc.sql.broadcastJoin.hints:
        annotation: Converted 1 Sort-Merge Joins to Broadcast Hash Join
        value: v2;Inner,<hint>
      spark.dynamicAllocation.initialExecutors:
        annotation: Adjusted Initial executors based on stages submitted in first
          2 minutes to 9
        overriddenValue: '2'
        value: '9'
      spark.dynamicAllocation.maxExecutors:
        annotation: Tuned Max executors to 11
        overriddenValue: '5'
        value: '11'
      spark.dynamicAllocation.minExecutors:
        annotation: Changed Min executors to 9
        overriddenValue: '2'
        value: '9'
...
如要查看套用至執行中、已完成或失敗工作負載的最新自動調整變更,請前往 Google Cloud 控制台的「Batch details」(批次詳細資料) 頁面,然後點選「Summary」(摘要) 分頁標籤。
定價
Managed Service for Apache Spark 自動調整功能在私人預先發布版期間免費提供。適用標準 Managed Service for Apache Spark 定價。