Los conectores personalizados te permiten integrar fuentes de datos externas que no están incluidas en la biblioteca de conectores estándar de Gemini Enterprise, lo que hace que se puedan buscar los datos únicos de tu organización y acceder a ellos con lenguaje natural, con la tecnología de Gemini y la inteligencia de búsqueda avanzada de Google. El conector personalizado interactúa directamente con la API de Discovery Engine, que permite un almacenamiento de datos sólido, indexación y capacidades de búsqueda inteligente. El conector convierte la información de origen en el formato de documento estandarizado basado en JSON (estructurando el contenido, los metadatos y las listas de control de acceso [ACL]) y garantiza que estos datos se organicen en almacenes de datos. Estos almacenes actúan como repositorios lógicos, que idealmente representan un solo formato de documento, cada uno con su propio índice de búsqueda y configuración dedicados.
Cómo funcionan los conectores personalizados
Los conectores personalizados funcionan con una canalización de datos automatizada para realizar tres acciones clave: recuperar, transformar y sincronizar. Este proceso garantiza que los datos externos se preparen y suban correctamente a Gemini Enterprise.
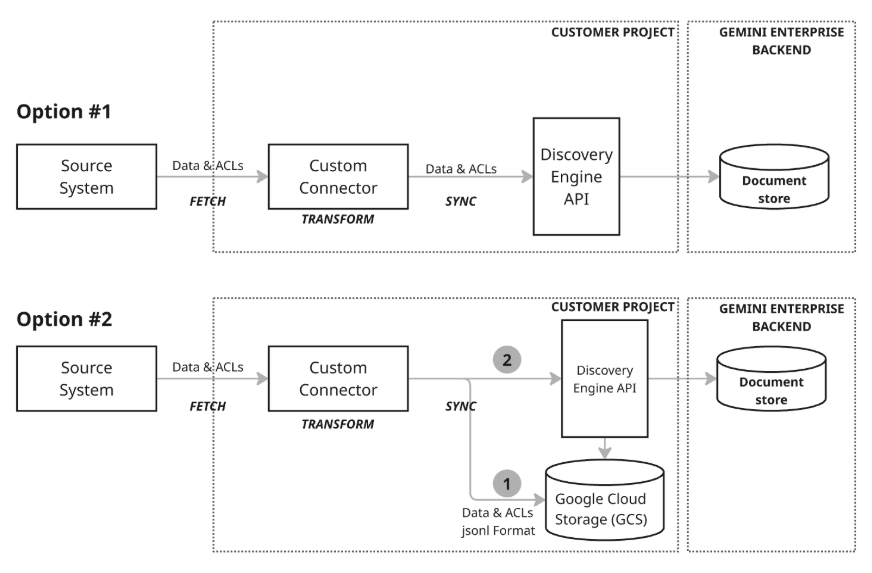
Recuperación: El conector extrae datos, incluidos documentos, metadatos y permisos, del sistema externo con sus APIs, bases de datos o formatos de archivo.
Transformación: El conector convierte los datos sin procesar en el formato de documento de Discovery Engine, estructura el contenido y los metadatos, y asigna un ID único a nivel global a cada documento. En el caso de los controles de acceso, puedes usar identidades reconocidas por Google directamente o la asignación de identidades para usuarios externos o grupos personalizados.
Sincronización: El conector sube los documentos a los almacenes de datos de Gemini Enterprise y los mantiene actualizados a través de trabajos programados. La sincronización de datos se realiza con un almacén de datos creado para una entidad. Para obtener más información sobre cómo crear un almacén de datos, consulta Proceso de creación de almacenes de datos. Elige un modo de sincronización según tus necesidades: Incremental agrega y actualiza datos, mientras que Completa reemplaza todo el conjunto de datos.
Asignación de identidades y LCA
Para administrar el acceso a nivel de documento, elige entre dos métodos: ACL puras o asignación de identidad, según el formato de identidad que usen los datos.
LCA puras (AclInfo): Este método se usa cuando la fuente de datos utiliza identidades basadas en correo electrónico reconocidas por (Google Cloud). Este enfoque es ideal para definir directamente quién tiene acceso.
Asignación de identidad: Este método se usa cuando la fuente de datos utiliza nombres de usuario, IDs heredados o algún otro sistema de identidad externo:
Establece una asociación clara y unívoca entre los grupos de identidad externos (p.ej., EXT1) y los usuarios o grupos internos del proveedor de identidad (IdP) (p.ej.,
IDPUser1@example.com).Permite que el sistema comprenda y aplique controles de acceso basados en grupos desde el sistema de origen, lo que es útil cuando una API devuelve etiquetas de grupo sin membresías de usuario completas o para escalar LCA de manera eficiente sin enumerar miles de usuarios por documento.
El proceso de asignación de identidades requiere resolver todas las estructuras de identidad anidadas o jerárquicas en una lista plana de asignaciones directas, por lo general, en un formato JSON especificado.
Usa IDs de grupos de identidades externas únicos (p.ej., EXT1) para las identidades externas con el objetivo de mantener la integridad del sistema. Para obtener más información y ejemplos, consulta Asigna identidades externas.
Proceso de creación del almacén de datos
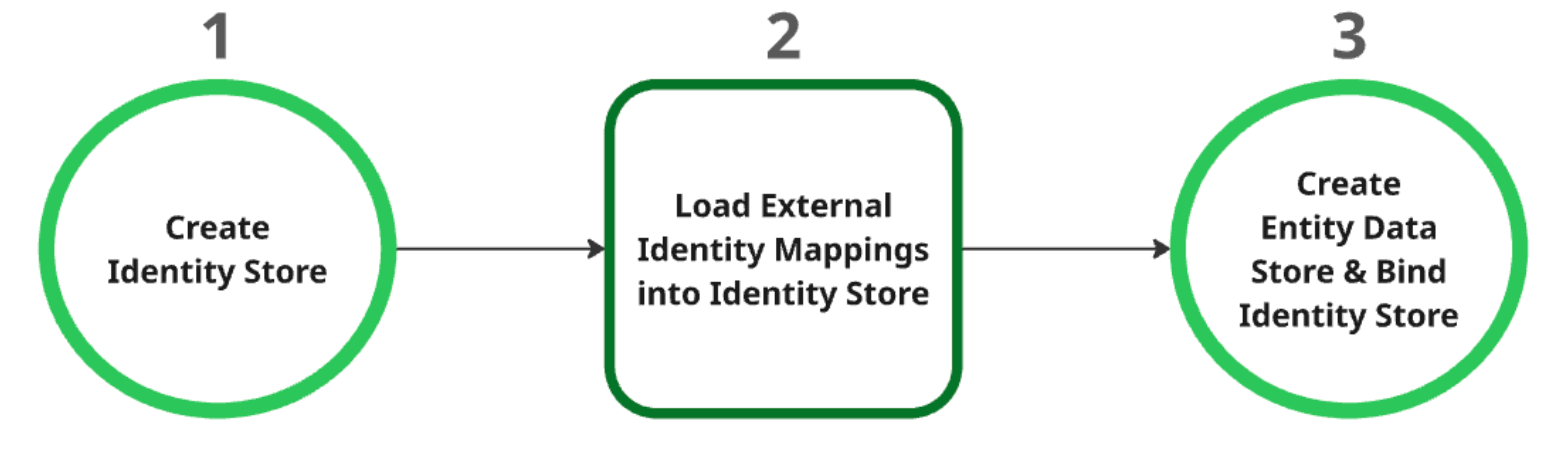
Crea el almacén de identidades: Este almacén actúa como el recurso superior para todas las asignaciones de identidad. Cuando se crea, se recupera automáticamente la configuración del proveedor de identidad (IDP) a nivel del proyecto. Para obtener más información, consulta Recupera o crea un almacén de identidades.
Carga asignaciones de identidades externas en el almacén de identidades: Después de crear el almacén de identidades, carga los datos de identidad externos en él. Para obtener más información, consulta Transferir la asignación de identidades al almacén de identidades.
Crea y vincula el almacén de datos de entidades: El almacén de datos de entidades solo se puede crear después de que se cree correctamente el almacén de identidades y se carguen las asignaciones de identidad. Debes vincular el almacén de identidades al almacén de datos de entidades durante su creación. Para obtener más información sobre cómo crear un almacén de datos de entidades, consulta Crea un almacén de datos.
Sincronizar datos
Existen dos modelos de arquitectura diferentes para sincronizar datos:
Modelo de arquitectura 1: Actualización o inserción incremental: El enfoque de actualización o inserción incremental es más adecuado para situaciones en las que los datos se transmiten y requieren actualizaciones en tiempo real. El conector aprovecha la API de Discovery Engine para realizar operaciones de upsert (inserción o actualización de datos) incrementales y eficientes llamando a las funciones adecuadas con pequeños cambios a medida que se producen. Este enfoque en tamaños de cambio mínimos y retrasos mínimos mantiene el almacén de documentos muy actualizado, incluso con datos que cambian rápidamente.
Modelo de arquitectura 2: Sincronización integral con Google Cloud Storage: Este enfoque recomendado ofrece un conjunto integral de funciones de administración de datos y una alta flexibilidad. Admite sincronizaciones completas, que permiten insertar, actualizar y borrar datos en todo el conjunto de datos, y sincronizaciones incrementales, que solo controlan las inserciones y actualizaciones enviando cambios. Esto hace que el enfoque sea sólido para una amplia gama de necesidades de datos, en especial para administrar operaciones de datos más grandes o complejas. Este modelo utiliza un proceso de etapa de pruebas (paso 1 en el diagrama) en el que el conector primero escribe los datos en Google Cloud Storage (GCS) y, luego, aprovecha la API de Discovery Engine para actualizar el almacén de documentos llamando a las funciones de importación necesarias desde la ubicación de GCS de etapa de pruebas.
Los conectores personalizados son lo suficientemente flexibles como para admitir una arquitectura híbrida, lo que te permite implementar la actualización o inserción incremental para los datos que cambian con rapidez y la sincronización completa para las actualizaciones o eliminaciones de datos completas programadas.