


このドキュメントでは、Gemini Enterprise が Knowledge Catalog と統合され、ユーザーがアクセスできるデータを検索し、技術的なコンテキストとビジネス コンテキストを検索するための読み取り専用ツールをエージェントに提供する方法について説明します。
Knowledge Catalog に接続するために、別のデータストアを作成する必要はありません。代わりに、連携クエリモードで BigQuery、Spanner、Cloud SQL、または AlloyDB for PostgreSQL のデータストアを Gemini Enterprise app に接続すると、Knowledge Catalog の統合が自動的に有効になります。Knowledge Catalog はデータストアとして表示されるのではなく、Gemini Enterprise app の [アシスタント] タブの構成オプションです。また、コンパニオンのデータクラウド コネクタ以外でも、いつでも統合を手動でオンまたはオフにできます。
Knowledge Catalog と データクラウド コネクタの連携の仕組み
Knowledge Catalog では、Google Cloud 環境全体でカタログ化されたすべてのデータアセットが、エントリと呼ばれるメタデータ レコードとして保存されます。フェデレーション クエリモードの Data Cloud コネクタは、単一のデータセットやテーブルに制限されるのではなく、認証されたユーザーが表示できるすべてのリソースに幅広くアクセスできるため、エージェントは最初、関連するデータがどこにあるかを認識していません。
Gemini Enterprise アプリで Knowledge Catalog が有効になっている場合(フェデレーション データクラウド コネクタを接続したときに自動的に有効になるか、[アシスタント] タブで手動で有効にする)、この統合により、エージェントに組み込みスキルと読み取り専用ツールが提供され、次のことが可能になります。
- アクセス可能なデータを検索する: 認証されたユーザーがアクセス権を持つ Knowledge Catalog のカタログ化されたデータアセットを検索します。
- 技術コンテキストとビジネス コンテキストを検索する: テーブル スキーマ、列の説明、ビジネス用語集の用語、事前に検証されたサンプルクエリ(ゴールデン クエリ)など、拡充されたメタデータを取得します。コンパニオン データクラウド コネクタと組み合わせると、エージェントはこれらのゴールデン クエリを使用して、複雑なスキーマでの結合ハルシネーションを防止し、このコンテキストをコネクタに渡して正確なクエリを生成して実行します。
ワークフローの例
次の図は、Knowledge Catalog と連携 Data Cloud コネクタが連携してユーザーの質問に回答する仕組みを示しています。
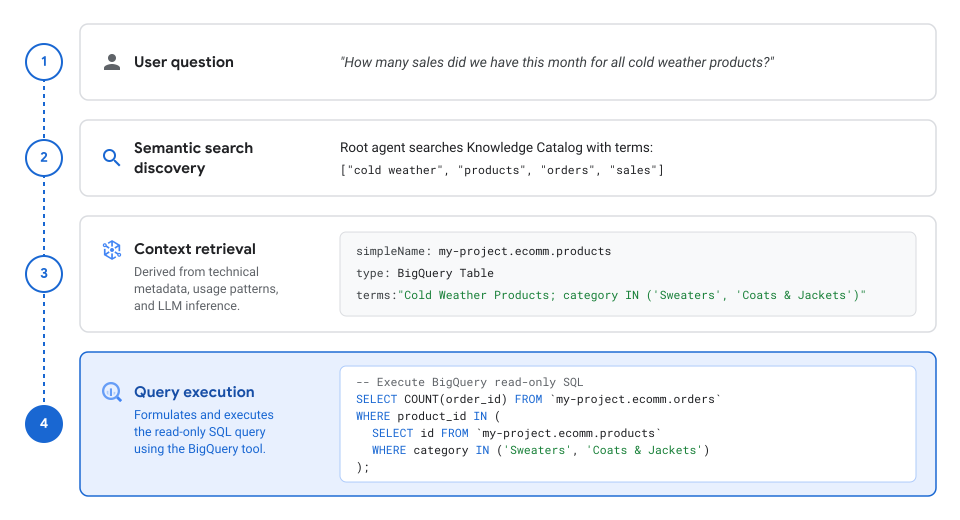
このワークフローでは、Gemini Enterprise が次の手順を完了します。
ユーザーの質問: ユーザーが Gemini Enterprise で自然言語で質問します。
"How many sales did we have this month for all cold weather products?"セマンティック検索の検出: Gemini Enterprise ルート エージェントは、ユーザーの質問から抽出された検索キーワードを使用して Knowledge Catalog を検索します。
["cold weather", "products", "orders", "sales"]コンテキストの取得: ユーザーがアクセスできる一致するエントリについて、エージェントは Knowledge Catalog で拡充されたコンテキスト(技術メタデータ、使用パターン、ビジネス用語集、LLM 推論から派生)を検索します。
simpleName: my-project.ecomm.products type: BigQuery Table terms: "Cold Weather Products; category IN ('Sweaters', 'Coats & Jackets')"クエリの実行: 取得したテーブル メタデータとビジネス定義を使用して、エージェントは連携 BigQuery コネクタを介して読み取り専用の SQL クエリを作成して実行します。
-- Execute BigQuery read-only SQL
SELECT COUNT(order_id) FROM `my-project.ecomm.orders`
WHERE product_id IN (
  SELECT id FROM `my-project.ecomm.products`
  WHERE category IN ('Sweaters', 'Coats & Jackets')
);
始める前に
Knowledge Catalog の統合は読み取り専用で、内部 API を使用します。そのため、Dataplex API を有効にしたり、MCP ツールに権限を付与したりする必要はありません。また、ユーザーは Knowledge Catalog でリソースを作成または変更する権限を必要としません。
この統合では、エンドユーザー認証情報を使用してリクエストを認証するため、エージェントは、認証されたユーザーが Identity and Access Management(IAM)権限を持つデータアセットのみを検索して検出できます。
- 検索結果のトリミングによるメタデータとデータアクセスの分離: Knowledge Catalog は、基盤となるデータソースでの認証済みユーザーの権限に基づいて検索結果のトリミングを適用します。ユーザーがデータセットまたはテーブルに対する読み取り権限(
roles/bigquery.dataViewerやroles/bigquery.metadataViewerなど)を持っていない場合、そのアセットはカタログ検索結果から自動的に除外され、アシスタントで検出できません。 - ファーストパーティの Google Cloud データソース: BigQuery、AlloyDB for PostgreSQL、Spanner、Cloud SQL などのファーストパーティのデータソースの権限は自動的に継承されます。たとえば、ユーザーに BigQuery データ閲覧者(
roles/bigquery.dataViewer)ロールを付与すると、Knowledge Catalog で対応するテーブルとデータセットのメタデータを検索して検出できるようになります。 - 追加のメタデータとサードパーティのデータソース: Knowledge Catalog に追加されたカスタム メタデータ、ビジネス用語集、サードパーティのデータアセットの場合、エージェントがそのデータを検出できるように、ユーザーに Knowledge Catalog で必要な表示権限(
roles/dataplex.dataDomainEntryReaderやroles/dataplex.catalogViewerなど)が付与されていることを確認します。詳細については、Knowledge Catalog のドキュメントの IAM でアクセスを管理するをご覧ください。
アプリで Knowledge Catalog を有効または無効にする
連携クエリモードで BigQuery、Spanner、Cloud SQL、AlloyDB for PostgreSQL のデータストアを Gemini Enterprise app に接続すると、Knowledge Catalog とその組み込みエージェント スキルがアプリで自動的に有効になります。
また、アプリの [構成] ページの [アシスタント] タブで、いつでも Knowledge Catalog の統合を手動でオンまたはオフにできます。これは、コンパニオン Data Cloud コネクタの外部でも可能です(たとえば、Data Cloud コネクタをアタッチせずに Knowledge Catalog を有効にしたり、Data Cloud コネクタを有効にしたままオフにしたりできます)。
Google Cloud コンソールで、[Gemini Enterprise] ページに移動します。
構成するアプリの名前をクリックします。
[構成] をクリックし、[アシスタント] タブを選択します。
[Knowledge Catalog を有効にする] セクションで、切り替えボタンを使用して Knowledge Catalog の統合をオンまたはオフにします。
[保存して公開] をクリックします。
アシスタントの設定の詳細については、アシスタントを構成するをご覧ください。
次のステップ
- 連携クエリモードで Data Cloud データソースを接続します。
- 会話分析を使用する Data Cloud コネクタのベスト プラクティスについて確認する。