


En este documento, se describen las capacidades y configuraciones del ancho de banda de red para las instancias de Compute Engine con GPU conectadas. Obtén información sobre el ancho de banda máximo de red, los arreglos de tarjetas de interfaz de red (NIC) y las configuraciones de red de VPC recomendadas para varios tipos de máquinas de GPU, incluidas las series A4X Max, A4X, A4, A3, A2, G4, G2 y N1. Comprender estas configuraciones puede ayudarte a optimizar el rendimiento de tus cargas de trabajo distribuidas en Compute Engine.
Descripción general
En la siguiente tabla, se proporciona una comparación general de las capacidades de redes en los tipos de máquinas con GPU.
| Tipo de máquina | Modelo de GPU | Ancho de banda total máximo | Tecnología de redes de GPU a GPU |
|---|---|---|---|
| A4X Max | Superchips NVIDIA GB300 Ultra | 3,600 Gbps | GPUDirect RDMA |
| A4X | Superchips NVIDIA GB200 | 2,000 Gbps | GPUDirect RDMA |
| A4 | NVIDIA B200 | 3,600 Gbps | GPUDirect RDMA |
| A3 Ultra | NVIDIA H200 | 3,600 Gbps | GPUDirect RDMA |
| A3 Mega | NVIDIA H100 de 80 GB | 1,800 Gbps | GPUDirect-TCPXO |
| A3 High | NVIDIA H100 de 80 GB | 1,000 Gbps | GPUDirect-TCPX |
| A3 Edge | NVIDIA H100 de 80 GB | 600 Gbps | GPUDirect-TCPX |
| G4 | NVIDIA RTX PRO 6000 | 400 Gbps | N/A |
| A2 estándar y A2 Ultra | NVIDIA A100 de 40 GB, NVIDIA A100 de 80 GB | 100 Gbps | N/A |
| G2 | NVIDIA L4 | 100 Gbps | N/A |
| N1 | NVIDIA T4, NVIDIA V100 | 100 Gbps | N/A |
| N1 | NVIDIA P4 | 32 Gbps | N/A |
Funciones de GPUDirect RDMA y MRDMA
En ciertos tipos de máquinas optimizadas para aceleradores, Google Cloud usa MRDMA como la implementación de la interfaz de red para las redes de GPU a GPU que admiten GPUDirect RDMA.
GPUDirect RDMA es una tecnología de NVIDIA que permite que una tarjeta de interfaz de red (NIC) acceda directamente a la memoria de la GPU a través de PCIe, lo que omite la CPU del host y la memoria del sistema. Esta comunicación de par a par entre la NIC y la GPU reduce de forma significativa la latencia para la comunicación de GPU a GPU entre nodos.
MRDMA es la implementación de la interfaz de red que se usa en los tipos de máquinas A4X Max, A4X, A4 y A3 Ultra para proporcionar capacidades de GPUDirect RDMA. MRDMA se basa en las NIC de NVIDIA ConnectX y se implementa de una de las siguientes maneras:
- Funciones virtuales (VF) de MRDMA: Se usan en las series A3 Ultra, A4 y A4X.
- Funciones físicas (PF) de MRDMA: Se usan en la serie A4X Max.
Funciones de MRDMA y herramientas de supervisión de red
Los tipos de máquinas A4X, A4 y A3 Ultra implementan redes de GPU a GPU de alto rendimiento con funciones virtuales (VF) de MRDMA. Como se trata de entidades virtualizadas, ciertas capacidades de supervisión a nivel de hardware están restringidas en comparación con las funciones físicas (PF).
Con las VF de MRDMA, los contadores de puertos físicos estándar (como los
que terminan en _phy) aparecen en el resultado de ethtool -S,
pero no se actualizan durante la actividad de red. Esta es una característica de
la arquitectura de VF de MRDMA. Para realizar un seguimiento preciso del rendimiento de la red en
estas interfaces, revisa las entradas de la tabla de contadores de vPort en lugar
de la tabla de contadores de puertos físicos.
El tipo de máquina A4X Max usa PF de MRDMA. A diferencia de los tipos de máquinas basados en VF de MRDMA, A4X Max admite el rango completo de contadores de puertos físicos para las redes de GPU.
Revisa los conceptos de redes para los tipos de máquinas de GPU
Usa la siguiente sección para revisar la disposición de la red y la velocidad del ancho de banda de cada tipo de máquina de GPU.
Tipos de máquinas A4X Max y A4X
Las series de máquinas A4X Max y A4X, que se basan en la arquitectura NVIDIA Blackwell, están diseñadas para cargas de trabajo de IA distribuidas, exigentes y a gran escala. La principal diferencia entre ambos son los aceleradores y el hardware de red conectados, como se describe en la siguiente tabla:
| Serie de máquinas A4X Max | Serie de máquinas A4X | |
|---|---|---|
| Hardware conectado | Superchips NVIDIA GB300 Ultra | Superchips NVIDIA GB200 |
| Herramientas de redes de GPU a GPU | 4 SuperNIC NVIDIA ConnectX-8 (CX-8) que proporcionan un ancho de banda de 3,200 Gbps en una topología de 8 vías encarrilada | 4 NIC NVIDIA ConnectX-7 (CX-7) que proporcionan un ancho de banda de 1,600 Gbps en una topología de 4 vías encarrilada |
| Implementación de redes de GPU a GPU | 8 funciones físicas (PF) de MRDMA configuradas como 2 PF por NIC | 4 funciones virtuales (VF) de MRDMA configuradas como 1 VF por NIC |
| Herramientas de redes de uso general | 2 NIC inteligentes Titanium que proporcionan un ancho de banda de 400 Gbps | 2 NIC inteligentes Titanium que proporcionan un ancho de banda de 400 Gbps |
| Ancho de banda de red máximo total | 3,600 Gbps | 2,000 Gbps |
Arquitectura de red de varias capas
Las instancias de procesamiento A4X Max y A4X usan una arquitectura de red jerárquica y de varias capas con un diseño encarrilado para optimizar el rendimiento de varios tipos de comunicación. En esta topología, las instancias se conectan a través de varios planos de red independientes, llamados rieles.
- Las instancias A4X Max usan una topología de 8 vías encarrilada en la que cada una de las cuatro NIC ConnectX-8 de 800 Gbps se conecta a dos rieles de 400 Gbps independientes.
- Las instancias A4X usan una topología encarrilada de 4 vías en la que cada una de las cuatro NIC ConnectX-7 se conecta a un riel independiente.
Las capas de red para estos tipos de máquinas son las siguientes:
Comunicación dentro del nodo y dentro del subbloque (NVLink): Un tejido de NVLink de alta velocidad interconecta las GPU para una comunicación de gran ancho de banda y baja latencia. Esta estructura conecta todas las GPUs dentro de una sola instancia y se extiende por un subbloque, que consta de 18 instancias de A4X Max o A4X (un total de 72 GPUs). Esto permite que las 72 GPU de un subbloque se comuniquen como si estuvieran en un solo servidor de GPU a gran escala.
Comunicación entre subbloques (NIC ConnectX con RoCE): Para escalar las cargas de trabajo más allá de un solo subbloque, estas máquinas usan NIC ConnectX de NVIDIA. Estas NIC usan RDMA sobre Ethernet convergente (RoCE) para proporcionar comunicación de gran ancho de banda y baja latencia entre subbloques, lo que te permite compilar clústeres de entrenamiento a gran escala con miles de GPUs.
Herramientas de redes de uso general (NIC inteligentes Titanium): Además de las redes de GPU especializadas, cada instancia tiene dos NIC inteligentes Titanium, que proporcionan un ancho de banda combinado de 400 Gbps para tareas de redes generales. Esto incluye el tráfico para el almacenamiento, la administración y la conexión a otros servicios de Google Cloud o a la Internet pública.
Arquitectura de A4X Max
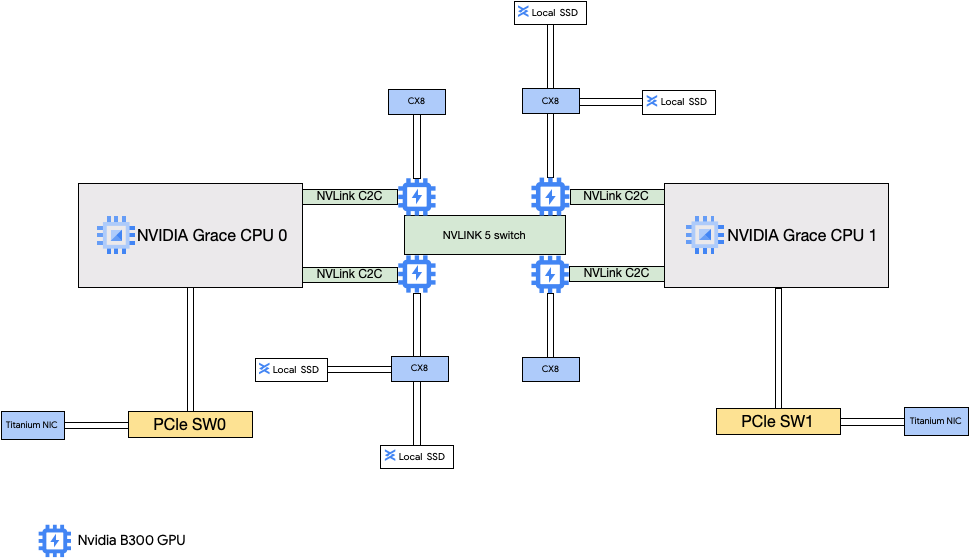
La arquitectura A4X Max se basa en los superchips NVIDIA GB300 Ultra. Una característica clave de este diseño es la conexión directa de las cuatro SuperNIC NVIDIA ConnectX-8 (CX-8) de 800 Gbps a las GPU. Cada ConnectX-8 es una NIC de puerto doble, que se expone a la instancia como dos funciones físicas (PF). Estas NIC forman parte de una topología de red de 8 vías encarrilada en la que cada NIC se conecta a dos rieles de 400 Gbps independientes. Esta ruta directa habilita el RDMA, lo que proporciona un ancho de banda alto y una latencia baja para la comunicación entre GPU en diferentes subbloques. Estas instancias de Compute Engine también incluyen SSD locales de alto rendimiento que se conectan a las NIC ConnectX-8, lo que omite el bus PCIe para un acceso más rápido a los datos.
Arquitectura de A4X
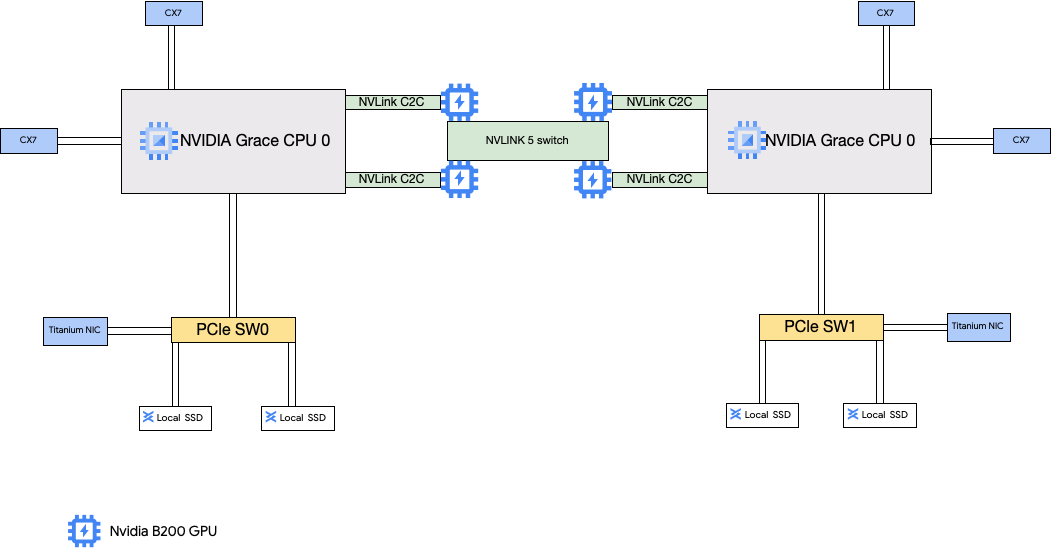
La arquitectura A4X usa superchips NVIDIA GB200. En esta configuración, las cuatro NIC NVIDIA ConnectX-7 (CX-7) están conectadas a la CPU del host. Esta configuración proporciona redes de alto rendimiento para la comunicación de GPU a GPU entre subbloques.
Configuración de red de nube privada virtual (VPC) de A4X Max y A4X
Para usar todas las capacidades de red de estos tipos de máquinas, debes crear y conectar redes de VPC a tus instancias. Para usar todas las NIC disponibles, debes crear redes de VPC de la siguiente manera:
Dos redes de VPC normales para las NIC inteligentes de Titanium.
- Para A4X Max, estas redes de VPC usan el controlador de dispositivo Intel IDPF LAN PF.
- Para A4X, estas redes de VPC usan la interfaz de red de la NIC virtual de Google (gVNIC).
Se requiere una red de VPC con el perfil de red de RoCE para las NIC de ConnectX cuando creas clústeres de varios subbloques de A4X Max o A4X. La red de VPC de RoCE debe tener una subred para cada riel de red. Esto significa ocho subredes para las instancias de A4X Max y cuatro subredes para las instancias de A4X. Si usas un solo subbloque, puedes omitir esta red de VPC, ya que la estructura de NVLink de varios nodos controla la comunicación directa de GPU a GPU.
Para configurar estas redes, consulta Crea redes de VPC en la documentación de AI Hypercomputer.
Tipos de máquinas A4X Max y A4X
A4X Max
| Tipo de máquina | Recuento de CPU virtuales | Memoria de la instancia (GB) | SSD local conectado (GiB) | Cantidad de NICs físicas | Ancho de banda de red máximo (Gbps) | Cantidad de GPU NVIDIA GB300 | Memoria de GPU (GB HBM3e) |
|---|---|---|---|---|---|---|---|
a4x-maxgpu-4g-metal |
144 | 960 | 12,000 | 6 | 3,600 | 4 | 1,116 |
Las siguientes notas se aplican a la tabla anterior:
- Recuento de CPU virtuales: Una CPU virtual se implementa como un solo hipersubproceso de hardware en una de las plataformas de CPU disponibles.
- Ancho de banda de red máximo: El ancho de banda de salida máximo no puede ser superior al número especificado. El ancho de banda de salida real depende de la dirección IP de destino y de otros factores. Para obtener más información sobre el ancho de banda de red, consulta Ancho de banda de red.
- Memoria de GPU: Es la memoria de un dispositivo GPU que se puede usar para el almacenamiento temporal de datos. Es independiente de la memoria de la instancia y está diseñado de forma específica para manejar las demandas más altas de ancho de banda de tus cargas de trabajo de alto contenido gráfico.
A4X
| Tipo de máquina | Recuento de CPU virtuales | Memoria de la instancia (GB) | SSD local conectado (GiB) | Cantidad de NICs físicas | Ancho de banda de red máximo (Gbps) | Recuento de GPU NVIDIA GB200 | Memoria de GPU (GB HBM3e) |
|---|---|---|---|---|---|---|---|
a4x-highgpu-4g |
140 | 884 | 12,000 | 6 | 2,000 | 4 | 744 |
Las siguientes notas se aplican a la tabla anterior:
- Recuento de CPU virtuales: Una CPU virtual se implementa como un solo hipersubproceso de hardware en una de las plataformas de CPU disponibles.
- Ancho de banda de red máximo: El ancho de banda de salida máximo no puede ser superior al número especificado. El ancho de banda de salida real depende de la dirección IP de destino y de otros factores. Para obtener más información sobre el ancho de banda de red, consulta Ancho de banda de red.
- Memoria de GPU: Es la memoria de un dispositivo GPU que se puede usar para el almacenamiento temporal de datos. Es independiente de la memoria de la instancia y está diseñado de forma específica para manejar las demandas más altas de ancho de banda de tus cargas de trabajo de alto contenido gráfico.
Tipos de máquinas A4 y A3 Ultra
Los tipos de máquinas A4 tienen GPU NVIDIA B200 conectadas y los tipos de máquinas A3 Ultra tienen GPU NVIDIA H200 conectadas.
Estos tipos de máquinas proporcionan ocho tarjetas de interfaz de red (NIC) NVIDIA ConnectX-7 (CX-7) y dos NIC virtuales de Google (gVNIC). Las ocho NIC CX-7 ofrecen un ancho de banda de red total de 3,200 Gbps. Estas NIC se dedican solo a la comunicación de GPU a GPU de gran ancho de banda y no se pueden usar para otras necesidades de red, como el acceso a Internet público. Como se describe en el siguiente diagrama, cada NIC CX-7 está alineada con una GPU para optimizar el acceso a la memoria no uniforme (NUMA). Las ocho GPU pueden comunicarse rápidamente entre sí con el puente NVLink de todos los elementos que las conecta. Las otras dos tarjetas de interfaz de red de gVNIC son NIC inteligentes que proporcionan 400 Gbps adicionales de ancho de banda de red para los requisitos de red de uso general. En conjunto, las tarjetas de interfaz de red proporcionan un ancho de banda de red máximo total de 3,600 Gbps para estas máquinas.
Las redes de GPU a GPU de alto rendimiento en las instancias A4 y A3 Ultra se implementan con funciones virtuales (VF) de MRDMA para cada una de las ocho NIC ConnectX-7.
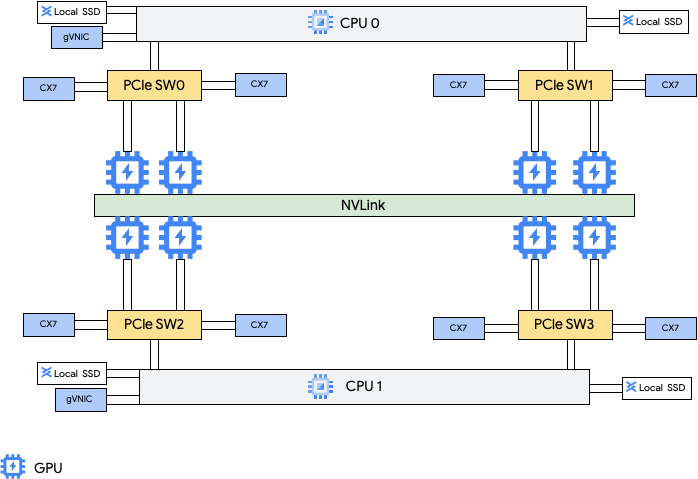
Para usar estas NIC múltiples, debes crear 3 redes de nube privada virtual de la siguiente manera:
- Dos redes de VPC normales: cada gVNIC debe conectarse a una red de VPC diferente
- Una red de VPC de RoCE: las ocho NIC de CX-7 comparten la misma red de VPC de RoCE
Para configurar estas redes, consulta Crea redes de VPC en la documentación de AI Hypercomputer.
A4
| Tipo de máquina | Recuento de CPU virtuales | Memoria de la instancia (GB) | SSD local conectado (GiB) | Cantidad de NICs físicas | Ancho de banda de red máximo (Gbps) | Cantidad de GPU NVIDIA B200 Blackwell | Memoria de GPU (GB HBM3e) |
|---|---|---|---|---|---|---|---|
a4-highgpu-8g |
224 | 3,968 | 12,000 | 10 | 3,600 | 8 | 1,440 |
Las siguientes notas se aplican a la tabla anterior:
- Recuento de CPU virtuales: Una CPU virtual se implementa como un solo hipersubproceso de hardware en una de las plataformas de CPU disponibles.
- Ancho de banda de red máximo: El ancho de banda de salida máximo no puede ser superior al número especificado. El ancho de banda de salida real depende de la dirección IP de destino y de otros factores. Para obtener más información sobre el ancho de banda de red, consulta Ancho de banda de red.
- Memoria de GPU: Es la memoria de un dispositivo GPU que se puede usar para el almacenamiento temporal de datos. Es independiente de la memoria de la instancia y está diseñado de forma específica para manejar las demandas más altas de ancho de banda de tus cargas de trabajo de alto contenido gráfico.
A3 Ultra
| Tipo de máquina | Recuento de CPU virtuales | Memoria de la instancia (GB) | SSD local conectado (GiB) | Cantidad de NICs físicas | Ancho de banda de red máximo (Gbps) | Recuento de GPU NVIDIA H200 | Memoria de GPU (GB HBM3e) |
|---|---|---|---|---|---|---|---|
a3-ultragpu-8g |
224 | 2,952 | 12,000 | 10 | 3,600 | 8 | 1128 |
Las siguientes notas se aplican a la tabla anterior:
- Recuento de CPU virtuales: Una CPU virtual se implementa como un solo hipersubproceso de hardware en una de las plataformas de CPU disponibles.
- Ancho de banda de red máximo: El ancho de banda de salida máximo no puede ser superior al número especificado. El ancho de banda de salida real depende de la dirección IP de destino y de otros factores. Para obtener más información sobre el ancho de banda de red, consulta Ancho de banda de red.
- Memoria de GPU: Es la memoria de un dispositivo GPU que se puede usar para el almacenamiento temporal de datos. Es independiente de la memoria de la instancia y está diseñado de forma específica para manejar las demandas más altas de ancho de banda de tus cargas de trabajo de alto contenido gráfico.
Tipos de máquinas A3 Mega, High y Edge
Estos tipos de máquinas tienen GPUs H100 conectadas. Cada uno de estos tipos de máquinas tiene un recuento fijo de GPU, de CPU virtuales y de tamaño de memoria.
- VMs A3 con una sola NIC: En el caso de las VMs A3 con 1 a 4 GPUs conectadas, solo hay una tarjeta de interfaz de red (NIC) física disponible.
- VMs A3 NIC NICs: Para las VMs A3 con 8 GPU conectadas,
hay varias NICs físicas disponibles. Para estos tipos de máquinas A3, las NIC se organizan de la siguiente manera en
un bus exprés de interconexión de componentes periféricos (PCIe):
- Para el tipo de máquina A3 Mega, hay disponible un arreglo de NIC de 8+1. Con esta disposición, 8 NICs comparten el mismo bus PCIe y 1 NIC reside en un bus PCIe independiente.
- Para el tipo de máquina A3 High, hay disponible un arreglo de NIC de 4+1. Con esta disposición, 4 NICs comparten el mismo bus PCIe y 1 NIC reside en un bus PCIe independiente.
- Para el tipo de máquina A3 Edge: está disponible una disposición de NIC de 4+1. Con esta disposición, 4 NICs comparten el mismo bus PCIe y 1 NIC reside en un bus PCIe independiente. Estas 5 NIC proporcionan un ancho de banda de red total de 400 Gbps para cada VM.
Las NIC que comparten el mismo bus PCIe tienen una alineación de acceso a memoria no uniforme (NUMA) de una NIC por cada dos GPU NVIDIA H100. Estas NIC son ideales para la comunicación dedicada de gran ancho de banda de GPU a GPU. La NIC física que reside en un bus PCIe independiente es ideal para otras necesidades de red. Para obtener instrucciones sobre cómo configurar las redes para las VMs A3 High y A3 Edge, consulta Configura redes de MTU de marcos jumbo.
A3 Mega
| Tipo de máquina | Recuento de CPU virtuales | Memoria de la instancia (GB) | SSD local conectado (GiB) | Cantidad de NICs físicas | Ancho de banda de red máximo (Gbps) | Cantidad de GPU NVIDIA H100 | Memoria de GPU (GB HBM3) |
|---|---|---|---|---|---|---|---|
a3-megagpu-8g |
208 | 1,872 | 6,000 | 9 | 1,800 | 8 | 640 |
A3 High
| Tipo de máquina | Recuento de CPU virtuales | Memoria de la instancia (GB) | SSD local conectado (GiB) | Cantidad de NICs físicas | Ancho de banda de red máximo (Gbps) | Cantidad de GPU NVIDIA H100 | Memoria de GPU (GB HBM3) |
|---|---|---|---|---|---|---|---|
a3-highgpu-1g |
26 | 234 | 750 | 1 | 25 | 1 | 80 |
a3-highgpu-2g |
52 | 468 | 1,500 | 1 | 50 | 2 | 160 |
a3-highgpu-4g |
104 | 936 | 3,000 | 1 | 100 | 4 | 320 |
a3-highgpu-8g |
208 | 1,872 | 6,000 | 5 | 1,000 | 8 | 640 |
A3 Edge
| Tipo de máquina | Recuento de CPU virtuales | Memoria de la instancia (GB) | SSD local conectado (GiB) | Cantidad de NICs físicas | Ancho de banda de red máximo (Gbps) | Cantidad de GPU NVIDIA H100 | Memoria de GPU (GB HBM3) |
|---|---|---|---|---|---|---|---|
a3-edgegpu-8g |
208 | 1,872 | 6,000 | 5 | 600 (asia-south1 y northamerica-northeast2) o 400 (todas las demás regiones de A3 Edge) |
8 | 640 |
Las siguientes notas se aplican a la tabla anterior:
- Recuento de CPU virtuales: Una CPU virtual se implementa como un solo hipersubproceso de hardware en una de las plataformas de CPU disponibles.
- Ancho de banda de red máximo: El ancho de banda de salida máximo no puede ser superior al número especificado. El ancho de banda de salida real depende de la dirección IP de destino y de otros factores. Para obtener más información sobre el ancho de banda de red, consulta Ancho de banda de red.
- Memoria de GPU: Es la memoria de un dispositivo GPU que se puede usar para el almacenamiento temporal de datos. Es independiente de la memoria de la instancia y está diseñado de forma específica para manejar las demandas más altas de ancho de banda de tus cargas de trabajo de alto contenido gráfico.
Tipos de máquinas A2
Cada tipo de máquina A2 tiene una cantidad fija de GPU NVIDIA A100 de 40 GB o NVIDIA A100 de 80 GB conectadas. Cada tipo de máquina también tiene un recuento fijo de CPU virtuales y de tamaño de memoria.
Las series de máquinas A2 están disponibles en dos tipos:
- A2 Ultra: Estos tipos de máquinas tienen GPU A100 de 80 GB y discos SSD local conectados.
- A2 estándar: Estos tipos de máquinas tienen GPU A100 de 40 GB conectadas.
A2 ultra
| Tipo de máquina | Recuento de CPU virtuales | Memoria de la instancia (GB) | SSD local conectado (GiB) | Ancho de banda de red máximo (Gbps) | Recuento de GPU NVIDIA A100 de 80 GB | Memoria de GPU (GB HBM2e) |
|---|---|---|---|---|---|---|
a2-ultragpu-1g |
12 | 170 | 375 | 24 | 1 | 80 |
a2-ultragpu-2g |
24 | 340 | 750 | 32 | 2 | 160 |
a2-ultragpu-4g |
48 | 680 | 1,500 | 50 | 4 | 320 |
a2-ultragpu-8g |
96 | 1,360 | 3,000 | 100 | 8 | 640 |
A2 Estándar
| Tipo de máquina | Recuento de CPU virtuales | Memoria de la instancia (GB) | Compatible con SSD local | Ancho de banda de red máximo (Gbps) | Recuento de GPU NVIDIA A100 de 40 GB | Memoria de GPU (GB HBM2) |
|---|---|---|---|---|---|---|
a2-highgpu-1g |
12 | 85 | Sí | 24 | 1 | 40 |
a2-highgpu-2g |
24 | 170 | Sí | 32 | 2 | 80 |
a2-highgpu-4g |
48 | 340 | Sí | 50 | 4 | 160 |
a2-highgpu-8g |
96 | 680 | Sí | 100 | 8 | 320 |
a2-megagpu-16g |
96 | 1,360 | Sí | 100 | 16 | 640 |
Las siguientes notas se aplican a la tabla anterior:
- Recuento de CPU virtuales: Una CPU virtual se implementa como un solo hipersubproceso de hardware en una de las plataformas de CPU disponibles.
- Ancho de banda de red máximo: El ancho de banda de salida máximo no puede ser superior al número especificado. El ancho de banda de salida real depende de la dirección IP de destino y de otros factores. Para obtener más información sobre el ancho de banda de red, consulta Ancho de banda de red.
- Memoria de GPU: Es la memoria de un dispositivo GPU que se puede usar para el almacenamiento temporal de datos. Es independiente de la memoria de la instancia y está diseñado de forma específica para manejar las demandas más altas de ancho de banda de tus cargas de trabajo de alto contenido gráfico.
Tipos de máquinas G4
Los tipos de máquinas optimizadas para aceleradores G4
usan
GPU NVIDIA RTX PRO 6000 Blackwell Server Edition (nvidia-rtx-pro-6000)
y son
adecuados para cargas de trabajo de simulación de NVIDIA Omniverse, aplicaciones con uso intensivo de gráficos, transcodificación de
video y escritorios virtuales. Los tipos de máquinas G4 también proporcionan una solución de bajo costo para
realizar inferencias de host único y ajustes de modelos en comparación con los tipos de máquinas de la serie A.
También puedes agregar discos SSD Titanium cuando creas una instancia G4. Para conocer la cantidad de discos que puedes conectar, consulta Tipos de máquinas que requieren que elijas una cantidad de discos SSD locales. Para obtener información sobre las limitaciones de tipo de máquina, consulta Limitaciones de G4.
| Tipo de máquina | Recuento de CPU virtuales | Memoria de la instancia (GB) | Máximo de SSD Titanium admitido (GiB) | Cantidad de NICs físicas | Ancho de banda de red máximo (Gbps) | Cantidad de GPU NVIDIA RTX PRO 6000 | Memoria de GPU (GB GDDR7) |
|---|---|---|---|---|---|---|---|
g4-standard-6 |
6 | 22 | 0 | 1 | 20 | 1/8 | 12 |
g4-standard-12 |
12 | 45 | 375 | 1 | 20 | 1/4 | 24 |
g4-standard-24 |
24 | 90 | 750 | 1 | 20 | 1/2 | 48 |
g4-standard-48 |
48 | 180 | 1,500 | 1 | 50 | 1 | 96 |
g4-standard-96 |
96 | 360 | 3,000 | 1 | 100 | 2 | 192 |
g4-standard-192 |
192 | 720 | 6,000 | 1 | 200 | 4 | 384 |
g4-standard-384 |
384 | 1,440 | 12,000 | 2 | 400 | 8 | 768 |
Las siguientes notas se aplican a la tabla anterior:
- Recuento de CPU virtuales: Una CPU virtual se implementa como un solo hipersubproceso de hardware en una de las plataformas de CPU disponibles.
- Ancho de banda de red máximo: El ancho de banda de salida máximo no puede ser superior al número especificado. El ancho de banda de salida real depende de la dirección IP de destino y de otros factores. Para obtener más información sobre el ancho de banda de red, consulta Ancho de banda de red.
- Memoria de GPU: Es la memoria de un dispositivo GPU que se puede usar para el almacenamiento temporal de datos. Es independiente de la memoria de la instancia y está diseñado de forma específica para manejar las demandas más altas de ancho de banda de tus cargas de trabajo de alto contenido gráfico.
Tipos de máquinas G2
Los tipos de máquinas optimizadas para aceleradores G2 tienen GPU NVIDIA L4 conectadas y son ideales para cargas de trabajo de inferencia con costos optimizados, de uso intensivo de gráficos y de computación de alto rendimiento.
Cada tipo de máquina G2 también tiene una memoria predeterminada y un rango de memoria personalizado. El rango de memoria personalizado define la cantidad de memoria que puedes asignar a tu instancia para cada tipo de máquina. También puedes agregar discos SSD locales cuando creas una instancia G2. Para conocer la cantidad de discos que puedes conectar, consulta Tipos de máquinas que requieren que elijas una cantidad de discos SSD locales.
Para obtener las tasas de transferencia de red más altas (50 Gbps o más) aplicadas a la mayoría de las instancias de GPU, te recomendamos que uses una NIC virtual de Google (gVNIC). Si quieres obtener más información para crear instancias de GPU que usen gVNIC, consulta Crea instancias de GPU que usen anchos de banda más altos.
| Tipo de máquina | Recuento de CPU virtuales | Memoria de la instancia predeterminada (GB) | Rango de memoria de la instancia personalizado (GB) | Máximo de SSD local admitido (GiB) | Ancho de banda de red máximo (Gbps) | Recuento de GPU NVIDIA L4 | Memoria de GPU (GB GDDR6) |
|---|---|---|---|---|---|---|---|
g2-standard-4 |
4 | 16 | De 16 a 32 | 375 | 10 | 1 | 24 |
g2-standard-8 |
8 | 32 | De 32 a 54 | 375 | 16 | 1 | 24 |
g2-standard-12 |
12 | 48 | De 48 a 54 | 375 | 16 | 1 | 24 |
g2-standard-16 |
16 | 64 | De 54 a 64 | 375 | 32 | 1 | 24 |
g2-standard-24 |
24 | 96 | De 96 a 108 | 750 | 32 | 2 | 48 |
g2-standard-32 |
32 | 128 | De 96 a 128 | 375 | 32 | 1 | 24 |
g2-standard-48 |
48 | 192 | De 192 a 216 | 1,500 | 50 | 4 | 96 |
g2-standard-96 |
96 | 384 | De 384 a 432 | 3,000 | 100 | 8 | 192 |
Las siguientes notas se aplican a la tabla anterior:
- Recuento de CPU virtuales: Una CPU virtual se implementa como un solo hipersubproceso de hardware en una de las plataformas de CPU disponibles.
- Ancho de banda de red máximo: El ancho de banda de salida máximo no puede ser superior al número especificado. El ancho de banda de salida real depende de la dirección IP de destino y de otros factores. Para obtener más información sobre el ancho de banda de red, consulta Ancho de banda de red.
- Memoria de GPU: Es la memoria de un dispositivo GPU que se puede usar para el almacenamiento temporal de datos. Es independiente de la memoria de la instancia y está diseñado de forma específica para manejar las demandas más altas de ancho de banda de tus cargas de trabajo de alto contenido gráfico.
Tipos de máquinas N1 + GPU
Para las instancias de máquina virtual (VM) de uso general N1 que tienen adjuntas las GPU T4 y V100, puedes obtener un ancho de banda de red máximo de hasta 100 Gbps, según la combinación de la cantidad de GPU y CPU virtuales. Para todas las demás instancias de GPU N1, consulta Descripción general.
Revisa la siguiente sección para calcular el ancho de banda de red máximo disponible para tus instancias T4 y V100 según el modelo de GPU, la vCPU y la cantidad de GPU.
Menos de 5 CPU virtuales
Para las instancias T4 y V100 que tienen 5 CPU virtuales o menos, hay un ancho de banda de red máximo de 10 Gbps.
Más de 5 CPU virtuales
Para las instancias T4 y V100 que tienen más de 5 CPUs virtuales, el ancho de banda máximo de la red se calcula en función de la cantidad de CPUs virtuales y GPUs para esa VM.
Para obtener las tasas de transferencia de red más altas (50 Gbps o más) aplicadas a la mayoría de las instancias de GPU, te recomendamos que uses una NIC virtual de Google (gVNIC). Si quieres obtener más información para crear instancias de GPU que usen gVNIC, consulta Crea instancias de GPU que usen anchos de banda más altos.
| Modelo de GPU | Cantidad de GPU | Cálculo del ancho de banda de red máximo |
|---|---|---|
| NVIDIA V100 | 1 | min(vcpu_count * 2, 32) |
| 2 | min(vcpu_count * 2, 32) |
|
| 4 | min(vcpu_count * 2, 50) |
|
| 8 | min(vcpu_count * 2, 100) |
|
| NVIDIA T4 | 1 | min(vcpu_count * 2, 32) |
| 2 | min(vcpu_count * 2, 50) |
|
| 4 | min(vcpu_count * 2, 100) |
Configuración de MTU y tipos de máquinas de GPU
Para aumentar la capacidad de procesamiento de la red, establece un valor de unidad de transmisión máxima (MTU) más alto para tus redes de VPC. Los valores de MTU más altos aumentan el tamaño del paquete y reducen la sobrecarga del encabezado del paquete, lo que, a su vez, aumenta la capacidad de procesamiento de los datos de carga útil.
Para los tipos de máquinas con GPU, recomendamos la siguiente configuración de MTU para tus redes de VPC.
| Tipo de máquina de GPU | MTU recomendada (en bytes) | |
|---|---|---|
| Red de VPC normal | Red de VPC de RoCE | |
|
8896 | 8896 |
|
8244 | N/A |
|
8896 | N/A |
Cuando configures el valor de la MTU, ten en cuenta lo siguiente:
- 8192 son dos páginas de 4 KB.
- Se recomienda 8244 en las VMs A3 Mega, A3 High y A3 Edge para las NIC de GPU que tienen habilitada la división de encabezados.
- Usa un valor de 8896, a menos que se indique lo contrario en la tabla.
Crea máquinas de GPU con ancho de banda alto
Para crear instancias de GPU que usen anchos de banda de red más altos, usa uno de los siguientes métodos según el tipo de máquina:
Para crear instancias A2, G2 y N1 que usen anchos de banda de red más altos, consulta Usa un ancho de banda de red más alto para las instancias A2, G2 y N1. Para probar o verificar la velocidad del ancho de banda de estas máquinas, puedes usar la prueba de comparativas. Para obtener más información, consulta Verifica el ancho de banda de la red.
Para crear instancias A3 Mega que usen anchos de banda de red más altos, consulta Implementa un clúster A3 Mega Slurm para el entrenamiento de AA. Para probar o verificar la velocidad del ancho de banda de estas máquinas, usa una prueba de comparativas siguiendo los pasos que se indican en Verifica el ancho de banda de la red.
Para las instancias A3 High y A3 Edge que usan anchos de banda de red más altos, consulta Crea una VM A3 con GPUDirect-TCPX habilitado. Para probar o verificar la velocidad del ancho de banda de estas máquinas, puedes usar la prueba de comparativas. Para obtener más información, consulta Verifica el ancho de banda de la red.
Para otros tipos de máquinas optimizadas para aceleradores, no se requiere ninguna acción para usar un ancho de banda de red más alto; la creación de una instancia como se documenta ya usa un ancho de banda de red alto. Para aprender a crear instancias para otros tipos de máquinas optimizados para aceleradores, consulta Crea una VM que tenga GPUs conectadas.
Próximos pasos
- Más información sobre las plataformas de GPU.
- Aprende a crear instancias con GPUs conectadas.
- Aprende a usar un ancho de banda de red más alto.
- Obtén información sobre los precios de GPU.