


Questo documento descrive le funzionalità e le configurazioni della larghezza di banda di rete per le istanze Compute Engine con GPU collegate. Scopri la larghezza di banda di rete massima, le disposizioni delle schede di interfaccia di rete (NIC) e le configurazioni di rete VPC consigliate per vari tipi di macchine GPU, tra cui le serie A4X Max, A4X, A4, A3, A2, G4, G2 e N1. Comprendere queste configurazioni può aiutarti a ottimizzare le prestazioni dei tuoi workload distribuiti su Compute Engine.
Panoramica
La tabella seguente fornisce un confronto generale delle funzionalità di networking tra i tipi di macchine GPU.
| Tipo di macchina | Modello di GPU | Larghezza di banda totale massima | Tecnologia di networking GPU-GPU |
|---|---|---|---|
| A4X Max | Superchip NVIDIA GB300 Ultra | 3600 Gbps | GPUDirect RDMA |
| A4X | Superchip NVIDIA GB200 | 2000 Gbps | GPUDirect RDMA |
| A4 | NVIDIA B200 | 3600 Gbps | GPUDirect RDMA |
| A3 Ultra | NVIDIA H200 | 3600 Gbps | GPUDirect RDMA |
| A3 Mega | NVIDIA H100 da 80 GB | 1800 Gbps | GPUDirect-TCPXO |
| A3 High | NVIDIA H100 da 80 GB | 1000 Gbps | GPUDirect-TCPX |
| A3 Edge | NVIDIA H100 da 80 GB | 600 Gbps | GPUDirect-TCPX |
| G4 | NVIDIA RTX PRO 6000 | 400 Gbps | N/D |
| A2 Standard e A2 Ultra | NVIDIA A100 da 40 GB, NVIDIA A100 da 80 GB | 100 Gbps | N/D |
| G2 | NVIDIA L4 | 100 Gbps | N/D |
| N1 | NVIDIA T4, NVIDIA V100 | 100 Gbps | N/D |
| N1 | NVIDIA P4 | 32 Gbps | N/D |
Funzioni GPUDirect RDMA e MRDMA
Su alcuni tipi di macchine ottimizzate per l'acceleratore, Google Cloud utilizza MRDMA come implementazione dell'interfaccia di rete per il networking GPU-GPU che supporta GPUDirect RDMA.
GPUDirect RDMA è una tecnologia NVIDIA che consente a una scheda di interfaccia di rete (NIC) di accedere direttamente alla memoria della GPU tramite PCIe, bypassando la CPU host e la memoria di sistema. Questa comunicazione peer-to-peer tra NIC e GPU riduce notevolmente la latenza per la comunicazione tra GPU tra nodi.
MRDMA è l'implementazione dell'interfaccia di rete utilizzata sui tipi di macchine A4X Max, A4X, A4 e A3 Ultra per fornire funzionalità GPUDirect RDMA. MRDMA si basa su NIC NVIDIA ConnectX e viene implementato in uno dei seguenti modi:
- Funzioni virtuali (VF) MRDMA: utilizzate nelle serie A3 Ultra, A4 e A4X.
- Funzioni fisiche (PF) MRDMA: utilizzate nella serie A4X Max.
Funzioni MRDMA e strumenti di monitoraggio della rete
I tipi di macchine A4X, A4 e A3 Ultra implementano il networking GPU-GPU ad alte prestazioni utilizzando le funzioni virtuali (VF) MRDMA. Poiché si tratta di entità virtualizzate, alcune funzionalità di monitoraggio a livello di hardware sono limitate rispetto alle funzioni fisiche (PF).
Con le VF MRDMA, i contatori delle porte fisiche standard (come quelli che terminano con _phy) vengono visualizzati nell'output ethtool -S, ma non vengono aggiornati durante l'attività di rete. Questa è una caratteristica dell'architettura VF MRDMA. Per monitorare con precisione le prestazioni della rete su queste interfacce, esamina le voci della tabella dei contatori vPort anziché della tabella dei contatori delle porte fisiche.
Il tipo di macchina A4X Max utilizza le PF MRDMA. A differenza dei tipi di macchine basate su VF MRDMA, A4X Max supporta l'intera gamma di contatori delle porte fisiche per il networking GPU.
Esamina i concetti di networking per i tipi di macchine GPU
Utilizza la sezione seguente per esaminare la disposizione della rete e la velocità della larghezza di banda per ciascun tipo di macchina GPU.
Tipi di macchine A4X Max e A4X
Le serie di macchine A4X Max e A4X, entrambe basate sull'architettura NVIDIA Blackwell, sono progettate per workload di AI distribuiti, su larga scala e impegnativi. La differenza principale tra i due tipi di macchine è rappresentata dagli acceleratori e dall'hardware di networking collegati, come descritto nella tabella seguente:
| Serie di macchine A4X Max | Serie di macchine A4X | |
|---|---|---|
| Hardware collegato | Superchip NVIDIA GB300 Ultra | Superchip NVIDIA GB200 |
| Networking GPU-GPU | 4 SuperNIC NVIDIA ConnectX-8 (CX-8) che forniscono una larghezza di banda di 3200 Gbps in una topologia con allineamento ai rail a 8 vie | 4 NIC NVIDIA ConnectX-7 (CX-7) che forniscono una larghezza di banda di 1600 Gbps in una topologia con allineamento ai rail a 4 vie |
| Implementazione del networking GPU-GPU | 8 funzioni fisiche (PF) MRDMA configurate come 2 PF per NIC | 4 funzioni virtuali (VF) MRDMA configurate come 1 VF per NIC |
| Networking per uso generico | 2 NIC Titanium intelligenti che forniscono una larghezza di banda di 400 Gbps | 2 NIC Titanium intelligenti che forniscono una larghezza di banda di 400 Gbps |
| Larghezza di banda di rete massima totale | 3600 Gbps | 2000 Gbps |
Architettura di networking multilivello
Le istanze di computing A4X Max e A4X utilizzano un'architettura di networking gerarchica multilivello con un design con allineamento ai rail per ottimizzare le prestazioni per vari tipi di comunicazione. In questa topologia, le istanze si connettono su più piani di rete indipendenti, chiamati rail.
- Le istanze A4X Max utilizzano una topologia con allineamento ai rail a 8 vie in cui ciascuna delle quattro NIC ConnectX-8 da 800 Gbps si connette a due rail separati da 400 Gbps.
- Le istanze A4X utilizzano una topologia con allineamento ai rail a 4 vie in cui ciascuna delle quattro NIC ConnectX-7 si connette a un rail separato.
I livelli di networking per questi tipi di macchine sono i seguenti:
Comunicazione intra-nodo e intra-sub-blocco (NVLink): un fabric NVLink ad alta velocità interconnette le GPU per una comunicazione a larghezza di banda elevata e bassa latenza. Questo fabric connette tutte le GPU all'interno di una singola istanza e si estende su un blocco secondario, composto da 18 istanze A4X Max o A4X (per un totale di 72 GPU). In questo modo, tutte le 72 GPU di un blocco secondario possono comunicare come se si trovassero in un unico server GPU su larga scala.
Comunicazione tra sottoblocchi (NIC ConnectX con RoCE): per scalare i workload oltre un singolo sottoblocco, queste macchine utilizzano NIC NVIDIA ConnectX. Queste NIC utilizzano RDMA over Converged Ethernet (RoCE) per fornire comunicazioni a larghezza di banda elevata e bassa latenza tra i blocchi secondari, in modo da consentirti di creare cluster di addestramento su larga scala con migliaia di GPU.
Networking per uso generico (Titanium Smart NIC): oltre alle reti GPU specializzate, ogni istanza dispone di due Titanium Smart NIC, che forniscono una larghezza di banda combinata di 400 Gbps per le attività di networking generali. Ciò include il traffico per l'archiviazione, la gestione e la connessione ad altri servizi Google Cloud o alla rete internet pubblica.
Architettura A4X Max
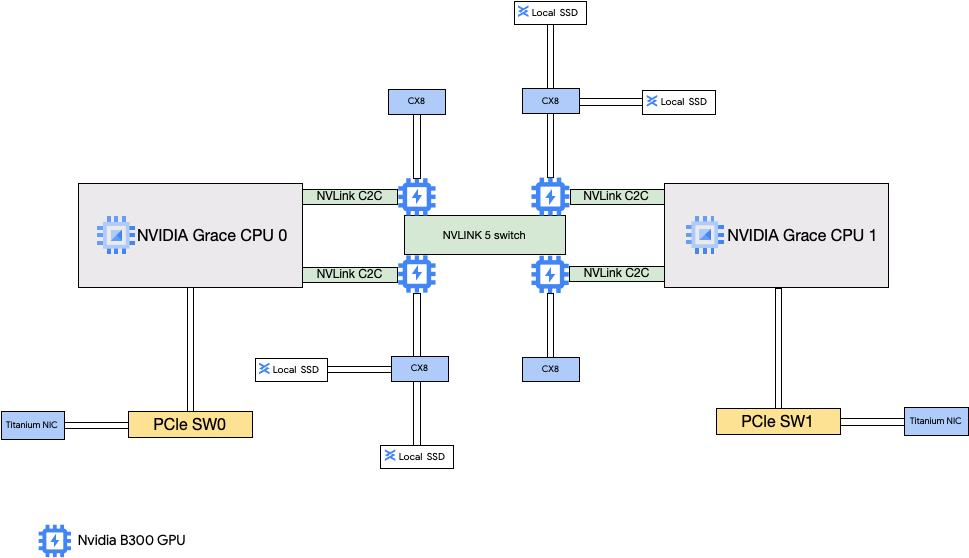
L'architettura A4X Max è basata su superchip NVIDIA GB300 Ultra. Una caratteristica chiave di questo design è la connessione diretta delle quattro SuperNIC NVIDIA ConnectX-8 (CX-8) da 800 Gbps alle GPU. Ogni ConnectX-8 è una NIC a doppia porta, esposta all'istanza come due funzioni fisiche (PF). Queste NIC fanno parte di una Network Topology con allineamento ai rail a 8 vie in cui ogni NIC si connette a due rail separati da 400 Gbps. Questo percorso diretto abilita l'RDMA, fornendo una larghezza di banda elevata e una bassa latenza per la comunicazione da GPU a GPU tra diversi blocchi secondari. Queste istanze di Compute Engine includono anche SSD locali ad alte prestazioni collegati alle NIC ConnectX-8, bypassando il bus PCIe per un accesso ai dati più rapido.
Architettura A4X
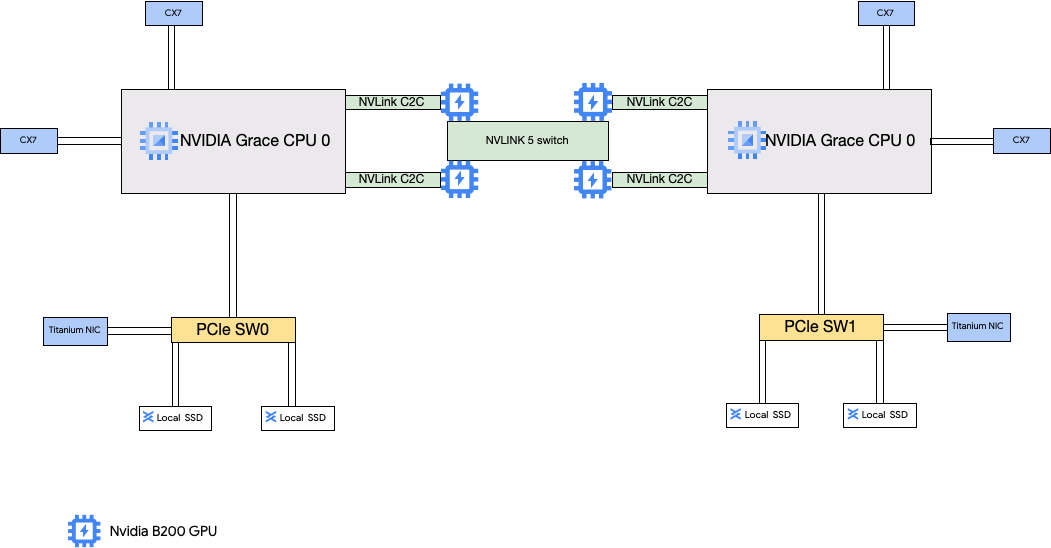
L'architettura A4X utilizza i superchip NVIDIA GB200. In questa configurazione, le quattro NIC NVIDIA ConnectX-7 (CX-7) sono connesse alla CPU host. Questa configurazione fornisce un networking ad alte prestazioni per la comunicazione da GPU a GPU tra i blocchi secondari.
Configurazione della rete Virtual Private Cloud (VPC) di A4X Max e A4X
Per utilizzare tutte le funzionalità di networking di questi tipi di macchine, devi creare e collegare reti VPC alle tue istanze. Per utilizzare tutte le NIC disponibili, devi creare reti VPC nel seguente modo:
Due reti VPC standard per le Smart NIC Titanium.
- Per A4X Max, queste reti VPC utilizzano il driver del dispositivo LAN PF IDPF di Intel.
- Per A4X, queste reti VPC utilizzano l'interfaccia di rete Google Virtual NIC (gVNIC).
È necessaria una rete VPC con il profilo di rete RoCE per le NIC ConnectX quando crei cluster di più blocchi secondari A4X Max o A4X. La rete VPC RoCE deve avere una subnet per ogni rail di rete. Ciò significa otto subnet per le istanze A4X Max e quattro subnet per le istanze A4X. Se utilizzi un singolo blocco secondario, puoi omettere questa rete VPC perché l'interconnessione NVLink multi-nodo gestisce la comunicazione diretta tra GPU.
Per configurare queste reti, consulta Crea reti VPC nella documentazione di AI Hypercomputer.
Tipi di macchine A4X Max e A4X
A4X Max
| Tipo di macchina | Numero di vCPU | Memoria istanza (GB) | SSD locale collegato (GiB) | Numero di NIC fisiche | Larghezza di banda massima della rete (Gbps) | Numero di GPU NVIDIA GB300 | Memoria GPU (GB HBM3e) |
|---|---|---|---|---|---|---|---|
a4x-maxgpu-4g-metal |
144 | 960 | 12.000 | 6 | 3600 | 4 | 1116 |
Le seguenti note si applicano alla tabella precedente:
- Conteggio vCPU: una vCPU viene implementata come un singolo hyperthread hardware su una delle piattaforme CPU disponibili.
- Larghezza di banda di rete massima: la larghezza di banda in uscita massima non può superare il numero specificato. La larghezza di banda in uscita effettiva dipende dall'indirizzo IP di destinazione e da altri fattori. Per saperne di più sulla larghezza di banda della rete, consulta Larghezza di banda della rete.
- Memoria GPU: la memoria GPU è la memoria di un dispositivo GPU che può essere utilizzata per l'archiviazione temporanea dei dati. È separata dalla memoria dell'istanza ed è progettata specificamente per gestire le richieste di larghezza di banda più elevate dei workload ad alta intensità grafica.
A4X
| Tipo di macchina | Numero di vCPU | Memoria istanza (GB) | SSD locale collegato (GiB) | Numero di NIC fisiche | Larghezza di banda massima della rete (Gbps) | Numero di GPU NVIDIA GB200 | Memoria GPU (GB HBM3e) |
|---|---|---|---|---|---|---|---|
a4x-highgpu-4g |
140 | 884 | 12.000 | 6 | 2000 | 4 | 744 |
Le seguenti note si applicano alla tabella precedente:
- Conteggio vCPU: una vCPU viene implementata come un singolo hyperthread hardware su una delle piattaforme CPU disponibili.
- Larghezza di banda di rete massima: la larghezza di banda in uscita massima non può superare il numero specificato. La larghezza di banda in uscita effettiva dipende dall'indirizzo IP di destinazione e da altri fattori. Per saperne di più sulla larghezza di banda della rete, consulta Larghezza di banda della rete.
- Memoria GPU: la memoria GPU è la memoria di un dispositivo GPU che può essere utilizzata per l'archiviazione temporanea dei dati. È separata dalla memoria dell'istanza ed è progettata specificamente per gestire le richieste di larghezza di banda più elevate dei workload ad alta intensità grafica.
Tipi di macchine A4 e A3 Ultra
I tipi di macchine A4 sono collegate a GPU NVIDIA B200 e i tipi di macchina A3 Ultra sono collegate a GPU NVIDIA H200.
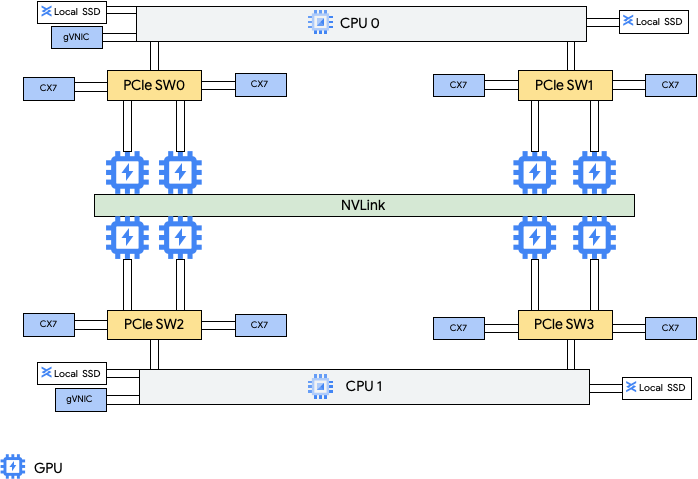
Questi tipi di macchine forniscono otto schede di interfaccia di rete (NIC) NVIDIA ConnectX-7 (CX-7) e due NIC virtuali di Google (gVNIC). Le otto NIC CX-7 offrono una larghezza di banda di rete totale di 3200 Gbps. Queste NIC sono dedicate solo alle comunicazioni tra GPU con elevata larghezza di banda e non possono essere utilizzate per altre esigenze di networking, come l'accesso a internet pubblico. Come illustrato nel seguente diagramma, ogni NIC CX-7 è allineata a una GPU per ottimizzare l'accesso alla memoria non uniforme (NUMA). Tutte e otto le GPU possono comunicare rapidamente tra loro utilizzando il bridge NVLink all to all che le connette. Le altre due schede di interfaccia di rete gVNIC sono NIC intelligenti che forniscono altri 400 Gbps di larghezza di banda di rete per i requisiti di rete per uso generico. Quando usate in combinazione, le schede di interfaccia di rete forniscono a queste macchine 3600 Gbps di larghezza di banda di rete totale massima.
Il networking GPU-GPU ad alte prestazioni sulle istanze A4 e A3 Ultra viene implementato utilizzando le funzioni virtuali (VF) MRDMA per ciascuna delle otto NIC ConnectX-7.
Per utilizzare queste NIC multiple, devi creare tre reti Virtual Private Cloud nel modo seguente:
- Due reti VPC normali: ogni gVNIC deve essere collegata a una rete VPC diversa
- Una rete VPC RoCE: tutte le otto NIC CX-7 condividono la stessa rete VPC RoCE
Per configurare queste reti, consulta Crea reti VPC nella documentazione di AI Hypercomputer.
A4
| Tipo di macchina | Numero di vCPU | Memoria istanza (GB) | SSD locale collegato (GiB) | Numero di NIC fisiche | Larghezza di banda massima della rete (Gbps) | Numero di GPU NVIDIA B200 Blackwell | Memoria GPU (GB HBM3e) |
|---|---|---|---|---|---|---|---|
a4-highgpu-8g |
224 | 3968 | 12.000 | 10 | 3600 | 8 | 1440 |
Le seguenti note si applicano alla tabella precedente:
- Conteggio vCPU: una vCPU viene implementata come un singolo hyperthread hardware su una delle piattaforme CPU disponibili.
- Larghezza di banda di rete massima: la larghezza di banda in uscita massima non può superare il numero specificato. La larghezza di banda in uscita effettiva dipende dall'indirizzo IP di destinazione e da altri fattori. Per saperne di più sulla larghezza di banda della rete, consulta Larghezza di banda della rete.
- Memoria GPU: la memoria GPU è la memoria di un dispositivo GPU che può essere utilizzata per l'archiviazione temporanea dei dati. È separata dalla memoria dell'istanza ed è progettata specificamente per gestire le richieste di larghezza di banda più elevate dei workload ad alta intensità grafica.
A3 Ultra
| Tipo di macchina | Numero di vCPU | Memoria istanza (GB) | SSD locale collegato (GiB) | Numero di NIC fisiche | Larghezza di banda massima della rete (Gbps) | Numero di GPU NVIDIA H200 | Memoria GPU (GB HBM3e) |
|---|---|---|---|---|---|---|---|
a3-ultragpu-8g |
224 | 2952 | 12.000 | 10 | 3600 | 8 | 1128 |
Le seguenti note si applicano alla tabella precedente:
- Conteggio vCPU: una vCPU viene implementata come un singolo hyperthread hardware su una delle piattaforme CPU disponibili.
- Larghezza di banda di rete massima: la larghezza di banda in uscita massima non può superare il numero specificato. La larghezza di banda in uscita effettiva dipende dall'indirizzo IP di destinazione e da altri fattori. Per saperne di più sulla larghezza di banda della rete, consulta Larghezza di banda della rete.
- Memoria GPU: la memoria GPU è la memoria di un dispositivo GPU che può essere utilizzata per l'archiviazione temporanea dei dati. È separata dalla memoria dell'istanza ed è progettata specificamente per gestire le richieste di larghezza di banda più elevate dei workload ad alta intensità grafica.
Tipi di macchine A3 Mega, High ed Edge
A questi tipi di macchine sono collegate GPU H100. Ciascuno di questi tipi di macchine ha un numero fisso di GPU, vCPU e dimensioni fisse della memoria.
- VM A3 con una sola NIC: per le VM A3 che hanno da 1 a 4 GPU collegate, è disponibile solo una singola scheda di interfaccia di rete (NIC) fisica.
- VM A3 multi-NIC: per le VM A3 con 8 GPU collegate,
sono disponibili più NIC fisiche. Per questi tipi di macchine A3, le NIC sono disposte come segue su
un bus Peripheral Component Interconnect Express (PCIe):
- Per il tipo di macchina A3 Mega: è disponibile una disposizione di NIC 8+1. Con questa disposizione, 8 NIC condividono lo stesso bus PCIe e 1 NIC si trova su un bus PCIe separato.
- Per il tipo di macchina A3 High: è disponibile una disposizione di NIC 4+1. Con questa disposizione, 4 NIC condividono lo stesso bus PCIe e 1 NIC si trova su un bus PCIe separato.
- Per il tipo di macchina A3 Edge: è disponibile una disposizione di NIC 4+1. Con questa disposizione, 4 NIC condividono lo stesso bus PCIe e 1 NIC si trova su un bus PCIe separato. Queste 5 NIC forniscono una larghezza di banda di rete totale di 400 Gbps per ogni VM.
Le NIC che condividono lo stesso bus PCIe hanno un allineamento NUMA (accesso alla memoria non uniforme) di una NIC ogni due GPU NVIDIA H100. Queste NIC sono ideali per la comunicazione da GPU a GPU dedicata a larghezza di banda elevata. La scheda NIC fisica che si trova su un bus PCIe separato è ideale per altre esigenze di rete. Per istruzioni su come configurare la rete per le VM A3 High e A3 Edge, consulta Configura le reti MTU con frame jumbo.
A3 Mega
| Tipo di macchina | Numero di vCPU | Memoria istanza (GB) | SSD locale collegato (GiB) | Numero di NIC fisiche | Larghezza di banda massima della rete (Gbps) | Numero di GPU NVIDIA H100 | Memoria GPU (GB HBM3) |
|---|---|---|---|---|---|---|---|
a3-megagpu-8g |
208 | 1872 | 6000 | 9 | 1800 | 8 | 640 |
A3 High
| Tipo di macchina | Numero di vCPU | Memoria istanza (GB) | SSD locale collegato (GiB) | Numero di NIC fisiche | Larghezza di banda massima della rete (Gbps) | Numero di GPU NVIDIA H100 | Memoria GPU (GB HBM3) |
|---|---|---|---|---|---|---|---|
a3-highgpu-1g |
26 | 234 | 750 | 1 | 25 | 1 | 80 |
a3-highgpu-2g |
52 | 468 | 1500 | 1 | 50 | 2 | 160 |
a3-highgpu-4g |
104 | 936 | 3000 | 1 | 100 | 4 | 320 |
a3-highgpu-8g |
208 | 1872 | 6000 | 5 | 1000 | 8 | 640 |
A3 Edge
| Tipo di macchina | Numero di vCPU | Memoria istanza (GB) | SSD locale collegato (GiB) | Numero di NIC fisiche | Larghezza di banda massima della rete (Gbps) | Numero di GPU NVIDIA H100 | Memoria GPU (GB HBM3) |
|---|---|---|---|---|---|---|---|
a3-edgegpu-8g |
208 | 1872 | 6000 | 5 | 600 (asia-south1 e northamerica-northeast2) o 400 (tutte le altre regioni A3 Edge) |
8 | 640 |
Le seguenti note si applicano alla tabella precedente:
- Conteggio vCPU: una vCPU viene implementata come un singolo hyperthread hardware su una delle piattaforme CPU disponibili.
- Larghezza di banda di rete massima: la larghezza di banda in uscita massima non può superare il numero specificato. La larghezza di banda in uscita effettiva dipende dall'indirizzo IP di destinazione e da altri fattori. Per saperne di più sulla larghezza di banda della rete, consulta Larghezza di banda della rete.
- Memoria GPU: la memoria GPU è la memoria di un dispositivo GPU che può essere utilizzata per l'archiviazione temporanea dei dati. È separata dalla memoria dell'istanza ed è progettata specificamente per gestire le richieste di larghezza di banda più elevate dei workload ad alta intensità grafica.
Tipi di macchine A2
A ogni tipo di macchina A2 è collegato un numero fisso di GPU NVIDIA A100 da 40 GB o NVIDIA A100 da 80 GB. Ogni tipo di macchina ha anche un conteggio di vCPU e una dimensione della memoria fissi.
Le serie di macchine A2 sono disponibili in due tipi:
- A2 Ultra: a questi tipi di macchine sono collegate GPU A100 da 80 GB e dischi SSD locali.
- A2 Standard: a questi tipi di macchine sono collegate GPU A100 da 40 GB.
A2 Ultra
| Tipo di macchina | Numero di vCPU | Memoria istanza (GB) | SSD locale collegato (GiB) | Larghezza di banda massima della rete (Gbps) | Numero di GPU NVIDIA A100 80 GB | Memoria GPU (GB HBM2e) |
|---|---|---|---|---|---|---|
a2-ultragpu-1g |
12 | 170 | 375 | 24 | 1 | 80 |
a2-ultragpu-2g |
24 | 340 | 750 | 32 | 2 | 160 |
a2-ultragpu-4g |
48 | 680 | 1500 | 50 | 4 | 320 |
a2-ultragpu-8g |
96 | 1360 | 3000 | 100 | 8 | 640 |
A2 Standard
| Tipo di macchina | Numero di vCPU | Memoria istanza (GB) | SSD locale supportato | Larghezza di banda massima della rete (Gbps) | Numero di GPU NVIDIA A100 40 GB | Memoria GPU (GB HBM2) |
|---|---|---|---|---|---|---|
a2-highgpu-1g |
12 | 85 | Sì | 24 | 1 | 40 |
a2-highgpu-2g |
24 | 170 | Sì | 32 | 2 | 80 |
a2-highgpu-4g |
48 | 340 | Sì | 50 | 4 | 160 |
a2-highgpu-8g |
96 | 680 | Sì | 100 | 8 | 320 |
a2-megagpu-16g |
96 | 1360 | Sì | 100 | 16 | 640 |
Le seguenti note si applicano alla tabella precedente:
- Conteggio vCPU: una vCPU viene implementata come un singolo hyperthread hardware su una delle piattaforme CPU disponibili.
- Larghezza di banda di rete massima: la larghezza di banda in uscita massima non può superare il numero specificato. La larghezza di banda in uscita effettiva dipende dall'indirizzo IP di destinazione e da altri fattori. Per saperne di più sulla larghezza di banda della rete, consulta Larghezza di banda della rete.
- Memoria GPU: la memoria GPU è la memoria di un dispositivo GPU che può essere utilizzata per l'archiviazione temporanea dei dati. È separata dalla memoria dell'istanza ed è progettata specificamente per gestire le richieste di larghezza di banda più elevate dei workload ad alta intensità grafica.
Tipi di macchine G4
I tipi di macchine G4 ottimizzate per l'acceleratore utilizzano
GPU NVIDIA RTX PRO 6000 Blackwell Server Edition (nvidia-rtx-pro-6000) e sono adatti per workload di simulazione NVIDIA Omniverse, applicazioni ad alta intensità di grafica, transcodifica video e desktop virtuali. I tipi di macchina G4 forniscono anche una soluzione a basso costo per eseguire l'inferenza su un singolo host e l'ottimizzazione del modello rispetto ai tipi di macchina della serie A.
Puoi anche aggiungere dischi SSD Titanium quando crei un'istanza G4. Per il numero di dischi che puoi collegare, consulta Tipi di macchine per cui devi scegliere un numero di dischi SSD locali. Per informazioni sulle limitazioni dei tipo di macchina, consulta Limitazioni di G4.
| Tipo di macchina | Numero di vCPU | Memoria istanza (GB) | SSD Titanium massimo supportato (GiB) | Numero di NIC fisiche | Larghezza di banda massima della rete (Gbps) | Numero di GPU NVIDIA RTX PRO 6000 | Memoria GPU (GB GDDR7) |
|---|---|---|---|---|---|---|---|
g4-standard-6 |
6 | 22 | 0 | 1 | 20 | 1/8 | 12 |
g4-standard-12 |
12 | 45 | 375 | 1 | 20 | 1/4 | 24 |
g4-standard-24 |
24 | 90 | 750 | 1 | 20 | 1/2 | 48 |
g4-standard-48 |
48 | 180 | 1500 | 1 | 50 | 1 | 96 |
g4-standard-96 |
96 | 360 | 3000 | 1 | 100 | 2 | 192 |
g4-standard-192 |
192 | 720 | 6000 | 1 | 200 | 4 | 384 |
g4-standard-384 |
384 | 1440 | 12.000 | 2 | 400 | 8 | 768 |
Le seguenti note si applicano alla tabella precedente:
- Conteggio vCPU: una vCPU viene implementata come un singolo hyperthread hardware su una delle piattaforme CPU disponibili.
- Larghezza di banda di rete massima: la larghezza di banda in uscita massima non può superare il numero specificato. La larghezza di banda in uscita effettiva dipende dall'indirizzo IP di destinazione e da altri fattori. Per saperne di più sulla larghezza di banda della rete, consulta Larghezza di banda della rete.
- Memoria GPU: la memoria GPU è la memoria di un dispositivo GPU che può essere utilizzata per l'archiviazione temporanea dei dati. È separata dalla memoria dell'istanza ed è progettata specificamente per gestire le richieste di larghezza di banda più elevate dei workload ad alta intensità grafica.
Tipi di macchine G2
I tipi di macchina G2 ottimizzati per l'acceleratore hanno GPU NVIDIA L4 collegate e sono ideali per workload di inferenza ottimizzati in termini di costi, ad alta intensità di grafica e computing ad alte prestazioni.
Ogni tipo di macchina G2 ha anche una memoria predefinita e un intervallo di memoria personalizzato. L'intervallo di memoria personalizzato definisce la quantità di memoria che puoi allocare all'istanza per ogni tipo di macchina. Puoi anche aggiungere dischi SSD locali quando crei un'istanza G2. Per il numero di dischi che puoi collegare, consulta Tipi di macchine per cui devi scegliere un numero di dischi SSD locali.
Per applicare larghezze di banda di rete più elevate (da 50 Gbps o superiori) alla maggior parte delle istanze di GPU, ti consigliamo di utilizzare la NIC virtuale Google (gVNIC). Per ulteriori informazioni sulla creazione di istanze di GPU che utilizzano gVNIC, consulta Creazione di istanze di GPU che utilizzano larghezze di banda più elevate.
| Tipo di macchina | Numero di vCPU | Memoria istanza predefinita (GB) | Intervallo di memoria dell'istanza personalizzata (GB) | SSD locale massimo supportato (GiB) | Larghezza di banda massima della rete (Gbps) | Numero di GPU NVIDIA L4 | Memoria GPU (GB GDDR6) |
|---|---|---|---|---|---|---|---|
g2-standard-4 |
4 | 16 | 16-32 | 375 | 10 | 1 | 24 |
g2-standard-8 |
8 | 32 | 32-54 | 375 | 16 | 1 | 24 |
g2-standard-12 |
12 | 48 | 48-54 | 375 | 16 | 1 | 24 |
g2-standard-16 |
16 | 64 | 54-64 | 375 | 32 | 1 | 24 |
g2-standard-24 |
24 | 96 | 96-108 | 750 | 32 | 2 | 48 |
g2-standard-32 |
32 | 128 | 96-128 | 375 | 32 | 1 | 24 |
g2-standard-48 |
48 | 192 | 192-216 | 1500 | 50 | 4 | 96 |
g2-standard-96 |
96 | 384 | 384-432 | 3000 | 100 | 8 | 192 |
Le seguenti note si applicano alla tabella precedente:
- Conteggio vCPU: una vCPU viene implementata come un singolo hyperthread hardware su una delle piattaforme CPU disponibili.
- Larghezza di banda di rete massima: la larghezza di banda in uscita massima non può superare il numero specificato. La larghezza di banda in uscita effettiva dipende dall'indirizzo IP di destinazione e da altri fattori. Per saperne di più sulla larghezza di banda della rete, consulta Larghezza di banda della rete.
- Memoria GPU: la memoria GPU è la memoria di un dispositivo GPU che può essere utilizzata per l'archiviazione temporanea dei dati. È separata dalla memoria dell'istanza ed è progettata specificamente per gestire le richieste di larghezza di banda più elevate dei workload ad alta intensità grafica.
Tipi di macchine N1 + GPU
Per le istanze di macchine virtuali (VM) N1 per uso generico a cui sono state collegate GPU T4 e V100, puoi ottenere una larghezza di banda di rete massima fino a 100 Gbps, in base al conteggio combinato di GPU e vCPU. Per tutte le altre istanze di GPU N1, consulta la Panoramica.
Consulta la sezione seguente per calcolare la larghezza di banda di rete massima disponibile per le istanze T4 e V100 in base al modello di GPU, al numero di vCPU e di GPU.
Meno di 5 vCPU
Le istanze T4 e V100 con al massimo 5 vCPU hanno a disposizione una larghezza di banda di rete massima di 10 Gbps.
Più di 5 vCPU
Per le istanze T4 e V100 con più di 5 vCPU, la larghezza di banda di rete massima viene calcolata in base al numero di vCPU e GPU per la VM.
Per applicare larghezze di banda di rete più elevate (da 50 Gbps o superiori) alla maggior parte delle istanze di GPU, ti consigliamo di utilizzare la NIC virtuale Google (gVNIC). Per ulteriori informazioni sulla creazione di istanze di GPU che utilizzano gVNIC, consulta Creazione di istanze di GPU che utilizzano larghezze di banda più elevate.
| Modello di GPU | Numero di GPU | Calcolo della larghezza di banda di rete massima |
|---|---|---|
| NVIDIA V100 | 1 | min(vcpu_count * 2, 32) |
| 2 | min(vcpu_count * 2, 32) |
|
| 4 | min(vcpu_count * 2, 50) |
|
| 8 | min(vcpu_count * 2, 100) |
|
| NVIDIA T4 | 1 | min(vcpu_count * 2, 32) |
| 2 | min(vcpu_count * 2, 50) |
|
| 4 | min(vcpu_count * 2, 100) |
Impostazioni MTU e tipi di macchine GPU
Per aumentare il throughput di rete, imposta un valore più elevato per l'unità massima di trasmissione (MTU) per le tue reti VPC. Valori MTU più elevati aumentano le dimensioni dei pacchetti e riducono l'overhead delle intestazioni dei pacchetti, il che a sua volta aumenta il throughput dei dati del payload.
Per i tipi di macchine GPU, consigliamo le seguenti impostazioni MTU per le reti VPC.
| Tipo di macchina GPU | MTU consigliata (in byte) | |
|---|---|---|
| Rete VPC normale | Rete VPC RoCE | |
|
8896 | 8896 |
|
8244 | N/D |
|
8896 | N/D |
Quando imposti il valore MTU, tieni presente quanto segue:
- 8192 corrisponde a due pagine da 4 KB.
- 8244 è consigliato nelle VM A3 Mega, A3 High e A3 Edge per le NIC GPU con suddivisione delle intestazioni abilitata.
- Utilizza un valore pari a 8896, se non diversamente indicato nella tabella.
Crea macchine GPU a larghezza di banda elevata
Per creare istanze di GPU che utilizzano larghezze di banda di rete più elevate, utilizza uno dei seguenti metodi in base al tipo di macchina:
Per creare istanze A2, G2 e N1 che utilizzano larghezze di banda di rete più elevate, consulta Utilizza una larghezza di banda di rete più elevata per le istanze A2, G2 e N1. Per testare o verificare la velocità della larghezza di banda delle macchine, puoi utilizzare il test di benchmarking. Per ulteriori informazioni, consulta la sezione Verifica della larghezza di banda di rete.
Per creare istanze A3 Mega che utilizzano larghezze di banda di rete più elevate, consulta Esegui il deployment di un cluster Slurm A3 Mega per l'addestramento ML. Per testare o verificare la velocità della larghezza di banda delle macchine, utilizza un test di benchmarking seguendo i passaggi descritti in Controllo della larghezza di banda della rete
Per le istanze A3 High e A3 Edge che utilizzano larghezze di banda della rete più elevate, consulta Crea una VM A3 con GPUDirect-TCPX abilitato. Per testare o verificare la velocità della larghezza di banda delle macchine, puoi utilizzare il test di benchmarking. Per ulteriori informazioni, consulta la sezione Verifica della larghezza di banda di rete.
Per gli altri tipi di macchine ottimizzate per l'acceleratore, non è richiesta alcuna azione per utilizzare una larghezza di banda di rete più elevata; la creazione di un'istanza come descritto nella documentazione ne utilizza già una elevata. Per scoprire come creare istanze per altri tipi di macchine ottimizzate per l'acceleratore, consulta Crea una VM con GPU collegate.
Passaggi successivi
- Scopri di più sulle piattaforme GPU.
- Scopri come creare istanze con GPU collegate.
- Scopri di più su come utilizzare una larghezza di banda di rete più elevata.
- Scopri di più sui prezzi delle GPU.