


このドキュメントでは、検索拡張生成(RAG)対応の生成 AI アプリケーションを実行するインフラストラクチャの設計に使用できるリファレンス アーキテクチャについて説明します。このドキュメントは、生成 AI アプリケーションのデベロッパーと管理者、Cloud Architect を対象としています。このドキュメントは、AI、ML、大規模言語モデル(LLM)のコンセプトに関する基本的な知識があることを前提としています。このドキュメントでは、生成 AI アプリケーションの設計と開発の方法については説明しません。
アーキテクチャ
次の図は、 Google Cloudでの RAG 対応の生成 AI アプリケーションのアーキテクチャの概要を示しています。

このアーキテクチャは、相互に接続されている次のコンポーネントから構成されています。
- データの取り込みサブシステム
- データの取り込みサブシステムは、RAG 機能で利用する外部データを準備して処理します。データベース レイヤを介してアーキテクチャ内の他のサブシステムと連携しています。
- サービング サブシステム
- サービング サブシステムは、生成 AI アプリケーションとユーザー間のリクエスト / レスポンス フローを処理します。データベース レイヤを介してデータ取り込みサブシステムと連携します。
- 品質評価サブシステム
- 品質評価サブシステムは、サービング サブシステムが生成したレスポンスの品質を評価します。サービング サブシステムと直接やり取りし、データベース レイヤを介してデータの取り込みサブシステムと連携しています。
- データベース
アーキテクチャ内のすべてのサブシステムがデータベースと連携しています。データベースには次のデータが保存されます。
- プロンプト
- RAG で使用されるデータのベクトル エンベディング
- データ取り込みサブシステムと品質評価サブシステムのサーバーレス関数の構成
次の図は、アーキテクチャの詳細を示しています。
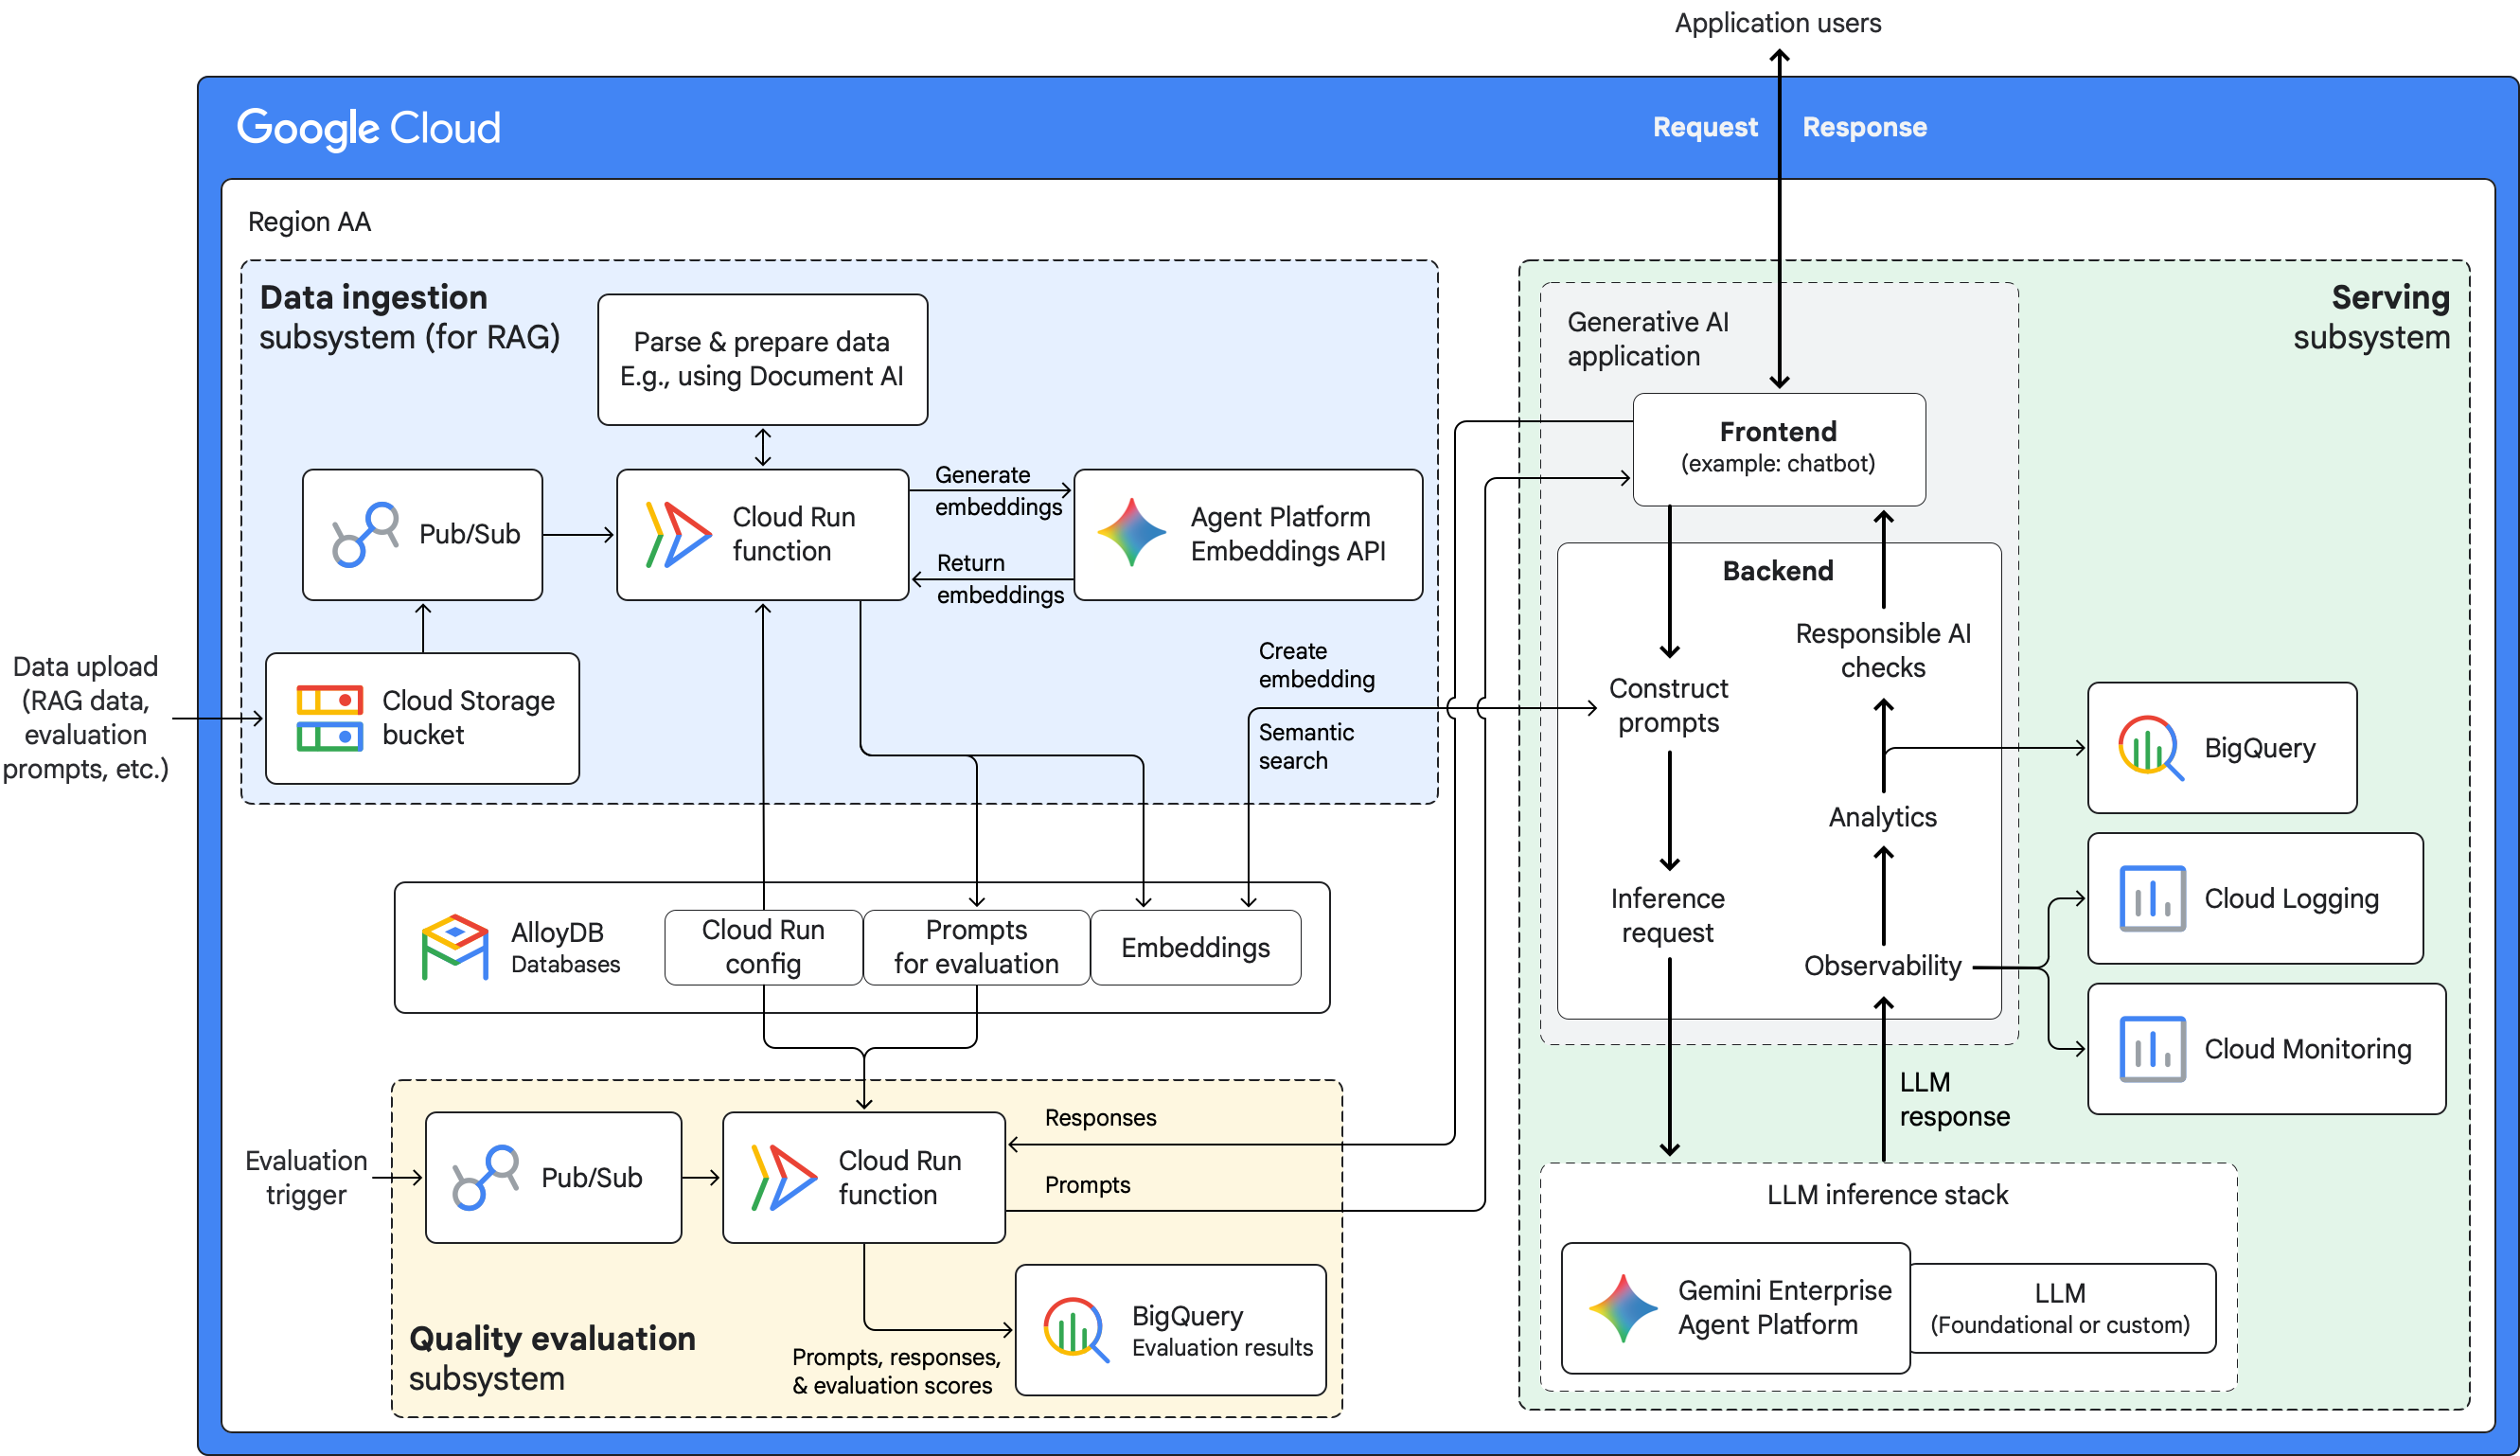
以降のセクションでは、アーキテクチャの各サブシステム内のコンポーネントとデータフローについて詳しく説明します。
データの取り込みサブシステム
データ取り込みサブシステムは、ファイル、データベース、ストリーミング サービスなどの外部ソースからデータを取り込みます。アップロードされたデータには品質評価のプロンプトが含まれています。データの取り込みサブシステムは、アーキテクチャに RAG 機能を提供します。次の図は、このアーキテクチャのデータ取り込みサブシステムの詳細を示しています。
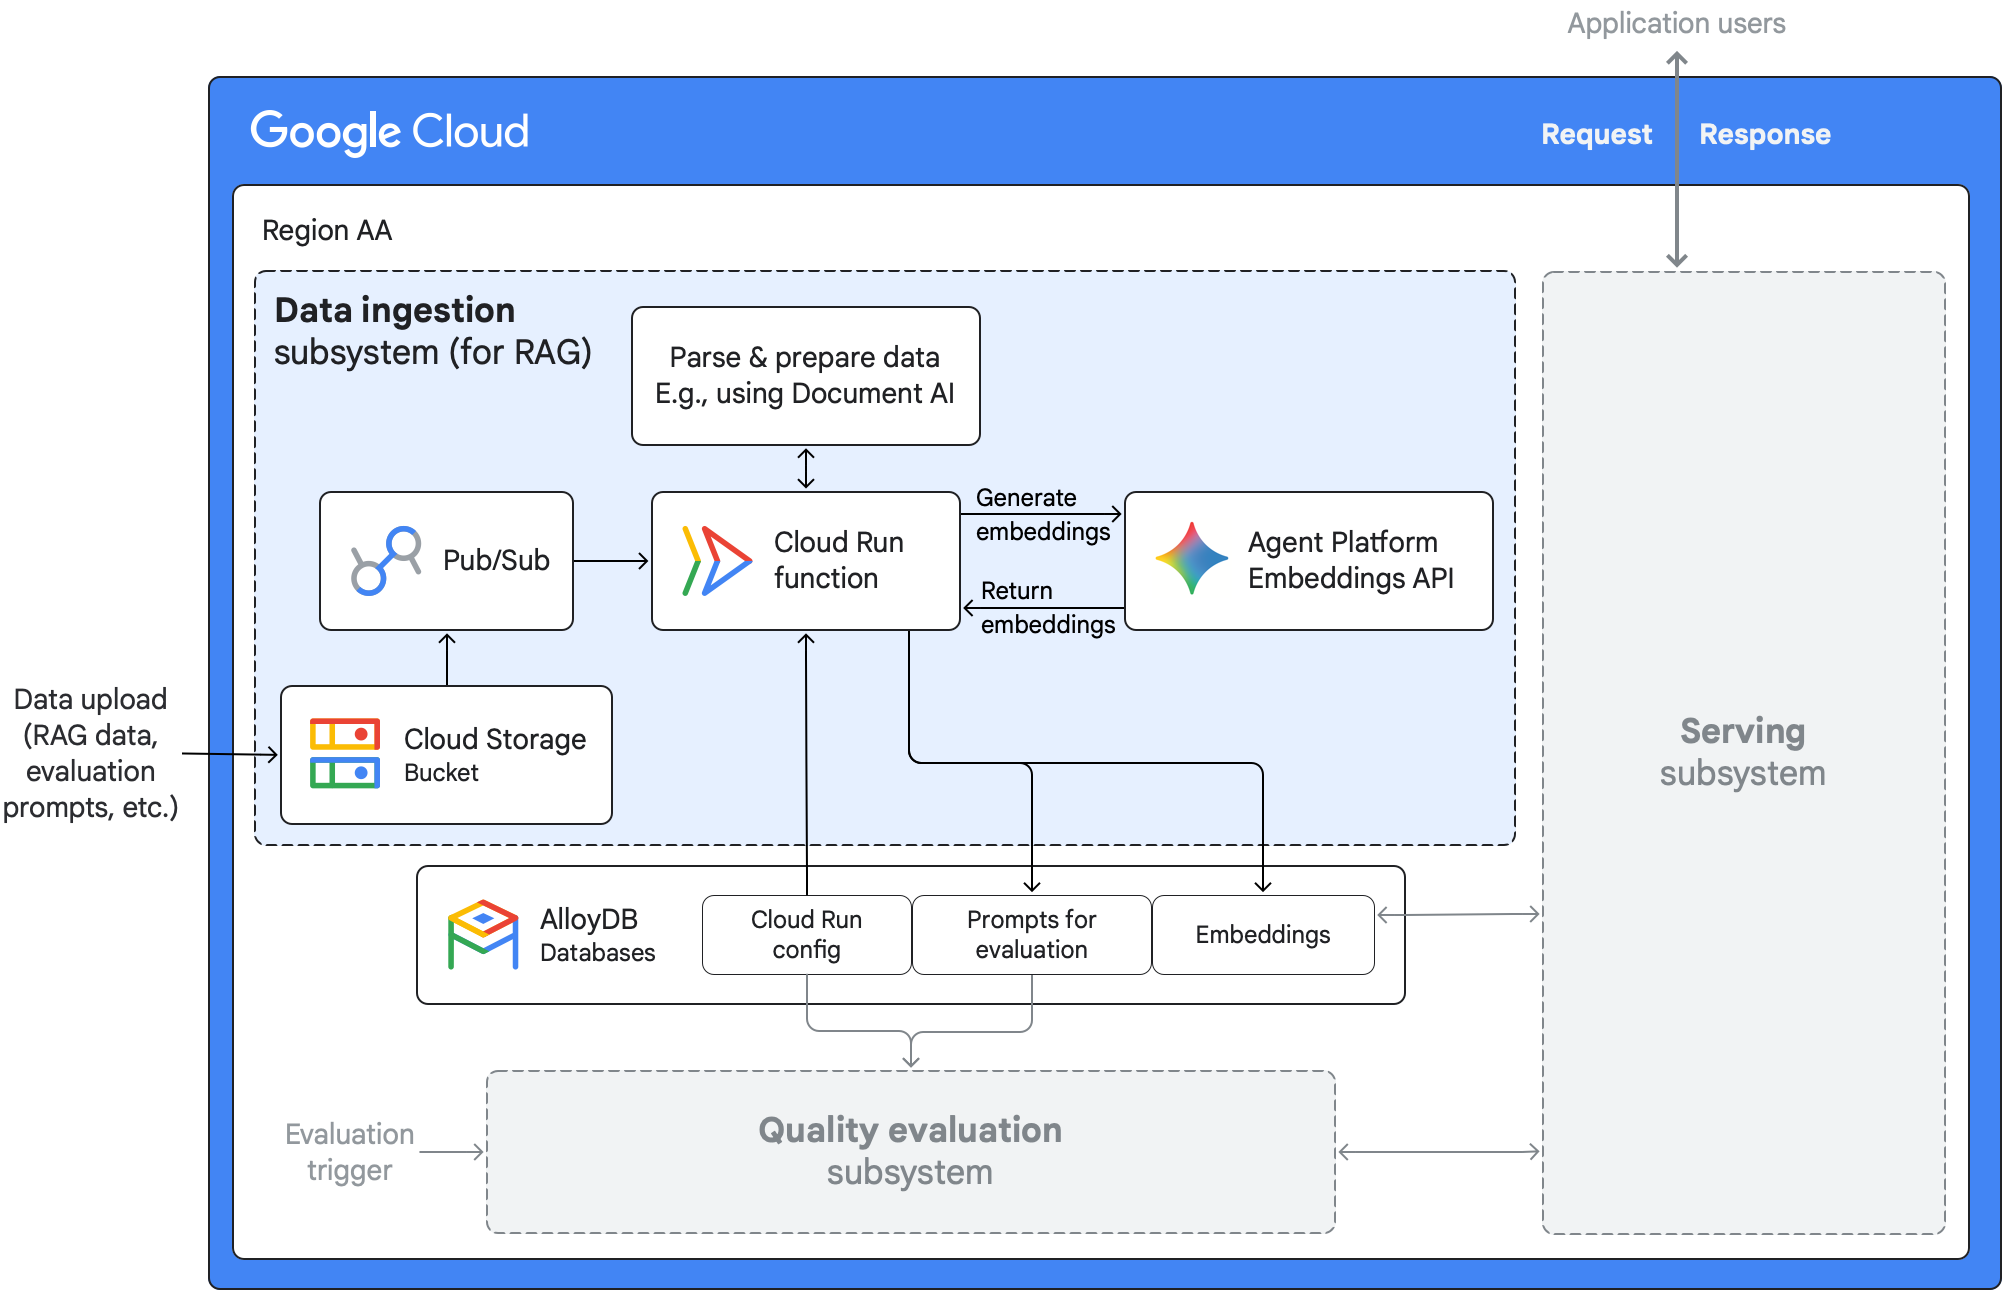
データ取り込みフローは次のようになります。
- データが Cloud Storage バケットにアップロードされます。データソースには、アプリケーション、データベース、ストリーミング サービスなどがあります。
- データが Cloud Storage にアップロードされると、メッセージが Pub/Sub トピックにパブリッシュされます。
- Pub/Sub が、アップロードされたデータを処理する Cloud Run functions をトリガーします。
- この関数は、AlloyDB for PostgreSQL データベースに保存されている構成データを使用して開始されます。
- この関数は、元データを解析し、必要に応じてフォーマットしてチャンクに分割します。
この関数は、Gemini Enterprise Agent Platform の適切なエンベディング モデルを使用して、取り込まれたデータのベクトル化エンベディングを作成します。
この関数は、
pgvector互換のvector拡張機能が有効になっている AlloyDB データベースにエンベディングを保存します。次のセクションで説明するように、サービング サブシステムはユーザー リクエストを処理する際に、ベクトル データベース内のエンベディングを使用して、関連するドメイン固有のデータを取得します。
サービング サブシステム
サービング サブシステムは、生成 AI アプリケーションとユーザー間のリクエスト / レスポンス フローを処理します。次の図は、このアーキテクチャのサービング サブシステムの詳細を示しています。
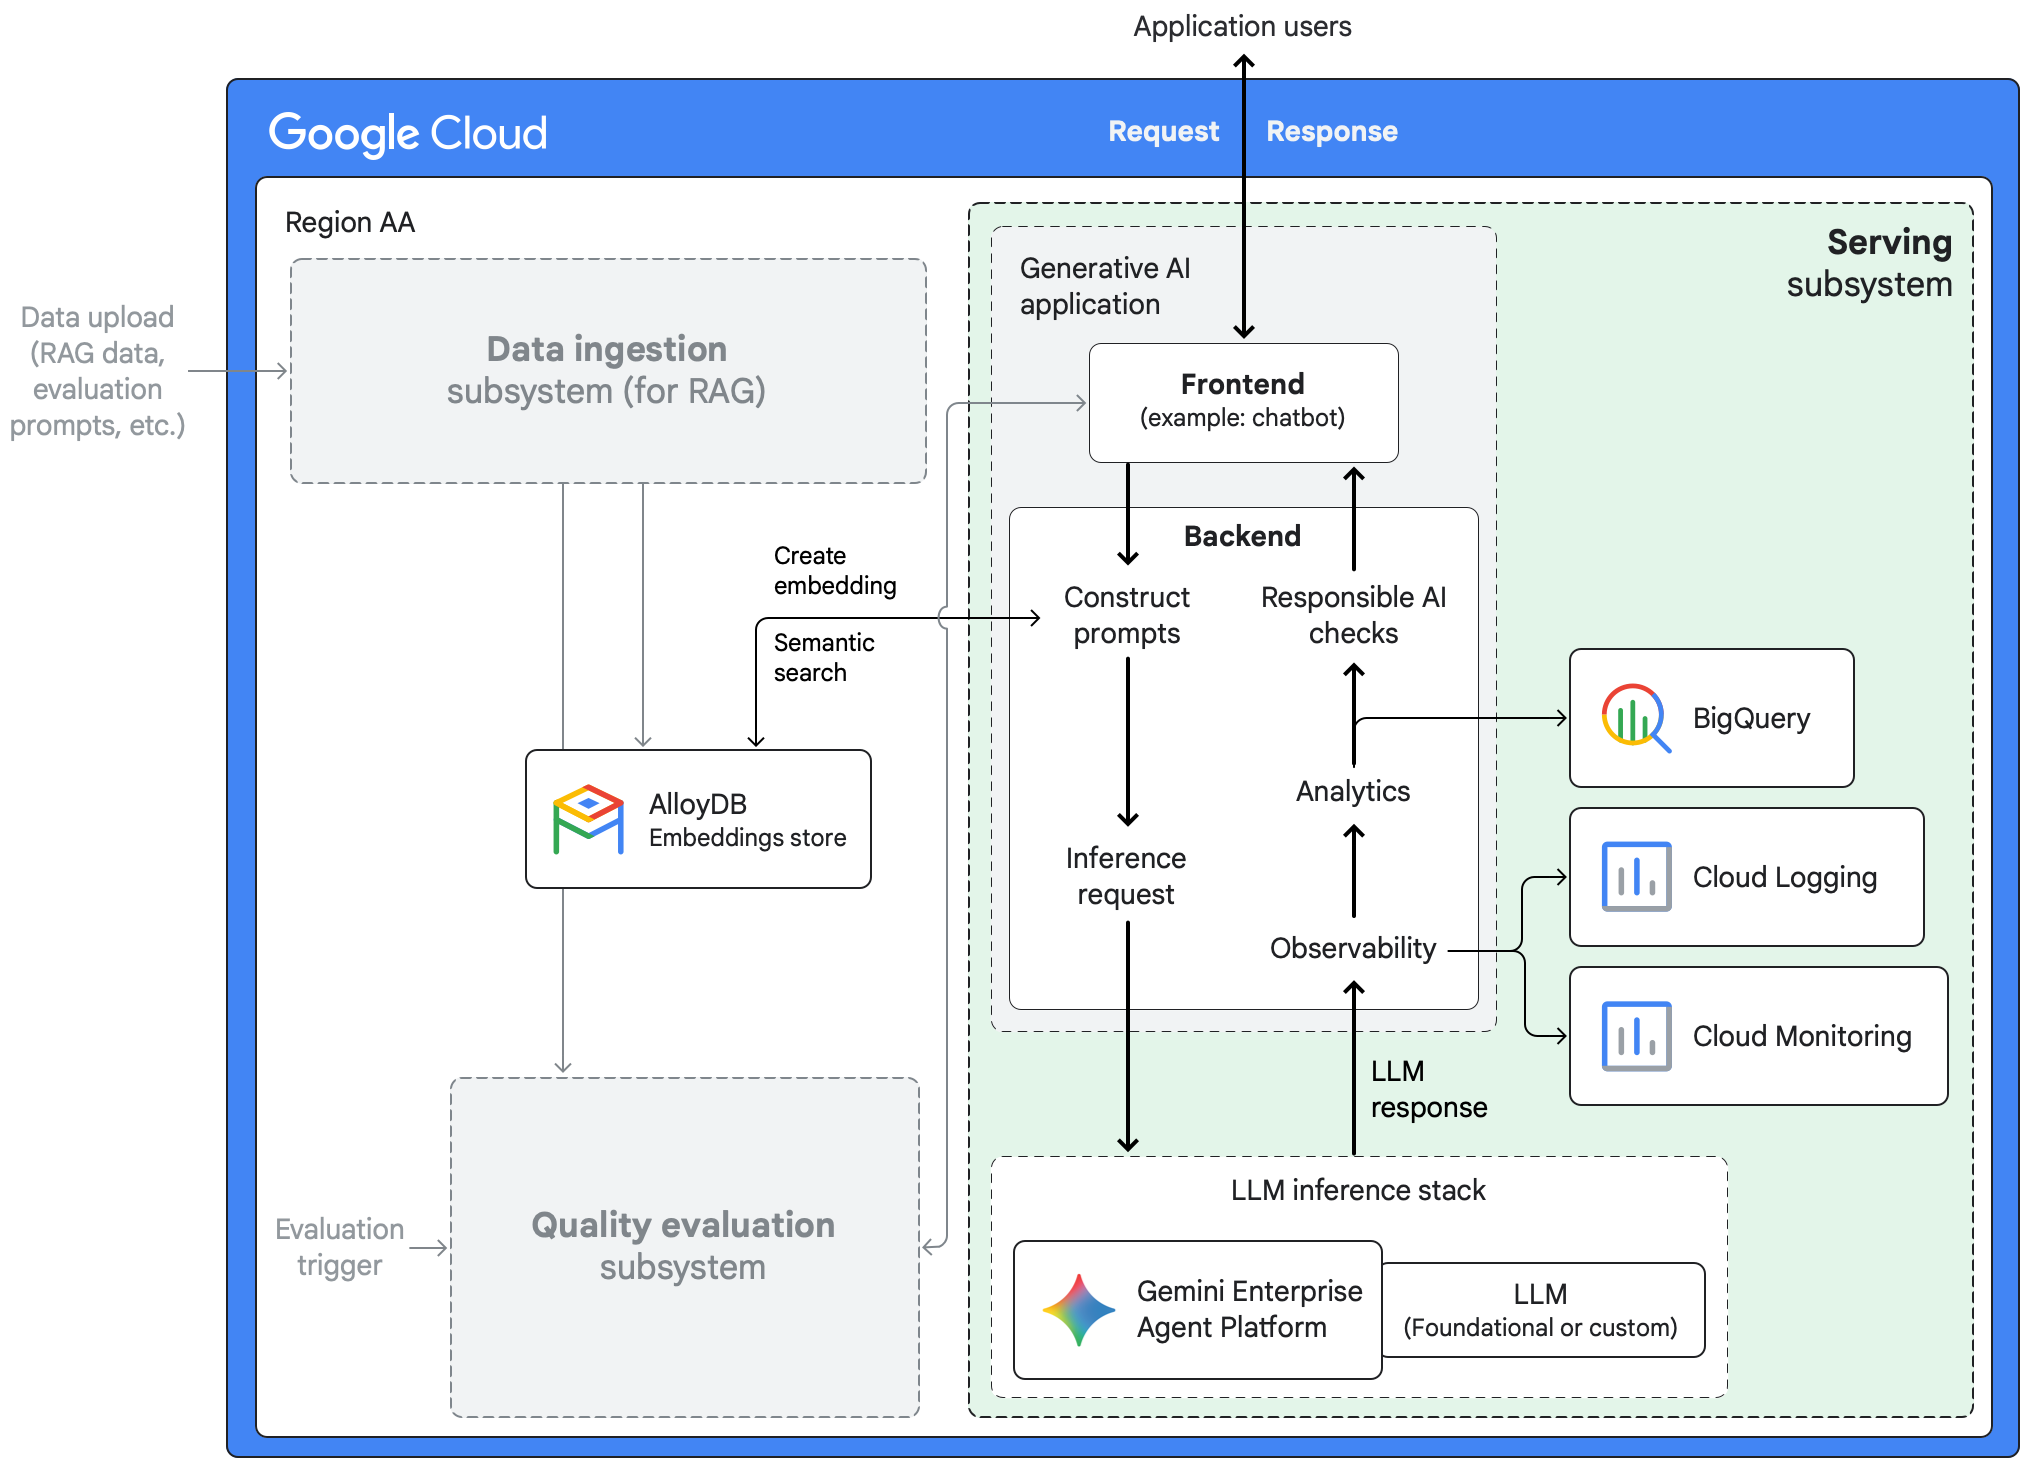
サービング サブシステムのリクエスト / レスポンス フローは次のとおりです。
- ユーザーが、フロントエンド(chatbot やモバイルアプリなど)を介して生成 AI アプリケーションにリクエストを送信します。
生成 AI アプリケーションが、自然言語のリクエストをエンベディングに変換します。
アプリケーションが RAG アプローチの取得部分を完了します。
- アプリケーションが、データ取り込みサブシステムで維持されている AlloyDB ベクトルストアのエンベディングに対してセマンティック検索を実行します。セマンティック検索は、テキストのコンテンツではなく、プロンプトの意図に基づいてエンベディングを見つける際に役立ちます。
- アプリケーションが、一致するエンベディングに基づいて取得された元データと元のリクエストを結合し、コンテキスト化されたプロンプトを生成します。
アプリケーションが、Agent Platform で実行される LLM 推論スタックにコンテキスト化されたプロンプトを送信します。
LLM 推論スタックが、生成 AI LLM(基盤 LLM またはカスタム LLM)を使用して、指定されたコンテキストに制約されたレスポンスを生成します。
- このアプリケーションは、リクエスト / レスポンス アクティビティのログを Cloud Logging に保存できます。このログは、Cloud Monitoring で表示して、モニタリングに使用できます。Google がログデータにアクセスしたり、ログデータを使用することはありません。
- アプリケーションが、オフライン分析のためにレスポンスを BigQuery に読み込みます。
アプリケーションが、責任ある AI フィルタを使用してレスポンスをスクリーニングします。
アプリケーションが、スクリーニングされたレスポンスをフロントエンド経由でユーザーに送信します。
品質評価サブシステム
次の図は、アーキテクチャの品質評価サブシステムの詳細を示しています。

リクエストを受け取ると、品質評価サブシステムは次の処理を行います。
- Pub/Sub が Cloud Run functions の関数をトリガーします。
- この関数は、AlloyDB データベースに保存されている構成データを使用して開始されます。
- この関数は、AlloyDB データベースから評価プロンプトを取得します。プロンプトは、すでにデータの取り込みサブシステムによってデータベースにアップロードされています。
この関数は、評価プロンプトを使用して、サービング サブシステムが生成したレスポンスの品質を評価します。
この評価の出力は、事実の正確性や関連性などの指標の評価スコアで構成されます。
この関数は、将来の分析のために評価スコアと、評価されたプロンプトとレスポンスを BigQuery に読み込みます。
使用するプロダクト
前述のアーキテクチャで使用される Google Cloud プロダクトの概要は次のとおりです。
- Gemini Enterprise Agent Platform: エンタープライズ グレードの AI エージェントを構築、スケーリング、管理、最適化できる包括的なプラットフォーム。
- Cloud Run functions: Google Cloudで単一目的の関数を直接実行できるサーバーレス コンピューティング プラットフォーム。
- BigQuery: ML、地理空間分析、ビジネス インテリジェンスなどの組み込み機能を使用してデータの管理と分析を支援する、Google Cloud のフルマネージド エンタープライズ データ ウェアハウス。
- Cloud Storage: 低コストで無制限のオブジェクト ストア。さまざまなデータ型に対応しています。データには Google Cloudの内部および外部からアクセスでき、冗長性を確保するために複数のロケーションに複製されます。
- AlloyDB for PostgreSQL: トランザクションと分析のハイブリッド処理など、特に要求の厳しいワークロード向けに設計された、PostgreSQL 対応のフルマネージド データベース サービス。
- Pub/Sub: メッセージを処理するサービスとメッセージを生成するサービスを切り離す、非同期でスケーラブルなメッセージング サービス。
- Cloud Logging: ストレージ、検索、分析、アラート機能を備えたリアルタイムのログ管理システム。
- Cloud Monitoring: アプリケーションとインフラストラクチャのパフォーマンス、可用性、動作状況を可視化するサービス。
ユースケース
RAG は、LLM から生成される出力の品質を高める効果的な手法です。このセクションでは、RAG 対応の生成 AI アプリケーションを使用するユースケースの例を示します。
個人に特化したおすすめの商品情報
オンライン ショッピング サイトで、LLM を利用した chatbot を使用して、買い物客が商品を見つけたり、ショッピング関連のサポートを利用できるようにします。ユーザーからの質問を、ユーザーの購入行動やウェブサイトのインタラクション パターンに関する過去のデータに基づいて拡張します。データには、非構造化データストアに保存されているユーザー レビューやフィードバック、ウェブ分析データ ウェアハウスに保存されている検索関連の指標などがあります。拡張された質問を LLM で処理することで、より魅力的で説得力のあるパーソナライズされた回答を生成できます。
臨床支援システム
病院の臨床医は、情報に基づいた治療の意思決定を行うために、患者の健康情報を確認して統合する必要があります。MedGemma などの医療基盤モデルを使用する生成 AI アプリケーションは、臨床医が臨床メモを要約し、医療コンテキストを確認するのに役立ちます。病院の電子医療記録(EHR)データベースや、PubMed などの外部のナレッジベースから取得したデータでプロンプトをコンテキスト化することで、過去の患者記録に裏付けられたレスポンスを生成できます。
効率的な法律調査
生成 AI を活用した法的調査により、弁護士は大量の法令と判例法をすばやく照会し、関連する判例を特定したり、複雑な法的概念を要約できます。法律事務所独自の契約書コーパス、過去の法的コミュニケーション、内部の訴訟記録から取得したデータで弁護士のプロンプトを補強することで、このような調査の出力精度を高めることができます。こうした設計アプローチにより、弁護士が専門とする法的領域に関連するレスポンスを生成することが可能になります。
代替案を設計する
このセクションでは、 Google Cloudの RAG 対応の生成 AI アプリケーションで検討できる代替の設計アプローチについて説明します。
マネージド RAG フレームワーク
カスタムの取り込みパイプラインと取得パイプラインを構築せずに、コンテキスト拡張 LLM ワークフローをオーケストレートするには、Gemini Enterprise Agent Platform の RAG Engine を使用します。RAG Engine は、RAG ワークロードのデータの取り込み、チャンク化、エンベディングの生成、インデックス登録、取得を管理します。
フルマネージド ベクトル検索
フルマネージド ベクトル検索プロダクトを使用するアーキテクチャが必要な場合は、Agent Platform とベクトル検索を使用できます。これは、非常に大規模なベクトル検索用に最適化されたサービング インフラストラクチャを提供します。詳細については、Agent Platform とベクトル検索を使用した生成 AI の RAG インフラストラクチャをご覧ください。
オープンソースのツールとモデル
オープンソースのツールとモデルである Ray、Hugging Face、LangChain を使用して、RAG 対応の生成 AI アプリケーションを迅速に構築してデプロイする場合は、GKE と Cloud SQL を使用した生成 AI 用 RAG インフラストラクチャをご覧ください。
設計上の考慮事項
このセクションでは、セキュリティとコンプライアンス、信頼性、費用、パフォーマンスに関する特定の要件を満たす RAG 対応生成 AI アーキテクチャを Google Cloud で開発する際に役立つガイダンスを提供します。このセクションのガイダンスはすべてを網羅しているわけではありません。生成 AI アプリケーション固有の要件と、使用する Google Cloud プロダクトと機能によっては、この他の設計要素やトレードオフについても考慮しなければならない場合があります。
セキュリティとコンプライアンス
このセクションでは、セキュリティとコンプライアンスの要件を満たす RAG 対応生成 AI アプリケーションを Google Cloud で設計して構築する際に考慮すべき要素について説明します。
Agent Platform のセキュリティに関する考慮事項
Agent Platform の構成と使用がセキュリティ要件を満たすようにするには、次の設計要素と推奨事項を考慮してください。
セキュリティ管理: Agent Platform は、データ所在地、データ暗号化、ネットワーク セキュリティ、アクセスの透明性の要件を満たすために使用できる Google Cloud セキュリティ管理をサポートしています。詳細については、機械学習(ML)サービスのセキュリティ管理と生成 AI のセキュリティ管理をご覧ください。
プロンプトとレスポンスのスクリーニング: RAG プロンプトとモデル レスポンスをスクリーニングして、プロンプト インジェクション、ジェイルブレイクの試み、有害なコンテンツ、機密データの漏洩を検出するには、Model Armor テンプレートとフィルタを使用します。
Cloud Run functions のデータ暗号化
お客様が管理する鍵を使用してデータを保護するには、顧客管理の暗号鍵(CMEK)を使用します。
AlloyDB のセキュリティに関する考慮事項
AlloyDB 構成がセキュリティ要件を満たすようにするには、次の推奨事項を考慮してください。
- データの暗号化: デフォルトでは、AlloyDB に保存されるデータはGoogle-owned and Google-managed encryption keysを使用して暗号化されます。お客様が制御、管理する暗号鍵を使用する必要がある場合は、CMEK を使用できます。詳細については、CMEK についてをご覧ください。
- ネットワーク制御: AlloyDB データベースからのデータの引き出しのリスクを軽減するには、VPC Service Controls を使用してサービス境界を作成します。
- 接続セキュリティ: デフォルトでは、AlloyDB インスタンスは SSL を使用する接続のみを受け入れます。AlloyDB データベースへの接続をさらに保護するには、AlloyDB Auth Proxy コネクタを使用します。Auth Proxy コネクタは Identity and Access Management(IAM)ベースの接続認可を提供します。256 ビット AES 暗号による TLS 1.3 接続を使用して、クライアントとサーバーの ID を検証し、データ トラフィックを暗号化します。詳細については、AlloyDB Auth Proxy についてをご覧ください。Java、Python、Go、Node.js を使用して作成した接続の場合は、Auth Proxy コネクタではなく、適切な言語コネクタを使用します。
- データ所在地: AlloyDB は、データ所在地の要件を満たすのに役立ちます。データは、指定したリージョン内で保存または複製されます。
BigQuery のセキュリティに関する考慮事項
BigQuery の構成がセキュリティ要件を満たすようにするには、次の推奨事項を考慮してください。
- データ ガバナンス: BigQuery には、データへのアクセスの制御、機密データの保護、データの正確性と整合性の確保に使用できる多くの機能が用意されています。詳細については、BigQuery のデータ ガバナンスの概要をご覧ください。
- データ所在地: BigQuery は、データ所在地の要件を満たすのに役立ちます。データは指定したリージョンに保存されます。
Cloud Storage のセキュリティに関する考慮事項
Cloud Storage の構成がセキュリティ要件を満たすようにするには、次の推奨事項を検討してください。
- データの暗号化: デフォルトでは、Cloud Storage に保存されるデータは Google-owned and Google-managed encryption keysを使用して暗号化されます。必要に応じて、CMEK を使用するか、顧客指定の暗号鍵(CSEK)などの外部の管理方法で管理する独自の鍵を使用できます。詳細については、データ暗号化オプションをご覧ください。
- アクセス制御: Cloud Storage は、バケットとオブジェクトにアクセスするためのユーザー権限を付与する 2 つのシステムをサポートしています。1 つは IAM、もう 1 つはアクセス制御リスト(ACL)です。ほとんどの場合は IAM を使用します。これにより、バケットレベルとプロジェクト レベルで権限を付与できます。詳細については、アクセス制御の概要をご覧ください。
- データ保護: Cloud Storage を介してデータの取り込みサブシステムに読み込むデータには、機密データが含まれる場合があります。このようなデータを保護するには、Sensitive Data Protection を使用してデータを検出、分類、匿名化します。詳細については、Cloud Storage での Sensitive Data Protection の使用をご覧ください。
- データ所在地: Cloud Storage は、データ所在地の要件を満たすのに役立ちます。データは、指定したリージョン内で保存または複製されます。
Pub/Sub のセキュリティに関する考慮事項
Pub/Sub 構成がセキュリティ要件を満たすようにするには、次の推奨事項を考慮してください。
- データ暗号化: Pub/Sub はデフォルトで Google-owned and Google-managed encryption keysを使用して、保存時と転送時の両方ですべてのメッセージを暗号化します。Pub/Sub は、アプリケーション レイヤでのメッセージ暗号化に CMEK の使用をサポートしています。詳細については、メッセージ暗号化の構成をご覧ください。
- データ所在地: データ所在地の要件がある場合、メッセージ データが特定のロケーションに保存されるように、メッセージ ストレージ ポリシーを構成できます。
Cloud Logging のセキュリティに関する考慮事項
Cloud Logging の構成がセキュリティ要件を満たすようにするには、次の設計要素と推奨事項を考慮してください。
- 管理アクティビティの監査: このリファレンス アーキテクチャで使用されるすべての Google Cloud サービスで、管理アクティビティ監査ログがデフォルトで有効になっています。これらのログには、 Google Cloud リソースの構成やメタデータを変更する API 呼び出しなどのアクションが記録されます。
- データアクセス監査: BigQuery では、データアクセス監査ログがデフォルトで有効になっています。このアーキテクチャで使用される他のサービスでは、データアクセスの監査ログを有効にできます。このログでは、リソースの構成やメタデータを読み取る API 呼び出しや、ユーザー提供のリソースデータの作成、変更、読み取りを行うユーザー リクエストを追跡できます。
- データ所在地: データ所在地の要件を満たすために、指定したリージョンにログデータを保存するように Cloud Logging を構成できます。詳細については、ログをリージョン化するをご覧ください。
AI ワークロードと ML ワークロードに固有のセキュリティの原則と推奨事項については、Well-Architected Framework の AI と ML の視点: セキュリティをご覧ください。
信頼性
このセクションでは、Google Cloudで RAG 対応生成 AI アプリケーション用に信頼性の高いインフラストラクチャを構築して運用する際に考慮すべき設計要素について説明します。
Cloud Run functions の信頼性に関する考慮事項
Cloud Run functions の実装が信頼性要件を満たすようにするには、次の設計要素と推奨事項を考慮してください。
- ゾーン冗長性: Cloud Run functions はリージョン内の複数のゾーンで実行され、ゾーンの停止に対する組み込みの復元力を提供します。
- エラー処理: 重複イベントや一時的なエラーを安全に処理するには、べき等関数を記述し、イベント ドリブン関数の再試行を構成します。処理に繰り返し失敗するメッセージを分離するには、Pub/Sub デッドレター トピックを構成します。
AlloyDB の信頼性に関する考慮事項
AlloyDB 構成が信頼性要件を満たすようにするには、次の設計要素と推奨事項を考慮してください。
- 高可用性: デフォルトでは、AlloyDB クラスタは自動フェイルオーバーによる高可用性(HA)を提供します。プライマリ インスタンスには、リージョン内の 2 つの異なるゾーンに配置された冗長ノードがあります。この冗長性により、ゾーンの停止に対してクラスタの耐障害性が確保されます。
- 障害復旧: リージョン停止からの復旧を計画するには、クロスリージョン レプリケーションを使用します。
BigQuery の信頼性に関する考慮事項
BigQuery に読み込むデータは、指定したリージョン内の 2 つのゾーンに同期的に保存されます。この冗長性により、ゾーン停止時のデータ消失を防ぐことができます。BigQuery の信頼性に関する機能の詳細については、信頼性についてをご覧ください。
Cloud Storage の信頼性に関する考慮事項
Cloud Storage バケットは、リージョン、デュアルリージョン、マルチリージョンのいずれかのロケーション タイプに作成できます。リージョン バケットに保存されるデータは、リージョン内の複数のゾーン間で同期をとって複製されます。高可用性を実現するには、デュアルリージョンまたはマルチリージョン バケットを使用します。この場合、データはリージョン間で非同期で複製されます。
Pub/Sub の信頼性に関する考慮事項
Pub/Sub 構成が信頼性の要件を満たすようにするには、次の推奨事項を考慮してください。
- レート制御: メッセージ トラフィックの一時的な急増を管理するには、パブリッシャーの設定でフロー制御を構成します。
- エラー処理: 失敗したパブリッシュを処理するには、必要に応じて再試行リクエスト変数を調整します。詳細については、リクエストを再試行するをご覧ください。
リージョン固有の考慮事項の詳細については、地域とリージョンをご覧ください。
AI ワークロードと ML ワークロードに固有の信頼性の原則と推奨事項については、Well-Architected Framework の AI と ML の視点: 信頼性をご覧ください。
費用の最適化
このセクションでは、 Google Cloudで RAG 対応生成 AI アプリケーションを設定して運用する際の費用を最適化するためのガイダンスを示します。
Agent Platform のコンテキスト キャッシュ
繰り返される RAG リクエストで大規模なシステム指示や取得されたコンテキストが共有される場合、入力トークンの費用を削減するには、コンテキスト キャッシュを使用します。
AlloyDB の費用に関する考慮事項
AlloyDB の費用を最適化するには、次の推奨事項を検討してください。
- インスタンスの可用性: デフォルトでは、AlloyDB クラスタのプライマリ インスタンスは高可用性(HA)です。インスタンスにはアクティブ ノードとスタンバイ ノードがあります。アクティブ ノードに障害が発生すると、AlloyDB は自動的にスタンバイ ノードにフェイルオーバーされます。データベースに HA が必要ない場合は、クラスタのプライマリ インスタンスを基本インスタンスにすることでコストを削減できます。基本インスタンスはゾーンの停止に対して復元力がなく、メンテナンス オペレーション中のダウンタイムが長くなります。詳細については、基本インスタンスを使用してコストを削減するをご覧ください。
- 料金の最適化: AlloyDB インスタンスの CPU とメモリの要件を予測できる場合は、確約利用の割引を受けることで費用を節約できます。詳細については、AlloyDB の確約利用割引をご覧ください。
BigQuery の費用に関する考慮事項
BigQuery では、クエリを実行する前に費用を見積もることができます。クエリ費用を最適化するには、ストレージとクエリ計算を最適化する必要があります。詳細については、費用の見積もりと管理をご覧ください。
Cloud Storage の費用に関する考慮事項
データ取り込みサブシステムへのデータの読み込みに使用する Cloud Storage バケットには、ワークロードのデータ保持とアクセス頻度の要件に基づいて適切なストレージ クラスを選択します。たとえば、ストレージ費用を管理するには、Standard Storage クラスを選択してオブジェクトのライフサイクル管理を使用します。この方法では、設定した条件に基づいて、オブジェクトを低コストのストレージ クラスに自動的にダウングレードしたり、オブジェクトを削除できます。
Cloud Logging の費用に関する考慮事項
ログの保存費用を管理するには、次の推奨事項を検討してください。
- 不要なログエントリを除外またはフィルタして、ログの量を減らします。詳細については、ログシンクのフィルタをご覧ください。
- ログエントリの保持期間を短縮します。詳細については、カスタム保持期間を構成するをご覧ください。
AI ワークロードと ML ワークロードに固有の費用最適化の原則と推奨事項については、Well-Architected Framework の AI と ML の視点: 費用の最適化をご覧ください。
パフォーマンス
このセクションでは、パフォーマンス要件を満たす RAG 対応生成 AI アプリケーションを Google Cloud で設計して構築する際に考慮すべき要素について説明します。
Cloud Run functions のレイテンシ
非アクティブな期間の後にコールド スタート レイテンシを短縮するには、インスタンスの最小数を構成します。
AlloyDB のパフォーマンスに関する考慮事項
AlloyDB 構成がパフォーマンス要件を満たすようにするには、次の推奨事項を考慮してください。
- ベクトル インデックス作成とカラム型エンジン: RAG ワークロードでベクトル類似度クエリを高速化するには、ScaNN や HNSW などの近似最近傍(ANN)インデックスを作成します。詳細については、インデックス戦略を選択するをご覧ください。ベクトル スキャンとフィルタ付きクエリをさらに高速化するには、カラム型エンジンを使用してベクトル検索を高速化するをご覧ください。
- クエリ パフォーマンス分析: データベースのクエリ パフォーマンスを分析して改善できるように、AlloyDB には Query Insights ツールが用意されています。このツールを使用すると、パフォーマンスをモニタリングして、問題のあるクエリの原因をトレースできます。詳細については、Query Insights についてをご覧ください。
- インスタンスのモニタリング: データベースのステータスとパフォーマンスの概要を取得し、ピーク時の接続数や最大レプリケーション ラグなどの詳細な指標を表示するには、システム分析情報ダッシュボードを使用します。詳細については、AlloyDB システム分析情報ダッシュボードでインスタンスをモニタリングするをご覧ください。
- 読み取りスケーリング: プライマリ AlloyDB インスタンスの負荷を軽減し、読み取りリクエストを処理する容量をスケールアウトするには、クラスタに読み取りプール インスタンスを追加します。詳細については、AlloyDB インスタンスとはをご覧ください。
BigQuery のパフォーマンスに関する考慮事項
BigQuery の使用がパフォーマンス要件を満たすようにするには、次の推奨事項を検討してください。
- クエリ パフォーマンス分析情報: BigQuery では、クエリ実行グラフを使用してクエリのパフォーマンスを分析し、スロット競合やシャッフル割り当ての不足などの問題に関するパフォーマンス分析情報を取得できます。詳細については、クエリのパフォーマンス分析情報を取得するをご覧ください。
- クエリ計算の最適化: クエリのパフォーマンス分析情報で特定した問題に対処したら、入力データと出力データの量を減らすなどの手法でクエリをさらに最適化できます。詳細については、クエリ計算を最適化するをご覧ください。
Cloud Storage のパフォーマンスに関する考慮事項
大きなファイルをアップロードするには、並列複合アップロードと呼ばれる方法を使用できます。この方法では、サイズの大きいファイルがチャンクに分割されます。チャンクは Cloud Storage に並行してアップロードされ、その後、クラウドでデータが再構成されます。ネットワーク帯域幅とディスク速度が制限要因になっていない場合は、並列複合アップロードが通常のアップロード オペレーションよりも高速になる可能性があります。ただし、この方法にはいくつかの制限事項があり、費用にも影響が及びます。詳細については、並列複合アップロードをご覧ください。
AI ワークロードと ML ワークロードに固有のパフォーマンス最適化の原則と推奨事項については、Well-Architected Framework の AI と ML の視点: パフォーマンスの最適化をご覧ください。
デプロイ
Google Cloudで、RAG 対応生成 AI アプリケーションのインフラストラクチャの構築を開始してテストするには、GitHub で入手できるサンプルコードを使用します。このコードは、Python ベースのチャット アプリケーションを Cloud Run にデプロイし、ベクトル検索にフルマネージド Cloud SQL データベースを使用します。
次のステップ
- MCP ツールボックスを使用した AlloyDB エージェント型 RAG アプリケーション
- Agent Platform とベクトル検索を使用した生成 AI 用 RAG インフラストラクチャ
- GKE と Cloud SQL を使用した生成 AI 用 RAG インフラストラクチャ
- Gemini Enterprise と Agent Platform を使用した生成 AI 用 RAG インフラストラクチャ
- Agent Platform と Spanner Graph を使用した生成 AI 用 GraphRAG インフラストラクチャ
- Google Cloudの AI ワークロードと ML ワークロードに固有のアーキテクチャ原則と推奨事項の概要について、Well-Architected Framework の AI と ML の視点を確認する。
- Cloud アーキテクチャ センターで、リファレンス アーキテクチャ、図、ベスト プラクティスを確認する。
協力者
著者: Kumar Dhanagopal | クロスプロダクト ソリューション デベロッパー
その他の関係者:
- Andrew Brook | エンジニアリング ディレクター
- Anna Berenberg | エンジニアリング フェロー
- Assaf Namer | プリンシパル クラウド セキュリティ アーキテクト
- Balachandar Krishnamoorthy | プリンシパル ソフトウェア エンジニア
- Daniel Lees | クラウド セキュリティ アーキテクト
- Derek Downey | デベロッパーリレーションズ エンジニア)
- Eran Lewis | シニア プロダクト マネージャー
- Geoffrey Anderson | プロダクト マネージャー
- Gleb Otochkin | Cloud アドボケイト、データベース
- Hamsa Buvaraghan | AI プロダクト マネージャー
- Irina Sigler | プロダクト マネージャー
- Jack Wotherspoon | デベロッパー アドボケイト
- Jason Davenport | デベロッパー アドボケイト
- Jordan Totten | カスタマー エンジニア
- Julia Wiesinger | プロダクト マネージャー
- Kara Greenfield | カスタマー エンジニア
- Kurtis Van Gent | スタッフ ソフトウェア エンジニア
- Per Jacobsson | ソフトウェア エンジニア
- Pranav Nambiar | ディレクター
- Richard Hendricks | アーキテクチャ センター スタッフ
- Safiuddin Khaja | クラウド エンジニア
- Sandy Ghai | グループ プロダクト マネージャー
- Vladimir Vuskovic | プロダクト マネジメント ディレクター
- Steren Giannini | グループ プロダクト マネージャー
- Wietse Venema | デベロッパーリレーションズ エンジニア