


Questo documento fornisce un'architettura di alto livello per un'applicazione che utilizza l'AI per generare podcast in base all'input audio.
Il pubblico di destinazione di questo documento include architetti, sviluppatori e amministratori che creano e gestiscono applicazioni di AI generativa nel cloud per i settori dei media e del marketing. Il documento presuppone che tu abbia una conoscenza di base dell'AI generativa.
La sezione Deployment di questo documento fornisce esempi di codice per i workload di AI generativa che coinvolgono formati di input e output multimodali.
Architettura
Il seguente diagramma mostra un'architettura per un'applicazione di produzione di podcast in Google Cloud. L'applicazione utilizza l'AI per generare podcast da file audio, come i commenti live per un evento sportivo.
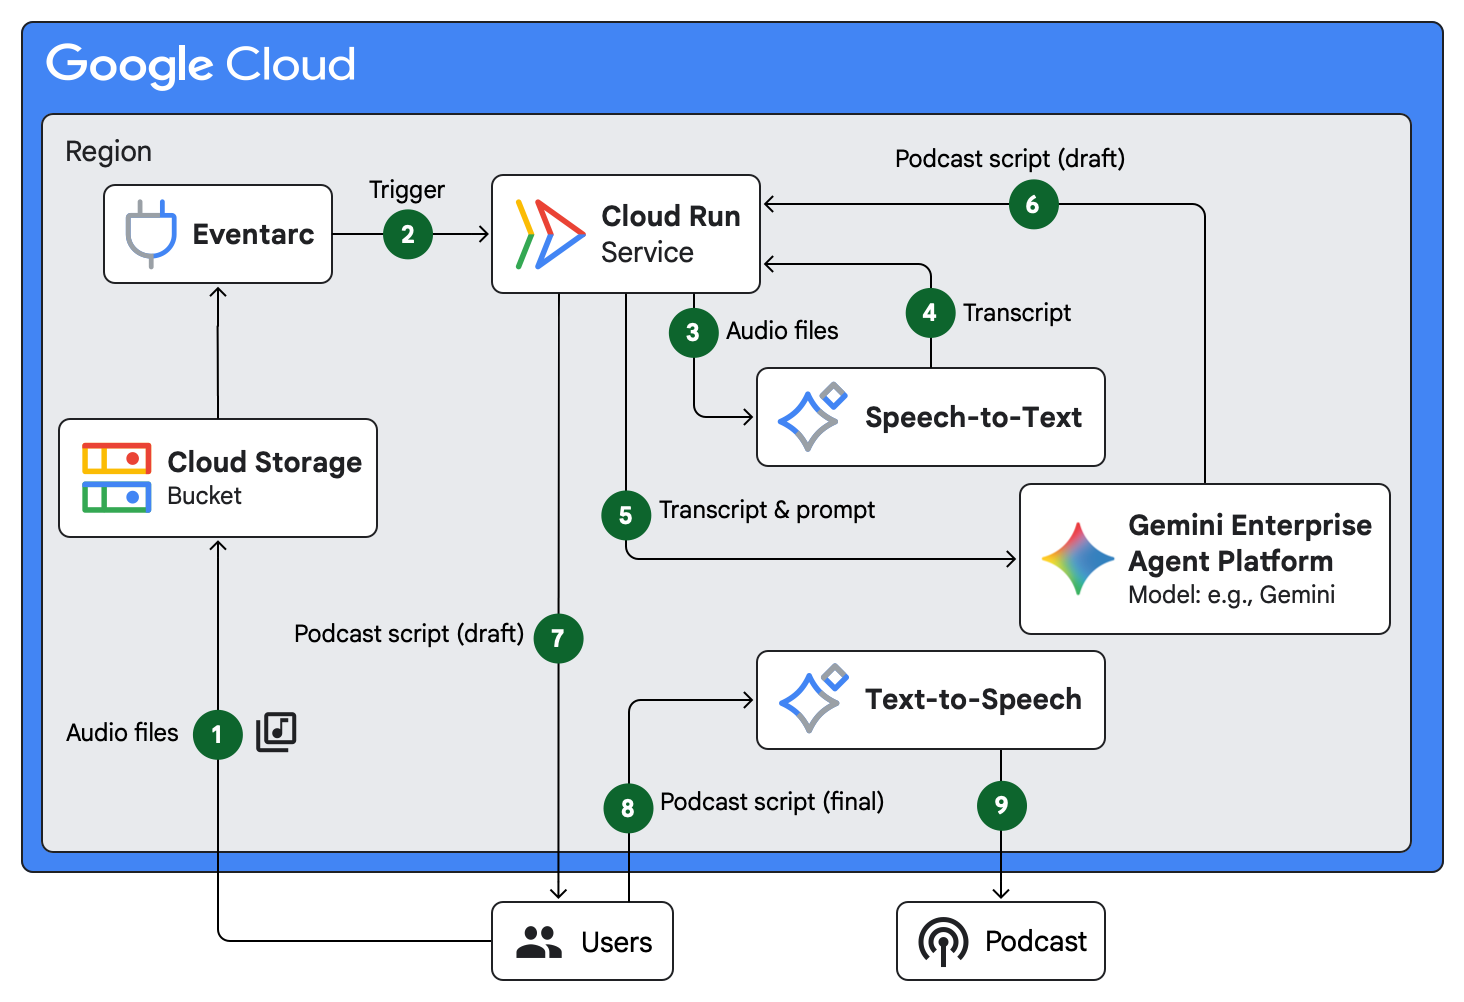
L'architettura mostra il seguente flusso:
- Un utente carica file audio in un bucket Cloud Storage.
- Eventarc attiva un servizio Cloud Run.
- Il servizio Cloud Run invia i file audio a Speech-to-Text.
- Speech-to-Text produce trascrizioni con timestamp dei file audio.
Il servizio Cloud Run invia le trascrizioni a Gemini Enterprise Agent Platform, con un prompt per generare uno script per un podcast.
Ad esempio, il prompt potrebbe essere quello di generare uno script per un podcast di 15 minuti sui momenti salienti di un evento sportivo in base a determinate parole chiave nel commento.
Un modello Gemini su Agent Platform genera una bozza di uno script per un podcast.
Il servizio Cloud Run invia la bozza dello script all'utente.
L'utente esamina e modifica la bozza dello script, quindi invia lo script finale a Text-to-Speech.
Text-to-Speech produce un file audio del podcast.
Prodotti utilizzati
Questa architettura di esempio utilizza i seguenti prodotti Google Cloud :
- Speech-to-Text: un'API che utilizza le tecnologie di riconoscimento vocale di Google per trascrivere l'audio in testo.
- Gemini Enterprise Agent Platform: una piattaforma completa che ti consente di creare, scalare, gestire e ottimizzare agenti AI di livello enterprise.
- Text-to-Speech: un'API per creare un parlato umano sintetico dal suono naturale a partire dal testo.
- Cloud Storage: un archivio di oggetti a basso costo e senza limiti per diversi tipi di dati. I dati sono accessibili dall'interno e dall'esterno di Google Cloude vengono replicati in più località per la ridondanza.
- Cloud Run: una piattaforma di serverless computing che ti consente di eseguire container direttamente sull'infrastruttura scalabile di Google.
- Eventarc: una soluzione serverless per instradare in modo asincrono i messaggi attivati dagli eventi.
Considerazioni sulla progettazione
Questa sezione descrive i fattori di progettazione, le best practice e i consigli in linea con il Well-Architected FrameworkGoogle Cloud . Tieni conto di queste informazioni quando utilizzi questa architettura di riferimento per sviluppare una topologia che soddisfi i tuoi requisiti specifici di sicurezza, affidabilità, ottimizzazione dei costi ed efficienza operativa.
Sicurezza, privacy e conformità
Per proteggere il workload di generazione dei podcast e soddisfare i requisiti di privacy e conformità, prendi in considerazione i seguenti suggerimenti:
- Per eseguire lo screening di prompt, trascrizioni e script di podcast per rilevare prompt injection, tentativi di jailbreak e contenuti dannosi, utilizza Model Armor. Per rilevare e oscurare le informazioni che consentono l'identificazione personale (PII) nelle trascrizioni e nelle bozze degli script prima della sintesi, utilizza Sensitive Data Protection.
- Per seguire il principio del privilegio minimo, assegna service account Identity and Access Management (IAM) dedicati al trigger Eventarc e al servizio Cloud Run. Per limitare l'accesso alla rete ai chiamanti e ai revisori autorizzati, configura i controlli in entrata di Cloud Run e richiedi l'autenticazione IAM.
Affidabilità
Per garantire un'elaborazione affidabile per la sintesi di podcast e commenti nel formato lungo, tieni presente i seguenti consigli:
- Per trascrivere in modo affidabile registrazioni di commenti lunghi, prendi in considerazione l'elaborazione batch asincrona. Per saperne di più, consulta Trascrivi file audio lunghi in testo.
- Per sintetizzare puntate intere, suddividi gli script in segmenti più piccoli o utilizza la sintesi audio di lunga durata, quindi archivia l'audio di output in Cloud Storage.
- Poiché Eventarc riprova le consegne non confermate, l'elaborazione sincrona di contenuti multimediali di più minuti in un gestore HTTP di Cloud Run può causare timeout e duplicazione del lavoro. Per disaccoppiare la distribuzione degli eventi dall'elaborazione a lunga esecuzione, orchestra le attività in più passaggi con Workflows o esegui workload batch nei job Cloud Run.
Ottimizzazione dei costi
Per ottimizzare i costi di generazione degli script e di sintesi dell'audio dei podcast, tieni presente i seguenti consigli:
- Quando gli script dei podcast non richiedono una generazione immediata, utilizza l'inferenza batch su Agent Platform. L'inferenza batch elabora workload di trascrizione di grandi dimensioni in modo asincrono a un costo inferiore rispetto all'inferenza online standard.
- Per ridurre i costi di sintesi per la produzione di podcast ad alto volume, scegli un modello appropriato in base ai tuoi requisiti sulla piattaforma dell'agente.
Efficienza operativa
Per semplificare la pipeline multimodale e la produzione audio con più interlocutori, tieni presente i seguenti consigli:
- Per semplificare la pipeline quando non hai bisogno di funzionalità di Speech-to-Text specializzate, passa gli URI audio di Cloud Storage direttamente a Gemini su Agent Platform. Con la comprensione audio multimodale, Gemini può analizzare file audio lunghi con comprensione dei timestamp e creare bozze di script per podcast in un unico passaggio. Continua a utilizzare Speech-to-Text con modelli di trascrizione specializzati se il tuo workload richiede la diarizzazione degli speaker in batch o l'adattamento del modello per nomi specifici del dominio.
- Per produrre podcast conversazionali con più host senza una complessa ottimizzazione SSML, utilizza Gemini TTS su Agent Platform. Se la tua applicazione chiama direttamente Text-to-Speech, puoi anche utilizzare Gemini TTS o altre voci conversazionali per un controllo vocale naturale. Per saperne di più, consulta Voci e lingue supportate.
Deployment
Per sperimentare l'utilizzo dei prodotti Google Cloud per workload che prevedono formati di input e output multimodali come audio e testo, prova i seguenti esempi di codice:
- Genera una trascrizione di un'intervista audio.
- Genera un podcast con più speaker utilizzando Gemini e l'API Text-to-Speech.
- Registra l'audio e genera una traduzione.
Passaggi successivi
- Esplora altre guide all'architettura dell'AI generativa.
- Per una panoramica dei principi e dei suggerimenti di architettura specifici per i workload di AI e ML in Google Cloud, consulta la prospettiva di AI e ML nel Well-Architected Framework.
- Per ulteriori architetture di riferimento, diagrammi e best practice, esplora Cloud Architecture Center.
Collaboratori
Autore: Kumar Dhanagopal | Cross-Product Solution Developer
Altri collaboratori:
- Amina Mansour | Tech Lead, Global Developer Relations & Strategic Content
- Megan O'Keefe | Developer Advocate
- Samantha He | Technical Writer
- Shir Meir Lador | Developer Relations Engineering Manager