


Dokumen ini memberikan arsitektur tingkat tinggi untuk aplikasi yang menggunakan AI untuk membuat podcast berdasarkan input audio.
Audiens yang dituju untuk dokumen ini mencakup arsitek, developer, dan administrator yang membangun dan mengelola aplikasi AI generatif di cloud untuk industri media dan pemasaran. Dokumen ini mengasumsikan bahwa Anda memiliki pemahaman dasar tentang AI generatif.
Bagian Deployment dalam dokumen ini menyediakan contoh kode untuk workload AI generatif yang melibatkan format input dan output multimodal.
Arsitektur
Diagram berikut menunjukkan arsitektur untuk aplikasi produser podcast di Google Cloud. Aplikasi ini menggunakan AI untuk membuat podcast dari file audio, seperti komentar langsung untuk acara olahraga.
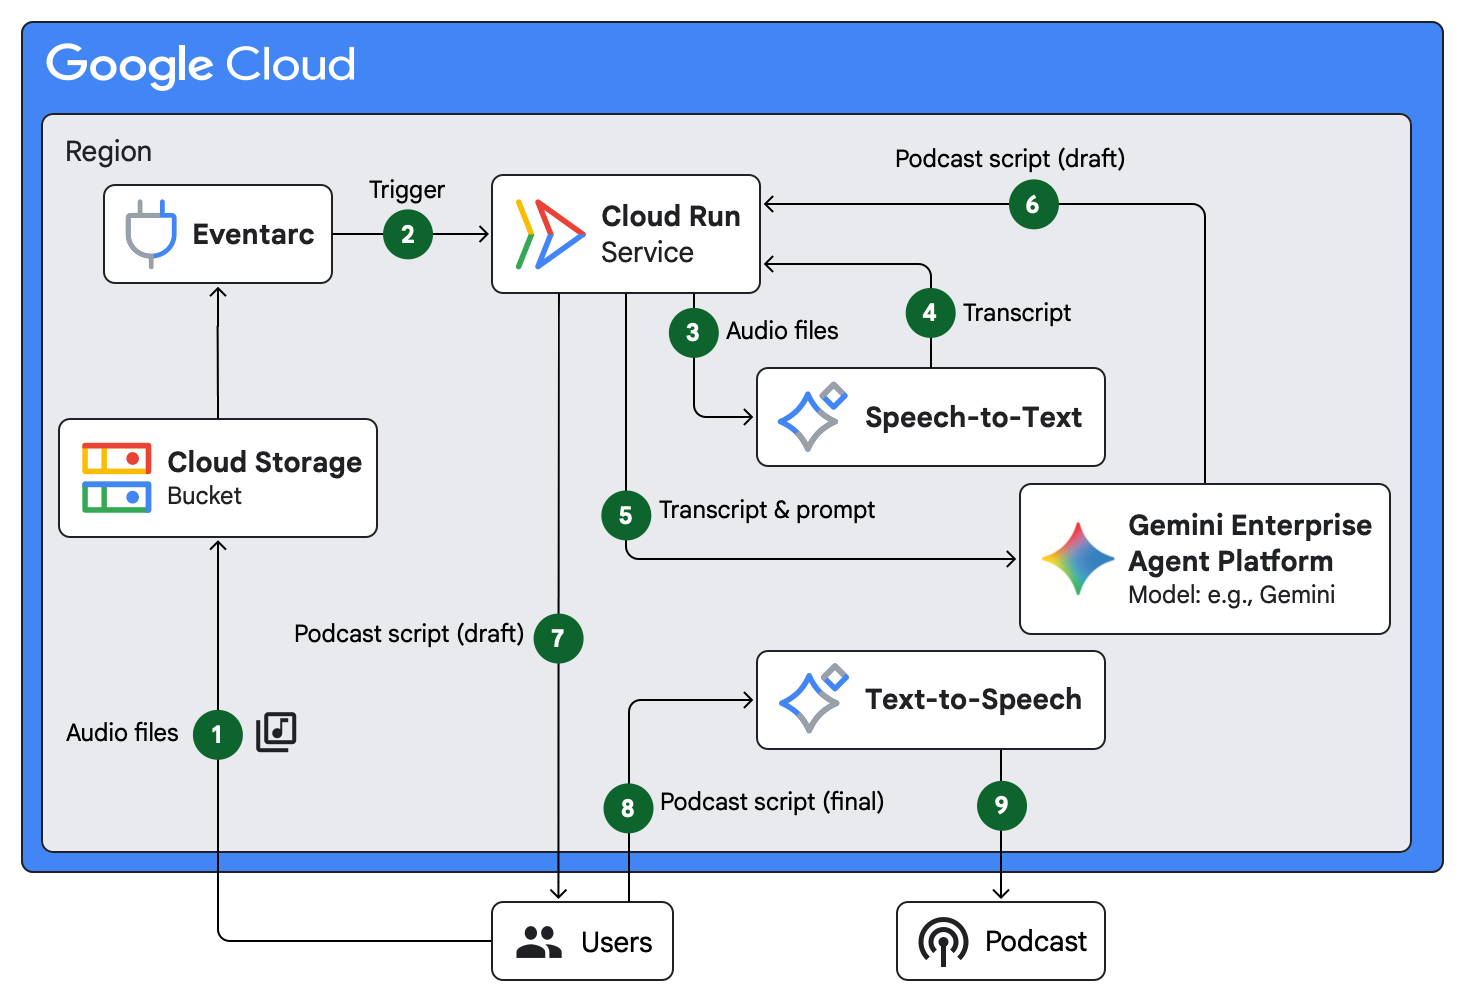
Arsitektur ini menampilkan alur berikut:
- Pengguna mengupload file audio ke bucket Cloud Storage.
- Eventarc memicu layanan Cloud Run.
- Layanan Cloud Run mengirimkan file audio ke Speech-to-Text.
- Speech-to-Text menghasilkan transkrip file audio yang diberi stempel waktu.
Layanan Cloud Run mengirimkan transkrip ke Gemini Enterprise Agent Platform, dengan perintah untuk membuat skrip podcast.
Misalnya, perintahnya dapat berupa membuat skrip untuk podcast berdurasi 15 menit tentang sorotan acara olahraga berdasarkan kata kunci tertentu dalam komentar.
Model Gemini di Agent Platform membuat draf skrip podcast.
Layanan Cloud Run mengirimkan draf skrip kepada pengguna.
Pengguna meninjau dan mengedit draf skrip, lalu mengirim skrip akhir ke Text-to-Speech.
Text-to-Speech menghasilkan file audio podcast.
Produk yang digunakan
Contoh arsitektur ini menggunakan produk Google Cloud berikut:
- Speech-to-Text: API yang menggunakan teknologi pengenalan ucapan Google untuk mentranskripsikan audio menjadi teks.
- Gemini Enterprise Agent Platform: Platform komprehensif yang memungkinkan Anda membangun, menskalakan, mengatur, dan mengoptimalkan agen AI tingkat perusahaan.
- Text-to-Speech: API untuk membuat ucapan manusia sintetis yang terdengar alami dari teks.
- Cloud Storage: Penyimpanan objek berbiaya rendah dan tanpa batas untuk beragam jenis data. Data dapat diakses dari dalam dan luar Google Cloud, serta direplikasi di berbagai lokasi untuk redundansi.
- Cloud Run: Platform komputasi serverless yang memungkinkan Anda menjalankan container langsung di atas infrastruktur Google yang skalabel.
- Eventarc: Solusi serverless untuk merutekan pesan yang dipicu oleh peristiwa secara asinkron.
Pertimbangan desain
Bagian ini menjelaskan faktor desain, praktik terbaik, dan rekomendasi yang selaras dengan Google Cloud Well-Architected Framework. Pertimbangkan informasi ini saat Anda menggunakan arsitektur referensi ini untuk mengembangkan topologi yang memenuhi persyaratan spesifik Anda terkait keamanan, keandalan, pengoptimalan biaya, dan efisiensi operasional.
Keamanan, privasi, dan kepatuhan
Untuk membantu mengamankan workload pembuatan podcast dan memenuhi persyaratan privasi dan kepatuhan Anda, pertimbangkan rekomendasi berikut:
- Untuk menyaring perintah, transkrip, dan skrip podcast dari injeksi perintah, upaya jailbreak, dan konten berbahaya, gunakan Model Armor. Untuk mendeteksi dan menyamarkan informasi identitas pribadi (PII) dalam transkrip dan draf skrip sebelum sintesis, gunakan Sensitive Data Protection.
- Untuk mengikuti prinsip hak istimewa terendah, tetapkan akun layanan Identity and Access Management (IAM) khusus ke pemicu Eventarc dan layanan Cloud Run. Untuk membatasi akses jaringan ke pemanggil dan peninjau yang diizinkan, konfigurasikan kontrol ingress Cloud Run dan wajibkan autentikasi IAM.
Keandalan
Untuk membantu memastikan pemrosesan yang andal untuk komentar panjang dan sintesis podcast, pertimbangkan rekomendasi berikut:
- Untuk mentranskripsikan rekaman komentar panjang dengan andal, pertimbangkan pemrosesan batch asinkron. Untuk mengetahui informasi selengkapnya, lihat Mentranskripsikan file audio panjang menjadi teks.
- Untuk menyintesis episode berdurasi penuh, bagi skrip menjadi segmen yang lebih kecil atau gunakan Long Audio Synthesis, lalu simpan audio output di Cloud Storage.
- Karena Eventarc mencoba ulang pengiriman yang tidak diakui, pemrosesan media multi-menit sinkron dalam pengendali HTTP Cloud Run dapat menyebabkan waktu tunggu habis dan pekerjaan duplikat. Untuk memisahkan pengiriman peristiwa dari pemrosesan yang berjalan lama, lakukan orkestrasi tugas multi-langkah dengan Workflows atau jalankan workload batch di tugas Cloud Run.
Pengoptimalan biaya
Untuk membantu mengoptimalkan biaya pembuatan skrip dan sintesis audio podcast, pertimbangkan rekomendasi berikut:
- Jika skrip podcast tidak memerlukan pembuatan langsung, gunakan inferensi batch di Agent Platform. Inferensi batch memproses workload transkrip besar secara asinkron dengan biaya yang lebih rendah daripada inferensi online standar.
- Untuk mengurangi biaya sintesis dalam produksi podcast bervolume tinggi, pilih model yang sesuai berdasarkan kebutuhan Anda di Agent Platform.
Efisiensi operasional
Untuk menyederhanakan pipeline multimodal dan produksi audio multi-pembicara, pertimbangkan rekomendasi berikut:
- Untuk menyederhanakan pipeline saat Anda tidak memerlukan fitur Speech-to-Text khusus, teruskan URI audio Cloud Storage langsung ke Gemini di Agent Platform. Dengan pemahaman audio multimodal, Gemini dapat menganalisis file audio panjang dengan pemahaman stempel waktu dan membuat draf skrip podcast dalam satu langkah. Pertahankan Speech-to-Text dengan model transkripsi khusus jika workload Anda memerlukan diarisasi pembicara batch atau adaptasi model untuk nama khusus domain.
- Untuk membuat podcast percakapan dengan beberapa host tanpa penyesuaian SSML yang rumit, gunakan Gemini TTS di Agent Platform. Jika aplikasi Anda memanggil Text-to-Speech secara langsung, Anda juga dapat menggunakan Gemini TTS atau suara percakapan lainnya untuk kontrol suara alami. Untuk mengetahui informasi selengkapnya, lihat Suara dan bahasa yang didukung.
Deployment
Untuk bereksperimen menggunakan produk Google Cloud untuk workload yang melibatkan format input dan output multimodal seperti audio dan teks, coba contoh kode berikut:
- Membuat transkrip wawancara audio.
- Membuat podcast dengan beberapa pembicara menggunakan Gemini dan Text-to-Speech API.
- Merekam audio dan membuat terjemahan.
Langkah berikutnya
- Jelajahi lainnya panduan arsitektur AI generatif.
- Untuk ringkasan prinsip dan rekomendasi arsitektur yang khusus untuk workload AI dan ML di Google Cloud, lihat Perspektif AI dan ML dalam Well-Architected Framework.
- Untuk mengetahui lebih banyak tentang arsitektur referensi, diagram, dan praktik terbaik lainnya, jelajahi Pusat Arsitektur Cloud.
Kontributor
Penulis: Kumar Dhanagopal | Developer Solusi Lintas Produk
Kontributor lainnya:
- Amina Mansour | Tech Lead, Global Developer Relations & Strategic Content
- Megan O'Keefe | Developer Advocate
- Samantha He | Technical Writer
- Shir Meir Lador | Developer Relations Engineering Manager