


Ce document fournit une architecture de haut niveau pour une application qui utilise l'IA pour générer des podcasts à partir d'une entrée audio.
Ce document s'adresse aux architectes, aux développeurs et aux administrateurs qui créent et gèrent des applications d'IA générative dans le cloud pour les secteurs des médias et du marketing. Ce document suppose que vous possédez des connaissances de base sur l'IA générative.
La section Déploiement de ce document fournit des exemples de code pour les charges de travail d'IA générative qui impliquent des formats d'entrée et de sortie multimodaux.
Architecture
Le schéma suivant montre l'architecture d'une application de production de podcasts dans Google Cloud. L'application utilise l'IA pour générer des podcasts à partir de fichiers audio, comme des commentaires en direct pour un événement sportif.
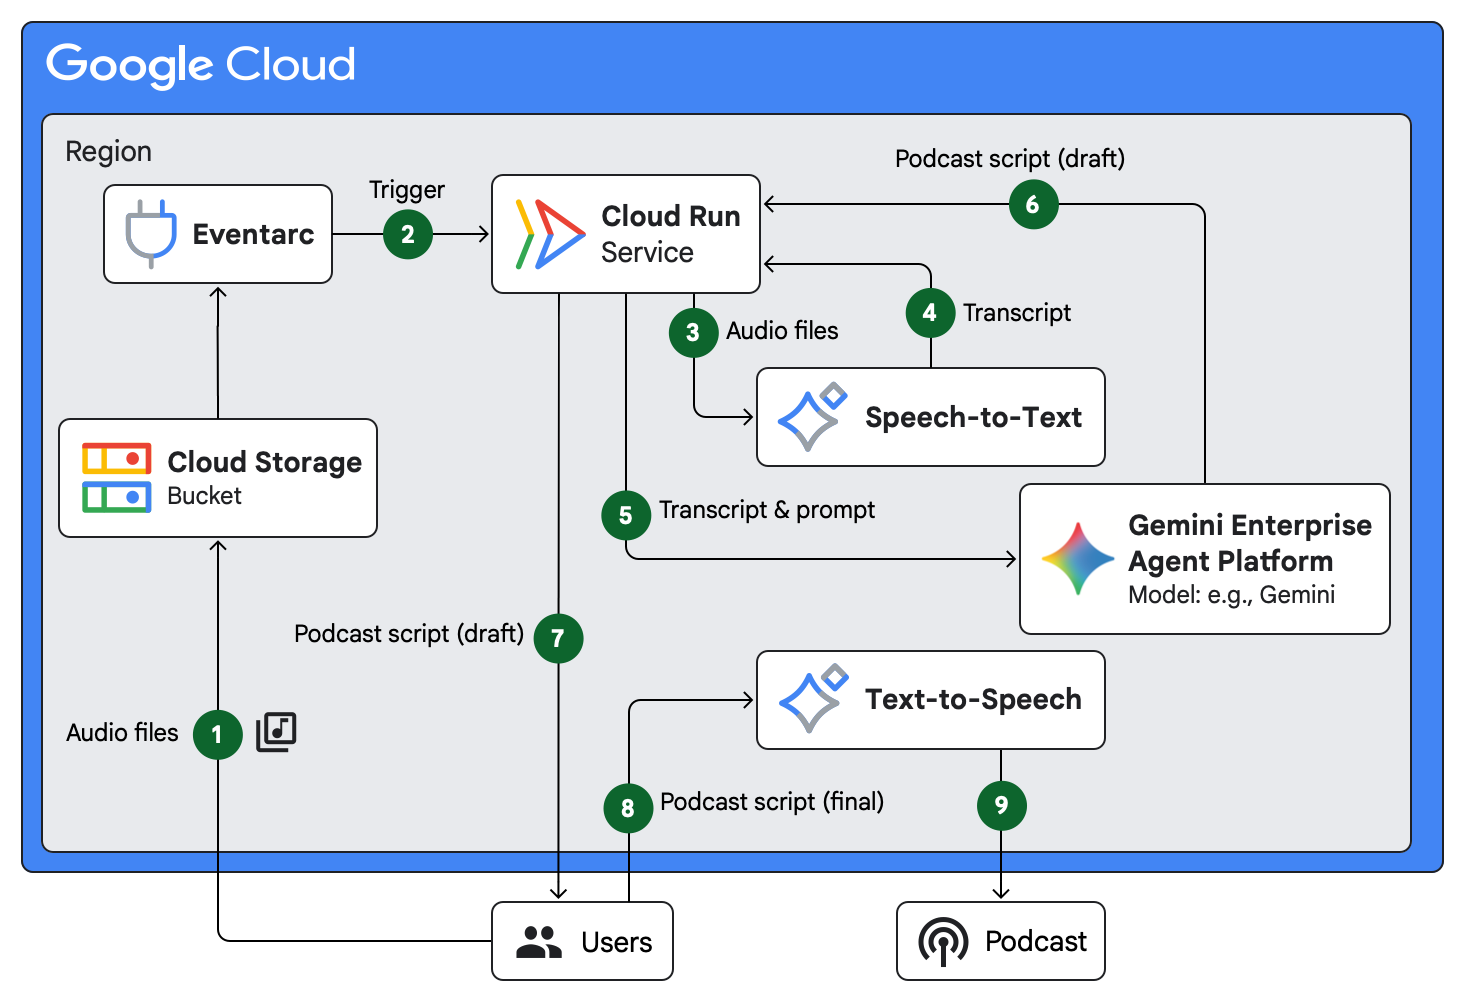
L'architecture présente le flux suivant :
- Un utilisateur importe des fichiers audio dans un bucket Cloud Storage.
- Eventarc déclenche un service Cloud Run.
- Le service Cloud Run envoie les fichiers audio à Speech-to-Text.
- Speech-to-Text produit des transcriptions horodatées des fichiers audio.
Le service Cloud Run envoie les transcriptions à Gemini Enterprise Agent Platform, avec un prompt pour générer un script pour un podcast.
Par exemple, la requête peut consister à générer un script pour un podcast de 15 minutes sur les temps forts d'un événement sportif en fonction de certains mots clés dans les commentaires.
Un modèle Gemini sur Agent Platform génère un brouillon de script de podcast.
Le service Cloud Run envoie le brouillon du script à l'utilisateur.
L'utilisateur examine et modifie le brouillon du script, puis envoie le script final à Text-to-Speech.
Text-to-Speech produit un fichier audio de podcast.
Produits utilisés
Cet exemple d'architecture utilise les produits Google Cloud suivants :
- Speech-to-Text : API qui utilise les technologies de reconnaissance vocale de Google pour transcrire du contenu audio en texte.
- Gemini Enterprise Agent Platform : plate-forme complète qui vous permet de créer, de faire évoluer, de gérer et d'optimiser des agents IA de niveau entreprise.
- Text-to-Speech : API permettant de créer une voix humaine synthétique aux sonorités naturelles à partir de texte.
- Cloud Storage : store d'objets économique et sans limite pour tout type de données. Les données sont accessibles depuis et en dehors de Google Cloud, et sont répliquées sur plusieurs emplacements à des fins de redondance.
- Cloud Run : plate-forme de calcul gérée qui vous permet d'exécuter des conteneurs directement sur l'infrastructure évolutive de Google.
- Eventarc : solution sans serveur permettant d'acheminer de manière asynchrone les messages déclenchés par des événements.
Considérations de conception
Cette section décrit les facteurs de conception, les bonnes pratiques et les recommandations conformément au Google Cloud Well-Architected Framework. Tenez compte de ces informations lorsque vous utilisez cette architecture de référence pour développer une topologie répondant à vos exigences spécifiques en termes de sécurité, de fiabilité, d'optimisation des coûts et d'efficacité opérationnelle.
Sécurité, confidentialité et conformité
Pour sécuriser votre charge de travail de génération de podcasts et répondre à vos exigences de confidentialité et de conformité, tenez compte des recommandations suivantes :
- Pour filtrer les prompts, les transcriptions et les scripts de podcast afin de détecter les injections de prompt, les tentatives de jailbreaking et les contenus nuisibles, utilisez Model Armor. Pour détecter et masquer les informations permettant d'identifier personnellement l'utilisateur dans les transcriptions et les brouillons de scripts avant la synthèse, utilisez Sensitive Data Protection.
- Pour respecter le principe du moindre privilège, attribuez des comptes de service IAM (Identity and Access Management) dédiés au déclencheur Eventarc et au service Cloud Run. Pour limiter l'accès réseau aux appelants et aux réviseurs autorisés, configurez les contrôles d'entrée Cloud Run et exigez l'authentification IAM.
Fiabilité
Pour garantir un traitement fiable des commentaires longs et de la synthèse de podcasts, tenez compte des recommandations suivantes :
- Pour transcrire de manière fiable de longs enregistrements de commentaires, envisagez un traitement par lot asynchrone. Pour en savoir plus, consultez Transcrire en texte des fichiers audio longs.
- Pour synthétiser des épisodes complets, divisez les scripts en segments plus petits ou utilisez la synthèse audio longue, puis stockez l'audio de sortie dans Cloud Storage.
- Étant donné qu'Eventarc relance les distributions non confirmées, le traitement multimédia synchrone de plusieurs minutes dans un gestionnaire HTTP Cloud Run peut entraîner des délais avant expiration et des tâches en double. Pour dissocier la diffusion d'événements du traitement de longue durée, orchestrez des tâches en plusieurs étapes avec Workflows ou exécutez des charges de travail par lot dans des jobs Cloud Run.
Optimisation des coûts
Pour optimiser le coût de la génération de scripts et de la synthèse audio de podcasts, tenez compte des recommandations suivantes :
- Lorsque les scripts de podcast ne nécessitent pas de génération immédiate, utilisez l'inférence par lot sur Agent Platform. L'inférence par lot traite de manière asynchrone des charges de travail de transcription volumineuses à un coût inférieur à celui de l'inférence en ligne standard.
- Pour réduire les coûts de synthèse pour la production de podcasts à volume élevé, choisissez un modèle approprié en fonction de vos besoins sur Agent Platform.
Efficacité opérationnelle
Pour optimiser votre pipeline multimodal et simplifier la production audio avec plusieurs locuteurs, tenez compte des recommandations suivantes :
- Pour simplifier le pipeline lorsque vous n'avez pas besoin de fonctionnalités Speech-to-Text spécialisées, transmettez les URI audio Cloud Storage directement à Gemini sur Agent Platform. Grâce à la compréhension audio multimodale, Gemini peut analyser de longs fichiers audio avec compréhension des codes temporels et rédiger des scripts de podcast en une seule étape. Conservez Speech-to-Text avec des modèles de transcription spécialisés lorsque votre charge de travail nécessite une segmentation du locuteur par lot ou une adaptation du modèle pour des noms spécifiques à un domaine.
- Pour produire des podcasts conversationnels avec plusieurs hôtes sans réglage SSML complexe, utilisez Gemini TTS sur Agent Platform. Si votre application appelle directement Text-to-Speech, vous pouvez également utiliser Gemini TTS ou d'autres voix conversationnelles pour un contrôle vocal naturel. Pour en savoir plus, consultez Voix et langues compatibles.
Déploiement
Pour tester l'utilisation des produits Google Cloud pour des charges de travail impliquant des formats d'entrée et de sortie multimodaux tels que l'audio et le texte, essayez les exemples de code suivants :
- Générer une transcription d'une interview audio
- Générer un podcast avec plusieurs intervenants à l'aide de Gemini et de l'API Text-to-Speech
- Enregistrez un contenu audio et générez une traduction.
Étapes suivantes
- Découvrez d'autres guides d'architecture d'IA générative.
- Pour obtenir une présentation des principes et des recommandations d'architecture spécifiques aux charges de travail d'IA et de ML dans Google Cloud, consultez la perspective IA et ML dans le Well-Architected Framework.
- Pour découvrir d'autres architectures de référence, schémas et bonnes pratiques, consultez le Centre d'architecture cloud.
Contributeurs
Auteur : Kumar Dhanagopal | Cross-product solution developer
Autres contributeurs :
- Amina Mansour | Tech Lead, Global Developer Relations & Strategic Content
- Megan O'Keefe | Developer Advocate
- Samantha He | Rédactrice technique
- Shir Meir Lador | Responsable ingénierie des relations avec les développeurs