


Vector Search 是強大的向量搜尋引擎,採用 Google 研究 開發的創新技術。Vector Search 採用 ScaNN 演算法,可讓您建構新一代搜尋和推薦系統,以及生成式 AI 應用程式。
您可以運用與 Google 核心產品 (包括 Google 搜尋、YouTube 和 Google Play) 相同的研究和技術。這代表您能享有可靠的可擴充性、可用性和效能,在全球範圍內處理大量資料集,並以極快的速度取得結果。有了向量搜尋,您就能使用企業級解決方案,在自己的應用程式中導入先進的語意搜尋功能。
|
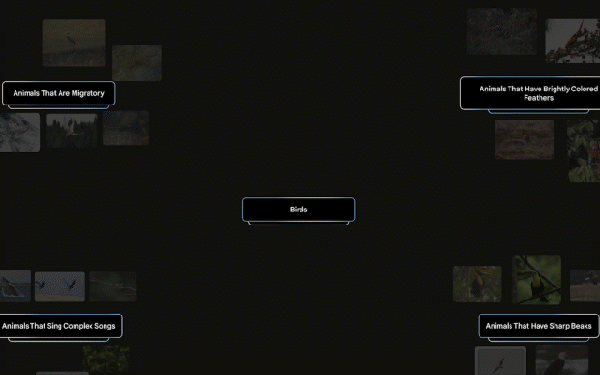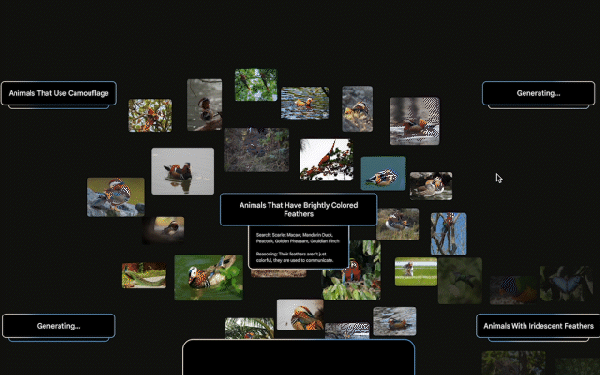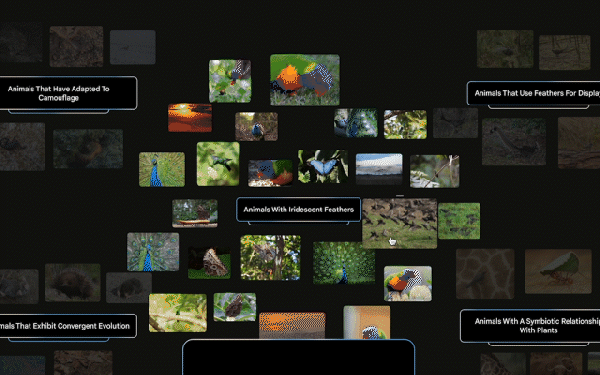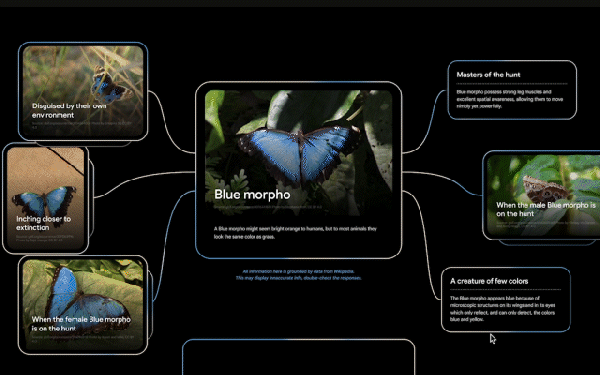
|
|
|
開始使用
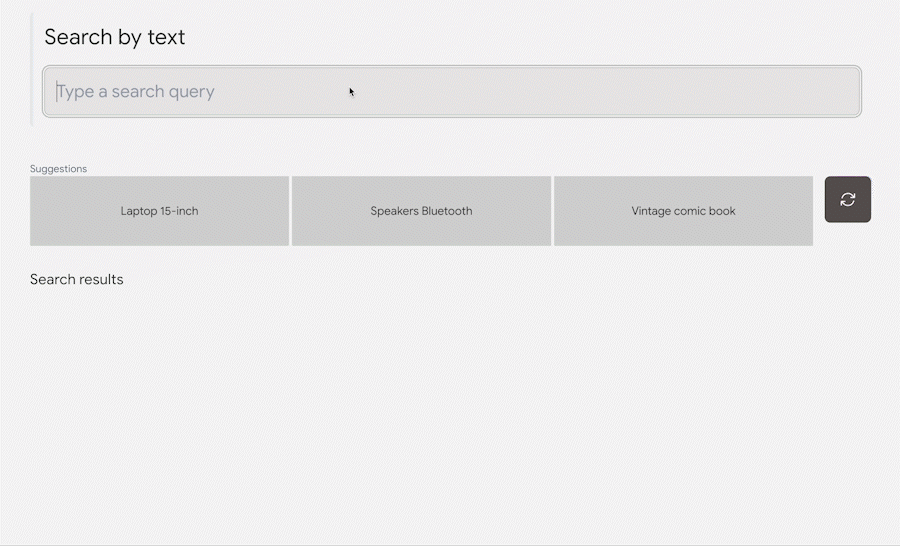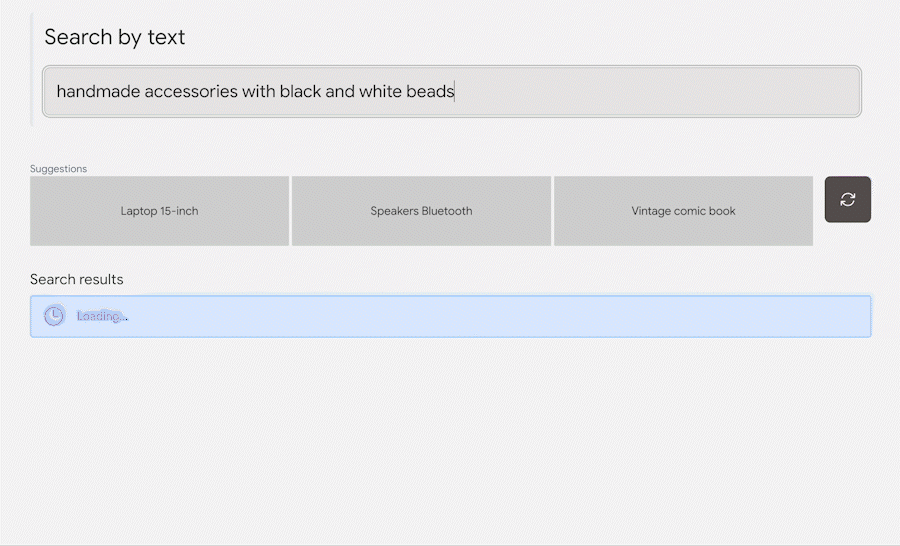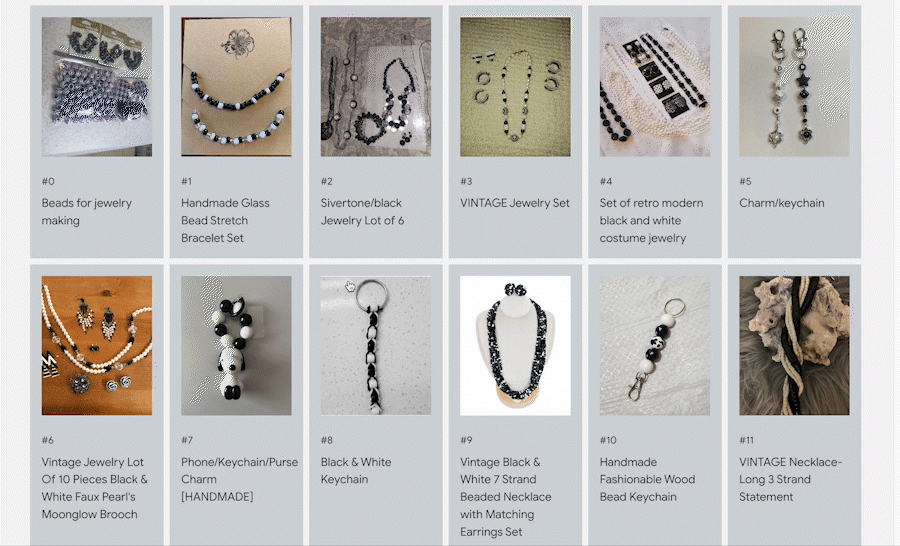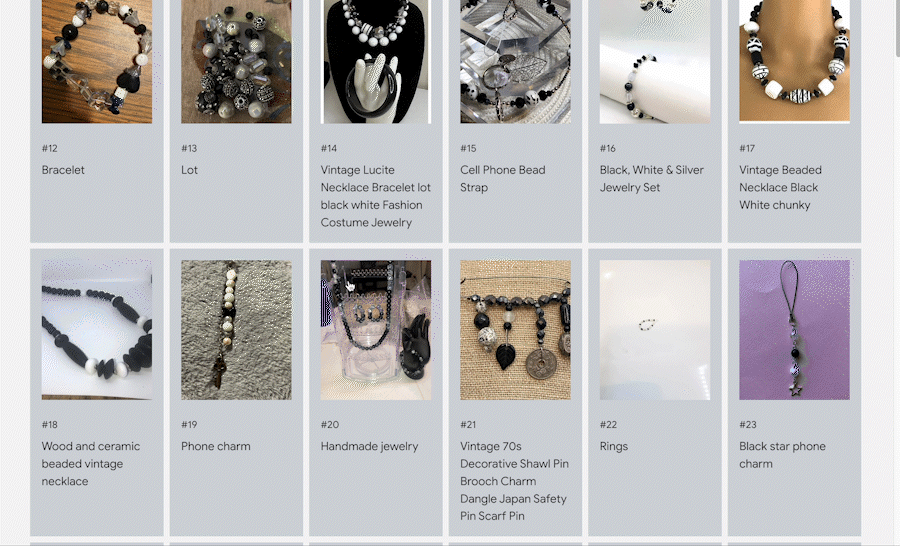
Vector Search 互動式示範:觀看實際示範,瞭解向量搜尋技術的實際應用,並開始使用 Vector Search。
向量搜尋快速入門導覽課程:使用範例資料集建構、部署及查詢向量搜尋索引,在 30 分鐘內試用向量搜尋。本教學課程涵蓋設定、資料準備、建立索引、部署、查詢和清除作業。
事前準備:選擇並訓練模型,然後準備資料,藉此準備嵌入。接著,選擇要將查詢索引部署至公開或私人端點。
向量搜尋定價和 Pricing Calculator:向量搜尋定價包含託管已部署索引的虛擬機器費用,以及建構和更新索引的費用。即使是最低限度的設定 (每月不到 $100 美元),也能為中等規模的用途提供高處理量。如要預估每月費用,請按照下列步驟操作:
- 前往 Google Cloud的 Pricing Calculator。
- 按一下「新增至估算項目」。
- 搜尋 Gemini Enterprise Agent Platform。
- 點按「Gemini Enterprise Agent Platform」按鈕。
- 從「Service type」(服務類型) 下拉式選單中,選取「Gemini Enterprise Agent Platform Vector Search」(Gemini Enterprise Agent Platform 向量搜尋)。
- 您可以保留預設設定,也可以自行設定。「Cost details」(費用明細) 面板會顯示每月預估費用。
說明文件
應用實例和網誌
向量搜尋技術正成為企業使用 AI 的核心。類似於 IT 系統中的關聯式資料庫,它會根據相關性連結各種業務元素,例如文件、內容、產品、使用者、事件和其他實體。除了搜尋文件和圖片等傳統媒體,向量搜尋還能提供智慧型建議、為業務問題找出解決方案,甚至將 IoT 訊號連結至監控快訊。這項多功能工具是不可或缺的利器,可協助您掌握日益成長的由 AI 技術支援企業資料。
|
搜尋/資訊檢索
推薦 |
Gemini Enterprise Agent Platform 向量搜尋如何協助打造高效能生成式 AI 應用程式:向量搜尋可支援多種應用程式,包括電子商務、RAG 系統、推薦引擎、聊天機器人、多模態搜尋等。混合型搜尋可進一步提升利基字詞的搜尋結果。 Bloomreach、eBay 和 Mercado Libre 等客戶使用 Gemini Enterprise Agent Platform,是因為其效能、擴充性和成本效益,並獲得更快的搜尋速度和更高的轉換率等效益。 eBay 使用向量搜尋提供推薦內容:重點說明 eBay 如何使用向量搜尋建立推薦系統。這項技術可讓 eBay 在龐大的目錄中找到類似產品,提升使用者體驗。 Mercari 運用 Google 的向量搜尋技術建立新的市集:說明 Mercari 如何運用向量搜尋改善新的市集平台。向量搜尋則為平台的推薦功能提供技術支援,協助使用者更有效率地找到相關產品。 Gemini Enterprise Agent Platform Embeddings for Text:輕鬆為 LLM 建立基準: 著重於使用 Gemini Enterprise Agent Platform Embeddings 為文字資料建立 LLM 基準。 向量搜尋在尋找相關文字段落時扮演重要角色,可確保模型回覆有事實依據。 What is Multimodal Search: "LLMs with vision" change businesses: 討論多模態搜尋,結合 LLM 與視覺理解。 說明向量搜尋如何處理及比較文字和圖片資料,提供更全面的搜尋體驗。 Unlock multimodal search at scale: Combine text & image power with Gemini Enterprise Agent Platform: 說明如何使用 Gemini Enterprise Agent Platform 建構多模態搜尋引擎,並透過加權 Rank-Biased Reciprocal Rank 整合方法,結合文字和圖片搜尋。這有助於改善使用者體驗,並提供更相關的結果。 使用 TensorFlow Recommenders 和 向量搜尋 擴充深度檢索: 說明如何使用 TensorFlow Recommenders 和 向量搜尋 建構播放清單推薦系統,涵蓋深度檢索模型、訓練、部署和擴充。 |
|
生成式 AI:RAG 和代理的檢索功能 |
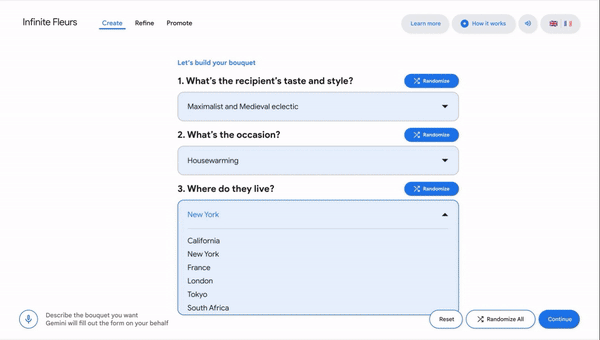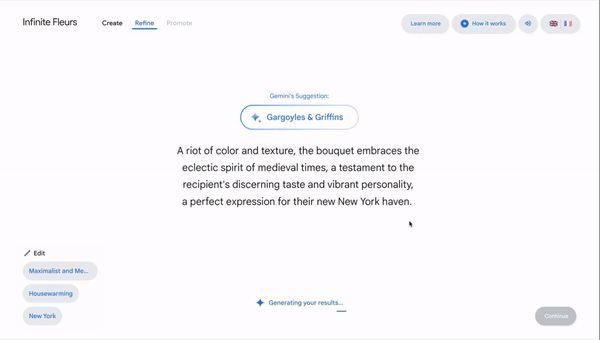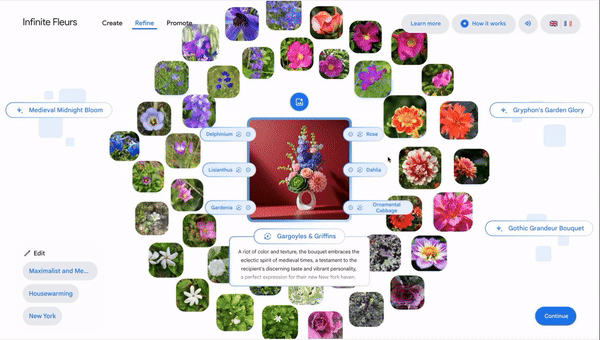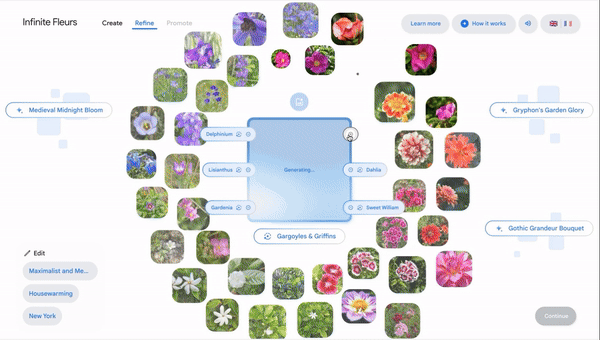
Gemini Enterprise Agent Platform 和 Denodo 運用生成式 AI 釋放企業資料價值: 展示 Gemini Enterprise Agent Platform 與 Denodo 整合後,企業如何運用生成式 AI 從資料中取得洞察資訊。向量搜尋是在企業環境中有效率地存取及分析相關資料的關鍵。 Infinite Nature and the nature of industries: This 'wild' demo shows the diverse possibilities of AI: 展示 AI 在不同產業的潛力。 這項服務運用向量搜尋,提供生成式推薦和多模態語意搜尋功能。 Infinite Fleurs:探索 AI 輔助創意,盡情綻放: Google 的 Infinite Fleurs 是一項 AI 實驗,使用向量搜尋和 Gemini 模型,根據使用者提示生成獨特的花束。這項技術展現了 AI 激發各行各業創意的潛力。 Google Cloud 上的 LlamaIndex for RAG: 說明如何使用 LlamaIndex 搭配大型語言模型,促進檢索增強生成 (RAG)。LlamaIndex 會使用向量搜尋從知識庫擷取相關資訊,生成更準確且符合情境的回覆。 Gemini Enterprise Agent Platform 的 RAG 和建立基準: 檢視 Gemini Enterprise Agent Platform 的 RAG 和建立基準技術。 向量搜尋有助於在檢索期間找出相關的基準資訊,讓生成的內容更準確可靠。 LangChain 上的向量搜尋:提供指南,說明如何搭配使用向量搜尋和 LangChain,建構及部署文字資料的向量資料庫索引,包括問答和 PDF 處理。 |
|
商業智慧、資料分析、監控等 |
Enabling real-time AI with Streaming Ingestion in Agent Platform: 探索 Vector Search 的串流更新功能,以及如何提供即時 AI 功能。這項技術可即時處理及分析傳入的資料串流。 |
相關資源
您可以參考下列資源,開始使用向量搜尋:
筆記本和解決方案
|
|
|
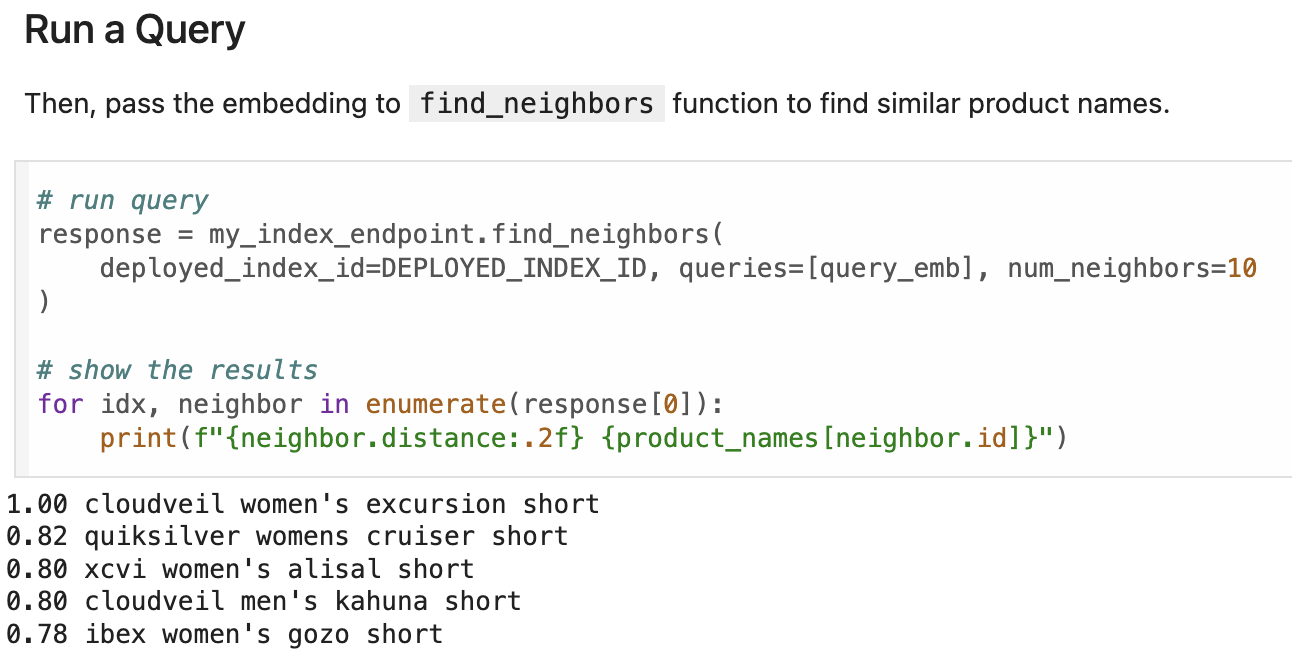
Agent Platform 向量搜尋快速入門導覽課程:提供向量搜尋總覽。適合剛接觸平台且想快速上手的使用者。 |
開始使用文字嵌入和向量搜尋: 介紹文字嵌入和向量搜尋。說明這些技術的運作方式,以及如何用來改善搜尋結果。 |
|
|
|
結合語意和關鍵字搜尋:Gemini Enterprise Agent Platform 向量搜尋的混合型搜尋教學課程: 提供如何使用向量搜尋執行混合型搜尋的操作說明。 包括設定及配置混合型搜尋系統的步驟。 |
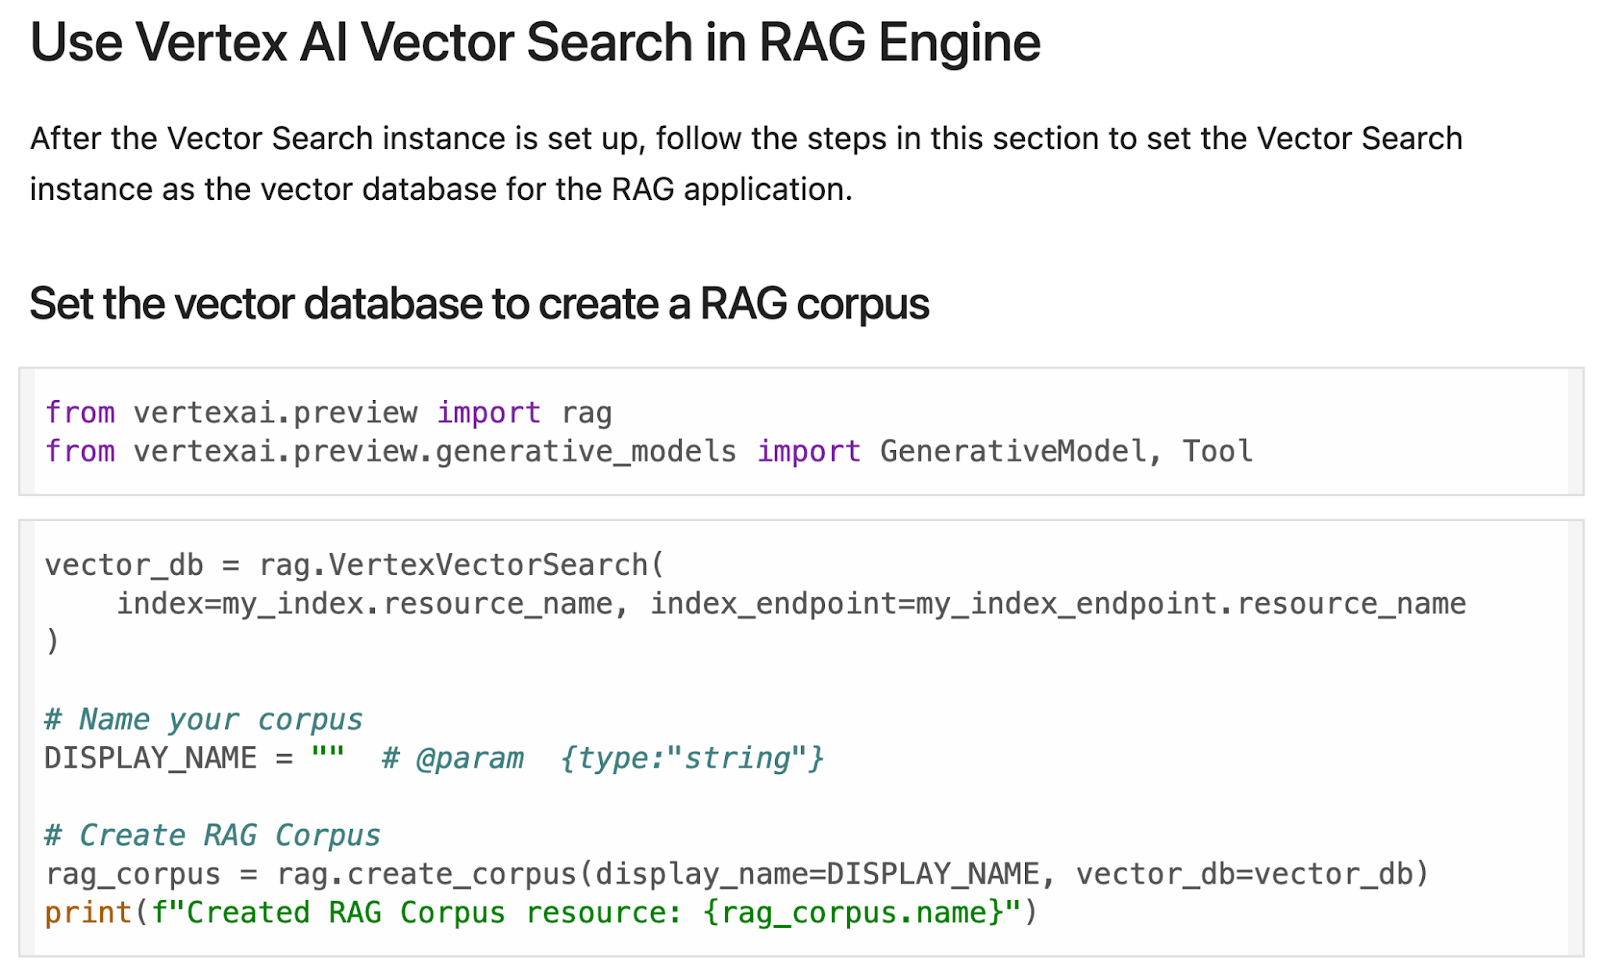
Gemini Enterprise Agent Platform 的 RAG Engine 搭配向量搜尋: 探索如何搭配使用 RAG Engine 與向量搜尋。 本文將探討同時使用這兩項技術的好處,並舉例說明如何在實際應用中使用。 |
|
|
|
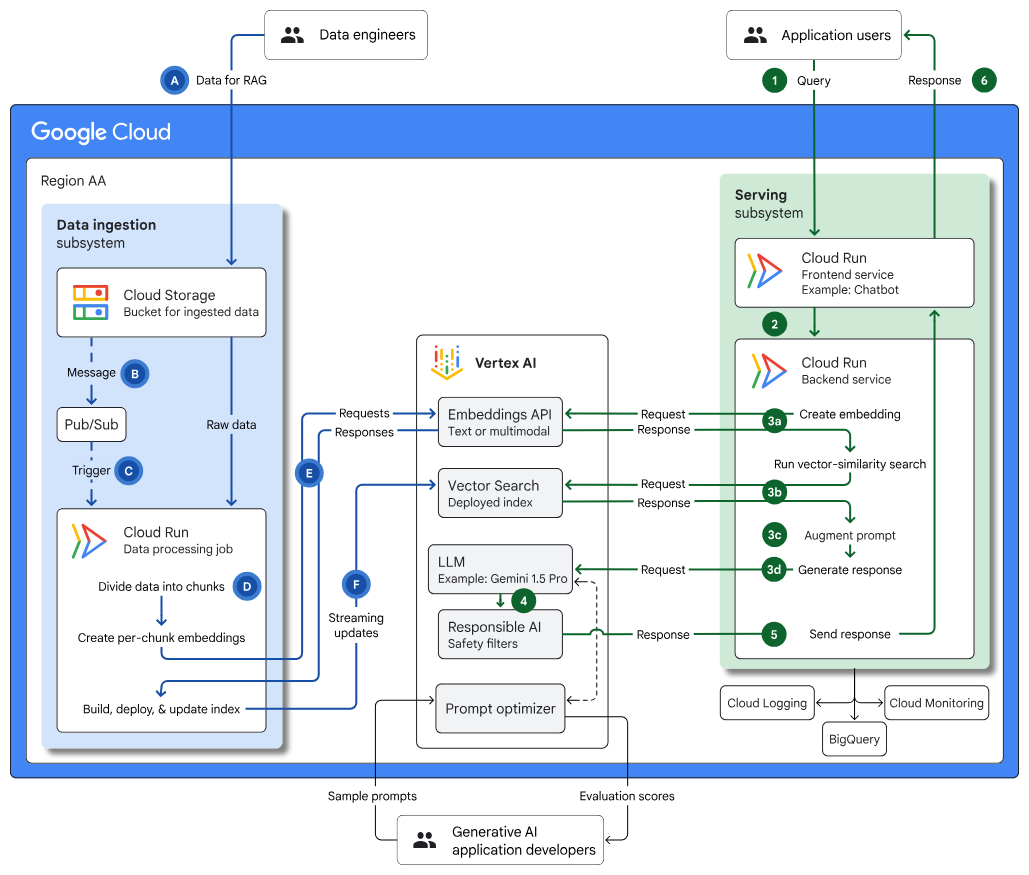
使用 Gemini Enterprise Agent Platform 和 向量搜尋 建構具備 RAG 功能的生成式 AI 應用程式基礎架構:詳細說明使用 向量搜尋、Cloud Run 和 Cloud Storage 建構生成式 AI 應用程式和 RAG 的架構,涵蓋用途、設計選擇和考量重點。 |
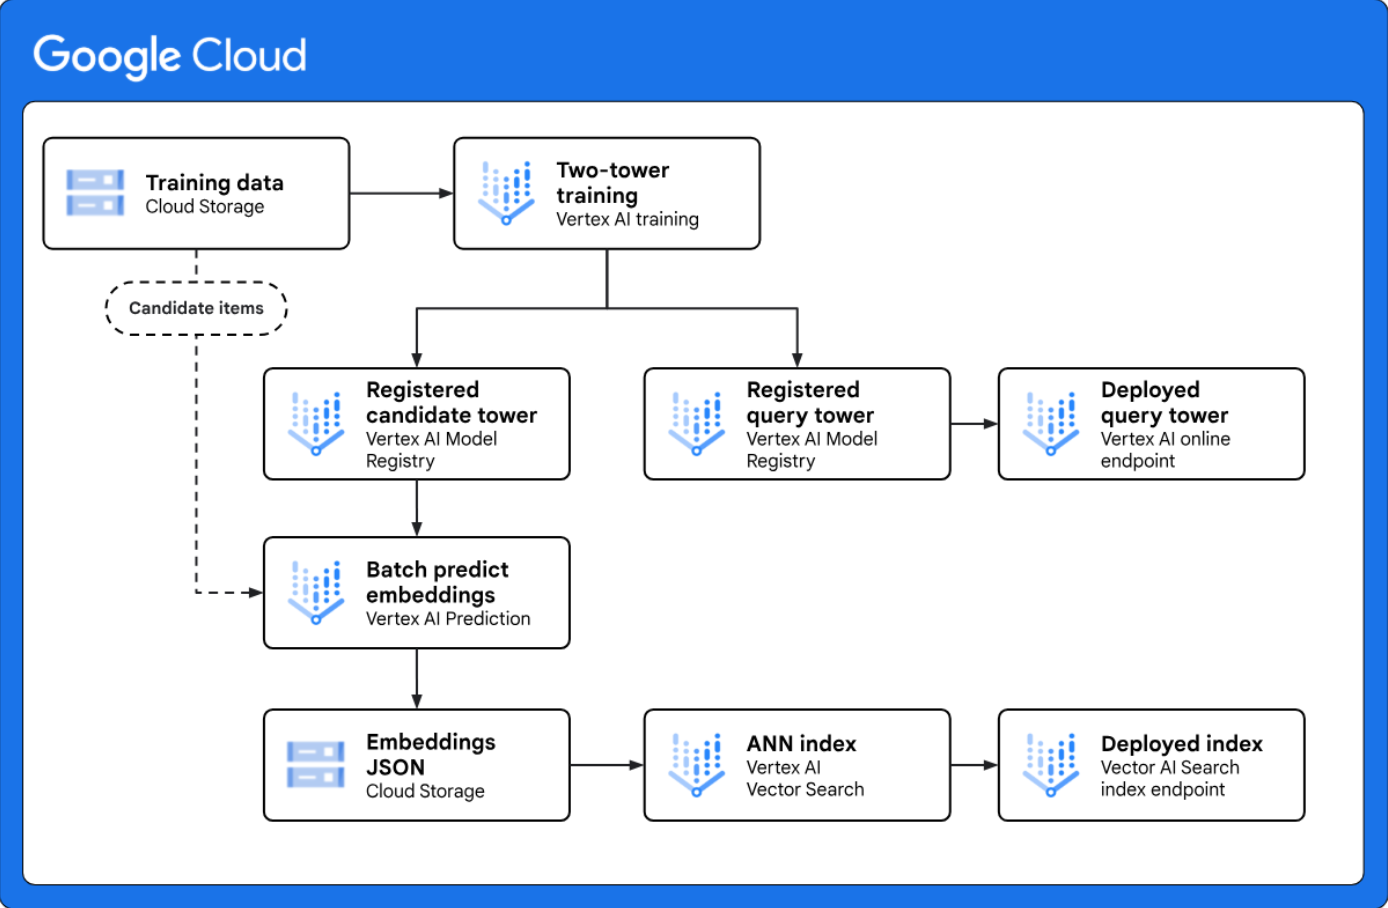
實作雙塔檢索,大規模生成候選項目: 提供參考架構,說明如何使用 Gemini Enterprise Agent Platform 實作端對端雙塔候選項目生成工作流程。 雙塔模型架構是強大的檢索技術,適用於個人化用途,因為它會學習兩個不同實體之間的語意相似度,例如網路查詢和候選項目。 |
訓練
開始使用 Vector Search 和嵌入 Vector Search 可用於尋找相似或相關的項目。可用於推薦、搜尋、聊天機器人和文字分類。這項程序包括建立嵌入、上傳至 Google Cloud,以及建立索引以供查詢。本實驗室著重於使用 Gemini Enterprise Agent Platform 建立文字嵌入,但您也可以為其他資料類型生成嵌入。
向量搜尋和嵌入 本課程旨在介紹向量搜尋,並說明如何透過大型語言模型 (LLM) API 生成嵌入,運用這項服務建構搜尋應用程式。這堂課程涵蓋概念課程、實際示範與實作實驗室。概念課程將說明向量搜尋和文字嵌入;實際示範則會演示如何透過 Gemini Enterprise Agent Platform 建構向量搜尋。
瞭解及套用文字嵌入
Gemini Enterprise Agent Platform Embeddings API 會生成文字嵌入,也就是
文字的數值表示法,用於識別相似項目等工作。
在本課程中,您將使用文字嵌入執行分類和語意搜尋等工作,並結合語意搜尋與 LLM,透過 Gemini Enterprise Agent Platform 建構問答系統。
機器學習密集課程:嵌入 本課程介紹字詞嵌入,並與稀疏表示法進行比較。本單元將探討取得嵌入的方法,並區分靜態和內容比對嵌入。
相關產品
Gemini Enterprise Agent Platform Embeddings 提供 Embeddings API 總覽。文字和多模態嵌入的使用案例,以及其他資源和相關服務的連結。 Google Cloud
Agent Search ranking API 排名 API 會使用預先訓練的語言模型,根據與查詢的關聯性重新排名文件,並提供精確的分數。適合用來改善各種來源 (包括向量搜尋) 的搜尋結果。
Gemini Enterprise Agent Platform 特徵儲存庫 可讓您使用 BigQuery 做為資料來源,管理及提供特徵資料。這項功能會佈建線上提供所需的資源,並做為中繼資料層,直接從 BigQuery 提供最新的特徵值。Agent Platform 特徵儲存庫可立即擷取 Vector Store 傳回的查詢項目特徵值。
Agent Platform Pipelines Agent Platform Pipelines 可讓您透過機器學習管道自動調度管理機器學習工作流程,以無伺服器的方式自動化、監控及管理機器學習系統。您可以批次執行使用 Kubeflow Pipelines 或 TensorFlow Extended (TFX) 架構定義的機器學習管道。Pipelines 可建構自動化管道,生成嵌入、建立及更新向量搜尋索引,並為正式環境搜尋和推薦系統建立 MLOps 設定。
深入解析資源
運用 Gemini Enterprise Agent Platform 嵌入和工作類型強化生成式 AI 應用實例 著重於使用 Gemini Enterprise Agent Platform 嵌入和工作類型,改善生成式 AI 應用程式。Vector Search 可與任務類型嵌入搭配使用,找出更相關的資訊,提升生成內容的脈絡和準確度。
TensorFlow Recommenders 用於建構推薦系統的開放原始碼程式庫。這項服務可簡化從資料準備到部署的流程,並支援彈性建構模型。TFRS 提供教學課程和資源,可建立複雜的推薦模型。
TensorFlow Ranking TensorFlow Ranking 是開放原始碼程式庫,可用來建構可擴充的類神經排序學習 (LTR) 模型。支援多種損失函式和排名指標,適用於搜尋、推薦和其他領域。這個程式庫由 Google AI 積極開發。
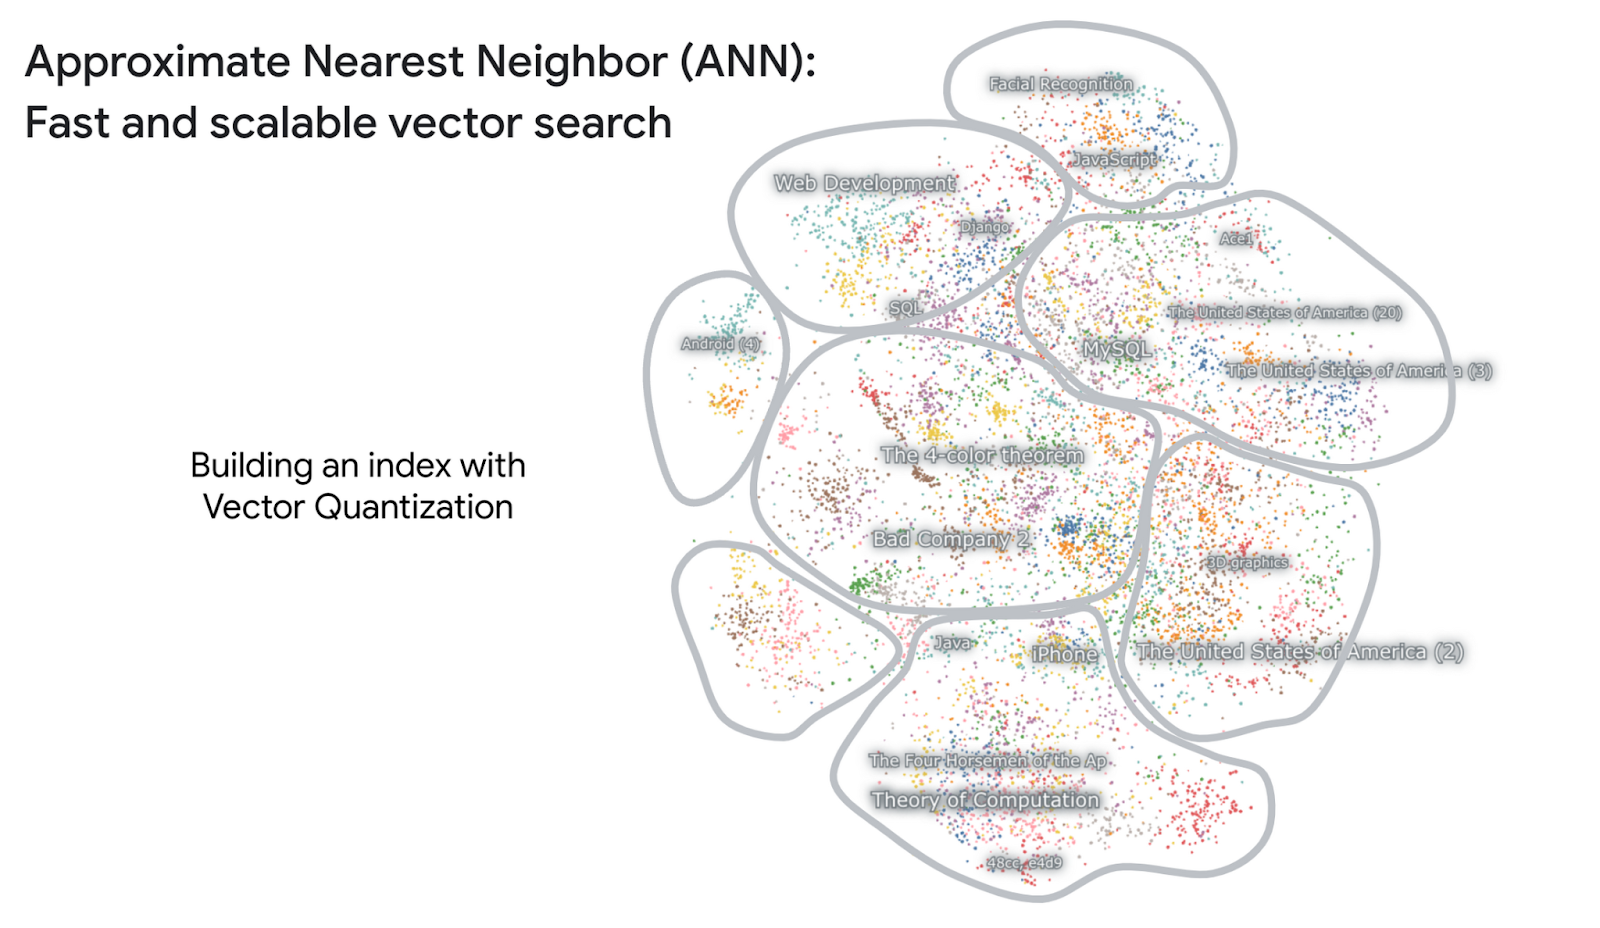
隆重推出 ScaNN:高效率的向量相似度搜尋 Google 的 ScaNN 演算法可有效率地搜尋向量相似度,並採用新穎技術,提高尋找最鄰近項目的準確度和速度。這項技術優於現有方法,廣泛應用於需要語意搜尋的機器學習工作。Google 的研究工作涵蓋多個領域,包括基礎機器學習和 AI 的社會影響。
SOAR:全新演算法,搭配 ScaNN 加快向量搜尋速度 Google 的 SOAR 演算法導入受控備援機制,可提升向量搜尋效率,以較小的索引加快搜尋速度。SOAR 會將向量指派給多個叢集,建立「備份」搜尋路徑,提高效能。
相關影片
向量搜尋是建構 AI 輔助應用程式的強大工具。這部影片將介紹這項技術,並提供逐步指南。
Vector Search 可用於混合型搜尋,結合向量搜尋的強大功能,以及傳統搜尋引擎的彈性和速度。這部影片會介紹混合型搜尋,並說明如何使用向量搜尋執行混合型搜尋。
您已在使用向量搜尋!Here's How to Be an Expert
您知道嗎?您可能每天都在使用向量搜尋,只是未曾發覺。 無論是在社群媒體上尋找難以找到的產品,還是追蹤腦海中揮之不去的歌曲,向量搜尋都是這些日常體驗背後的 AI 魔法。
DeepMind 團隊推出全新「工作類型」嵌入,提升 RAG 搜尋品質
Google DeepMind 團隊開發了新的工作類型嵌入,可提升 RAG 系統的準確度和關聯性。觀看期間,您將瞭解 RAG 搜尋品質的常見挑戰,以及工作類型嵌入如何有效縮小問題與答案之間的語意差距,進而提升檢索效率和 RAG 效能。
向量搜尋術語
以下列出使用向量搜尋時,必須瞭解的一些重要術語:
向量:向量是浮點值清單,具有大小和方向。可用來表示任何類型的資料,例如數字、空間中的點和方向。
嵌入:嵌入是一種向量,用於表示資料,並擷取其語意。嵌入通常是使用機器學習技術建立,常用於自然語言處理 (NLP) 和其他機器學習應用程式。
稠密嵌入:稠密嵌入使用主要包含非零值的陣列,代表文字的語意。使用密集嵌入時,系統會根據語意相似度傳回相似的搜尋結果。
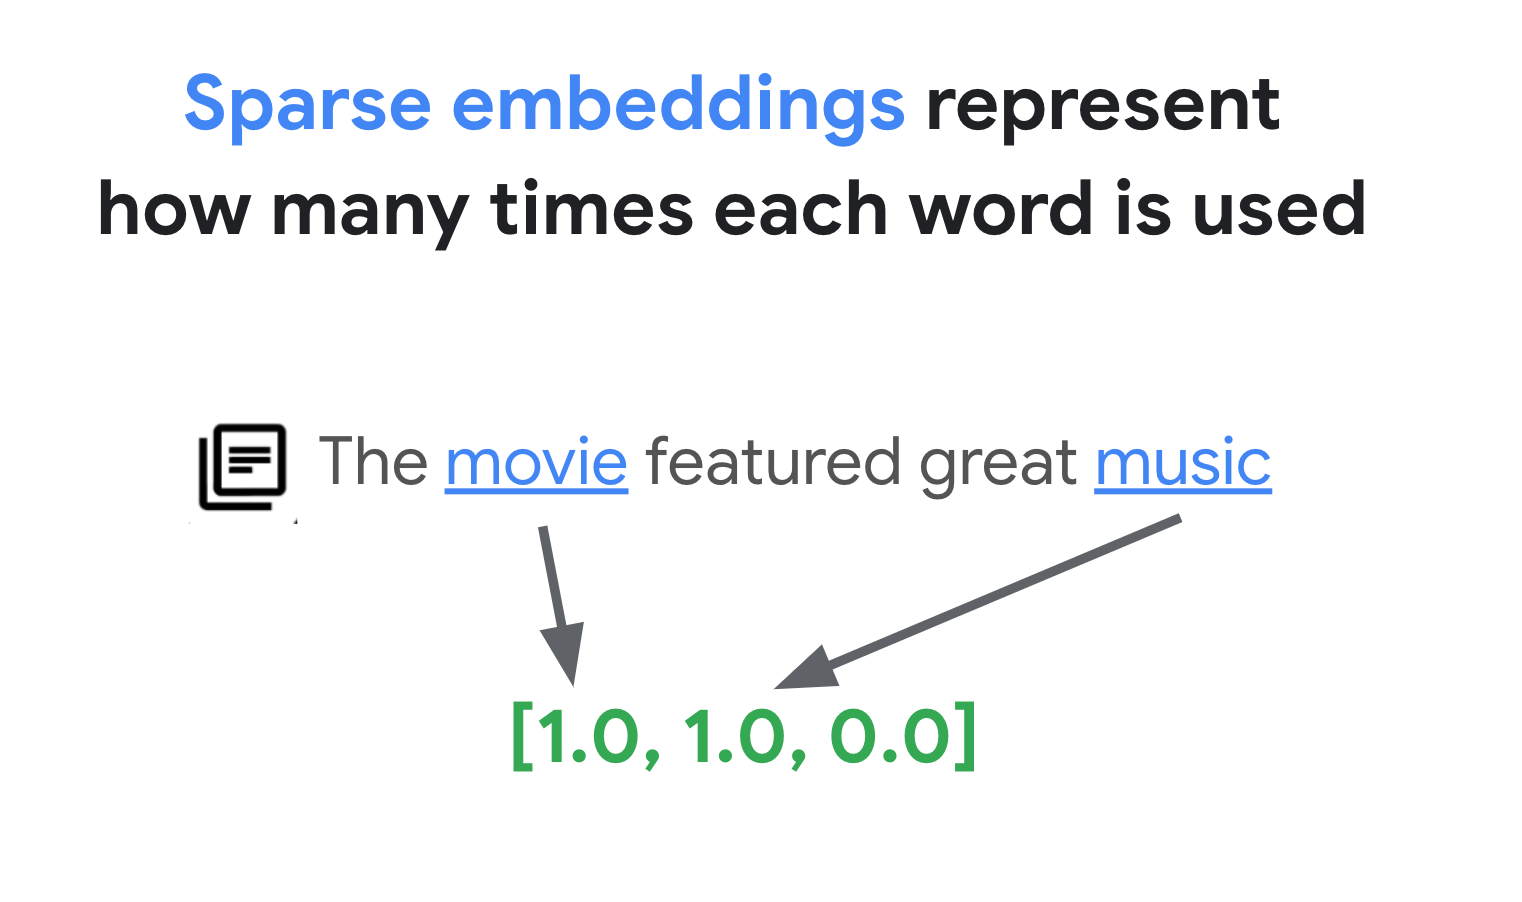
稀疏嵌入:稀疏嵌入代表文字語法,使用高維度陣列,其中非零值比稠密嵌入少得多。稀疏嵌入通常用於關鍵字搜尋。
混合型搜尋:混合型搜尋會同時使用稠密和稀疏嵌入,可讓您結合關鍵字搜尋和語意搜尋。向量搜尋支援以密集嵌入、稀疏嵌入和混合型搜尋為基礎的搜尋。
索引:一組共同部署的向量,用於相似度搜尋。向量可以新增至索引,也可以從索引中移除。相似度搜尋查詢會傳送至特定索引,並搜尋該索引中的向量。
基準真相:這個詞彙是指根據現實世界驗證機器學習的準確度,例如基準真相資料集。
喚回度:索引傳回的最鄰近項目中,實際為最鄰近項目的百分比。舉例來說,如果查詢 20 個最鄰近項目,傳回 19 個基準真相最鄰近項目,則喚回度為 19/20x100 = 95%。
限制:這項功能可使用布林值規則,將搜尋範圍限制在索引的子集。限制也稱為「篩選」。使用向量搜尋時,您可以使用數值篩選和文字屬性篩選。