


在 Gemini Enterprise Agent Platform 向量搜尋快速入門導覽課程中,您將瞭解如何使用虛構電子商務服飾網站的範例資料集建立索引。在本快速入門導覽課程中,嵌入項目已建立完成。本快速入門導覽課程旨在協助您在 30 分鐘內開始建立及部署索引。
必要條件
本教學課程需要 Google Cloud 專案,且該專案必須連結至帳單帳戶。如要建立新專案,請參閱「設定專案和開發環境」。您必須建立專案並設定帳單帳戶。
選擇執行階段環境
本教學課程可在 Colab 或 Gemini Enterprise Agent Platform Workbench 執行。
- Colab:在 Colab 中開啟本教學課程
- Gemini Enterprise Agent Platform Workbench:在 Gemini Enterprise Agent Platform Workbench 中開啟本教學課程。如果這是您第一次在 Google Cloud 專案中使用 Gemini Enterprise Agent Platform Workbench,請前往 Google Cloud 控制台的 Gemini Enterprise Agent Platform Workbench 專區,然後按一下「Enable」(啟用),啟用 Notebooks API。
如要在 GitHub 中查看這個筆記本,請前往 GitHub。
完成這堂快速入門導覽課程的費用
完成本教學課程的費用約為幾美元。如要瞭解本教學課程使用的 Google Cloud 服務定價,請參閱下列頁面:
您也可以使用 Pricing Calculator,根據預測用量估算費用。
設定
開始使用 Gemini Enterprise Agent Platform 前,請先完成下列設定:
安裝 Agent Platform SDK for Python
您可以透過多種方式存取 Gemini Enterprise Agent Platform 和 Cloud Storage API,包括 REST API 和 Agent Platform SDK for Python。本教學課程使用 Agent Platform SDK for Python。
!pip install --upgrade --user google-cloud-aiplatform>=1.29.0 google-cloud-storage
如要在這個 Jupyter 執行階段使用新安裝的套件,請重新啟動執行階段,如以下程式碼片段所示。
# Restart kernel after installs so that your environment can access the new packages
import IPython

app = IPython.Application.instance()
app.kernel.do_shutdown(True)
環境變數
設定環境變數。如果系統要求,請將 your-project-id 替換為專案 ID,然後執行儲存格。
# get project ID
PROJECT_ID = ! gcloud config get-value project
PROJECT_ID = PROJECT_ID[0]
LOCATION = "us-central1"
if PROJECT_ID == "(unset)":
    print(f"Please set the project ID manually below")
# define project information
if PROJECT_ID == "(unset)":
  PROJECT_ID = "[your-project-id]"

# generate a unique id for this session
from datetime import datetime
UID = datetime.now().strftime("%m%d%H%M")
驗證 (僅限 Colab)
如果您是在 Colab 執行這個筆記本,請執行下列儲存格驗證。如果使用 Gemini Enterprise Agent Platform Workbench,則不必執行這個步驟,因為該平台已預先驗證。
import sys

# if it's Colab runtime, authenticate the user with Google Cloud
if 'google.colab' in sys.modules:
    from google.colab import auth
    auth.authenticate_user()
設定 IAM 權限
您必須為預設服務帳戶新增存取權限,才能使用服務。
- 前往 Google Cloud 控制台的「IAM」頁面。
- 找出預設運算服務帳戶的主體。看起來應該像這樣:
compute@developer.gserviceaccount.com - 按一下「編輯」按鈕,並將下列角色授予預設運算服務帳戶:Agent Platform 使用者、Storage 管理員和 Service Usage 管理員。
啟用 API
執行下列指令,為這個 Google Cloud 專案啟用 Compute Engine、Gemini Enterprise Agent Platform 和 Cloud Storage 的 API。
! gcloud services enable compute.googleapis.com aiplatform.googleapis.com storage.googleapis.com --project {PROJECT_ID}
準備範例資料
在本教學課程中,我們使用 TheLook 資料集,其中包含一個產品資料表,內有約 5,000 列虛構電子商務服飾網站的合成產品資料。

我們已根據這個資料表準備好 product-embs.json 檔案。
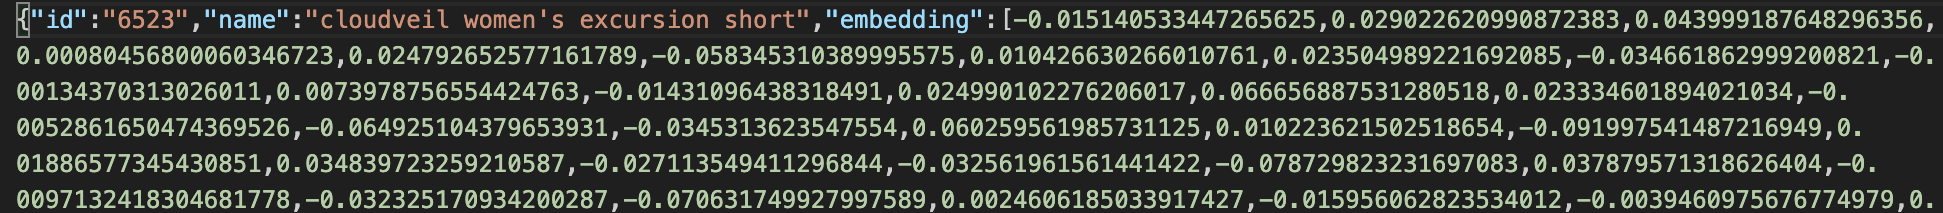
這個檔案採用 JSONL 格式,每列都有產品 ID、產品名稱,以及產品名稱的 768 維嵌入,先前已使用 Gemini Enterprise Agent Platform 文字嵌入功能生成。
文字嵌入代表服飾產品名稱的含義。在本教學課程中,我們會使用 Vector Search 完成項目的語意搜尋。這段程式碼範例可做為其他快速推薦系統的基礎,讓您快速找到「與此產品類似的其他產品」。
如要進一步瞭解如何根據 BigQuery 資料表中的資料建立嵌入,並將其儲存在 JSON 檔案中,請參閱「開始使用文字嵌入 + Gemini Enterprise Agent Platform 向量搜尋」。
準備 Cloud Storage 中的資料
如要使用 Gemini Enterprise Agent Platform 建構索引,請將嵌入檔案放在 Cloud Storage bucket 中。下列程式碼會完成兩項工作:
- 建立 Cloud Storage bucket。
- 將範例檔案複製到 Cloud Storage bucket。
BUCKET_URI = f"gs://{PROJECT_ID}-vs-quickstart-{UID}"
! gcloud storage buckets create $BUCKET_URI --location=$LOCATION --project=$PROJECT_ID
! gcloud storage cp "gs://github-repo/data/vs-quickstart/product-embs.json" $BUCKET_URI
如要使用向量搜尋執行查詢,您也需要將嵌入檔案複製到本機目錄:
! gcloud storage cp "gs://github-repo/data/vs-quickstart/product-embs.json" . # for query tests
建構及部署向量搜尋索引
瞭解如何建立索引、建立索引端點,然後將索引部署至端點。
建立索引
現在可以將嵌入載入向量搜尋。您可以在 SDK 的 aiplatform 套件中找到這些 API。
# init the aiplatform package
from google.cloud import aiplatform
aiplatform.init(project=PROJECT_ID, location=LOCATION)
使用 create_tree_ah_index 函式建立 MatchingEngineIndex (Matching Engine 是 Vector Search 的舊稱)。
# create Index
my_index = aiplatform.MatchingEngineIndex.create_tree_ah_index(
    display_name = f"vs-quickstart-index-{UID}",
    contents_delta_uri = BUCKET_URI,
    dimensions = 768,
    approximate_neighbors_count = 100,
)
MatchingEngineIndex.create_tree_ah_index() 方法會建立索引。如果資料集較小,這項作業會在 10 分鐘內完成,否則可能需要約 60 分鐘或更久,具體時間取決於資料集大小。您可以在 Vector Search Google Cloud 控制台查看索引建立狀態
建立索引的參數:
contents_delta_uri:儲存嵌入 JSON 檔案的 Cloud Storage 目錄 URIdimensions:各個嵌入項目的維度大小。在本例中,由於您使用的是文字嵌入 API 的嵌入,因此維度為 768。approximate_neighbors_count: 一般情況下要擷取的相似項目數量
如要進一步瞭解如何建立索引和可用參數,請參閱「建立及管理索引」
建立索引端點並部署索引
如要使用索引,請建立索引端點。這個端點相當於伺服器執行個體,負責接受針對索引發出的查詢要求。
## create `IndexEndpoint`
my_index_endpoint = aiplatform.MatchingEngineIndexEndpoint.create(
    display_name = f"vs-quickstart-index-endpoint-{UID}",
    public_endpoint_enabled = True
)
使用索引端點,指定不重複的已部署索引 ID,即可部署索引。
DEPLOYED_INDEX_ID = f"vs_quickstart_deployed_{UID}"
# deploy the Index to the Index Endpoint
my_index_endpoint.deploy_index(
    index = my_index, deployed_index_id = DEPLOYED_INDEX_ID
)
如果是首次將這個索引部署至索引端點,系統可能需要約 30 分鐘,才能自動建構及啟動後端。如要查看索引部署作業的狀態,請前往Google Cloud 控制台 Agent Platform 專區的「Deploy and Use」(部署及使用) 部分。選取「Indexes」(索引)。
使用向量搜尋執行查詢
在下列程式碼中,系統會找出指定產品名稱的嵌入,並透過向量搜尋找出相似的產品名稱。
取得嵌入來執行查詢
首先,載入嵌入 JSON 檔案,建立產品名稱和嵌入的 dict。
import json

# build dicts for product names and embs
product_names = {}
product_embs = {}
with open('product-embs.json') as f:
    for l in f.readlines():
        p = json.loads(l)
        id = p['id']
        product_names[id] = p['name']
        product_embs[id] = p['embedding']
您可以使用 product_embs 字典指定產品 ID,取得該產品的嵌入。
 # Get the embedding for ID 6523 "cloudveil women's excursion short"
 # You can also try with other IDs such as 12711, 18090, 19536 and 11863
query_emb = product_embs['6523']
執行查詢
將嵌入傳遞至 Endpoint.find_neighbors() 方法,找出相似的產品名稱。
# run query
response = my_index_endpoint.find_neighbors(
    deployed_index_id = DEPLOYED_INDEX_ID,
    queries = [query_emb],
    num_neighbors = 10
)

# show the results
for idx, neighbor in enumerate(response[0]):
    print(f"{neighbor.distance:.2f} {product_names[neighbor.id]}")
find_neighbors() 方法只需幾毫秒就能擷取相似項目,即使索引中有數十億個項目也一樣,這要歸功於 ScaNN 演算法。Vector Search 也支援自動調度資源,可依據工作負載需求,自動調整節點數量。
清除所用資源
如果您使用的是自己的雲端專案,而非 Qwiklabs 上的臨時專案,請務必在完成本教學課程後,刪除所有索引、索引端點和 Cloud Storage bucket。否則剩餘的資源可能會產生非預期的費用。
如果您使用 Workbench,可能也需要從控制台刪除筆記本。
# wait for a confirmation
input("Press Enter to delete Index Endpoint, Index and Cloud Storage bucket:")

# delete Index Endpoint
my_index_endpoint.undeploy_all()
my_index_endpoint.delete(force = True)

# delete Index
my_index.delete()

# delete Cloud Storage bucket
! gcloud storage rm {BUCKET_URI} --recursive
公用程式
建立或部署索引可能需要一些時間,期間您可能會與 Colab 執行階段中斷連線。如果連線中斷,您不必重新建立或部署新索引,只要查看 Vector SearchGoogle Cloud 控制台,並使用現有索引繼續操作即可。
取得現有索引
如要取得現有的索引物件,請將下列 your-index-id 替換為索引 ID,然後執行儲存格。您可以查看向量搜尋 Google Cloud 控制台,取得索引 ID。前往 Google Cloud 控制台的「Agent Platform」部分,然後前往「Deploy and Use」(部署及使用) 部分。選取「Indexes」(索引)。
my_index_id = "[your-index-id]"
my_index = aiplatform.MatchingEngineIndex(my_index_id)
取得現有索引端點
如要取得現有的索引端點物件,請將下列 your-index-endpoint-id 替換為索引端點 ID,然後執行儲存格。您可以查看 Vector Search Google Cloud 控制台,取得索引端點。前往 Google Cloud 控制台的「Agent Platform」部分,然後前往「Deploy and Use」(部署及使用) 專區。選取「Index Endpoints」(索引端點)。
my_index_endpoint_id = "[your-index-endpoint-id]"
my_index_endpoint = aiplatform.MatchingEngineIndexEndpoint(my_index_endpoint_id)