


ארכיטקטורת TPU
יחידות עיבוד Tensor (TPU) הן מעגלים משולבים לאפליקציות ספציפיות (ASIC) שפותחו על ידי Google כדי להאיץ עומסי עבודה של למידת מכונה. אתם יכולים להשתמש ב-TPU דרך Compute Engine, Google Kubernetes Engine ו-Vertex AI.
יחידות TPU מיועדות לבצע פעולות מטריצה במהירות, ולכן הן אידיאליות לעומסי עבודה של למידת מכונה. אתם יכולים להריץ עומסי עבודה של למידת מכונה ב-TPU באמצעות מסגרות כמו PyTorch ו-JAX.
איך מעבדי TPU פועלים?
כדי להבין איך יחידות TPU פועלות, כדאי להבין איך מאיצים אחרים מתמודדים עם האתגרים החישוביים של אימון מודלים של למידת מכונה.
איך פועל מעבד (CPU)
מעבד (CPU) הוא מעבד למטרות כלליות שמבוסס על ארכיטקטורת פון נוימן. זה אומר שהמעבד עובד עם תוכנה וזיכרון באופן הבא:
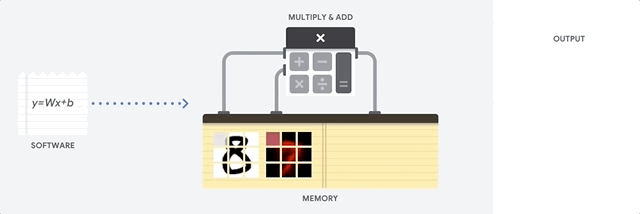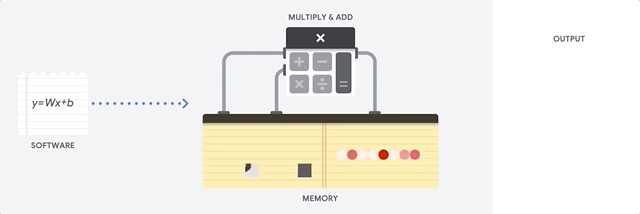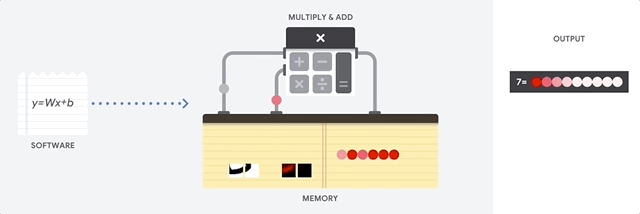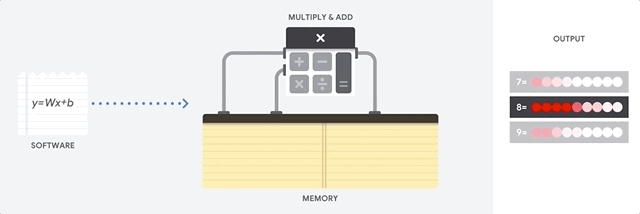
היתרון הגדול ביותר של מעבדים הוא הגמישות שלהם. אפשר לטעון כל סוג של תוכנה ב-CPU, להרבה סוגים שונים של אפליקציות. לדוגמה, אפשר להשתמש ב-CPU לעיבוד תמלילים במחשב, לשליטה במנועי טילים, לביצוע עסקאות בנקאיות או לסיווג תמונות באמצעות רשת נוירונים.
בכל חישוב, המעבד (CPU) טוען ערכים מהזיכרון, מבצע חישוב על הערכים ומאחסן את התוצאה בחזרה בזיכרון. הגישה לזיכרון איטית בהשוואה למהירות החישוב, ויכולה להגביל את התפוקה הכוללת של המעבדים. התופעה הזו נקראת לעיתים קרובות צוואר הבקבוק של פון נוימן.
איך GPU פועל
כדי להשיג תפוקה גבוהה יותר, מעבדי GPU מכילים אלפי יחידות אריתמטיות לוגיות (ALU) במעבד יחיד. GPU מודרני מכיל בדרך כלל בין 2,500 ל-5,000 יחידות ALU. המספר הגדול של המעבדים מאפשר לבצע אלפי פעולות כפל וחיבור בו-זמנית.
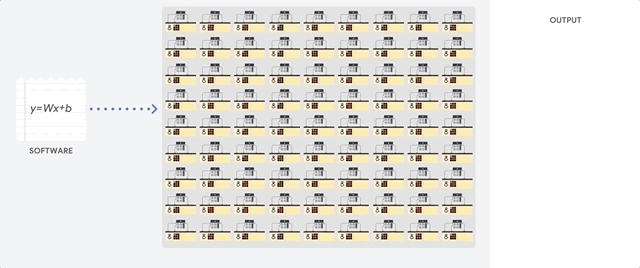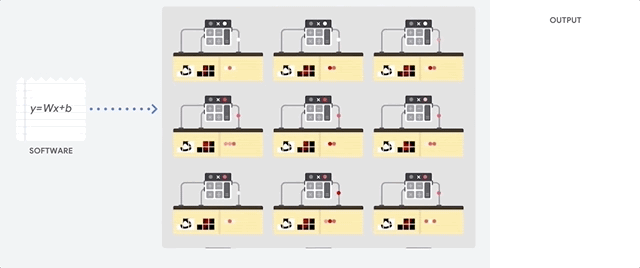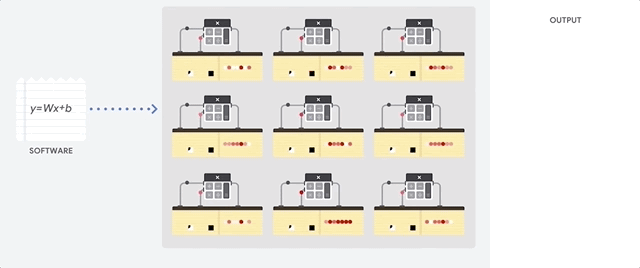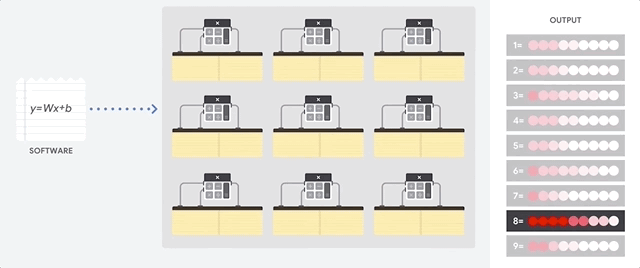
ארכיטקטורת ה-GPU הזו מתאימה לאפליקציות עם מקביליות מסיבית, כמו פעולות מטריצה ברשת נוירונים. למעשה, בעומס עבודה אופייני של אימון ללמידה עמוקה, GPU יכול לספק תפוקה גבוהה בסדר גודל מאשר CPU.
אבל ה-GPU הוא עדיין מעבד לשימוש כללי שצריך לתמוך בהרבה אפליקציות ותוכנות שונות. לכן, למעבדים גרפיים יש את אותה בעיה כמו למעבדים. בכל חישוב באלפי ה-ALU, ה-GPU צריך לגשת לרגיסטרים או לזיכרון המשותף כדי לקרוא אופרנדים ולאחסן את תוצאות החישובים שמתקבלות באמצע התהליך.
איך TPU פועל
Google פיתחה את יחידות ה-Cloud TPU כמעבדי מטריצה שמתמחים בעומסי עבודה של רשתות נוירונים. יחידות TPU לא יכולות להריץ מעבדי תמלילים, לשלוט במנועי טילים או לבצע עסקאות בנקאיות, אבל הן יכולות לטפל במהירות בפעולות מטריצה מסיביות שמשמשות ברשתות נוירונים.
המשימה העיקרית של יחידות TPU היא עיבוד מטריצות, שהוא שילוב של פעולות כפל וצבירה. יחידות TPU מכילות אלפי רכיבי multiply-accumulate שמחוברים ישירות זה לזה כדי ליצור מטריצה פיזית גדולה. הארכיטקטורה הזו נקראת מערך סיסטולי. ב-Cloud TPU v3 יש שני מערכים סיסטוליים של 128 x 128 יחידות ALU במעבד יחיד.
מארח ה-TPU מעביר נתונים בסטרימינג לתור הזנה. ה-TPU טוען נתונים מתור ההזנה ומאחסן אותם בזיכרון ברוחב פס גבוה (HBM). כשהחישוב מסתיים, ה-TPU טוען את התוצאות לתור ה-outfeed. לאחר מכן, מארח ה-TPU קורא את התוצאות מתור הפלט ושומר אותן בזיכרון של המארח.
כדי לבצע את פעולות המטריצה, ה-TPU טוען את הפרמטרים מ-HBM ליחידת הכפל של המטריצה (MXU).
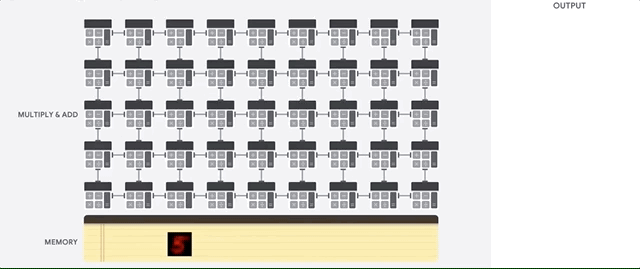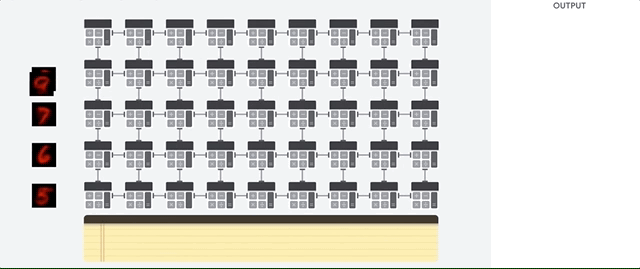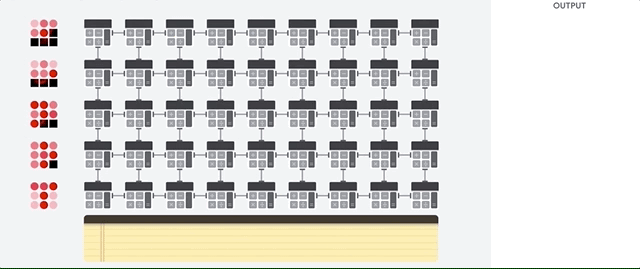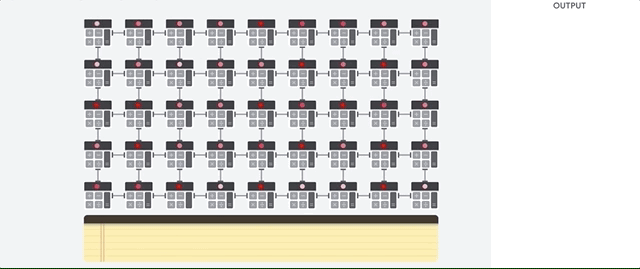
לאחר מכן, ה-TPU טוען נתונים מ-HBM. בכל פעם שמתבצעת פעולת כפל, התוצאה מועברת למכפיל-צובר הבא. הפלט הוא הסכום של כל תוצאות הכפל בין הנתונים לפרמטרים. לא נדרשת גישה לזיכרון במהלך תהליך הכפלת המטריצה.
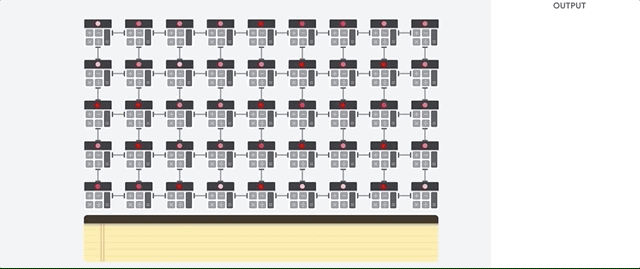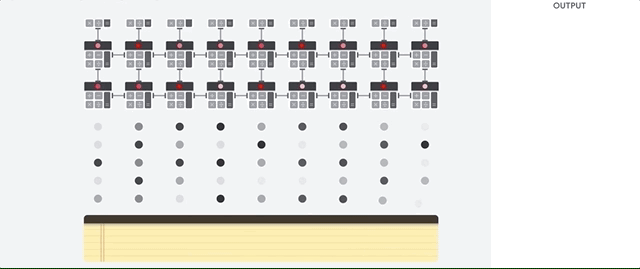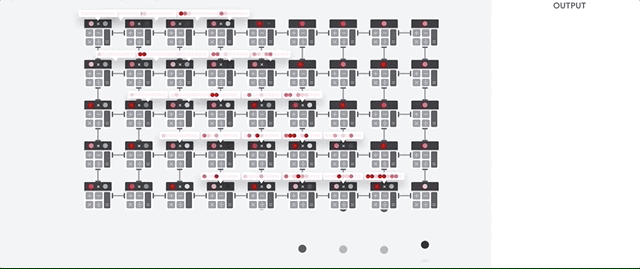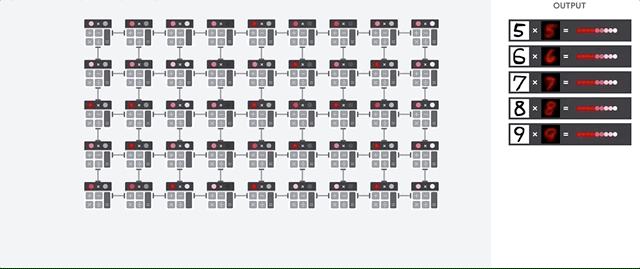
כתוצאה מכך, יחידות TPU יכולות להשיג תפוקת חישוב גבוהה בחישובים של רשתות נוירונים.
ארכיטקטורת מערכת TPU
בקטעים הבאים מתוארים המושגים העיקריים של מערכת TPU. למידע נוסף על מונחים נפוצים של למידת מכונה, ראו מילון מונחים של למידת מכונה.
אם אתם משתמשים חדשים ב-Cloud TPU, כדאי לעיין בדף הבית של מסמכי התיעוד של TPU.
צ'יפ TPU
שבב TPU מכיל ליבת TensorCore אחת או יותר. מספר ליבות ה-TensorCore תלוי בגרסה של שבב ה-TPU. כל TensorCore מורכב מיחידה אחת או יותר של כפל מטריצות (MXU), יחידה וקטורית ויחידה סקלרית. למידע נוסף על TensorCores, קראו את המאמר מחשב-על ספציפי לדומיין לאימון רשתות עצביות עמוקות.
יחידת MXU מורכבת מ-256 x 256 (TPU v6e ו-TPU7x) או 128 x 128 (גרסאות TPU לפני v6e) של צוברי כפל במערך סיסטולי. יחידות MXU מספקות את רוב כוח המחשוב ב-TensorCore. כל יחידת MXU בגודל 128 x 128 (TPU v5p וגרסאות קודמות) מבצעת 16,000 פעולות של כפל וצבירה בכל מחזור. כל MXU בגודל 256x256 (ב-TPU v6e וב-TPU7x) מבצע 128K פעולות כפל וצבירה של bfloat16 בכל מחזור. כל פעולות הכפל מקבלות קלט bfloat16, וגם פורמטים ברמת דיוק נמוכה יותר בדורות נתמכים (כמו מספר שלם של 8 ביט ב-TPU v5e ו-v6e, ו-FP8 ב-TPU v5p ו-TPU7x), בעוד שפעולות הצבירה מתבצעות בפורמט מספר FP32.
יחידת הווקטור משמשת לחישובים כלליים כמו הפעלות ו-softmax. היחידה הסקלרית משמשת לבקרת זרימה, לחישוב כתובות זיכרון ולפעולות תחזוקה אחרות.
TPU Pod
TPU Pod הוא קבוצה רציפה של יחידות TPU שמקובצות יחד ברשת ייעודית. מספר שבבי ה-TPU ב-TPU Pod תלוי בגרסת ה-TPU.
Slice
פרוסה היא אוסף של צ'יפים שנמצאים באותו TPU Pod ומחוברים באמצעות חיבורים מהירים בין צ'יפים (ICI). הפרוסות מתוארות במונחים של צ'יפים או TensorCores, בהתאם לגרסת ה-TPU.
טופולוגיה
הטופולוגיה מגדירה את הסידור הפיזי של יחידות ה-TPU בתוך פרוסת TPU. לפרוסות TPU יש טופולוגיות דו-ממדיות (2D) או תלת-ממדיות (3D), בהתאם לגרסת ה-TPU. מציינים טופולוגיה כמספר שבבי ה-TPU בכל מימד, באופן הבא:
- טופולוגיות תלת-ממדיות: מגדירים את הטופולוגיה כ-3-tuple (
{A}x{B}x{C}), לדוגמה,4x4x4. המכפלה של{A}x{B}x{C}מגדירה את מספר שבבי ה-TPU בפרוסה. אם אתם משתמשים בטופולוגיה עם יותר מ-64 צ'יפים, הערכים שאתם מקצים ל-{A}, ל-{B}ול-{C}צריכים לעמוד בתנאים הבאים:- הערכים
{A},{B}ו-{C}חייבים להיות כפולות של ארבע. - הערכים שמוקצים צריכים להיות לפי התבנית הזו:
{A}≤{B}≤{C}. לדוגמה:4x4x8או8x8x8.
- הערכים
- טופולוגיות דו-ממדיות: מגדירים את הטופולוגיה כ-2-tuple (
{A}x{B}), לדוגמה2x4. המכפלה של{A}x{B}מגדירה את מספר שבבי ה-TPU בפרוסה.
טופולוגיה של מארח יחיד מתייחסת לטופולוגיה עם שבבי TPU ממארח מחשוב יחיד. לדוגמה, ב-TPU7x, כל מארח מחובר לארבעה שבבים. פרוסת 2x2x1 כוללת ארבעה צ'יפים שמחוברים למארח אחד, ולכן 2x2x1 היא טופולוגיה של מארח יחיד.
טופולוגיה עם כמה מארחים היא טופולוגיה עם שבבי TPU מיותר ממארח מחשוב אחד. לדוגמה, ב-TPU7x, פרוסות של 2x2x2 (שמונה שבבים משני מארחים) ופרוסות גדולות יותר הן טופולוגיות עם כמה מארחים.
ריבוי-פרוסות (Multislice) לעומת פרוסה אחת
ריבוי-פרוסות (Multislice) הוא קבוצה של פרוסות, שמרחיבה את הקישוריות של ה-TPU מעבר לחיבורים בין שבבים (ICI) וממנפת את רשת מרכז הנתונים (DCN) כדי להעביר נתונים מעבר לפרוסה. הנתונים בכל פרוסה עדיין מועברים באמצעות ICI. באמצעות הקישוריות ההיברידית הזו, ריבוי-פרוסות מאפשר מקביליות בין פרוסות, ושימוש במספר גדול יותר של ליבות TPU למשימה אחת, יותר ממה שפרוסה אחת יכולה להכיל.
אפשר להשתמש ב-TPU כדי להריץ משימה בפרוסה אחת או בכמה פרוסות. למידע נוסף, קראו את מבוא לריבוי-פרוסות.
קוביית TPU
טופולוגיה של 4x4x4 עם 64 שבבי TPU מקושרים. ההגדרה הזו רלוונטית רק לטופולוגיות תלת-ממדיות (החל מ-TPU v4). בתוך קובייה, שבבי TPU סמוכים מחוברים באמצעות קישורי חיבור בין שבבים (ICI) מנחושת במהירות גבוהה. כדי ליצור פרוסות של כמה קוביות ב-TPU Pod (ב-TPU v4, v5p ו-TPU7x), הקישורים של הגבולות של כל קוביית 4x4x4 מחוברים באמצעות קישורים אופטיים ומתגי מעגלים אופטיים (OCS) שאפשר להגדיר מחדש לטופולוגיית טורוס תלת-ממדית או טורוס תלת-ממדית מעוותת.
SparseCore
SparseCores הם מעבדי זרימת נתונים שמאיצים מודלים באמצעות פעולות דלילות. תרחיש לדוגמה עיקרי הוא האצת מודלים של המלצות, שמסתמכים במידה רבה על הטמעות. ל-v5p ול-TPU7x יש ארבעה SparseCores לכל שבב, ול-v6e יש שני SparseCores לכל שבב. הסבר מעמיק על השימוש ב-SparseCores מופיע במאמר A deep dive into SparseCore for Large Embedding Models (LEM). אתם יכולים לקבוע איך מהדר ה-XLA ישתמש ב-SparseCores באמצעות דגלי XLA. מידע נוסף זמין במאמר דגלי TPU XLA.
עמידות של Cloud TPU ICI
עמידות ICI עוזרת לשפר את העמידות בפני תקלות של קישורים אופטיים ומתגי מעגלים אופטיים (OCS) שמחברים בין יחידות TPU בקוביות. (חיבורי ICI בתוך קובייה משתמשים בקישורי נחושת שלא מושפעים). עמידות ה-ICI מאפשרת לנתב חיבורי ICI סביב תקלות ב-OCS וב-ICI האופטי. כתוצאה מכך, הזמינות של פרוסות TPU לתזמון משתפרת, אבל הביצועים של ה-ICI נפגעים באופן זמני.
ב-Cloud TPU v4, v5p ו-TPU7x, עמידות ICI מופעלת כברירת מחדל לפרוסות בגודל של קובייה אחת או יותר, לדוגמה:
- v5p-128 כשמציינים את סוג המאיץ
- 4x4x4 כשמציינים את הגדרת המאיץ
גרסאות של TPU
הארכיטקטורה המדויקת של שבב TPU תלויה בגרסת ה-TPU שבה אתם משתמשים. כל גרסת TPU תומכת גם בגדלים ובהגדרות שונות של פרוסות. מידע נוסף על ארכיטקטורת המערכת וההגדרות הנתמכות מופיע בדפים הבאים:
ארכיטקטורת TPU בענן
Google Cloud הופך את יחידות ה-TPU לזמינות כמשאבי מחשוב באמצעות מכונות וירטואליות של TPU. אתם יכולים להשתמש ביחידות TPU לעומסי העבודה שלכם דרך Compute Engine, Google Kubernetes Engine ו-Vertex AI. בקטעים הבאים מתוארים הרכיבים העיקריים של ארכיטקטורת הענן של TPU.
ארכיטקטורת TPU VM
ארכיטקטורת ה-TPU VM מאפשרת להתחבר ישירות למכונה הווירטואלית שמחוברת פיזית למכשיר ה-TPU באמצעות SSH. TPU VM, שנקרא גם worker, הוא מכונה וירטואלית שמריצה את Linux ויש לה גישה ליחידות ה-TPU הבסיסיות. יש לכם גישת root למכונה הווירטואלית, כך שאתם יכולים להריץ קוד שרירותי. אתם יכולים לגשת ליומני ניפוי באגים ולהודעות שגיאה של המהדר ושל זמן הריצה.
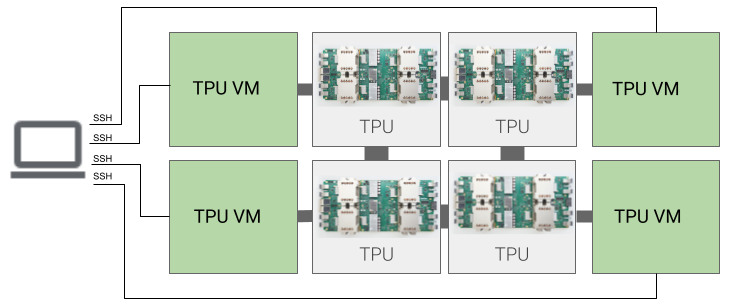
מארח יחיד, כמה מארחים ומארח משני
מארח TPU הוא VM שפועל במחשב פיזי שמחובר לחומרת TPU. עומסי עבודה של TPU יכולים להשתמש במארח אחד או יותר.
עומס עבודה במארח יחיד מוגבל ל-TPU VM אחד. בעומס עבודה עם כמה מארחים, האימון מתבצע בכמה TPU VM. עומס עבודה של מארח משנה לא משתמש בכל הצ'יפים של מכונת TPU וירטואלית.
כלי להמחשה חזותית של טופולוגיית TPU
הכלי להמחשת טופולוגיית TPU מאפשר להמחיש את הפריסה הפיזית של יחידות TPU ותשתית הרשת המשויכת אליהן בתוך מרכז נתונים פיזי. אתם יכולים להשתמש בכלי כדי להבין את פריסת התשתית הפיזית של דורות וטופולוגיות שונים של TPU.