


TPU v4
במאמר הזה מתוארים הארכיטקטורה וההגדרות האישיות הנתמכות של Cloud TPU v4.
ארכיטקטורת המערכת
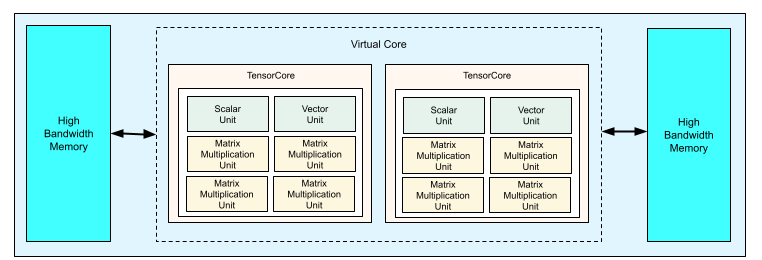
כל שבב TPU v4 מכיל שני ליבות Tensor. לכל TensorCore יש ארבע יחידות של כפל מטריצות (MXU), יחידה וקטורית ויחידה סקלרית. בטבלה הבאה מוצגים המפרטים העיקריים של TPU Pod בגרסה 4.
| מפרט | ערכים |
|---|---|
| שיא המחשוב לכל שבב | 275 טרה-פלופ (bf16 או int8) |
| קיבולת ורוחב פס של HBM2 | 32GiB, 1,200GBps |
| הספק מינימלי/ממוצע/מקסימלי שנמדד | 90/170/192 ואט |
| גודל ה-TPU Pod | 4,096 צ'יפים |
| טופולוגיית Interconnect | רשת תלת-ממדית |
| שיא המחשוב לכל Pod | 1.1 אקסה-פלופ (bf16 או int8) |
| רוחב פס All-reduce לכל Pod | 1.1 פטה-בייט לשנייה |
| רוחב פס של חצייה לכל Pod | 24TB לשנייה |
התרשים הבא ממחיש שבב TPU v4.
למידע נוסף על פרטי הארכיטקטורה ומאפייני הביצועים של TPU v4, קראו את המאמר TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings.
רשת תלת-ממדית וטורוס תלת-ממדי
ל-TPU מדור 4 יש חיבור ישיר לשבבים השכנים הקרובים ביותר ב-3 ממדים, וכתוצאה מכך נוצרת רשת תלת-ממדית של חיבורי רשת. פרוסות של קובייה אחת או יותר בגודל 4x4x4 (כאשר כל מימד A, B ו-C בטופולוגיה AxBxC הוא כפולה של 4) כוללות קישורי גלישה שמחברים את הצדדים המנוגדים של הפרוסה לטורוס תלת-ממדי, ואילו פרוסות קטנות יותר יוצרות רשת תלת-ממדית ללא קישורי גלישה. בפרוסות שבהן הטופולוגיה, AxBxC, היא 2A=B=C או 2A=2B=C וכל מימד הוא כפולה של 4 (לדוגמה, 4x4x8, 4x8x8 או 12x12x24), אפשר גם להגדיר את החיבורים כטורוס תלת-ממדי מעוות. באופן כללי, הביצועים של הגדרת טורוס תלת-ממדי טובים יותר מהביצועים של הגדרת רשת תלת-ממדית. מידע נוסף על הגדרות של טורוס מעוות מופיע במאמר טופולוגיות של טורוס מעוות.
יתרונות הביצועים של TPU v4 לעומת v3
בקטע הזה מוסבר איך להריץ סקריפט אימון לדוגמה ב-TPU v4 בצורה יעילה מבחינת זיכרון, וגם על שיפורי הביצועים של TPU v4 בהשוואה ל-TPU v3.
מערכת הזיכרון
גישה לא אחידה לזיכרון (NUMA) היא ארכיטקטורת זיכרון למחשבים עם כמה מעבדים. לכל מעבד יש גישה ישירה לבלוק של זיכרון במהירות גבוהה. מעבד (CPU) והזיכרון שלו נקראים צומת NUMA. צומתי NUMA מחוברים לצומתי NUMA אחרים שסמוכים להם ישירות. מעבד (CPU) מצומת NUMA אחד יכול לגשת לזיכרון בצומת NUMA אחר, אבל הגישה הזו איטית יותר מגישה לזיכרון בתוך צומת NUMA.
תוכנה שפועלת במכונה עם כמה מעבדים יכולה למקם את הנתונים שנדרשים למעבד בתוך צומת ה-NUMA שלו, וכך להגדיל את קצב העברת הנתונים בזיכרון. למידע נוסף על NUMA, קראו את הערך Non Uniform Memory Access בוויקיפדיה.
כדי לנצל את היתרונות של NUMA-locality, אתם יכולים לקשר את סקריפט האימון ל-NUMA Node 0.
כדי להפעיל קישור צומת NUMA:
מתקינים את כלי שורת הפקודה numactl. numactl מאפשר להריץ תהליכים עם מדיניות ספציפית של תזמון NUMA או מיקום זיכרון.
 $ sudo apt-get update
 $ sudo apt-get install numactl
מקשרים את קוד הסקריפט ל-NUMA Node 0. מחליפים את your-training-script בנתיב לסקריפט האימון.
$ numactl --cpunodebind=0 python3 your-training-script
מפעילים קישור צומת NUMA אם:
- אם עומס העבודה שלכם תלוי מאוד בעומסי עבודה של מעבד (לדוגמה, סיווג תמונות, עומסי עבודה של המלצות) ללא קשר למסגרת.
- אם אתם משתמשים בגרסת זמן ריצה של TPU בלי הסיומת -pod (לדוגמה,
tpu-vm-tf-2.10.0-v4).
הבדלים אחרים במערכת הזיכרון:
- לשבבי TPU מדור 4 יש מרחב זיכרון HBM מאוחד של 32GiB בכל השבב, שמאפשר תיאום טוב יותר בין שתי ליבות ה-TensorCore בשבב.
- ביצועים משופרים של HBM באמצעות תקני הזיכרון והמהירויות העדכניים ביותר.
- פרופיל ביצועים משופר של DMA עם תמיכה מובנית ב-striding בביצועים גבוהים ברמת פירוט של 512B.
TensorCores
- מספר כפול של יחידות MXU וקצב שעון גבוה יותר, שמספקים עד 275 TFLOPS.
- רוחב פס כפול לטרנספוזיציה ולתמורה.
- מודל גישה לזיכרון מסוג Load-store לזיכרון משותף (Cmem).
- רוחב פס מהיר יותר לטעינת משקלים של MXU ותמיכה במצב 8 ביט, שמאפשרים גודלי אצווה קטנים יותר וזמן אחזור משופר של הסקת מסקנות.
חיבור בין שבבים
שישה קישורי חיבור לכל שבב, כדי לאפשר הטופולוגיה של הרשת עם קוטר רשת קטן יותר.
אחר
- ממשק x16 PCIE gen3 למארח (חיבור ישיר).
- מודל אבטחה משופר.
- יעילות אנרגטית משופרת.
הגדרות אישיות
TPU v4 Pod מורכב מ-4,096 צ'יפים שמחוברים ביניהם באמצעות קישורים מהירים שאפשר להגדיר מחדש. הרשת הגמישה של TPU v4 מאפשרת לחבר את הצ'יפים בפרוסה באותו גודל בכמה דרכים. כשיוצרים פרוסת TPU, מציינים את גרסת ה-TPU ואת מספר משאבי ה-TPU שנדרשים.
מציינים טופולוגיית TPU באמצעות 3-tuple, AxBxC, כאשר A<=B<=C ו-A, B, C הם כולם <= 4 או כולם כפולות של מספרים שלמים של 4. הערכים A, B ו-C הם מספר הצ'יפים בכל אחד משלושת הממדים.
לטופולוגיות שבהן 2A=B=C או 2A=2B=C יש גם וריאציות של טופולוגיה שמותאמות לתקשורת מסוג all-to-all, לדוגמה, 4×4×8, 8×8×16 ו-12×12×24. הטופולוגיות האלה נקראות טורוס מעוות.
באיורים הבאים מוצגות כמה טופולוגיות נפוצות של TPU v4.
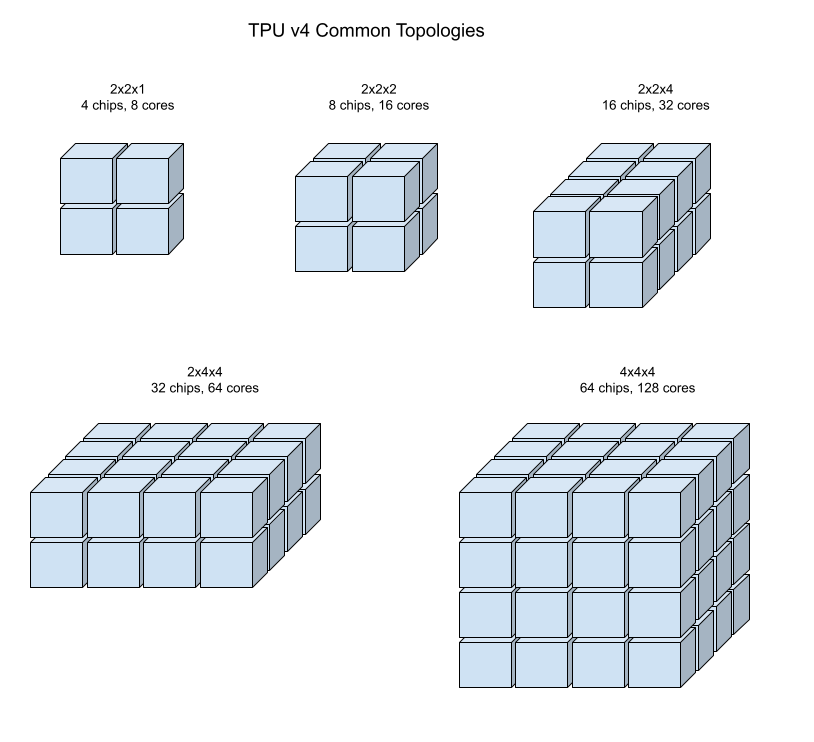
אפשר לבנות פרוסות גדולות יותר מ "קוביות" של שבבים בגודל 4x4x4.
מידע נוסף על ניהול יחידות TPU זמין במאמר ניהול יחידות TPU. למידע נוסף על ארכיטקטורת המערכת של Cloud TPU, קראו את המאמר ארכיטקטורת המערכת.
טופולוגיות של טורוס מפותל
בחלק מהצורות של פרוסות תלת-ממדיות, אפשר להשתמש בטופולוגיה של טורוס מעוות. הטופולוגיות האלה מציעות רוחב פס גבוה משמעותית לחציית הרשת. לדוגמה, טופולוגיה מפותלת של 4x4x8 מספקת עלייה תיאורטית של 70% ברוחב הפס של החצייה בהשוואה לפרוסה לא מפותלת של 4x4x8. רוחב הפס המוגדל הזה עוזר לעומסי עבודה שמשתמשים בדפוסי תקשורת גלובליים. טופולוגיות מעוותות יכולות לשפר את הביצועים של רוב המודלים, והיתרון הגדול ביותר הוא בעומסי עבודה גדולים של הטמעת TPU. תוכנת TPU תומכת בטופולוגיות מעוותות בפרוסות שבהן כל מימד שווה לגודל של המימד הקטן ביותר או כפול ממנו. לדוגמה, 4x4x8, 4×8×8 או 12x12x24. טופולוגיות מעוותות נתמכות ב-TPU v4 וב-TPU v5p באמצעות Cloud TPU API.
בעומסי עבודה שמשתמשים במקביליות נתונים כאסטרטגיית המקביליות היחידה, יכול להיות שהביצועים של טופולוגיות מפותלות יהיו קצת יותר טובים. במודלים גדולים של שפה (LLM), הביצועים של טופולוגיית Twisted משתנים בהתאם לסוג המקביליות שמשתמשים בה (לדוגמה, מקביליות נתונים או מקביליות מודלים). כדי למצוא את הביצועים הטובים ביותר למודל, מאמנים את ה-LLM גם עם טופולוגיה מעוותת וגם בלי. בניסויים מסוימים במודל FSDP MaxText, נצפו שיפורים של 1-2 אחוזים בניצול ה-FLOP של המודל (MFU) כשמשתמשים בטופולוגיה מפותלת.
היתרון העיקרי של טופולוגיות מפותלות הוא שהן משנות טופולוגיית טורוס אסימטרית (לדוגמה, 4×4×8) לטופולוגיה סימטרית. טופולוגיה סימטרית מציעה:
- איזון עומסים משופר
- רוחב פס גבוה יותר של חצייה
- מסלולי חבילות קצרים יותר
היתרונות האלה משפרים את הביצועים של הרבה דפוסי תקשורת גלובליים.
לדוגמה, נבחן את טופולוגיית הטורוס הזו בגודל 4×2 עם מעבדי TPU שמסומנים בקואורדינטות X ו-Y בפרוסה:
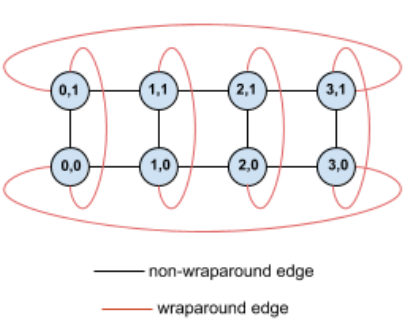
לשם הבהרה, בתרשים מוצגים חיבורים כקצוות לא מכוונים. בפועל, כל קצה הוא חיבור דו-כיווני בין יחידות TPU. הקצוות בין צד אחד של הרשת הזו לבין הצד הנגדי הם קצוות גלישה.
פיתול הטופולוגיה הזו יוצר טופולוגיה סימטרית של טורוס מפותל בגודל 4×2:
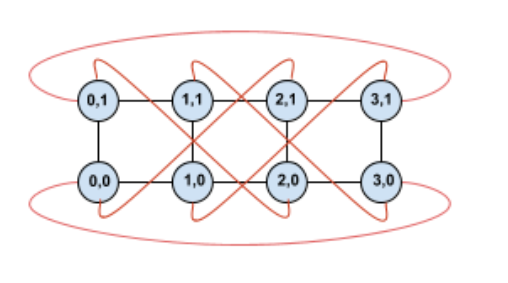
ההבדל בין הדיאגרמה המפותלת הזו לבין הדיאגרמה הלא מפותלת הוא בקצוות המעטפת של ציר ה-Y. במקום להתחבר ל-TPU אחר עם אותו קואורדינטת X, הקצוות האלה משתנים כדי להתחבר ל-TPU בקואורדינטה X+2 mod 4.
העיקרון הזה חל על גדלים שונים של מאפיינים ועל מספרים שונים של מאפיינים. הרשת שנוצרת היא סימטרית אם כל מימד שווה לגודל של המימד הקטן ביותר או גדול ממנו פי שניים.
בטבלה הבאה מוצגות כמה מהטופולוגיות המפותלות הנתמכות, והעלייה התיאורטית ברוחב הפס של החצייה שהן מספקות בהשוואה לטופולוגיות לא מפותלות.
| טופולוגיה | עלייה תיאורטית ברוחב הפס של החיתוך לעומת טורוס לא מעוות |
|---|---|
| 4×4×8 | ~70% |
| 8x8x16 | |
| 12×12×24 | |
| 4x8x8 | ~40% |
| 8×16×16 |
וריאנטים של טופולוגיית TPU v4
אפשר לסדר טופולוגיות מסוימות שמכילות את אותו מספר צ'יפים בדרכים שונות. לדוגמה, אפשר להגדיר פרוסת TPU עם 512 צ'יפים (1, 024 ליבות Tensor) באמצעות הטופולוגיות הבאות: 4x4x32, 4x8x16 או 8x8x8. בפרוסת TPU עם 2,048 צ'יפים (4,096 ליבות Tensor) יש עוד יותר אפשרויות טופולוגיה: 4x4x128, 4x8x64, 4x16x32 ו-8x16x16.
הטופולוגיה שמוגדרת כברירת מחדל ומשויכת למספר צ'יפים נתון היא זו שהכי דומה לקובייה. הצורה הזו היא כנראה הבחירה הטובה ביותר לאימון ML מקביל לנתונים. טופולוגיות אחרות יכולות להיות שימושיות לעומסי עבודה עם כמה סוגים של מקביליות (לדוגמה, מקביליות של מודלים ונתונים, או חלוקה מרחבית של סימולציה). עומסי העבודה האלה פועלים בצורה הטובה ביותר אם הטופולוגיה תואמת למקביליות שבה משתמשים. לדוגמה, הצבת מודל מקביליות של 4 כיוונים במאפיין X ומודל מקביליות של 256 כיוונים במאפיינים Y ו-Z תואמת לטופולוגיה של 4x16x16.
מודלים עם כמה ממדים של מקביליות פועלים בצורה הכי טובה כשממדי המקביליות שלהם ממופים לממדי הטופולוגיה של ה-TPU. בדרך כלל מדובר במודלים גדולים של שפה (LLM) עם מקביליות של נתונים ומודלים. לדוגמה, לפרוסת TPU v4 עם טופולוגיה 8x16x16, מימדי הטופולוגיה של ה-TPU הם 8, 16 ו-16. כדי לשפר את הביצועים, כדאי להשתמש במודל מקביליות של 8 או 16 (ממופה לאחד מממדי הטופולוגיה הפיזיים של ה-TPU). מודל מקביליות של 4 כיוונים לא יהיה אופטימלי בטופולוגיה הזו, כי הוא לא תואם לאף אחד מהממדים של טופולוגיית ה-TPU, אבל הוא יהיה אופטימלי בטופולוגיה של 4x16x32 באותו מספר שבבים.
ההגדרות של TPU v4 מורכבות משתי קבוצות: קבוצה עם טופולוגיות של פחות מ-64 צ'יפים (טופולוגיות קטנות) וקבוצה עם טופולוגיות של יותר מ-64 צ'יפים (טופולוגיות גדולות).
טופולוגיות קטנות בגרסה 4
ב-Cloud TPU יש תמיכה בפרוסות TPU v4 הבאות, שקטנות מ-64 צ'יפים, קובייה של 4x4x4. אפשר ליצור את הטופולוגיות הקטנות האלה של v4 באמצעות השם שלהן שמבוסס על TensorCore (לדוגמה, v4-32) או באמצעות הטופולוגיה שלהן (לדוגמה, 2x2x4):
| שם (על סמך מספר ליבות Tensor) | מספר הצ'יפים | טופולוגיה |
| v4-8 | 4 | 2x2x1 |
| v4-16 | 8 | 2x2x2 |
| v4-32 | 16 | 2x2x4 |
| v4-64 | 32 | 2x4x4 |
טופולוגיות גדולות בגרסה 4
פרוסות TPU v4 זמינות במרווחים של 64 צ'יפים, עם צורות שהן כפולות של 4 בכל שלושת הממדים. המידות צריכות להיות בסדר עולה. בטבלה הבאה מוצגות כמה דוגמאות. חלק מהטופולוגיות האלה הן טופולוגיות "בהתאמה אישית" שאפשר ליצור רק באמצעות הדגלים --type ו---topology, כי יש יותר מדרך אחת לסדר את הצ'יפים.
| שם (על סמך מספר ליבות Tensor) | מספר הצ'יפים | טופולוגיה |
| v4-128 | 64 | 4x4x4 |
| v4-256 | 128 | 4x4x8 |
| v4-512 | 256 | 4x8x8 |
טופולוגיה בהתאמה אישית: צריך להשתמש בדגלים --type ו---topology |
256 | 4x4x16 |
| v4-1024 | 512 | 8x8x8 |
| v4-1536 | 768 | 8x8x12 |
| v4-2048 | 1024 | 8x8x16 |
טופולוגיה בהתאמה אישית: צריך להשתמש בדגלים --type ו---topology |
1024 | 4x16x16 |
| v4-4096 | 2048 | 8x16x16 |
| … | … | … |