


TPU7x (Ironwood)
בדף הזה מתוארים הארכיטקטורה וההגדרות הזמינות של TPU7x, הגרסה העדכנית ביותר של TPU שזמינה ב- Google Cloud. TPU7x הוא הגרסה הראשונה במשפחת Ironwood,הדור השביעי של TPU של Google Cloud. הדור של Ironwood מיועד לאימון ולהסקה של AI בקנה מידה גדול.
עם 9,216 צ'יפים לכל Pod, ל-TPU7x יש הרבה מאפיינים דומים ל-TPU v5p. TPU7x מספק ביצועים גבוהים למודלים צפופים בקנה מידה גדול ולמודלים של MoE, לאימון מקדים, לדגימה ולהסקת מסקנות שדורשת פענוח רב.
כדי להשתמש ב-TPU7x, אתם יכולים להשתמש ב-Google Kubernetes Engine (GKE) או ב-Compute Engine. מידע נוסף על השימוש ב-TPU עם GKE זמין במאמר מידע על יחידות TPU ב-GKE.
אפשר גם להשתמש ב-TPU7x וב-GKE במצב All Capacity. מצב All Capacity זמין באמצעות הזמנה במצב All Capacity, שנותנת לכם גישה מלאה לכל הקיבולת שהזמנתם (בלי עיכובים) וסקירה מלאה של טופולוגיית החומרה של ה-TPU, סטטוס הניצול וסטטוס התקינות. מידע נוסף זמין במאמר סקירה כללית על מצב All Capacity.
ארכיטקטורת המערכת
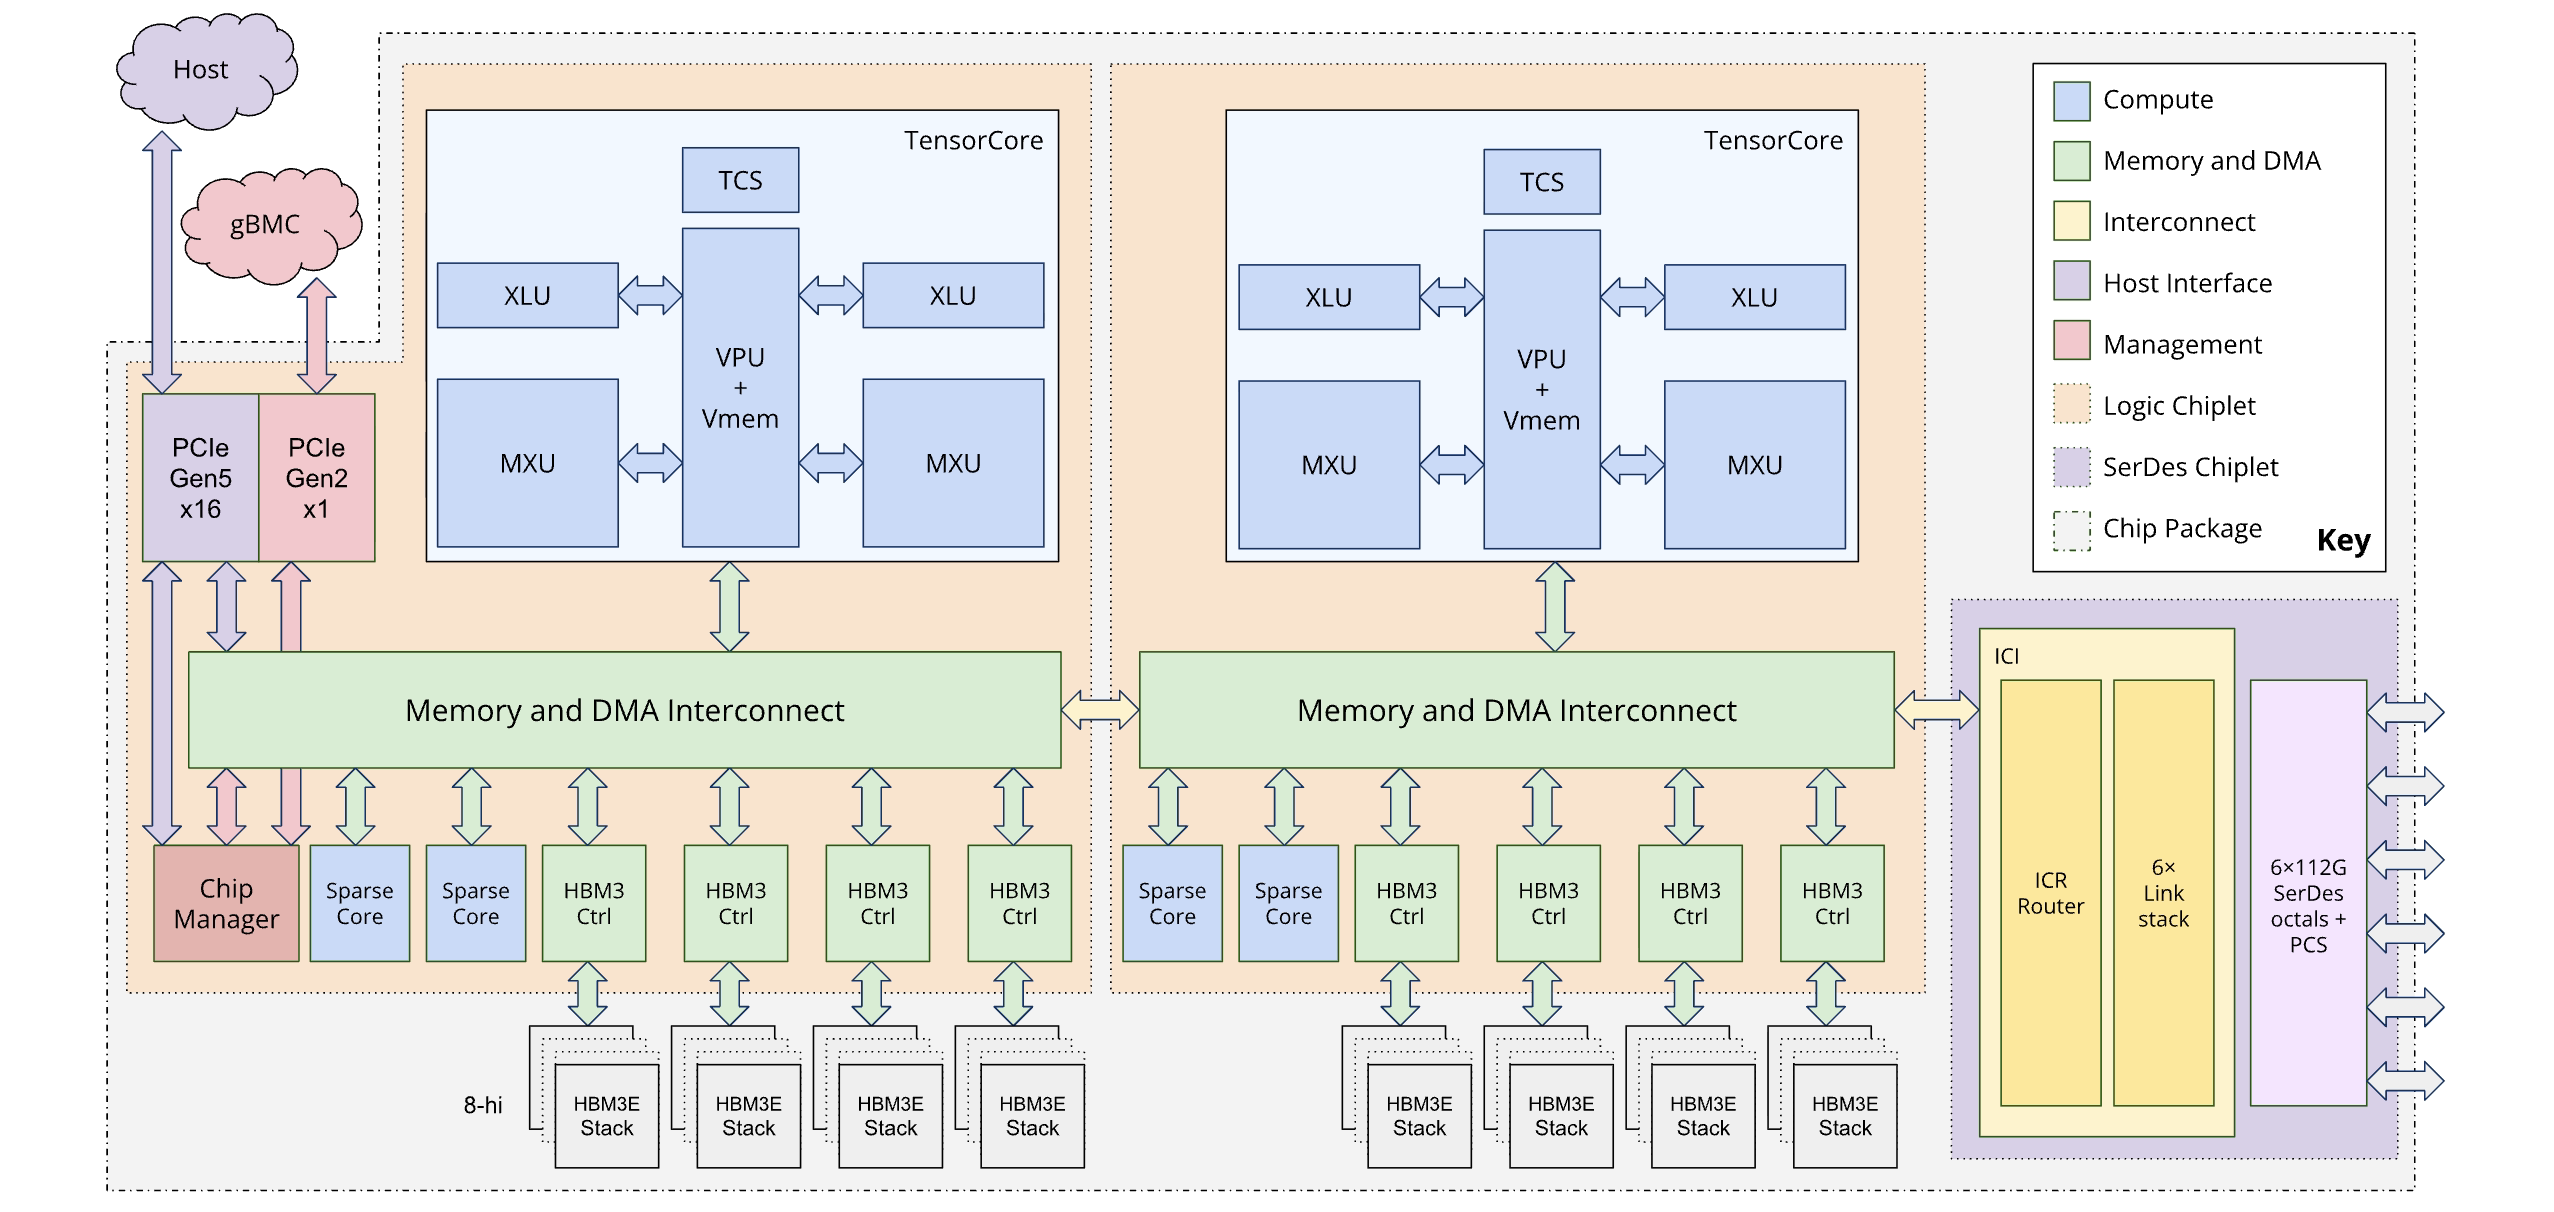
כל שבב TPU7x מכיל שתי ליבות Tensor וארבע ליבות Sparse. בטבלה הבאה מוצגים המפרטים העיקריים והערכים שלהם ב-TPU7x בהשוואה לדורות קודמים.
| מפרט | v5p | v6e (Trillium) | TPU7x (Ironwood) |
|---|---|---|---|
| מספר הצ'יפים בכל פוד | 8960 | 256 | 9216 |
| שיא העיבוד לכל שבב (BF16) (TFLOPs) | 459 | 918 | 2307 |
| שיא העיבוד לכל שבב (FP8) (TFLOPs) | 459 | 918 | 4614 |
| קיבולת HBM לכל שבב (GiB) | 95 | 32 | 192 |
| רוחב פס של HBM לכל שבב (GBps) | 2765 | 1638 | 7380 |
| מספר המעבדים הווירטואליים (מכונה וירטואלית עם 4 שבבים) | 208 | 180 | 224 |
| RAM (GB) (מכונה וירטואלית עם 4 שבבים) | 448 | 720 | 960 |
| מספר ליבות TensorCore בכל שבב | 2 | 1 | 2 |
| מספר ליבות SparseCore בכל שבב | 4 | 2 | 4 |
| רוחב פס דו-כיווני של חיבור בין שבבים (ICI) לכל שבב (GBps) | 1200 | 800 | 1200 |
| רוחב הפס של רשת מרכז הנתונים (DCN) לכל שבב (Gbps) | 50 | 100 | 100 |
התרשים הבא ממחיש את הארכיטקטורה של Ironwood:
היררכיית הזיכרון
ל-TPU7x יש מערכת זיכרון בכמה רמות, וכדי לשפר את הביצועים חשוב לנהל את תנועת הנתונים בין הרמות האלה:
זיכרון ברוחב פס גבוה (HBM): כל שבב מצויד ב-192 GiB של HBM, עם רוחב פס של כ-7.37 TB/s. הקיבולת הגדולה של ה-HBM מאפשרת גודלי אצווה גדולים, שיכולים לשפר את התפוקה. עם זאת, למרות הגודל שלו, HBM עדיין יכול להיות צוואר בקבוק, במיוחד לפעולות וקטוריות שמוגבלות על ידי הזיכרון או לדפוסי גישה לא יעילים לנתונים.
זיכרון וקטורי (VMEM): זיכרון VMEM הוא זיכרון SRAM (זיכרון גישה אקראית סטטי) קטן יותר על השבב, עם רוחב פס גדול משמעותית ליחידת Matrix Multiply Unit (MXU) בהשוואה ל-HBM. הזיכרון הזה משמש כפנקס טיוטה במהירות גבוהה לקרנלים בהתאמה אישית. גודל המאגר הזה הוא פרמטר שניתן לשנות. אופטימיזציה של שטח אחסון זמני היא קריטית לכוונון של ליבות Pallas בהתאמה אישית, כי גודל הבלוקים שלהן מוגבל לעיתים קרובות על ידי ה-VMEM הזמין.
זיכרון מארח ו-PCIe: כל קבוצה של ארבעה שבבי TPU מחוברת למארח של מעבד (CPU) באמצעות רשת PCIe. למרות שלחיבור הזה יש רוחב פס נמוך בהרבה מ-HBM, אפשר להשתמש בזיכרון הראשי של המארח כדי להעביר הפעלות או מצבי אופטימיזציה כדי לפנות HBM. זו טכניקה שימושית במיוחד לניהול לחץ הזיכרון במודלים גדולים.
מידע נוסף על ניהול יעיל של תנועת הנתונים בין השכבות של היררכיית הזיכרון של TPU7x זמין במאמר אופטימיזציות של ביצועים ב-Ironwood.
ארכיטקטורה של שני צ'יפלטים
מודל התכנות של Ironwood מאפשר לגשת לשני צ'יפלטים של TPU במקום לארכיטקטורה של ליבה לוגית אחת (שנקראת גם MegaCore) ששימשה בדורות קודמים (TPU v4 ו-v5p). השינוי הזה משפר את היעילות הכלכלית והתפעולית של ייצור השבב. למרות שמדובר בשינוי ארכיטקטוני, העיצוב החדש מאפשר לכם להשתמש שוב במודלים קיימים של תוכנה עם שינויים מינימליים.
יחידות TPU מדגם Ironwood מורכבות משני צ'יפלטים נפרדים, שלכל אחד מהם יש מרחב זיכרון ייעודי משלו. זה שונה ממרחב הזיכרון המאוחד של ארכיטקטורת MegaCore.
הרכב הצ'יפלט: כל צ'יפלט הוא יחידה עצמאית עם TensorCore אחד, שני SparseCores ו-96GiB של זיכרון ברוחב פס גבוה (HBM).
חיבור במהירות גבוהה: שני הצ'יפלטים מחוברים באמצעות ממשק die-to-die (D2D) שמהיר פי שישה מקישור 1D inter-chip interconnect (ICI). התקשורת בין הצ'יפלטים מנוהלת באמצעות פעולות קולקטיביות.
חשיפה למודלים ולמסגרות של תכנות
מודל התכנות של Ironwood דומה לזה של דורות TPU שקדמו לגרסה 4, כמו TPU v3. הארכיטקטורה החדשה נחשפת בדרכים הבאות:
שני מכשירים לכל שבב: מסגרות כמו JAX חושפות כל שבב Ironwood כשני "מכשירים" נפרדים, אחד לכל צ'יפלט. לדוגמה, במכונה וירטואלית אחת של
tpu7x-standard-4tעם 4 צ'יפים, הפונקציהjax.devices()מחזירה שמונה רשומות שלTpuDevice(שתיים לכל צ'יפ).מפרט צ'יפלט: אתם יכולים לציין באיזה צ'יפלט להשתמש לחישוב. JAX מוסיף מימד רביעי (
(x, y, z, chiplet)) למפרט הקואורדינטות של המכשיר, שבו הקואורדינטה הרביעית (0או1) מבדילה בין שני הצ'יפלטים בשבב. העיצוב הזה מאפשר לכם להשתמש מחדש במודלים קיימים של תוכנה בשינויים מינימליים.
למידע נוסף על השגת ביצועים אופטימליים עם ארכיטקטורת צ'יפלט כפול, קראו את המלצות לביצועים בארכיטקטורת צ'יפלט כפול של Ironwood.
הגדרות נתמכות
לשבבי TPU7x יש חיבור ישיר לשבבים השכנים הקרובים ביותר ב-3 ממדים, וכתוצאה מכך נוצרת רשת תלת-ממדית של חיבורי רשת. פרוסות של 64 צ'יפים או יותר מורכבות מ"קוביות" של צ'יפים בגודל 4x4x4, שמחוברות בטופולוגיית חיבור טורוס תלת-ממדית.
מערך TPU7x Pod יכול להכיל עד 9,216 שבבים (144 קוביות). כל אחד מ-6 קישורי ה-ICI בשבב TPU7x מספק רוחב פס דו-כיווני של 200GBps (400GBps לכל ציר ורוחב פס דו-כיווני כולל של 1,200GBps לכל שבב) לתקשורת בין שבבים בתוך Pod.
בטבלה הבאה מוצגות צורות נפוצות של פרוסות תלת-ממדיות שנתמכות ב-TPU7x:
| טופולוגיה | צ'יפים של TPU | מארחים | VMs (מכונות וירטואליות) | קוביות | היקף |
|---|---|---|---|---|---|
| 2x2x1 | 4 | 1 | 1 | 1/16 | מארח יחיד |
| 2x2x2 | 8 | 2 | 2 | 1/8 | מספר מארחים |
| 2x2x4 | 16 | 4 | 4 | 1/4 | מספר מארחים |
| 2x4x4 | 32 | 8 | 8 | 1/2 | מספר מארחים |
| 4x4x4 | 64 | 16 | 16 | 1 | מספר מארחים |
| 4x4x8 | 128 | 32 | 32 | 2 | מספר מארחים |
| 4x8x8 | 256 | 64 | 64 | 4 | מספר מארחים |
| 8x8x8 | 512 | 128 | 128 | 8 | מספר מארחים |
| 8x8x16 | 1024 | 256 | 256 | 16 | מספר מארחים |
| 8x16x16 | 2048 | 512 | 512 | 32 | מספר מארחים |
AxBxC (כאשר A, B ו-C הם כפולות של 4) |
A*B*C (עד 9,216) |
(A*B*C)/4 |
(A*B*C)/4 |
(A*B*C)/64 |
מספר מארחים |
TPU7x VM
כל מכונה וירטואלית (VM) מסוג TPU7x מכילה 4 צ'יפים. לכל VM יש גישה לשני צומתי NUMA. למידע נוסף על צומתי NUMA, קראו את המאמר Non-uniform memory access בוויקיפדיה.
כל פרוסות TPU7x משתמשות במכונות וירטואליות עם מארח מלא ו-4 צ'יפים. המפרט הטכני של מכונה וירטואלית מסוג TPU7x:
- מספר מעבדי ה-vCPU לכל מכונה וירטואלית: 224
- RAM לכל מכונה וירטואלית: 960GB
- מספר צומתי NUMA לכל מכונה וירטואלית: 2
מודלים נתמכים
מודל נתמך עובר כוונון ואימות לחומרת TPU7x. אתם יכולים לפרוס ולהריץ מודלים נתמכים בלי לשנות את הקוד. המודלים הנתמכים מוגדרים כך שינצלו את התכונות של TPU7x, כולל ארכיטקטורת צ'יפלט כפול, חיבורים ברוחב פס גבוה (ICI), HBM וחישובים ברמת דיוק משולבת (כמו FP8 ו-BF16).
Google וקהילת הקוד הפתוח מתחזקות מתכונים, הגדרות ותמיכה שהותאמו מראש לעומסי עבודה של אימון והסקה ב-TPU7x.
מודלים שעברו אופטימיזציה לאימון
מודלים שעברו אופטימיזציה לאימון כוללים מתכונים שהוגדרו מראש והיפר-פרמטרים שמותאמים למסגרות אימון מבוזרות. המתכונים האלה מגדירים אסטרטגיות אופטימליות של מקביליות (כולל מקביליות של נתונים, טנזורים, צינורות עיבוד נתונים והקשרים) כדי למקסם את קצב העיבוד ואת יעילות ההתאמה לעומס (scaling) בטופולוגיות של TPU7x עם מארח יחיד ועם כמה פרוסות.
כדי למצוא מתכוני אימון, מדריכים ונקודות השוואה לביצועים של מודלים נתמכים ב-TPU7x, אפשר לעיין במקורות המידע הבאים:
- מתכוני אימון TPU ל-TPU7x: מאגר GitHub הרשמי שמכיל מתכוני אימון שהוגדרו מראש, הגדרות דיוק (FP8 ו-BF16), נקודות השוואה לזמן שלב ומדדי תפוקה למודלים פתוחים פופולריים ב-TPU7x.
- מאגר MaxText: מסגרת לאימון מודלים גדולים של שפה (LLM) בקוד פתוח ובביצועים גבוהים, שכתובה ב-JAX ומותאמת ל-Cloud TPU.
- אימון מודל באמצעות TPU7x: מדריך להקצאת משאבי TPU7x ופריסת עומסי עבודה של אימון באמצעות MaxText.
- TorchTitan ב-TPU: מסגרת בקוד פתוח שמבוססת על TorchTitan של PyTorch, ומותאמת לאימון מודלים גדולים ב-Cloud TPU.
מודלים שעברו אופטימיזציה להסקת מסקנות
מודלים שעברו אופטימיזציה להסקת מסקנות מאומתים להצגה ב-TPU7x באמצעות vLLM ו-SGLang, עם קצוות עורפיים של JAX ו-PyTorch (TorchTPU). המודלים האלה נבדקים כדי לוודא שהם תקינים, מדויקים מבחינה מספרית ובעלי קצב העברת נתונים תקין, באמצעות מקביליות של טנזורים וליבות TPU בהתאמה אישית שנכתבו ב-Pallas וב-Tokamax.
במקורות המידע הבאים מוסבר איך למצוא מתכונים להצגה וכלים לפריסה של מודלים נתמכים ב-TPU7x:
- TPU inference recipes for TPU7x: מתכונים, הגדרות ומניפסטים של פריסה שעברו אופטימיזציה ל-TPU7x.
- vLLM ב-TPU: מילוי בקשות באמצעות הקצה העורפי
vllm-jaxלמודלים של JAX והקצה העורפיvllm-torchtpuלמודלים של PyTorch. - SGLang ב-TPU: הצגה באמצעות הקצה העורפי של
sglang-jaxלמודלים של JAX והקצה העורפי שלsglang-torchtpuלמודלים של PyTorch. - מטריצת התמיכה במודל TPU v7x vLLM: תוצאות של בדיקות אוטומטיות ליליות של בדיקות יחידה, נכוֹנוּת וסטטוס השוואה לשוק ב-TPU7x.
- הרצת הסקה ב-Cloud TPU: מדריך להגדרת פרסום מודל במארח יחיד ב-Cloud TPU.
Hyperdisk
כברירת מחדל, דיסק האתחול של ה-VM ל-TPU7x הוא Hyperdisk Balanced. כדי להגדיל את נפח האחסון, אתם יכולים לחבר עוד דיסקים ל-TPU VM. אלה סוגי הדיסקים שנתמכים ב-TPU7x:
- Hyperdisk Balanced
- Hyperdisk ML
מידע נוסף על Hyperdisk זמין במאמר סקירה כללית על Hyperdisk. מידע נוסף על אפשרויות האחסון של Cloud TPU מופיע במאמר אפשרויות אחסון לנתוני Cloud TPU.
המאמרים הבאים
- שימוש ב-TPU7x עם GKE
- שימוש ב-TPU7x במצב All Capacity
- שימוש בפלטפורמת Google Cloud ML Diagnostics כדי לבצע אופטימיזציה ולאבחן את עומסי העבודה
- הרצת עומס עבודה של אימון באמצעות מתכון שעבר אופטימיזציה ל-TPU7x
- הרצת בדיקת ביצועים של TPU7x
- אופטימיזציה של ביצועי Ironwood
- אימון מודלים של למידת מכונה בקנה מידה גדול ב-GKE באמצעות Multi-Tier Checkpointing