


總覽
本頁面說明查詢執行計畫背後的概念,以及 Spanner 如何使用這些計畫在分散式環境中執行查詢。如要瞭解如何使用Google Cloud 控制台擷取特定查詢的執行計畫,請參閱「瞭解 Spanner 如何執行查詢」。您也可以查看取樣的歷來查詢計畫,比較不同時間點的查詢效能。詳情請參閱「取樣查詢計畫」。
Spanner 使用宣告式 SQL 陳述式查詢資料庫。SQL 陳述式會定義使用者「想要」什麼,但不會指定「如何」取得結果。「查詢執行計畫」是一組取得結果的步驟。對於特定的 SQL 陳述式,取得結果的方式可能有很多種。Spanner 查詢最佳化工具會評估不同的執行計畫,並選擇最有效率的計畫。Spanner 接著會使用執行計畫擷取結果。執行計畫支援 GoogleSQL 方言資料庫和 PostgreSQL 方言資料庫。
如要進一步瞭解查詢最佳化工具,請參閱「查詢最佳化工具總覽」。
就概念上而言,執行計劃就是相關運算子的樹狀結構。每個運算子都會從輸入內容讀取資料列,並產生輸出資料列。系統會傳回執行作業根部的運算子結果做為 SQL 查詢的結果。
以下列查詢為例:
SELECT s.SongName FROM Songs AS s;
這項查詢會產生查詢執行計畫,可視覺化呈現如下:
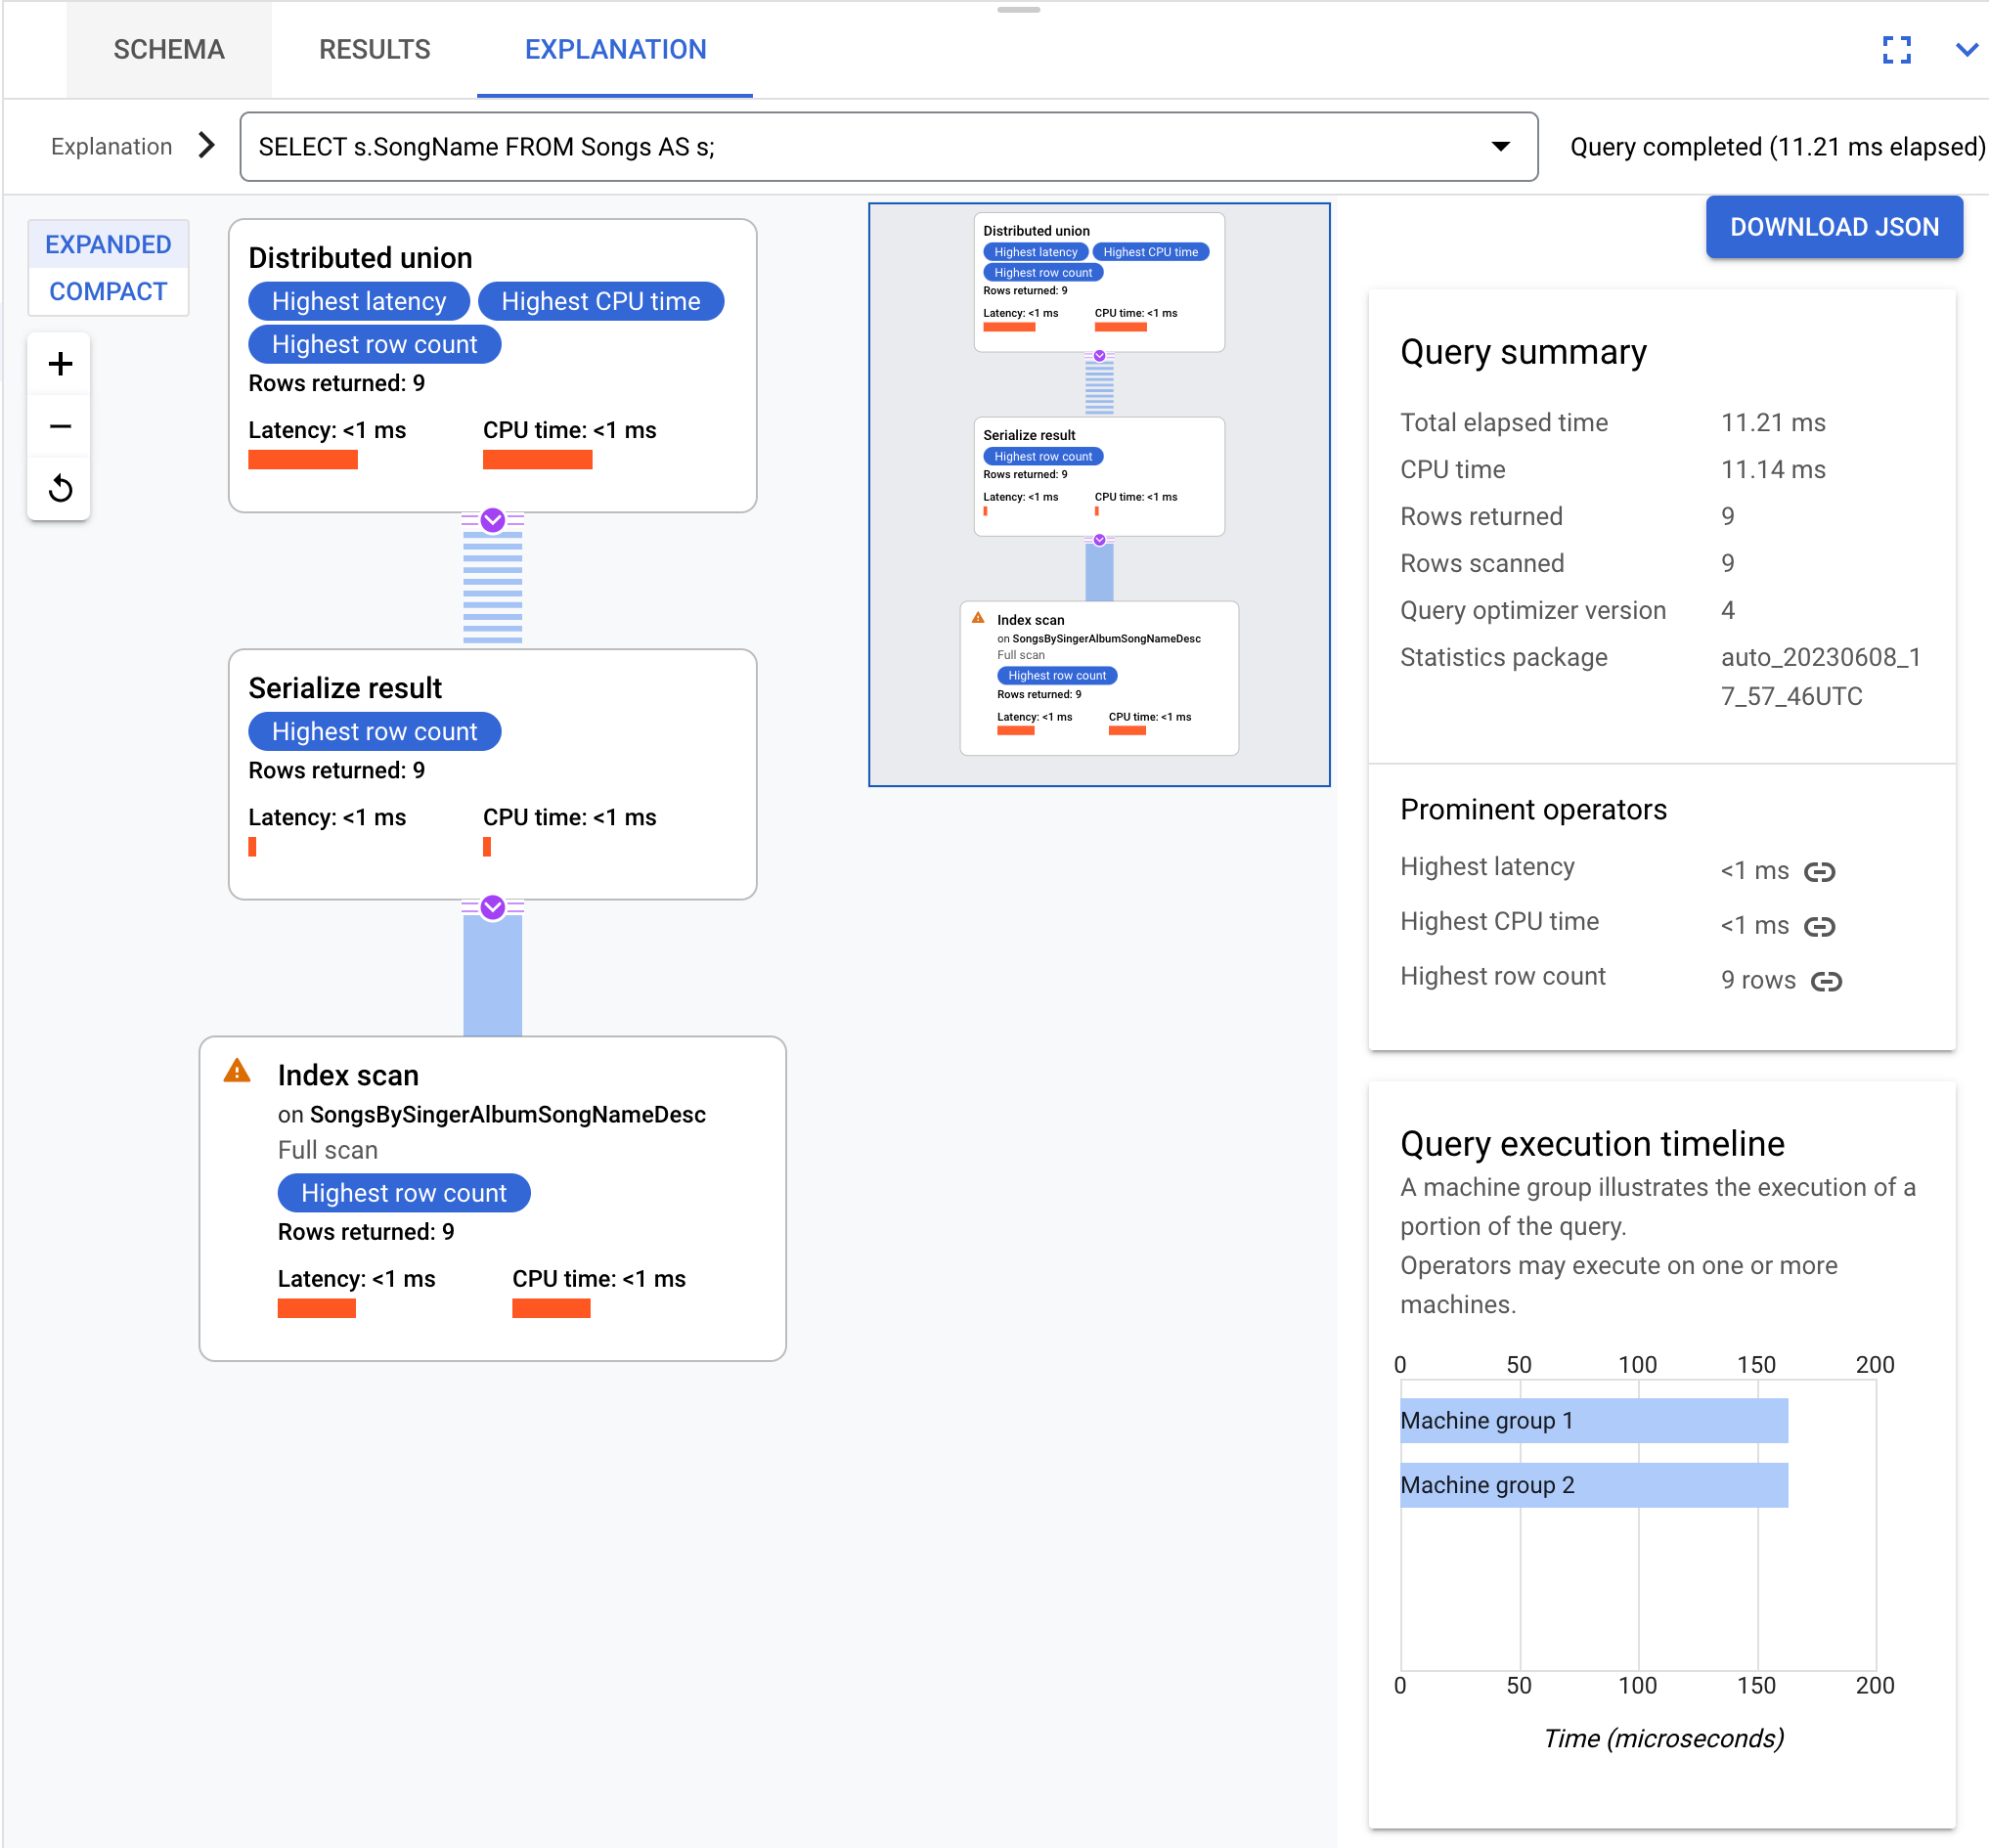
在這個範例中,Spanner 會由上而下執行查詢計畫,資料則由下而上流動。distributed union 運算子會先執行。藍色虛線表示這個運算子可以發出遠端呼叫。無論是在本機或遠端,系統都會叫用 serialize result 運算子,並繼續沿著樹狀結構向下執行。當 table scan 運算子產生資料列時,會立即將控制權交還給 serialize result 運算子。這個程序會持續進行,直到查詢掃描完所有資料列。
本頁的查詢和執行計畫是以以下資料庫結構定義為基礎:
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo BYTES(MAX),
  BirthDate  DATE
) PRIMARY KEY(SingerId);

CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);

CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);

CREATE TABLE Songs (
  SingerId  INT64 NOT NULL,
  AlbumId   INT64 NOT NULL,
  TrackId   INT64 NOT NULL,
  SongName  STRING(MAX),
  Duration  INT64,
  SongGenre STRING(25)
) PRIMARY KEY(SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC), INTERLEAVE IN Albums;

CREATE INDEX SongsBySongName ON Songs(SongName);

CREATE TABLE Concerts (
  VenueId      INT64 NOT NULL,
  SingerId     INT64 NOT NULL,
  ConcertDate  DATE NOT NULL,
  BeginTime    TIMESTAMP,
  EndTime      TIMESTAMP,
  TicketPrices ARRAY<INT64>
) PRIMARY KEY(VenueId, SingerId, ConcertDate);
您可以使用下列 data manipulation language (DML) 陳述式,將資料新增至這些資料表:
INSERT INTO Singers (SingerId, FirstName, LastName, BirthDate)
VALUES (1, "Marc", "Richards", "1970-09-03"),
       (2, "Catalina", "Smith", "1990-08-17"),
       (3, "Alice", "Trentor", "1991-10-02"),
       (4, "Lea", "Martin", "1991-11-09"),
       (5, "David", "Lomond", "1977-01-29");

INSERT INTO Albums (SingerId, AlbumId, AlbumTitle)
VALUES (1, 1, "Total Junk"),
       (1, 2, "Go, Go, Go"),
       (2, 1, "Green"),
       (2, 2, "Forever Hold Your Peace"),
       (2, 3, "Terrified"),
       (3, 1, "Nothing To Do With Me"),
       (4, 1, "Play");

INSERT INTO Songs (SingerId, AlbumId, TrackId, SongName, Duration, SongGenre)
VALUES (2, 1, 1, "Let's Get Back Together", 182, "COUNTRY"),
       (2, 1, 2, "Starting Again", 156, "ROCK"),
       (2, 1, 3, "I Knew You Were Magic", 294, "BLUES"),
       (2, 1, 4, "42", 185, "CLASSICAL"),
       (2, 1, 5, "Blue", 238, "BLUES"),
       (2, 1, 6, "Nothing Is The Same", 303, "BLUES"),
       (2, 1, 7, "The Second Time", 255, "ROCK"),
       (2, 3, 1, "Fight Story", 194, "ROCK"),
       (3, 1, 1, "Not About The Guitar", 278, "BLUES");
Spanner 會將資料分成分割,因此難以取得有效的執行計畫。分割區可以獨立移動,Spanner 也能將分割區指派給不同伺服器,這些伺服器可能位於不同實體位置。為了評估分散式資料的執行計畫,Spanner 會執行下列工作:
- 在本機上,於儲存資料的伺服器執行子計畫。
- 透過積極的分散式剪枝,自動調度管理及匯總多項遠端執行作業。
為啟用這個模型,Spanner 會使用 distributed union 運算子,以及其 distributed cross apply 和 distributed outer apply 變體。
Spanner 如何執行查詢
概念上,查詢流程是由上往下執行,查詢結果則是由下往上傳回。這個模式如下圖所示:
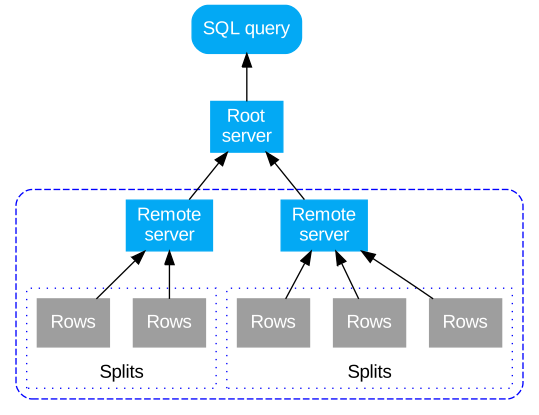
Spanner 會將 SQL 查詢編譯成執行計畫,為盡可能減少到達查詢資料的躍點數,Spanner 會選擇初始「根」伺服器,並將計畫傳送至該伺服器。根伺服器會執行下列動作:
- 視需要啟動子計畫的遠端執行作業。
- 等待遠端執行的結果。
- 完成任何剩餘的本機執行步驟,例如匯總結果。
- 傳回查詢結果。
收到子計畫的遠端伺服器會做為其子計畫的根伺服器,按照頂層根伺服器的模式執行。這種執行模式會產生遠端執行作業的樹狀結構。
主要成效指標
Spanner Studio 查詢計畫視覺化工具會顯示查詢執行的摘要指標。摘要指標代表查詢期間執行的所有個別運算子指標匯總。下表說明主要成效指標:
| 指標 | 說明 |
|---|---|
| 經過時間總計 | 執行查詢所花費的總實際時間。 |
| CPU 作業時間 | 執行查詢時,所有相關伺服器耗費的 CPU 作業時間總計。由於查詢執行作業的某些部分可以平行處理,因此 CPU 作業時間有可能超過總執行時間。 |
取樣的查詢計畫
Spanner 取樣查詢計畫可讓您查看歷來查詢計畫的樣本,並比較查詢在一段時間內的效能。並非所有查詢都有取樣查詢計畫。Spanner 可能只會對耗用大量 CPU 的查詢進行取樣。Spanner 會保留查詢計畫樣本 30 天。如要在Google Cloud 控制台的「Query insights」(查詢洞察) 頁面中查看查詢計畫樣本,請參閱「查看取樣的查詢計畫」。
取樣查詢計畫的結構與一般查詢執行計畫相同。如要進一步瞭解如何解讀視覺化計畫,並使用這些計畫對查詢進行偵錯,請參閱「查詢計畫視覺化工具導覽」。
取樣查詢計畫的常見用途
取樣查詢計畫的常見用途包括:
- 因結構定義變更 (例如新增或移除索引) 而觀察查詢計畫變更。
- 因最佳化工具版本更新而觀察查詢計畫變更。
- 觀察新的最佳化工具統計資料導致的查詢計畫變更。Spanner 每三天會自動收集這些統計資料,您也可以使用
ANALYZE指令手動更新。
如果查詢效能隨時間大幅變化,或您想提高效能,請參閱 SQL 最佳做法,建構最佳化的查詢陳述式,協助 Spanner 找出有效率的執行計畫。
常見模式
以下範例說明 Spanner 執行計畫中的常見模式。
匯總查詢
匯總查詢會實作 GROUP BY 邏輯。
舉例來說,下列查詢會依歌手計算歌曲數量:
SELECT s.SingerId, COUNT(*) AS SongCount
FROM Songs AS s
WHERE s.SingerId < 100
GROUP BY s.SingerId;
結果會是:
+----------+-----------+
| SingerId | SongCount |
+----------+-----------+
|        3 |         1 |
|        2 |         8 |
+----------+-----------+
概念上,下方是執行計劃:

Spanner 會將執行計畫傳送至根伺服器,由根伺服器協調執行查詢作業,並從遠端發布子計畫。
這項執行計畫從 distributed union 運算子開始,將子計畫分散至分割符合 SingerId < 100 的遠端伺服器。個別分割區的掃描作業完成後,stream aggregate 運算子會匯總資料列,取得每個 SingerId 的計數。serialize result 運算子接著會序列化結果。最後,distributed union 會合併所有結果,並傳回查詢結果。
如要進一步瞭解匯總,請參閱「匯總運算子」。
co-located join 查詢
在交錯式資料表中,Spanner 會將相關資料列儲存在同一位置。共置彙整是指交錯式資料表之間的彙整。與需要索引或反向 join 的 join 相比,共置 join 可提升效能。
例如,請思考以下查詢:
SELECT al.AlbumTitle, so.SongName
FROM Albums AS al, Songs AS so
WHERE al.SingerId = so.SingerId AND
      al.AlbumId = so.AlbumId;
這項查詢假設 Songs 與 Albums 交錯。
結果會是:
+-----------------------+--------------------------+
| AlbumTitle            | SongName                 |
+-----------------------+--------------------------+
| Nothing To Do With Me | Not About The Guitar     |
| Green                 | The Second Time          |
| Green                 | Starting Again           |
| Green                 | Nothing Is The Same      |
| Green                 | Let's Get Back Together  |
| Green                 | I Knew You Were Magic    |
| Green                 | Blue                     |
| Green                 | 42                       |
| Terrified             | Fight Story              |
+-----------------------+--------------------------+
以下為執行計畫:
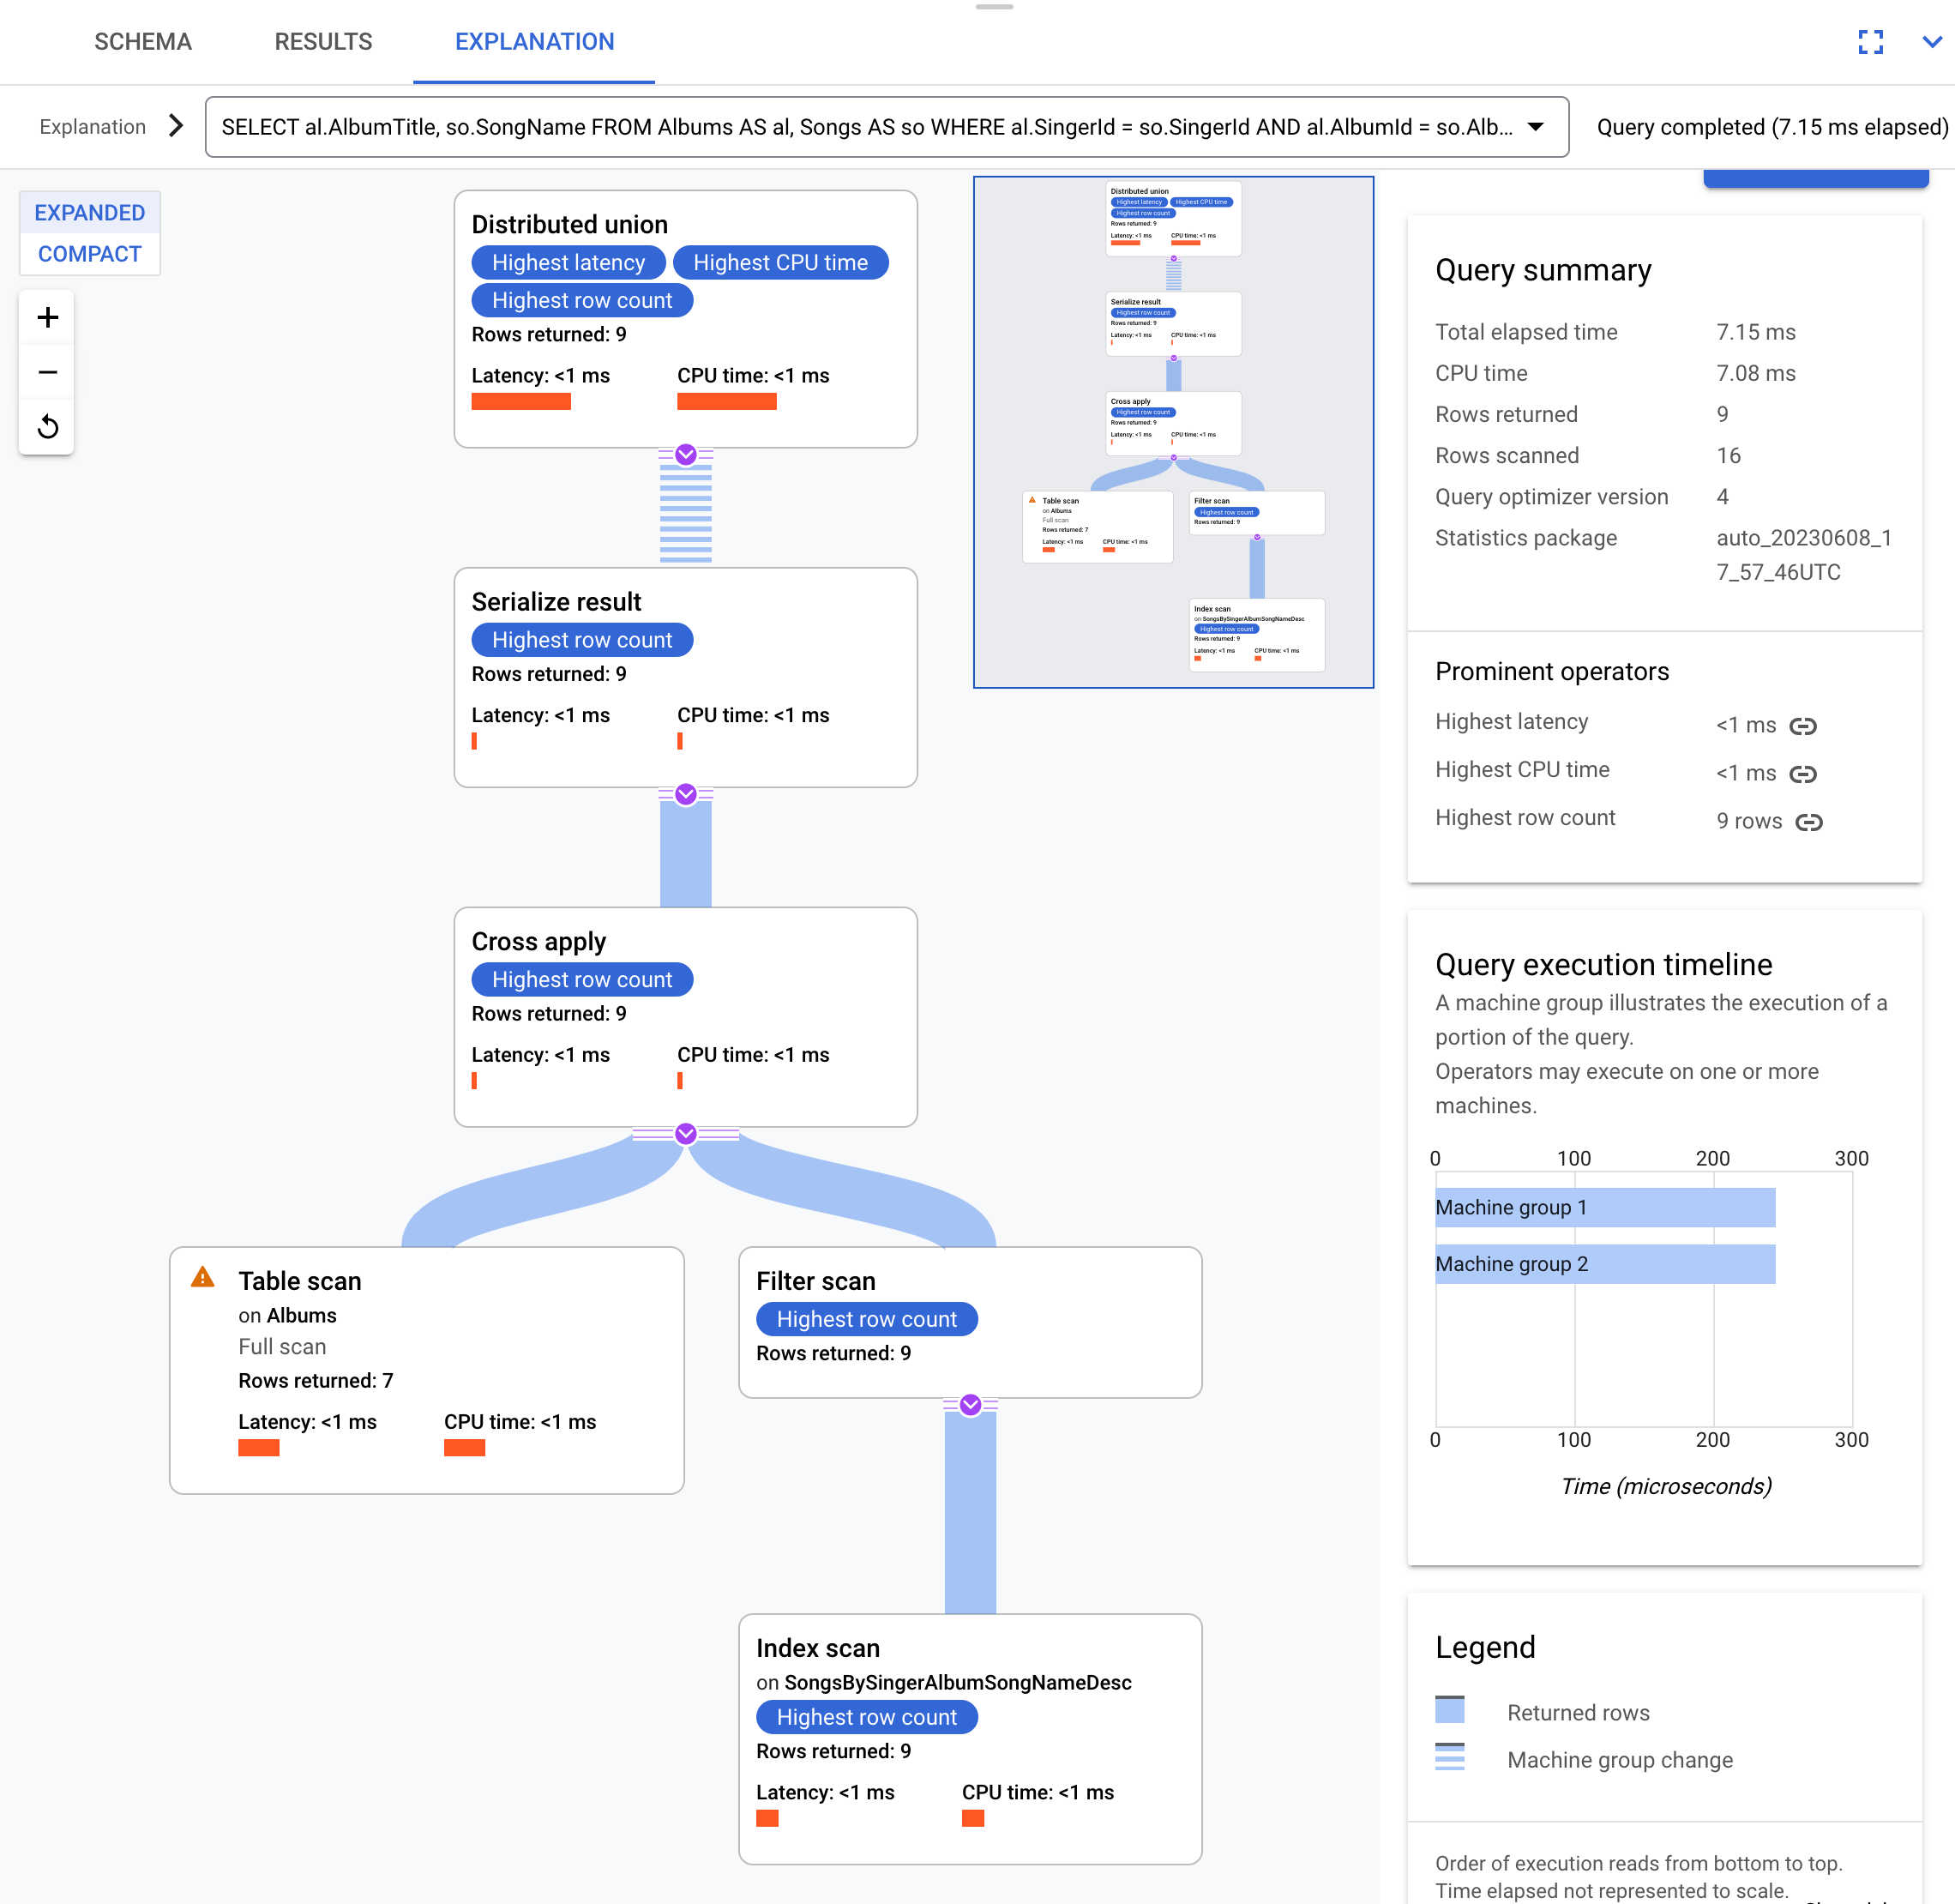
這項執行計畫從 distributed union 運算子開始,將子計畫分散至含有 Albums 資料表分割的遠端伺服器。由於 Songs 交錯於 Albums,每個遠端伺服器都會在本機執行整個子計畫,不會跨不同伺服器執行彙整。
子計畫包含 cross apply 運算子。每個 cross apply 運算子都會對 Albums 資料表執行 table scan,以擷取 SingerId、AlbumId 和 AlbumTitle。接著,cross apply 運算子會將資料表掃描輸出內容,對應至 SongsBySingerAlbumSongNameDesc 索引的索引掃描輸出內容。這個索引會套用篩選器,要求索引中的 SingerId 必須與資料表掃描輸出內容中的 SingerId 相符。每個 cross apply 運算子都會將結果傳送至 serialize result 運算子,該運算子會將 AlbumTitle 和 SongName 資料序列化,並將結果傳回本機分散式聯集。分散式聯集匯總本機分散式聯集的結果後,會傳回這些結果做為查詢結果。
索引與後端彙整查詢
上例使用 join 彙整兩個資料表,其中一個資料表交錯在另一個資料表中。如果兩個資料表 (或一個資料表和一個索引) 未交錯,執行計畫會更複雜且效率較低。
建議使用以下指令建立索引:
CREATE INDEX SongsBySongName ON Songs(SongName);
如要在查詢中使用這個索引,請選取下列其中一個資料庫方言選項:
GoogleSQL
SELECT s.SongName, s.Duration
FROM Songs@{force_index=SongsBySongName} AS s
WHERE STARTS_WITH(s.SongName, "B");
PostgreSQL
SELECT s.SongName, s.Duration
FROM Songs /*@ force_index=SongsBySongName */ AS s
WHERE STARTS_WITH(s.SongName, "B");
結果會是:
+----------+----------+
| SongName | Duration |
+----------+----------+
| Blue     |      238 |
+----------+----------+
以下為執行計畫:
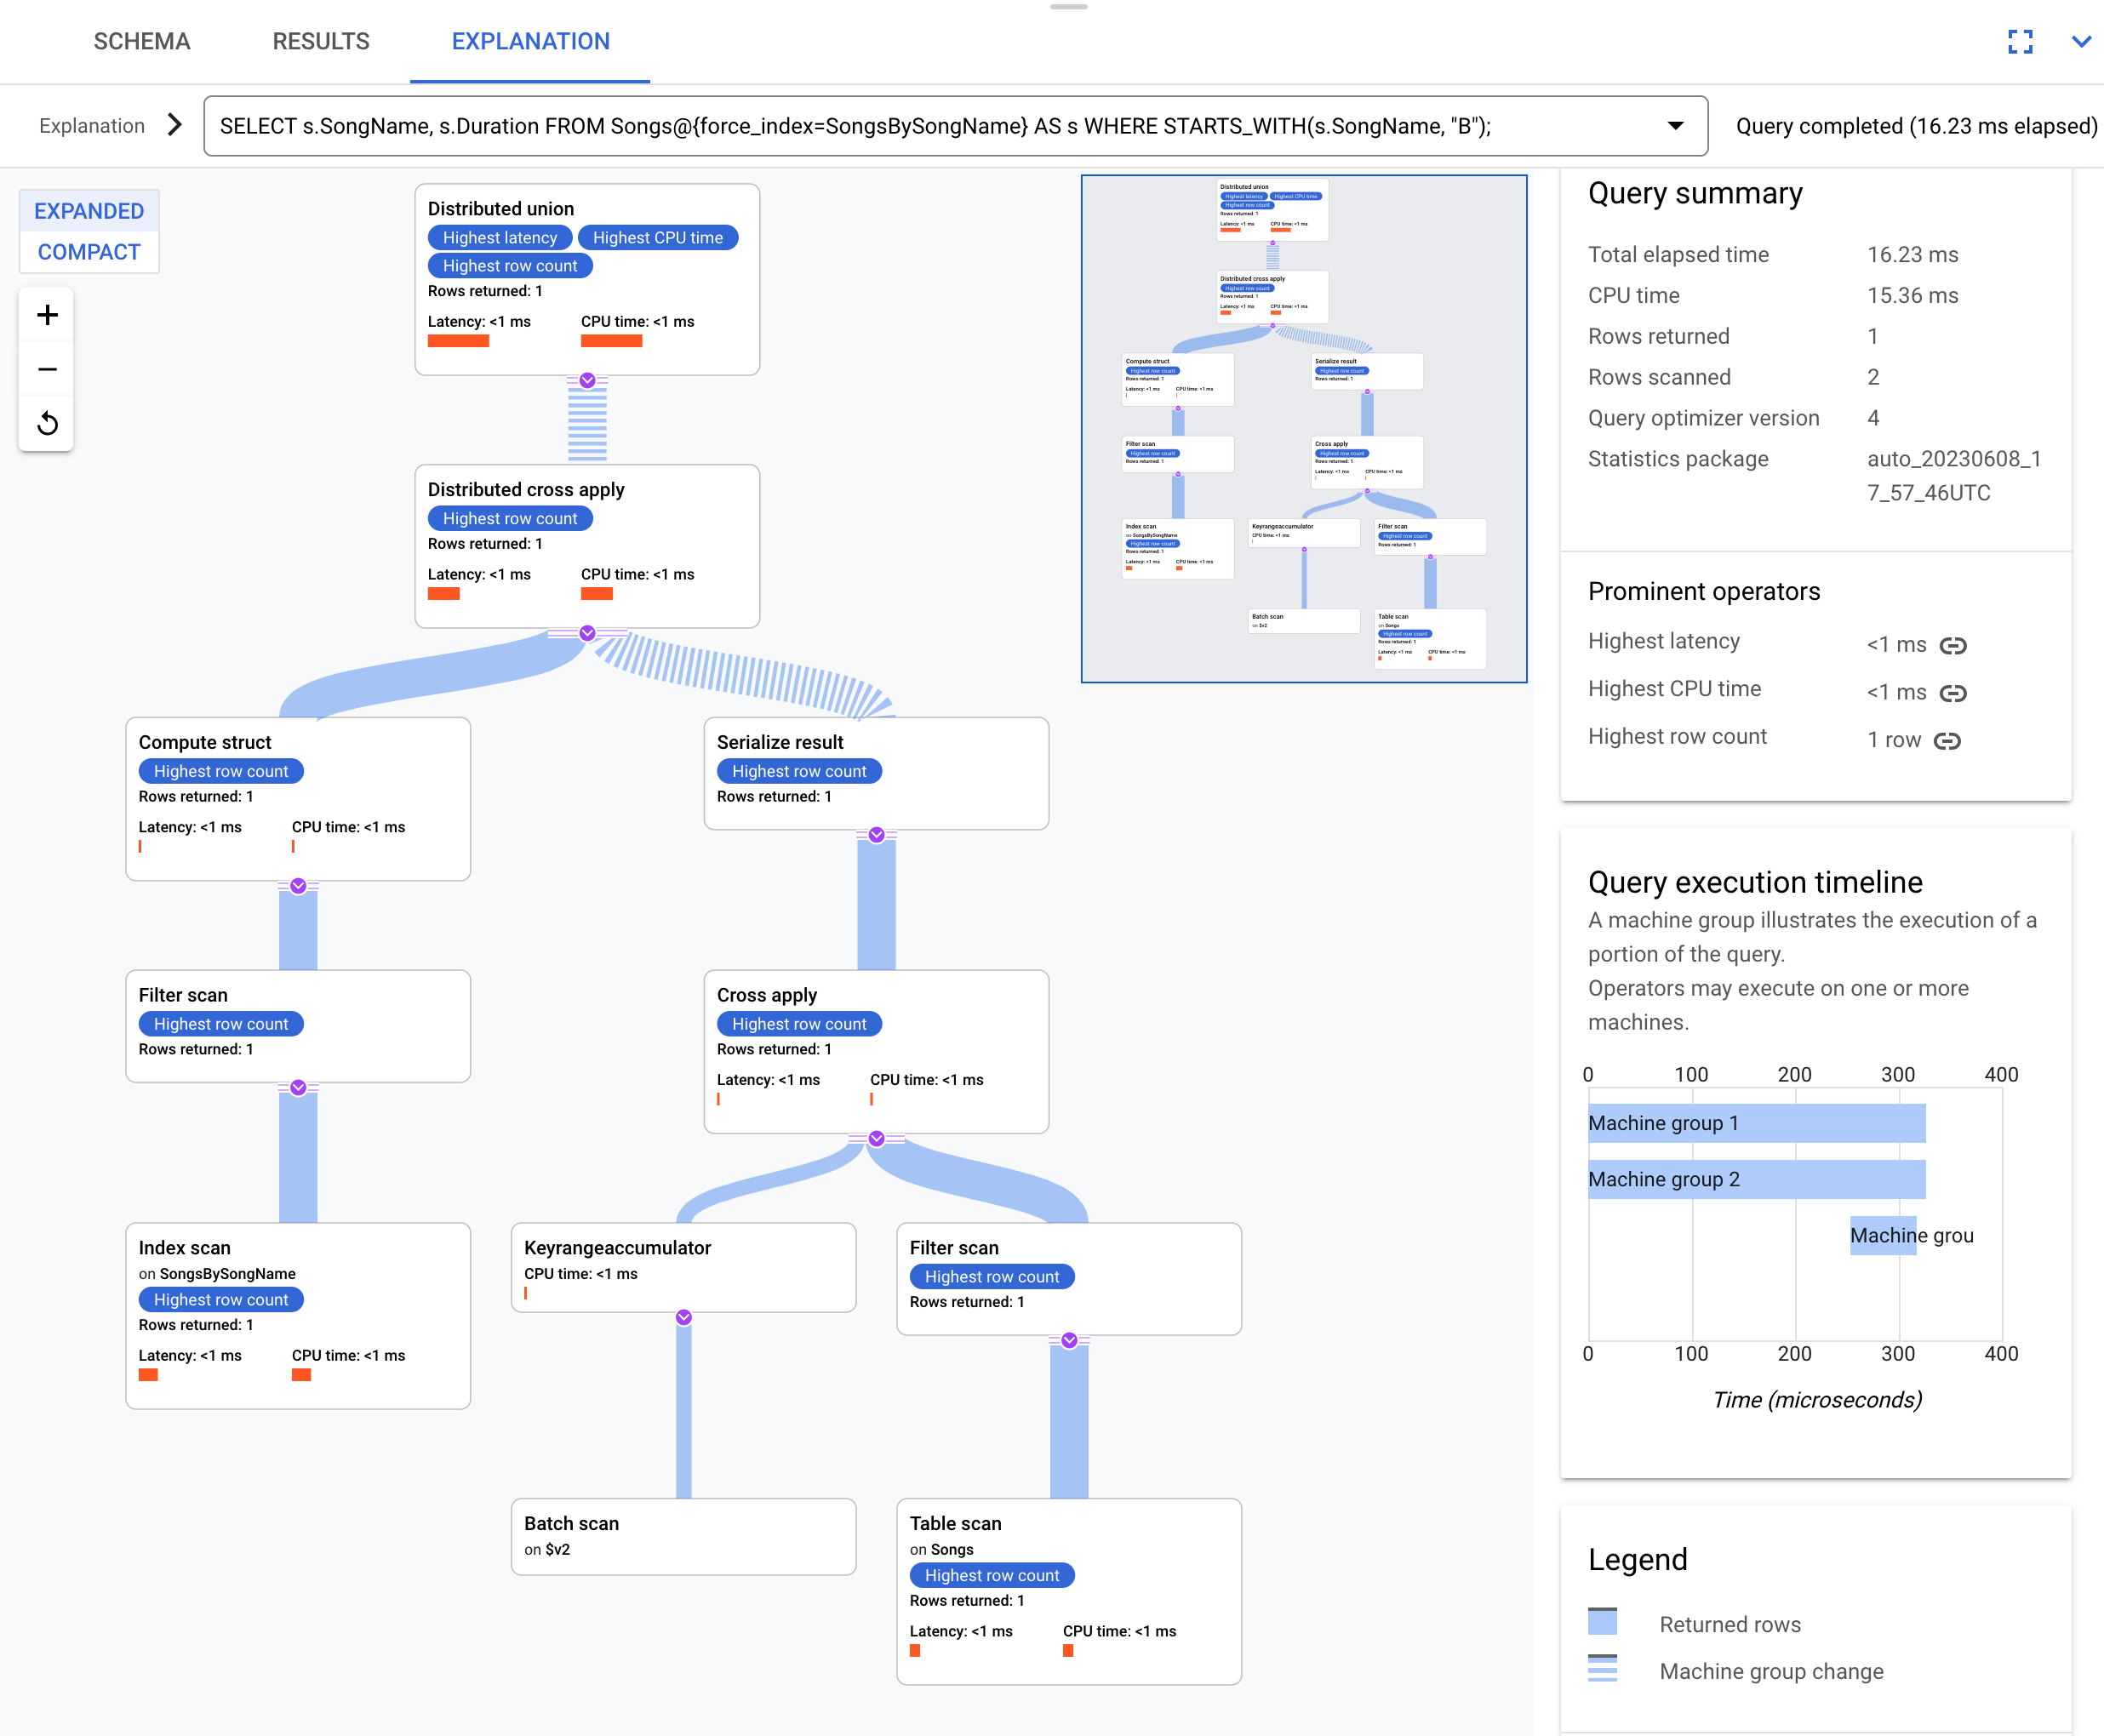
產生的執行計畫很複雜,因為 SongsBySongName 索引不含 Duration 欄。為了取得 Duration 值,Spanner 會將索引結果重新彙整至 Songs 資料表。這是一項彙整作業,但並非共置,因為 Songs 資料表和 SongsBySongName 全域索引並未交錯。如果資料未共置,Spanner 會執行最佳化作業,加快執行速度。這些最佳化作業會使執行計畫比先前的共置 join 範例更複雜。
頂端運算子是 distributed cross apply。這個運算子的輸入端會從 SongsBySongName 索引接收符合 STARTS_WITH(s.SongName, "B") 述詞的多批資料列。接著,distributed cross apply 運算子會將這些批次對應至含有 Duration 資料分割的遠端伺服器。如要擷取 Duration 資料欄,遠端伺服器會執行資料表掃描。這項掃描會使用 Condition:($Songs_key_TrackId' = $batched_Songs_key_TrackId) 篩選條件,將 Songs 資料表中的 TrackId 彙整至從 SongsBySongName 索引批次處理的資料列 TrackId 欄。
Spanner 會將結果匯總為最終查詢答案。distributed cross apply 運算子的輸入端則包含 distributed union 或 local distributed union 配對,用於評估索引中符合 STARTS_WITH 述詞的資料列。
假設查詢略有不同,未選取 s.Duration 欄:
GoogleSQL
SELECT s.SongName
FROM Songs@{force_index=SongsBySongName} AS s
WHERE STARTS_WITH(s.SongName, "B");
PostgreSQL
SELECT s.SongName
FROM Songs /*@ force_index=SongsBySongName */ AS s
WHERE STARTS_WITH(s.SongName, "B");
下列執行計畫顯示這項查詢完全使用索引:
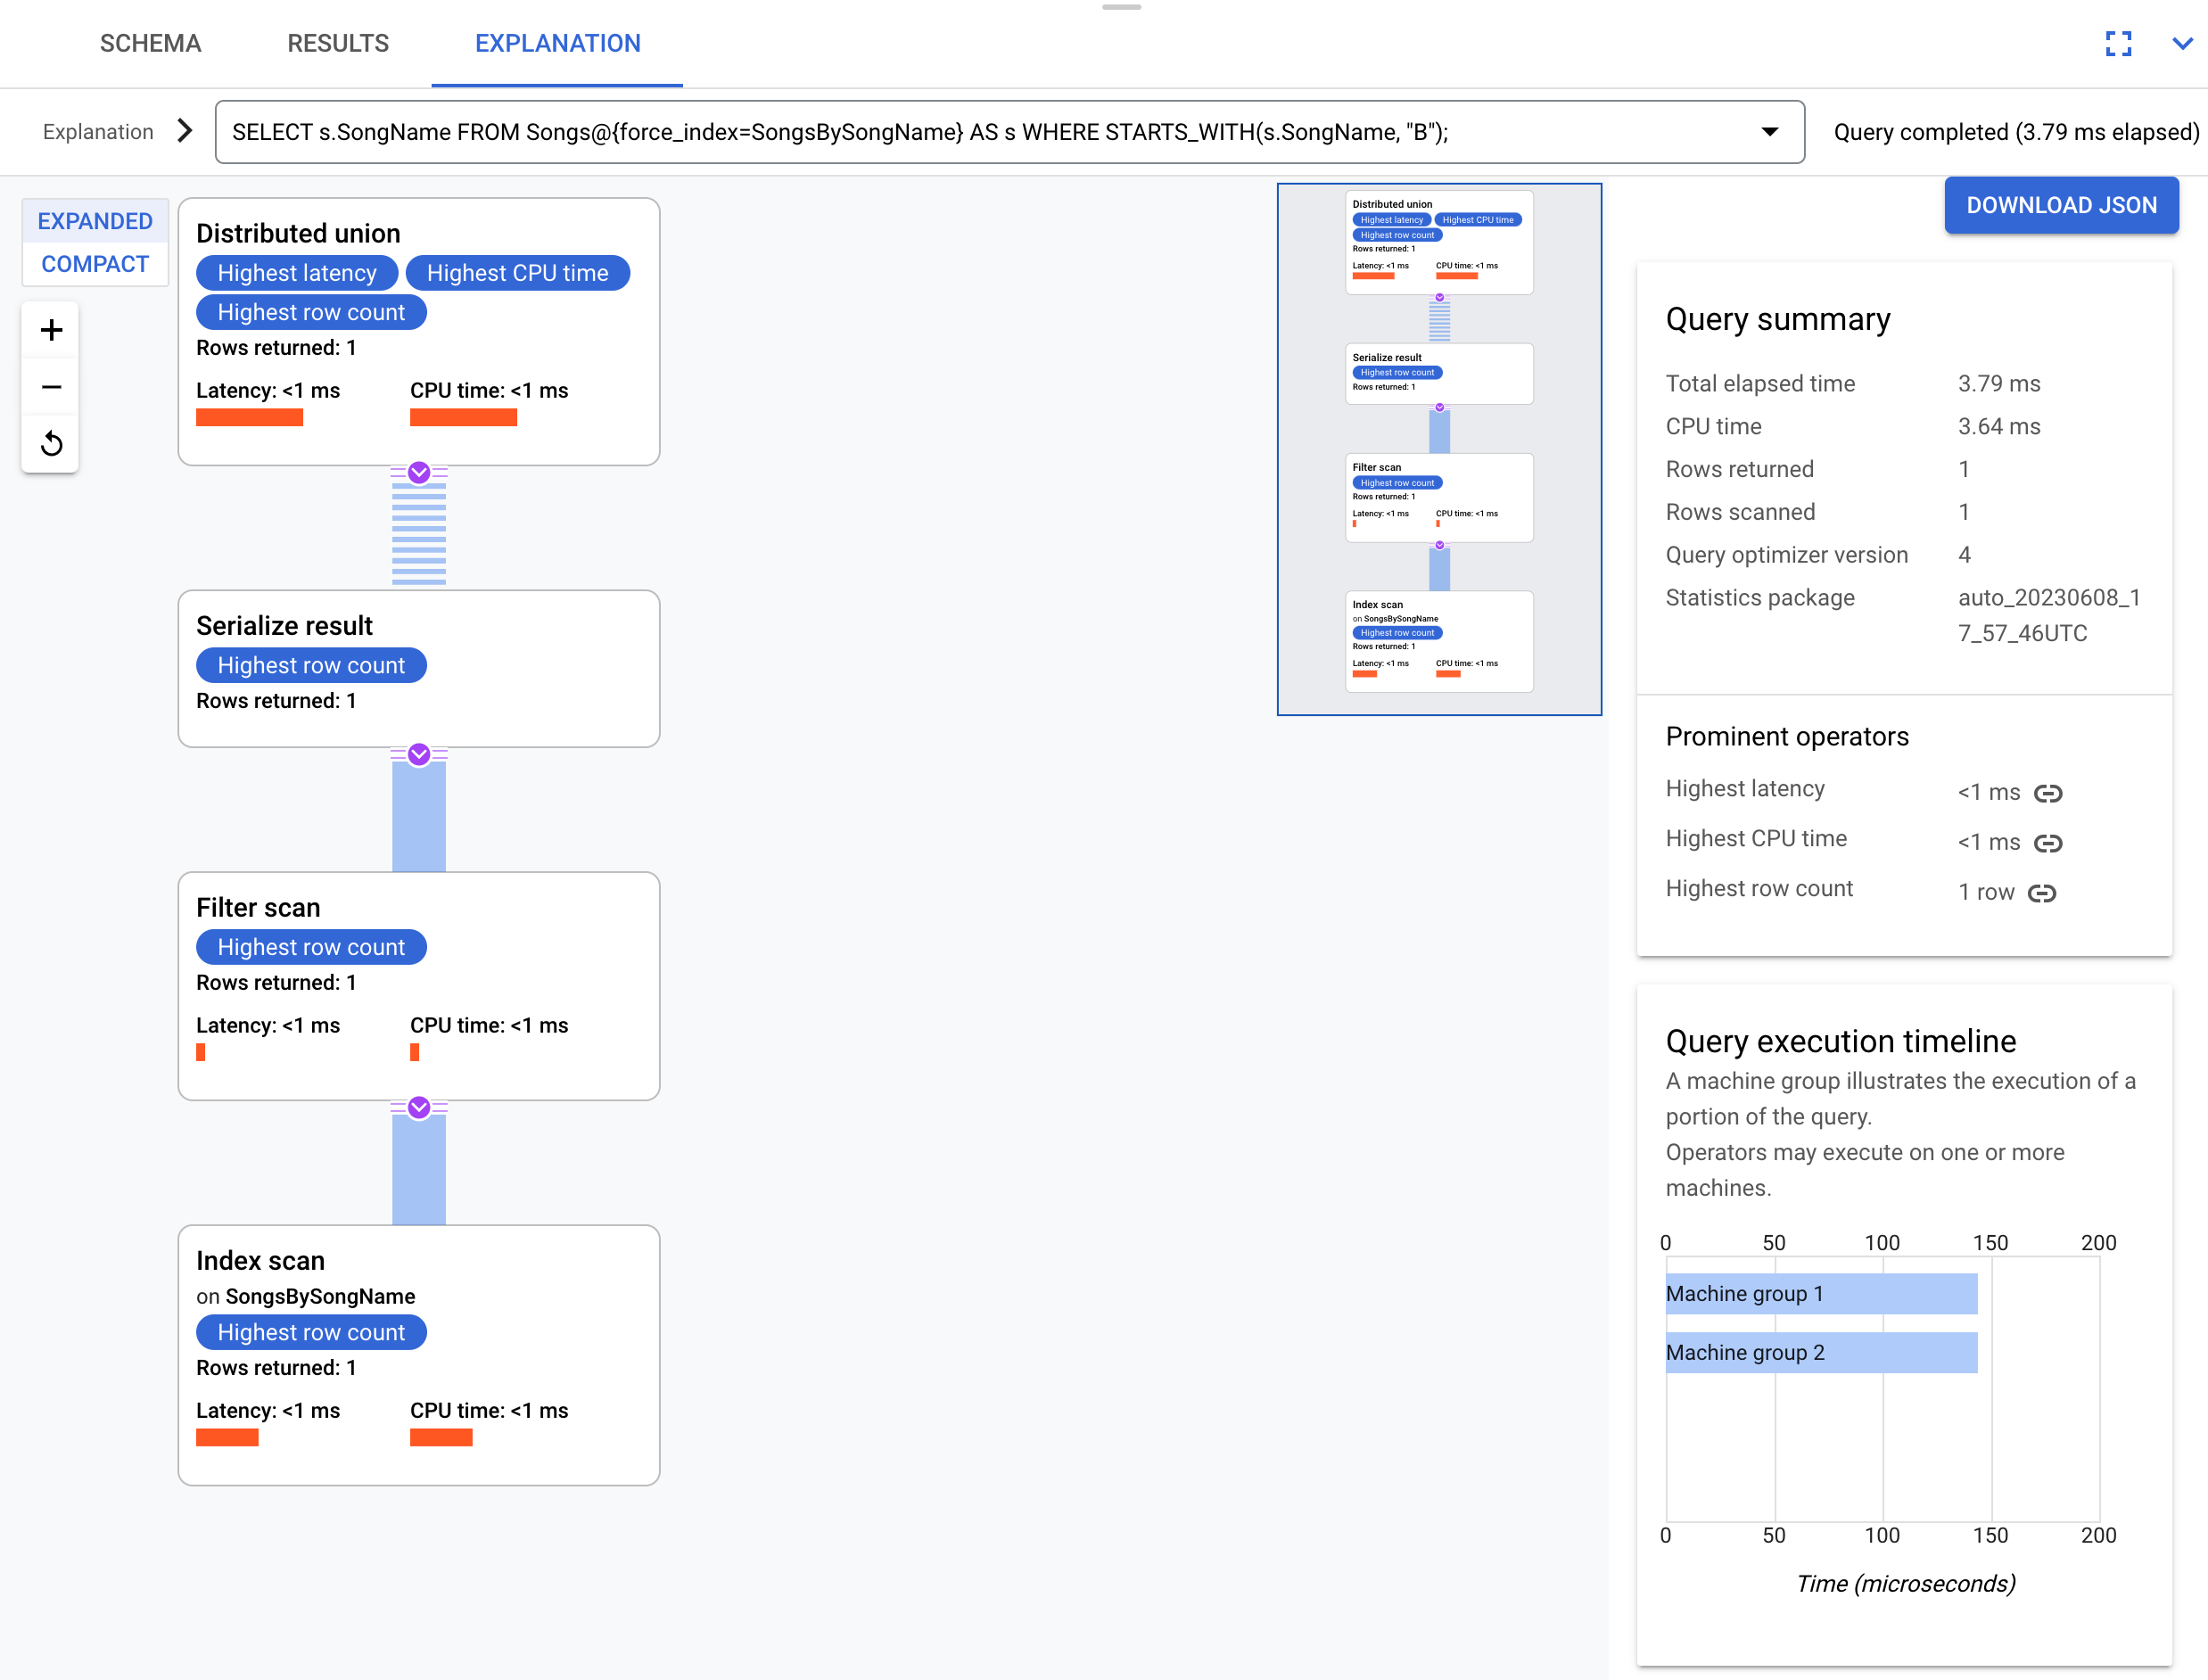
執行計畫不需要反向 join,因為索引包含查詢要求的所有資料欄。
循序掃描與分散搜尋
讀取連續範圍的資料列,速度會比讀取相同數量的分散資料列快得多。
舉例來說,下列查詢會加總指定歌手組合的歌曲長度。這項查詢會針對每個指定的歌手 ID 執行搜尋。如要查看查詢執行的搜尋次數,請參閱「Seek count」(搜尋次數) 統計資料。
SELECT SUM(Duration)
FROM Songs
WHERE SingerId IN (1, 3, 9, 10, 15);
不過,如果將查詢結構設為讀取連續的歌手 ID 序列,則可透過依序讀取 Songs 資料表來提升效能。Songs 資料表包含 SingerId,做為主鍵的一部分。
SELECT SUM(Duration)
FROM Songs
WHERE SingerId BETWEEN 1 AND 5;
選擇彙整方法和決定結構定義設計 (例如選擇主鍵) 時,這項差異會產生影響。如要進一步瞭解如何選擇彙整方法,請參閱「彙整與掃描的互動方式」。
共用分散式聯集
查詢中的每個資料表或索引都必須有對應的分散式運算子。這個運算子可以是 distributed union 或 distributed apply。如果兩個資料表或索引在同一個父項中交錯,查詢最佳化工具可能會對這兩個資料表或索引使用單一 distributed union 運算子。