


במדריך הזה נסביר איך להעביר נתונים מ-Amazon DynamoDB אל Spanner. הוא מיועד בעיקר לבעלי אפליקציות שרוצים לעבור ממערכת NoSQL ל-Spanner, מערכת מסד נתונים של SQL רלציוני לחלוטין, סובלנית לתקלות וניתנת להרחבה רבה, שתומכת בטרנזקציות. אם אתם משתמשים בטבלאות Amazon DynamoDB באופן עקבי, מבחינת הסוגים והפריסה, המיפוי ל-Spanner הוא פשוט. אם הטבלאות שלכם ב-Amazon DynamoDB מכילות סוגים וערכים שרירותיים של נתונים, יכול להיות שיהיה לכם פשוט יותר לעבור לשירותי NoSQL אחרים, כמו Datastore או Firestore.
במדריך הזה אנחנו מניחים שאתם מכירים סכימות של מסדי נתונים, סוגי נתונים, את היסודות של NoSQL ומערכות של מסדי נתונים רלציוניים. ההדרכה מתבססת על הפעלת משימות מוגדרות מראש כדי לבצע העברה לדוגמה. אחרי שתסיימו את המדריך, תוכלו לשנות את הקוד והשלבים שסופקו כדי להתאים לסביבה שלכם.
דיאגרמת הארכיטקטורה הבאה מפרטת את הרכיבים שבהם נעשה שימוש במדריך להעברת נתונים:
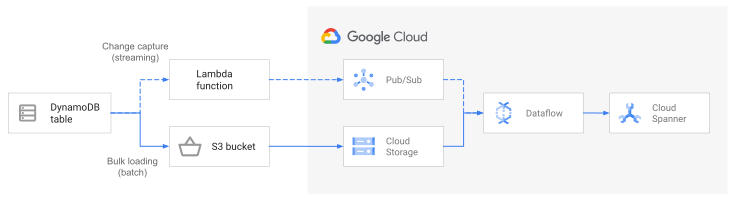
מטרות
- העברת נתונים מ-Amazon DynamoDB ל-Spanner.
- יוצרים מסד נתונים של Spanner וטבלת העברה.
- מיפוי סכימת NoSQL לסכימה יחסית.
- יוצרים ומייצאים מערך נתונים לדוגמה באמצעות Amazon DynamoDB.
- העברת נתונים בין Amazon S3 לבין Cloud Storage.
- שימוש ב-Dataflow כדי לטעון נתונים ל-Spanner.
עלויות
במדריך הזה השתמשנו ברכיבים הבאים של Google Cloud, והשימוש בהם כרוך בתשלום:
החיובים ב-Spanner מבוססים על כמות קיבולת החישוב במופע ועל כמות הנתונים שאוחסנו במהלך מחזור החיוב החודשי. במהלך המדריך, תשתמשו בהגדרה מינימלית של המשאבים האלה, שיימחקו בסוף. כדי להעריך את דרישות התפוקה והאחסון שלכם בתרחישים מהעולם האמיתי, תוכלו להיעזר במסמכי המידע על מופעי Spanner כדי לקבוע את כמות קיבולת החישוב שאתם צריכים.
בנוסף ל Google Cloud משאבים, במדריך הזה נעשה שימוש במשאבים הבאים של Amazon Web Services (AWS):
- AWS Lambda
- Amazon S3
- Amazon DynamoDB
השירותים האלה נדרשים רק במהלך תהליך ההעברה. בסיום המדריך, פועלים לפי ההוראות כדי למחוק את כל המשאבים, וכך למנוע חיובים מיותרים. כדי להעריך את העלויות האלה, אפשר להשתמש במחשבון העלויות של AWS.
כדי להעריך את העלויות בהתאם לשימוש הצפוי, אתם יכולים להשתמש במחשבון העלויות.
לפני שמתחילים
- נכנסים לחשבון Google Cloud . אנחנו ממליצים למשתמשים חדשים ב- Google Cloud ליצור חשבון כדי שיוכלו להעריך את הביצועים של המוצרים שלנו בתרחישים מהעולם האמיתי. לקוחות חדשים מקבלים בחינם גם קרדיט בשווי 300$ להרצה, לבדיקה ולפריסה של עומסי העבודה.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Spanner, Pub/Sub, Compute Engine, and Dataflow APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Spanner, Pub/Sub, Compute Engine, and Dataflow APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.
כשמסיימים את המשימות שמתוארות במסמך הזה אפשר למחוק את המשאבים שיצרתם כדי להימנע מחיובים נוספים. מידע נוסף זמין בקטע הסרת המשאבים.
הכנת הסביבה
במדריך הזה מריצים פקודות ב-Cloud Shell. ב-Cloud Shell יש גישה לשורת הפקודה ב- Google Cloud, והוא כולל את Google Cloud CLI וכלים אחרים שצריך לפיתוח ב- Google Cloud . יכול להיות שיעברו כמה דקות עד ש-Cloud Shell יופעל.
-
במסוף Google Cloud , מפעילים את Cloud Shell.
בחלק התחתון של Google Cloud המסוף יתחיל סשן של Cloud Shell ותופיע הודעה של שורת הפקודה. Cloud Shell היא סביבת מעטפת שבה ה-CLI של Google Cloud מותקן ומוגדרים ערכים לפרויקט הקיים. הסשן יופעל תוך כמה שניות.
- מגדירים את ברירת המחדל לתחום (zone) של Compute Engine. לדוגמה,
us-central1-b. gcloud config set compute/zone us-central1-b - משכפלים את מאגר GitHub שמכיל את קוד הדוגמה. git clone https://github.com/GoogleCloudPlatform/dynamodb-spanner-migration.git
- עוברים לספרייה המשוכפלת. cd dynamodb-spanner-migration
- יוצרים סביבה וירטואלית של Python. pip3 install virtualenv virtualenv env
- מפעילים את הסביבה הווירטואלית. source env/bin/activate
- מתקינים את מודולי Python הנדרשים. pip3 install -r requirements.txt
הגדרת הגישה ל-AWS
במדריך הזה תיצרו ותמחקו טבלאות ב-Amazon DynamoDB, קטגוריות ב-Amazon S3 ומשאבים אחרים. כדי לגשת למשאבים האלה, קודם צריך ליצור את ההרשאות הנדרשות ב-AWS Identity and Access Management (IAM). כדי להימנע מהשפעה על משאבי הייצור באותו חשבון, אפשר להשתמש בחשבון בדיקה או בחשבון ארגז חול של AWS.
יצירת תפקיד AWS IAM עבור AWS Lambda
בקטע הזה יוצרים תפקיד AWS IAM ש-AWS Lambda משתמש בו בשלב מאוחר יותר במדריך.
- במסוף AWS, עוברים לקטע IAM, לוחצים על Roles ואז על Create role.
- בקטע Trusted entity type, מוודאים שהאפשרות AWS service מסומנת.
- בקטע תרחיש לדוגמה, בוחרים באפשרות Lambda ולוחצים על הבא.
- בתיבת הסינון Permission policies, מזינים
AWSLambdaDynamoDBExecutionRoleומקישים עלReturnכדי לחפש. - מסמנים את התיבה AWSLambdaDynamoDBExecutionRole ולוחצים על הבא.
- בתיבה שם התפקיד מזינים
dynamodb-spanner-lambda-roleולוחצים על יצירת תפקיד.
יצירת משתמש AWS IAM
כדי ליצור משתמש AWS IAM עם גישה פרוגרמטית למשאבי AWS שבהם נעשה שימוש לאורך המדריך, פועלים לפי השלבים הבאים.
- בקטע IAM במסוף AWS, לוחצים על Users ואז על Add users.
- בתיבה שם משתמש, מזינים
dynamodb-spanner-migration. בקטע Access type, מסמנים את התיבה שמימין לאפשרות Access key - Programmatic access.
לוחצים על הבא: הרשאות.
לוחצים על Attach existing policies directly (צירוף ישיר של מדיניות קיימת), משתמשים בתיבת Search (חיפוש) כדי לסנן, ומסמנים את התיבה לצד כל אחת משלוש המדיניות הבאות:
AmazonDynamoDBFullAccessAmazonS3FullAccessAWSLambda_FullAccess
לוחצים על הבא: תגים ועל הבא: בדיקה, ואז על יצירת משתמש.
לוחצים על הצגה כדי לראות את פרטי הכניסה. המזהה של מפתח הגישה ומפתח הגישה הסודי מוצגים עבור המשתמש החדש שנוצר. בינתיים משאירים את החלון הזה פתוח כי פרטי הכניסה נחוצים בקטע הבא. חשוב לאחסן את פרטי הכניסה האלה בצורה בטוחה, כי בעזרתם אפשר לבצע שינויים בחשבון ולהשפיע על הסביבה. בסוף המדריך הזה, תוכלו למחוק את משתמש ה-IAM.
הגדרת ממשק שורת הפקודה (CLI) של AWS
ב-Cloud Shell, מגדירים את ממשק שורת הפקודה (CLI) של AWS.
aws configure
הפלט הבא מופיע:
AWS Access Key ID [None]: PASTE_YOUR_ACCESS_KEY_ID
AWS Secret Access Key [None]: PASTE_YOUR_SECRET_ACCESS_KEY
Default region name [None]: us-west-2
Default output format [None]:
- מזינים את
ACCESS KEY IDואתSECRET ACCESS KEYמחשבון AWS IAM שיצרתם. - בשדה שם אזור ברירת המחדל, מזינים
us-west-2. משאירים את ערכי ברירת המחדל בשאר השדות.
- מזינים את
סוגרים את חלון מסוף AWS IAM.
הסבר על מודל הנתונים
בקטע הבא מפורטים קווי הדמיון וההבדלים בין סוגי הנתונים, המפתחות והאינדקסים ב-Amazon DynamoDB וב-Spanner.
סוגי הנתונים
ב-Spanner נעשה שימוש בסוגי נתונים של GoogleSQL. בטבלה הבאה מוסבר איך סוגי נתונים של Amazon DynamoDB ממופים לסוגי נתונים של Spanner.
| Amazon DynamoDB | Spanner |
|---|---|
| מספר | בהתאם לדיוק או לשימוש המיועד, יכול להיות מיפוי ל-INT64, ל-FLOAT64, ל-TIMESTAMP או ל-DATE. |
| String | String |
| בוליאני | BOOL |
| Null | אין סוג מפורש. העמודות יכולות להכיל ערכי null. |
| בינארי | בייטים |
| ערכות | מערך |
| מפה ורשימה | Struct אם המבנה עקבי ואפשר לתאר אותו באמצעות תחביר DDL של טבלה. |
מפתח ראשי
מפתח ראשי של Amazon DynamoDB קובע ייחודיות, ויכול להיות מפתח גיבוב או שילוב של מפתח גיבוב ומפתח טווח. ההדרכה הזו מתחילה בהדגמה של העברה של טבלה ב-Amazon DynamoDB, שהמפתח הראשי שלה הוא מפתח גיבוב. מפתח הגיבוב הזה הופך למפתח הראשי של טבלת Spanner. בהמשך, בקטע על טבלאות משולבות, מוצג מצב שבו טבלה של Amazon DynamoDB משתמשת במפתח ראשי שמורכב ממפתח hash וממפתח טווח.
אינדקסים משניים
גם Amazon DynamoDB וגם Spanner תומכים ביצירת אינדקס במאפיין של מפתח לא ראשי. חשוב לשים לב לכל האינדקסים המשניים בטבלת Amazon DynamoDB, כדי שתוכלו ליצור אותם בטבלת Spanner. הנושא הזה מוסבר בקטע בהמשך המדריך.
טבלה לדוגמה
כדי להקל על המדריך, אתם מעבירים את הטבלה לדוגמה הבאה מ-Amazon DynamoDB ל-Spanner:
| Amazon DynamoDB | Spanner | |
|---|---|---|
| שם טבלה |
Migration
|
Migration
|
| מפתח ראשי |
"Username" : String
|
"Username" : STRING(1024)
|
| סוג מפתח | גיבוב (Hash) | לא רלוונטי |
| שדות אחרים |
Zipcode: Number
Subscribed: Boolean
ReminderDate: String
PointsEarned: Number
|
Zipcode: INT64
Subscribed: BOOL
ReminderDate: DATE
PointsEarned: INT64
|
הכנת הטבלה ב-Amazon DynamoDB
בקטע הבא, יוצרים טבלת מקור של Amazon DynamoDB ומאכלסים אותה בנתונים.
ב-Cloud Shell, יוצרים טבלת Amazon DynamoDB שמשתמשת במאפיינים של הטבלה לדוגמה.
aws dynamodb create-table --table-name Migration \
    --attribute-definitions AttributeName=Username,AttributeType=S \
    --key-schema AttributeName=Username,KeyType=HASH \
    --provisioned-throughput ReadCapacityUnits=75,WriteCapacityUnits=75
מוודאים שהסטטוס של הטבלה הוא
ACTIVE.aws dynamodb describe-table --table-name Migration \ --query 'Table.TableStatus'מאכלסים את הטבלה בנתונים לדוגמה.
python3 make-fake-data.py --table Migration --items 25000
יצירת מסד נתונים ב-Spanner
אתם יוצרים מכונה של Spanner עם קיבולת המחשוב הקטנה ביותר האפשרית: 100 יחידות עיבוד. קיבולת החישוב הזו מספיקה להיקף של ההדרכה הזו. לפריסת ייצור, כדאי לעיין במסמכי התיעוד בנושא מופעי Spanner כדי לקבוע את קיבולת המחשוב המתאימה לדרישות הביצועים של מסד הנתונים.
בדוגמה הזו, יוצרים סכימה של טבלה במקביל ליצירת מסד הנתונים. אפשר גם לבצע עדכוני סכימה אחרי שיוצרים את מסד הנתונים, וזה נפוץ.
יוצרים מכונה של Spanner באותו אזור שבו הגדרתם את ברירת המחדל לתחום (zone) של Compute Engine. לדוגמה,
us-central1.gcloud beta spanner instances create spanner-migration \ --config=regional-us-central1 --processing-units=100 \ --description="Migration Demo"יוצרים מסד נתונים במופע Spanner יחד עם טבלת הדוגמה.
gcloud spanner databases create migrationdb \
    --instance=spanner-migration \
    --ddl "CREATE TABLE Migration ( \
            Username STRING(1024) NOT NULL, \
            PointsEarned INT64, \
            ReminderDate DATE, \
            Subscribed BOOL, \
            Zipcode INT64, \
         ) PRIMARY KEY (Username)"
הכנות להעברה
בקטעים הבאים מוסבר איך לייצא את טבלת המקור של Amazon DynamoDB ולהגדיר שכפול של Pub/Sub כדי לתעד שינויים במסד הנתונים שמתרחשים בזמן הייצוא.
העברת שינויים בסטרימינג ל-Pub/Sub
אתם משתמשים בפונקציית AWS Lambda כדי להזרים שינויים במסד נתונים אל Pub/Sub.
ב-Cloud Shell, מפעילים את הסטרימינג של Amazon DynamoDB בטבלת המקור.
aws dynamodb update-table --table-name Migration \
    --stream-specification StreamEnabled=true,StreamViewType=NEW_AND_OLD_IMAGES
מגדירים נושא Pub/Sub כדי לקבל את השינויים.
gcloud pubsub topics create spanner-migration
הפלט הבא מוצג:
Created topic [projects/your-project/topics/spanner-migration].
יוצרים חשבון שירות ב-IAM כדי לשלוח עדכונים בטבלה לנושא ב-Pub/Sub.
gcloud iam service-accounts create spanner-migration \
    --display-name="Spanner Migration"
הפלט הבא מופיע:
Created service account [spanner-migration].
יוצרים קישור למדיניות IAM כדי שלחשבון השירות תהיה הרשאה לפרסם ב-Pub/Sub. מחליפים את
GOOGLE_CLOUD_PROJECTבשם הפרויקט ב- Google Cloud .gcloud projects add-iam-policy-binding GOOGLE_CLOUD_PROJECT \ --role roles/pubsub.publisher \ --member serviceAccount:spanner-migration@GOOGLE_CLOUD_PROJECT.iam.gserviceaccount.comהפלט הבא מוצג:
bindings:
(...truncated...)
- members:
  - serviceAccount:spanner-migration@solution-z.iam.gserviceaccount.com
  role: roles/pubsub.publisher
יוצרים פרטי כניסה לחשבון השירות.
gcloud iam service-accounts keys create credentials.json \
    --iam-account spanner-migration@GOOGLE_CLOUD_PROJECT.iam.gserviceaccount.com
הפלט הבא מוצג:
created key [5e559d9f6bd8293da31b472d85a233a3fd9b381c] of type [json] as [credentials.json] for [spanner-migration@your-project.iam.gserviceaccount.com]
מכינים ואורזים את הפונקציה של AWS Lambda כדי לשלוח שינויים בטבלה של Amazon DynamoDB לנושא Pub/Sub.
pip3 install --ignore-installed --target=lambda-deps google-cloud-pubsub
cd lambda-deps; zip -r9 ../pubsub-lambda.zip *; cd -
zip -g pubsub-lambda.zip ddbpubsub.py
יוצרים משתנה כדי לתעד את שם משאב Amazon (ARN) של תפקיד ההרשאה לביצוע Lambda שיצרתם קודם.
LAMBDA_ROLE=$(aws iam list-roles \
    --query 'Roles[?RoleName==`dynamodb-spanner-lambda-role`].[Arn]' \
    --output text)
משתמשים בחבילה
pubsub-lambda.zipכדי ליצור את הפונקציה AWS Lambda.aws lambda create-function --function-name dynamodb-spanner-lambda \ --runtime python3.9 --role ${LAMBDA_ROLE} \ --handler ddbpubsub.lambda_handler --zip fileb://pubsub-lambda.zip \ --environment Variables="{SVCACCT=$(base64 -w 0 credentials.json),PROJECT=GOOGLE_CLOUD_PROJECT,TOPIC=spanner-migration}"הפלט הבא מוצג:
{
    "FunctionName": "dynamodb-spanner-lambda",
    "LastModified": "2022-03-17T23:45:26.445+0000",
    "RevisionId": "e58e8408-cd3a-4155-a184-4efc0da80bfb",
    "MemorySize": 128,
... truncated output...
    "PackageType": "Zip",
    "Architectures": [
        "x86_64"
    ]
}
יוצרים משתנה לתיעוד ה-ARN של הסטרים של Amazon DynamoDB עבור הטבלה.
STREAMARN=$(aws dynamodb describe-table \
    --table-name Migration \
    --query "Table.LatestStreamArn" \
    --output text)
מצרפים את פונקציית Lambda לטבלת Amazon DynamoDB.
aws lambda create-event-source-mapping --event-source ${STREAMARN} \
    --function-name dynamodb-spanner-lambda --enabled \
    --starting-position TRIM_HORIZON
כדי לשפר את מהירות התגובה במהלך הבדיקה, מוסיפים את
--batch-size 1לסוף הפקודה הקודמת, שמפעילה את הפונקציה בכל פעם שיוצרים, מעדכנים או מוחקים פריט.הפלט אמור להיראות כך:
{
    "UUID": "44e4c2bf-493a-4ba2-9859-cde0ae5c5e92",
    "StateTransitionReason": "User action",
    "LastModified": 1530662205.549,
    "BatchSize": 100,
    "EventSourceArn": "arn:aws:dynamodb:us-west-2:accountid:table/Migration/stream/2018-07-03T15:09:57.725",
    "FunctionArn": "arn:aws:lambda:us-west-2:accountid:function:dynamodb-spanner-lambda",
    "State": "Creating",
    "LastProcessingResult": "No records processed"
... truncated output...
ייצוא הטבלה של Amazon DynamoDB אל Amazon S3
ב-Cloud Shell, יוצרים משתנה לשם של קטגוריה שבה משתמשים בכמה מהקטעים הבאים.
BUCKET=${DEVSHELL_PROJECT_ID}-dynamodb-spanner-exportיוצרים קטגוריה ב-Amazon S3 כדי לקבל את הייצוא מ-DynamoDB.
aws s3 mb s3://${BUCKET}ב-AWS Management Console, עוברים אל DynamoDB ולוחצים על Tables.
לוחצים על הטבלה
Migration.בכרטיסייה Exports and stream, לוחצים על Export to S3.
אם מופיעה בקשה, מפעילים את
point-in-time-recovery(שחזור לנקודת זמן).לוחצים על Browse S3 כדי לבחור את קטגוריית S3 שיצרתם קודם.
לוחצים על ייצוא.
לוחצים על סמל הרענון כדי לעדכן את הסטטוס של משימת הייצוא. הייצוא של המשימה נמשך כמה דקות.
בסיום התהליך, בודקים את דלי הפלט.
aws s3 ls --recursive s3://${BUCKET}השלב הזה אמור להימשך כ-5 דקות. בסיום התהליך, הפלט אמור להיראות כך:
2022-02-17 04:41:46          0 AWSDynamoDB/01645072900758-ee1232a3/_started
2022-02-17 04:46:04     500441 AWSDynamoDB/01645072900758-ee1232a3/data/xygt7i2gje4w7jtdw5652s43pa.json.gz
2022-02-17 04:46:17        199 AWSDynamoDB/01645072900758-ee1232a3/manifest-files.json
2022-02-17 04:46:17         24 AWSDynamoDB/01645072900758-ee1232a3/manifest-files.md5
2022-02-17 04:46:17        639 AWSDynamoDB/01645072900758-ee1232a3/manifest-summary.json
2022-02-17 04:46:18         24 AWSDynamoDB/01645072900758-ee1232a3/manifest-summary.md5
ביצוע ההעברה
אחרי שהגדרתם את המסירה ב-Pub/Sub, אתם יכולים להעביר את כל השינויים בטבלה שקרו אחרי הייצוא.
העתקת הטבלה המיוצאת ל-Cloud Storage
ב-Cloud Shell, יוצרים קטגוריה של Cloud Storage כדי לקבל את הקבצים שיוצאו מ-Amazon S3.
gcloud storage buckets create gs://${BUCKET}מסנכרנים את הקבצים מ-Amazon S3 ל-Cloud Storage. לרוב פעולות ההעתקה, הפקודה
rsyncיעילה. אם קובצי הייצוא גדולים (כמה GB או יותר), השתמשו ב-Cloud Storage transfer service כדי לנהל את ההעברה ברקע.gcloud storage rsync s3://${BUCKET} gs://${BUCKET} --recursive --delete-unmatched-destination-objects
ייבוא הנתונים באצווה
כדי לכתוב את הנתונים מהקבצים המיוצאים לטבלת Spanner, מריצים משימת Dataflow עם קוד לדוגמה של Apache Beam.
cd dataflow
mvn compile
mvn exec:java \
-Dexec.mainClass=com.example.spanner_migration.SpannerBulkWrite \
-Pdataflow-runner \
-Dexec.args="--project=GOOGLE_CLOUD_PROJECT \
             --instanceId=spanner-migration \
             --databaseId=migrationdb \
             --table=Migration \
             --importBucket=$BUCKET \
             --runner=DataflowRunner \
             --region=us-central1"
כדי לעקוב אחרי התקדמות משימת הייבוא, עוברים אל Dataflow ב Google Cloud מסוף.
בזמן שהעבודה פועלת, אפשר לצפות בתרשים הביצוע כדי לבדוק את היומנים. לוחצים על המשימה שמופיעה בסטטוס פועלת.
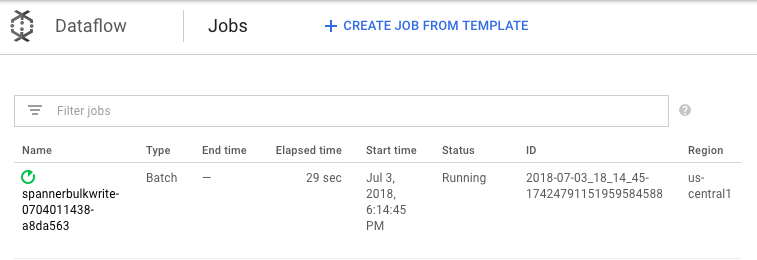
כדי לראות כמה רכיבים עברו עיבוד, לוחצים על כל שלב. הייבוא מסתיים כשבכל השלבים מופיע הכיתוב הצלחה. בכל שלב מוצג אותו מספר של רכיבים שנוצרו בטבלת Amazon DynamoDB, כשהם מסומנים כמעובדים.
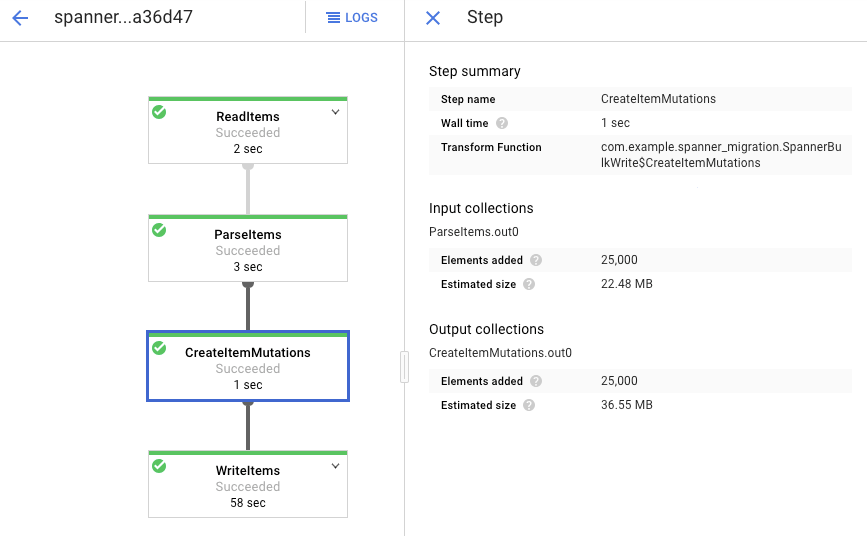
מוודאים שמספר הרשומות בטבלת היעד ב-Spanner זהה למספר הפריטים בטבלת Amazon DynamoDB.
aws dynamodb describe-table --table-name Migration --query Table.ItemCount
gcloud spanner databases execute-sql migrationdb \
--instance=spanner-migration --sql="select count(*) from Migration"
הפלט הבא מופיע:
$ aws dynamodb describe-table --table-name Migration --query Table.ItemCount
25000
$ gcloud spanner databases execute-sql migrationdb --instance=spanner-migration --sql="select count(*) from Migration"
25000
דוגמים רשומות אקראיות בכל טבלה כדי לוודא שהנתונים עקביים.
gcloud spanner databases execute-sql migrationdb \
    --instance=spanner-migration \
    --sql="select * from Migration limit 1"
הפלט הבא מופיע:
 Username: aadams4495
 PointsEarned: 5247
 ReminderDate: 2022-03-14
 Subscribed: True
 Zipcode: 58057
מריצים שאילתה בטבלת Amazon DynamoDB עם אותו
Usernameשהוחזר מהשאילתה ב-Spanner בשלב הקודם. לדוגמה,aallen2538. הערך ספציפי לנתוני הדוגמה במסד הנתונים.aws dynamodb get-item --table-name Migration \ --key '{"Username": {"S": "aadams4495"}}'הערכים של שאר השדות צריכים להיות זהים לאלה שמופיעים בפלט של Spanner. הפלט הבא מוצג:
{
    "Item": {
        "Username": {
            "S": "aadams4495"
        },
        "ReminderDate": {
            "S": "2018-06-18"
        },
        "PointsEarned": {
            "N": "1606"
        },
        "Zipcode": {
            "N": "17303"
        },
        "Subscribed": {
            "BOOL": false
        }
    }
}
שכפול השינויים החדשים
בסיום משימת הייבוא באצווה, מגדירים משימת סטרימינג כדי לכתוב עדכונים שוטפים מטבלת המקור ל-Spanner. נרשמים לאירועים מ-Pub/Sub וכותבים אותם ב-Spanner.
פונקציית Lambda שיצרתם מוגדרת לתעד שינויים בטבלת המקור של Amazon DynamoDB ולפרסם אותם ב-Pub/Sub.
יוצרים מינוי לנושא Pub/Sub שאליו AWS Lambda שולח אירועים.
gcloud pubsub subscriptions create spanner-migration \
    --topic spanner-migration
הפלט הבא מוצג:
Created subscription [projects/your-project/subscriptions/spanner-migration].
כדי להזרים את השינויים שמגיעים ל-Pub/Sub לכתיבה בטבלת Spanner, מריצים את משימת Dataflow מ-Cloud Shell.
mvn exec:java \ -Dexec.mainClass=com.example.spanner_migration.SpannerStreamingWrite \ -Pdataflow-runner \ -Dexec.args="--project=GOOGLE_CLOUD_PROJECT \ --instanceId=spanner-migration \ --databaseId=migrationdb \ --table=Migration \ --experiments=allow_non_updatable_job \ --subscription=projects/GOOGLE_CLOUD_PROJECT/subscriptions/spanner-migration \ --runner=DataflowRunner \ --region=us-central1"בדומה לשלב טעינת אצווה, כדי לראות את התקדמות העבודה, במסוף Google Cloud , עוברים אל Dataflow.
לוחצים על העבודה שהסטטוס שלה הוא פועל.
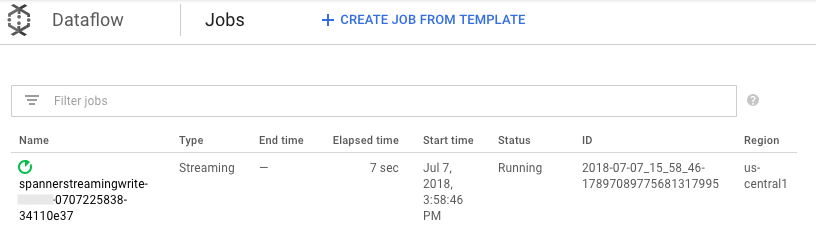
תרשים העיבוד מציג פלט דומה לזה שראינו קודם, אבל כל פריט שעבר עיבוד נספר בחלון הסטטוס. זמן ההשהיה של המערכת הוא הערכה גסה של משך העיכוב הצפוי עד שהשינויים יופיעו בטבלת Spanner.
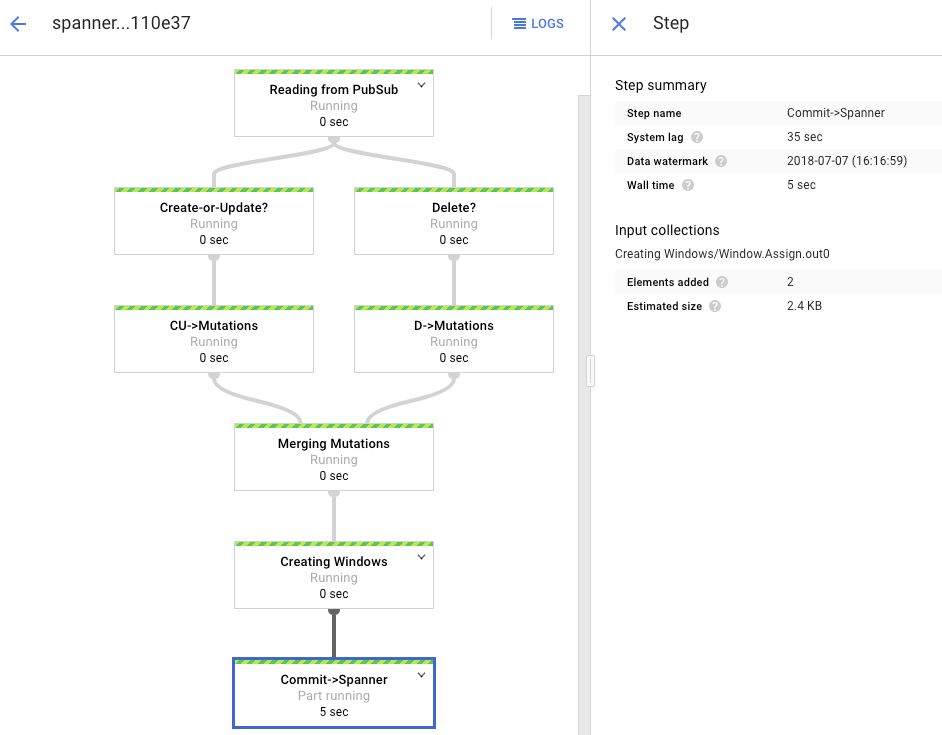
משימת Dataflow שהרצתם בשלב הטעינה באצווה הייתה קבוצה סופית של נתוני קלט, שנקראת גם קבוצת נתונים מוגבלת. משימת Dataflow הזו משתמשת ב-Pub/Sub כמקור סטרימינג, והיא נחשבת לא מוגבלת. מידע נוסף על שני סוגי המקורות האלה זמין בקטע בנושא PCollections במדריך התכנות של Apache Beam. העבודה של Dataflow בשלב הזה אמורה להישאר פעילה, ולכן היא לא מסתיימת כשהיא מסתיימת. הסטטוס של משימת Dataflow בסטרימינג נשאר Running (פועלת) במקום Succeeded (הושלמה).
אימות הרפליקציה
מבצעים כמה שינויים בטבלת המקור כדי לוודא שהשינויים משוכפלים לטבלת Spanner.
שליחת שאילתה לגבי שורה שלא קיימת ב-Spanner.
gcloud spanner databases execute-sql migrationdb \
    --instance=spanner-migration \
    --sql="SELECT * FROM Migration WHERE Username='my-test-username'"
הפעולה לא תחזיר תוצאות.
יוצרים רשומה ב-Amazon DynamoDB עם אותו מפתח שבו השתמשתם בשאילתה ב-Spanner. אם הפקודה מופעלת בהצלחה, לא מוצג פלט.
aws dynamodb put-item \
    --table-name Migration \
    --item '{"Username" : {"S" : "my-test-username"}, "Subscribed" : {"BOOL" : false}}'
מריצים שוב את אותה שאילתה כדי לוודא שהשורה נמצאת עכשיו ב-Spanner.
gcloud spanner databases execute-sql migrationdb \
    --instance=spanner-migration \
    --sql="SELECT * FROM Migration WHERE Username='my-test-username'"
הפלט מציג את השורה שנוספה:
Username: my-test-username
PointsEarned: None
ReminderDate: None
Subscribed: False
Zipcode:
משנים חלק מהמאפיינים בפריט המקורי ומעדכנים את הטבלה ב-Amazon DynamoDB.
aws dynamodb update-item \
    --table-name Migration \
    --key '{"Username": {"S":"my-test-username"}}' \
    --update-expression "SET PointsEarned = :pts, Subscribed = :sub" \
    --expression-attribute-values '{":pts": {"N":"4500"}, ":sub": {"BOOL":true}}'\
    --return-values ALL_NEW
הפלט אמור להיראות כך:
{
    "Attributes": {
        "Username": {
            "S": "my-test-username"
        },
        "PointsEarned": {
            "N": "4500"
        },
        "Subscribed": {
            "BOOL": true
        }
    }
}
מוודאים שהשינויים מועברים לטבלת Spanner.
gcloud spanner databases execute-sql migrationdb \
    --instance=spanner-migration \
    --sql="SELECT * FROM Migration WHERE Username='my-test-username'"
הפלט אמור להיראות כך:
Username          PointsEarned  ReminderDate  Subscribed  Zipcode
my-test-username  4500          None          True
מוחקים את פריט הבדיקה מטבלת המקור ב-Amazon DynamoDB.
aws dynamodb delete-item \
    --table-name Migration \
    --key '{"Username": {"S":"my-test-username"}}'
מוודאים שהשורה המתאימה נמחקה מטבלת Spanner. כשמפיצים את השינוי, הפקודה הבאה מחזירה אפס שורות:
gcloud spanner databases execute-sql migrationdb \
    --instance=spanner-migration \
    --sql="SELECT * FROM Migration WHERE Username='my-test-username'"
שימוש בטבלאות משולבות
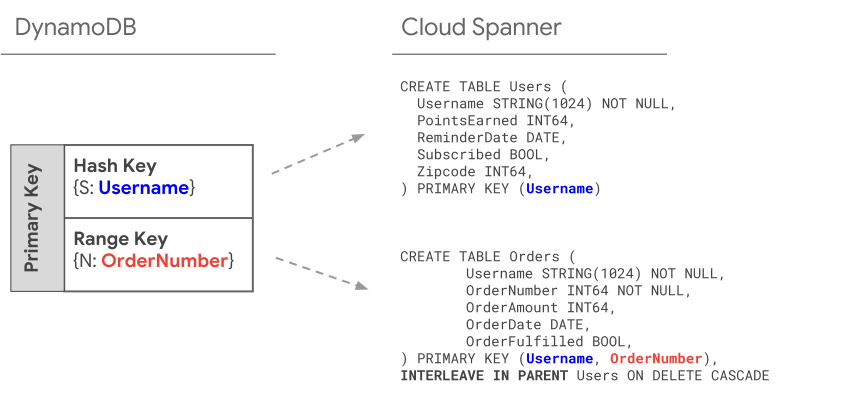
Spanner תומך במושג של שילוב טבלאות. זהו מודל עיצוב שבו לפריט ברמה העליונה יש כמה פריטים מוטמעים שקשורים לפריט ברמה העליונה, כמו לקוח וההזמנות שלו, או שחקן והניקוד שלו במשחק. אם טבלת המקור שלכם ב-Amazon DynamoDB משתמשת במפתח ראשי שמורכב ממפתח hash וממפתח טווח, אתם יכולים ליצור מודל של סכימת טבלה משולבת כמו שמוצג בתרשים הבא. המבנה הזה מאפשר לכם לבצע שאילתות ביעילות בטבלה המשלבת תוך צירוף שדות בטבלת ההורה.
החלת אינדקסים משניים
השיטה המומלצת היא להחיל אינדקסים משניים על טבלאות Spanner אחרי שאתם טוענים את הנתונים. עכשיו, אחרי שהשכפול פועל, מגדירים אינדקס משני כדי להאיץ את השאילתות. כמו טבלאות Spanner, גם אינדקסים משניים של Spanner הם עקביים לחלוטין. הם לא עקביים בסופו של דבר, כמו בהרבה מסדי נתונים של NoSQL. התכונה הזו יכולה לעזור לכם לפשט את עיצוב האפליקציה
מריצים שאילתה שלא משתמשת באינדקסים. אתם מחפשים את N המופעים המובילים, בהינתן ערך מסוים של עמודה. זו שאילתה נפוצה ב-Amazon DynamoDB לבדיקת יעילות מסד הנתונים.
עוברים אל Spanner.
לוחצים על Spanner Studio.
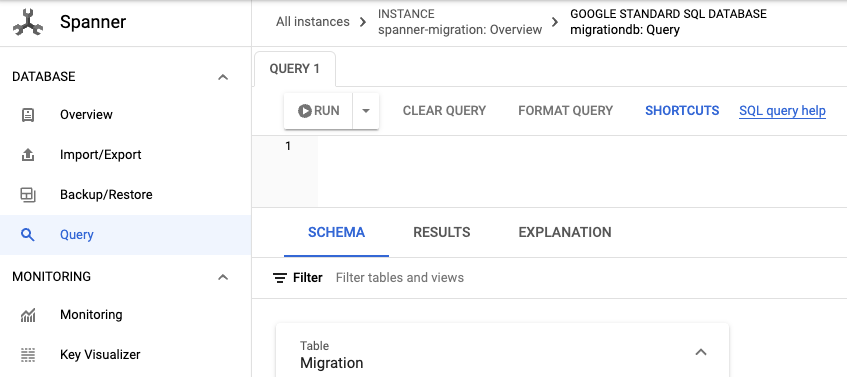
בשדה Query, מזינים את השאילתה הבאה ולוחצים על Run query.
SELECT Username,PointsEarned
  FROM Migration
 WHERE Subscribed=true
   AND ReminderDate > DATE_SUB(DATE(current_timestamp()), INTERVAL 14 DAY)
 ORDER BY ReminderDate DESC
 LIMIT 10
אחרי הרצת השאילתה, לוחצים על הסבר ורושמים את הערכים של שורות שנסרקו לעומת שורות שהוחזרו. בלי אינדקס, Spanner סורק את כל הטבלה כדי להחזיר קבוצת משנה קטנה של נתונים שתואמים לשאילתה.
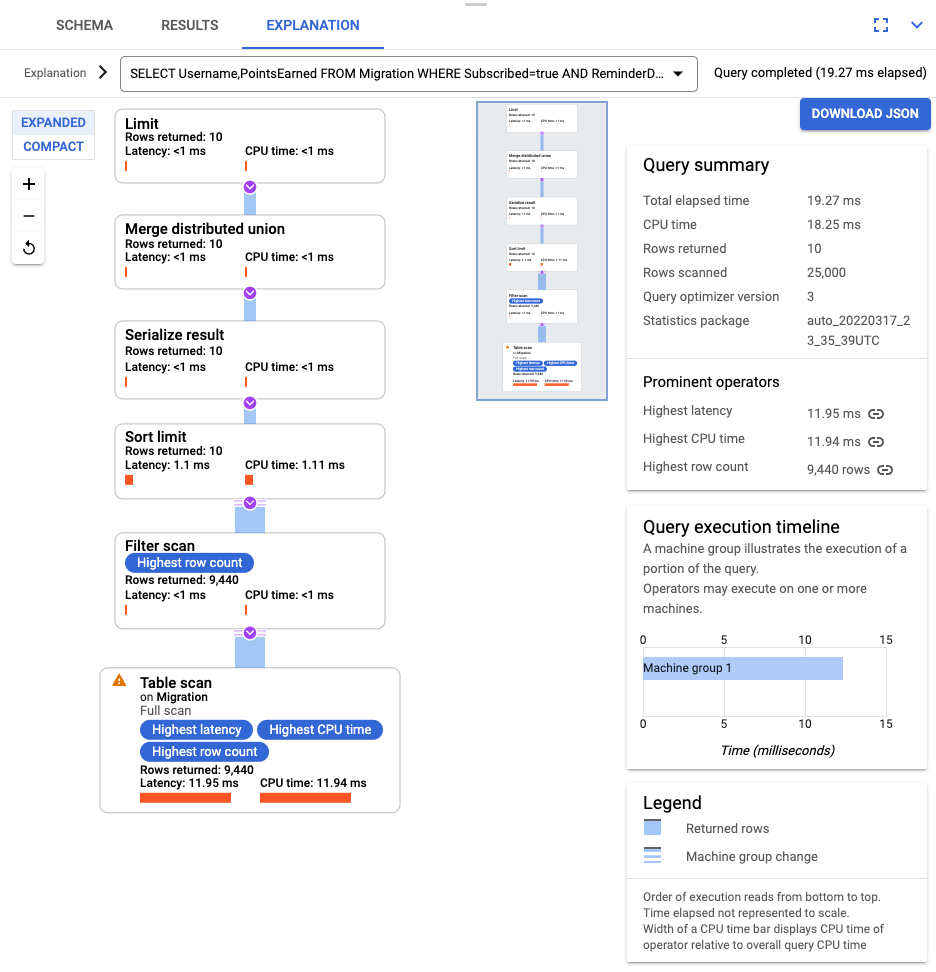
אם השאילתה הזו מייצגת שאילתה שמופיעה לעיתים קרובות, כדאי ליצור אינדקס מורכב בעמודות Subscribed ו-ReminderDate. במסוף Spanner, בוחרים באפשרות Indexes בחלונית הניווט הימנית ולוחצים על Create Index.
בתיבת הטקסט, מזינים את הגדרת האינדקס.
CREATE INDEX SubscribedDateDesc
ON Migration (
  Subscribed,
  ReminderDate DESC
)
כדי להתחיל ליצור את מסד הנתונים ברקע, לוחצים על Create.
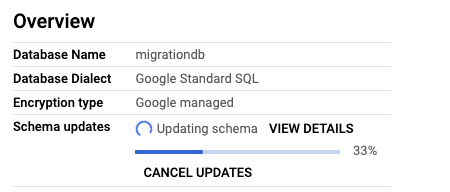
אחרי שיוצרים את האינדקס, מריצים שוב את השאילתה ומוסיפים את האינדקס.
SELECT Username,PointsEarned
  FROM Migration@{FORCE_INDEX=SubscribedDateDesc}
 WHERE Subscribed=true
   AND ReminderDate > DATE_SUB(DATE(current_timestamp()), INTERVAL 14 DAY)
 ORDER BY ReminderDate DESC
 LIMIT 10
כדאי לבדוק שוב את ההסבר לשאילתה. שימו לב שמספר השורות שנסרקו קטן יותר. הערך של Rows returned בכל שלב תואם למספר שהוחזר על ידי השאילתה.
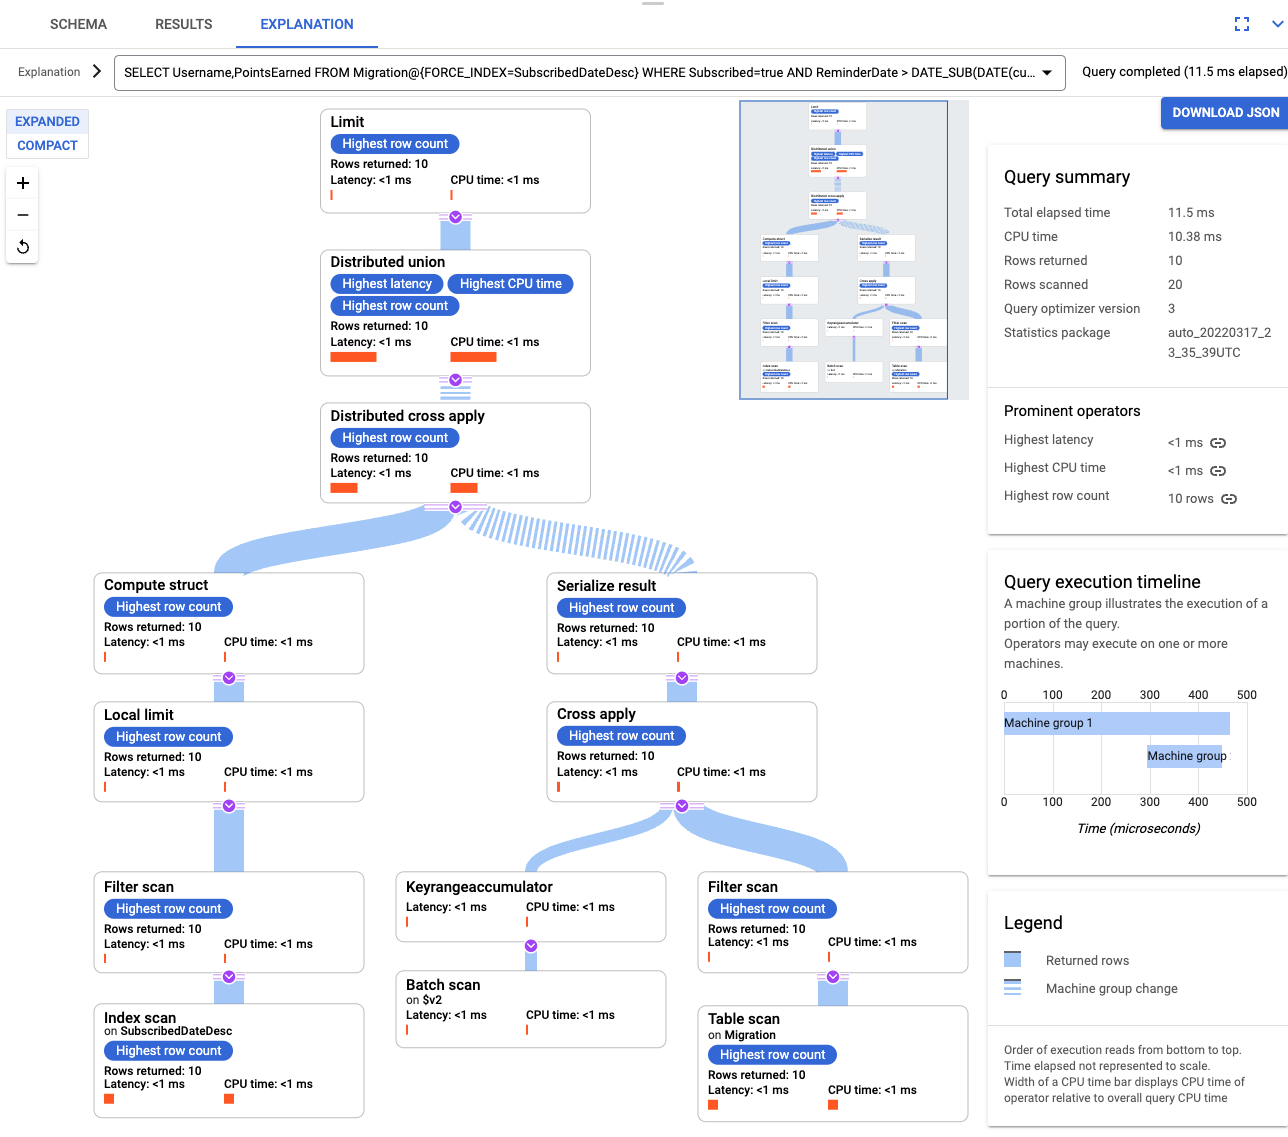
אינדקסים משולבים
אפשר להגדיר אינדקסים משולבים ב-Spanner. האינדקסים המשניים שמתוארים בסעיף הקודם נמצאים בשורש של היררכיית מסד הנתונים, והם משתמשים באינדקסים באותו אופן כמו מסד נתונים רגיל. אינדקס משולב נמצא בהקשר של השורה המשולבת שלו. מידע נוסף על המקומות שבהם כדאי להשתמש באינדקסים משולבים זמין במאמר בנושא אפשרויות אינדקס.
התאמה למודל הנתונים שלכם
כדי להתאים את חלק ההעברה במדריך הזה למצב שלכם, צריך לשנות את קובצי המקור של Apache Beam. חשוב לא לשנות את סכימת המקור במהלך חלון ההעברה בפועל, אחרת עלולים לאבד נתונים.
כדי לנתח JSON נכנס וליצור מוטציות, משתמשים ב-GSON. משנים את הגדרת ה-JSON כך שתתאים לנתונים.
משנים את מיפוי ה-JSON המתאים.
בשלבים הקודמים שיניתם את קוד המקור של Apache Beam לייבוא בכמות גדולה. משנים את קוד המקור של החלק בצינור עיבוד הנתונים שקשור לסטרימינג באופן דומה. לבסוף, משנים את הסקריפטים ליצירת טבלאות, את הסכימות ואת האינדקסים של מסד הנתונים של Spanner.
הסרת המשאבים
כדי להימנע מחיובים בחשבון Google Cloud בגלל השימוש במשאבים שנעשה במסגרת המדריך הזה, אפשר למחוק את הפרויקט שמכיל את המשאבים, או להשאיר את הפרויקט ולמחוק את המשאבים הנפרדים.
מחיקת הפרויקט
- במסוף Google Cloud , נכנסים לדף Manage resources.
- ברשימת הפרויקטים, בוחרים את הפרויקט שרוצים למחוק ולוחצים על Delete.
- כדי למחוק את הפרויקט, כותבים את מזהה הפרויקט בתיבת הדו-שיח ולוחצים על Shut down.
מחיקת משאבים ב-AWS
אם משתמשים בחשבון AWS שלכם מחוץ למדריך הזה, חשוב לנקוט משנה זהירות כשמוחקים את המשאבים הבאים:
- מוחקים את הטבלה של DynamoDB שנקראת Migration.
- מוחקים את דלי Amazon S3 ואת פונקציית Lambda שיצרתם במהלך שלבי ההעברה.
- לבסוף, מוחקים את המשתמש ב-AWS IAM שיצרתם במהלך המדריך הזה.
המאמרים הבאים
- איך מבצעים אופטימיזציה של סכימת Spanner
- איך משתמשים ב-Dataflow במצבים מורכבים יותר.