이 문서에서는 Managed Service for Apache Spark SQL 및 PySpark 일괄 워크로드를 실행하여 Lakehouse 런타임 카탈로그에 메타데이터가 저장된 Apache Iceberg 테이블을 만드는 방법을 보여줍니다. Spark 코드를 실행하는 다른 방법에 관한 자세한 내용은 BigQuery 노트북에서 PySpark 코드 실행 및 Apache Spark 워크로드 실행을 참고하세요.
시작하기 전에
아직 만들지 않았다면 Google Cloud 프로젝트와 Cloud Storage 버킷을 만듭니다.
프로젝트 설정하기
- Google Cloud 계정에 로그인합니다. Google Cloud를 처음 사용하는 경우 계정을 만들고 Google 제품의 실제 성능을 평가해 보세요. 신규 고객에게는 워크로드를 실행, 테스트, 배포하는 데 사용할 수 있는 $300의 무료 크레딧이 제공됩니다.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
Enable the Dataproc, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
Enable the Dataproc, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.
프로젝트에 Cloud Storage 버킷을 만듭니다.
- Google Cloud 콘솔에서 Cloud Storage 버킷 페이지로 이동합니다.
- 만들기를 클릭합니다.
- 버킷 만들기 페이지에서 버킷 정보를 입력합니다. 다음 단계로 이동하려면 계속을 클릭합니다.
-
시작하기 섹션에서 다음을 수행합니다.
- 버킷 이름 요구사항을 충족하는 전역적으로 고유한 이름을 입력합니다.
- 버킷 라벨을 추가하려면 라벨 섹션 ()을 펼치고 add_box
라벨 추가를 클릭한 다음 라벨에
key및value를 지정합니다.
-
데이터 저장 위치 선택 섹션에서 다음을 수행합니다.
- 위치 유형을 선택합니다.
- 위치 유형 드롭다운 메뉴에서 버킷의 데이터가 영구적으로 저장될 위치를 선택합니다.
- 버킷 간 복제를 설정하려면 Storage Transfer Service를 통해 버킷 간 복제 추가를 선택하고 다음 단계를 따르세요.
버킷 간 복제 설정
- 버킷 메뉴에서 버킷을 선택합니다.
복제 설정 섹션에서 구성을 클릭하여 복제 작업의 설정을 구성합니다.
버킷 간 복제 구성 창이 표시됩니다.
- 객체 이름 프리픽스를 기준으로 복제할 객체를 필터링하려면 객체를 포함하거나 제외할 프리픽스를 입력한 다음 프리픽스 추가를 클릭합니다.
- 복제된 객체의 스토리지 클래스를 설정하려면 스토리지 클래스 메뉴에서 스토리지 클래스를 선택합니다. 이 단계를 건너뛰면 복제된 객체가 기본적으로 대상 버킷의 스토리지 클래스를 사용합니다.
- 완료를 클릭합니다.
-
데이터 저장 방법 선택 섹션에서 다음을 수행합니다.
- 버킷의 기본 스토리지 클래스를 선택하거나 버킷 데이터의 자동 스토리지 클래스 관리에서 자동 클래스를 선택합니다.
- 계층적 네임스페이스를 사용 설정하려면 데이터 집약적인 워크로드에 맞게 스토리지 최적화 섹션에서 이 버킷에서 계층적 네임스페이스 사용 설정을 선택합니다.
- 객체 액세스를 제어하는 방식 선택 섹션에서 버킷이 공개 액세스 방지를 적용할지 여부를 선택하고 버킷의 객체에 대한 액세스 제어 방법을 선택합니다.
-
객체 데이터 보호 방법 선택 섹션에서 다음을 수행합니다.
- 버킷에 설정할 데이터 보호 아래의 옵션을 선택합니다.
- 객체 데이터가 암호화되는 방식을 선택하려면 데이터 암호화 섹션 ()을 펼치고 데이터 암호화 방법을 선택합니다.
-
시작하기 섹션에서 다음을 수행합니다.
- 만들기를 클릭합니다.
Compute Engine 기본 서비스 계정(
PROJECT_NUMBER-compute@developer.gserviceaccount.com)에 BigQuery 데이터 편집자(roles/bigquery.dataEditor) 역할을 부여합니다. 자세한 내용은 단일 역할 부여를 참고하세요.Google Cloud CLI 예:
gcloud projects add-iam-policy-binding PROJECT_ID \
    --member PROJECT_NUMBER-compute@developer.gserviceaccount.com \
--role roles/bigquery.dataEditor
참고:
- PROJECT_ID 및 PROJECT_NUMBER는 Google Cloud 콘솔 대시보드의 프로젝트 정보 섹션에 나열됩니다.
OSS 리소스와 BigQuery 리소스 매핑
오픈소스 리소스와 BigQuery 리소스 용어 간의 다음 매핑을 참고하세요.
| OSS 리소스 | BigQuery 리소스 |
|---|---|
| 네임스페이스, 데이터베이스 | 데이터 세트 |
| 파티션을 나누거나 나누지 않은 테이블 | 테이블 |
| 뷰 | 뷰 |
Iceberg 테이블 만들기
이 섹션에서는 Managed Service for Apache Spark Spark SQL 및 PySpark 일괄 워크로드를 사용하여 Lakehouse 런타임 카탈로그에 메타데이터가 포함된 Iceberg 테이블을 만드는 방법을 보여줍니다.
Spark SQL
Spark SQL 워크로드를 실행하여 Iceberg 테이블 만들기
다음 단계에서는 Lakehouse 런타임 카탈로그에 저장된 테이블 메타데이터가 포함된 Iceberg 테이블을 만들기 위해 Managed Service for Apache Spark SQL 일괄 워크로드를 실행하는 방법을 보여줍니다.
다음 Spark SQL 명령어를 로컬 또는 Cloud Shell에서
iceberg-table.sql파일에 복사합니다.USE CATALOG_NAME; CREATE NAMESPACE IF NOT EXISTS example_namespace; USE example_namespace; DROP TABLE IF EXISTS example_table; CREATE TABLE example_table (id int, data string) USING ICEBERG LOCATION 'gs://BUCKET/WAREHOUSE_FOLDER'; INSERT INTO example_table VALUES (1, 'first row'); ALTER TABLE example_table ADD COLUMNS (newDoubleCol double); DESCRIBE TABLE example_table;
다음을 바꿉니다.
- CATALOG_NAME: Iceberg 카탈로그 이름
- BUCKET 및 WAREHOUSE_FOLDER: Iceberg 웨어하우스 디렉터리로 사용되는 Cloud Storage 버킷 및 폴더입니다.
iceberg-table.sql이 포함된 디렉터리에서 로컬 또는 Cloud Shell에서 다음 명령어를 실행하여 Spark SQL 워크로드를 제출합니다.gcloud dataproc batches submit spark-sql iceberg-table.sql \ --project=PROJECT_ID \ --region=REGION \ --deps-bucket=BUCKET_NAME \ --version=2.2 \ --subnet=SUBNET_NAME \ --properties="spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,spark.sql.catalog.CATALOG_NAME.catalog-impl=org.apache.iceberg.gcp.bigquery.BigQueryMetastoreCatalog,spark.sql.catalog.CATALOG_NAME.gcp_project=PROJECT_ID,spark.sql.catalog.CATALOG_NAME.gcp_location=LOCATION,spark.sql.catalog.CATALOG_NAME.warehouse=gs://BUCKET/WAREHOUSE_FOLDER"
참고:
- PROJECT_ID: Google Cloud 프로젝트 ID입니다. 프로젝트 ID는 Google Cloud 콘솔 대시보드의 프로젝트 정보 섹션에 나열됩니다.
- REGION: 워크로드를 실행하는 데 사용할 수 있는 Compute Engine 리전입니다.
- BUCKET_NAME: Cloud Storage 버킷의 이름입니다. Spark는 일괄 워크로드를 실행하기 전에 이 버킷의
/dependencies폴더에 워크로드 종속 항목을 업로드합니다. WAREHOUSE_FOLDER는 이 버킷에 있습니다. --version: Managed Service for Apache Spark 런타임 버전 2.2 이상- SUBNET_NAME:
REGION의 VPC 서브넷 이름입니다. 이 플래그를 생략하면 Managed Service for Apache Spark가 세션 리전에서default서브넷을 선택합니다. Managed Service for Apache Spark는 서브넷에서 비공개 Google 액세스 (PGA)를 사용 설정합니다. 네트워크 연결 요구사항은 Managed Service for Apache Spark 네트워크 구성을 참고하세요. - LOCATION: 지원되는 BigQuery 위치입니다. 기본 위치는 'US'입니다.
--properties카탈로그 속성
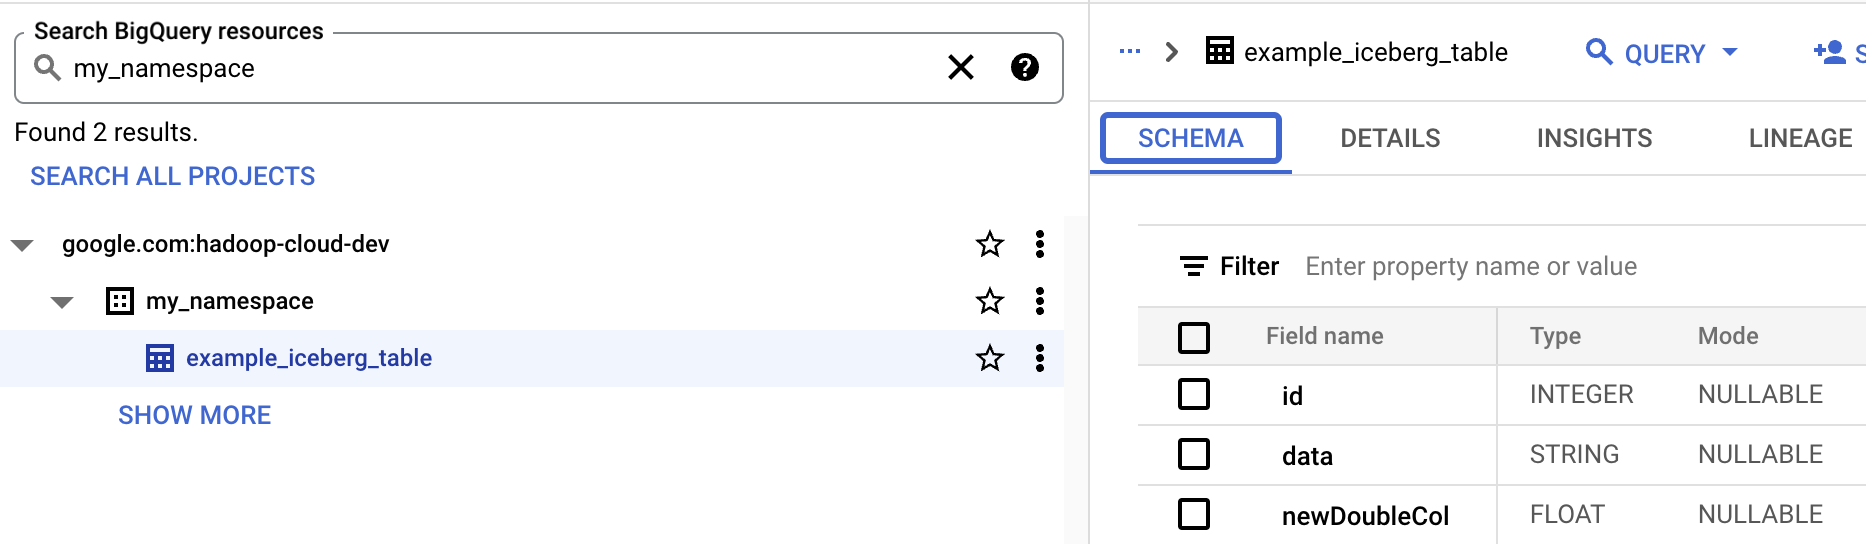
BigQuery에서 테이블 메타데이터를 확인합니다.
Google Cloud 콘솔에서 BigQuery 페이지로 이동합니다.
Iceberg 테이블 메타데이터를 확인합니다.
PySpark
다음 단계에서는 Managed Service for Apache Spark PySpark 일괄 워크로드를 실행하여 Lakehouse 런타임 카탈로그에 저장된 테이블 메타데이터가 포함된 Iceberg 테이블을 만드는 방법을 보여줍니다.
- 다음 PySpark 코드를 로컬 또는 Cloud Shell에서
iceberg-table.py파일에 복사합니다.from pyspark.sql import SparkSession spark = SparkSession.builder.appName("iceberg-table-example").getOrCreate() catalog = "CATALOG_NAME" namespace = "NAMESPACE" spark.sql(f"USE `{catalog}`;") spark.sql(f"CREATE NAMESPACE IF NOT EXISTS `{namespace}`;") spark.sql(f"USE `{namespace}`;") # Create table and display schema spark.sql("DROP TABLE IF EXISTS example_iceberg_table") spark.sql("CREATE TABLE example_iceberg_table (id int, data string) USING ICEBERG") spark.sql("DESCRIBE example_iceberg_table;") # Insert table data. spark.sql("INSERT INTO example_iceberg_table VALUES (1, 'first row');") # Alter table, then display schema. spark.sql("ALTER TABLE example_iceberg_table ADD COLUMNS (newDoubleCol double);") spark.sql("DESCRIBE example_iceberg_table;")
다음을 바꿉니다.
- CATALOG_NAME 및 NAMESPACE: Iceberg 카탈로그 이름과 네임스페이스가 결합되어 Iceberg 테이블 (
catalog.namespace.table_name)을 식별합니다.
- CATALOG_NAME 및 NAMESPACE: Iceberg 카탈로그 이름과 네임스페이스가 결합되어 Iceberg 테이블 (
-
iceberg-table.py가 포함된 디렉터리에서 로컬 또는 Cloud Shell에서 다음 명령어를 실행하여 PySpark 워크로드를 제출합니다.gcloud dataproc batches submit pyspark iceberg-table.py \ --project=PROJECT_ID \ --region=REGION \ --deps-bucket=BUCKET_NAME \ --version=2.2 \ --subnet=SUBNET_NAME \ --properties="spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,spark.sql.catalog.CATALOG_NAME.catalog-impl=org.apache.iceberg.gcp.bigquery.BigQueryMetastoreCatalog,spark.sql.catalog.CATALOG_NAME.gcp_project=PROJECT_ID,spark.sql.catalog.CATALOG_NAME.gcp_location=LOCATION,spark.sql.catalog.CATALOG_NAME.warehouse=gs://BUCKET/WAREHOUSE_FOLDER"참고:
- PROJECT_ID: Google Cloud 프로젝트 ID입니다. 프로젝트 ID는 Google Cloud 콘솔 대시보드의 프로젝트 정보 섹션에 나열됩니다.
- REGION: 워크로드를 실행하는 데 사용할 수 있는 Compute Engine 리전입니다.
- BUCKET_NAME: Cloud Storage 버킷의 이름입니다. Spark는 일괄 워크로드를 실행하기 전에 이 버킷의
/dependencies폴더에 워크로드 종속 항목을 업로드합니다. --version: Managed Service for Apache Spark 런타임 버전 2.2 이상- SUBNET_NAME:
REGION의 VPC 서브넷 이름입니다. 이 플래그를 생략하면 Managed Service for Apache Spark가 세션 리전에서default서브넷을 선택합니다. Managed Service for Apache Spark는 서브넷에서 비공개 Google 액세스 (PGA)를 사용 설정합니다. 네트워크 연결 요구사항은 Managed Service for Apache Spark 네트워크 구성을 참고하세요. - LOCATION: 지원되는 BigQuery 위치입니다. 기본 위치는 'US'입니다.
- BUCKET 및 WAREHOUSE_FOLDER: Iceberg 웨어하우스 디렉터리로 사용되는 Cloud Storage 버킷 및 폴더입니다.
--properties: 카탈로그 속성입니다.
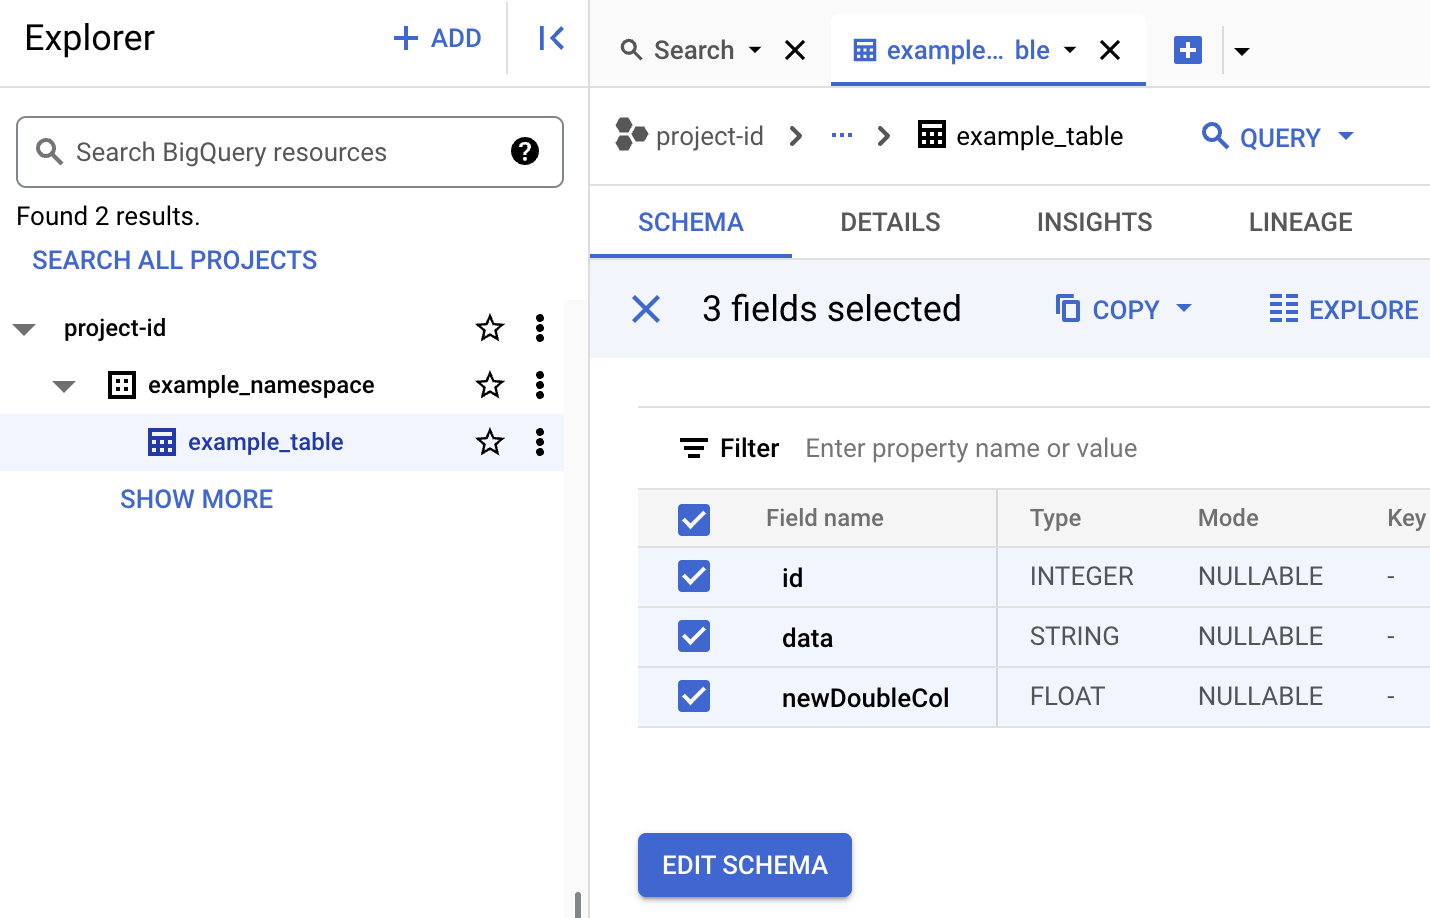
- BigQuery에서 테이블 스키마를 봅니다.
- Google Cloud 콘솔에서 BigQuery 페이지로 이동합니다. BigQuery Studio로 이동합니다.
- Iceberg 테이블 메타데이터를 확인합니다.