Dokumen ini menunjukkan cara menjalankan workload batch Managed Service untuk Apache Spark SQL dan PySpark guna membuat tabel Apache Iceberg dengan metadata yang disimpan di katalog runtime Lakehouse. Untuk mengetahui informasi tentang cara lain menjalankan kode Spark, lihat Menjalankan kode PySpark di notebook BigQuery dan Menjalankan workload Apache Spark
Sebelum memulai
Jika Anda belum melakukannya, buat project Google Cloud dan bucket Cloud Storage.
Menyiapkan project
- Login ke akun Google Cloud Anda. Jika Anda baru menggunakan Google Cloud, buat akun untuk mengevaluasi performa produk kami dalam skenario dunia nyata. Pelanggan baru juga mendapatkan kredit gratis senilai $300 untuk menjalankan, menguji, dan men-deploy workload.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
Enable the Dataproc, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
Enable the Dataproc, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.
Buat bucket Cloud Storage di project Anda.
- Di konsol Google Cloud , buka halaman Buckets Cloud Storage.
- Klik Create.
- Di halaman Buat bucket, masukkan informasi bucket Anda. Untuk melanjutkan ke
langkah berikutnya, klik Lanjutkan.
-
Di bagian Get started, lakukan tindakan berikut:
- Masukkan nama yang unik secara global yang memenuhi persyaratan penamaan bucket.
- Untuk menambahkan label bucket, luaskan bagian Labels (), klik add_box Add label, lalu tentukan
keydanvalueuntuk label Anda.
-
Di bagian Choose where to store your data, lakukan tindakan berikut:
- Pilih Location type.
- Pilih lokasi tempat data bucket Anda disimpan secara permanen dari menu drop-down Location type.
- Jika memilih jenis lokasi dual-region, Anda juga dapat memilih untuk mengaktifkan replikasi turbo menggunakan kotak centang yang relevan.
- Untuk menyiapkan replikasi lintas bucket, pilih Add cross-bucket replication via Storage Transfer Service dan ikuti langkah-langkah berikut:
Menyiapkan replikasi lintas bucket
- Di menu Bucket, pilih bucket.
Di bagian Replication settings, klik Configure guna mengonfigurasi setelan untuk tugas replikasi.
Panel Configure cross-bucket replication akan muncul.
- Untuk memfilter objek yang akan direplikasi berdasarkan awalan nama objek, masukkan awalan yang ingin Anda sertakan atau kecualikan objek, lalu klik Tambahkan awalan.
- Untuk menetapkan kelas penyimpanan bagi objek yang direplikasi, pilih kelas penyimpanan dari menu Storage class. Jika Anda melewati langkah ini, objek yang direplikasi akan menggunakan kelas penyimpanan bucket tujuan secara default.
- Klik Done.
-
Di bagian Choose how to store your data, lakukan tindakan berikut:
- Pilih kelas penyimpanan default untuk bucket atau Autoclass untuk pengelolaan kelas penyimpanan otomatis untuk data bucket Anda.
- Untuk mengaktifkan namespace hierarkis, di bagian Optimalkan penyimpanan untuk workload yang memerlukan banyak data, pilih Aktifkan namespace hierarkis di bucket ini.
- Di bagian Choose how to control access to objects, pilih apakah bucket Anda menerapkan pencegahan akses publik atau tidak, lalu pilih metode kontrol akses untuk objek bucket Anda.
-
Di bagian Choose how to protect object data, lakukan hal berikut:
- Pilih salah satu opsi di bagian Perlindungan data yang ingin Anda tetapkan untuk bucket.
- Untuk mengaktifkan penghapusan sementara, centang kotak Kebijakan penghapusan sementara (Untuk pemulihan data), dan tentukan jumlah hari yang Anda inginkan untuk mempertahankan objek setelah penghapusan.
- Untuk menetapkan Pembuatan Versi Objek, klik kotak centang Pembuatan versi objek (Untuk kontrol versi), lalu tentukan jumlah maksimum versi per objek dan jumlah hari setelah versi lama tidak berlaku.
- Untuk mengaktifkan kebijakan retensi pada objek dan bucket, klik kotak centang Retention (For compliance), lalu lakukan hal berikut:
- Untuk mengaktifkan Kunci Retensi Objek, centang kotak Aktifkan retensi objek.
- Untuk mengaktifkan Bucket Lock, centang kotak Set bucket retention policy, lalu pilih satuan waktu dan lama untuk periode retensi data.
- Untuk memilih cara data objek Anda akan dienkripsi, luaskan bagian Data encryption (), lalu pilih metode Data encryption.
- Pilih salah satu opsi di bagian Perlindungan data yang ingin Anda tetapkan untuk bucket.
-
Di bagian Get started, lakukan tindakan berikut:
- Klik Create.
Berikan peran BigQuery Data Editor (
roles/bigquery.dataEditor) ke akun layanan default Compute Engine,PROJECT_NUMBER-compute@developer.gserviceaccount.com. Untuk mengetahui petunjuknya, lihat bagian Memberikan satu peran.Contoh Google Cloud CLI:
gcloud projects add-iam-policy-binding PROJECT_ID \
    --member PROJECT_NUMBER-compute@developer.gserviceaccount.com \
--role roles/bigquery.dataEditor
Catatan:
- PROJECT_ID dan PROJECT_NUMBER tercantum di bagian Project info di Google Cloud konsol Dashboard.
Pemetaan resource OSS ke resource BigQuery
Perhatikan pemetaan berikut antara istilah resource open source dan resource BigQuery:
| Resource OSS | Resource BigQuery |
|---|---|
| Namespace, Database | Set data |
| Tabel Berpartisi atau Tidak Berpartisi | Tabel |
| Lihat | Lihat |
Membuat tabel Iceberg
Bagian ini menunjukkan cara membuat tabel Iceberg dengan metadata di katalog runtime Lakehouse menggunakan workload batch Spark SQL dan PySpark Managed Service untuk Apache Spark.
Spark SQL
Menjalankan workload Spark SQL untuk membuat tabel Iceberg
Langkah-langkah berikut menunjukkan cara menjalankan workload batch Managed Service untuk Apache Spark SQL guna membuat tabel Iceberg dengan metadata tabel yang disimpan di katalog runtime Lakehouse.
Salin perintah Spark SQL berikut secara lokal atau di Cloud Shell ke dalam file
iceberg-table.sql.USE CATALOG_NAME; CREATE NAMESPACE IF NOT EXISTS example_namespace; USE example_namespace; DROP TABLE IF EXISTS example_table; CREATE TABLE example_table (id int, data string) USING ICEBERG LOCATION 'gs://BUCKET/WAREHOUSE_FOLDER'; INSERT INTO example_table VALUES (1, 'first row'); ALTER TABLE example_table ADD COLUMNS (newDoubleCol double); DESCRIBE TABLE example_table;
Ganti kode berikut:
- CATALOG_NAME: Nama katalog Iceberg.
- BUCKET dan WAREHOUSE_FOLDER: Bucket dan folder Cloud Storage yang digunakan sebagai direktori warehouse Iceberg.
Jalankan perintah berikut secara lokal atau di Cloud Shell dari direktori yang berisi
iceberg-table.sqluntuk mengirimkan workload Spark SQL.gcloud dataproc batches submit spark-sql iceberg-table.sql \ --project=PROJECT_ID \ --region=REGION \ --deps-bucket=BUCKET_NAME \ --version=2.2 \ --subnet=SUBNET_NAME \ --properties="spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,spark.sql.catalog.CATALOG_NAME.catalog-impl=org.apache.iceberg.gcp.bigquery.BigQueryMetastoreCatalog,spark.sql.catalog.CATALOG_NAME.gcp_project=PROJECT_ID,spark.sql.catalog.CATALOG_NAME.gcp_location=LOCATION,spark.sql.catalog.CATALOG_NAME.warehouse=gs://BUCKET/WAREHOUSE_FOLDER"
Catatan:
- PROJECT_ID: Project ID Google Cloud Anda. Project ID tercantum di bagian Project info di Dashboard konsol Google Cloud .
- REGION: Region Compute Engine yang tersedia untuk menjalankan workload.
- BUCKET_NAME: Nama bucket Cloud Storage Anda. Spark mengupload dependensi workload ke folder
/dependenciesdi bucket ini sebelum menjalankan workload batch. WAREHOUSE_FOLDER berada di bucket ini. --version: Managed Service untuk Apache Spark runtime versi 2.2 atau yang lebih baru.- SUBNET_NAME: Nama subnet VPC di
REGION. Jika Anda menghilangkan flag ini, Managed Service untuk Apache Spark akan memilih subnetdefaultdi region sesi. Managed Service untuk Apache Spark mengaktifkan Akses Google Pribadi (PGA) di subnet. Untuk persyaratan konektivitas jaringan, lihat Konfigurasi jaringan Managed Service untuk Apache Spark. - LOCATION: Lokasi BigQuery yang didukung. Lokasi defaultnya adalah "US".
--propertiesProperti katalog.
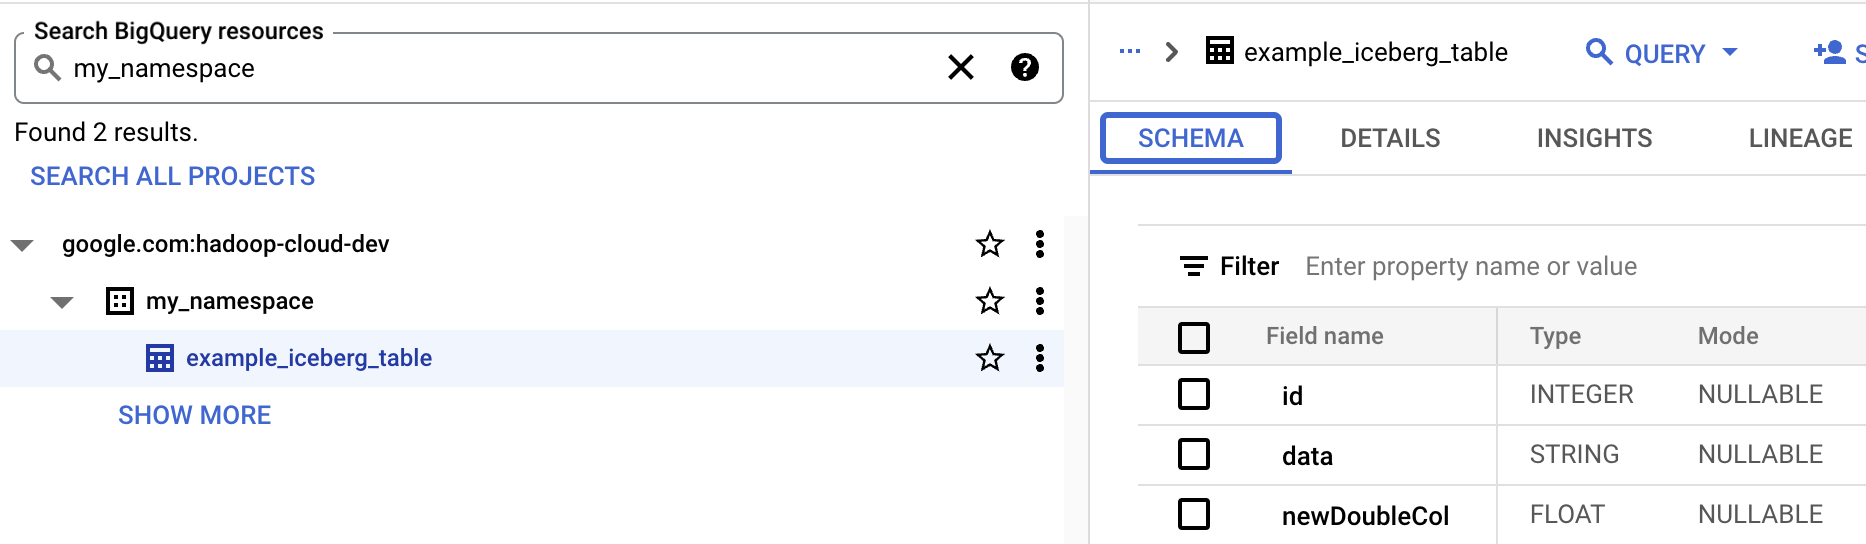
Melihat metadata tabel di BigQuery
Di konsol Google Cloud , buka halaman BigQuery.
Melihat metadata tabel Iceberg.
PySpark
Langkah-langkah berikut menunjukkan cara menjalankan workload batch PySpark Managed Service untuk Apache Spark guna membuat tabel Iceberg dengan metadata tabel yang disimpan di katalog runtime Lakehouse.
- Salin kode PySpark berikut secara lokal atau di
Cloud Shell
ke dalam file
iceberg-table.py.from pyspark.sql import SparkSession spark = SparkSession.builder.appName("iceberg-table-example").getOrCreate() catalog = "CATALOG_NAME" namespace = "NAMESPACE" spark.sql(f"USE `{catalog}`;") spark.sql(f"CREATE NAMESPACE IF NOT EXISTS `{namespace}`;") spark.sql(f"USE `{namespace}`;") # Create table and display schema spark.sql("DROP TABLE IF EXISTS example_iceberg_table") spark.sql("CREATE TABLE example_iceberg_table (id int, data string) USING ICEBERG") spark.sql("DESCRIBE example_iceberg_table;") # Insert table data. spark.sql("INSERT INTO example_iceberg_table VALUES (1, 'first row');") # Alter table, then display schema. spark.sql("ALTER TABLE example_iceberg_table ADD COLUMNS (newDoubleCol double);") spark.sql("DESCRIBE example_iceberg_table;")
Ganti kode berikut:
- CATALOG_NAME dan NAMESPACE: Nama dan namespace katalog Iceberg digabungkan untuk mengidentifikasi tabel Iceberg (
catalog.namespace.table_name).
- CATALOG_NAME dan NAMESPACE: Nama dan namespace katalog Iceberg digabungkan untuk mengidentifikasi tabel Iceberg (
-
Jalankan perintah berikut secara lokal atau di
Cloud Shell
dari direktori yang berisi
iceberg-table.pyuntuk mengirimkan workload PySpark.gcloud dataproc batches submit pyspark iceberg-table.py \ --project=PROJECT_ID \ --region=REGION \ --deps-bucket=BUCKET_NAME \ --version=2.2 \ --subnet=SUBNET_NAME \ --properties="spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,spark.sql.catalog.CATALOG_NAME.catalog-impl=org.apache.iceberg.gcp.bigquery.BigQueryMetastoreCatalog,spark.sql.catalog.CATALOG_NAME.gcp_project=PROJECT_ID,spark.sql.catalog.CATALOG_NAME.gcp_location=LOCATION,spark.sql.catalog.CATALOG_NAME.warehouse=gs://BUCKET/WAREHOUSE_FOLDER"Catatan:
- PROJECT_ID: Project ID Google Cloud Anda. Project ID tercantum di bagian Project info di Dashboard konsol Google Cloud .
- REGION: Region Compute Engine yang tersedia untuk menjalankan workload.
- BUCKET_NAME: Nama bucket Cloud Storage Anda. Spark mengupload dependensi workload ke folder
/dependenciesdi bucket ini sebelum menjalankan workload batch. --version: Managed Service untuk Apache Spark runtime versi 2.2 atau yang lebih baru.- SUBNET_NAME: Nama subnet VPC di
REGION. Jika Anda menghilangkan flag ini, Managed Service untuk Apache Spark akan memilih subnetdefaultdi region sesi. Managed Service untuk Apache Spark mengaktifkan Akses Google Pribadi (PGA) di subnet. Untuk persyaratan konektivitas jaringan, lihat Konfigurasi jaringan Managed Service untuk Apache Spark. - LOCATION: Lokasi BigQuery yang didukung. Lokasi defaultnya adalah "US".
- BUCKET dan WAREHOUSE_FOLDER: Bucket dan folder Cloud Storage yang digunakan sebagai direktori warehouse Iceberg.
--properties: Properti katalog.
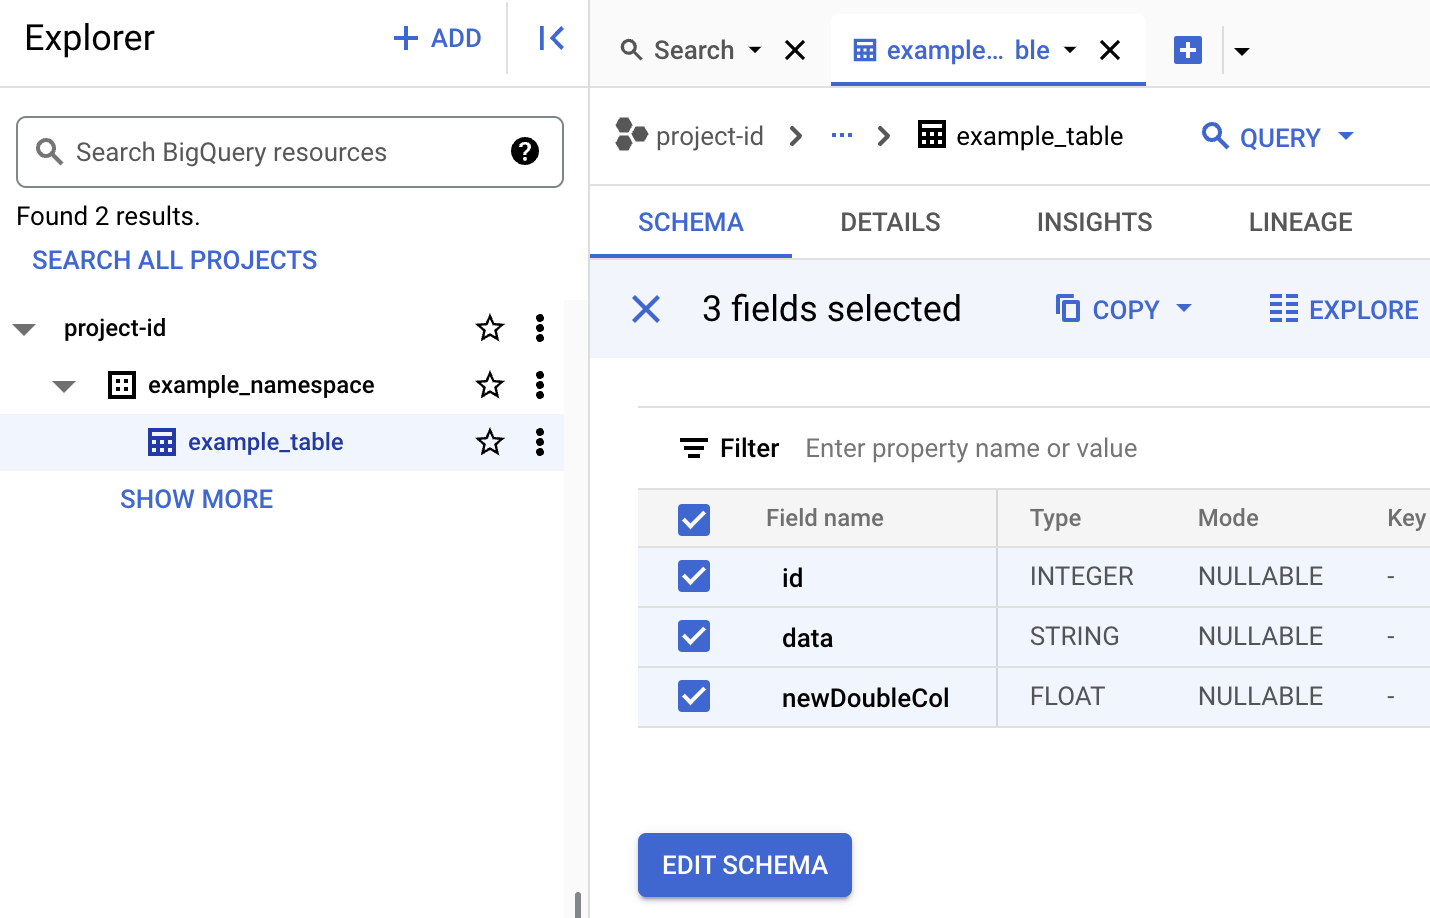
- Melihat skema tabel di BigQuery.
- Di konsol Google Cloud , buka halaman BigQuery. Buka BigQuery Studio
- Melihat metadata tabel Iceberg.