Ce document explique comment exécuter des charges de travail par lot Managed Service pour Apache Spark SQL et PySpark afin de créer une table Apache Iceberg avec des métadonnées stockées dans le catalogue d'environnements d'exécution Lakehouse. Pour en savoir plus sur les autres façons d'exécuter du code Spark, consultez Exécuter du code PySpark dans un notebook BigQuery et Exécuter une charge de travail Apache Spark.
Avant de commencer
Si vous ne l'avez pas déjà fait, créez un projet Google Cloud et un bucket Cloud Storage.
Configurer votre projet
- Connectez-vous à votre compte Google Cloud . Si vous débutez sur Google Cloud, créez un compte pour évaluer les performances de nos produits en conditions réelles. Les nouveaux clients bénéficient également de 300 $ de crédits sans frais pour exécuter, tester et déployer des charges de travail.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
Enable the Dataproc, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
Enable the Dataproc, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.
Créez un bucket Cloud Storage dans votre projet.
- Dans la console Google Cloud , accédez à la page Buckets de Cloud Storage.
- Cliquez sur Créer.
- Sur la page Créer un bucket, saisissez les informations concernant votre bucket. Pour passer à l'étape suivante, cliquez sur Continuer.
-
Dans la section Premiers pas, procédez comme suit :
- Saisissez un nom unique qui répond aux exigences de dénomination des buckets.
- Pour ajouter une étiquette de bucket, développez la section Étiquettes (), cliquez sur add_box Ajouter une étiquette, puis spécifiez un élément
keyet un élémentvaluepour votre étiquette.
-
Dans la section Choisir l'emplacement de stockage de vos données, procédez comme suit :
- Sélectionnez un type d'emplacement.
- Dans le menu déroulant Type d'emplacement, choisissez l'emplacement où les données de votre bucket seront stockées de manière permanente.
- Si vous sélectionnez le type d'emplacement birégional, vous pouvez également choisir d'activer la réplication turbo à l'aide de la case à cocher correspondante.
- Pour configurer la réplication entre buckets, sélectionnez Ajouter une réplication entre buckets via le service de transfert de stockage et suivez les étapes :
Configurer la réplication entre buckets
- Dans le menu Bucket, sélectionnez un bucket.
Dans la section Paramètres de réplication, cliquez sur Configurer pour configurer les paramètres du job de réplication.
Le volet Configurer la réplication entre buckets s'affiche.
- Pour filtrer les objets à répliquer en fonction du préfixe de leur nom, saisissez le préfixe avec lequel vous souhaitez inclure ou exclure des objets, puis cliquez sur Ajouter un préfixe.
- Pour définir une classe de stockage pour les objets répliqués, sélectionnez-en une dans le menu Classe de stockage. Si vous ignorez cette étape, les objets répliqués utiliseront la classe de stockage par défaut du bucket de destination.
- Cliquez sur OK.
-
Dans la section Choisir comment stocker vos données, procédez comme suit :
- Sélectionnez une classe de stockage par défaut pour le bucket ou bien classe automatique pour gérer automatiquement les classes de stockage des données de votre bucket.
- Pour activer l'espace de noms hiérarchique, dans la section Optimiser l'espace de stockage pour les charges de travail utilisant beaucoup de données, sélectionnez Activer l'espace de noms hiérarchique sur ce bucket.
- Dans la section Choisissez comment contrôler l'accès aux objets, indiquez si votre bucket applique ou non la protection contre l'accès public et sélectionnez une méthode de contrôle des accès pour les objets de votre bucket.
-
Dans la section Choisissez comment protéger les données des objets, procédez comme suit :
- Sous Protection des données, sélectionnez les options que vous souhaitez définir pour votre bucket.
- Pour activer la suppression réversible, cochez la case Règle de suppression réversible (pour la récupération de données), puis spécifiez le nombre de jours pendant lesquels vous souhaitez conserver les objets après leur suppression.
- Pour définir la gestion des versions d'objets, cochez la case Gestion des versions d'objets (pour le contrôle des versions), puis spécifiez le nombre maximal de versions par objet et le nombre de jours après lequel les versions obsolètes expirent.
- Pour activer la règle de conservation sur les objets et les buckets, cochez la case Conservation (pour la conformité), puis procédez comme suit :
- Pour activer le verrou de conservation des objets, cochez la case Activer la conservation des objets.
- Pour activer le verrou de bucket, cochez la case Définir une règle de conservation de bucket, puis choisissez une unité de temps et une durée pour votre période de conservation.
- Pour choisir comment vos données d'objet seront chiffrées, développez la section Chiffrement des données (), puis sélectionnez une méthode de chiffrement des données.
- Sous Protection des données, sélectionnez les options que vous souhaitez définir pour votre bucket.
-
Dans la section Premiers pas, procédez comme suit :
- Cliquez sur Créer.
Attribuez le rôle Éditeur de données BigQuery (
roles/bigquery.dataEditor) au compte de service Compute Engine par défaut,PROJECT_NUMBER-compute@developer.gserviceaccount.com. Pour savoir comment procéder, consultez la section Attribuer un rôle unique.Exemple avec Google Cloud CLI :
gcloud projects add-iam-policy-binding PROJECT_ID \
    --member PROJECT_NUMBER-compute@developer.gserviceaccount.com \
--role roles/bigquery.dataEditor
Remarques :
- PROJECT_ID et PROJECT_NUMBER sont listés dans la section Informations sur le projet du tableau de bord de la console Google Cloud .
Mappage des ressources OSS vers les ressources BigQuery
Notez la correspondance suivante entre les termes des ressources Open Source et ceux des ressources BigQuery :
| Ressource OSS | Ressource BigQuery |
|---|---|
| Espace de noms, base de données | Ensemble de données |
| Table partitionnée ou non partitionnée | Table |
| Afficher | Afficher |
Créer une table Iceberg
Cette section vous explique comment créer une table Iceberg avec des métadonnées dans le catalogue d'environnements d'exécution Lakehouse à l'aide des charges de travail par lot Spark SQL et PySpark de Managed Service pour Apache Spark.
Spark SQL
Exécuter une charge de travail Spark SQL pour créer une table Iceberg
Les étapes suivantes vous montrent comment exécuter une charge de travail par lot Managed Service pour Apache Spark SQL afin de créer une table Iceberg avec des métadonnées de table stockées dans le catalogue d'environnements d'exécution Lakehouse.
Copiez les commandes Spark SQL suivantes localement ou dans Cloud Shell dans un fichier
iceberg-table.sql.USE CATALOG_NAME; CREATE NAMESPACE IF NOT EXISTS example_namespace; USE example_namespace; DROP TABLE IF EXISTS example_table; CREATE TABLE example_table (id int, data string) USING ICEBERG LOCATION 'gs://BUCKET/WAREHOUSE_FOLDER'; INSERT INTO example_table VALUES (1, 'first row'); ALTER TABLE example_table ADD COLUMNS (newDoubleCol double); DESCRIBE TABLE example_table;
Remplacez les éléments suivants :
- CATALOG_NAME : nom du catalogue Iceberg.
- BUCKET et WAREHOUSE_FOLDER : bucket Cloud Storage et dossier utilisés comme répertoire d'entrepôt Iceberg.
Exécutez la commande suivante localement ou dans Cloud Shell à partir du répertoire contenant
iceberg-table.sqlpour envoyer la charge de travail Spark SQL.gcloud dataproc batches submit spark-sql iceberg-table.sql \ --project=PROJECT_ID \ --region=REGION \ --deps-bucket=BUCKET_NAME \ --version=2.2 \ --subnet=SUBNET_NAME \ --properties="spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,spark.sql.catalog.CATALOG_NAME.catalog-impl=org.apache.iceberg.gcp.bigquery.BigQueryMetastoreCatalog,spark.sql.catalog.CATALOG_NAME.gcp_project=PROJECT_ID,spark.sql.catalog.CATALOG_NAME.gcp_location=LOCATION,spark.sql.catalog.CATALOG_NAME.warehouse=gs://BUCKET/WAREHOUSE_FOLDER"
Remarques :
- PROJECT_ID : ID de votre projet Google Cloud . Les ID de projet sont listés dans la section Informations sur le projet du tableau de bord de la console Google Cloud .
- REGION : région Compute Engine disponible pour exécuter la charge de travail.
- BUCKET_NAME : nom du bucket Cloud Storage. Spark importe les dépendances de la charge de travail dans un dossier
/dependenciesde ce bucket avant d'exécuter la charge de travail par lot. Le fichier WAREHOUSE_FOLDER se trouve dans ce bucket. --version: version d'exécution 2.2 ou ultérieure de Managed Service pour Apache Spark.- SUBNET_NAME : nom d'un sous-réseau VPC dans
REGION. Si vous omettez cette option, Managed Service pour Apache Spark sélectionne le sous-réseaudefaultdans la région de la session. Managed Service pour Apache Spark active l'accès privé à Google (PGA) sur le sous-réseau. Pour connaître les exigences de connectivité réseau, consultez Configuration réseau de Managed Service pour Apache Spark. - LOCATION : un emplacement BigQuery compatible. L'emplacement par défaut est "US".
--propertiesPropriétés de catalogue.
Afficher les métadonnées d'une table dans BigQuery
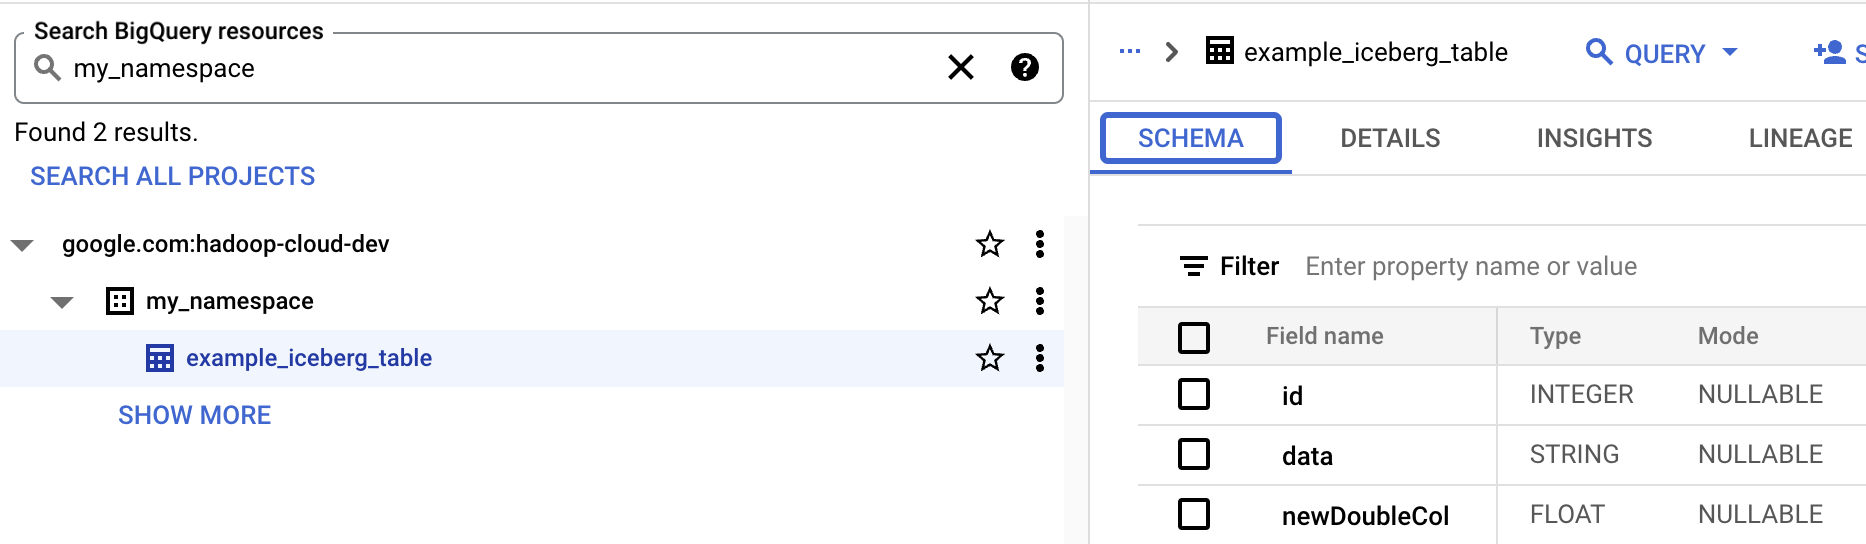
Dans la console Google Cloud , accédez à la page BigQuery.
Afficher les métadonnées d'une table Iceberg.
PySpark
Les étapes suivantes vous montrent comment exécuter une charge de travail par lot PySpark Managed Service pour Apache Spark afin de créer une table Iceberg avec des métadonnées de table stockées dans le catalogue d'environnements d'exécution Lakehouse.
- Copiez le code PySpark suivant localement ou dans Cloud Shell dans un fichier
iceberg-table.py.from pyspark.sql import SparkSession spark = SparkSession.builder.appName("iceberg-table-example").getOrCreate() catalog = "CATALOG_NAME" namespace = "NAMESPACE" spark.sql(f"USE `{catalog}`;") spark.sql(f"CREATE NAMESPACE IF NOT EXISTS `{namespace}`;") spark.sql(f"USE `{namespace}`;") # Create table and display schema spark.sql("DROP TABLE IF EXISTS example_iceberg_table") spark.sql("CREATE TABLE example_iceberg_table (id int, data string) USING ICEBERG") spark.sql("DESCRIBE example_iceberg_table;") # Insert table data. spark.sql("INSERT INTO example_iceberg_table VALUES (1, 'first row');") # Alter table, then display schema. spark.sql("ALTER TABLE example_iceberg_table ADD COLUMNS (newDoubleCol double);") spark.sql("DESCRIBE example_iceberg_table;")
Remplacez les éléments suivants :
- CATALOG_NAME et NAMESPACE : le nom et l'espace de noms du catalogue Iceberg se combinent pour identifier la table Iceberg (
catalog.namespace.table_name).
- CATALOG_NAME et NAMESPACE : le nom et l'espace de noms du catalogue Iceberg se combinent pour identifier la table Iceberg (
-
Exécutez la commande suivante localement ou dans Cloud Shell à partir du répertoire contenant
iceberg-table.pypour envoyer la charge de travail PySpark.gcloud dataproc batches submit pyspark iceberg-table.py \ --project=PROJECT_ID \ --region=REGION \ --deps-bucket=BUCKET_NAME \ --version=2.2 \ --subnet=SUBNET_NAME \ --properties="spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,spark.sql.catalog.CATALOG_NAME.catalog-impl=org.apache.iceberg.gcp.bigquery.BigQueryMetastoreCatalog,spark.sql.catalog.CATALOG_NAME.gcp_project=PROJECT_ID,spark.sql.catalog.CATALOG_NAME.gcp_location=LOCATION,spark.sql.catalog.CATALOG_NAME.warehouse=gs://BUCKET/WAREHOUSE_FOLDER"Remarques :
- PROJECT_ID : ID de votre projet Google Cloud . Les ID de projet sont listés dans la section Informations sur le projet du tableau de bord de la console Google Cloud .
- REGION : région Compute Engine disponible pour exécuter la charge de travail.
- BUCKET_NAME : nom du bucket Cloud Storage. Spark importe les dépendances de la charge de travail dans un dossier
/dependenciesde ce bucket avant d'exécuter la charge de travail par lot. --version: version d'exécution 2.2 ou ultérieure de Managed Service pour Apache Spark.- SUBNET_NAME : nom d'un sous-réseau VPC dans
REGION. Si vous omettez cette option, Managed Service pour Apache Spark sélectionne le sous-réseaudefaultdans la région de la session. Managed Service pour Apache Spark active l'accès privé à Google (PGA) sur le sous-réseau. Pour connaître les exigences de connectivité réseau, consultez Configuration réseau de Managed Service pour Apache Spark. - LOCATION : emplacement BigQuery compatible. L'emplacement par défaut est "US".
- BUCKET et WAREHOUSE_FOLDER : bucket Cloud Storage et dossier utilisés comme répertoire d'entrepôt Iceberg.
--properties: Propriétés du catalogue.
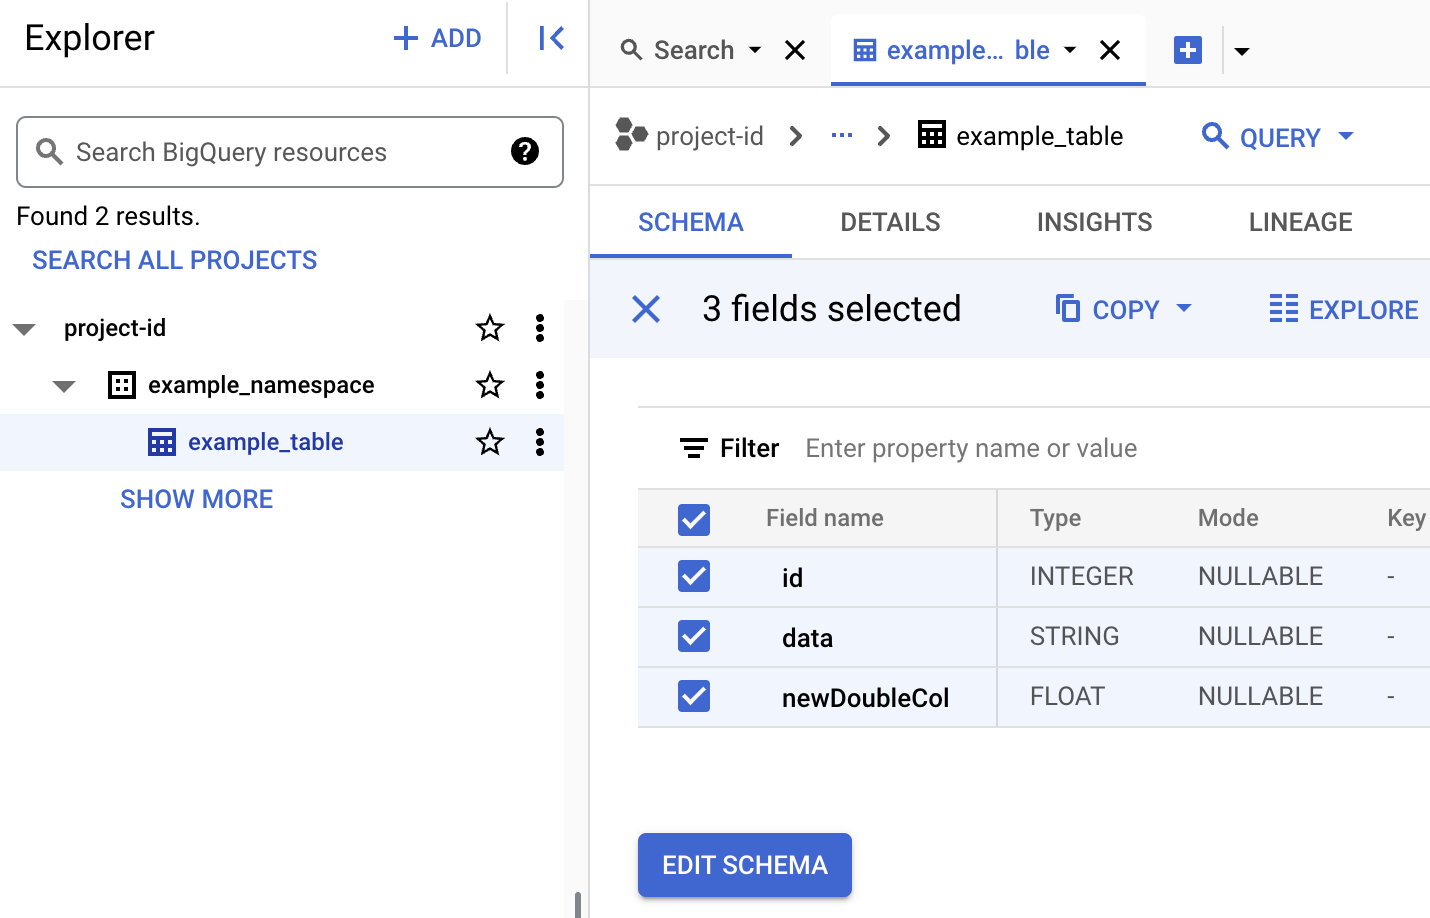
- Afficher le schéma de la table dans BigQuery
- Dans la console Google Cloud , accédez à la page BigQuery. Accédez à BigQuery Studio.
- Afficher les métadonnées d'une table Iceberg.