


Puedes usar el conector spark-bigquery
con Managed Service para Apache Spark para leer y escribir datos desde y hacia BigQuery. En este instructivo, se muestra una aplicación de PySpark que usa el
spark-bigquery-connector.
Confirma la versión del conector
Consulta las versiones del entorno de ejecución de Managed Service para Apache Spark para determinar la versión del conector de BigQuery que está instalada en la versión del entorno de ejecución de tu carga de trabajo por lotes o sesión interactiva. Si el conector no aparece en la lista, consulta Haz que el conector esté disponible para las aplicaciones.
Haz que el conector esté disponible para las aplicaciones (si es necesario)
El conector de BigQuery se instala en todas las
versiones compatibles del entorno de ejecución de Managed Service para Apache Spark.
Si usas una
versión de entorno de ejecución no compatible
que no instala el conector (Spark runtime 1.0), puedes hacer que el conector esté disponible para una
aplicación de cualquiera de las siguientes dos maneras:
- Usa el parámetro
jarspara apuntar a un archivo JAR del conector cuando envíes una carga de trabajo por lotes de Managed Service para Apache Spark o ejecutes una sesión interactiva. En el siguiente ejemplo de carga de trabajo por lotes, se especifica un archivo JAR del conector (consulta el repositorio GoogleCloudDataproc/spark-bigquery-connector en GitHub para obtener una lista de los archivos JAR del conector disponibles).- Ejemplo de Google Cloud CLI:
gcloud dataproc batches submit pyspark \
    --region=REGION \
    --jars=spark-3.5-bigquery-version.jar \
    ... other args
- Ejemplo de Google Cloud CLI:
Calcula los costos
En este instructivo, se usan componentes facturables de Google Cloud, incluidos los siguientes:
- Managed Service para Apache Spark
- BigQuery
- Cloud Storage
Usa la calculadora de precios para generar una estimación de los costos según el uso previsto.
Configura la facturación
De forma predeterminada, el proyecto asociado con las credenciales o la cuenta de servicio se
factura por el uso de la API. Para facturar un proyecto diferente, establece la siguiente
propiedad de configuración: spark.conf.set("parentProject", "<BILLED-GCP-PROJECT>").
También puedes agregar esta propiedad a una operación de lectura o escritura, de la siguiente manera:
.option("parentProject", "<BILLED-GCP-PROJECT>").
Envía una carga de trabajo por lotes de recuento de palabras de PySpark
Este ejemplo lee los datos de BigQuery en un DataFrame de Spark para realizar un recuento de palabras mediante la API de fuente de datos estándar.
El conector escribe el resultado del recuento de palabras en BigQuery en la siguiente secuencia de operaciones:
Almacena los datos en búfer en archivos temporales en tu bucket de Cloud Storage.
Copia los datos en una sola operación desde tu bucket de Cloud Storage hasta BigQuery.
Borra los archivos temporales en Cloud Storage después de que se completa la operación de carga de BigQuery (los archivos temporales también se borran después de que finaliza la aplicación de Spark). Si la eliminación falla, deberás borrar los archivos temporales no deseados de Cloud Storage, que, por lo general, se colocan en
gs://BUCKET_NAME/.spark-bigquery-JOB_ID-UUID.
Pasos para ejecutar la carga de trabajo de wordcount
- Abre una terminal local o Cloud Shell.
- Crea el
wordcount_datasetcon la herramienta de línea de comandos de bq en una terminal local o en Cloud Shell.bq mk wordcount_dataset
- Crea un bucket de Cloud Storage con la
Google Cloud CLI.
gcloud storage buckets create gs://BUCKET_NAME
BUCKET_NAMEpor el nombre del bucket de Cloud Storage que creaste. - Crea el archivo
wordcount.pyde forma local en un editor de texto copiando el siguiente código de PySpark.#!/usr/bin/python """BigQuery I/O PySpark example.""" from pyspark.sql import SparkSession spark = SparkSession \ .builder \ .appName('spark-bigquery-demo') \ .getOrCreate() # Cloud Storage bucket used by the connector for temporary BigQuery # export data. bucket = "BUCKET_NAME" spark.conf.set('temporaryGcsBucket', bucket) # Enable reading from BigQuery views and materializing query results. spark.conf.set('viewsEnabled', 'true') spark.conf.set('materializationDataset', 'wordcount_dataset') # Load data from BigQuery. words = spark.read.format('bigquery') \ .load('bigquery-public-data.samples.shakespeare') words.createOrReplaceTempView('words') # Perform word count. word_count = spark.sql( 'SELECT word, SUM(word_count) AS word_count FROM words GROUP BY word') word_count.show() word_count.printSchema() # Save the data to BigQuery word_count.write.format('bigquery') \ .save('wordcount_dataset.wordcount_output')
- Envía la carga de trabajo por lotes de PySpark:
gcloud dataproc batches submit pyspark wordcount.py \
    --region=REGION \
    --deps-bucket=BUCKET_NAME
...
+---------+----------+
|     word|word_count|
+---------+----------+
|     XVII|         2|
|    spoil|        28|
|    Drink|         7|
|forgetful|         5|
|   Cannot|        46|
|    cures|        10|
|   harder|        13|
|  tresses|         3|
|      few|        62|
|  steel'd|         5|
| tripping|         7|
|   travel|        35|
|   ransom|        55|
|     hope|       366|
|       By|       816|
|     some|      1169|
|    those|       508|
|    still|       567|
|      art|       893|
|    feign|        10|
+---------+----------+
only showing top 20 rows

root
 |-- word: string (nullable = false)
 |-- word_count: long (nullable = true)
Para obtener una vista previa de la tabla de salida en la consola de Google Cloud , abre la página de BigQuery, selecciona la tablawordcount_outputy, luego, haz clic en Vista previa.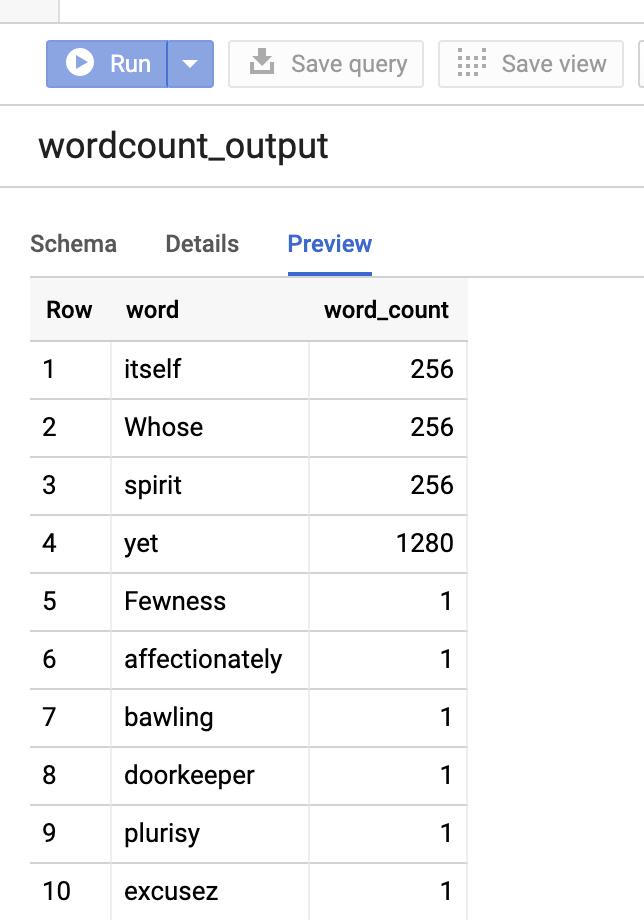
Figura 1: Obtén una vista previa de la tabla de salida en BigQuery
Más información
- Almacenamiento de BigQuery y Spark SQL: Python
- Crea un archivo de definición de tablas para una fuente de datos externa
- Usa datos particionados de forma externa