


משאב NodeGroup של Managed Service for Apache Spark הוא קבוצה של צומתי אשכולות של Managed Service for Apache Spark שמבצעים תפקיד שהוקצה להם. בדף הזה מתוארת קבוצת צומתי הדרייבר, שהיא קבוצה של מכונות וירטואליות של Compute Engine שהוקצה להן התפקיד Driver כדי להריץ דרייברים של משימות באשכול של Managed Service for Apache Spark.
מתי כדאי להשתמש בקבוצות של צומתי דרייבר
- השתמשו בקבוצות של צומתי דרייבר רק כשאתם צריכים להריץ הרבה משימות בו-זמנית באשכול משותף.
- כדי להימנע ממגבלות של קבוצות צומתי דרייבר, צריך להגדיל את המשאבים של צומת המאסטר לפני שמשתמשים בקבוצות צומתי דרייבר.
איך צומתי דרייבר עוזרים להריץ משימות בו-זמנית
בכל משימה, Managed Service for Apache Spark מפעיל תהליך של מנהל התקן משימות בצומת הראשי של אשכול Managed Service for Apache Spark. תהליך הדרייבר, בתורו, מריץ דרייבר של אפליקציה, כמו spark-submit, כתהליך משני.
עם זאת, מספר המשימות שפועלות בו-זמנית בצומת הראשי מוגבל על ידי המשאבים שזמינים בצומת הראשי. מכיוון שלא ניתן לשנות את קנה המידה של הצמתים הראשיים ב-Managed Service for Apache Spark, משימה יכולה להיכשל או להיות מוגבלת כשהמשאבים של הצומת הראשי לא מספיקים להרצת המשימה.
קבוצות של צומתי דרייבר הן קבוצות מיוחדות של צמתים שמנוהלות על ידי YARN, כך שהפעלה בו-זמנית של משימות לא מוגבלת על ידי המשאבים של צומת המאסטר. באשכולות עם קבוצת צומתי דרייבר, הדרייברים של האפליקציות פועלים בצומתי הדרייבר. כל צומת דרייבר יכול להריץ כמה דרייברים של אפליקציות, אם יש לו מספיק משאבים.
יתרונות
שימוש באשכול של Managed Service for Apache Spark עם קבוצת צומתי דרייבר מאפשר לכם:
- הגדלה אופקית של משאבי מנהלי ההתקנים של המשימות כדי להריץ יותר משימות בו-זמנית
- התאמת קנה המידה של משאבי הדרייבר בנפרד ממשאבי ה-worker
- צמצום מהיר יותר של אשכולות של קובצי אימג' בגרסה 2.0 ומעלה של Managed Service for Apache Spark. באשכולות האלה, מנהל האפליקציה פועל בתוך מנהל התקן של Spark בקבוצת צומתי דרייבר (הערך של
spark.yarn.unmanagedAM.enabledמוגדר כ-trueכברירת מחדל). - התאמה אישית של הפעלת צומת הדרייבר. אפשר להוסיף את
{ROLE} == 'Driver'לסקריפט אתחול כדי שהסקריפט יבצע פעולות בקבוצת צומתי דרייבר בבחירת צומת.
מגבלות
- אין תמיכה בקבוצות של צמתים בתבניות של תהליכי עבודה ב-Managed Service for Apache Spark.
- אי אפשר לעצור, להפעיל מחדש או לשנות את קנה המידה באופן אוטומטי של אשכולות של קבוצות צמתים.
- האפליקציה הראשית של MapReduce פועלת בצומתי עובדים. אם מפעילים את האפשרות צמצום הדרגתי של כמות השרתים, יכול להיות שהצמצום האנכי של צומתי העובדים יהיה איטי.
- ההרצה בו-זמנית של משימות מושפעת ממאפיין האשכול
dataproc:agent.process.threads.job.max. לדוגמה, אם יש שלושה מאסטרים והמאפיין הזה מוגדר לערך ברירת המחדל100, מספר המשימות המקסימלי שאפשר להריץ בו-זמנית ברמת האשכול הוא300.
קבוצת צומתי דרייבר בהשוואה למצב אשכול Spark
| תכונה | מצב אשכול של Spark | קבוצת צומתי דרייבר |
|---|---|---|
| צמצום אנכי בהתאם לעומס (scale down) של צומת עובד | מנהלי התקנים לטווח ארוך פועלים באותם צומתי עובדים כמו קונטיינרים לטווח קצר, ולכן צמצום הדרגתי של כמות השרתים של העובדים באמצעות הוצאה הדרגתית משימוש הוא איטי. | צמצום אנכי של צומתי עובדים מתבצע מהר יותר כשמנהלי ההתקנים פועלים בקבוצות של צמתים. |
| פלט של מנהל התקן בסטרימינג | צריך לחפש ביומני YARN כדי למצוא את הצומת שבו תזמנו את הדרייבר. | הפלט של מנהל ההתקן מועבר בסטרימינג ל-Cloud Storage, ואפשר לראות אותו במסוף Google Cloud ובפלט של הפקודה gcloud dataproc jobs wait אחרי שהמשימה מסתיימת. |
הרשאות IAM לקבוצת צומתי הדרייבר
הרשאות ה-IAM הבאות משויכות לפעולות שקשורות לקבוצת הצמתים של Managed Service for Apache Spark.
| הרשאה | פעולה |
|---|---|
dataproc.nodeGroups.create
|
ליצור קבוצות של צמתים ב-Managed Service for Apache Spark. אם למשתמש יש את ההרשאה dataproc.clusters.create בפרויקט, ההרשאה הזו ניתנת. |
dataproc.nodeGroups.get |
קבלת הפרטים של קבוצת צמתים ב-Managed Service for Apache Spark. |
dataproc.nodeGroups.update |
שינוי הגודל של קבוצת צמתים ב-Managed Service for Apache Spark. |
פעולות בקבוצת צומתי דרייבר
אתם יכולים להשתמש ב-CLI של gcloud וב-Managed Service for Apache Spark API כדי ליצור, לקבל, לשנות את הגודל, למחוק ולשלוח משימה לקבוצת צומתי דרייבר של Managed Service for Apache Spark.
יצירת אשכול של קבוצת צומתי דרייבר
קבוצת צומתי דרייבר משויכת לאשכול אחד של Managed Service for Apache Spark. יוצרים קבוצת צמתים כחלק מיצירת אשכול Managed Service for Apache Spark. אתם יכולים להשתמש ב-CLI של gcloud או ב-API בארכיטקטורת REST של Managed Service for Apache Spark כדי ליצור אשכול של Managed Service for Apache Spark עם קבוצת צומתי דרייבר.
gcloud
gcloud dataproc clusters create CLUSTER_NAME \
    --region=REGION \
    --driver-pool-size=SIZE \
    --driver-pool-id=NODE_GROUP_ID
דגלים נדרשים:
- CLUSTER_NAME: שם האשכול, שחייב להיות ייחודי בפרויקט. השם צריך להתחיל באות קטנה באנגלית, ויכול לכלול עד 51 אותיות קטנות, מספרים ומקפים. הוא לא יכול להסתיים במקף. אפשר להשתמש שוב בשם של אשכול שנמחק.
- REGION: האזור שבו יהיה האשכול.
- SIZE: מספר צומתי הדרייבר בקבוצת הצמתים. מספר הצמתים שצריך תלוי בעומס העבודה ובסוג המכונה של מאגר הדרייברים. מספר הצמתים המינימלי בקבוצת מנהלי ההתקנים שווה לזיכרון הכולל או למעבדים הווירטואליים שנדרשים למנהלי ההתקנים של המשימות, חלקי הזיכרון או המעבדים הווירטואליים של המכונה בכל מאגר של מנהלי התקנים.
- NODE_GROUP_ID: אופציונלי ומומלץ. המזהה חייב להיות ייחודי באשכול. אתם יכולים להשתמש במזהה הזה כדי לזהות את קבוצת הדרייברים בפעולות עתידיות, כמו שינוי הגודל של קבוצת הצמתים. אם לא מציינים מזהה, Managed Service for Apache Spark יוצר את מזהה קבוצת הצמתים.
הדגל המומלץ:
-
--enable-component-gateway: מוסיפים את הדגל הזה כדי להפעיל את שער הרכיבים של Managed Service for Apache Spark, שמאפשר גישה לממשק האינטרנט של YARN. בדפים Application ו-Scheduler בממשק המשתמש של YARN מוצגים הסטטוס של האשכול והמשימה, זיכרון התור של האפליקציה, קיבולת הליבה ומדדים אחרים.
דגלים נוספים: אפשר להוסיף את הדגלים האופציונליים הבאים של driver-pool לפקודה gcloud dataproc clusters create כדי להתאים אישית את קבוצת הצמתים.
| דגל | ערך ברירת המחדל |
|---|---|
--driver-pool-id |
מזהה מחרוזת, שנוצר על ידי השירות אם לא הוגדר על ידי הדגל. אפשר להשתמש במזהה הזה כדי לזהות את קבוצת הצמתים כשמבצעים פעולות עתידיות במאגר הצמתים, כמו שינוי הגודל של קבוצת הצמתים. |
--driver-pool-machine-type |
n1-standard-4 |
--driver-pool-accelerator |
אין ברירת מחדל. כשמציינים מאיץ, חובה לציין את סוג ה-GPU. מספר יחידות ה-GPU הוא אופציונלי. |
--num-driver-pool-local-ssds |
ללא ברירת מחדל |
--driver-pool-local-ssd-interface |
ללא ברירת מחדל |
--driver-pool-boot-disk-type |
pd-standard |
--driver-pool-boot-disk-size |
1000 GB |
--driver-pool-min-cpu-platform |
AUTOMATIC |
REST
ממלאים את השדה AuxiliaryNodeGroup כחלק מבקשת cluster.create ב-Managed Service for Apache Spark API.
לפני שמשתמשים בנתוני הבקשה, צריך להחליף את הנתונים הבאים:
- PROJECT_ID: חובה. מזהה הפרויקט ב-Google Cloud.
- REGION: חובה. האזור של אשכול Dataproc.
- CLUSTER_NAME: חובה. שם האשכול, שחייב להיות ייחודי בפרויקט. השם צריך להתחיל באות קטנה באנגלית, ויכול להכיל עד 51 אותיות קטנות, מספרים ומקפים. הוא לא יכול להסתיים במקף. אפשר להשתמש שוב בשם של אשכול שנמחק.
- SIZE: חובה. מספר הצמתים בקבוצת הצמתים.
- NODE_GROUP_ID: אופציונלי ומומלץ. המזהה חייב להיות ייחודי באשכול. משתמשים במזהה הזה כדי לזהות את קבוצת הדרייברים בפעולות עתידיות, כמו שינוי הגודל של קבוצת הצמתים. אם לא מציינים מזהה, Managed Service for Apache Spark יוצר את מזהה קבוצת הצמתים.
אפשרויות נוספות: ראו NodeGroup.
ה-method של ה-HTTP וכתובת ה-URL:
POST https://dataproc.googleapis.com/v1/projects/PROJECT_ID/regions/REGION/clusters
תוכן בקשת JSON:
{
  "clusterName":"CLUSTER_NAME",
  "config": {
    "softwareConfig": {
      "imageVersion":""
    },
    "endpointConfig": {
      "enableHttpPortAccess": true
    },
    "auxiliaryNodeGroups": [{
        "nodeGroup":{
            "roles":["DRIVER"],
            "nodeGroupConfig": {
                "numInstances": SIZE
             }
         },
        "nodeGroupId": "NODE_GROUP_ID"
    }]
  }
}
כדי לשלוח את הבקשה צריך להרחיב אחת מהאפשרויות הבאות:
אתם אמורים לקבל תגובת JSON שדומה לזו:
{
  "projectId": "PROJECT_ID",
  "clusterName": "CLUSTER_NAME",
  "config": {
    ...
    "auxiliaryNodeGroups": [
      {
        "nodeGroup": {
"name": "projects/PROJECT_ID/regions/REGION/clusters/CLUSTER_NAME/nodeGroups/NODE_GROUP_ID",
          "roles": [
            "DRIVER"
          ],
          "nodeGroupConfig": {
            "numInstances": SIZE,
            "instanceNames": [
              "CLUSTER_NAME-np-q1gp",
              "CLUSTER_NAME-np-xfc0"
            ],
            "imageUri": "https://www.googleapis.com/compute/v1/projects/cloud-dataproc-ci/global/images/dataproc-2-0-deb10-...-rc01",
            "machineTypeUri": "https://www.googleapis.com/compute/v1/projects/PROJECT_ID/zones/REGION-a/machineTypes/n1-standard-4",
            "diskConfig": {
              "bootDiskSizeGb": 1000,
              "bootDiskType": "pd-standard"
            },
            "managedGroupConfig": {
              "instanceTemplateName": "dataproc-2a8224d2-...",
              "instanceGroupManagerName": "dataproc-2a8224d2-..."
            },
            "minCpuPlatform": "AUTOMATIC",
            "preemptibility": "NON_PREEMPTIBLE"
          }
        },
        "nodeGroupId": "NODE_GROUP_ID"
      }
    ]
  },
}
אחזור מטא-נתונים של אשכול קבוצת צומתי דרייבר
כדי לקבל את המטא-נתונים של קבוצת צומתי הדרייבר, אתם יכולים להשתמש בפקודה gcloud dataproc node-groups describe או ב-Managed Service for Apache Spark API.
gcloud
gcloud dataproc node-groups describe NODE_GROUP_ID \
    --cluster=CLUSTER_NAME \
    --region=REGION
דגלים נדרשים:
- NODE_GROUP_ID: אפשר להריץ את
gcloud dataproc clusters
describe CLUSTER_NAME
כדי להציג את מזהה קבוצת הצמתים. - CLUSTER_NAME: שם האשכול.
- REGION: האזור של האשכול.
REST
לפני שמשתמשים בנתוני הבקשה, צריך להחליף את הנתונים הבאים:
- PROJECT_ID: חובה. מזהה הפרויקט ב-Google Cloud.
- REGION: חובה. האזור של האשכול.
- CLUSTER_NAME: חובה. שם האשכול.
- NODE_GROUP_ID: חובה. אפשר להריץ את הפקודה
gcloud dataproc clusters describe CLUSTER_NAMEכדי להציג את המזהה של קבוצת הצמתים.
ה-method של ה-HTTP וכתובת ה-URL:
GET https://dataproc.googleapis.com/v1/projects/PROJECT_ID/regions/REGION/clusters/CLUSTER_NAMEnodeGroups/Node_GROUP_ID
כדי לשלוח את הבקשה צריך להרחיב אחת מהאפשרויות הבאות:
אתם אמורים לקבל תגובת JSON שדומה לזו:
{
  "name": "projects/PROJECT_ID/regions/REGION/clusters/CLUSTER_NAME/nodeGroups/NODE_GROUP_ID",
  "roles": [
    "DRIVER"
  ],
  "nodeGroupConfig": {
    "numInstances": 5,
    "imageUri": "https://www.googleapis.com/compute/v1/projects/cloud-dataproc-ci/global/images/dataproc-2-0-deb10-...-rc01",
    "machineTypeUri": "https://www.googleapis.com/compute/v1/projects/PROJECT_ID/zones/REGION-a/machineTypes/n1-standard-4",
    "diskConfig": {
      "bootDiskSizeGb": 1000,
      "bootDiskType": "pd-standard"
    },
    "managedGroupConfig": {
      "instanceTemplateName": "dataproc-driver-pool-mcia3j656h2fy",
      "instanceGroupManagerName": "dataproc-driver-pool-mcia3j656h2fy"
    },
    "minCpuPlatform": "AUTOMATIC",
    "preemptibility": "NON_PREEMPTIBLE"
  }
}
שינוי הגודל של קבוצת צומתי דרייבר
כדי להוסיף צומתי דרייבר לקבוצת צומתי דרייבר של אשכול או להסיר אותם ממנה, אתם יכולים להשתמש בפקודה gcloud dataproc node-groups resize או ב-Managed Service for Apache Spark API.
gcloud
gcloud dataproc node-groups resize NODE_GROUP_ID \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --size=SIZE
דגלים נדרשים:
- NODE_GROUP_ID: אפשר להריץ את
gcloud dataproc clusters
describe CLUSTER_NAME
כדי להציג את מזהה קבוצת הצמתים. - CLUSTER_NAME: שם האשכול.
- REGION: האזור של האשכול.
- SIZE: מציינים את המספר החדש של צומתי הדרייבר בקבוצת הצמתים.
דגל אופציונלי:
-
--graceful-decommission-timeout=TIMEOUT_DURATION: כשמצמצמים אנכית בהתאם לעומס (scale down) קבוצת צמתים, אפשר להוסיף את הדגל הזה כדי לציין צמצום הדרגתי של כמות השרתים TIMEOUT_DURATION, וכך להימנע מסיום מיידי של מנהלי התקנים של משימות. המלצה: הגדירו משך זמן קצוב ששווה לפחות למשך הזמן של המשימה הארוכה ביותר שפועלת בקבוצת הצמתים (אין תמיכה בשחזור של מנהלי התקנים שנכשלו).
דוגמה: פקודת הגדלה של NodeGroup ב-CLI של gcloud:
gcloud dataproc node-groups resize NODE_GROUP_ID \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --size=4
דוגמה: פקודת צמצום אנכי בהתאם לעומס (scale down) ב-CLI של gcloud NodeGroup:
gcloud dataproc node-groups resize NODE_GROUP_ID \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --size=1 \
    --graceful-decommission-timeout="100s"
REST
לפני שמשתמשים בנתוני הבקשה, צריך להחליף את הנתונים הבאים:
- PROJECT_ID: חובה. מזהה הפרויקט ב-Google Cloud.
- REGION: חובה. האזור של האשכול.
- NODE_GROUP_ID: חובה. אפשר להריץ את הפקודה
gcloud dataproc
    clusters describe CLUSTER_NAME
כדי להציג את המזהה של קבוצת הצמתים. - SIZE: חובה. מספר הצמתים החדש בקבוצת הצמתים.
- TIMEOUT_DURATION: אופציונלי. כשמצמצמים אנכית קבוצת צמתים, אפשר להוסיף
gracefulDecommissionTimeoutלגוף הבקשה כדי למנוע סיום מיידי של מנהלי התקנים של משימות. המלצה: הגדירו משך זמן קצוב ששווה לפחות למשך הזמן של המשימה הארוכה ביותר שפועלת בקבוצת הצמתים (אין תמיכה בשחזור של מנהלי התקנים שנכשלו).דוגמה:
{ "size": SIZE,
  "gracefulDecommissionTimeout": "TIMEOUT_DURATION"
}
ה-method של ה-HTTP וכתובת ה-URL:
POST https://dataproc.googleapis.com/v1/projects/PROJECT_ID/regions/REGION/clusters/CLUSTER_NAME/nodeGroups/Node_GROUP_ID:resize
תוכן בקשת JSON:
{
  "size": SIZE,
}
כדי לשלוח את הבקשה צריך להרחיב אחת מהאפשרויות הבאות:
אתם אמורים לקבל תגובת JSON שדומה לזו:
{
  "name": "projects/PROJECT_ID/regions/REGION/operations/OPERATION_ID",
  "metadata": {
    "@type": "type.googleapis.com/google.cloud.dataproc.v1.NodeGroupOperationMetadata",
    "nodeGroupId": "NODE_GROUP_ID",
    "clusterUuid": "CLUSTER_UUID",
    "status": {
      "state": "PENDING",
      "innerState": "PENDING",
      "stateStartTime": "2022-12-01T23:34:53.064308Z"
    },
    "operationType": "RESIZE",
    "description": "Scale "up or "down" a GCE node pool to SIZE nodes."
  }
}
מחיקת אשכול של קבוצת צומתי דרייבר
כשמוחקים אשכול של Managed Service for Apache Spark, קבוצות הצמתים שמשויכות לאשכול נמחקות.
שליחת משימה
אתם יכולים להשתמש בפקודה gcloud dataproc jobs submit או ב-Managed Service for Apache Spark API כדי לשלוח משימה לאשכול עם קבוצת צומתי דרייבר.
gcloud
gcloud dataproc jobs submit JOB_COMMAND \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --driver-required-memory-mb=DRIVER_MEMORY \
    --driver-required-vcores=DRIVER_VCORES \
    DATAPROC_FLAGS \
    -- JOB_ARGS
דגלים נדרשים:
- JOB_COMMAND: מציינים את פקודת המשימה.
- CLUSTER_NAME: שם האשכול.
- DRIVER_MEMORY: כמות הזיכרון של מנהלי ההתקנים של המשימה ב-MB שנדרשת כדי להריץ משימה (ראו אמצעי הבקרה של הזיכרון ב-YARN).
- DRIVER_VCORES: מספר המעבדים הווירטואליים שנדרשים כדי להריץ משימה.
דגלים נוספים:
- DATAPROC_FLAGS: מוסיפים דגלים נוספים של gcloud dataproc jobs submit שקשורים לסוג העבודה.
- JOB_ARGS: מוסיפים ארגומנטים (אחרי
--) כדי להעביר אותם למשימה.
דוגמאות: אתם יכולים להריץ את הדוגמאות הבאות מסשן טרמינל SSH באשכול של קבוצת צומתי דרייבר ב-Managed Service for Apache Spark.
משימת Spark להערכת הערך של
pi:gcloud dataproc jobs submit spark \ --cluster=CLUSTER_NAME \ --region=REGION \ --driver-required-memory-mb=2048 \ --driver-required-vcores=2 \ --class=org.apache.spark.examples.SparkPi \ --jars=file:///usr/lib/spark/examples/jars/spark-examples.jar \ -- 1000
משימה של ספירת מילים ב-Spark:
gcloud dataproc jobs submit spark \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --driver-required-memory-mb=2048 \
    --driver-required-vcores=2 \
    --class=org.apache.spark.examples.JavaWordCount \
    --jars=file:///usr/lib/spark/examples/jars/spark-examples.jar \
    -- 'gs://apache-beam-samples/shakespeare/macbeth.txt'
משימת PySpark להערכת הערך של
pi:gcloud dataproc jobs submit pyspark \ file:///usr/lib/spark/examples/src/main/python/pi.py \ --cluster=CLUSTER_NAME \ --region=REGION \ --driver-required-memory-mb=2048 \ --driver-required-vcores=2 \ -- 1000
משימת MapReduce של TeraGen ב-Hadoop:
gcloud dataproc jobs submit hadoop \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --driver-required-memory-mb=2048 \
    --driver-required-vcores=2 \
    --jar file:///usr/lib/hadoop-mapreduce/hadoop-mapreduce-examples.jar \
    -- teragen 1000 \
    hdfs:///gen1/test
REST
לפני שמשתמשים בנתוני הבקשה, צריך להחליף את הנתונים הבאים:
- PROJECT_ID: חובה. מזהה הפרויקט ב-Google Cloud.
- REGION: חובה. האזור של אשכול Dataproc
- CLUSTER_NAME: חובה. שם האשכול, שחייב להיות ייחודי בפרויקט. השם צריך להתחיל באות קטנה באנגלית, ויכול להכיל עד 51 אותיות קטנות, מספרים ומקפים. הוא לא יכול להסתיים במקף. אפשר להשתמש שוב בשם של אשכול שנמחק.
- DRIVER_MEMORY: חובה. נפח הזיכרון של מנהלי ההתקנים של המשימה ב-MB שנדרש כדי להריץ משימה (ראו פקדי הזיכרון של Yarn).
- DRIVER_VCORES: חובה. מספר המעבדים הווירטואליים שנדרשים כדי להריץ משימה.
pi).
ה-method של ה-HTTP וכתובת ה-URL:
POST https://dataproc.googleapis.com/v1/projects/PROJECT_ID/regions/REGION/jobs:submit
תוכן בקשת JSON:
{
  "job": {
    "placement": {
    "clusterName": "CLUSTER_NAME",
    },
    "driverSchedulingConfig": {
      "memoryMb]": DRIVER_MEMORY,
      "vcores": DRIVER_VCORES
    },
    "sparkJob": {
      "jarFileUris": "file:///usr/lib/spark/examples/jars/spark-examples.jar",
      "args": [
        "10000"
      ],
      "mainClass": "org.apache.spark.examples.SparkPi"
    }
  }
}
כדי לשלוח את הבקשה צריך להרחיב אחת מהאפשרויות הבאות:
אתם אמורים לקבל תגובת JSON שדומה לזו:
{
  "reference": {
    "projectId": "PROJECT_ID",
    "jobId": "job-id"
  },
  "placement": {
    "clusterName": "CLUSTER_NAME",
    "clusterUuid": "cluster-Uuid"
  },
  "sparkJob": {
    "mainClass": "org.apache.spark.examples.SparkPi",
    "args": [
      "1000"
    ],
    "jarFileUris": [
      "file:///usr/lib/spark/examples/jars/spark-examples.jar"
    ]
  },
  "status": {
    "state": "PENDING",
    "stateStartTime": "start-time"
  },
  "jobUuid": "job-Uuid"
}
Python
- התקנה של ספריית הלקוח
- הגדרת Application Default Credentials
- מריצים את הקוד
- משימת Spark להערכת הערך של פאי:
- משימת PySpark להדפסת "hello world":
צפייה ביומני המשימות
כדי לראות את סטטוס המשימה ולפתור בעיות שקשורות למשימות, אתם יכולים לראות את יומני מנהל ההתקן באמצעות ה-CLI של gcloud או מסוף Google Cloud .
gcloud
יומני מנהלי ההתקנים של המשימות מועברים לפלט של ה-CLI של gcloud או למסוףGoogle Cloud במהלך ביצוע המשימה. יומני הדרייבר נשמרים בקטגוריית ה-Staging של אשכול Managed Service for Apache Spark ב-Cloud Storage.
מריצים את הפקודה הבאה ב-CLI של gcloud כדי להציג את המיקום של יומני מנהלי ההתקנים ב-Cloud Storage:
gcloud dataproc jobs describe JOB_ID \
    --region=REGION
המיקום של יומני מנהלי ההתקנים ב-Cloud Storage מופיע בתור driverOutputResourceUri בפלט הפקודה, בפורמט הבא:
driverOutputResourceUri: gs://CLUSTER_STAGING_BUCKET/google-cloud-dataproc-metainfo/CLUSTER_UUID/jobs/JOB_ID
המסוף
כדי לראות את יומני האשכולות של קבוצת הצמתים:
כדי למצוא יומנים, אפשר להשתמש בפורמט השאילתה הבא של Logs Explorer:
resource.type="cloud_dataproc_cluster"
resource.labels.project_id="PROJECT_ID"
resource.labels.cluster_name="CLUSTER_NAME"
log_name="projects/PROJECT_ID/logs/LOG_TYPE>"
- PROJECT_ID: מזהה הפרויקט ב- Google Cloud .
- CLUSTER_NAME: שם האשכול.
- LOG_TYPE:
- יומני משתמשים של Yarn:
yarn-userlogs - יומנים של מנהל המשאבים של Yarn:
hadoop-yarn-resourcemanager - יומני Node Manager של Yarn:
hadoop-yarn-nodemanager
- יומני משתמשים של Yarn:
מעקב אחרי מדדים
מנהלי התקנים של משימות בקבוצת צמתים של Managed Service for Apache Spark פועלים בתור צאצא של dataproc-driverpool-driver-queue במחיצה של dataproc-driverpool.
מדדים של קבוצת צומתי דרייבר
בטבלה הבאה מפורטים המדדים המשויכים לקבוצת צומתי הדרייבר, שנאספים כברירת מחדל לקבוצות של צומתי דרייבר.
| מדד של קבוצת צומתי דרייבר | תיאור |
|---|---|
yarn:ResourceManager:DriverPoolsQueueMetrics:AvailableMB |
נפח הזיכרון הזמין ב-Mebibytes ב-dataproc-driverpool-driver-queue במחיצה dataproc-driverpool.
|
yarn:ResourceManager:DriverPoolsQueueMetrics:PendingContainers |
מספר הקונטיינרים בהמתנה (בתור) ב-dataproc-driverpool-driver-queue במחיצה dataproc-driverpool. |
מדדים של תור משני
בטבלה הבאה מפורטים המדדים של התור הצאצא. כברירת מחדל, המדדים נאספים מקבוצות של צומתי דרייבר, ואפשר להפעיל את האיסוף שלהם בכל אשכול של Managed Service for Apache Spark.
| מדד תור משני | תיאור |
|---|---|
yarn:ResourceManager:ChildQueueMetrics:AvailableMB |
נפח הזיכרון הזמין ב-Mebibytes בתור הזה, במחיצת ברירת המחדל. |
yarn:ResourceManager:ChildQueueMetrics:PendingContainers |
מספר הקונטיינרים בהמתנה (בתור) בתור הזה, במחיצת ברירת המחדל. |
yarn:ResourceManager:ChildQueueMetrics:running_0 |
מספר המשימות עם זמן ריצה בין 0 ל-60 דקות בתור הזה בכל המחיצות. |
yarn:ResourceManager:ChildQueueMetrics:running_60 |
מספר המשימות עם זמן ריצה בין 60 ל-300 דקות בתור הזה בכל המחיצות. |
yarn:ResourceManager:ChildQueueMetrics:running_300 |
מספר המשימות עם זמן ריצה בין 300 ל-1440 דקות בתור הזה בכל המחיצות. |
yarn:ResourceManager:ChildQueueMetrics:running_1440 |
מספר המשימות עם זמן ריצה של יותר מ-1440 דקות בתור הזה בכל המחיצות. |
yarn:ResourceManager:ChildQueueMetrics:AppsSubmitted |
מספר הבקשות שנשלחו לתור הזה בכל המחיצות. |
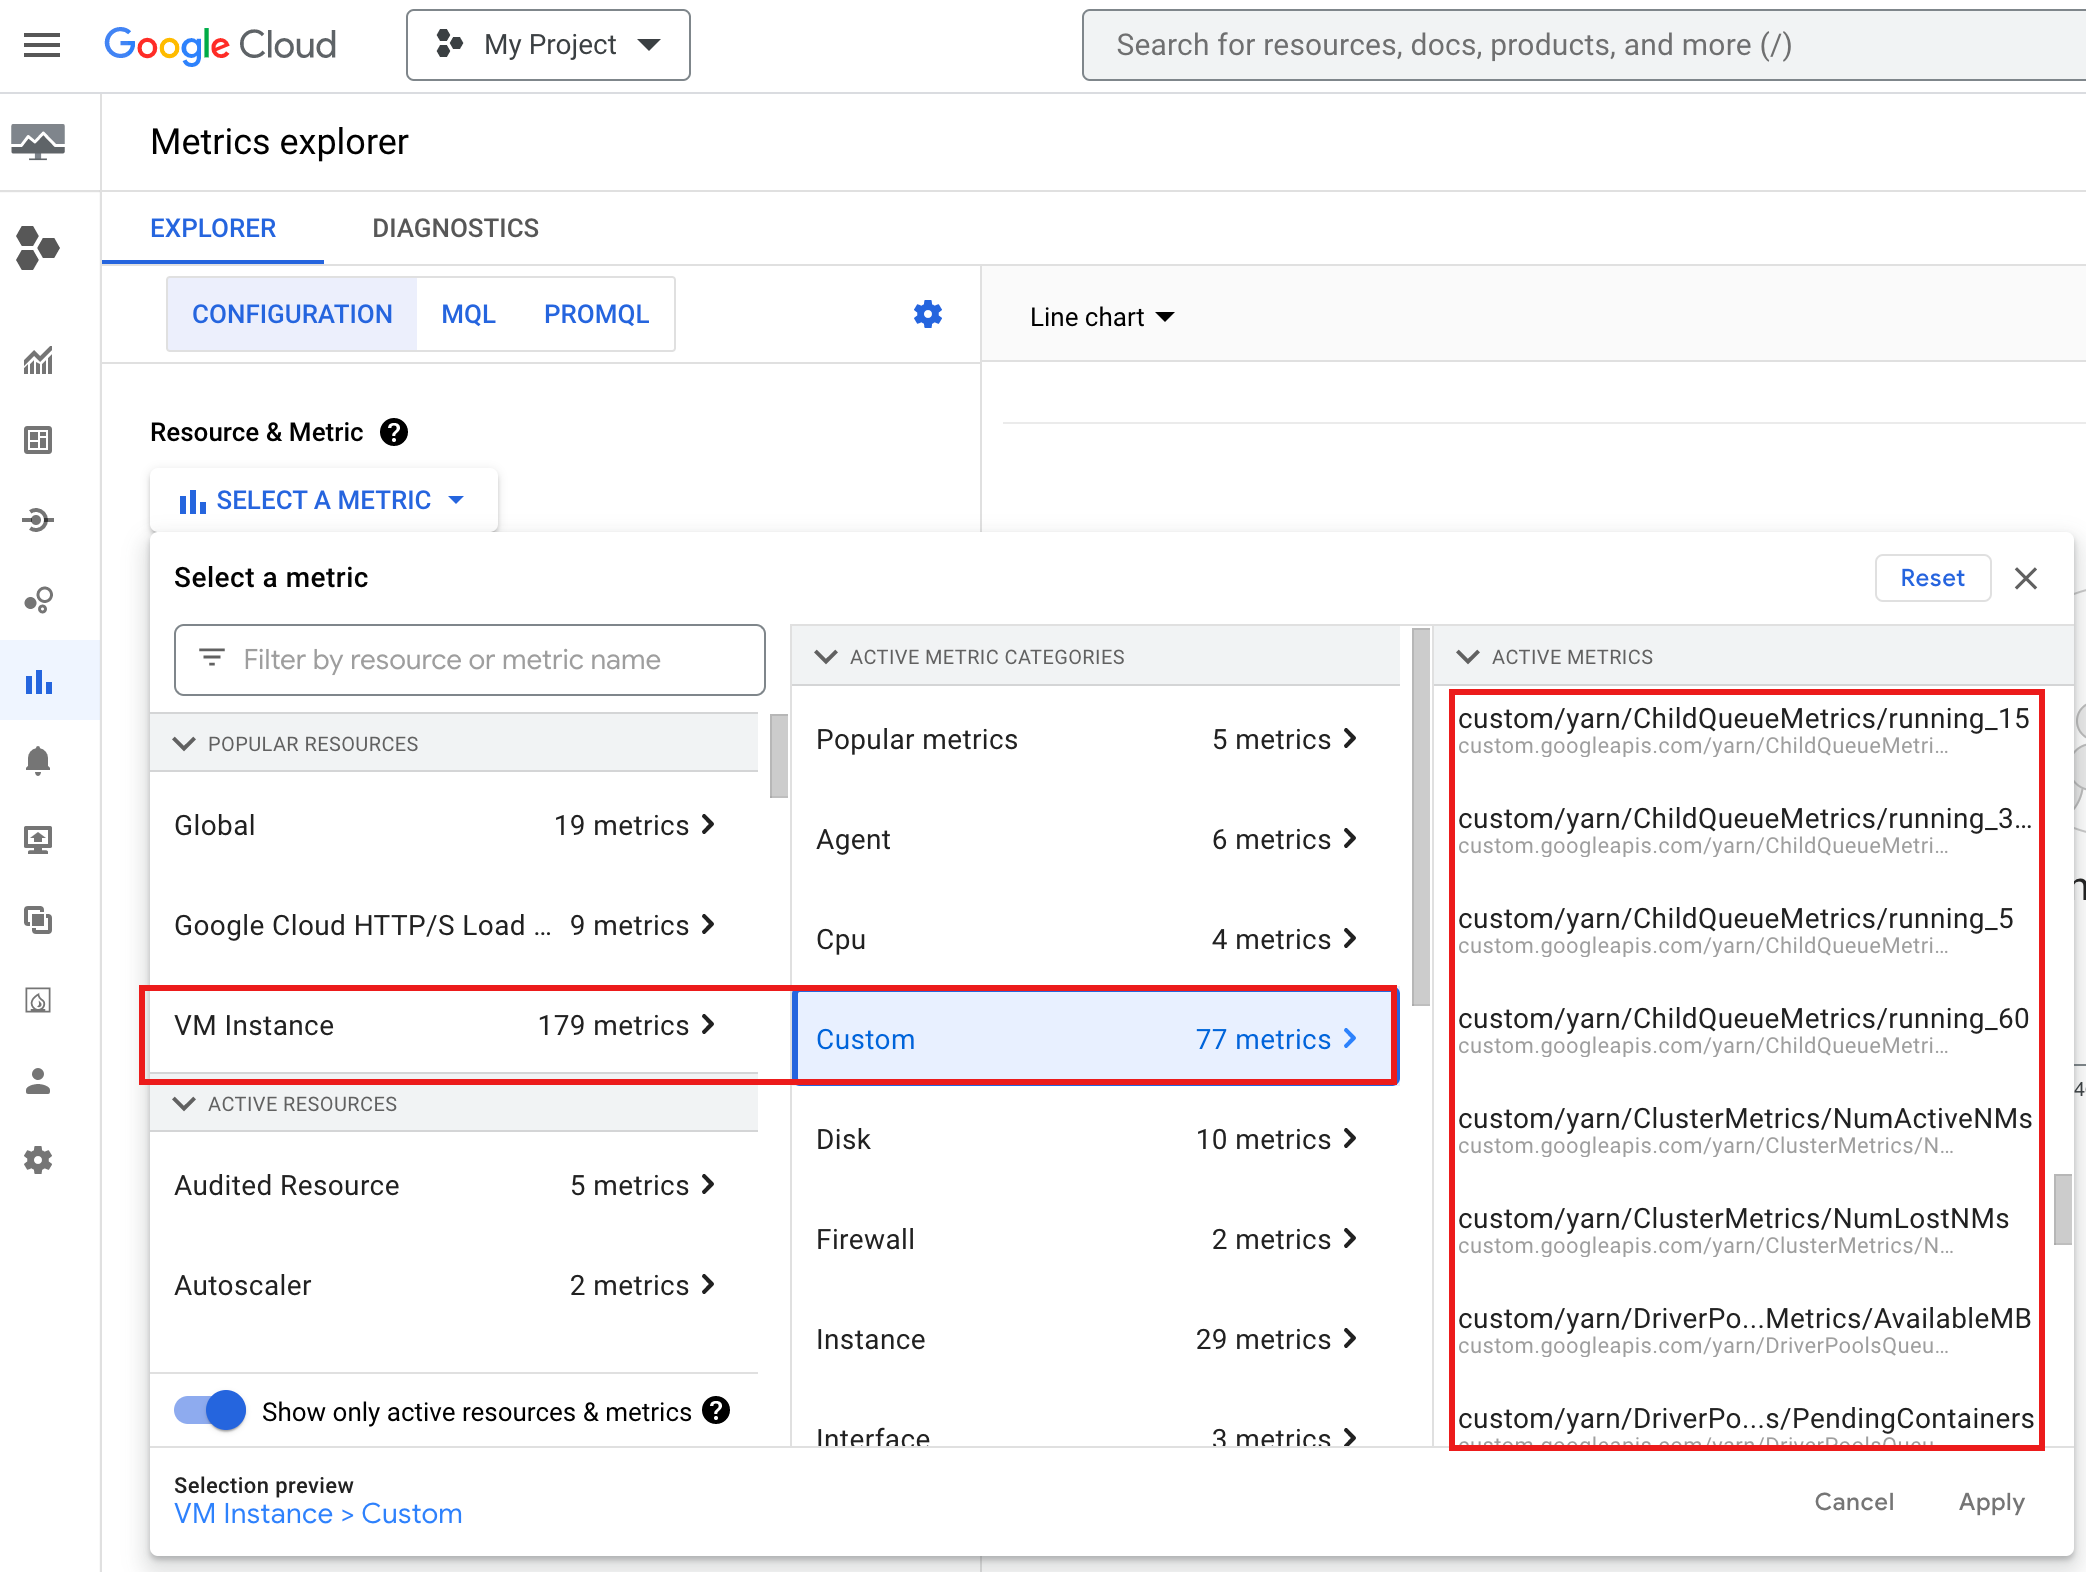
כדי לראות את YARN ChildQueueMetrics ו-DriverPoolsQueueMetrics במסוףGoogle Cloud :
בוחרים את המשאבים VM Instance → Custom ב-Metrics Explorer.
מנהל התקן של משימות ניפוי באגים בקבוצת צמתים
בקטע הזה מפורטים מצבים ושגיאות של קבוצת צומתי הדרייבר, עם המלצות לתיקון המצב או השגיאה.
תנאים
תנאי:
yarn:ResourceManager:DriverPoolsQueueMetrics:AvailableMBקרוב ל-0. ההודעה הזו מציינת שנגמר הזיכרון בתור של מאגרי מנהלי ההתקנים של האשכול.המלצה:: הגדילו את מאגר הנהגים.
תנאי:
yarn:ResourceManager:DriverPoolsQueueMetrics:PendingContainersגדול מ-0. זה יכול להצביע על כך שנגמר הזיכרון בתור של מאגרי מנהלי ההתקנים של האשכול, ו-YARN מוסיף משימות לתור.המלצה:: הגדילו את מאגר הנהגים.
שגיאות
שגיאה:
Cluster <var>CLUSTER_NAME</var> requires driver scheduling config to run
SPARK job because it contains a node pool with role DRIVER.
Positive values are required for all driver scheduling config values.
המלצה: הגדירו את
driver-required-memory-mbו-driver-required-vcoresעם מספרים חיוביים.שגיאה:
Container exited with a non-zero exit code 137.המלצה: להגדיל את
driver-required-memory-mbלשימוש בזיכרון של המשימה.