


ב-Cloud Logging אפשר להציג, לחפש, לסנן ולאחסן בארכיון את יומני המשימות והאשכולות של Managed Service for Apache Spark.
כדי להבין את העלויות, קראו את המאמר התמחור של Google Cloud Observability.
למידע על שמירת יומנים, ראו תקופות שמירה של יומנים.
במאמר החרגות של יומנים מוסבר איך להשבית את כל היומנים או להחריג יומנים מ-Logging.
במאמר סקירה כללית על ניתוב ואחסון מוסבר איך לנתב יומנים מ-Logging אל Cloud Storage, BigQuery או Pub/Sub.
רמות הרישום ביומן של הרכיבים
כשיוצרים אשכול, אפשר להגדיר את רמות הרישום ביומן של Spark, Hadoop, Flink ורכיבים אחרים של Managed Service for Apache Spark באמצעות מאפייני אשכול של log4j שספציפיים לרכיב, כמו hadoop-log4j. רמות הרישום ביומן של רכיבים שמבוססים על אשכולות חלות על תהליכי רקע של שירותים, כמו YARN ResourceManager, ועל משימות שפועלות באשכול.
אם מאפייני log4j לא נתמכים ברכיב מסוים, כמו רכיב Presto, צריך לכתוב פעולת אתחול שעורכת את הקובץ log4j.properties או log4j2.properties של הרכיב.
רמות רישום ביומן של רכיבים ספציפיים למשימה: אפשר גם להגדיר רמות רישום ביומן של רכיבים כששולחים משימה. רמות הרישום ביומן האלה חלות על המשימה, והן מקבלות קדימות על פני רמות הרישום ביומן שהוגדרו כשיצרתם את האשכול. למידע נוסף, ראו מאפייני אשכול לעומת מאפייני משימה.
רמות הרישום ביומן של גרסאות הרכיבים של Spark ו-Hive:
הרכיבים Spark 3.3.X ו-Hive 3.X משתמשים במאפייני log4j2, ואילו גרסאות קודמות של הרכיבים האלה משתמשות במאפייני log4j (ראו Apache Log4j2).
כדי להגדיר רמות רישום ביומן של Spark באשכול, משתמשים בתחילית spark-log4j:.
דוגמה: גרסה 2.0 של Managed Service for Apache Spark עם Spark 3.1 כדי להגדיר את
log4j.logger.org.apache.spark:gcloud dataproc clusters create ... \ --properties spark-log4j:log4j.logger.org.apache.spark=DEBUG
דוגמה: Managed Service for Apache Spark גרסת תמונה 2.1 עם Spark 3.3 כדי להגדיר את
logger.sparkRoot.level:gcloud dataproc clusters create ...\ --properties spark-log4j:logger.sparkRoot.level=debug
רמות הרישום ביומן של מנהל ההתקן של המשימה
ב-Managed Service for Apache Spark, רמת רישום ברירת המחדל ביומן של תוכניות מנהלי ההתקנים של המשימות היא INFO. אפשר לשנות את ההגדרה הזו לחבילה אחת או יותר באמצעות הדגל --driver-log-levels של gcloud dataproc jobs submit.
דוגמה:
מגדירים את רמת הרישום ביומן של DEBUG כששולחים משימת Spark שקוראת קובצי Cloud Storage.
gcloud dataproc jobs submit spark ...\
    --driver-log-levels org.apache.spark=DEBUG,com.google.cloud.hadoop.gcsio=DEBUG
דוגמה:
מגדירים את רמת הרישום ביומן של root ל-WARN, ואת רמת הרישום ביומן של com.example ל-INFO.
gcloud dataproc jobs submit hadoop ...\
    --driver-log-levels root=WARN,com.example=INFO
רמות הרישום ביומן של מנהל הביצוע של Spark
כדי להגדיר את רמות הרישום ביומן של מנהל הביצוע ב-Spark:
מכינים קובץ תצורה של log4j ומעלים אותו ל-Cloud Storage
.מפנים לקובץ התצורה כששולחים את המשימה.
דוגמה:
gcloud dataproc jobs submit spark ...\
    --file gs://my-bucket/path/spark-log4j.properties \
    --properties spark.executor.extraJavaOptions=-Dlog4j.configuration=file:spark-log4j.properties
Spark מוריד את קובץ המאפיינים של Cloud Storage לספריית העבודה המקומית של המשימה, שמופיעה בתור file:<name> ב--Dlog4j.configuration.
יומני משימות של Managed Service for Apache Spark ב-Logging
במאמר פלט ויומנים של משימות ב-Managed Service for Apache Spark מוסבר איך להפעיל ב-Logging יומני מנהלי התקנים של משימות ב-Managed Service for Apache Spark.
גישה ליומני המשימות ב-Logging
אפשר לגשת ליומני המשימות של Managed Service for Apache Spark באמצעות Logs Explorer, הפקודה gcloud logging או Logging API.
המסוף
יומני הקונטיינרים של YARN ומנהלי המשימות של Managed Service for Apache Spark מופיעים במשאב Cloud Managed Service for Apache Spark Job.
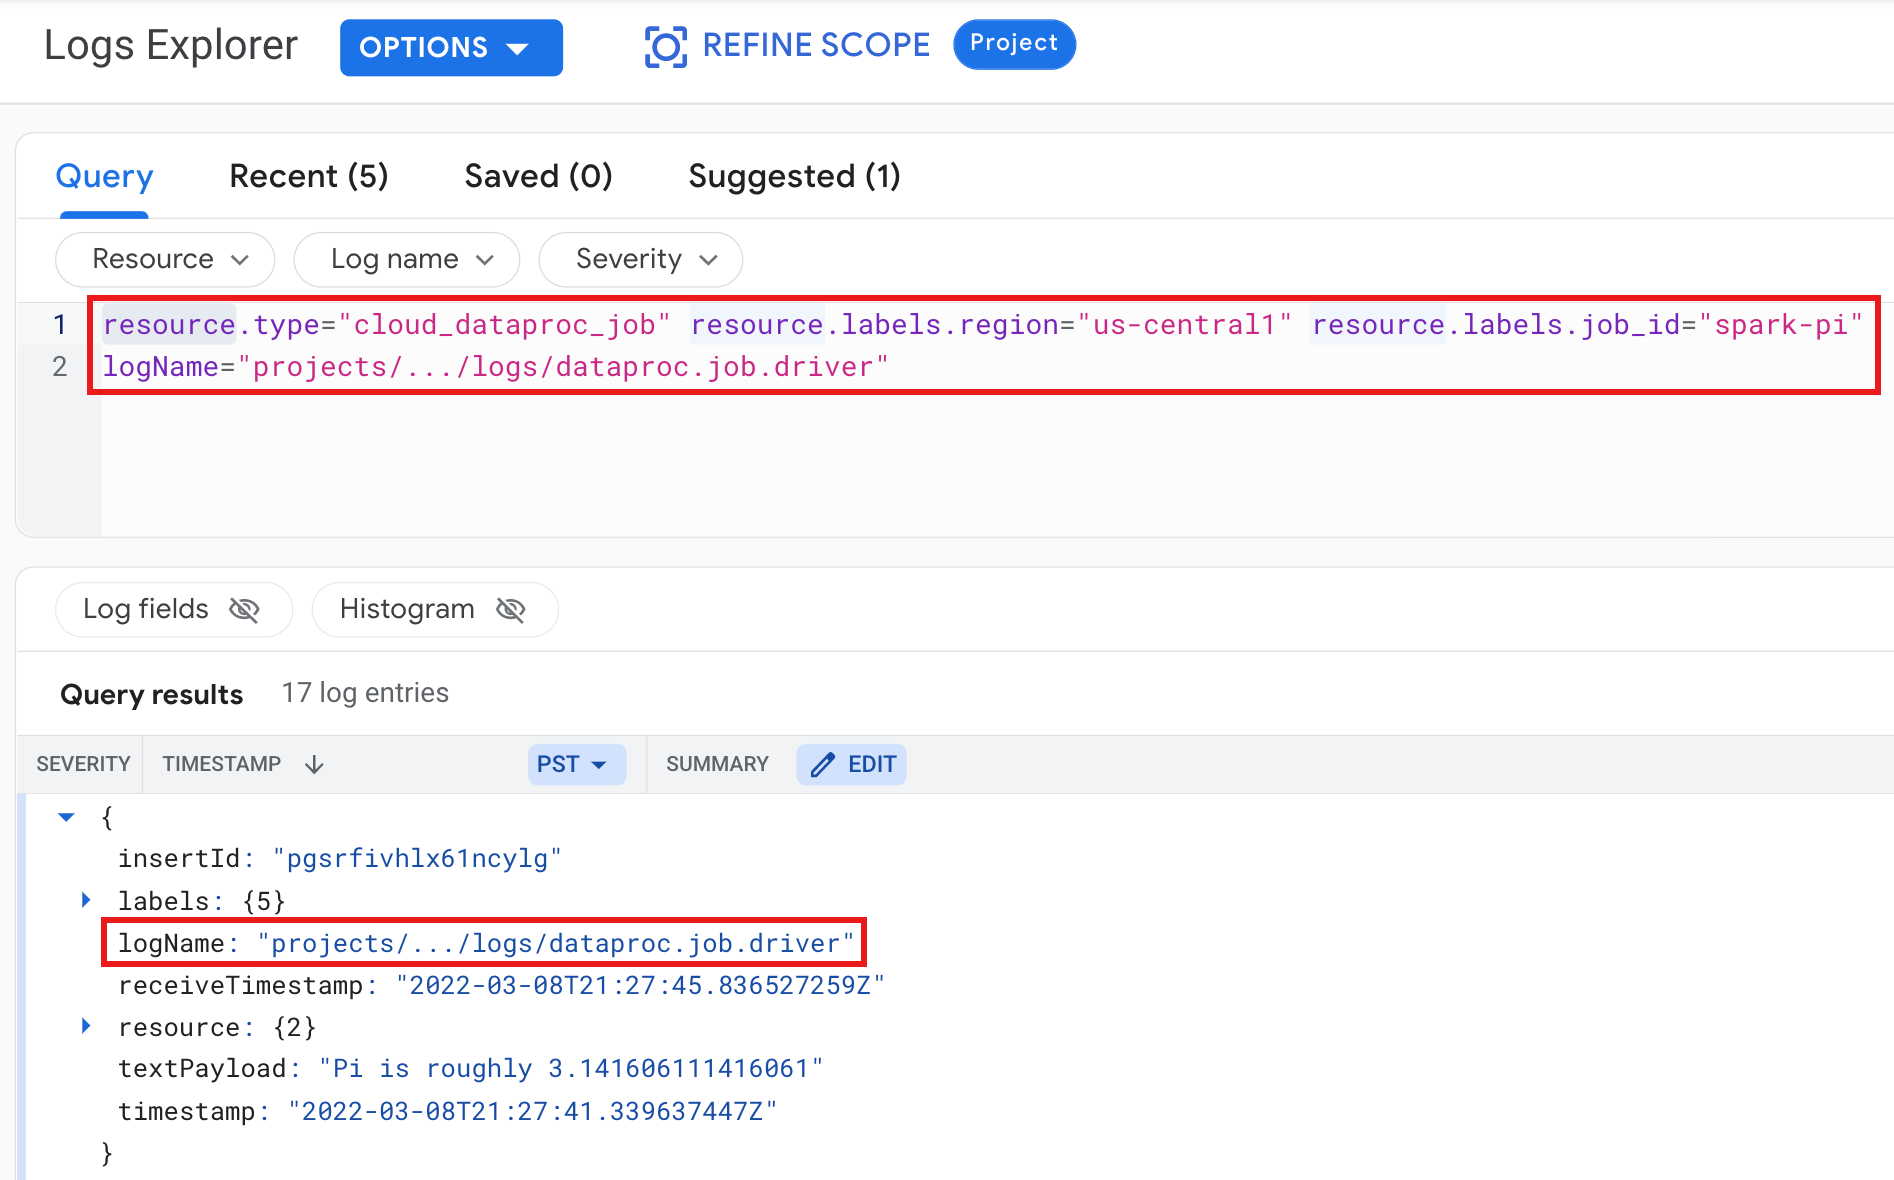
דוגמה: יומן של מנהל התקן של משימה אחרי הרצת שאילתה ב-Logs Explorer עם הבחירות הבאות:
- מקור מידע:
Cloud Dataproc Job - שם היומן:
dataproc.job.driver
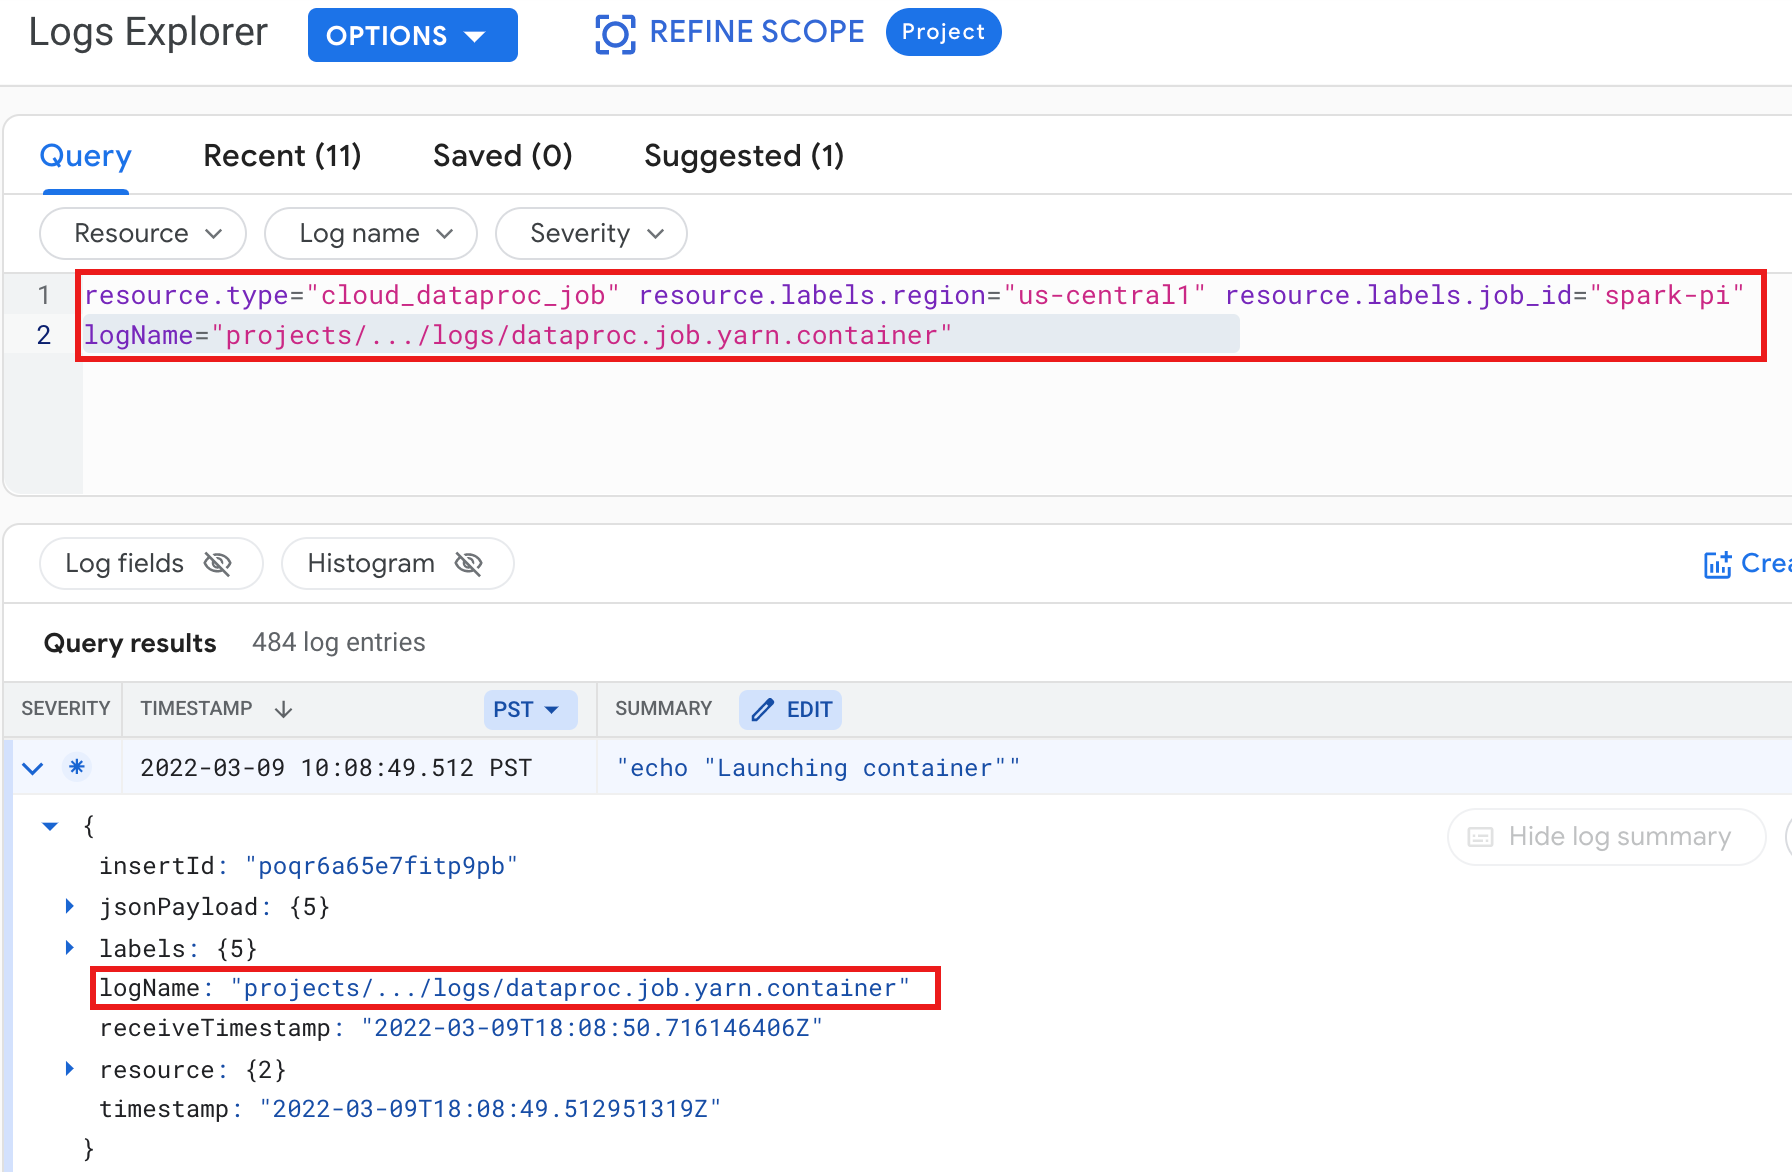
דוגמה: יומן של קונטיינר YARN אחרי הרצת שאילתה ב-Logs Explorer עם הבחירות הבאות:
- מקור מידע:
Cloud Dataproc Job - שם היומן:
dataproc.job.yarn.container
gcloud
אפשר לקרוא את רשומות היומן של המשימה באמצעות הפקודה gcloud logging read. הארגומנטים של המשאב חייבים להיות מוקפים במירכאות ("..."). הפקודה הבאה משתמשת בתוויות של אשכולות כדי לסנן את רשומות היומן שמוחזרות.
gcloud logging read \
    "resource.type=cloud_dataproc_job \
    resource.labels.region=cluster-region \
    resource.labels.job_id=my-job-id"
פלט לדוגמה (חלקי):
jsonPayload:
  class: org.apache.hadoop.hdfs.StateChange
  filename: hadoop-hdfs-namenode-test-dataproc-resize-cluster-20190410-38an-m-0.log
  ,,,
logName: projects/project-id/logs/hadoop-hdfs-namenode
---
jsonPayload:
  class: SecurityLogger.org.apache.hadoop.security.authorize.ServiceAuthorizationManager
  filename: cluster-name-dataproc-resize-cluster-20190410-38an-m-0.log
  ...
logName: projects/google.com:hadoop-cloud-dev/logs/hadoop-hdfs-namenode
API בארכיטקטורת REST
אתם יכולים להשתמש ב-Logging API בארכיטקטורת REST כדי להציג רשימה של רשומות ביומן (ראו entries.list).
יומני אשכולות של Managed Service for Apache Spark ב-Logging
השירות Managed Service for Apache Spark מייצא ל-Cloud Logging את היומנים הבאים של אשכולות Apache Hadoop, Spark, Hive, Zookeeper ויומנים אחרים של אשכולות Managed Service for Apache Spark.
| סוג היומן | שם היומן | תיאור | הערות |
|---|---|---|---|
| יומני הדימון הראשי | hadoop-hdfs hadoop-hdfs-namenode hadoop-hdfs-secondarynamenode hadoop-hdfs-zkfc hadoop-yarn-resourcemanager hadoop-yarn-timelineserver hive-metastore hive-server2 hadoop-mapred-historyserver zookeeper |
צומת יומן צומת שם של HDFS צומת שם משני של HDFS בקר יתירות כשל של Zookeeper מנהל משאבים של YARN שרת ציר זמן של YARN מאגר מטא-נתונים של Hive שרת Hive 2 שרת היסטוריית משימות של Mapreduce שרת Zookeeper |
|
| יומני ה-daemon של ה-worker |
hadoop-hdfs-datanode hadoop-yarn-nodemanager |
HDFS datanode YARN nodemanager |
|
| יומני מערכת |
thought
autoscaler google.dataproc.agent google.dataproc.startup |
יומן המידרוג האוטומטי של Managed Service for Apache Spark יומן הפעילות של סוכן Managed Service for Apache Spark יומן הסקריפט לטעינה בזמן ההפעלה של Managed Service for Apache Spark ויומן פעולת האתחול |
|
| יומנים מורחבים (נוספים) |
knox gateway-audit zeppelin ranger-usersync jupyter_notebook jupyter_kernel_gateway spark-history-server |
כל היומנים בספריות המשנה של /var/log/ שתואמים ל:knox (כולל gateway-audit.log) zeppelin ranger-usersync jupyter_notebook jupyter_kernel_gateway spark-history-server |
הגדרת המאפיין
dataproc:dataproc.logging.extended.enabled=false משביתה את האיסוף של יומנים מורחבים באשכול
|
| יומני המערכת של ה-VM |
syslog |
יומני מערכת מהצמתים הראשיים ומהצמתים העובדים של האשכול |
הגדרת המאפיין
dataproc:dataproc.logging.syslog.enabled=false משביתה את האיסוף של יומני המערכת של המכונות הווירטואליות באשכול
|
גישה ליומני אשכולות ב-Cloud Logging
אפשר לגשת ליומני האשכולות של Managed Service for Apache Spark באמצעות Logs Explorer, הפקודה gcloud logging או Logging API.
המסוף
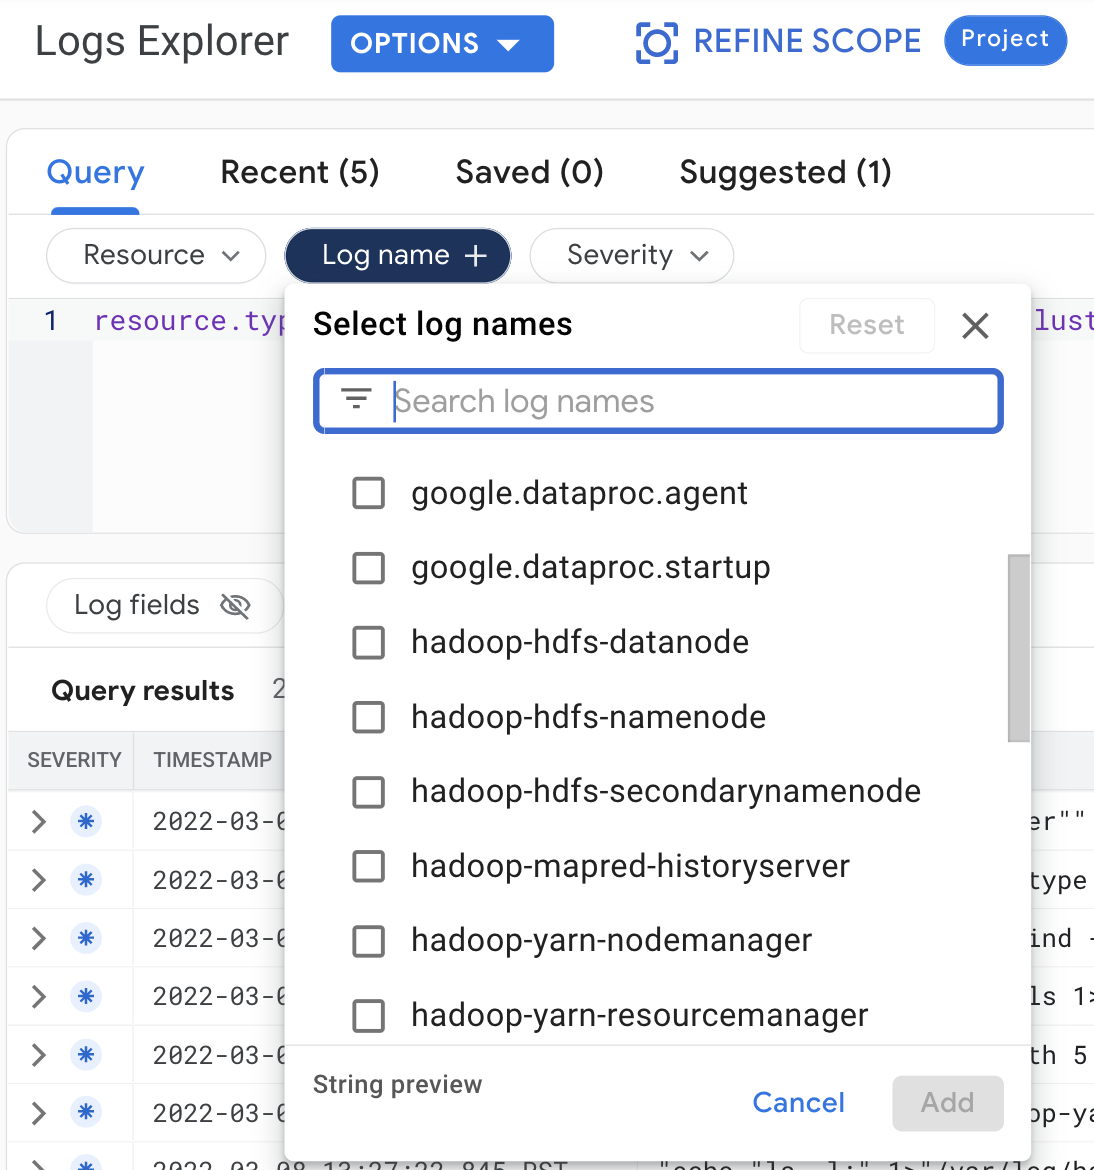
כדי להציג את יומני האשכול ב-Logs Explorer, בוחרים את השאילתות הבאות:
- מקור מידע:
Cloud Dataproc Cluster - שם היומן: log name
gcloud
אפשר לקרוא את רשומות היומן של האשכול באמצעות הפקודה gcloud logging read. הארגומנטים של המשאב חייבים להיות מוקפים במירכאות ("..."). הפקודה הבאה משתמשת בתוויות של אשכולות כדי לסנן את רשומות היומן שמוחזרות.
gcloud logging read <<'EOF'
    "resource.type=cloud_dataproc_cluster
    resource.labels.region=cluster-region
    resource.labels.cluster_name=cluster-name
    resource.labels.cluster_uuid=cluster-uuid"
EOF
פלט לדוגמה (חלקי):
jsonPayload:
  class: org.apache.hadoop.yarn.server.resourcemanager.ResourceTrackerService
  filename: hadoop-yarn-resourcemanager-cluster-name-m.log
  ...
logName: projects/project-id/logs/hadoop-yarn-resourcemanager
---
jsonPayload:
  class: org.apache.hadoop.yarn.server.resourcemanager.ResourceTrackerService
  filename: hadoop-yarn-resourcemanager-component-gateway-cluster-m.log
  ...
logName: projects/project-id/logs/hadoop-yarn-resourcemanager
API בארכיטקטורת REST
אתם יכולים להשתמש ב-Logging API בארכיטקטורת REST כדי להציג רשימה של רשומות ביומן (ראו entries.list).
הרשאות
כדי לכתוב יומנים ב-Logging, לחשבון השירות של Managed Service for Apache Spark VM צריך להיות תפקיד logging.logWriter ב-IAM. התפקיד הזה מוגדר כברירת מחדל בחשבון השירות של Managed Service for Apache Spark. אם משתמשים בחשבון שירות בהתאמה אישית, צריך להקצות את התפקיד הזה לחשבון השירות.
הגנה על היומנים
כברירת מחדל, היומנים ב-Logging מוצפנים במנוחה. אתם יכולים להפעיל מפתחות הצפנה בניהול הלקוח (CMEK) כדי להצפין את היומנים. מידע נוסף על התמיכה ב-CMEK זמין במאמרים ניהול המפתחות שמגינים על הנתונים של נתב היומנים וניהול המפתחות שמגינים על הנתונים באחסון של Logging.