


Membuat lakehouse dengan Spark dan katalog runtime Lakehouse
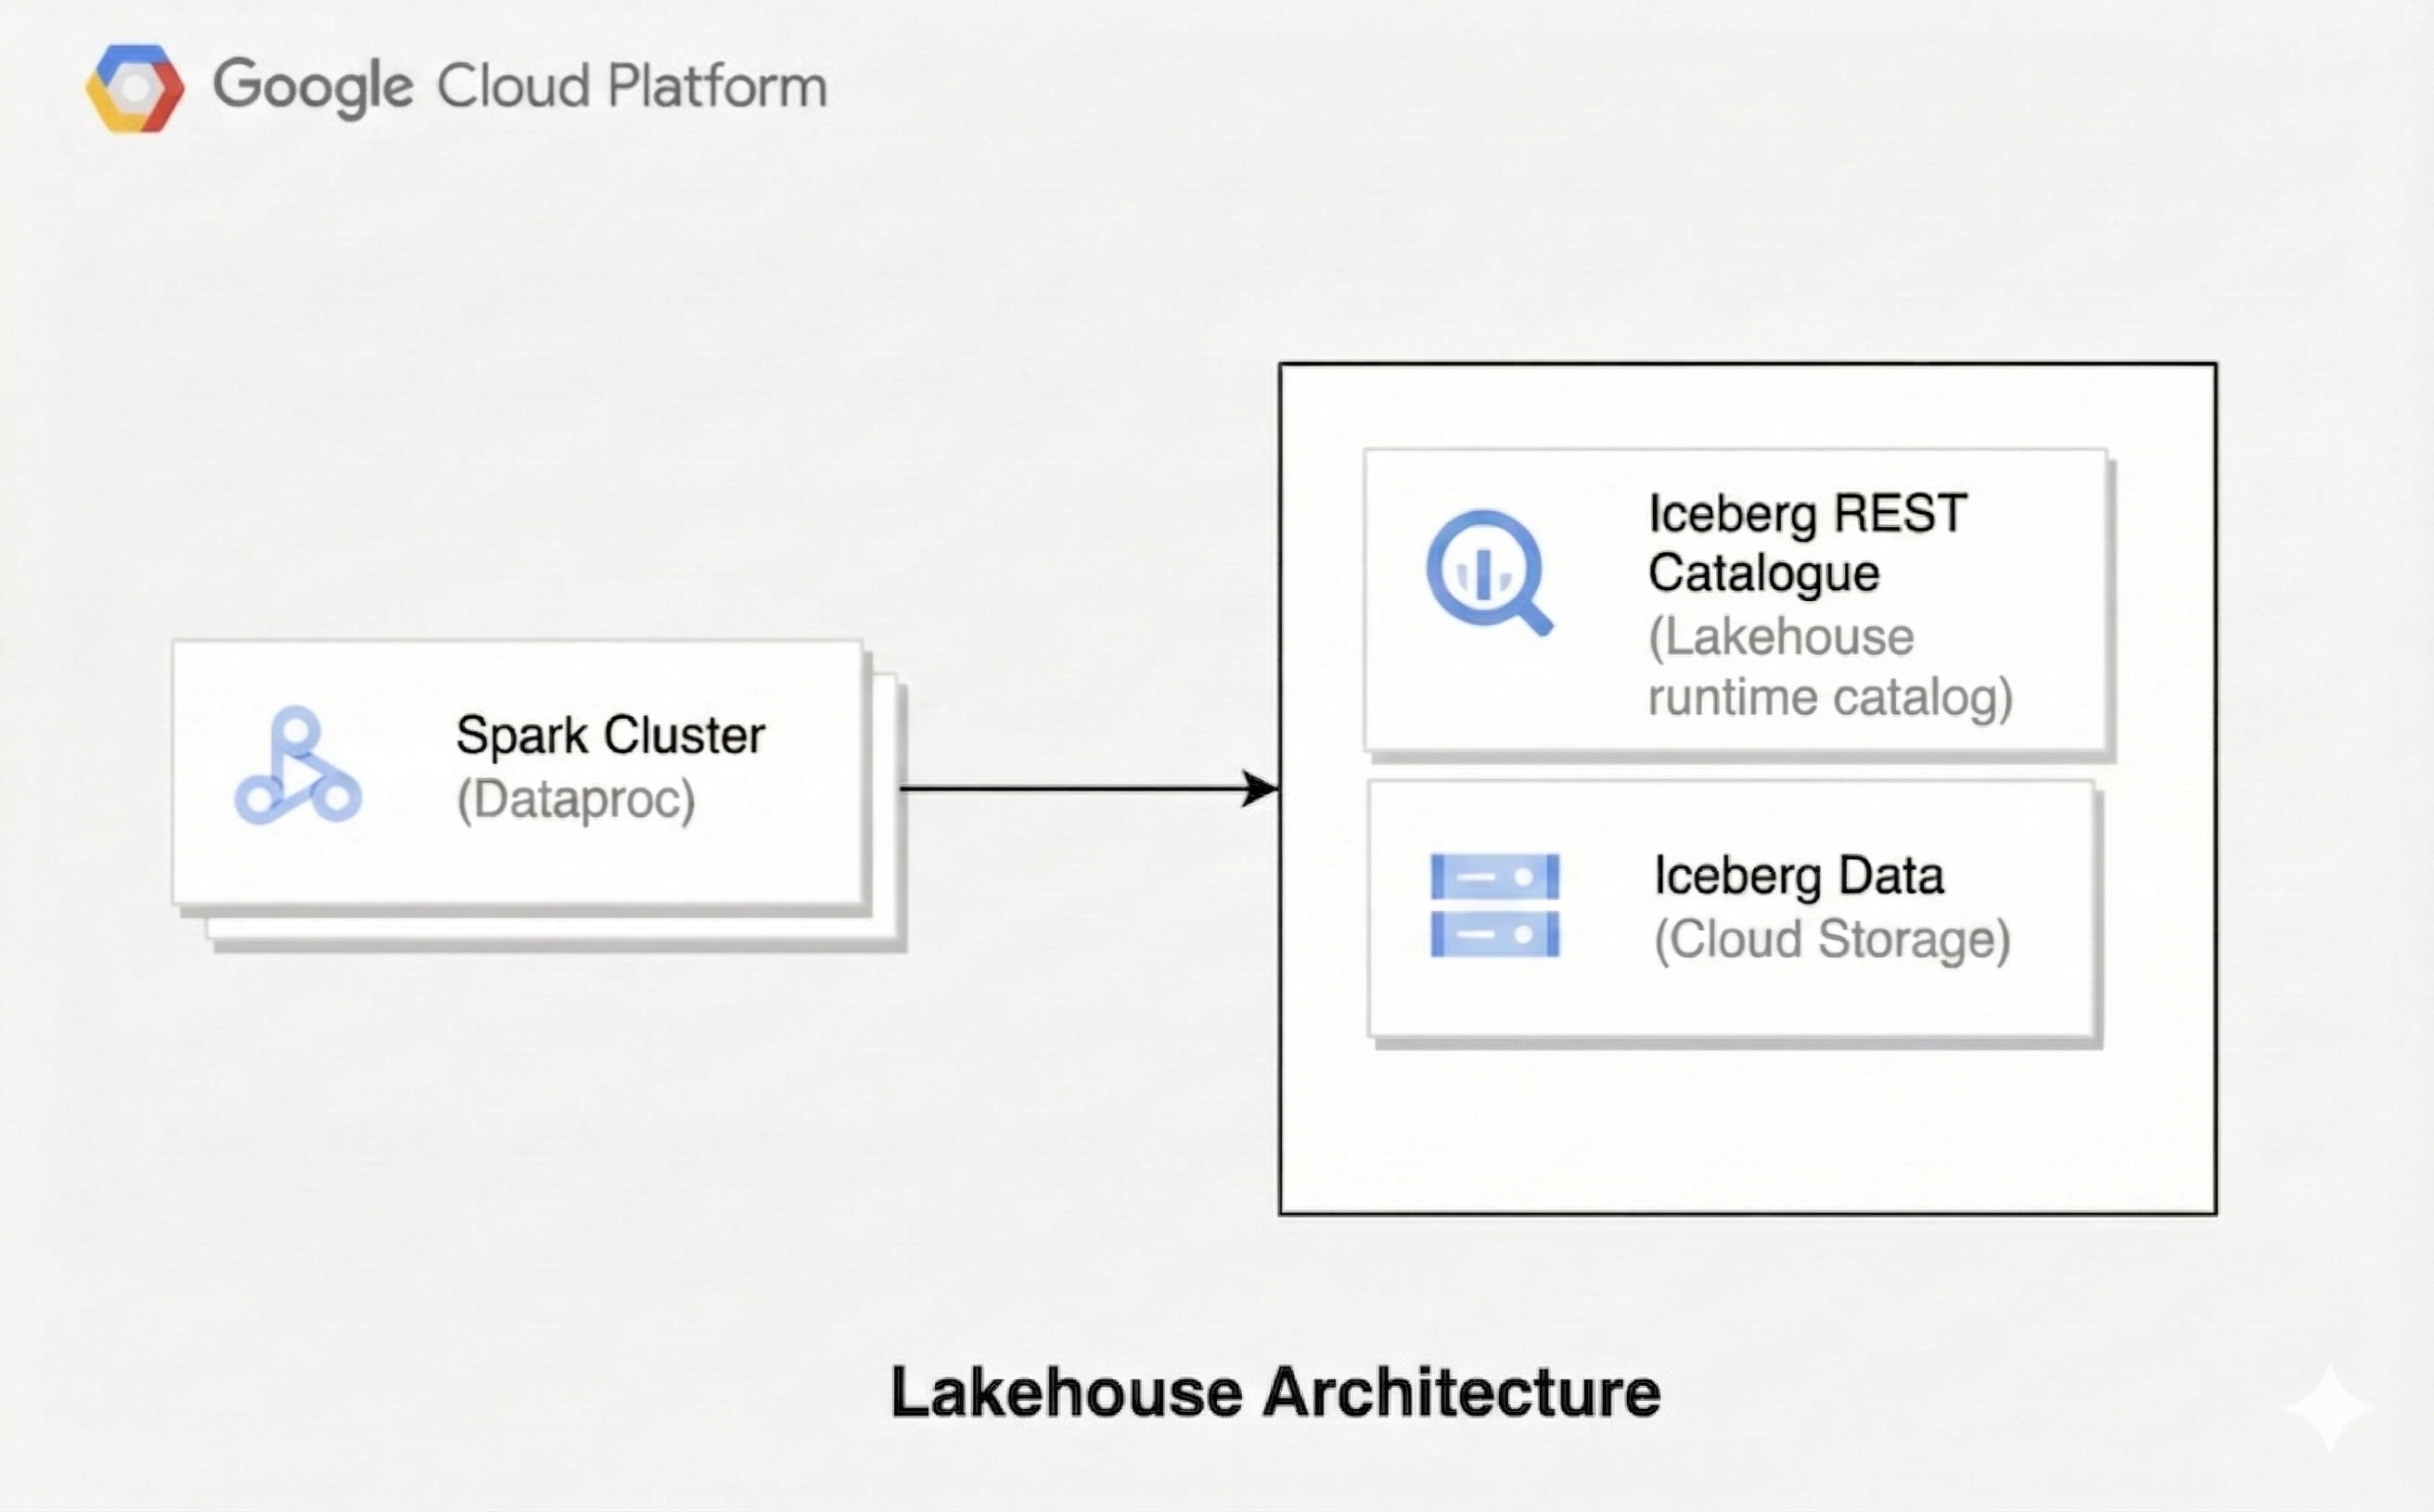
Arsitektur lakehouse menggabungkan fleksibilitas data lake dengan fitur pengelolaan data dari data warehouse. Dokumen ini menunjukkan cara menyiapkan lakehouse di Google Cloud. Anda menggunakan Apache Iceberg sebagai format tabel, Managed Service untuk Apache Spark untuk pemrosesan, dan Katalog REST Iceberg katalog runtime Lakehouse untuk pengelolaan metadata terpadu.
Arsitektur ini menggunakan format tabel terbuka seperti Iceberg untuk menambahkan kemampuan data warehouse, seperti transaksi dan evolusi skema, ke data di Cloud Storage. Pendekatan ini menciptakan satu sumber tepercaya untuk data Anda yang dapat diakses oleh berbagai mesin telusur.
Dokumen ini membahas katalog yang Anda buat di katalog runtime Lakehouse. Untuk membuat kueri tabel Iceberg yang dikelola oleh AWS Glue Data Catalog, Databricks Unity Catalog, atau Snowflake Horizon Catalog melalui katalog gabungan katalog runtime Lakehouse, lihat Membuat kueri katalog gabungan dengan Spark.
Sebelum memulai
- Login ke akun Google Cloud Anda. Jika Anda baru menggunakan Google Cloud, buat akun untuk mengevaluasi performa produk kami dalam skenario dunia nyata. Pelanggan baru juga mendapatkan kredit gratis senilai $300 untuk menjalankan, menguji, dan men-deploy workload.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that you have the permissions required to complete this guide.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Dataproc, BigLake, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that you have the permissions required to complete this guide.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Dataproc, BigLake, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.- Buat bucket Cloud Storage untuk menyimpan data Iceberg.
- Buat katalog di katalog runtime Lakehouse yang mengarah ke bucket Anda. Katalog multi-bucket direkomendasikan.
Peran yang diperlukan
Peran Identity and Access Management (IAM) tertentu diperlukan untuk menjalankan contoh di halaman ini. Bergantung pada kebijakan organisasi, peran ini mungkin sudah diberikan. Untuk memeriksa pemberian peran, lihat Apakah Anda perlu memberikan peran?.
Untuk mengetahui informasi selengkapnya tentang pemberian peran, lihat Mengelola akses ke project,folder, dan organisasi.
Peran yang Anda butuhkan bergantung pada cara workload Anda berjalan.
Cluster Managed Service untuk Apache Spark dan runtime serverless Managed Service untuk Apache Spark 2.3 dan yang lebih lama menjalankan workload sebagai akun layanan. Runtime serverless Managed Service untuk Apache Spark 3.0 dan yang lebih baru menjalankan workload dengan kredensial pengguna akhir (EUC) Anda secara default, sehingga Anda memberikan peran akses data ke akun pengguna, bukan akun layanan. Jika Anda menentukan akun layanan kustom untuk runtime 3.0 atau yang lebih baru, workload akan berjalan dengan kredensial akun layanan. Untuk mengetahui informasi selengkapnya, lihat
Peran deployment serverless.
Peran pengguna
Untuk mendapatkan izin yang Anda perlukan untuk membuat cluster Managed Service untuk Apache Spark, mengirimkan workload batch, atau membuat sesi interaktif, minta administrator untuk memberi Anda peran IAM berikut:
-
Gunakan cluster atau runtime serverless 2.3 atau yang lebih lama:
- Dataproc Editor (
roles/dataproc.editor) di project - Pengguna Akun Layanan (
roles/iam.serviceAccountUser) pada akun layanan default Compute Engine atau akun layanan kustom
- Dataproc Editor (
-
Menggunakan runtime serverless 3.0 atau yang lebih baru:
Dataproc Serverless Editor (
roles/dataproc.serverlessEditor) pada project -
Gunakan kredensial akun layanan pada runtime serverless 3.0 atau yang lebih baru:
Pengguna Akun Layanan (
roles/iam.serviceAccountUser) di akun layanan kustom
Jika Anda menggunakan runtime serverless Managed Service untuk Apache Spark 3.0 atau yang lebih baru dengan kredensial pengguna akhir (default), Anda juga memerlukan peran akses data berikut:
Untuk mendapatkan izin yang Anda perlukan untuk membaca dan menulis tabel di katalog dengan kredensial pengguna akhir, minta administrator untuk memberi Anda peran IAM berikut:
-
Membaca dan menulis data tabel dalam mode penyediaan kredensial:
BigLake Editor (
roles/biglake.editor) di project yang berisi katalog -
Mengelola resource katalog dan menulis data tabel dalam mode penjualan non-kredensial:
- BigLake Editor (
roles/biglake.editor) pada project yang berisi katalog - Storage Object User (
roles/storage.objectUser) di semua bucket Cloud Storage yang terkait dengan katalog
- BigLake Editor (
Peran akun layanan
Berikan peran berikut ke akun layanan yang menjalankan workload Anda.
Runtime serverless Managed Service untuk Apache Spark 3.0 dan yang lebih baru memerlukan peran ini hanya jika workload dijalankan dengan kredensial akun layanan.
Untuk memastikan bahwa akun layanan default Compute Engine atau akun layanan kustom memiliki izin yang diperlukan untuk menjalankan tugas Managed Service untuk Apache Spark serta membaca dan menulis tabel di katalog Anda, minta administrator untuk memberikan peran IAM berikut ke akun layanan default Compute Engine atau akun layanan kustom:
-
Menjalankan tugas Managed Service untuk Apache Spark di cluster atau runtime serverless 2.3 atau yang lebih lama:
Dataproc Worker (
roles/dataproc.worker) di project -
Menjalankan tugas Managed Service untuk Apache Spark di runtime serverless 3.0 atau yang lebih baru:
- Node Dataproc Serverless (
roles/dataproc.serverlessNode) di project - Dataproc Resource Manager Node Service Agent (
roles/dataprocrm.nodeServiceAgent) di project
- Node Dataproc Serverless (
-
Membaca dan menulis data tabel dalam mode penyediaan kredensial:
BigLake Editor (
roles/biglake.editor) pada project yang berisi katalog -
Mengelola resource katalog dan menulis data tabel dalam mode non-credential vending:
- BigLake Editor (
roles/biglake.editor) di project yang berisi katalog - Storage Object User (
roles/storage.objectUser) di semua bucket Cloud Storage yang terkait dengan katalog
- BigLake Editor (
Mengonfigurasi Managed Service untuk Apache Spark dan membuat sesi Spark
Konfigurasikan cluster Managed Service untuk Apache Spark, workload batch serverless Managed Service untuk Apache Spark, atau sesi interaktif serverless Managed Service untuk Apache Spark agar menggunakan Katalog REST Iceberg katalog runtime Lakehouse. Ketiganya mendukung properti konfigurasi yang disederhanakan dataproc.lakehouse.catalog.CATALOG_NAME (direkomendasikan), yang memungkinkan Managed Service untuk Apache Spark membaca definisi katalog dan membuat properti Spark Katalog REST Iceberg. Hanya bentuk cluster yang menggunakan awalan dataproc:.
Versi image dan runtime yang didukung:
Konfigurasi yang disederhanakan dan konfigurasi manual menggunakan otorisasi Google untuk Iceberg (GoogleAuthManager), yang memerlukan salah satu versi berikut:
- Cluster Managed Service untuk Apache Spark: Versi image
2.22.2.65dan yang lebih baru, atau versi image2.32.3.11dan yang lebih baru. - Workload batch dan sesi interaktif serverless Managed Service untuk Apache Spark:
2.2runtime2.2.60dan yang lebih baru,2.3runtime2.3.10dan yang lebih baru, atau3.0runtime.
Untuk workload batch serverless dan sesi interaktif, peran yang diperlukan
bergantung pada versi runtime. Runtime 3.0 dan yang lebih baru menggunakan kredensial pengguna akhir secara default. Untuk mengetahui detailnya, lihat Peran yang diperlukan.
Cluster
Buat cluster Managed Service untuk Apache Spark dengan komponen opsional Iceberg dan Jupyter menggunakan properti konfigurasi yang disederhanakan (direkomendasikan), atau dengan menentukan properti katalog secara manual di notebook Anda.
Konfigurasi yang disederhanakan menggunakan properti (direkomendasikan)
Buat cluster dengan properti katalog:
gcloud dataproc clusters create CLUSTER_NAME \
  --project=PROJECT_ID \
  --region=REGION \
  --image-version=IMAGE_VERSION \
  --optional-components=ICEBERG,JUPYTER \
  --enable-component-gateway \
  --properties='dataproc:dataproc.lineage.enabled=true,dataproc:dataproc.lakehouse.catalog.CATALOG_NAME=projects/PROJECT_ID/catalogs/CATALOG_ID,spark:spark.sql.defaultCatalog=CATALOG_NAME'
Ganti kode berikut:
CLUSTER_NAME: nama untuk cluster Anda.PROJECT_ID: Project ID Google Cloud Anda.REGION: region Google Cloud untuk cluster, misalnya,us-central1.IMAGE_VERSION: versi image Managed Service untuk Apache Spark—misalnya,2.3-debian12. Lihat Versi image dan runtime yang didukung.CATALOG_NAME: nama untuk katalog Spark lokal, misalnya,iceberg_catalog. Bucket ini bisa sama denganCATALOG_ID.CATALOG_ID: ID katalog yang Anda buat di Sebelum memulai.
Properti dataproc:dataproc.lineage.enabled=true tidak diperlukan agar Katalog REST Iceberg katalog runtime Lakehouse berfungsi dengan benar. Label ini ditambahkan untuk pelacakan silsilah dalam
contoh silsilah data.
Hubungkan ke cluster menggunakan notebook Jupyter (baik notebook Vertex AI Workbench maupun notebook yang diluncurkan di cluster), dan buat SparkSession tanpa menentukan konfigurasi katalog:
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("APP_NAME").getOrCreate()
Ganti APP_NAME dengan nama aplikasi Spark Anda.
Konfigurasi manual
Jika Anda tidak menggunakan properti konfigurasi yang disederhanakan, buat cluster
seperti yang dijelaskan sebelumnya tanpa dataproc:dataproc.lakehouse.catalog.
di flag --properties, hubungkan ke notebook Jupyter, dan
konfigurasi SparkSession secara manual, sebagai berikut:
import pyspark
from pyspark.context import SparkContext
from pyspark.sql import SparkSession

catalog_name = "CATALOG_NAME"

spark = SparkSession.builder.appName("APP_NAME") \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
Ganti kode berikut:
CATALOG_NAME: nama untuk katalog Spark lokal, misalnya,iceberg_catalog.APP_NAME: nama aplikasi Spark Anda.WAREHOUSE_PATH: jalur ke warehouse Anda. Untuk katalog multi-bucket (direkomendasikan), gunakanbl://projects/PROJECT_ID/catalogs/CATALOG_ID. Untuk katalog bucket tunggal, gunakangs://CLOUD_STORAGE_BUCKET_NAME.PROJECT_ID: project ID Google Cloud Anda.
Mengonfigurasi dengan penyediaan kredensial
Untuk menggunakan penjualan kredensial, Anda harus menggunakan
katalog dalam mode penjualan kredensial
dan menambahkan header X-Iceberg-Access-Delegation ke
permintaan katalog REST Iceberg dengan nilai
vended-credentials dengan menambahkan baris berikut ke
builder SparkSession:
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials')
Contoh berikut mengonfigurasi SparkSession dengan
penjualan kredensial:
from pyspark.sql import SparkSession

catalog_name = "CATALOG_NAME"

spark = SparkSession.builder.appName("APP_NAME") \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
Konfigurasi yang disederhanakan menambahkan header ini saat katalog menggunakan
mode penyediaan kredensial. Untuk mengetahui informasi selengkapnya, lihat bagian
Header di RESTCatalog
dalam dokumentasi Iceberg.
Serverless
Kirim workload batch PySpark ke Managed Service untuk Apache Spark serverless menggunakan properti konfigurasi yang disederhanakan (direkomendasikan), atau dengan menentukan properti katalog secara manual.
Konfigurasi yang disederhanakan menggunakan properti (direkomendasikan)
Teruskan properti dataproc.lakehouse.catalog.CATALOG_NAME (tanpa awalan dataproc:) saat Anda mengirimkan beban kerja batch:
gcloud dataproc batches submit pyspark PYSPARK_FILE \
  --project=PROJECT_ID \
  --region=REGION \
  --version=RUNTIME_VERSION \
  --properties="dataproc.lakehouse.catalog.CATALOG_NAME=projects/PROJECT_ID/catalogs/CATALOG_ID,spark.sql.defaultCatalog=CATALOG_NAME"
Ganti kode berikut:
PYSPARK_FILE: jalur Cloud Storagegs://ke file aplikasi PySpark Anda.PROJECT_ID:Google Cloud Project ID Anda.REGION: region untuk workload batch Anda.RUNTIME_VERSION: versi runtime serverless Managed Service untuk Apache Spark, misalnya,3.0. Peran yang diperlukan bergantung pada versi runtime (lihat Versi image dan runtime yang didukung).CATALOG_NAME: nama untuk katalog Spark lokal, misalnya,iceberg_catalog. Nilainya bisa sama denganCATALOG_ID.CATALOG_ID: ID katalog yang Anda buat di Sebelum memulai.
Dalam file aplikasi PySpark, buat SparkSession tanpa
menentukan konfigurasi katalog:
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("APP_NAME").getOrCreate()
Konfigurasi manual
Jika Anda tidak menggunakan properti konfigurasi yang disederhanakan, tentukan properti katalog dalam tanda --properties saat Anda mengirimkan beban kerja batch:
gcloud dataproc batches submit pyspark PYSPARK_FILE \
  --project=PROJECT_ID \
  --region=REGION \
  --version=RUNTIME_VERSION \
  --properties="\
spark.sql.defaultCatalog=CATALOG_NAME,\
spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,\
spark.sql.catalog.CATALOG_NAME.type=rest,\
spark.sql.catalog.CATALOG_NAME.uri=https://biglake.googleapis.com/iceberg/v1/restcatalog,\
spark.sql.catalog.CATALOG_NAME.warehouse=WAREHOUSE_PATH,\
spark.sql.catalog.CATALOG_NAME.header.x-goog-user-project=PROJECT_ID,\
spark.sql.catalog.CATALOG_NAME.rest.auth.type=org.apache.iceberg.gcp.auth.GoogleAuthManager,\
spark.sql.catalog.CATALOG_NAME.io-impl=org.apache.iceberg.gcp.gcs.GCSFileIO,\
spark.sql.extensions=org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions"
Ganti WAREHOUSE_PATH dengan jalur ke warehouse Anda. Untuk katalog multi-bucket (direkomendasikan), gunakan
bl://projects/PROJECT_ID/catalogs/CATALOG_ID.
Untuk katalog bucket tunggal, gunakan
gs://CLOUD_STORAGE_BUCKET_NAME.
Mengonfigurasi dengan penyediaan kredensial
Untuk menggunakan penjualan kredensial, Anda harus menggunakan
katalog dalam mode penjualan kredensial
dan menambahkan header X-Iceberg-Access-Delegation ke
permintaan katalog REST Iceberg dengan nilai
vended-credentials dengan menambahkan properti berikut ke
flag --properties:
spark.sql.catalog.CATALOG_NAME.header.X-Iceberg-Access-Delegation=vended-credentialsContoh berikut mengirimkan workload batch dengan penyediaan kredensial:
gcloud dataproc batches submit pyspark PYSPARK_FILE \
  --project=PROJECT_ID \
  --region=REGION \
  --version=RUNTIME_VERSION \
  --properties="\
spark.sql.defaultCatalog=CATALOG_NAME,\
spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,\
spark.sql.catalog.CATALOG_NAME.type=rest,\
spark.sql.catalog.CATALOG_NAME.uri=https://biglake.googleapis.com/iceberg/v1/restcatalog,\
spark.sql.catalog.CATALOG_NAME.warehouse=WAREHOUSE_PATH,\
spark.sql.catalog.CATALOG_NAME.header.x-goog-user-project=PROJECT_ID,\
spark.sql.catalog.CATALOG_NAME.rest.auth.type=org.apache.iceberg.gcp.auth.GoogleAuthManager,\
spark.sql.catalog.CATALOG_NAME.io-impl=org.apache.iceberg.gcp.gcs.GCSFileIO,\
spark.sql.catalog.CATALOG_NAME.header.X-Iceberg-Access-Delegation=vended-credentials,\
spark.sql.extensions=org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions"
Konfigurasi yang disederhanakan menambahkan header ini saat katalog menggunakan mode penjualan kredensial. Untuk mengetahui informasi selengkapnya, lihat bagian
Header di RESTCatalog
dalam dokumentasi Iceberg.
Serverless
Buat sesi interaktif serverless Managed Service untuk Apache Spark dari notebook dengan API DataprocSparkSession, menggunakan properti konfigurasi yang disederhanakan (direkomendasikan), atau dengan menentukan properti katalog secara manual.
Konfigurasi yang disederhanakan menggunakan properti (direkomendasikan)
Dalam notebook yang telah menginstal paket dataproc-spark-connect, seperti notebook BigQuery Studio atau notebook Vertex AI Workbench, teruskan properti dataproc.lakehouse.catalog.CATALOG_NAME (tanpa awalan dataproc:) saat Anda membuat sesi:
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session

catalog_name = "CATALOG_NAME"

session_config = Session()
session_config.runtime_config.version = 'RUNTIME_VERSION'

spark = DataprocSparkSession.builder.appName("APP_NAME") \
.dataprocSessionConfig(session_config) \
.config(f'dataproc.lakehouse.catalog.{catalog_name}', 'projects/PROJECT_ID/catalogs/CATALOG_ID') \
.config('spark.sql.defaultCatalog', catalog_name) \
.getOrCreate()
Ganti kode berikut:
CATALOG_NAME: nama untuk katalog Spark lokal, misalnya,iceberg_catalog. Nilainya bisa sama denganCATALOG_ID.RUNTIME_VERSION: versi runtime serverless Managed Service untuk Apache Spark, misalnya,3.0. Peran yang diperlukan bergantung pada versi runtime (lihat Versi gambar dan runtime yang didukung).APP_NAME: nama aplikasi Spark Anda.PROJECT_ID: Project ID Google Cloud Anda.CATALOG_ID: ID katalog yang Anda buat di Sebelum memulai.
Anda juga dapat menyetel properti ini dalam template sesi.
Konfigurasi manual
Jika Anda tidak menggunakan properti konfigurasi yang disederhanakan, tentukan properti katalog saat Anda membuat sesi:
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session

catalog_name = "CATALOG_NAME"

session_config = Session()
session_config.runtime_config.version = 'RUNTIME_VERSION'

spark = DataprocSparkSession.builder.appName("APP_NAME") \
.dataprocSessionConfig(session_config) \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
Ganti RUNTIME_VERSION seperti yang dijelaskan dalam contoh konfigurasi yang disederhanakan sebelumnya di tab ini.
Ganti WAREHOUSE_PATH dengan jalur ke warehouse Anda. Untuk katalog multi-bucket (direkomendasikan), gunakan
bl://projects/PROJECT_ID/catalogs/CATALOG_ID.
Untuk katalog bucket tunggal, gunakan
gs://CLOUD_STORAGE_BUCKET_NAME.
Mengonfigurasi dengan penyediaan kredensial
Untuk menggunakan penyediaan kredensial, Anda harus menggunakan
katalog dalam mode penyediaan kredensial
dan menambahkan header X-Iceberg-Access-Delegation ke
permintaan katalog REST Iceberg dengan nilai
vended-credentials dengan menambahkan baris berikut ke
builder sesi:
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials')
Contoh berikut membuat sesi dengan penjualan kredensial:
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session

catalog_name = "CATALOG_NAME"

session_config = Session()
session_config.runtime_config.version = 'RUNTIME_VERSION'

spark = DataprocSparkSession.builder.appName("APP_NAME") \
.dataprocSessionConfig(session_config) \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
Konfigurasi yang disederhanakan menambahkan header ini saat katalog menggunakan
mode penyediaan kredensial. Untuk mengetahui informasi selengkapnya, lihat bagian
Header di RESTCatalog
dalam dokumentasi Iceberg.
Mengelola data dengan Spark SQL
Setelah mengonfigurasi sesi Spark, gunakan Spark SQL untuk menjalankan operasi pengelolaan data.
Menetapkan katalog: Properti dataproc.lakehouse.catalog. mendaftarkan
katalog dengan Spark, tetapi tidak menjadikannya katalog default. Contoh di bagian sebelumnya menetapkan spark.sql.defaultCatalog (spark:spark.sql.defaultCatalog di cluster) sehingga Anda dapat menggunakan nama tabel yang tidak memenuhi syarat. Jika Anda menghapus properti tersebut, tetapkan nama tabel dengan
nama katalog—misalnya,
CATALOG_NAME.NAMESPACE_NAME.base_table.
Membuat namespace. Di katalog runtime Lakehouse, Katalog REST Iceberg, namespace sesuai dengan set data BigQuery.
spark.sql("CREATE NAMESPACE IF NOT EXISTS NAMESPACE_NAME")
spark.sql("USE NAMESPACE_NAME")
Ganti
NAMESPACE_NAMEdengan nama untuk namespace Anda, misalnya,spark_lakehouse.Membuat tabel dasar dalam format Iceberg dan menyisipkan data.
spark.sql("DROP TABLE IF EXISTS base_table PURGE")
spark.sql("CREATE TABLE base_table (id LONG) USING iceberg")
spark.sql("INSERT INTO base_table VALUES 0, 1, 2, 3, 4")
spark.sql("SELECT * FROM base_table").show()
Outputnya mirip dengan hal berikut ini:
   +---+
   | id|
   +---+
   |  0|
   |  1|
   |  2|
   |  3|
   |  4|
   +---+
Membuat tabel lain untuk data baru.
spark.sql("DROP TABLE IF EXISTS newdata PURGE")
spark.sql("CREATE TABLE newdata(id LONG) USING iceberg")
spark.sql("INSERT INTO newdata VALUES 3, 4, 5, 6")
spark.sql("SELECT * FROM newdata").show()
Outputnya mirip dengan hal berikut ini:
   +---+
   | id|
   +---+
   |  3|
   |  4|
   |  5|
   |  6|
   +---+
Gabungkan data baru ke dalam tabel dasar.
spark.sql("""MERGE INTO base_table USING newdata
           ON base_table.id = newdata.id
           WHEN MATCHED THEN
             UPDATE SET base_table.id = newdata.id
           WHEN NOT MATCHED THEN INSERT * """)
spark.sql("SELECT * FROM base_table").show()
Outputnya mirip dengan hal berikut ini:
   +---+
   | id|
   +---+
   |  0|
   |  1|
   |  2|
   |  3|
   |  4|
   |  5|
   |  6|
   +---+
Perbarui data dalam tabel dasar.
spark.sql(
     "UPDATE base_table SET id = (id + 100) WHERE (id % 2 == 0)"
 )
spark.sql("SELECT * FROM base_table").show()
Outputnya mirip dengan hal berikut ini:
   +---+
   | id|
   +---+
   |  3|
   |104|
   |  5|
   |106|
   |100|
   |102|
   |  1|
   +---+
Menghapus data dari tabel dasar.
spark.sql("DELETE FROM base_table WHERE (id % 2 == 0)")
spark.sql("SELECT * FROM base_table").show()
Outputnya mirip dengan hal berikut ini:
   +---+
   | id|
   +---+
   |  3|
   |  5|
   |  1|
   +---+
Membuat kueri snapshot historis
Mengambil versi tabel sebelumnya dengan membuat kueri ID snapshot. Operasi ini juga dikenal sebagai perjalanan waktu.
Ambil ID snapshot versi tabel sebelum operasi
MERGE,UPDATE, danDELETE.snapshot_ids = spark.sql( "SELECT snapshot_id FROM `NAMESPACE_NAME`.`base_table`.snapshots" ).collect() oldest_snapshot_id = snapshot_ids[1]["snapshot_id"]Ganti
NAMESPACE_NAMEdengan namespace yang Anda buat.Buat kueri tabel menggunakan ID snapshot yang diambil.
df = (
     spark.read.format("iceberg")
     .option("versionAsOf", oldest_snapshot_id)
     .load("base_table")
 )
df.show()
Output menunjukkan status tabel setelah operasi
MERGE, tetapi sebelum operasiUPDATEatauDELETE.+---+ | id| +---+ | 0| | 1| | 2| | 3| | 4| | 5| | 6| +---+
Menemukan silsilah data
Dengan menggunakan Managed Service untuk Apache Spark versi image 2.2 dan yang lebih baru, Anda dapat melacak pergerakan data antara tabel Katalog REST Iceberg dan katalog runtime Lakehouse dengan silsilah data.
Contoh silsilah data
Buat tabel Iceberg sumber dan target, lalu salin data.
spark.sql("DROP TABLE IF EXISTS source_table PURGE")
spark.sql("DROP TABLE IF EXISTS target_table PURGE")
spark.sql("CREATE TABLE source_table (id LONG) USING iceberg")
spark.sql("""CREATE TABLE target_table
  USING ICEBERG
  AS SELECT max(id) as top_id FROM source_table
  """)
Di konsol Google Cloud , buka halaman Knowledge Catalog Search.
Telusuri salah satu tabel, lalu klik tab
Lineage: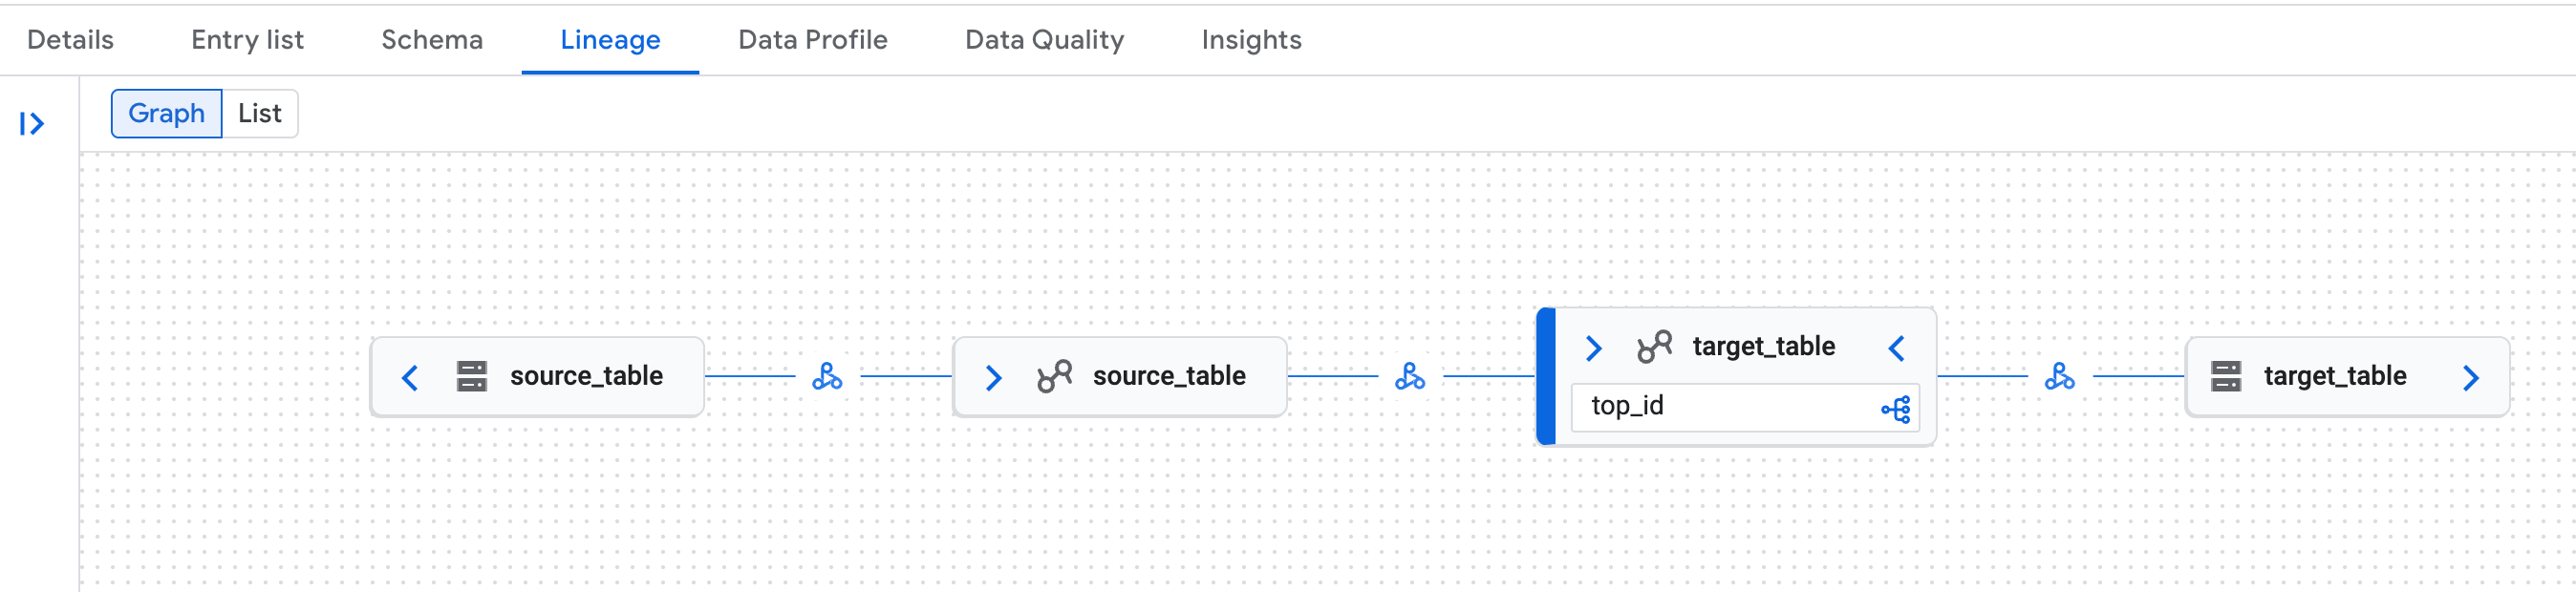
Contoh grafik silsilah data di halaman Knowledge Catalog di konsol Google Cloud . Linieritas data mengenali representasi logis (tabel katalog runtime Lakehouse) dan fisik (Cloud Storage) dari tabel Katalog REST Iceberg katalog runtime Lakehouse.
Masalah umum silsilah data
Di beberapa cluster Managed Service untuk Apache Spark, silsilah data lengkap mungkin tidak dibuat karena masalah library OpenLineage. Ini adalah batasan umum. Jika hal ini memengaruhi workload Anda, hubungi dukungan Google Cloud.
Langkah berikutnya
- Pelajari lebih lanjut Katalog REST Iceberg katalog runtime Lakehouse.
- Membuat kueri katalog gabungan dengan Spark.
- Pelajari fitur-fitur Apache Iceberg.
- Pelajari cara mengkueri data Iceberg dari katalog runtime Lakehouse.
- Pelajari lebih lanjut silsilah data dan Managed Service untuk Apache Spark.