


סקירה כללית
Persistent History Server (PHS) של Managed Service for Apache Spark מספק ממשקי אינטרנט לצפייה בהיסטוריית המשימות שהופעלו באשכולות פעילים או שנמחקו של Managed Service for Apache Spark. הוא זמין ב-Managed Service for Apache Spark מגרסת קובץ אימג' 1.5 ואילך, ופועל באשכול של צומת יחיד ב-Managed Service for Apache Spark. הוא מספק ממשקי אינטרנט לקבצים ולנתונים הבאים:
קובצי היסטוריית המשימות של MapReduce ו-Spark
קבצים של היסטוריית משימות ב-Flink (כדי ליצור אשכול של Managed Service for Apache Spark להרצת משימות ב-Flink, עיינו ברכיב האופציונלי של Flink ב-Dataproc)
קובצי נתונים בציר הזמן של האפליקציה שנוצרו על ידי YARN Timeline Service v2 ומאוחסנים במכונה של Bigtable.
יומני צבירת נתונים של YARN
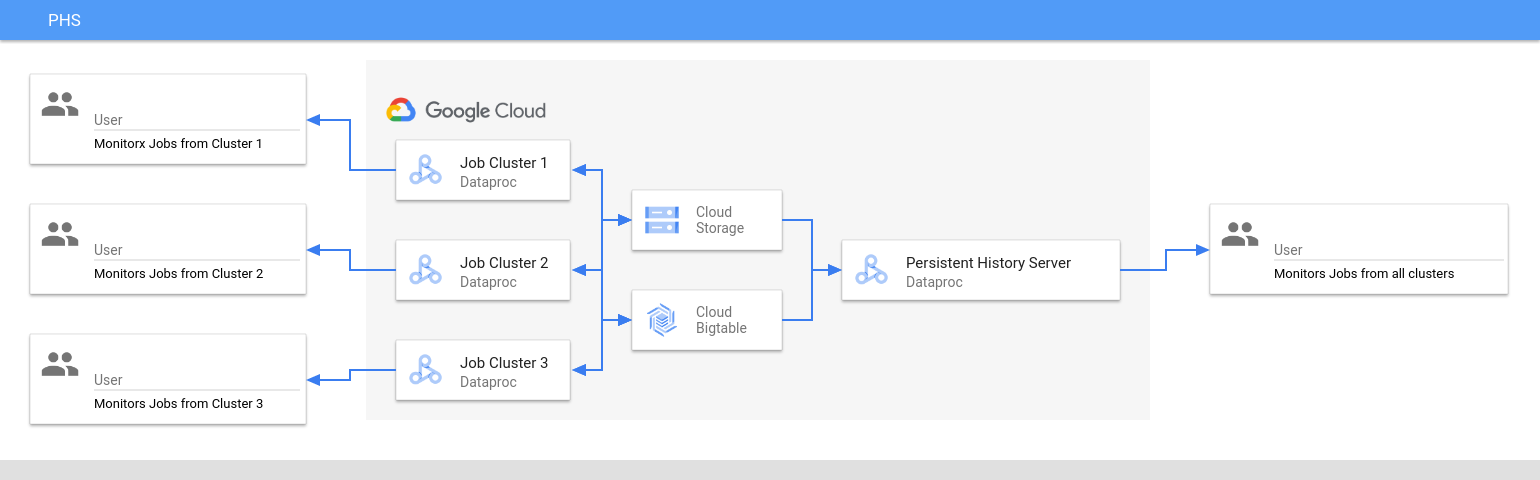
שרת ההיסטוריה הקבוע ניגש לקובצי ההיסטוריה של משימות Spark ו-MapReduce, לקובצי ההיסטוריה של משימות Flink ולקובצי היומן של YARN שנכתבו ב-Cloud Storage במהלך חיי אשכולות המשימות של Managed Service for Apache Spark, ומציג אותם.
מגבלות
גרסת קובץ האימג' של אשכול ה-PHS וגרסת קובץ האימג' של אשכולות המשימות ב-Managed Service for Apache Spark חייבות להיות זהות. לדוגמה, אתם יכולים להשתמש באשכול PHS של גרסת אימג' של Managed Service for Apache Spark 2.0 כדי להציג קובצי היסטוריית משימות של משימות שרצו באשכולות משימות של גרסת אימג' של Managed Service for Apache Spark 2.0, שהיו ממוקמים בפרויקט שבו נמצא אשכול ה-PHS.
אשכול PHS לא תומך ב-Kerberos ובאימות אישי.
יצירת אשכול PHS ב-Managed Service for Apache Spark
כדי ליצור אשכול עם צומת יחיד של Managed Service for Apache Spark Persistent History Server, אתם יכולים להריץ את הפקודה הבאה של gcloud dataproc clusters create במסוף מקומי או ב-Cloud Shell עם הדגלים הבאים ומאפייני האשכול.
gcloud dataproc clusters create CLUSTER_NAME \
    --project=PROJECT \
    --region=REGION \
    --single-node \
    --enable-component-gateway \
    --optional-components=COMPONENT \
    --properties=PROPERTIES
- CLUSTER_NAME: השם של אשכול ה-PHS.
- PROJECT: הפרויקט שרוצים לשייך לאשכול ה-PHS. הפרויקט הזה צריך להיות זהה לפרויקט שמשויך לאשכול שמריץ את המשימות (ראו יצירת אשכול משימות ב-Dataproc).
- REGION: מציינים אזור ב-Compute Engine שבו ימוקם אשכול ה-PHS.
-
--single-node: אשכול PHS הוא אשכול של צומת יחיד ב-Dataproc. -
--enable-component-gateway: הדגל הזה מפעיל ממשקי אינטרנט של Component Gateway באשכול PHS. - COMPONENT: משתמשים בדגל הזה כדי להתקין רכיבים אופציונליים באשכול. כדי להציג קובצי היסטוריה של משימות Flink, צריך לציין את הרכיב האופציונלי
FLINKכדי להריץ את שירות האינטרנט Flink HistoryServer באשכול ה-PHS. - PROPERTIES. מציינים מאפיין אשכול אחד או יותר.
אם רוצים, מוסיפים את הדגל --image-version כדי לציין את גרסת קובץ האימג' של אשכול ה-PHS. גרסת התמונה של ה-PHS צריכה להיות זהה לגרסת התמונה של אשכולות המשימות ב-Managed Service for Apache Spark. מגבלות
הערות:
- בדוגמאות לערכי המאפיינים בקטע הזה נעשה שימוש בתו הכללי לחיפוש "*", כדי לאפשר ל-PHS להתאים לכמה ספריות בקטגוריה שצוינה, שאשכולות שונים של משימות כותבים בהן (אבל כדאי לעיין בשיקולי יעילות של תווים כלליים לחיפוש).
- בדוגמאות הבאות מוצגים דגלי
--propertiesנפרדים כדי לשפר את הקריאוּת. כשמשתמשים ב-gcloud dataproc clusters createכדי ליצור אשכול של Managed Service for Apache Spark, מומלץ להשתמש בדגל--propertiesאחד כדי לציין רשימה של מאפיינים שמופרדים בפסיקים (ראו פורמט של מאפייני אשכול).
מאפיינים:
-
yarn:yarn.nodemanager.remote-app-log-dir=gs://bucket-name/*/yarn-logs: מוסיפים את המאפיין הזה כדי לציין את המיקום ב-Cloud Storage שבו ה-PHS ייגש ליומני YARN שנכתבו על ידי אשכולות של משימות.
spark:spark.history.fs.logDirectory=gs://bucket-name/*/spark-job-history: צריך להוסיף את המאפיין הזה כדי להפעיל היסטוריית משימות מתמידה של Spark. המאפיין הזה מציין את המיקום שבו שרת PHS ייגש ליומני ההיסטוריה של משימות Spark שנכתבו על ידי אשכולות של משימות.באשכולות של Managed Service for Apache Spark מגרסה 2.0 ומעלה, צריך להגדיר גם את שני המאפיינים הבאים כדי להפעיל את יומני ההיסטוריה של PHS Spark (ראו אפשרויות להגדרת שרת ההיסטוריה של Spark). הערך
spark.history.custom.executor.log.urlהוא ליטרל שמכיל {{פלייסהולדרים}} למשתנים שיוגדרו על ידי Persistent History Server. המשתנים האלה לא מוגדרים על ידי המשתמשים. צריך להעביר את ערך המאפיין כמו שהוא מוצג.--properties=spark:spark.history.custom.executor.log.url.applyIncompleteApplication=false
--properties=spark:spark.history.custom.executor.log.url={{YARN_LOG_SERVER_URL}}/{{NM_HOST}}:{{NM_PORT}}/{{CONTAINER_ID}}/{{CONTAINER_ID}}/{{USER}}/{{FILE_NAME}}
mapred:mapreduce.jobhistory.read-only.dir-pattern=gs://bucket-name/*/mapreduce-job-history/done: הוסיפו את המאפיין הזה כדי להפעיל היסטוריית משימות MapReduce מתמידה. המאפיין הזה מציין את המיקום ב-Cloud Storage שבו שרת PHS ייגש ליומני היסטוריית המשימות של MapReduce שנכתבו על ידי אשכולות של משימות.
dataproc:yarn.atsv2.bigtable.instance=projects/project-id/instance_id/bigtable-instance-id: אחרי שמגדירים את Yarn Timeline Service v2, מוסיפים את המאפיין הזה כדי להשתמש באשכול PHS לצפייה בנתוני ציר הזמן בממשקי האינטרנט של YARN Application Timeline Service V2 ו-Tez (ראו ממשקי האינטרנט של Component Gateway).
flink:historyserver.archive.fs.dir=gs://bucket-name/*/flink-job-history/completed-jobs: משתמשים במאפיין הזה כדי להגדיר אתHistoryServerשל Flink למעקב אחרי רשימה מופרדת בפסיקים של ספריות.
דוגמאות למאפיינים:
--properties=spark:spark.history.fs.logDirectory=gs://bucket-name/*/spark-job-history
--properties=mapred:mapreduce.jobhistory.read-only.dir-pattern=gs://bucket-name/*/mapreduce-job-history/done
--properties=flink:flink.historyserver.archive.fs.dir=gs://bucket-name/*/flink-job-history/completed-jobs
יצירת אשכול משימות ב-Managed Service for Apache Spark
כדי ליצור אשכול של משימות ב-Managed Service for Apache Spark שמריץ משימות וכותב קובצי היסטוריית משימות ב-Persistent History Server (PHS), אתם יכולים להריץ את הפקודה הבאה בטרמינל מקומי או ב-Cloud Shell.
gcloud dataproc clusters create CLUSTER_NAME \ --project=PROJECT \ --region=REGION \ --optional-components=COMPONENT \ --enable-component-gateway \ --properties=PROPERTIES \ other args ...
- CLUSTER_NAME: מציינים את שם אשכול המשימות.
- PROJECT: מציינים את הפרויקט שמשויך לאשכול המשימות.
- REGION: מציינים את האזור של Compute Engine שבו ימוקם אשכול המשימות.
-
--enable-component-gateway: הדגל הזה מפעיל את ממשקי האינטרנט של Component Gateway באשכול של המשימה. - COMPONENT: משתמשים בדגל הזה כדי להתקין רכיבים אופציונליים באשכול. מציינים את הרכיב האופציונלי
FLINKכדי להריץ משימות Flink באשכול. PROPERTIES: מוסיפים אחד או יותר ממאפייני האשכול הבאים כדי להגדיר מיקומים ב-Cloud Storage שקשורים ל-PHS שהם לא ברירת המחדל, ומאפיינים אחרים של אשכול המשימות.
הערות:
- בדוגמאות לערכי המאפיינים בקטע הזה נעשה שימוש בתו הכללי לחיפוש "*", כדי לאפשר ל-PHS להתאים לכמה ספריות בקטגוריה שצוינה, שאשכולות שונים של משימות כותבים בהן (אבל כדאי לעיין בשיקולי יעילות של תווים כלליים לחיפוש).
- בדוגמאות הבאות מוצגים דגלי
--propertiesנפרדים כדי לשפר את הקריאוּת. כשמשתמשים ב-gcloud dataproc clusters createכדי ליצור אשכול של Managed Service for Apache Spark, מומלץ להשתמש בדגל--propertiesאחד כדי לציין רשימה של מאפיינים שמופרדים בפסיקים (ראו פורמט של מאפייני אשכול).
מאפיינים:
-
yarn:yarn.nodemanager.remote-app-log-dir: כברירת מחדל, יומני YARN נצברים מופעלים באשכולות של משימות Managed Service for Apache Spark, ונכתבים בקטגוריה הזמנית של האשכול. צריך להוסיף את המאפיין הזה כדי לציין מיקום אחר ב-Cloud Storage שבו האשכול יכתוב יומני צבירה, כדי ששרת ההיסטוריה הקבוע יוכל לגשת אליהם.--properties=yarn:yarn.nodemanager.remote-app-log-dir=gs://bucket-name/directory-name/yarn-logs
-
spark:spark.history.fs.logDirectoryו-spark:spark.eventLog.dir: כברירת מחדל, קובצי ההיסטוריה של משימות Spark נשמרים ב-temp bucketשל האשכול בספרייה/spark-job-history. אפשר להוסיף את המאפיינים האלה כדי לציין מיקומים שונים ב-Cloud Storage לקבצים האלה. אם משתמשים בשני המאפיינים, הם צריכים להפנות לספריות באותה קטגוריה.--properties=spark:spark.history.fs.logDirectory=gs://bucket-name/directory-name/spark-job-history
--properties=spark:spark.eventLog.dir=gs://bucket-name/directory-name/spark-job-history
-
mapred:mapreduce.jobhistory.done-dirו-mapred:mapreduce.jobhistory.intermediate-done-dir: כברירת מחדל, קובצי ההיסטוריה של משימות MapReduce נשמרים ב-temp bucketשל האשכול, בספריות/mapreduce-job-history/doneו-/mapreduce-job-history/intermediate-done. מיקום הבינייםmapreduce.jobhistory.intermediate-done-dirהוא אחסון זמני. קובצי הביניים מועברים למיקוםmapreduce.jobhistory.done-dirכשמשימת MapReduce מסתיימת. אתם יכולים להוסיף את המאפיינים האלה כדי לציין מיקומים שונים ב-Cloud Storage לקבצים האלה. אם משתמשים בשני המאפיינים, הם צריכים להפנות לספריות באותה קטגוריה.--properties=mapred:mapreduce.jobhistory.done-dir=gs://bucket-name/directory-name/mapreduce-job-history/done
--properties=mapred:mapreduce.jobhistory.intermediate-done-dir=gs://bucket-name/directory-name/mapreduce-job-history/intermediate-done
-
spark:spark.history.fs.gs.outputstream.type: המאפיין הזה רלוונטי לאשכולות של גרסאות תמונה של2.0ו-2.1שמשתמשים בגרסה2.0.xשל החיבור ל-Cloud Storage (גרסת ברירת המחדל של החיבור לאשכולות של גרסאות תמונה של2.0ו-2.1). הוא קובע איך משימות Spark שולחות נתונים ל-Cloud Storage. הגדרת ברירת המחדל היאBASIC, ששולחת נתונים ל-Cloud Storage אחרי שהמשימה מסתיימת. כשהערך הואFLUSHABLE_COMPOSITE, הנתונים מועתקים ל-Cloud Storage במרווחי זמן קבועים בזמן שהמשימה פועלת, כפי שמוגדר על ידיspark:spark.history.fs.gs.outputstream.sync.min.interval.ms.--properties=spark:spark.history.fs.gs.outputstream.type=FLUSHABLE_COMPOSITE
-
spark:spark.history.fs.gs.outputstream.sync.min.interval.ms: המאפיין הזה רלוונטי לאשכולות של גרסאות התמונה2.0ו-2.1שמשתמשים בגרסה2.0.xשל החיבור ל-Cloud Storage (גרסת ברירת המחדל של החיבור לאשכולות של גרסאות התמונה2.0ו-2.1). היא קובעת את התדירות במילי-שניות שבה הנתונים מועברים ל-Cloud Storage כש-spark:spark.history.fs.gs.outputstream.typeמוגדר ל-FLUSHABLE_COMPOSITE. מרווח הזמן שמוגדר כברירת מחדל הוא5000ms. אפשר לציין את ערך מרווח הזמן באלפיות השנייה עם או בלי הסיומתms.--properties=spark:spark.history.fs.gs.outputstream.sync.min.interval.ms=INTERVALms
-
spark:spark.history.fs.gs.outputstream.sync.min.interval: המאפיין הזה רלוונטי לאשכולות של גרסאות אימג' מ-2.2ואילך, שמשתמשים בגרסה3.0.xשל החיבור ל-Cloud Storage (גרסת ברירת המחדל של החיבור לאשכולות של גרסאות אימג'2.2). הוא מחליף את המאפיין הקודםspark:spark.history.fs.gs.outputstream.sync.min.interval.ms, ותומך בערכים עם סיומת זמן, כמוms,sו-m. היא קובעת את התדירות שבה הנתונים מועברים ל-Cloud Storage כשהערך שלspark:spark.history.fs.gs.outputstream.typeמוגדר כ-FLUSHABLE_COMPOSITE.--properties=spark:spark.history.fs.gs.outputstream.sync.min.interval=INTERVAL
-
dataproc:yarn.atsv2.bigtable.instance: אחרי שמגדירים את Yarn Timeline Service v2, מוסיפים את המאפיין הזה כדי לכתוב את נתוני ציר הזמן של YARN למכונה שצוינה ב-Bigtable, כדי להציג אותם בממשקי האינטרנט YARN Application Timeline Service V2 ו-Tez של אשכול ה-PHS. הערה: יצירת האשכול תיכשל אם המכונה של Bigtable לא קיימת.--properties=dataproc:yarn.atsv2.bigtable.instance=projects/project-id/instance_id/bigtable-instance-id
-
flink:jobhistory.archive.fs.dir: Flink JobManager מעביר לארכיון משימות Flink שהושלמו על ידי העלאת מידע על משימות שהועברו לארכיון לספרייה של מערכת קבצים. משתמשים במאפיין הזה כדי להגדיר את ספריית הארכיון ב-flink-conf.yaml.--properties=flink:jobmanager.archive.fs.dir=gs://bucket-name/job-cluster-1/flink-job-history/completed-jobs
שימוש ב-PHS עם עומסי עבודה באצווה של Spark
כדי להשתמש ב-Persistent History Server עם Managed Service for Apache Spark Serverless לעומסי עבודה באצווה של Spark:
בוחרים או מציינים את אשכול ה-PHS כששולחים עומס עבודה באצווה של Spark.
שימוש ב-PHS עם Managed Service for Apache Spark ב-Google Kubernetes Engine
כדי להשתמש ב-Persistent History Server עם Managed Service for Apache Spark ב-GKE:
בוחרים או מציינים את אשכול ה-PHS כשיוצרים אשכול וירטואלי של Managed Service for Apache Spark ב-GKE.
ממשקי אינטרנט של Component Gateway
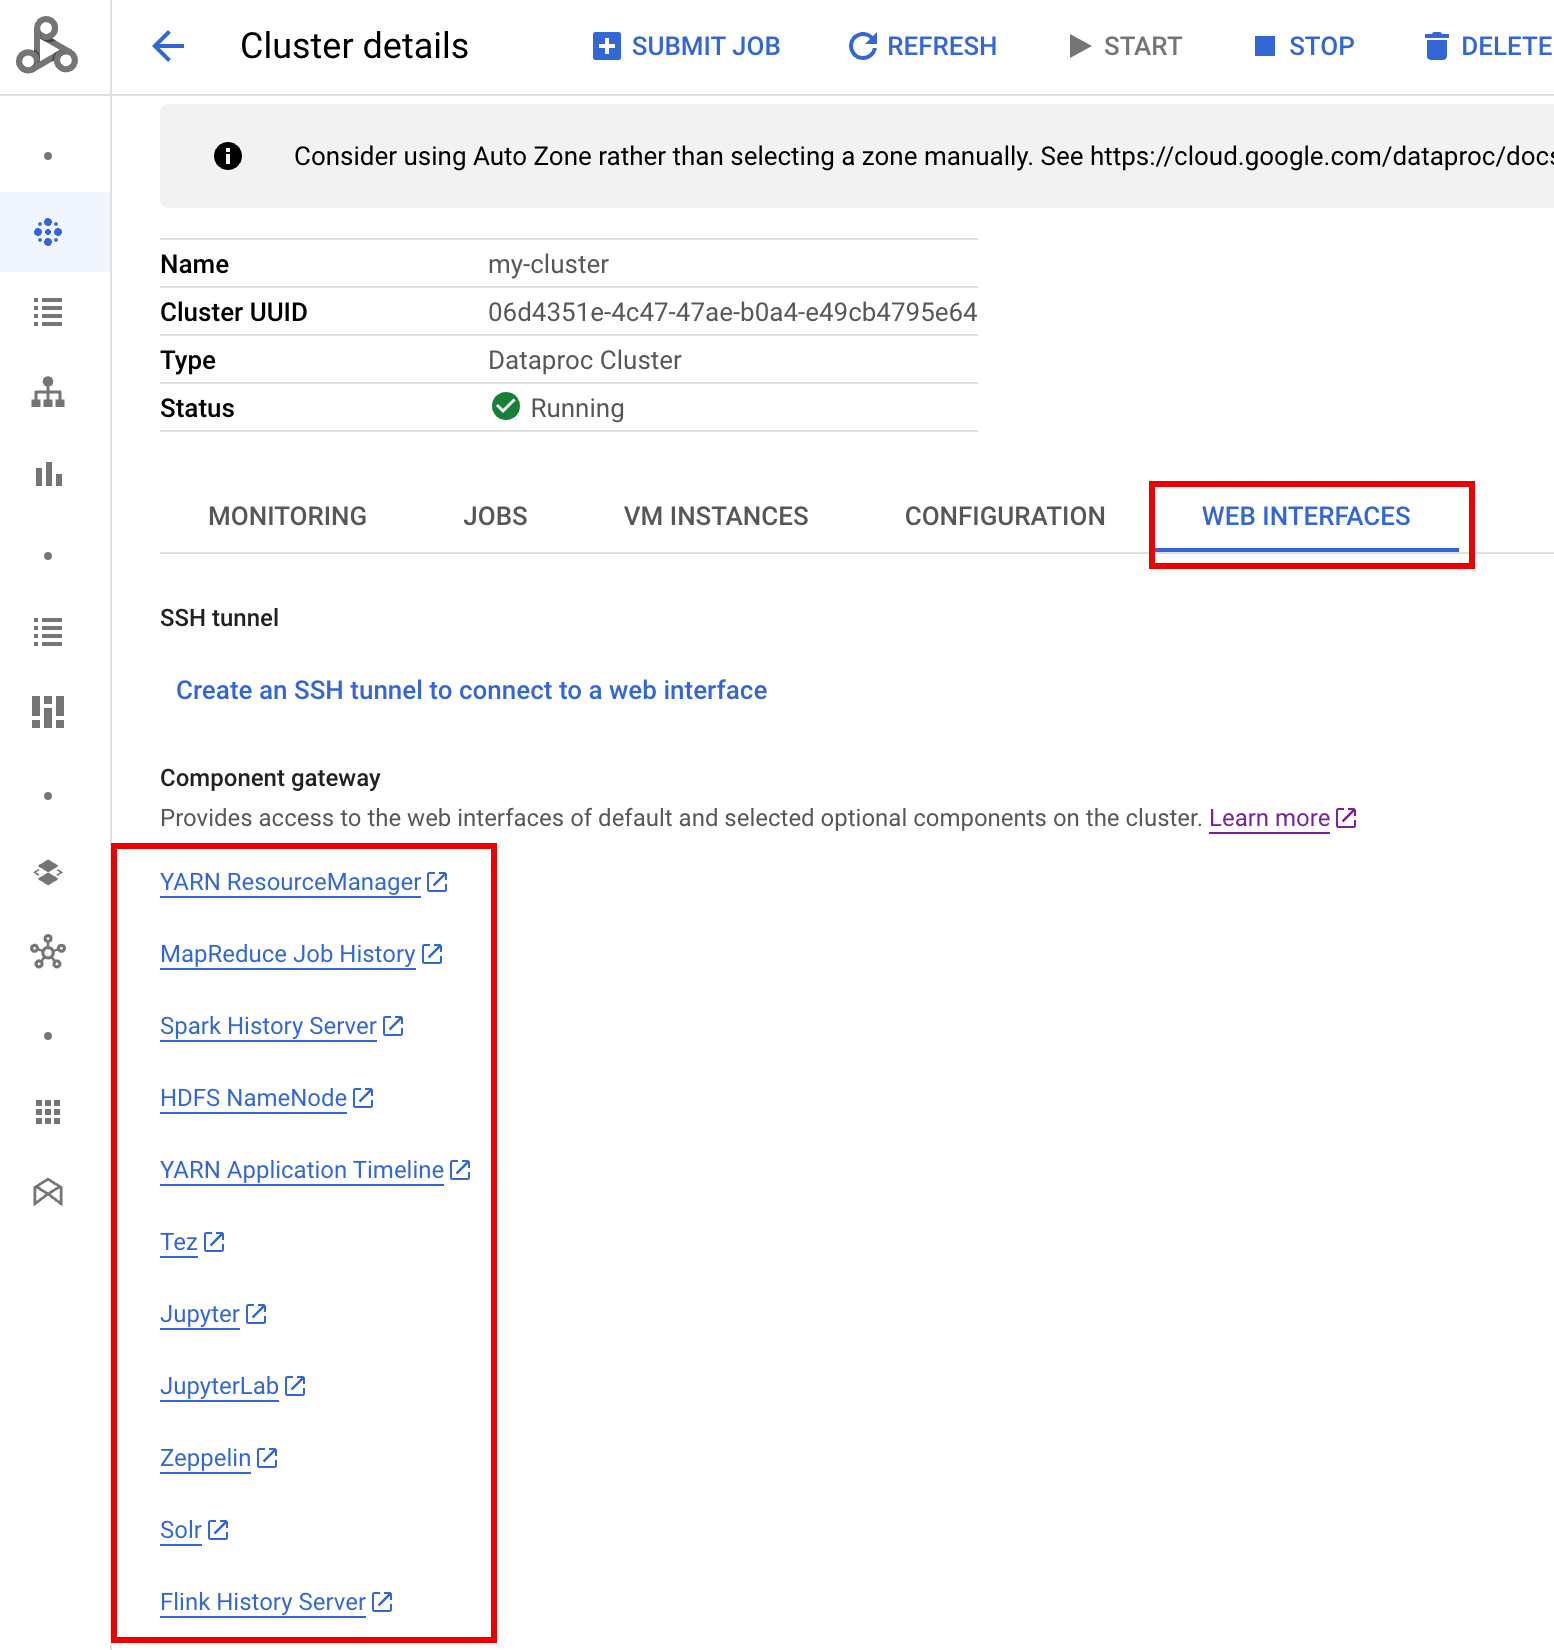
במסוף Google Cloud , בדף Clusters של Managed Service for Apache Spark, לוחצים על שם האשכול של PHS כדי לפתוח את הדף Cluster details. בכרטיסייה Web Interfaces, בוחרים את הקישורים של Component gateway כדי לפתוח ממשקי אינטרנט שפועלים באשכול PHS.
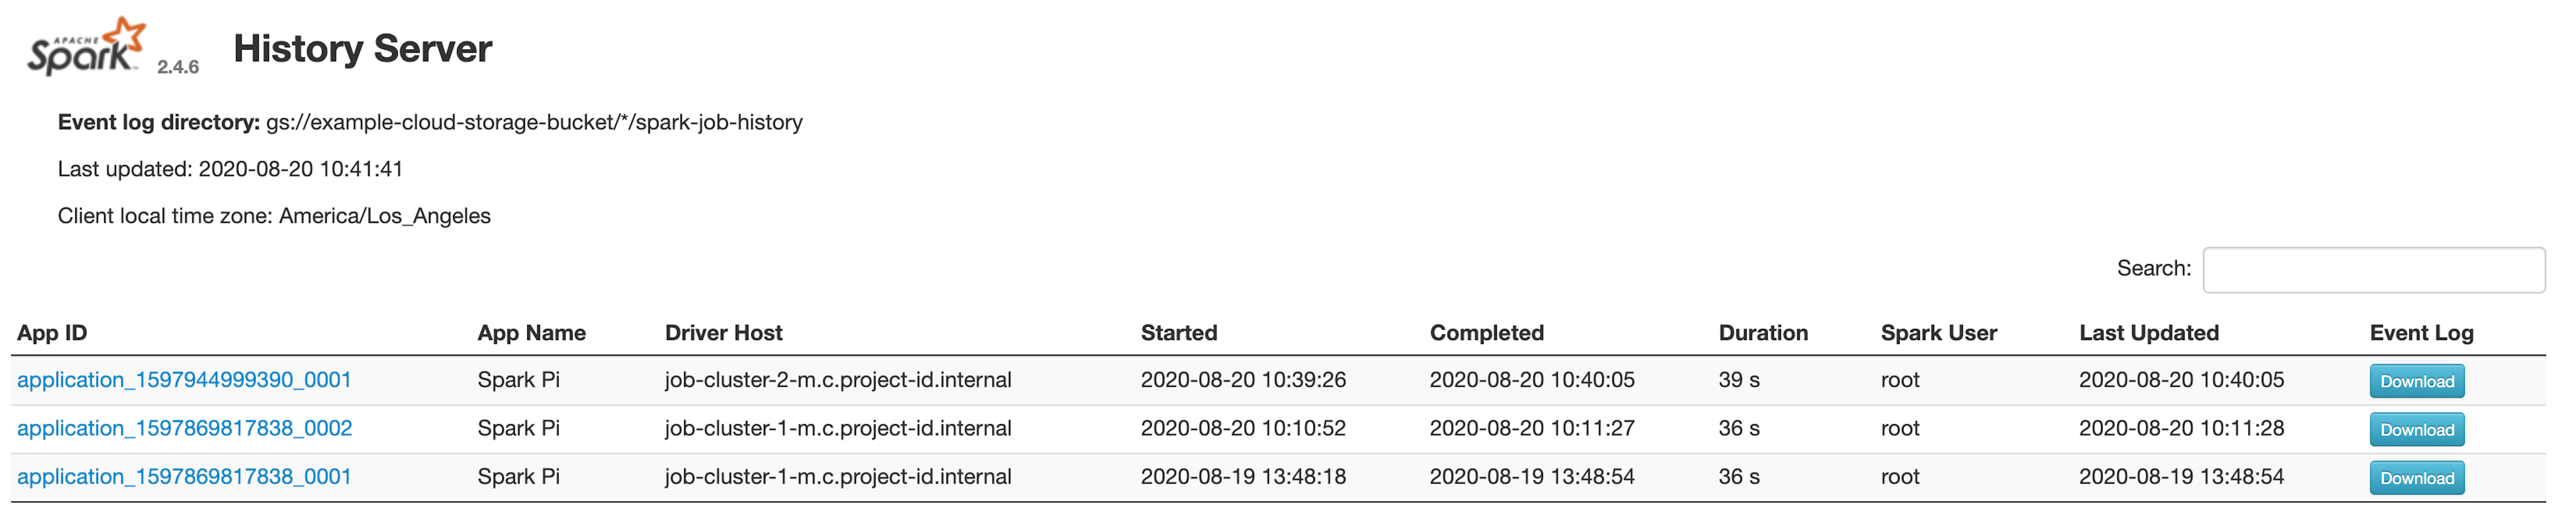
ממשק האינטרנט של Spark History Server
בצילום המסך הבא מוצג ממשק האינטרנט של Spark History Server, שבו מופיעים קישורים למשימות Spark שפועלות ב-job-cluster-1 וב-job-cluster-2 אחרי שמגדירים את המיקומים של spark.history.fs.logDirectory ו-spark:spark.eventLog.dir באשכולות המשימות, ואת המיקום של spark.history.fs.logDirectory באשכול PHS, באופן הבא:
| job-cluster-1 | gs://example-cloud-storage-bucket/job-cluster-1/spark-job-history |
| job-cluster-2 | gs://example-cloud-storage-bucket/job-cluster-2/spark-job-history |
| phs-cluster | gs://example-cloud-storage-bucket/*/spark-job-history |
חיפוש שם האפליקציה
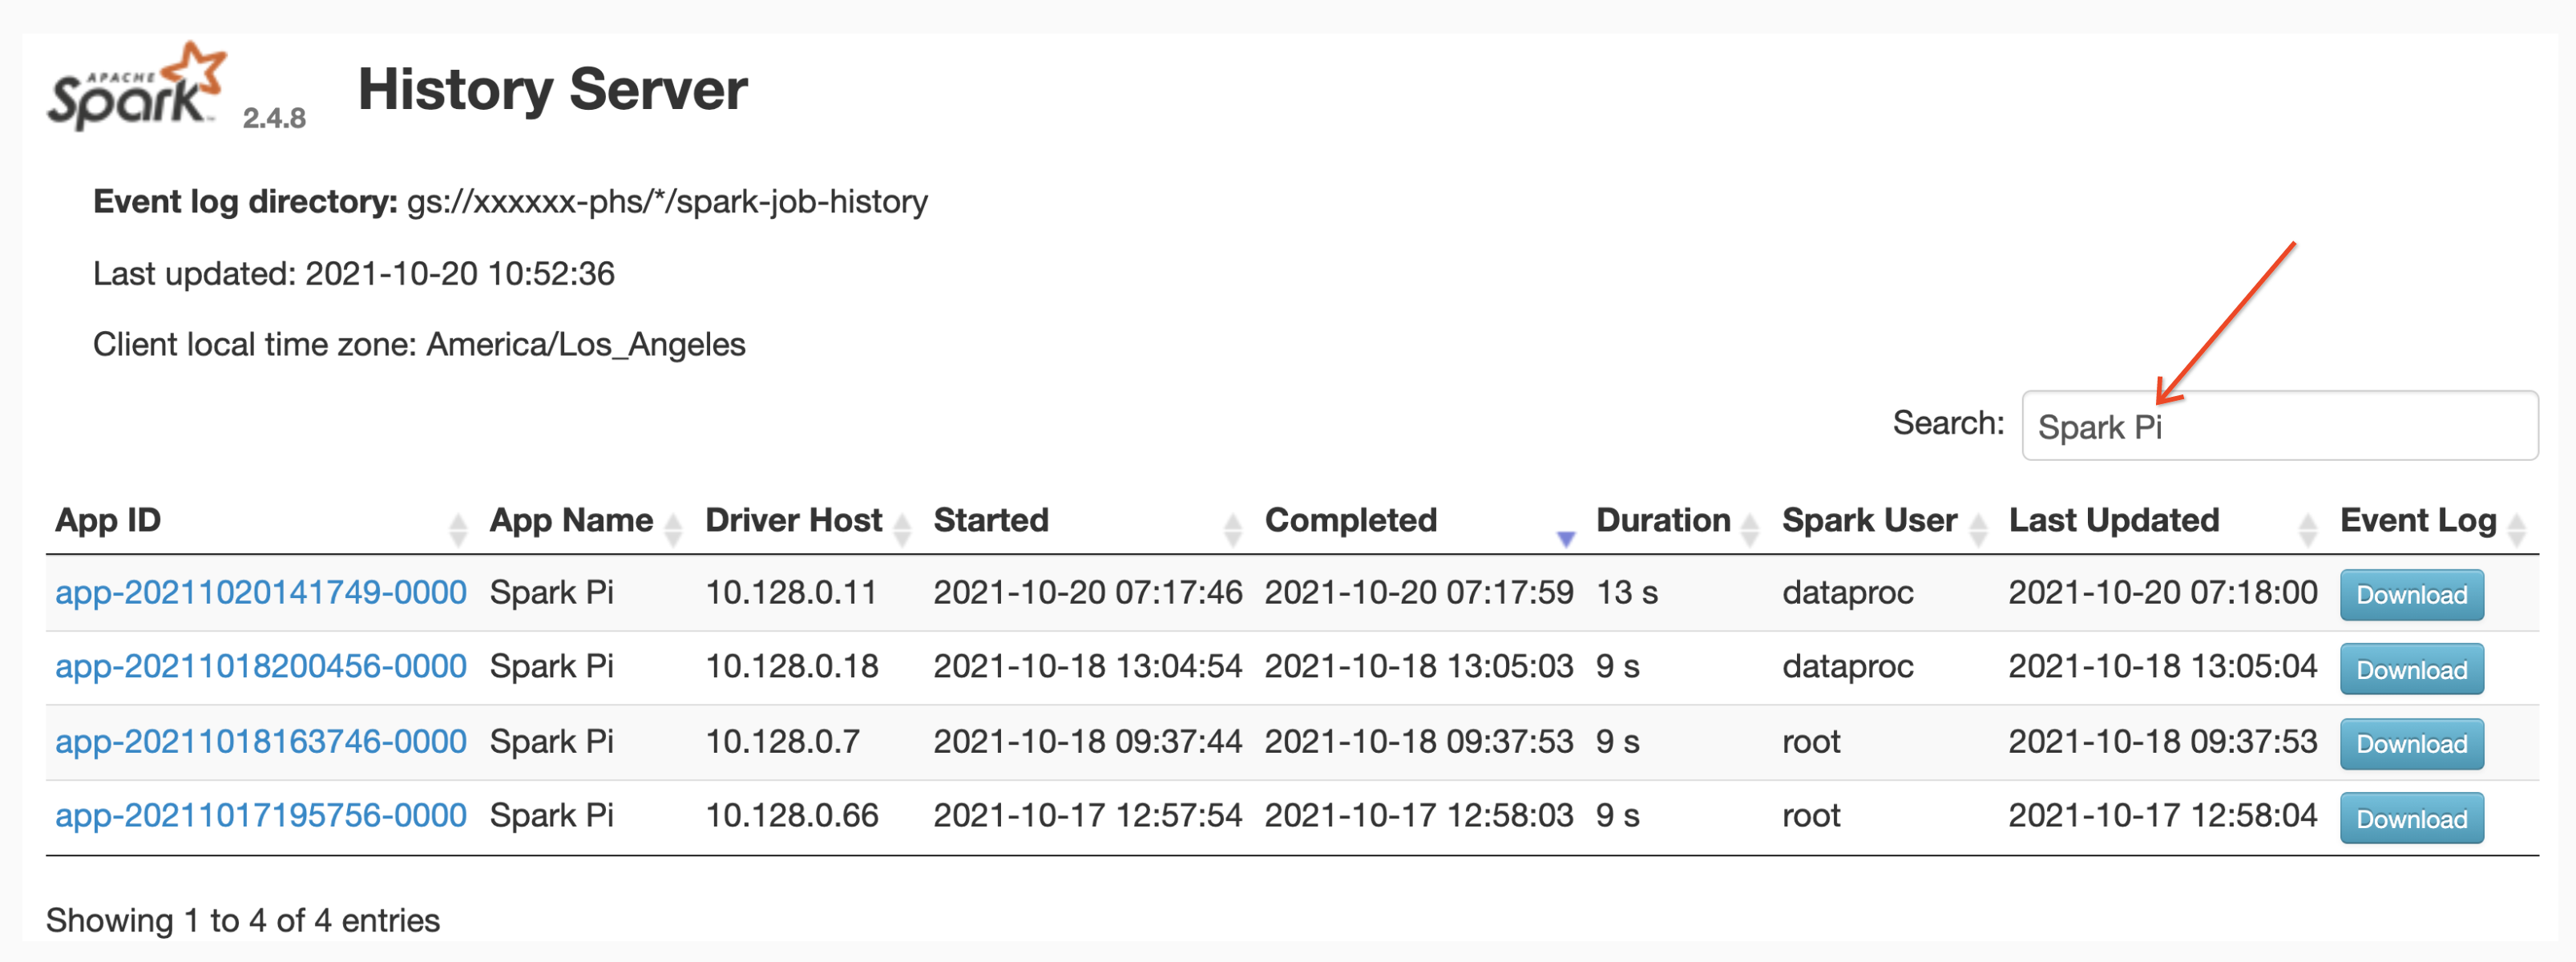
אפשר להציג רשימה של משימות לפי שם האפליקציה בממשק האינטרנט של שרת ההיסטוריה של Spark, על ידי הזנת שם האפליקציה בתיבת החיפוש. אפשר להגדיר את שם האפליקציה באחת מהדרכים הבאות (לפי סדר העדיפויות):
- מוגדר בתוך קוד האפליקציה כשיוצרים את ההקשר של Spark
- מוגדר על ידי המאפיין spark.app.name כשהמשימה נשלחת
- מוגדר על ידי Managed Service for Apache Spark לשם המלא של משאב ה-REST של המשימה (
projects/project-id/regions/region/jobs/job-id)
המשתמשים יכולים להזין שם של אפליקציה או משאב בתיבת החיפוש כדי למצוא משימות ולהציג אותן ברשימה.
יומני אירועים
בממשק האינטרנט של Spark History Server יש כפתור Event Log, שאפשר ללחוץ עליו כדי להוריד את יומני האירועים של Spark. היומנים האלה שימושיים לבדיקת מחזור החיים של אפליקציית Spark.
משימות Spark
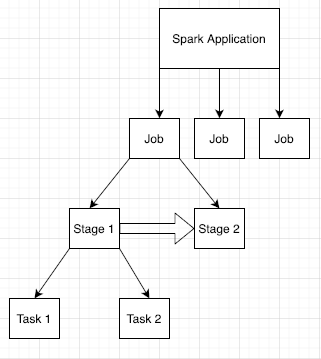
אפליקציות Spark מחולקות לכמה משימות, שמחולקות לכמה שלבים. כל שלב יכול לכלול כמה משימות, שפועלות בצומתי מנהלי משימות (עובדים).
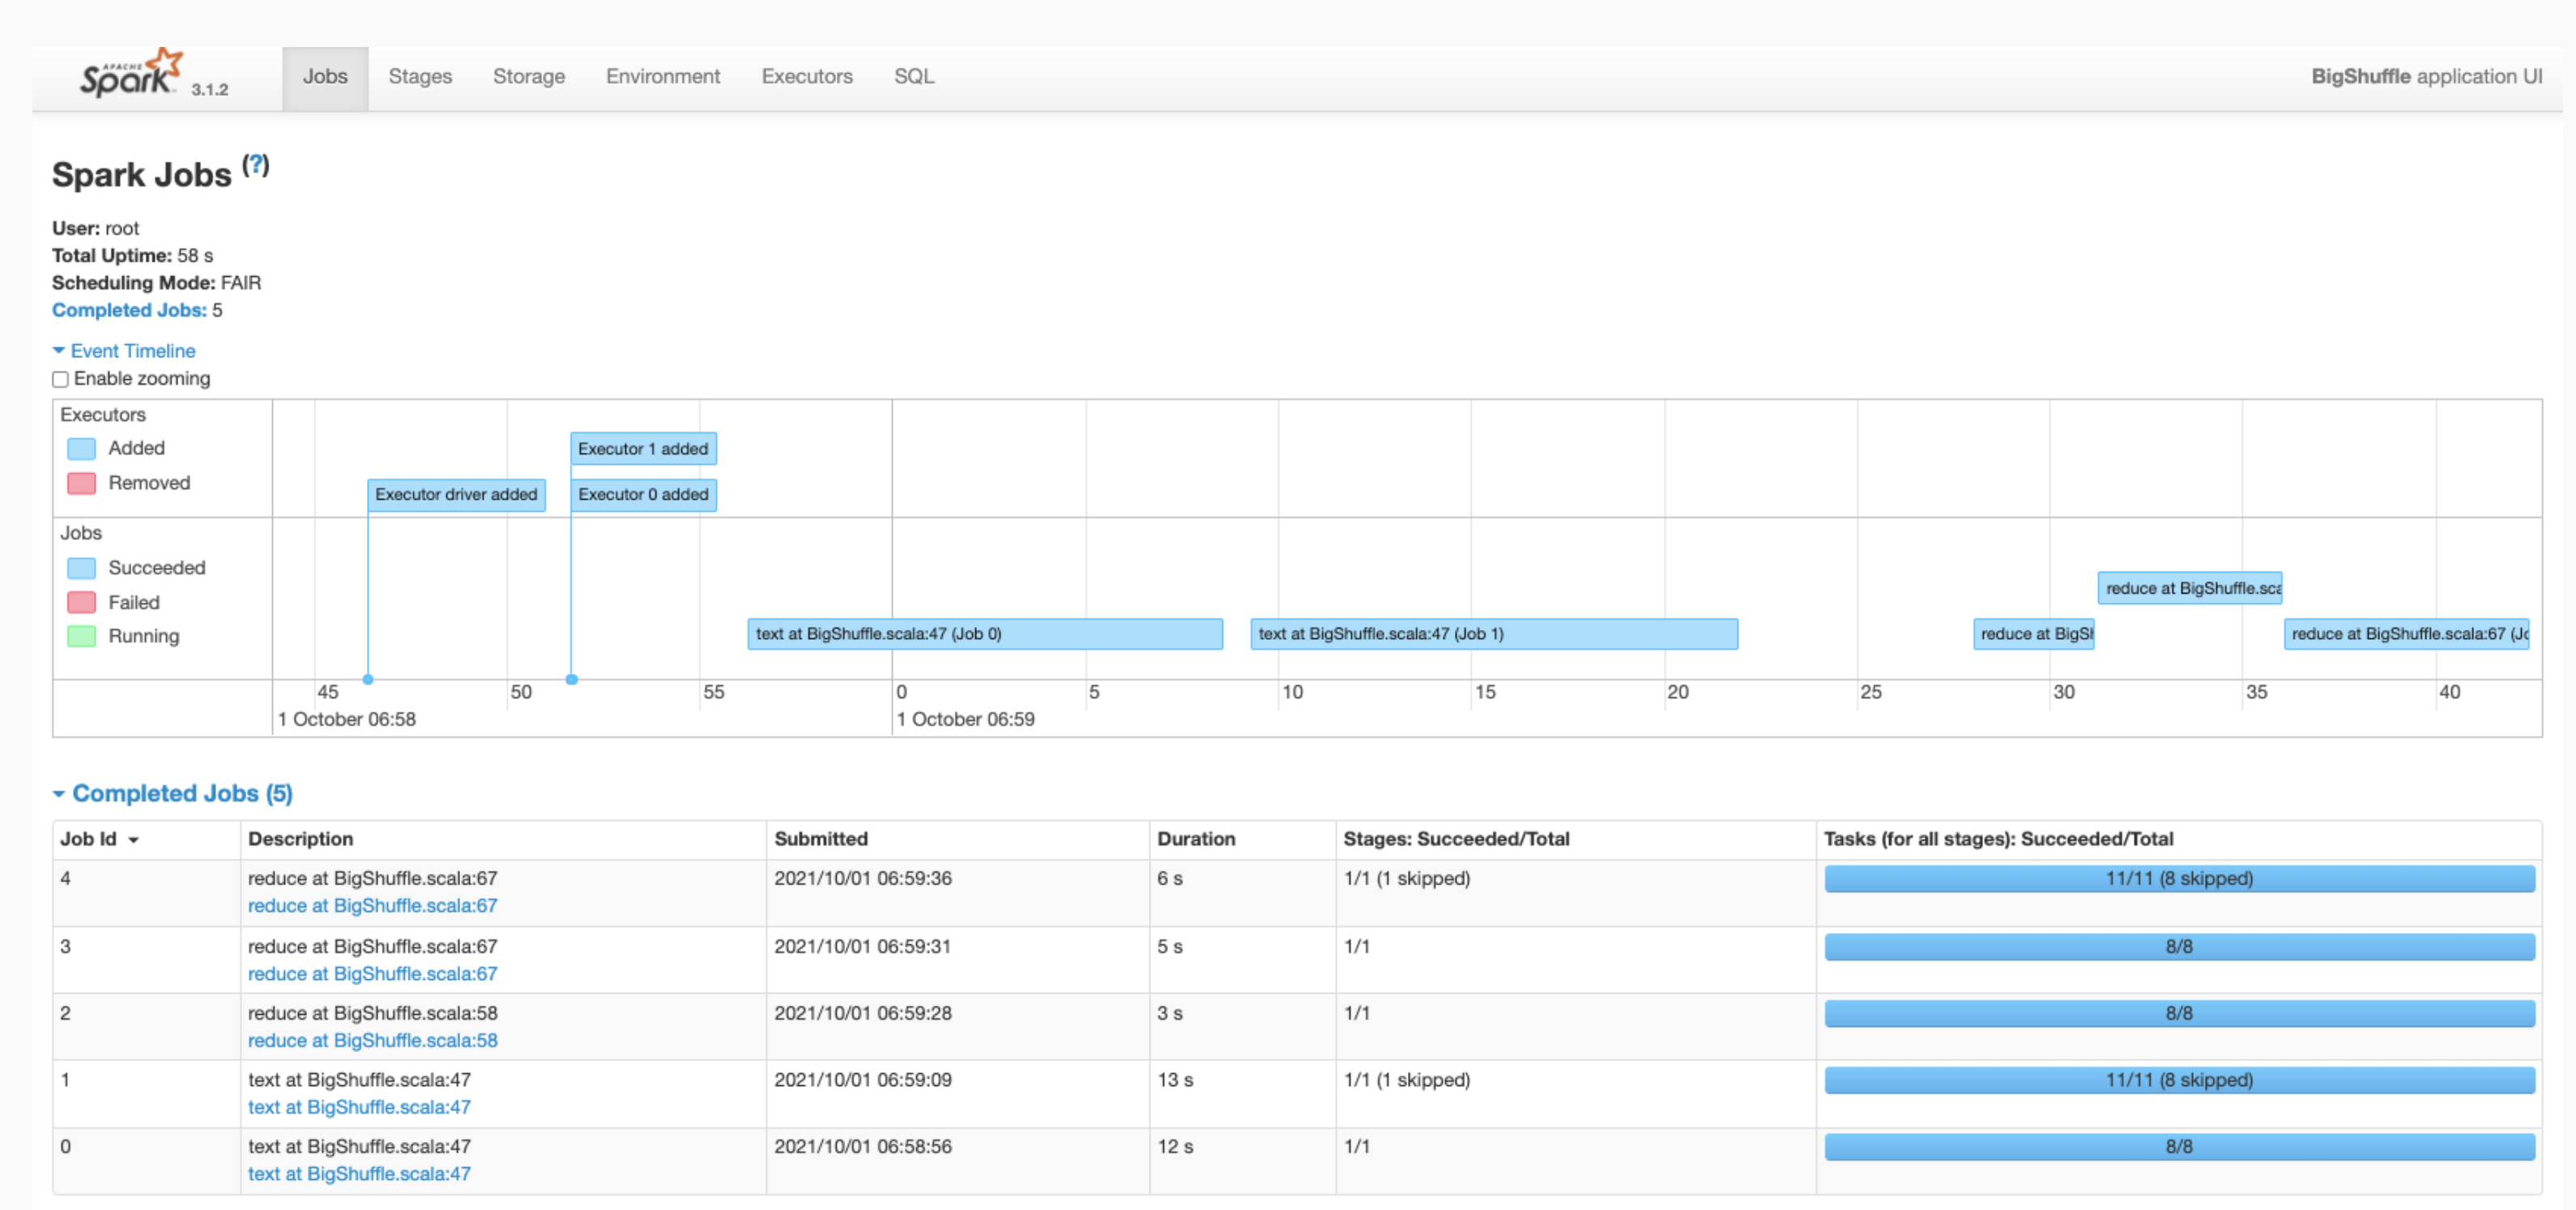
לוחצים על מזהה אפליקציית Spark בממשק האינטרנט כדי לפתוח את הדף Spark Jobs, שבו מוצגים ציר זמן של אירועים וסיכום של המשימות באפליקציה.
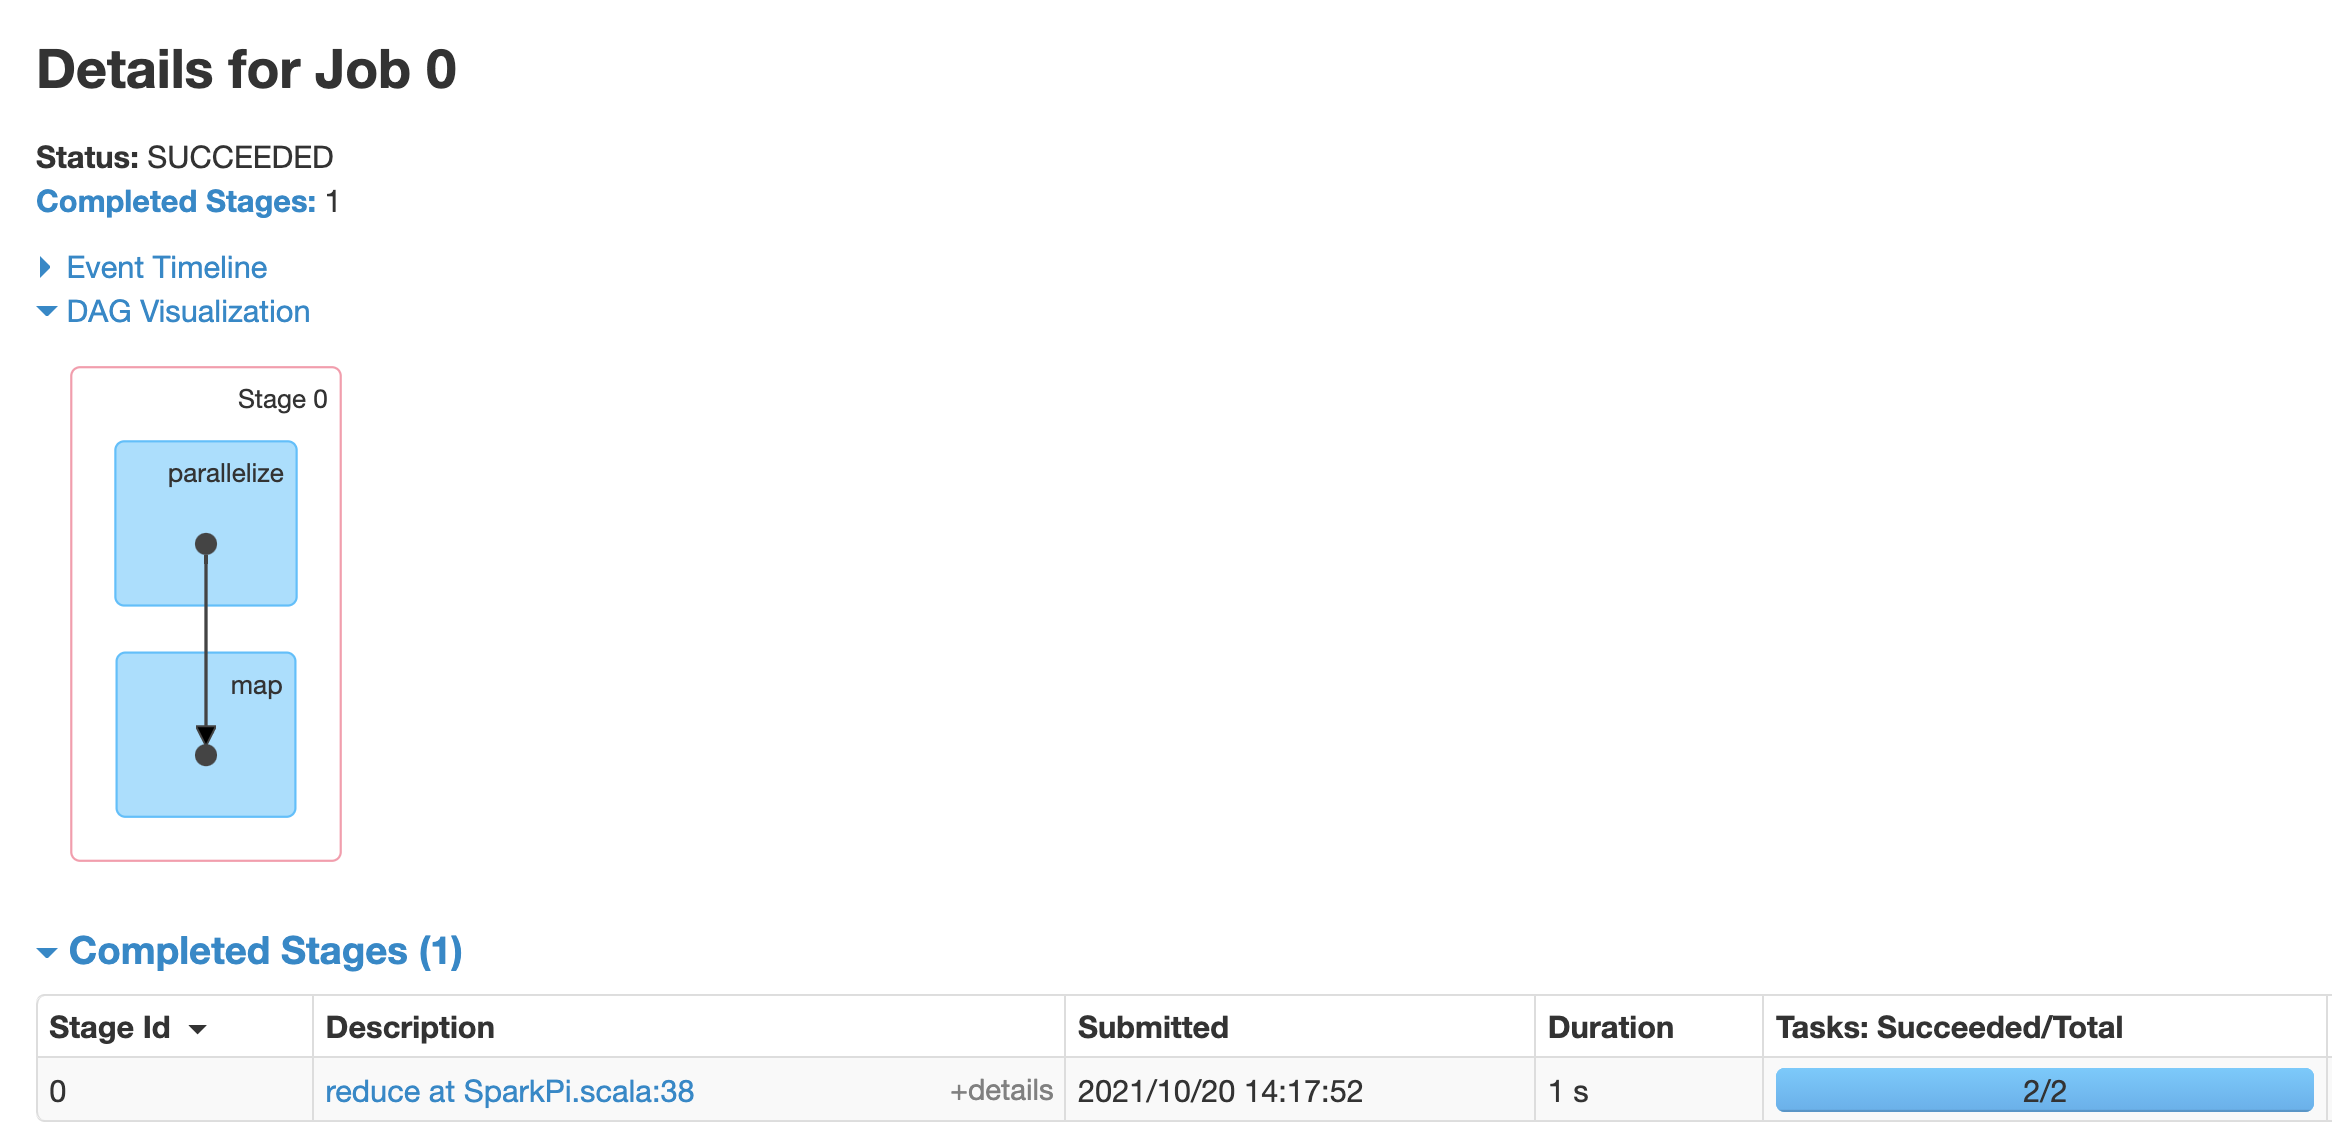
לוחצים על משימה כדי לפתוח את דף הפרטים של המשימה עם גרף אציקלי מכוון (DAG) וסיכום של שלבי המשימה.
לוחצים על שלב או משתמשים בכרטיסייה Stages כדי לבחור שלב ולפתוח את דף הפרטים שלו.
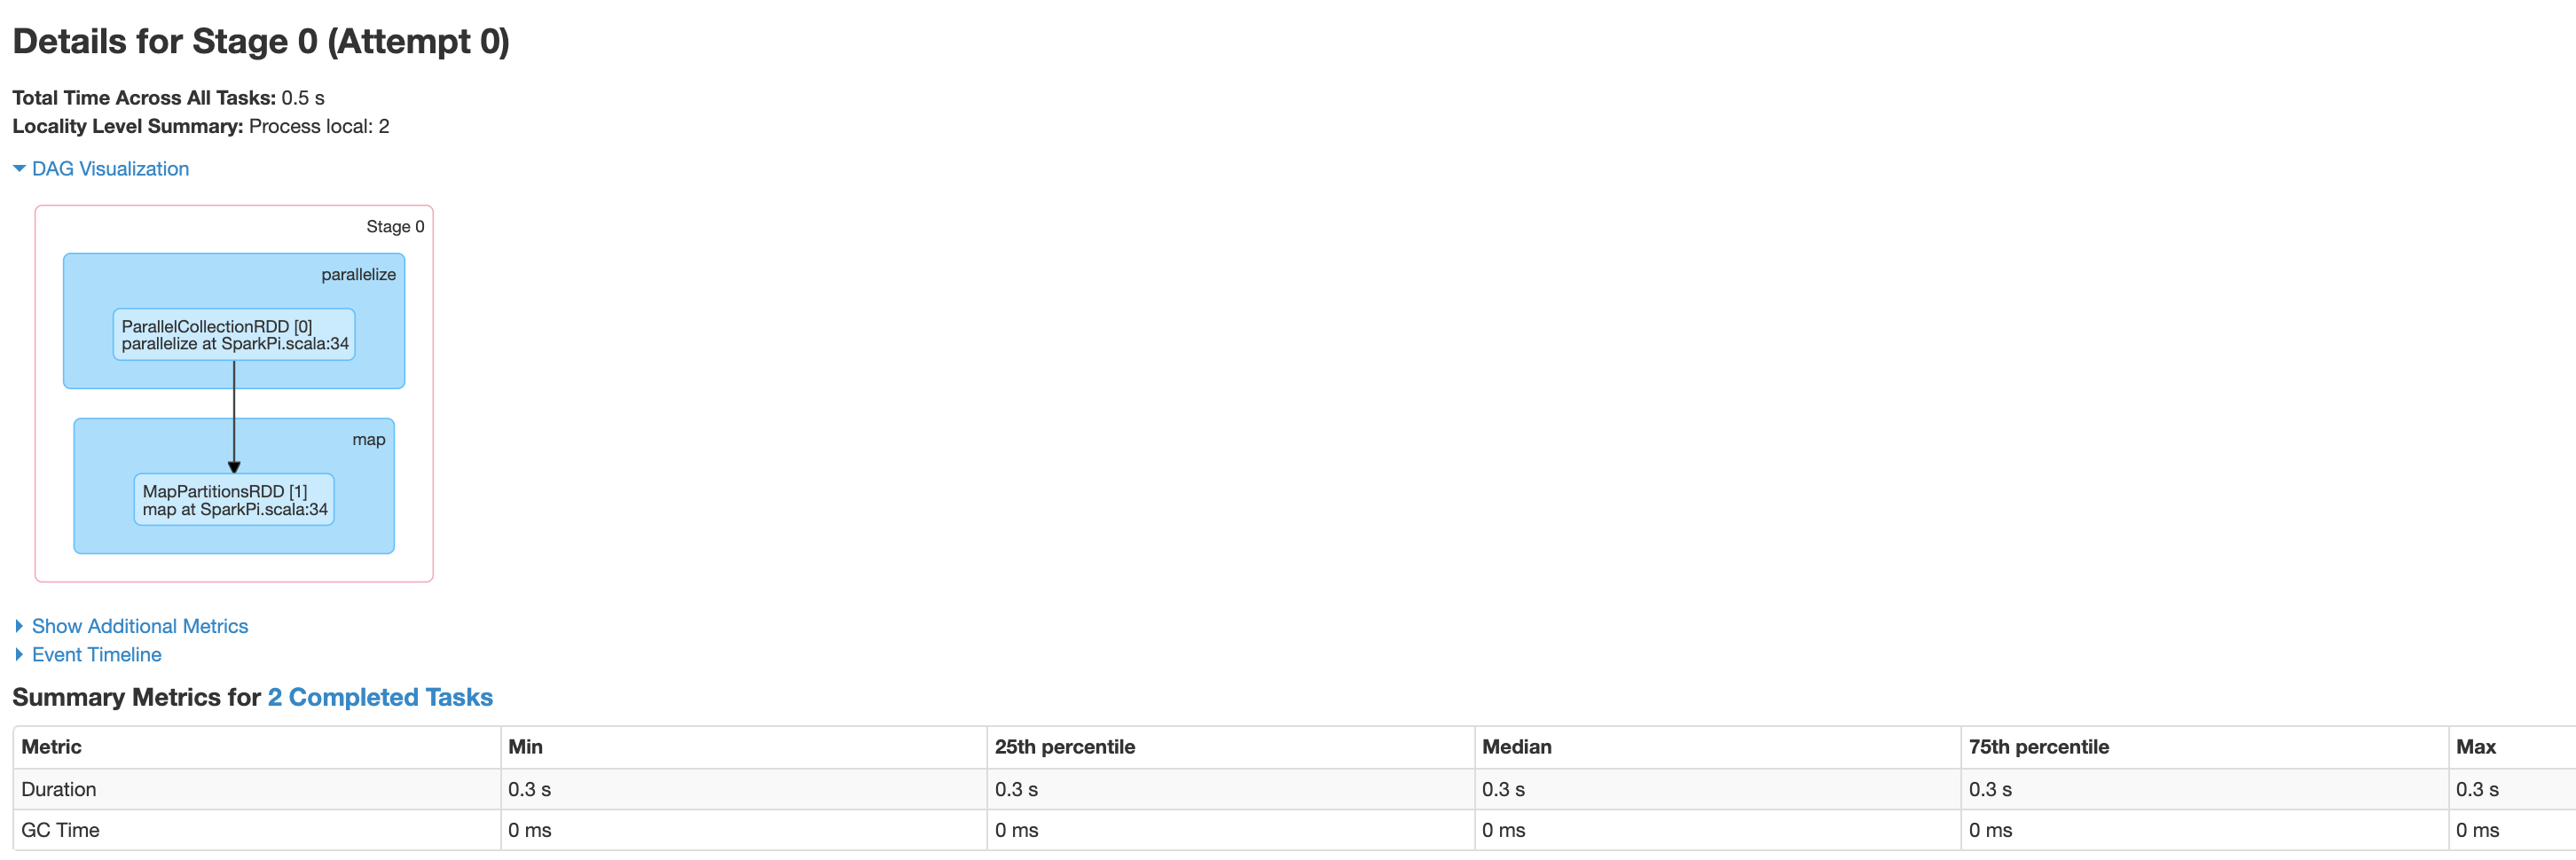
הקטע Stage Details כולל תצוגה חזותית של DAG, ציר זמן של אירועים ומדדים למשימות שבשלב. אתם יכולים להשתמש בדף הזה כדי לפתור בעיות שקשורות למשימות שנתקעו, עיכובים בתזמון ושגיאות שנובעות מאין זיכרון פנוי (OOM). הכלי להמחשה חזותית של DAG מציג את שורת הקוד שממנה נגזר השלב, וכך עוזר לכם לעקוב אחרי בעיות בחזרה לקוד.
לוחצים על הכרטיסייה Executors כדי לקבל מידע על צומתי ה-driver וה-executor של אפליקציית Spark.
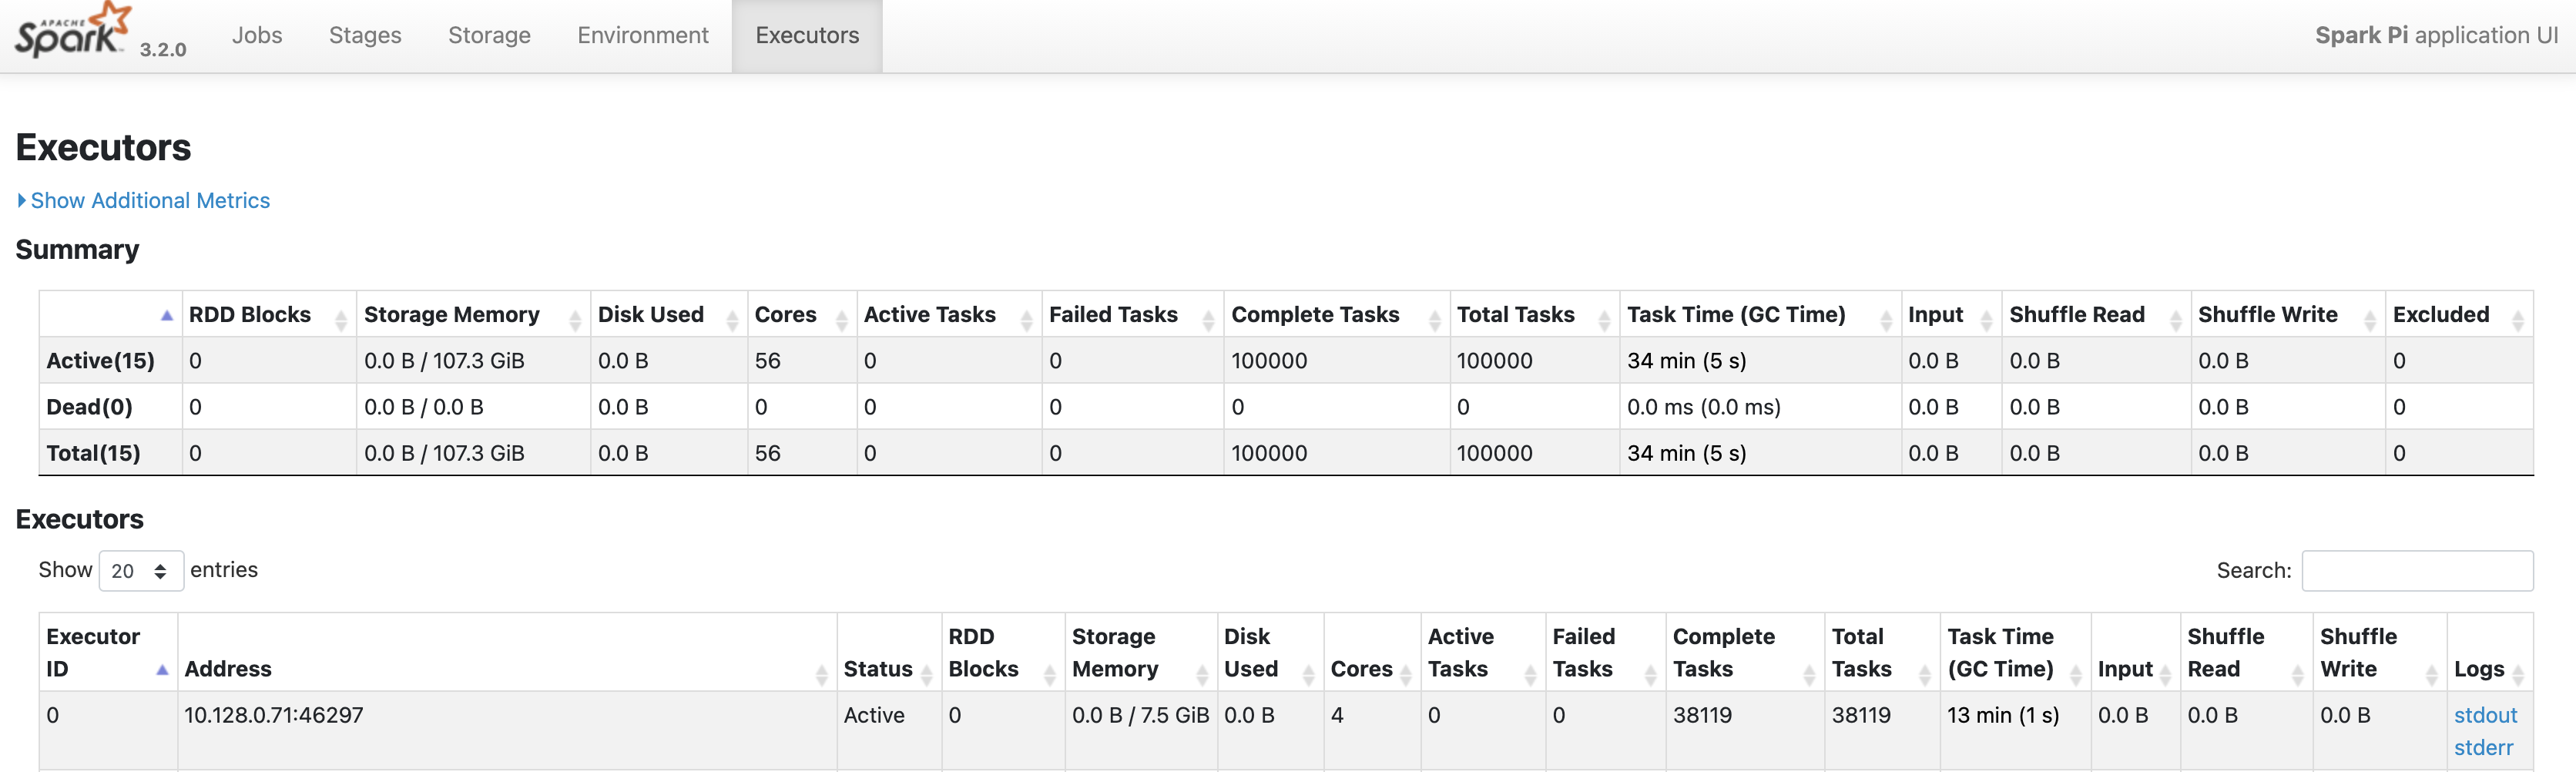
המידע החשוב בדף הזה כולל את מספר הליבות ומספר המשימות שהופעלו בכל מפעיל.
ממשק האינטרנט של Tez
Tez הוא מנוע ברירת המחדל להרצה של Hive ו-Pig ב-Managed Service for Apache Spark. כששולחים משימת Hive באשכול משימות של Managed Service for Apache Spark, מופעלת אפליקציית Tez.
אם הגדרתם את Yarn Timeline Service v2 והגדרתם את המאפיין dataproc:yarn.atsv2.bigtable.instance כשיצרתם את אשכולות ה-PHS וה-Managed Service for Apache Spark, YARN כותב את נתוני ציר הזמן של משימות Hive ו-Pig שנוצרו למכונה שצוינה ב-Bigtable, כדי לאחזר ולהציג אותם בממשק האינטרנט של Tez שפועל בשרת ה-PHS.
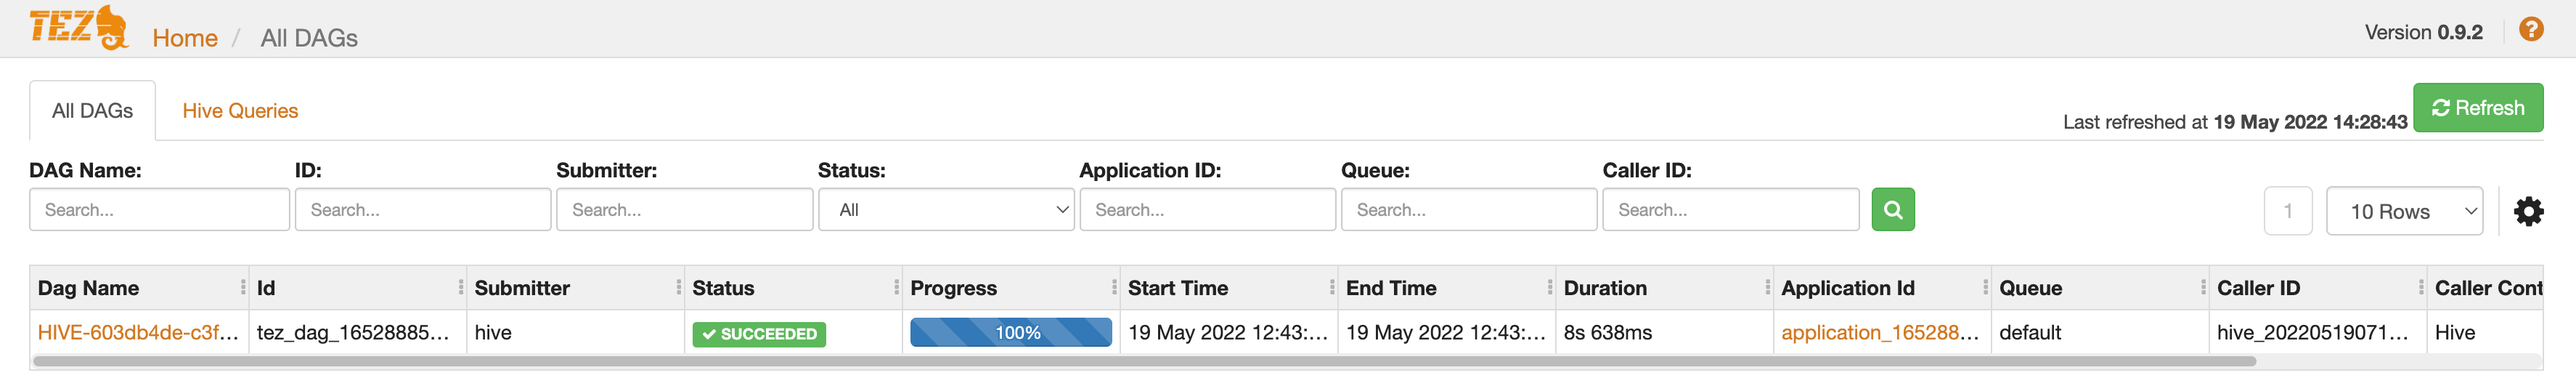
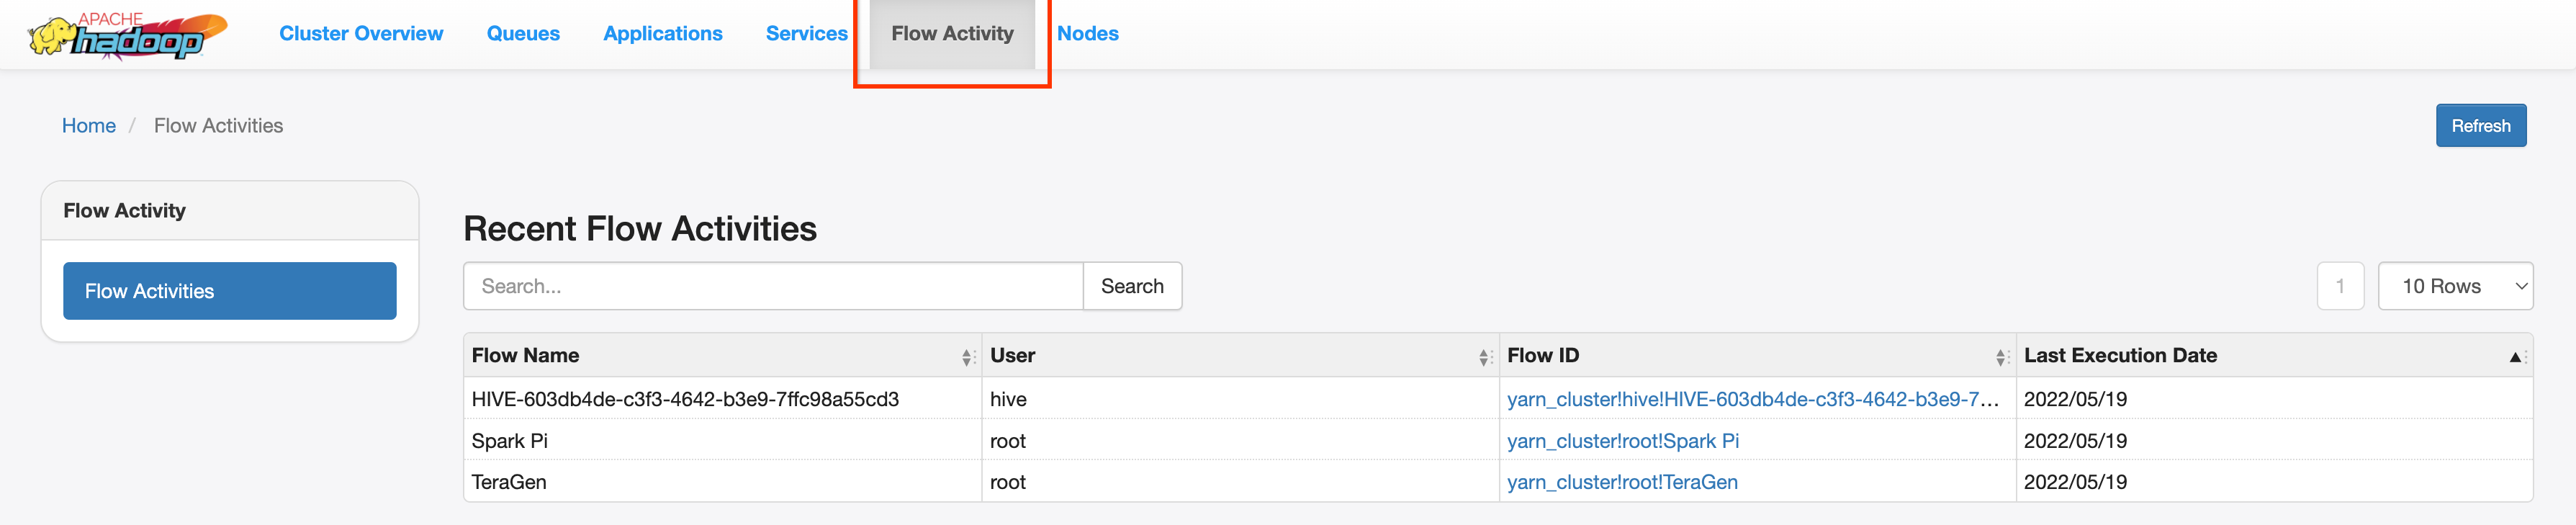
ממשק האינטרנט של YARN Application Timeline V2
אם הגדרתם את Yarn Timeline Service v2 והגדרתם את המאפיין dataproc:yarn.atsv2.bigtable.instance כשיצרתם את אשכולות ה-PHS והמשימות של Managed Service for Apache Spark, YARN כותב את נתוני ציר הזמן של המשימות שנוצרו למכונה שצוינה ב-Bigtable כדי לאחזר ולהציג אותם בממשק האינטרנט של YARN Application Timeline Service שפועל בשרת ה-PHS. המשימות של Managed Service for Apache Spark מופיעות בכרטיסייה Flow Activity בממשק האינטרנט.
הגדרת Yarn Timeline Service v2
כדי להגדיר את Yarn Timeline Service v2, מגדירים מכונה של Bigtable ובודקים את התפקידים של חשבון השירות, לפי הצורך:
בודקים את התפקידים של חשבון השירות, אם צריך. חשבון השירות של המכונה הווירטואלית שמוגדר כברירת מחדל במכונות הווירטואליות של אשכול Dataproc כולל את ההרשאות שנדרשות כדי ליצור ולהגדיר את מכונות Bigtable בשביל YARN Timeline Service. אם אתם יוצרים את המשימה או את אשכול ה-PHS באמצעות חשבון שירות של מכונה וירטואלית בהתאמה אישית, לחשבון צריך להיות התפקיד
AdministratorאוBigtable Userשל Bigtable.
סכימת הטבלה הנדרשת
כדי להשתמש ב-PHS של Managed Service for Apache Spark עם YARN Timeline Service v2, צריך ליצור סכימה ספציפית במכונה של Bigtable. Managed Service for Apache Spark יוצר את הסכימה הנדרשת כשנוצר אשכול של משימות או אשכול PHS, והמאפיין dataproc:yarn.atsv2.bigtable.instance מוגדר להצביע על המכונה של Bigtable.
זו הסכימה הנדרשת של מכונות Bigtable:
| Tables | קבוצות עמודות |
|---|---|
| prod.timelineservice.application | c,i,m |
| prod.timelineservice.app_flow | m |
| prod.timelineservice.entity | c,i,m |
| prod.timelineservice.flowactivity | i |
| prod.timelineservice.flowrun | i |
| prod.timelineservice.subapplication | c,i,m |
איסוף אשפה של Bigtable
אפשר להגדיר איסוף אשפה ב-Bigtable לפי גיל בטבלאות ATSv2:
מתקינים את cbt (כולל יצירת
.cbrtc file).יוצרים את מדיניות איסוף הזבל מבוססת-הגיל של ATSv2:
export NUMBER_OF_DAYS = number \
cbt setgcpolicy prod.timelineservice.application c maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.application i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.application m maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.app_flow m maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.entity c maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.entity i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.entity m maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.flowactivity i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.flowrun i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.subapplication c maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.subapplication i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.subapplication m maxage=${NUMBER_OF_DAYS}
הערות:
NUMBER_OF_DAYS: מספר הימים המקסימלי הוא 30d.