


O ajuste automático do Serviço Gerenciado para Apache Spark permite otimizar cargas de trabalho em lote recorrentes para desempenho e resiliência sem configuração manual. Em vez de exigir que você avalie parâmetros complexos do Spark, o ajuste automático analisa as execuções anteriores (chamadas de coortes) e aplica automaticamente as configurações com base nas práticas recomendadas do Spark.
Neste documento, fornecemos informações sobre o ajuste automático de cargas de trabalho em lote do Serviço Gerenciado para Apache Spark. Otimizar uma carga de trabalho do Spark para desempenho e resiliência pode ser desafiador devido ao número de opções de configuração do Spark e à dificuldade de avaliar como essas opções afetam uma carga de trabalho. O ajuste automático do Serviço Gerenciado para Apache Spark oferece uma alternativa à configuração manual de cargas de trabalho, aplicando automaticamente as configurações do Spark a uma carga de trabalho recorrente do Spark com base nas práticas recomendadas de otimização do Spark e em uma análise das execuções de carga de trabalho (chamadas de "coortes").
Inscreva-se no ajuste automático do Serviço Gerenciado para Apache Spark
Para se inscrever e ter acesso à versão de pré-lançamento do ajuste automático do Serviço Gerenciado para Apache Spark descrita nesta página, preencha e envie o formulário de inscrição Solicitação de acesso à pré-lançamento do Serviço Gerenciado para Apache Spark. Depois que o formulário for aprovado, os projetos listados nele terão acesso aos recursos em fase de pré-lançamento.
Vantagens
O ajuste automático do Serviço Gerenciado para Apache Spark pode oferecer os seguintes benefícios:
- Otimização automática: ajuste automaticamente as configurações ineficientes do lote do Serviço Gerenciado para Apache Spark e do Spark, o que pode acelerar os tempos de execução dos jobs.
- Aprendizado histórico: aprenda com execuções recorrentes para aplicar recomendações personalizadas para sua carga de trabalho.
Coortes de ajuste automático
O ajuste automático é aplicado a execuções recorrentes (coortes) de uma carga de trabalho em lote.
O nome da coorte que você especifica ao enviar uma carga de trabalho em lote a identifica como uma das execuções sucessivas da carga de trabalho recorrente.
O ajuste automático é aplicado às coortes de carga de trabalho em lote da seguinte maneira:
O ajuste automático é calculado e aplicado à segunda coorte e às seguintes de uma carga de trabalho. O ajuste automático não é aplicado à primeira execução de uma carga de trabalho recorrente, porque o ajuste automático do Serviço Gerenciado para Apache Spark usa o histórico de cargas de trabalho para otimização.
O ajuste automático não é aplicado retroativamente às cargas de trabalho em execução, mas apenas às cargas de trabalho recém-enviadas.
O ajuste automático aprende e melhora ao longo do tempo analisando as estatísticas de coorte. Para permitir que o sistema colete dados suficientes, recomendamos manter o ajuste automático ativado por pelo menos cinco execuções.
Nomes de coorte: uma prática recomendada é usar nomes de coorte que ajudem a
identificar o tipo de carga de trabalho recorrente. Por exemplo, é possível usar
daily_sales_aggregation como o nome da coorte para uma carga de trabalho programada que executa
uma tarefa diária de agregação de vendas.
Cenários de ajuste automático
Quando aplicável, o ajuste automático seleciona e executa automaticamente os seguintes
scenarios ou metas para otimizar uma carga de trabalho em lote:
- Escalonamento: configurações de escalonamento automático do Spark.
- Otimização de mesclagem: configurações do Spark para otimizar o desempenho da mesclagem de transmissão SQL.
- Partições de embaralhamento: configurações do Spark para ajustar as partições de embaralhamento.
Usar o ajuste automático do Serviço Gerenciado para Apache Spark
É possível ativar o ajuste automático do Serviço Gerenciado para Apache Spark em uma carga de trabalho em lote usando o console do Google Cloud , a Google Cloud CLI, a API Dataproc ou as bibliotecas de cliente do Cloud.
Console
Para ativar o ajuste automático do Serviço Gerenciado para Apache Spark em cada envio de uma carga de trabalho em lote recorrente, siga estas etapas:
No console do Google Cloud , acesse a página Lotes do Serviço Gerenciado para Apache Spark.
Para criar uma carga de trabalho em lote, clique em Criar.
Na seção Ajuste automático:
Ative o botão Ativar para ativar o ajuste automático na carga de trabalho do Spark.
Coorte:preencha o nome da coorte, que identifica o lote como uma de uma série de cargas de trabalho recorrentes. O ajuste automático é aplicado à segunda carga de trabalho e às seguintes que são enviadas com esse nome de coorte. Por exemplo, especifique
daily_sales_aggregationcomo o nome da coorte para uma carga de trabalho em lote programada que executa uma tarefa diária de agregação de vendas.
Preencha as outras seções da página Criar lote conforme necessário e clique em Enviar. Para mais informações sobre esses campos, consulte Enviar uma carga de trabalho em lote.
gcloud
Para ativar o ajuste automático do Serviço Gerenciado para Apache Spark em cada envio de uma
carga de trabalho em lote recorrente, execute o seguinte comando
gcloud dataproc batches submit
da CLI gcloud localmente em uma janela do terminal ou no
Cloud Shell.
gcloud dataproc batches submit COMMAND \
    --region=REGION \
    --cohort=COHORT \
    --autotuning-scenarios=auto  \
    other arguments ...
Substitua:
- COMMAND: o tipo de carga de trabalho do Spark, como
Spark,PySpark,Spark-SqlouSpark-R. - REGION: a região em que a carga de trabalho em lote será executada.
- COHORT: o nome da coorte, que
identifica o lote como uma de uma série de cargas de trabalho recorrentes.
O ajuste automático é aplicado à segunda carga de trabalho e às seguintes que são
enviadas com esse nome de coorte. Por exemplo, especifique
daily_sales_aggregationcomo o nome da coorte para uma carga de trabalho em lote programada que executa uma tarefa diária de agregação de vendas. --autotuning-scenarios=auto: ativa o ajuste automático.
API
Para ativar o ajuste automático do Serviço Gerenciado para Apache Spark em cada envio de uma carga de trabalho em lote recorrente, envie uma solicitação batches.create que inclua os seguintes campos:
RuntimeConfig.cohort: o nome da coorte, que identifica o lote como uma de uma série de cargas de trabalho recorrentes. A otimização automática é aplicada à segunda carga de trabalho e às seguintes enviadas com esse nome de coorte. Por exemplo, especifiquedaily_sales_aggregationcomo o nome da coorte para uma carga de trabalho em lote programada que executa uma tarefa diária de agregação de vendas.AutotuningConfig.scenarios: especifiqueAUTOpara ativar o ajuste automático na carga de trabalho em lote do Spark.
Exemplo:
...
runtimeConfig:
  cohort: COHORT_NAME
  autotuningConfig:
    scenarios:
    - AUTO
...
Java
Antes de testar este exemplo, siga as instruções de configuração do Java no Guia de início rápido do Serviço Gerenciado para Apache Spark: como usar bibliotecas de cliente. Para mais informações, consulte a documentação de referência da API Java do Serviço Gerenciado para Apache Spark.
Para autenticar no Serviço Gerenciado para Apache Spark, configure o Application Default Credentials. Para mais informações, consulte Configurar a autenticação para um ambiente de desenvolvimento local.
Para ativar o ajuste automático do Serviço Gerenciado para Apache Spark em cada envio de uma carga de trabalho em lote recorrente, chame BatchControllerClient.createBatch com um CreateBatchRequest que inclua os seguintes campos:
Batch.RuntimeConfig.cohort: o nome da coorte, que identifica o lote como uma de uma série de cargas de trabalho recorrentes. A otimização automática é aplicada à segunda carga de trabalho e às seguintes enviadas com esse nome de coorte. Por exemplo, é possível especificardaily_sales_aggregationcomo o nome da coorte para uma carga de trabalho em lote programada que executa uma tarefa diária de agregação de vendas.Batch.RuntimeConfig.AutotuningConfig.scenarios: especifiqueAUTOpara ativar o ajuste automático na carga de trabalho em lote do Spark.
Exemplo:
...
Batch batch =
  Batch.newBuilder()
    .setRuntimeConfig(
      RuntimeConfig.newBuilder()
        .setCohort("daily_sales_aggregation")
        .setAutotuningConfig(
          AutotuningConfig.newBuilder()
            .addScenarios(Scenario.AUTO))
    ...
  .build();

batchControllerClient.createBatch(
    CreateBatchRequest.newBuilder()
        .setParent(parent)
        .setBatchId(batchId)
        .setBatch(batch)
        .build());
...
Para usar a API, é necessário usar a versão 4.43.0 ou mais recente da biblioteca de cliente google-cloud-dataproc. Use uma das configurações a seguir para adicionar a
biblioteca ao seu projeto.
Maven
<dependencies>
 <dependency>
   <groupId>com.google.cloud</groupId>
   <artifactId>google-cloud-dataproc</artifactId>
   <version>4.43.0</version>
 </dependency>
</dependencies>
Gradle
implementation 'com.google.cloud:google-cloud-dataproc:4.43.0'
SBT
libraryDependencies += "com.google.cloud" % "google-cloud-dataproc" % "4.43.0"
Python
Antes de testar este exemplo, siga as instruções de configuração do Python no Guia de início rápido do Serviço Gerenciado para Apache Spark: como usar bibliotecas de cliente. Para mais informações, consulte a documentação de referência da API Python do Serviço Gerenciado para Apache Spark.
Para autenticar no Serviço Gerenciado para Apache Spark, configure o Application Default Credentials. Para mais informações, consulte Configurar a autenticação para um ambiente de desenvolvimento local.
Para ativar o ajuste automático do Serviço Gerenciado para Apache Spark em cada envio de uma carga de trabalho em lote recorrente, chame BatchControllerClient.create_batch com um Batch que inclua os seguintes campos:
batch.runtime_config.cohort: o nome da coorte, que identifica o lote como uma de uma série de cargas de trabalho recorrentes. A otimização automática é aplicada à segunda carga de trabalho e às seguintes enviadas com esse nome de coorte. Por exemplo, é possível especificardaily_sales_aggregationcomo o nome da coorte para uma carga de trabalho em lote programada que executa uma tarefa diária de agregação de vendas.batch.runtime_config.autotuning_config.scenarios: especifiqueAUTOpara ativar o ajuste automático na carga de trabalho em lote do Spark.
Exemplo:
# Create a client
client = dataproc_v1.BatchControllerClient()

# Initialize request argument(s)
batch = dataproc_v1.Batch()
batch.pyspark_batch.main_python_file_uri = "gs://bucket/run_tpcds.py"
batch.runtime_config.cohort = "daily_sales_aggregation"
batch.runtime_config.autotuning_config.scenarios = [
    Scenario.AUTO
]

request = dataproc_v1.CreateBatchRequest(
    parent="parent_value",
    batch=batch,
)

# Make the request
operation = client.create_batch(request=request)
Para usar a API, é necessário usar a versão 5.10.1 ou posterior da biblioteca de cliente google-cloud-dataproc. Para adicioná-la ao projeto, use o seguinte requisito:
google-cloud-dataproc>=5.10.1
Airflow
Em vez de enviar cada coorte de lote com ajuste automático manualmente, use o Airflow para programar o envio de cada carga de trabalho em lote recorrente. Para fazer isso, chame BatchControllerClient.create_batch com um Batch que inclua os seguintes campos:
batch.runtime_config.cohort: o nome da coorte, que identifica o lote como uma das séries de cargas de trabalho recorrentes. A otimização automática é aplicada à segunda carga de trabalho e às seguintes enviadas com esse nome de coorte. Por exemplo, é possível especificardaily_sales_aggregationcomo o nome da coorte para uma carga de trabalho em lote programada que executa uma tarefa diária de agregação de vendas.batch.runtime_config.autotuning_config.scenarios: especifiqueAUTOpara ativar o ajuste automático na carga de trabalho em lote do Spark.
Exemplo:
create_batch = DataprocCreateBatchOperator(
    task_id="batch_create",
    batch={
        "pyspark_batch": {
            "main_python_file_uri": PYTHON_FILE_LOCATION,
        },
        "environment_config": {
            "peripherals_config": {
                "spark_history_server_config": {
                    "dataproc_cluster": PHS_CLUSTER_PATH,
                },
            },
        },
        "runtime_config": {
            "cohort": "daily_sales_aggregation",
            "autotuning_config": {
                "scenarios": [
                    Scenario.AUTO,
                ]
            }
        },
    },
    batch_id="BATCH_ID",
)
Para usar a API, é necessário usar a versão 5.10.1 ou posterior da biblioteca de cliente google-cloud-dataproc. Use o seguinte requisito de ambiente do Airflow:
google-cloud-dataproc>=5.10.1
Para atualizar o pacote no Serviço Gerenciado para Apache Airflow, consulte Instalar dependências do Python para o Airflow Gerenciado .
Ver mudanças de ajuste automático
Para conferir as mudanças de ajuste automático do Serviço Gerenciado para Apache Spark em uma carga de trabalho em lote,
execute o comando
gcloud dataproc batches describe.
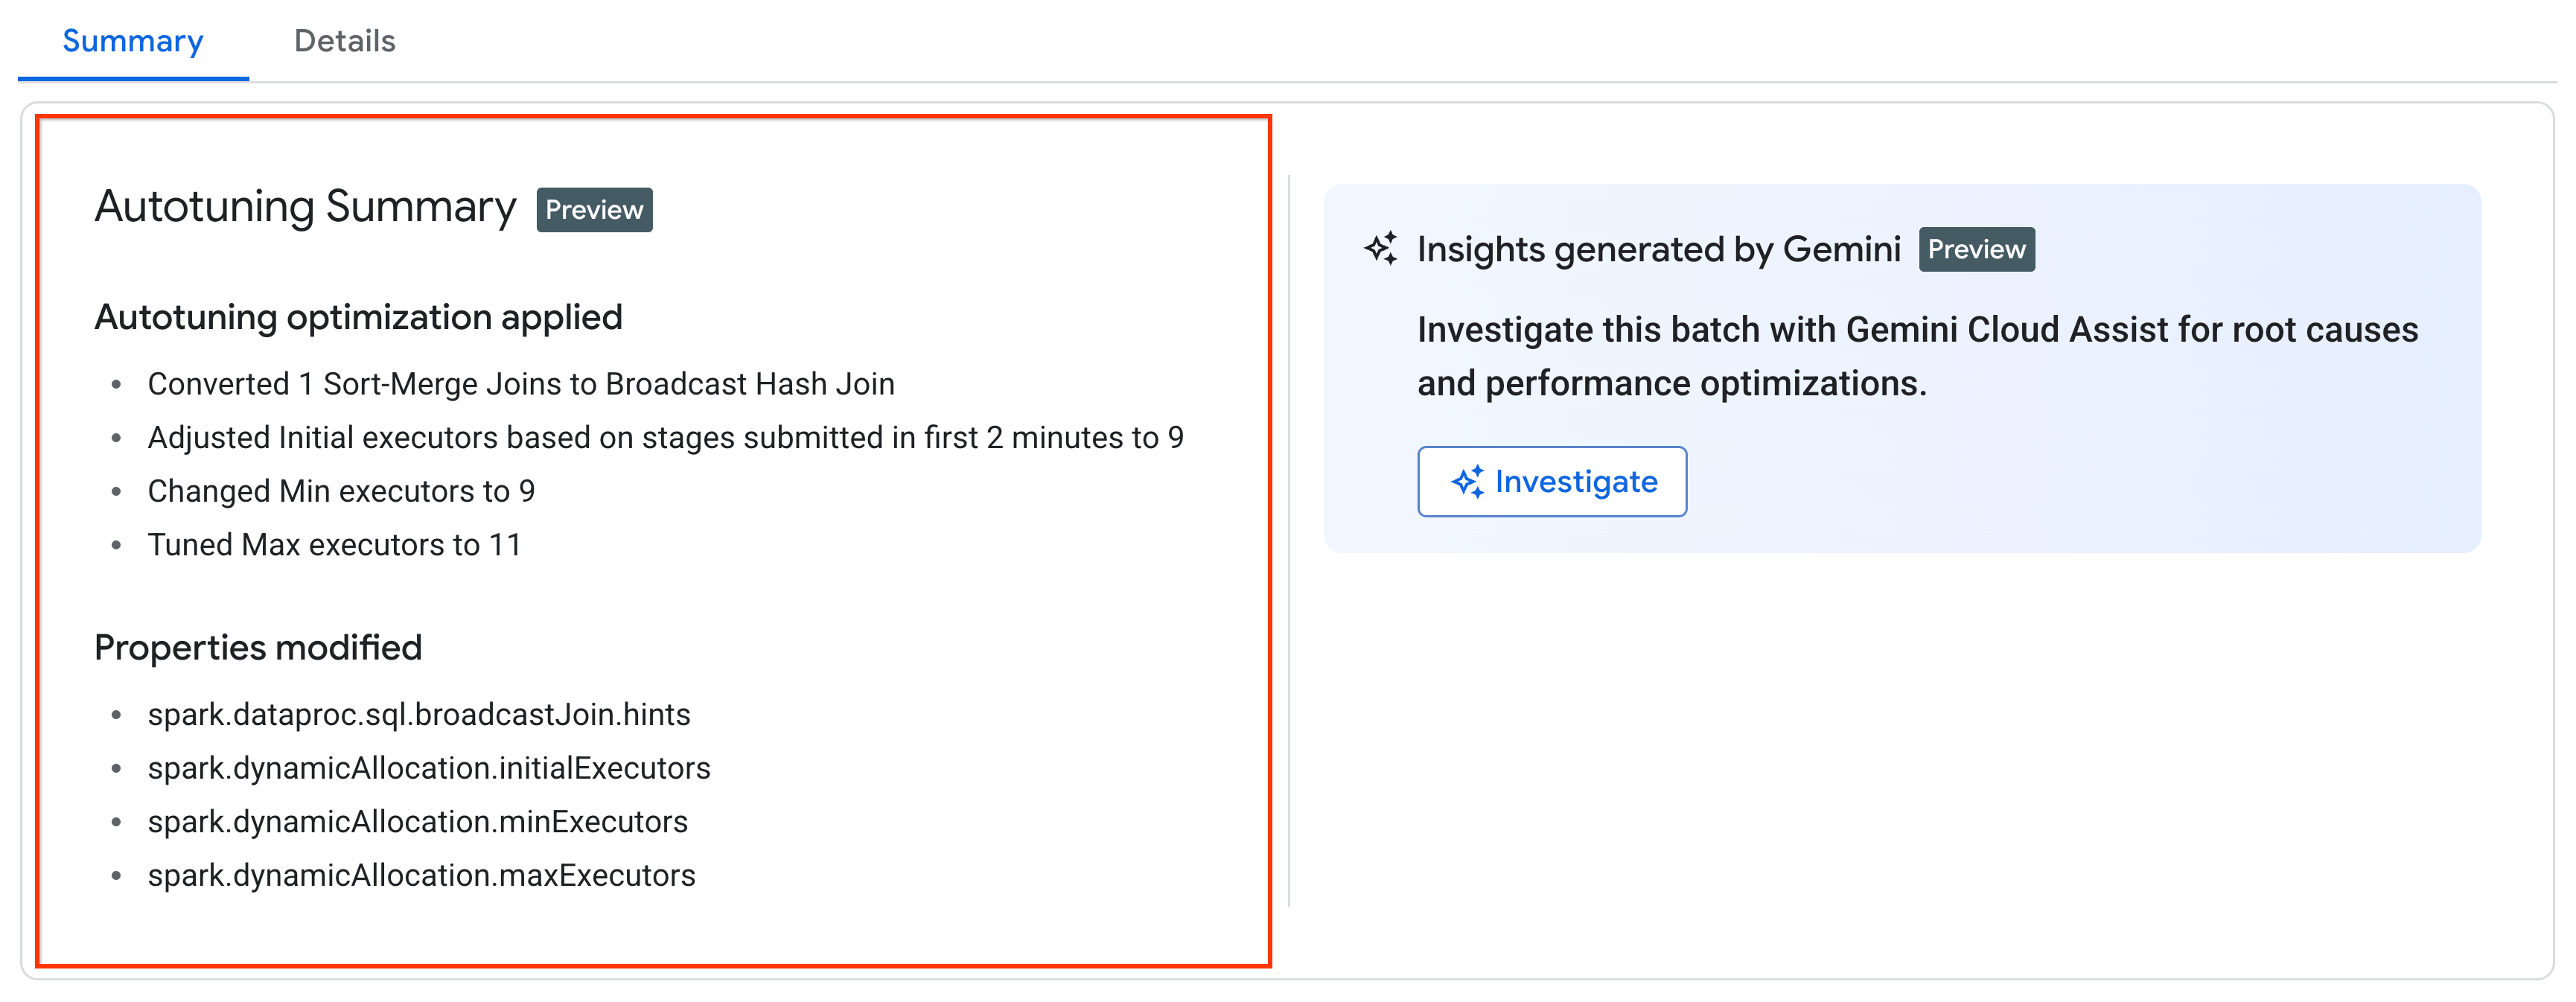
Exemplo: a saída de gcloud dataproc batches describe é semelhante a esta:
...
runtimeInfo:
  propertiesInfo:
    # Properties set by autotuning.
    autotuningProperties:
      spark.dataproc.sql.broadcastJoin.hints:
        annotation: Converted 1 Sort-Merge Joins to Broadcast Hash Join
        value: v2;Inner,<hint>
      spark.dynamicAllocation.initialExecutors:
        annotation: Adjusted Initial executors based on stages submitted in first
          2 minutes to 9
        overriddenValue: '2'
        value: '9'
      spark.dynamicAllocation.maxExecutors:
        annotation: Tuned Max executors to 11
        overriddenValue: '5'
        value: '11'
      spark.dynamicAllocation.minExecutors:
        annotation: Changed Min executors to 9
        overriddenValue: '2'
        value: '9'
...
É possível conferir as mudanças mais recentes de ajuste automático que foram aplicadas a uma carga de trabalho em execução, concluída ou com falha na página Detalhes do lote no console do Google Cloud , na guia Resumo.
Preços
O ajuste automático do Serviço Gerenciado para Apache Spark é oferecido durante o pré-lançamento particular sem custo financeiro adicional. Os preços padrão do Serviço Gerenciado para Apache Spark se aplicam.