


הכוונון האוטומטי של Managed Service for Apache Spark מאפשר לכם לבצע אופטימיזציה של עומסי עבודה חוזרים (recurring) באצווה, כדי לשפר את הביצועים והעמידות בלי הגדרה ידנית. במקום שתצטרכו להעריך פרמטרים מורכבים של Spark, הכוונון האוטומטי מנתח הפעלות קודמות (שנקראות קבוצות משתמשים) ומחיל באופן אוטומטי הגדרות שמבוססות על השיטות המומלצות של Spark.
במאמר הזה מוסבר איך להשתמש בכוונון אוטומטי של עומסי עבודה באצווה ב-Managed Service for Apache Spark. יכול להיות שיהיה קשה לבצע אופטימיזציה של עומס עבודה ב-Spark לביצועים ולעמידות, בגלל מספר אפשרויות ההגדרה של Spark והקושי להעריך איך האפשרויות האלה משפיעות על עומס העבודה. הכוונון האוטומטי של Managed Service for Apache Spark מספק חלופה להגדרה ידנית של עומסי עבודה, על ידי החלה אוטומטית של הגדרות Spark על עומס עבודה חוזר של Spark, על סמך שיטות מומלצות לאופטימיזציה של Spark וניתוח של הרצות של עומסי עבודה (שנקראות "קבוצות").
הרשמה לכוונון אוטומטי של Managed Service for Apache Spark
כדי להירשם לגישה לגרסת בטא של הכוונון האוטומטי ב-Managed Service for Apache Spark שמתוארת בדף הזה, צריך למלא ולשלוח את טופס ההרשמה Managed Service for Apache Spark Preview access request. אחרי שהטופס יאושר, לפרויקטים שרשומים בטופס תהיה גישה לתכונות בגרסת טרום-השקה (Preview).
יתרונות
הכוונון האוטומטי של Managed Service for Apache Spark יכול לספק את היתרונות הבאים:
- אופטימיזציה אוטומטית: התאמה אוטומטית של הגדרות לא יעילות של Spark ושל אצוות ב-Managed Service for Apache Spark, כדי לקצר את זמני הריצה של המשימות.
- למידה היסטורית: למידה מהרצות חוזרות כדי ליישם המלצות שמותאמות לעומס העבודה.
קבוצות של משתמשים בעלי מאפיינים משותפים לכוונון אוטומטי
הכוונון האוטומטי מופעל על הפעלות חוזרות (קבוצות בעלות מאפיינים משותפים) של עומס עבודה באצווה.
שם הקבוצה שאתם מציינים כשאתם שולחים עומס עבודה באצווה מזהה אותו כאחת מההרצות העוקבות של עומס העבודה החוזר.
הכוונון האוטומטי מופעל על קבוצות של עומסי עבודה באצווה באופן הבא:
הכוונון האוטומטי מחושב ומוחל על הקבוצה השנייה והקבוצות הבאות של עומס העבודה. הכוונון האוטומטי לא מופעל בהרצה הראשונה של עומס עבודה חוזר, כי הכוונון האוטומטי של Managed Service for Apache Spark משתמש בהיסטוריית עומסי העבודה לצורך אופטימיזציה.
הכוונון האוטומטי לא חל רטרואקטיבית על עומסי עבודה שפועלים, אלא רק על עומסי עבודה חדשים שנשלחים.
הכוונון האוטומטי לומד ומשתפר לאורך זמן על ידי ניתוח הנתונים הסטטיסטיים של הקבוצה. כדי לאפשר למערכת לאסוף מספיק נתונים, מומלץ להשאיר את הכוונון האוטומטי מופעל למשך חמש הפעלות לפחות.
שמות של קבוצות: מומלץ להשתמש בשמות של קבוצות שעוזרים לזהות את סוג עומס העבודה החוזר. לדוגמה, אפשר להשתמש ב-daily_sales_aggregation בתור שם הקבוצה של עומס עבודה מתוזמן שמריץ משימה יומית של צבירת נתוני מכירות.
תרחישים של כוונון אוטומטי
במקרים הרלוונטיים, הכוונון האוטומטי בוחר ומפעיל באופן אוטומטי את scenarios או היעדים הבאים כדי לבצע אופטימיזציה של עומס עבודה באצווה:
- Scaling: הגדרות ההתאמה האוטומטית של Spark לעומס.
- Join optimization: הגדרות Spark לאופטימיזציה של ביצועי SQL broadcast join.
- Shuffle partitions: הגדרות Spark לכוונון מחיצות ערבוב.
שימוש בכוונון אוטומטי ב-Managed Service for Apache Spark
אפשר להפעיל את הכוונון האוטומטי של Managed Service for Apache Spark בעומס עבודה באצווה באמצעות מסוף Google Cloud , ה-CLI של Google Cloud, Dataproc API או ספריות הלקוח ב-Cloud.
המסוף
כדי להפעיל את הכוונון האוטומטי של Managed Service for Apache Spark בכל שליחה של עומס עבודה חוזר (recurring) באצווה, מבצעים את השלבים הבאים:
נכנסים לדף Jobs של Managed Service for Apache Spark במסוף Google Cloud .
כדי ליצור עומס עבודה באצווה, לוחצים על Submit job כדי לפתוח את הדף Submit a job.
בקטע Select compute type for job, מוודאים שהאפשרות Serverless Spark מסומנת.
בקטע Serverless job details:
- מציינים מזהה משימה או מאשרים את מזהה ברירת המחדל.
- בוחרים פרופיל זמן ריצה (או משאירים את הגדרת ברירת המחדל של השירות לאזור שלכם), ואז לוחצים על Configure בכרטיס Summary (או לוחצים על Create new profile בתפריט Runtime profile) כדי לפתוח את חלונית ההגדרות של פרופיל זמן הריצה.
- בחלונית ההגדרות של פרופיל סביבת זמן הריצה, מרחיבים את Additional configuration ולוחצים על Edit לצד Other customizations.
בחלונית התאמות אישיות אחרות, בקטע כוונון אוטומטי:
- לוחצים על המתג Enable כדי להפעיל את הכוונון האוטומטי של עומס העבודה באצווה של Spark.
- Cohort ID: מזהה הקבוצה, שמזהה את ה-batch כאחד מסדרה של עומסי עבודה חוזרים.
הכוונון האוטומטי מופעל על עומסי העבודה השני והבאים אחריו שנשלחים עם מזהה הקבוצה הזה. לדוגמה, אפשר לציין את הערך
daily_sales_aggregationכמזהה קבוצת המשתמשים של עומס עבודה באצווה מתוזמנת, שמריץ משימה יומית של צבירת נתוני מכירות.
לוחצים על Save בחלונית Other customizations, ואז לוחצים על Use configuration (או על Save new profile) בחלונית ההגדרות של פרופיל זמן הריצה.
ממלאים את הקטעים Files and artifacts ו-Job execution and properties בדף Submit a job לפי הצורך, ולוחצים על Submit. למידע נוסף על השדות האלה, קראו את המאמר שליחת עומס עבודה באצווה.
gcloud
כדי להפעיל את הכוונון האוטומטי של Managed Service for Apache Spark בכל שליחה של עומס עבודה חוזר באצווה, מריצים את הפקודה הבאה של ה-CLI של gcloud gcloud dataproc batches submit באופן מקומי בחלון הטרמינל או ב-Cloud Shell.
gcloud dataproc batches submit COMMAND \
    --region=REGION \
    --cohort=COHORT \
    --autotuning-scenarios=auto  \
    other arguments ...
מחליפים את מה שכתוב בשדות הבאים:
- COMMAND: הסוג של עומס העבודה ב-Spark, למשל
Spark, PySpark, Spark-SqlאוSpark-R. - REGION: האזור שבו יפעל עומס העבודה באצווה.
- COHORT: שם הקבוצה בעלת המאפיינים המשותפים, שמזהה את ה-batch כאחד מסדרה של עומסי עבודה חוזרים.
הכוונון האוטומטי מופעל על עומסי העבודה השני והבאים אחריו שנשלחים עם שם הקבוצה הזו. לדוגמה, אפשר לציין את השם
daily_sales_aggregationלקבוצת משתמשים של עומס עבודה מתוזמן באצווה שמריץ משימה יומית של צבירת נתוני מכירות.
--autotuning-scenarios=auto: הפעלת הכוונון האוטומטי.
API
כדי להפעיל את הכוונון האוטומטי של Managed Service for Apache Spark בכל שליחה של עומס עבודה חוזר באצווה, שולחים בקשת batches.create שכוללת את השדות הבאים:
-
RuntimeConfig.cohort: שם הקבוצה בעלת המאפיינים המשותפים, שמזהה את ה-batch כאחד מסדרה של עומסי עבודה חוזרים. הכוונון האוטומטי מופעל על עומסי העבודה השני והבאים אחריו שנשלחים עם שם הקבוצה הזה. לדוגמה, אפשר לציין את השםdaily_sales_aggregationלקבוצה של עומס עבודה באצווה מתוזמנת, שמריצה משימה יומית של צבירת נתוני מכירות.
AutotuningConfig.scenarios: מציינים את הערךAUTOכדי להפעיל את הכוונון האוטומטי בעומס העבודה של Spark באצווה.
דוגמה:
...
runtimeConfig:
  cohort: COHORT_NAME
  autotuningConfig:
    scenarios:
    - AUTO
...
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במדריך למתחילים של Managed Service for Apache Spark באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של Managed Service for Apache Spark Java API.
כדי לבצע אימות ב-Managed Service for Apache Spark, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
כדי להפעיל את הכוונון האוטומטי של Managed Service for Apache Spark בכל שליחה של עומס עבודה חוזר באצווה, מפעילים את BatchControllerClient.createBatch עם CreateBatchRequest שכולל את השדות הבאים:
-
Batch.RuntimeConfig.cohort: השם של הקבוצה, שמזהה את האצווה כאחת מסדרה של עומסי עבודה חוזרים. הכוונון האוטומטי מופעל על עומסי העבודה השני והבאים אחריו שנשלחים עם שם הקבוצה הזה. לדוגמה, אפשר לציין את הערךdaily_sales_aggregationבתור שם הקבוצה של עומס עבודה מתוזמן באצווה שמריץ משימה יומית של צבירת נתוני מכירות.
Batch.RuntimeConfig.AutotuningConfig.scenarios: מציינים את הערךAUTOכדי להפעיל את הכוונון האוטומטי בעומס העבודה של Spark באצווה.
דוגמה:
...
Batch batch =
  Batch.newBuilder()
    .setRuntimeConfig(
      RuntimeConfig.newBuilder()
        .setCohort("daily_sales_aggregation")
        .setAutotuningConfig(
          AutotuningConfig.newBuilder()
            .addScenarios(Scenario.AUTO))
    ...
  .build();

batchControllerClient.createBatch(
    CreateBatchRequest.newBuilder()
        .setParent(parent)
        .setBatchId(batchId)
        .setBatch(batch)
        .build());
...
כדי להשתמש ב-API, צריך להשתמש בגרסה 4.43.0 ומעלה של ספריית הלקוח של google-cloud-dataproc. כדי להוסיף את הספרייה לפרויקט, אפשר להשתמש באחת מההגדרות הבאות.
Maven
<dependencies>
 <dependency>
   <groupId>com.google.cloud</groupId>
   <artifactId>google-cloud-dataproc</artifactId>
   <version>4.43.0</version>
 </dependency>
</dependencies>
Gradle
implementation 'com.google.cloud:google-cloud-dataproc:4.43.0'
SBT
libraryDependencies += "com.google.cloud" % "google-cloud-dataproc" % "4.43.0"
Python
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Python במדריך למתחילים של Managed Service for Apache Spark באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של Managed Service for Apache Spark Python API.
כדי לבצע אימות ב-Managed Service for Apache Spark, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
כדי להפעיל את הכוונון האוטומטי של Managed Service for Apache Spark בכל שליחה של עומס עבודה חוזר באצווה, מפעילים את BatchControllerClient.create_batch עם Batch שכולל את השדות הבאים:
-
batch.runtime_config.cohort: השם של הקבוצה, שמזהה את האצווה כאחת מסדרה של עומסי עבודה חוזרים. הכוונון האוטומטי מופעל על עומסי העבודה השני והבאים אחריו שנשלחים עם שם הקבוצה הזה. לדוגמה, אפשר לציין את הערךdaily_sales_aggregationבתור שם הקבוצה של עומס עבודה מתוזמן באצווה, שמריץ משימה יומית של צבירת נתוני מכירות.
batch.runtime_config.autotuning_config.scenarios: מציינים את הערךAUTOכדי להפעיל את הכוונון האוטומטי בעומס העבודה של Spark באצווה.
דוגמה:
# Create a client
client = dataproc_v1.BatchControllerClient()

# Initialize request argument(s)
batch = dataproc_v1.Batch()
batch.pyspark_batch.main_python_file_uri = "gs://bucket/run_tpcds.py"
batch.runtime_config.cohort = "daily_sales_aggregation"
batch.runtime_config.autotuning_config.scenarios = [
    Scenario.AUTO
]

request = dataproc_v1.CreateBatchRequest(
    parent="parent_value",
    batch=batch,
)

# Make the request
operation = client.create_batch(request=request)
כדי להשתמש ב-API, צריך להשתמש בגרסה 5.10.1 ואילך של ספריית הלקוח של google-cloud-dataproc. כדי להוסיף אותו לפרויקט, אפשר להשתמש בדרישה הבאה:
google-cloud-dataproc>=5.10.1
Airflow
במקום לשלוח ידנית כל קבוצת אצווה שעברה כוונון אוטומטי, אתם יכולים להשתמש ב-Airflow כדי לתזמן את השליחה של כל עומס עבודה חוזר של אצווה. כדי לעשות את זה, קוראים ל-BatchControllerClient.create_batch עם Batch שכולל את השדות הבאים:
-
batch.runtime_config.cohort: השם של הקבוצה, שמזהה את האצווה כאחת מסדרה של עומסי עבודה חוזרים. הכוונון האוטומטי מופעל על עומסי העבודה השני והבאים אחריו שנשלחים עם שם הקבוצה הזה. לדוגמה, אפשר לציין את השםdaily_sales_aggregationלקבוצת משתמשים של עומס עבודה מתוזמן באצווה שמריץ משימה יומית של צבירת נתוני מכירות.
batch.runtime_config.autotuning_config.scenarios: מציינים את הערךAUTOכדי להפעיל את הכוונון האוטומטי בעומס העבודה של Spark באצווה.
דוגמה:
create_batch = DataprocCreateBatchOperator(
    task_id="batch_create",
    batch={
        "pyspark_batch": {
            "main_python_file_uri": PYTHON_FILE_LOCATION,
        },
        "environment_config": {
            "peripherals_config": {
                "spark_history_server_config": {
                    "dataproc_cluster": PHS_CLUSTER_PATH,
                },
            },
        },
        "runtime_config": {
            "cohort": "daily_sales_aggregation",
            "autotuning_config": {
                "scenarios": [
                    Scenario.AUTO,
                ]
            }
        },
    },
    batch_id="BATCH_ID",
)
כדי להשתמש ב-API, צריך להשתמש בגרסה 5.10.1 ואילך של ספריית הלקוח של google-cloud-dataproc. אפשר להשתמש בדרישה הבאה לסביבת Airflow:
google-cloud-dataproc>=5.10.1
כדי לעדכן את החבילה ב-Managed Service for Apache Airflow, קראו את המאמר התקנת יחסי תלות של Python ב-Managed Airflow.
צפייה בשינויים שבוצעו על ידי הכוונון האוטומטי
כדי לראות את השינויים שבוצעו בעקבות הכוונון האוטומטי של Managed Service for Apache Spark בעומס עבודה באצווה, מריצים את הפקודה gcloud dataproc batches describe.
דוגמה: הפלט של gcloud dataproc batches describe דומה לפלט הבא:
...
runtimeInfo:
  propertiesInfo:
    # Properties set by autotuning.
    autotuningProperties:
      spark.dataproc.sql.broadcastJoin.hints:
        annotation: Converted 1 Sort-Merge Joins to Broadcast Hash Join
        value: v2;Inner,<hint>
      spark.dynamicAllocation.initialExecutors:
        annotation: Adjusted Initial executors based on stages submitted in first
          2 minutes to 9
        overriddenValue: '2'
        value: '9'
      spark.dynamicAllocation.maxExecutors:
        annotation: Tuned Max executors to 11
        overriddenValue: '5'
        value: '11'
      spark.dynamicAllocation.minExecutors:
        annotation: Changed Min executors to 9
        overriddenValue: '2'
        value: '9'
...
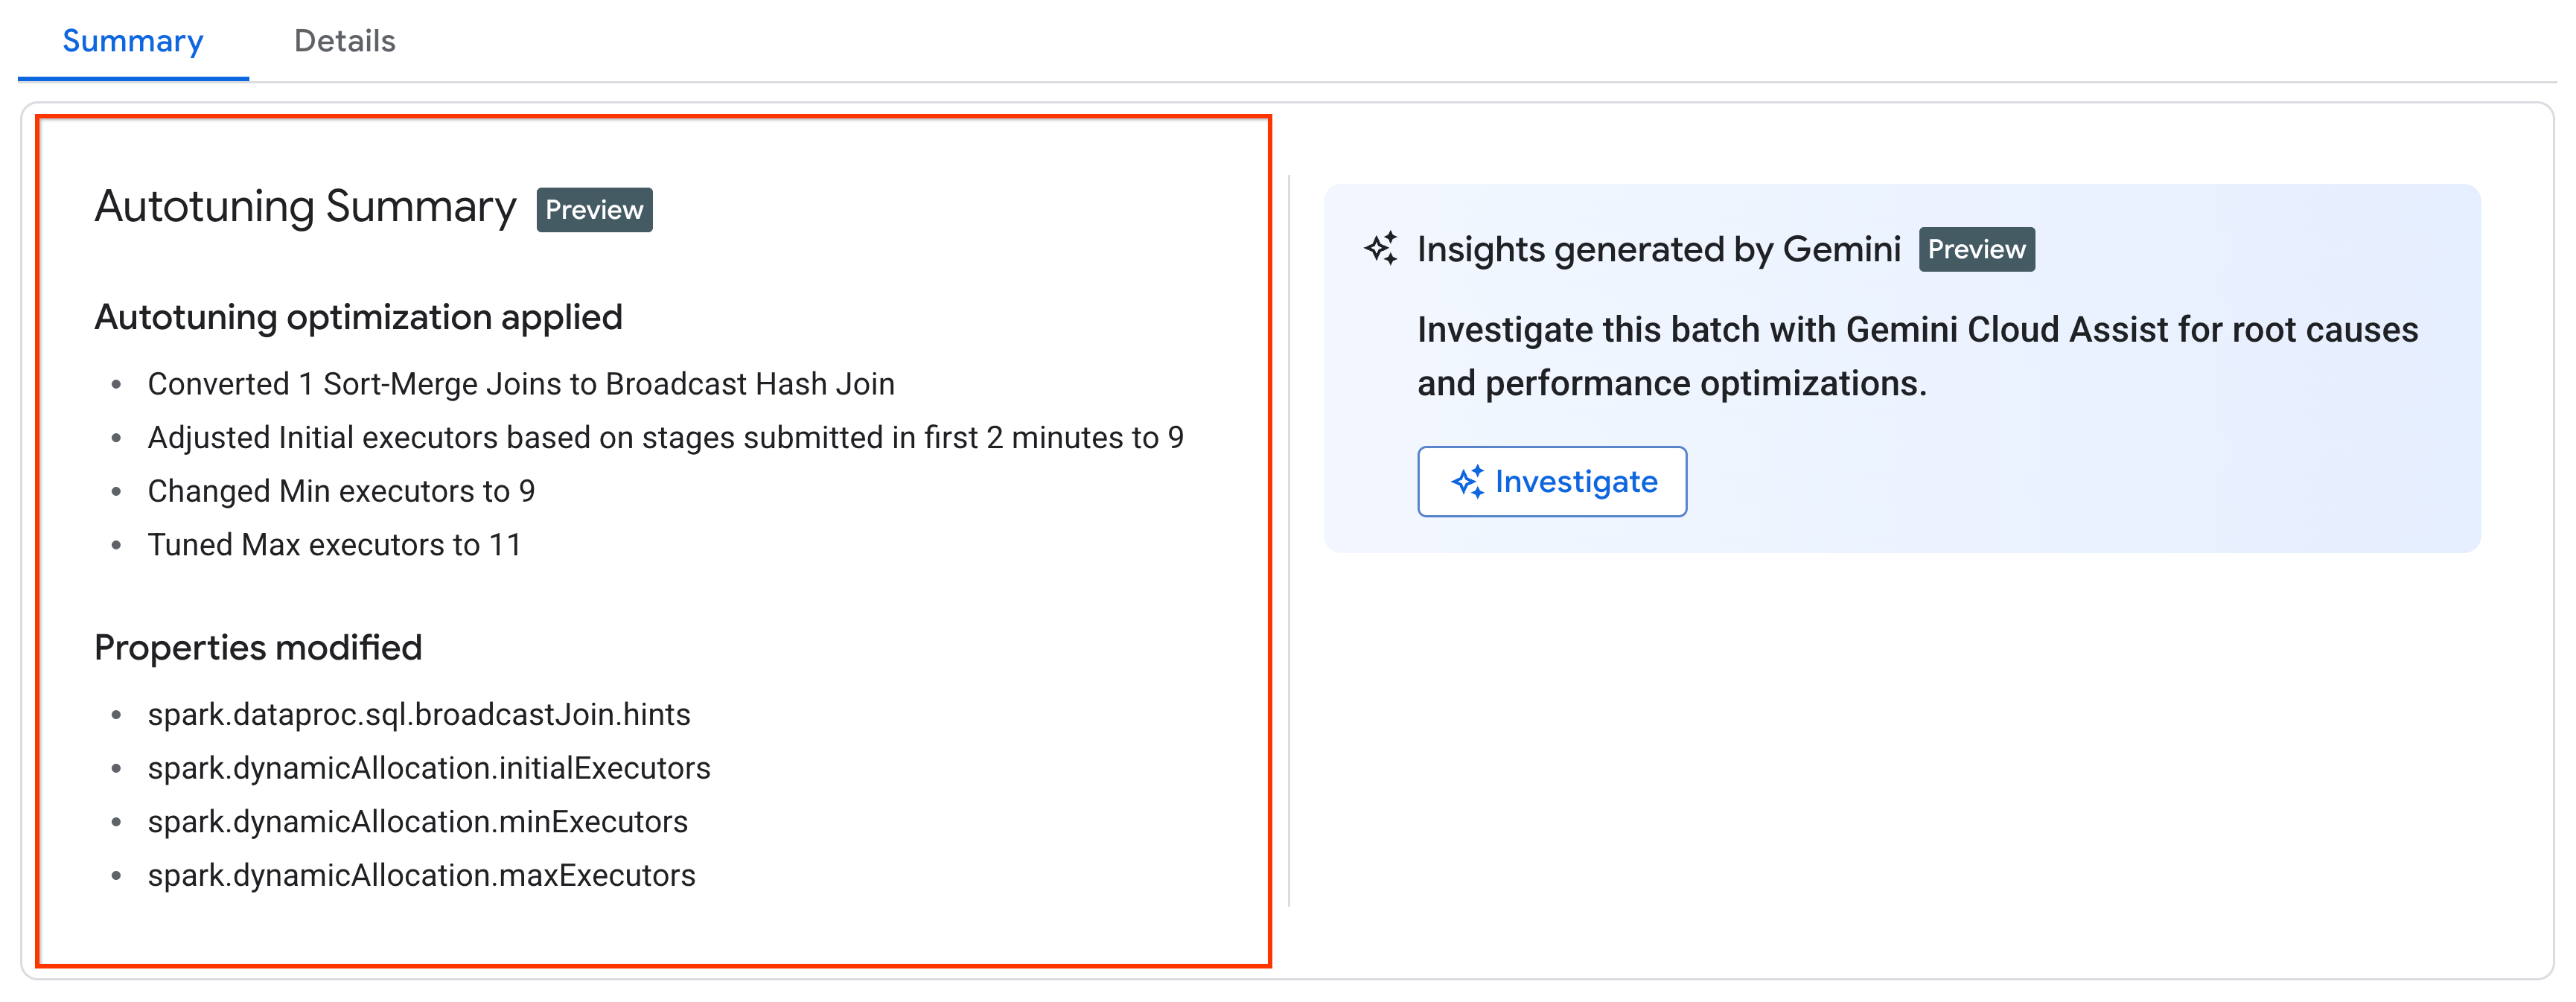
אתם יכולים לראות את השינויים האחרונים שבוצעו בכוונון האוטומטי של עומס עבודה פעיל, שהושלם או שנכשל, בדף Job details של משימה באצווה במסוףGoogle Cloud (לוחצים על מזהה משימה של משימה באצווה בכרטיסייה Serverless Spark בדף Jobs), בכרטיסייה Summary.
תמחור
הכוונון האוטומטי של Managed Service for Apache Spark מוצע בגרסת טרום-השקה (Preview) פרטית ללא תשלום נוסף. התמחור הרגיל של Managed Service for Apache Spark.