


Questo tutorial mostra come eseguire la migrazione dei dati MySQL esistenti da un Persistent Disk (DP) a Hyperdisk su Google Kubernetes Engine per migliorare le prestazioni di archiviazione. Hyperdisk offre un numero di IOPS e un throughput superiori rispetto a Persistent Disk, il che può migliorare le prestazioni di MySQL riducendo la latenza per le query e le transazioni del database. Puoi utilizzare gli snapshot del disco per eseguire la migrazione dei dati a tipi di disco diversi a seconda della compatibilità del tipo di macchina. Ad esempio, i volumi Hyperdisk sono compatibili solo con alcuni tipi di macchine di terza, quarta e generazioni successive, come N4, che non supportano i dischi permanenti. Per ulteriori informazioni, consulta le serie di macchine disponibili.
Per dimostrare la migrazione da Persistent Disk a Hyperdisk, questo tutorial utilizza il database Sakila per fornire un set di dati di esempio. Sakila è un database di esempio fornito da MySQL che puoi utilizzare come schema per tutorial ed esempi. Rappresenta un negozio di noleggio di DVD fittizio e include tabelle per film, attori, clienti e noleggi.
Questa guida è destinata agli specialisti e agli amministratori dello spazio di archiviazione che creano e allocano spazio di archiviazione e gestiscono la sicurezza e l'accesso ai dati. Per scoprire di più sui ruoli comuni e sulle attività di esempio a cui facciamo riferimento nei contenuti di Google Cloud , consulta Ruoli utente e attività comuni di GKE.
Architettura di deployment
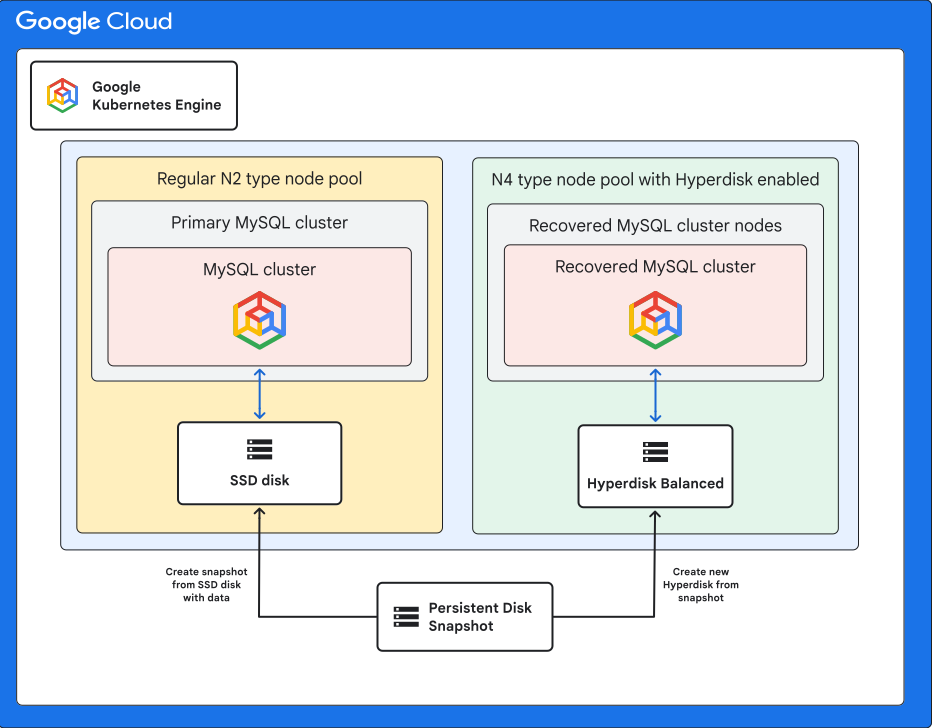
Il seguente diagramma illustra il processo di migrazione da un Persistent Disk a un Hyperdisk.
- Un'applicazione MySQL viene eseguita su un pool di nodi GKE con tipi di macchine N2 e archivia i dati su un Persistent Disk SSD.
- Per garantire la coerenza dei dati, l'applicazione viene ridimensionata per impedire nuove scritture.
- Viene creato uno snapshot del Persistent Disk, che funge da backup point-in-time completo dei dati.
- Viene eseguito il provisioning di un nuovo Hyperdisk dallo snapshot e viene eseguito il deployment di una nuova istanza MySQL su un pool di nodi N4 separato e compatibile con Hyperdisk. Questa nuova istanza si collega all'Hyperdisk appena creato, completando la migrazione allo spazio di archiviazione con prestazioni più elevate.
Obiettivi
In questo tutorial imparerai a:
- Esegui il deployment di un cluster MySQL.
- Carica un set di dati di test.
- Crea uno snapshot dei tuoi dati.
- Crea un Hyperdisk dallo snapshot.
- Avvia un nuovo cluster MySQL in un pool di nodi di tipo di macchina N4 abilitato per Hyperdisk.
- Verifica l'integrità dei dati per confermare la riuscita della migrazione.
Costi
In questo documento vengono utilizzati i seguenti componenti fatturabili di Google Cloud:
- GKE
- Compute Engine, which includes:
- Storage capacity provisioned for both Persistent Disk and Hyperdisk.
- Storage costs for the snapshots.
Per generare una stima dei costi in base all'utilizzo previsto, utilizza il Calcolatore prezzi.
Prima di iniziare
- Accedi al tuo account Google Cloud . Se non conosci Google Cloud, crea un account per valutare le prestazioni dei nostri prodotti in scenari reali. I nuovi clienti ricevono anche 300 $di crediti senza costi per l'esecuzione, il test e il deployment dei carichi di lavoro.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Compute Engine, GKE, Identity and Access Management Service Account Credentials APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
Assicurati di disporre dei seguenti ruoli nel progetto: roles/container.admin, roles/iam.serviceAccountAdmin, roles/compute.admin
Controlla i ruoli
-
Nella console Google Cloud vai alla pagina IAM.
Vai a IAM - Seleziona il progetto.
-
Nella colonna Entità, individua tutte le righe che identificano te o un gruppo di cui fai parte. Per scoprire in quali gruppi sei incluso, contatta il tuo amministratore.
- Per tutte le righe che ti specificano o ti includono, controlla la colonna Ruolo per verificare se l'elenco dei ruoli include i ruoli richiesti.
Concedi i ruoli
-
Nella console Google Cloud vai alla pagina IAM.
Vai a IAM - Seleziona il progetto.
- Fai clic su Concedi l'accesso.
-
Nel campo Nuove entità, inserisci il tuo identificatore dell'utente. In genere si tratta dell'indirizzo email di un Account Google.
- Fai clic su Seleziona un ruolo, quindi cerca il ruolo.
- Per concedere altri ruoli, fai clic su Aggiungi un altro ruolo e aggiungi ogni ruolo successivo.
- Fai clic su Salva.
-
Configura Cloud Shell
-
Nella console Google Cloud , attiva Cloud Shell.
Nella parte inferiore della console Google Cloud viene avviata una sessione di Cloud Shell e viene visualizzato un prompt della riga di comando. Cloud Shell è un ambiente shell con Google Cloud CLI già installata e con valori già impostati per il progetto corrente. L'inizializzazione della sessione può richiedere alcuni secondi.
- Imposta il progetto predefinito:
gcloud config set project PROJECT_IDSostituisci
PROJECT_IDcon l'ID progetto.
Viene avviata una sessione di Cloud Shell e viene visualizzato un prompt della riga di comando. L'inizializzazione della sessione può richiedere alcuni secondi.
Prepara l'ambiente
In Cloud Shell, imposta le variabili di ambiente per il progetto, la località e il prefisso del cluster.
export PROJECT_ID=PROJECT_ID
export EMAIL_ADDRESS=EMAIL_ADDRESS
export KUBERNETES_CLUSTER_PREFIX=offline-hyperdisk-migration
export LOCATION=us-central1-a
Sostituisci quanto segue:
PROJECT_ID: il tuo Google Cloud ID progetto.EMAIL_ADDRESS: il tuo indirizzo email.LOCATION: la zona in cui vuoi creare le risorse di deployment. Ai fini di questo tutorial, utilizza la zonaus-central1-a.
Clona il repository di codice campione da GitHub:
git clone https://github.com/GoogleCloudPlatform/kubernetes-engine-samplesVai alla directory
offline-hyperdisk-migrationper iniziare a creare risorse di deployment:cd kubernetes-engine-samples/databases/offline-hyperdisk-migration
Crea il cluster GKE e i node pool
Questo tutorial utilizza un cluster a livello di zona per semplicità, perché i volumi Hyperdisk sono risorse di zona e sono accessibili solo all'interno di una singola zona.
Crea un cluster GKE di zona:
gcloud container clusters create ${KUBERNETES_CLUSTER_PREFIX}-cluster \
    --location ${LOCATION} \
    --node-locations ${LOCATION} \
    --shielded-secure-boot \
    --shielded-integrity-monitoring \
    --machine-type "e2-micro" \
    --num-nodes "1"
Aggiungi un pool di nodi con un tipo di macchina N2 per il deployment iniziale di MySQL:
gcloud container node-pools create regular-pool \
    --cluster ${KUBERNETES_CLUSTER_PREFIX}-cluster \
    --machine-type n2-standard-4 \
    --location ${LOCATION} \
    --num-nodes 1
Aggiungi un pool di nodi con un tipo di macchina N4 su Hyperdisk in cui verrà eseguita la migrazione e l'esecuzione del deployment di MySQL:
gcloud container node-pools create hyperdisk-pool \
    --cluster ${KUBERNETES_CLUSTER_PREFIX}-cluster \
    --machine-type n4-standard-4 \
    --location ${LOCATION} \
    --num-nodes 1
Connettiti al cluster:
gcloud container clusters get-credentials ${KUBERNETES_CLUSTER_PREFIX}-cluster --location ${LOCATION}
Esegui il deployment di MySQL su Persistent Disk
In questa sezione, esegui il deployment di un'istanza MySQL che utilizza un Persistent Disk per l'archiviazione e caricala con dati di esempio.
Crea e applica un
StorageClassper Hyperdisk. QuestoStorageClassverrà utilizzato più avanti nel tutorial.kubectl apply -f manifests/01-storage-class/storage-class-hdb.yamlCrea e implementa un'istanza MySQL che includa l'affinità dei nodi per garantire che i pod vengano pianificati sui nodi
regular-poole che venga eseguito il provisioning di un volume SSD Persistent Disk.kubectl apply -f manifests/02-mysql/mysql-deployment.yamlQuesto manifest crea un servizio e un deployment MySQL, con un Persistent Disk di cui viene eseguito il provisioning dinamico per l'archiviazione dei dati. La password per l'utente
rootèmigration.Esegui il deployment di un pod client MySQL per caricare i dati e verificare la migrazione dei dati:
kubectl apply -f manifests/02-mysql/mysql-client.yaml
kubectl wait pods mysql-client --for condition=Ready --timeout=300s
Connettiti al pod client:
kubectl exec -it mysql-client -- bashDalla shell del pod client, scarica e importa il set di dati di esempio Sakila:
# Download the dataset
curl --output dataset.tgz "https://downloads.mysql.com/docs/sakila-db.tar.gz"

# Extract the dataset
tar -xvzf dataset.tgz -C /

# Import the dataset into MySQL (the password is "migration").
mysql -u root -h regular-mysql.default -p
    SOURCE /sakila-db/sakila-schema.sql;
    SOURCE /sakila-db/sakila-data.sql;
Verifica che i dati siano stati importati:
USE sakila;
SELECT      table_name,      table_rows  FROM      INFORMATION_SCHEMA.TABLES  WHERE TABLE_SCHEMA = 'sakila';
L'output mostra un elenco di tabelle con i conteggi delle righe.
| TABLE_NAME                 | TABLE_ROWS |
+----------------------------+------------+
| actor                      |        200 |
| actor_info                 |       NULL |
| address                    |        603 |
| category                   |         16 |
| city                       |        600 |
| country                    |        109 |
| customer                   |        599 |
| customer_list              |       NULL |
| film                       |       1000 |
| film_actor                 |       5462 |
| film_category              |       1000 |
| film_list                  |       NULL |
| film_text                  |       1000 |
| inventory                  |       4581 |
| language                   |          6 |
| nicer_but_slower_film_list |       NULL |
| payment                    |      16086 |
| rental                     |      16419 |
| sales_by_film_category     |       NULL |
| sales_by_store             |       NULL |
| staff                      |          2 |
| staff_list                 |       NULL |
| store                      |          2 |
+----------------------------+------------+
23 rows in set (0.01 sec)
Esci dalla sessione
mysql:exit;Esci dalla shell del pod client:
exitRecupera il nome del PersistentVolume (PV) creato per MySQL e memorizzalo in una variabile di ambiente:
export PV_NAME=$(kubectl get pvc mysql-pv-claim -o jsonpath='{.spec.volumeName}')
Esegui la migrazione dei dati a un volume Hyperdisk
Ora hai un workload MySQL con dati archiviati su un volume SSD Persistent Disk. Questa sezione descrive come eseguire la migrazione di questi dati a un volume Hyperdisk utilizzando uno snapshot. Questo approccio alla migrazione conserva anche il volume del Persistent Disk originale, il che ti consente di eseguire il rollback all'utilizzo dell'istanza MySQL originale, se necessario.
Anche se puoi creare snapshot dai dischi senza scollegarli dai workload, per garantire l'integrità dei dati per MySQL devi interrompere qualsiasi nuova scrittura sul disco durante la creazione dello snapshot. Fai lo scale down del deployment MySQL a
0repliche per interrompere le scritture:kubectl scale deployment existing-mysql --replicas=0Crea uno snapshot dal Persistent Disk esistente:
gcloud compute disks snapshot ${PV_NAME} --zone=${LOCATION} --snapshot-names=original-snapshot --description="snapshot taken from pd-ssd"Crea un nuovo volume Hyperdisk denominato
mysql-recoverydallo snapshot:gcloud compute disks create mysql-recovery --project=${PROJECT_ID} \ --type=hyperdisk-balanced \ --size=150GB --zone=${LOCATION} \ --source-snapshot=projects/${PROJECT_ID}/global/snapshots/original-snapshotAggiorna il file manifest per il VP ripristinato con l'ID progetto:
sed -i "s/PRJCTID/$PROJECT_ID/g" manifests/02-mysql/restore_pv.yamlCrea il PersistentVolume (PVC) e il PersistentVolumeClaim dal nuovo Hyperdisk:
kubectl apply -f manifests/02-mysql/restore_pv.yaml
Verificare la migrazione dei dati
Esegui il deployment di una nuova istanza MySQL che utilizza il volume Hyperdisk appena creato. Questo pod verrà pianificato sul pool di nodi hyperdisk-pool, costituito da nodi N4.
Esegui il deployment della nuova istanza MySQL:
kubectl apply -f manifests/02-mysql/recovery_mysql_deployment.yamlPer verificare l'integrità dei dati, connettiti di nuovo al pod del client MySQL:
kubectl exec -it mysql-client -- bashAll'interno del pod client, connettiti al nuovo database MySQL (
recovered-mysql.default) e verifica i dati. La password èmigration.mysql -u root -h recovered-mysql.default -p USE sakila; SELECT table_name, table_rows FROM INFORMATION_SCHEMA.TABLES WHERE TABLE_SCHEMA = 'sakila';I dati devono essere gli stessi dell'istanza MySQL originale sul Persistent Disk permanente.
Esci dalla sessione
mysql:exit;Esci dalla shell del pod client:
exit
Esegui la pulizia
Per evitare che al tuo Account Google Cloud vengano addebitati costi relativi alle risorse utilizzate in questo tutorial, elimina il progetto che contiene le risorse oppure mantieni il progetto ed elimina le singole risorse.
Elimina il progetto
Elimina un progetto Google Cloud :
gcloud projects delete PROJECT_ID
Elimina singole risorse
Se hai utilizzato un progetto esistente e non vuoi eliminarlo, elimina le singole risorse:
Imposta le variabili di ambiente per la pulizia e recupera il nome del volume Persistent Disk creato da
mysql-pv-claimPersistentVolumeClaim:export PROJECT_ID=PROJECT_ID export KUBERNETES_CLUSTER_PREFIX=offline-hyperdisk-migration export location=us-central1-a export PV_NAME=$(kubectl get pvc mysql-pv-claim -o jsonpath='{.spec.volumeName}')Sostituisci
PROJECT_IDcon l'ID progetto.Elimina lo snapshot:
gcloud compute snapshots delete original-snapshot --quietElimina il cluster GKE:
gcloud container clusters delete ${KUBERNETES_CLUSTER_PREFIX}-cluster --location=${LOCATION} --quietElimina i volumi Persistent Disk e Hyperdisk:
gcloud compute disks delete ${PV_NAME} --zone=${LOCATION} --quiet
gcloud compute disks delete mysql-recovery --zone=${LOCATION} --quiet
Passaggi successivi
- Esamina altri esempi di codice nel repository GitHub di esempi di GKE.
- Scopri come scalare le prestazioni di archiviazione con i volumi Hyperdisk.
- Scopri di più sull'utilizzo del driver CSI per il disco permanente di Compute Engine per la gestione dei volumi Persistent Disk e Hyperdisk.
- Esplora architetture, diagrammi e best practice di riferimento su Google Cloud. Consulta il nostro Cloud Architecture Center.