


Los glosarios de Vertex AI Translation en Google Distributed Cloud (GDC) aislado te permiten definir terminología específica de un dominio para que las traducciones sean coherentes en todos los pares de idiomas. Al configurar pares de términos de origen y de destino, controlas cómo traduce el servicio el vocabulario especializado, como nombres de productos, palabras ambiguas y términos prestados.
Las entradas del glosario pueden ser palabras sueltas (también denominadas tokens) o frases cortas, normalmente de menos de cinco palabras. Vertex AI Translation aplica las entradas que coinciden durante la traducción, pero ignora las que coinciden con palabras irrelevantes.
Métodos de glosario
Vertex AI Translation ofrece los siguientes métodos de glosario en GDC:
| Método | Descripción |
|---|---|
CreateGlossary |
Crea un glosario. |
GetGlossary |
Devolver un glosario almacenado. |
ListGlossaries |
Devuelve una lista de glosarios de un proyecto. |
DeleteGlossary |
Eliminar un glosario que ya no necesites. |
Antes de empezar
Antes de crear un glosario para definir la terminología de la traducción, debes tener un proyecto llamado translation-glossary-project. El recurso personalizado del proyecto debe ser similar al del siguiente ejemplo:
  apiVersion: resourcemanager.gdc.goog/v1
  kind: Project
  metadata:
    labels:
      atat.config.google.com/clin-number: CLIN_NUMBER
      atat.config.google.com/task-order-number: TASK_ORDER_NUMBER
    name: translation-glossary-project
    namespace: platform
Para obtener los permisos que necesitas para usar un glosario, pide al administrador de proyectos de gestión de identidades y accesos que te conceda los siguientes roles en el espacio de nombres de tu proyecto:
- Desarrollador de Vertex AI Translation: obtén el rol de desarrollador de Vertex AI Translation (
ai-translation-developer) para acceder al servicio Vertex AI Translation. - Administrador de segmentos de proyecto: obtén el rol de administrador de segmentos de proyecto (
project-bucket-admin) para gestionar los segmentos de almacenamiento y los objetos que contienen, lo que te permite crear y subir archivos.
Para obtener más información sobre los requisitos, consulta Configurar un proyecto de traducción.
Crear un archivo de glosario
Debes crear un archivo de glosario para almacenar los términos del idioma de origen y del idioma de destino. En esta sección se incluyen los dos diseños de glosario que puedes usar para definir tus términos.
En la siguiente tabla se describen los límites admitidos en Distributed Cloud para los archivos de glosario:
| Descripción | Límite |
|---|---|
| Tamaño máximo de archivo | 10,4 millones (10.485.760) de bytes UTF-8 |
| Longitud máxima de un término de glosario | 1024 bytes UTF-8 |
| Número máximo de recursos de glosario en un proyecto | 10.000 |
Elige uno de los siguientes diseños para tu archivo de glosario:
- Glosario unidireccional: especifica la traducción esperada para un par de términos de origen y de destino en un idioma concreto. Los glosarios unidireccionales admiten los formatos de archivo TSV, CSV y TMX.
- Glosario de conjuntos de términos equivalentes: especifica la traducción esperada en varios idiomas en cada fila. Los glosarios de conjuntos de términos equivalentes admiten formatos de archivo CSV.
Glosario unidireccional
La API Translation de Vertex AI acepta valores separados por tabulaciones (TSV) y valores separados por comas (CSV). Cada fila contiene un par de términos separados por un tabulador (\t) o una coma (,) en estos formatos de archivo.
La API Translation de Vertex AI también acepta el formato Translation Memory eXchange (TMX), un formato XML estándar para proporcionar los pares de términos de origen y de destino de la traducción. Los archivos de entrada admitidos tienen un formato basado en la versión 1.4 de TMX.
En los siguientes ejemplos se muestra la estructura necesaria para los formatos de archivo TSV, CSV y TMX de los glosarios unidireccionales:
TSV y CSV
En la siguiente imagen se muestran dos columnas de un archivo TSV o CSV. La primera columna contiene el término en el idioma de origen y la segunda, el término en el idioma de destino.
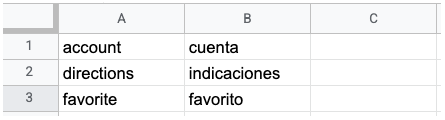
No incluyas una fila de encabezado en un archivo TSV o CSV unidireccional. La primera fila debe contener datos de términos. La solicitud de glosario hace que el archivo esté disponible para la API Translation de Vertex AI.
TMX
En el siguiente ejemplo se muestra la estructura necesaria en un archivo TMX:
<?xml version='1.0' encoding='utf-8'?>
<!DOCTYPE tmx SYSTEM "tmx14.dtd">
<tmx version="1.4">
  <header segtype="sentence" o-tmf="UTF-8" adminlang="en" srclang="en" datatype="PlainText"/>
  <body>
    <tu>
      <tuv xml:lang="en">
        <seg>account</seg>
      </tuv>
      <tuv xml:lang="es">
        <seg>cuenta</seg>
      </tuv>
    </tu>
    <tu>
      <tuv xml:lang="en">
        <seg>directions</seg>
      </tuv>
      <tuv xml:lang="es">
        <seg>indicaciones</seg>
      </tuv>
    </tu>
  </body>
</tmx>
Si tu archivo contiene etiquetas XML que no se muestran en este ejemplo, la API Vertex AI Translation las ignorará.
Incluye los siguientes elementos en tu archivo TMX para que la API Translation de Vertex AI lo procese correctamente:
<header>: identifica el idioma de origen con el atributosrclang.<tu>: incluye un par de elementos<tuv>con los mismos idiomas de origen y de destino. Estos elementos de<tuv>cumplen lo siguiente:- Cada elemento
<tuv>identifica el idioma del texto que contiene mediante el atributoxml:lang. Usa los códigos ISO 639-1 para identificar los idiomas de origen y de destino. Consulta la lista de idiomas admitidos y sus códigos correspondientes. - Si un elemento
<tu>contiene más de dos elementos<tuv>, la API Vertex AI Translation solo procesa el primer elemento<tuv>que coincida con el idioma de origen y el primer elemento<tuv>que coincida con el idioma de destino. El servicio ignora el resto de los elementos<tuv>. - Si un elemento
<tu>no tiene un par de elementos<tuv>que coincidan, la API Translation de Vertex AI ignorará el elemento<tu>no válido.
- Cada elemento
<seg>: Representan cadenas de texto generalizadas. La API Translation de Vertex AI excluye las etiquetas de marcado de un elemento<seg>antes de procesar el archivo. Si un elemento<tuv>contiene más de un elemento<seg>, la API Vertex AI Translation concatena el texto en un solo elemento con un espacio entre las cadenas de texto.
Después de identificar los términos del glosario unidireccional, sube el archivo a un segmento de almacenamiento y ponlo a disposición de la API Vertex AI Translation creando e importando un glosario.
Glosario de conjuntos de términos equivalentes
La API Translation de Vertex AI acepta archivos de glosario para conjuntos de términos equivalentes en formato CSV. Para definir conjuntos de términos equivalentes, crea un archivo CSV con varias columnas en el que cada fila incluya un único término del glosario en varios idiomas. Consulta la lista de idiomas admitidos y sus códigos correspondientes.
En la siguiente imagen se muestra un ejemplo de un archivo CSV con varias columnas. Cada fila representa un término del glosario y cada columna, una traducción del término a diferentes idiomas.
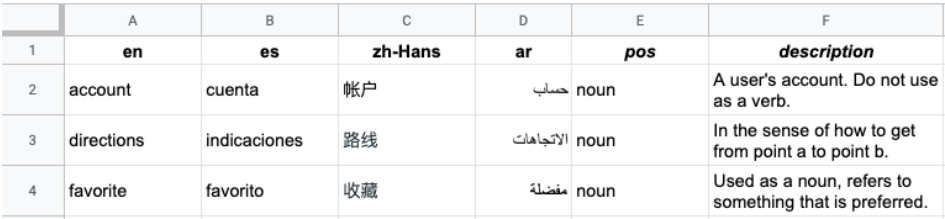
El encabezado es la primera fila del archivo, que identifica el idioma de cada columna. La fila de encabezado usa los códigos de idioma estándar ISO-639-1 o BCP-47. La API Vertex AI Translation no usa información de categorías gramaticales (pos) y no se validan los valores de posición específicos.
Cada fila posterior contiene términos del glosario equivalentes en los idiomas identificados en el encabezado. Puedes dejar columnas en blanco si el término no está disponible en todos los idiomas.
Después de identificar los términos del glosario en tu conjunto de términos equivalentes, sube el archivo a un segmento de almacenamiento y ponlo a disposición de la API Vertex AI Translation creando e importando un glosario.
Subir el archivo de glosario a un segmento de almacenamiento
Sigue estos pasos para subir tu archivo de glosario a un segmento de almacenamiento:
- Configura la CLI gdcloud para el almacenamiento de objetos.
Crea un segmento de almacenamiento en el espacio de nombres de tu proyecto. Usa una clase de almacenamiento
Standard.Puedes crear el segmento de almacenamiento desplegando un recurso
Bucketen el espacio de nombres de tu proyecto:apiVersion: object.gdc.goog/v1 kind: Bucket metadata: name: glossary-bucket namespace: translation-glossary-project spec: description: bucket for translation glossary storageClass: Standard bucketPolicy: lockingPolicy: defaultObjectRetentionDays: 90Concede permisos de
readen el segmento y permisos deget,listywatchensecretsen el espacio de nombres del proyecto a las cuentas de servicio (ai-translation-system-sayg-vai-translation-sie-sa) que usa el servicio Vertex AI Translation.Sigue estos pasos para crear el rol y la vinculación de roles usando recursos personalizados en el servidor de la API de gestión. Un usuario que ya tenga los permisos
secretsdebe aplicar estos recursos o la solicitud fallará conattempting to grant RBAC permissions not currently held:Crea el rol desplegando un recurso
Roleen el espacio de nombres del proyecto:apiVersion: rbac.authorization.k8s.io/v1 kind: Role metadata: name: ai-translation-glossary-reader namespace: translation-glossary-project rules: - apiGroups: - object.gdc.goog resources: - buckets verbs: - read-object - apiGroups: - "" resources: - secrets verbs: - get - list - watchCrea la vinculación de roles desplegando un recurso
RoleBindingen el espacio de nombres del proyecto:apiVersion: rbac.authorization.k8s.io/v1 kind: RoleBinding metadata: name: ai-translation-glossary-reader-rolebinding namespace: translation-glossary-project roleRef: apiGroup: rbac.authorization.k8s.io kind: Role name: ai-translation-glossary-reader subjects: - kind: ServiceAccount name: ai-translation-system-sa namespace: g-vai-translation-sie - kind: ServiceAccount name: g-vai-translation-sie-sa namespace: g-vai-translation-sie
Sube tu archivo de glosario al segmento de almacenamiento que has creado. Para obtener más información, consulta el artículo Subir y descargar objetos de almacenamiento en proyectos.
Crear un glosario
El método CreateGlossary crea un glosario y devuelve el identificador de la operación de larga duración que genera el glosario.
Para crear un glosario, sustituye lo siguiente antes de usar cualquiera de los datos de la solicitud:
ENDPOINT: el endpoint de Vertex AI Translation que usas en tu organización. Para obtener más información, consulta el estado del servicio y los puntos finales.PROJECT_ID: el ID de tu proyecto.BUCKET_NAME: el nombre del segmento de almacenamiento donde se encuentra el archivo del glosario.GLOSSARY_FILENAME: el nombre del archivo de glosario en el segmento de almacenamiento.
A continuación se muestra la sintaxis de una solicitud HTTP para crear un glosario:
POST https://ENDPOINT/v3/projects/PROJECT_ID/glossaries
Según el archivo de glosario que hayas creado, elige una de las siguientes opciones para crear un glosario:
Unidireccional
Para crear un glosario unidireccional, especifica un par de idiomas (language_pair) con un idioma de origen (source_language_code) y un idioma de destino (target_language_code).
Sigue estos pasos para crear un glosario unidireccional:
Guarda el siguiente cuerpo de solicitud en un archivo JSON llamado
request.json:{ "language_pair": { "source_language_code": "SOURCE_LANGUAGE", "target_language_code": "TARGET_LANGUAGE" }, "input_config": { "s3_source": { "input_uri": "s3://BUCKET_NAME/GLOSSARY_FILENAME" } } }Haz los cambios siguientes:
SOURCE_LANGUAGE: el código de idioma de origen del glosario. Consulta la lista de idiomas admitidos y sus respectivos códigos de idioma.TARGET_LANGUAGE: el código del idioma de destino del glosario. Consulta la lista de idiomas admitidos y sus respectivos códigos de idioma.
Haz la solicitud. En los siguientes ejemplos se usa un método de la API REST y la línea de comandos, pero también puedes usar bibliotecas de cliente para crear un glosario unidireccional.
curl
curl -X POST \
-H "Authorization: Bearer TOKEN" \
-H "Content-Type: application/json; charset=utf-8" \
-d @request.json \
"https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
Sustituye TOKEN por el token de autenticación que has obtenido.
PowerShell
$cred = TOKEN
$headers = @{ "Authorization" = "Bearer $cred" }
Invoke-WebRequest
  -Method POST
  -Headers $headers
  -ContentType: "application/json; charset=utf-8"
  -InFile request.json
  -Uri "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
  | Select-Object -Expand Content
Sustituye TOKEN por el token de autenticación que has obtenido.
Python
Instala la última versión de la biblioteca de cliente de Vertex AI Translation.
Configura las variables de entorno necesarias en una secuencia de comandos de Python.
Añade el siguiente código a la secuencia de comandos de Python que has creado:
import time
import google.auth
import google.auth.transport.requests
import requests

def create_glossary(project_id="PROJECT_ID", input_uri="s3://BUCKET_NAME/GLOSSARY_FILENAME",
                    source_lang_code="SOURCE_LANGUAGE", target_lang_code="TARGET_LANGUAGE"):
    # Client 3.8.0 has no s3_source field, so call REST (token audience without :443).
    creds, _ = google.auth.default()
    creds = creds.with_gdch_audience("https://ENDPOINT")
    creds.refresh(google.auth.transport.requests.Request())
    session = requests.Session()
    session.verify = "CERT_NAME"
    session.headers["Authorization"] = f"Bearer {creds.token}"
    body = {"language_pair": {"source_language_code": source_lang_code,
                              "target_language_code": target_lang_code},
            "input_config": {"s3_source": {"input_uri": input_uri}}}
    r = session.post(f"https://ENDPOINT/v3/projects/{project_id}/glossaries", json=body)
    r.raise_for_status()
    op = r.json()
    while not op.get("done"):
        time.sleep(2)
        op = session.get(f"https://ENDPOINT/v3/{op['name']}").json()
    return op  # The service assigns the glossary ID: op["metadata"]["name"]
Haz los cambios siguientes:
SOURCE_LANGUAGE: el código de idioma de origen del glosario. Consulta la lista de idiomas admitidos y sus códigos correspondientes.TARGET_LANGUAGE: el código del idioma de destino del glosario. Consulta la lista de idiomas admitidos y sus códigos correspondientes.CERT_NAME: el nombre del archivo de certificado de la autoridad de certificación (AC), comoorg-1-trust-bundle-ca.cert. Para obtener más información, consulta Generar el archivo de certificado AC del paquete de confianza en un entorno de desarrollo.
Guarda la secuencia de comandos de Python.
Ejecuta la secuencia de comandos de Python:
python SCRIPT_NAMESustituye
SCRIPT_NAMEpor el nombre que hayas dado a tu secuencia de comandos de Python, comoglossary.py.
Para obtener más información sobre el método projects.glossaries.create, consulta la referencia de la API REST de Vertex AI Translation.
Debes recibir una respuesta JSON similar a la siguiente:
{
"name": "projects/PROJECT_ID/operations/OPERATION_ID",
"metadata": {
    "@type": "type.googleapis.com/google.cloud.translation.v3.CreateGlossaryMetadata",
    "name": "projects/PROJECT_ID/glossaries/GLOSSARY_ID",
    "state": "RUNNING",
    "submitTime": "TIME"
  }
}
En la respuesta:
OPERATION_ID: el ID asignado por el servidor de la operación de larga duración que crea el glosario. El servicio devuelve este ID en el camponamede la respuesta, o bien puedes encontrarlo llamando aprojects.operations.list. Puedes pasarprojects/PROJECT_ID/operations/OPERATION_IDaprojects.operations.getpara comprobar el estado de la operación de creación del glosario.GLOSSARY_ID: el ID del glosario asignado por el servidor (Gseguido de dígitos), que se usa en las solicitudes de obtención, traducción y eliminación.
Conjunto de términos equivalentes
Para crear un glosario de conjuntos de términos equivalentes, especifica un conjunto de idiomas (language_codes_set) con los códigos de idioma (language_codes) del glosario.
Sigue estos pasos para crear un glosario de conjuntos de términos equivalentes:
Guarda el siguiente cuerpo de solicitud en un archivo JSON llamado
request.json:{ "language_codes_set": { "language_codes": ["LANGUAGE_CODE_1", "LANGUAGE_CODE_2", "LANGUAGE_CODE_3" ] }, "input_config": { "s3_source": { "input_uri": "s3://BUCKET_NAME/GLOSSARY_FILENAME" } } }Sustituye
LANGUAGE_CODE_1,LANGUAGE_CODE_2yLANGUAGE_CODE_3por los códigos de los idiomas del glosario. Consulta la lista de idiomas admitidos y sus códigos correspondientes.Haz la solicitud:
curl
curl -X POST \
    -H "Authorization: Bearer TOKEN" \
    -H "Content-Type: application/json; charset=utf-8" \
    -d @request.json \
    "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
Sustituye TOKEN por el token de autenticación que has obtenido.
Debes recibir una respuesta JSON similar a la siguiente:
{
  "name": "projects/PROJECT_ID/operations/OPERATION_ID",
  "metadata": {
    "@type": "type.googleapis.com/google.cloud.translation.v3.CreateGlossaryMetadata",
    "name": "projects/PROJECT_ID/glossaries/GLOSSARY_ID",
    "state": "RUNNING",
    "submitTime": "TIME"
  }
}
En la respuesta:
OPERATION_ID: el ID asignado por el servidor de la operación de larga duración que crea el glosario. El servicio devuelve este ID en el camponamede la respuesta, o bien puedes encontrarlo llamando aprojects.operations.list. Puedes pasarprojects/PROJECT_ID/operations/OPERATION_IDaprojects.operations.getpara comprobar el estado de la operación de creación del glosario.GLOSSARY_ID: el ID del glosario asignado por el servidor (Gseguido de dígitos), que se usa en las solicitudes de obtención, traducción y eliminación.
PowerShell
$cred = TOKEN
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
  -Method POST `
  -Headers $headers `
  -ContentType: "application/json; charset=utf-8" `
  -InFile request.json `
  -Uri "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
  | Select-Object -Expand Content
Sustituye TOKEN por el token de autenticación que has obtenido.
Debes recibir una respuesta JSON similar a la siguiente:
{
  "name": "projects/PROJECT_ID/operations/OPERATION_ID",
  "metadata": {
    "@type": "type.googleapis.com/google.cloud.translation.v3.CreateGlossaryMetadata",
    "name": "projects/PROJECT_ID/glossaries/GLOSSARY_ID",
    "state": "RUNNING",
    "submitTime": "TIME"
  }
}
En la respuesta:
OPERATION_ID: el ID asignado por el servidor de la operación de larga duración que crea el glosario. El servicio devuelve este ID en el camponamede la respuesta, o bien puedes encontrarlo llamando aprojects.operations.list. Puedes pasarprojects/PROJECT_ID/operations/OPERATION_IDaprojects.operations.getpara comprobar el estado de la operación de creación del glosario.GLOSSARY_ID: el ID del glosario asignado por el servidor (Gseguido de dígitos), que se usa en las solicitudes de obtención, traducción y eliminación.
Python
Instala la última versión de la biblioteca de cliente de Vertex AI Translation.
Configura las variables de entorno necesarias en una secuencia de comandos de Python.
Añade el siguiente código a la secuencia de comandos de Python que has creado:
import time
import google.auth
import google.auth.transport.requests
import requests

def create_glossary(project_id="PROJECT_ID", input_uri="s3://BUCKET_NAME/GLOSSARY_FILENAME",
                    lang_1="LANGUAGE_CODE_1", lang_2="LANGUAGE_CODE_2"):
    # Client 3.8.0 has no s3_source field, so call REST (token audience without :443).
    creds, _ = google.auth.default()
    creds = creds.with_gdch_audience("https://ENDPOINT")
    creds.refresh(google.auth.transport.requests.Request())
    session = requests.Session()
    session.verify = "CERT_NAME"
    session.headers["Authorization"] = f"Bearer {creds.token}"
    body = {"language_codes_set": {"language_codes": [lang_1, lang_2]},
            "input_config": {"s3_source": {"input_uri": input_uri}}}
    r = session.post(f"https://ENDPOINT/v3/projects/{project_id}/glossaries", json=body)
    r.raise_for_status()
    op = r.json()
    while not op.get("done"):
        time.sleep(2)
        op = session.get(f"https://ENDPOINT/v3/{op['name']}").json()
    return op  # The service assigns the glossary ID: op["metadata"]["name"]
Haz los cambios siguientes:
LANGUAGE_CODE_1yLANGUAGE_CODE_2: los códigos de idioma de los idiomas del glosario. Consulta la lista de idiomas admitidos y sus códigos correspondientes.CERT_NAME: el nombre del archivo de certificado de la autoridad de certificación (AC), comoorg-1-trust-bundle-ca.cert. Para obtener más información, consulta Generar el archivo de certificado AC del paquete de confianza en un entorno de desarrollo.
Guarda la secuencia de comandos de Python.
Ejecuta la secuencia de comandos de Python:
python SCRIPT_NAMESustituye
SCRIPT_NAMEpor el nombre que hayas dado a tu secuencia de comandos de Python, comoglossary.py.
Para obtener más información sobre el método projects.glossaries.create, consulta la referencia de la API REST de Vertex AI Translation.
En función del tamaño del archivo del glosario, el proceso de creación suele tardar menos de 10 minutos en completarse. Puedes obtener el estado de esta operación para saber cuándo ha finalizado.
Obtener un glosario
El método GetGlossary devuelve un glosario almacenado. Si el glosario no existe, la salida devuelve el valor NOT_FOUND. Para llamar al método GetGlossary, especifica el ID del proyecto y el ID del glosario. Tanto el método CreateGlossary como el método ListGlossaries devuelven el ID de glosario. La API Translation de Vertex AI solo acepta solicitudes HTTPS.
Por ejemplo, las siguientes solicitudes devuelven información sobre un glosario específico de tu proyecto:
curl
curl -X GET \
   -H "Authorization: Bearer TOKEN" \
   "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries/GLOSSARY_ID"
Sustituye TOKEN por el token de autenticación que has obtenido.
Python
from google.cloud import translate_v3 as translate
from google.api_core.client_options import ClientOptions

def get_glossary(creds, name="projects/PROJECT_ID/glossaries/GLOSSARY_ID"):
    """Get a glossary by its full name. The service assigns the glossary ID."""
    client = translate.TranslationServiceClient(
        credentials=creds, client_options=ClientOptions(api_endpoint="ENDPOINT:443"))
    response = client.get_glossary(name=name)
    print(f"Glossary name: {response.name}")
Envía las credenciales de Distributed Cloud (creds) configuradas con la audiencia https://ENDPOINT:443, tal como se muestra en Traducir texto.
Para obtener más información sobre el método get_glossary, consulta la biblioteca de cliente de Python.
Mostrar glosarios
El método ListGlossaries devuelve una lista de recursos Glossary de un proyecto, cada uno de los cuales contiene el name completo (projects/PROJECT_ID/glossaries/GLOSSARY_ID). Si el proyecto no tiene glosarios, el resultado devuelve {}. Si el proyecto no existe, el resultado devuelve el valor NOT_FOUND. Para llamar al método ListGlossaries, especifica el ID de tu proyecto y el endpoint de Vertex AI Translation.
La API Translation de Vertex AI solo acepta solicitudes HTTPS.
Por ejemplo, la siguiente solicitud devuelve los glosarios de tu proyecto:
curl -X GET \
    -H "Authorization: Bearer TOKEN" \
    "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries?page_size=10"
Sustituye TOKEN por el token de autenticación que has obtenido.
Eliminar un glosario
El método DeleteGlossary elimina un glosario. Si el glosario no existe, la salida devuelve el valor NOT_FOUND. Para llamar al método DeleteGlossary, especifica el ID de tu proyecto, el ID del glosario y el endpoint de Vertex AI Translation.
Tanto el método CreateGlossary como el método ListGlossaries devuelven el ID de glosario. La API Translation de Vertex AI solo acepta solicitudes HTTPS.
Por ejemplo, la siguiente solicitud elimina un glosario de tu proyecto:
curl -X DELETE \
    -H "Authorization: Bearer TOKEN" \
    "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries/GLOSSARY_ID"
Sustituye TOKEN por el token de autenticación que has obtenido.