


El objetivo de una configuración de alta disponibilidad es reducir el tiempo de inactividad cuando una instancia de clúster de base de datos deja de estar disponible. Esto puede ocurrir cuando una instancia se queda sin memoria. Con la alta disponibilidad, tus datos siguen estando disponibles para las aplicaciones cliente.
En un sitio, la configuración se compone de una instancia principal y una réplica de reserva. Todas las escrituras realizadas en la instancia principal se replican en la réplica de reserva antes de que se notifique que se ha confirmado una transacción. Si la instancia principal deja de estar disponible, GDC convierte automáticamente la réplica de espera en la nueva instancia principal. El tráfico de la aplicación se redirige a la nueva instancia principal. Este proceso se denomina conmutación por error.
La conmutación por error automática se inicia después de que se produzcan tres fallos consecutivos en la comprobación de estado de la instancia principal, con un intervalo de 30 segundos entre cada uno.
GDC admite la conmutación por error tanto automática como manual. La conmutación por error automática está habilitada de forma predeterminada, pero puedes inhabilitarla si es necesario. También puedes activar manualmente una conmutación por error en cualquier momento para recuperarte de un fallo inesperado y minimizar el tiempo de inactividad.
La conmutación por error implica el siguiente proceso, en orden:
GDC desconecta la instancia principal.
GDC convierte la réplica de espera en el nuevo clúster de base de datos activo.
GDC elimina el clúster de bases de datos activo anterior.
GDC crea una nueva réplica de reserva.
Actualizar un clúster
Puedes actualizar la configuración de alta disponibilidad de un clúster de bases de datos:
Consola
En el menú de navegación, selecciona Database Service (Servicio de base de datos).
En la lista de clústeres de bases de datos, haz clic en el clúster de bases de datos que quieras actualizar.
Selecciona Editar Editar en la sección Alta disponibilidad.
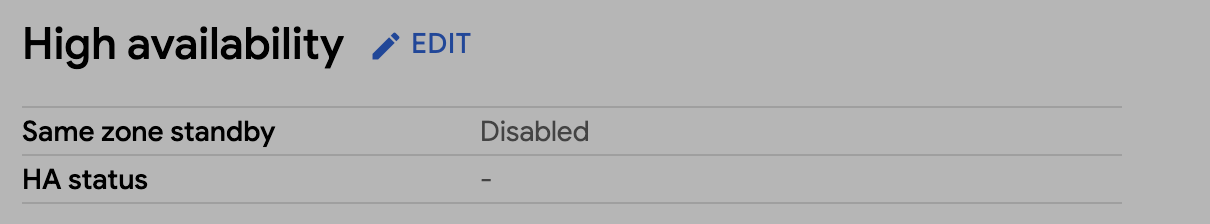
Selecciona Habilitar espera en la misma zona para activar o desactivar la disponibilidad de una instancia en espera en la misma zona que tu clúster de base de datos principal.
Haz clic en Guardar.
Comprueba que el clúster de bases de datos refleje la actualización de alta disponibilidad consultando su estado en la columna Alta disponibilidad de la lista de clústeres de bases de datos.
gdcloud
Actualiza la configuración de alta disponibilidad del clúster de bases de datos:
gdcloud database clusters update CLUSTER_NAME \
    --availability-type HA_TYPE
Haz los cambios siguientes:
CLUSTER_NAME: el nombre del clúster de la base de datos.HA_TYPE: el nivel de alta disponibilidad del clúster de bases de datos. Puedes definirzonalozonal_ha. El valorzonalse define de forma predeterminada.
Verifica que tu clúster de bases de datos refleje la actualización de alta disponibilidad:
gdcloud database clusters list
API
Actualiza la configuración de alta disponibilidad del clúster de bases de datos:
  kubectl patch dbcluster.postgresql.dbadmin.gdc.goog DBCLUSTER_NAME \
    -n USER_PROJECT \
    -p '{"spec": {"availability": {"enableHighAvailability": HA_ENABLED}}}' \
    --type=merge
Sustituye las siguientes variables:
DBCLUSTER_NAME: el nombre del clúster de bases de datos.USER_PROJECT: el nombre del proyecto de usuario en el que se ha creado el clúster de bases de datos.HA_ENABLED: el nivel de alta disponibilidad del clúster de bases de datos. Puedes definirtrueofalse. El valorfalsese define de forma predeterminada.
Verifica que tu clúster de bases de datos refleje la actualización de alta disponibilidad:
kubectl get dbcluster.DBENGINE_NAME.dbadmin.gdc.goog DBCLUSTER_NAME \
  -n USER_PROJECT \
  -o yaml
Migrar a la implementación de alta disponibilidad más reciente
Para verificar que tu clúster de bases de datos de alta disponibilidad usa la implementación más reciente, comprueba si la anotación dbcluster.dbadmin.goog/raasEnabled existe en el CR de tu clúster de bases de datos de alta disponibilidad. Esta anotación solo aparecerá en los clústeres que usen la nueva implementación. Si no tienes esta anotación, puedes habilitarla y migrar tu clúster siguiendo estos pasos:
- Consulta con tu operador de infraestructura si tu entorno de GDC se ha actualizado a la versión 1.15.1 o una posterior.
- Inhabilitar la alta disponibilidad en tu clúster de bases de datos. Espera a que desaparezca la condición
HAReadyy, a continuación, vuelve a habilitar la alta disponibilidad. - Cuando veas
HAReady in progressoHAReady setup complete, comprueba la anotacióndbcluster.dbadmin.goog/raasEnableden el CR de tu clúster de bases de datos. Si aparece, significa que el clúster de bases de datos se ha migrado correctamente.
Activar una conmutación por error
Si has configurado la alta disponibilidad en tu clúster de bases de datos, puedes activar una conmutación por error. Para activar una conmutación por error, sigue estos pasos:
Consola
En el menú de navegación, selecciona Database Service (Servicio de base de datos).
En la lista de clústeres de bases de datos, haz clic en el clúster de bases de datos para el que quieras activar una conmutación por error. Tu clúster de bases de datos debe tener habilitada la alta disponibilidad para poder optar a una conmutación por error.
Haz clic en Conmutación por error.
Escribe el ID del clúster para la frase de confirmación y haz clic en Conmutación por error para activar el proceso de conmutación por error.
gdcloud
Activa la conmutación por error del clúster de bases de datos:
gdcloud database clusters failover CLUSTER_NAME
Sustituye CLUSTER_NAME por el nombre del clúster de bases de datos.
API
  apiVersion: fleet.dbadmin.gdc.goog/v1
  kind: Failover
  metadata:
    name: FAILOVER_NAME
    namespace: USER_PROJECT
  spec:
    dbclusterRef: DBCLUSTER_NAME
Sustituye las siguientes variables:
DBCLUSTER_NAME, el nombre del clúster de bases de datos.USER_PROJECT: el nombre del proyecto de usuario en el que se ha creado el clúster de bases de datos.FAILOVER_NAME, el nombre único de la conmutación por error (por ejemplo,failover-sample).
Inhabilitar la conmutación por error automática
La conmutación por error automática está habilitada de forma predeterminada en los clústeres de bases de datos de alta disponibilidad.
Para inhabilitar la conmutación por error automática, asigna el valor false a enableAutoFailover en el manifiesto del clúster de bases de datos:
spec:
  availability:
    enableAutoFailover: false
Para actualizar la configuración de conmutación por error automática de un clúster de bases de datos mediante la API, ejecuta el siguiente comando:
kubectl patch dbcluster.postgresql.dbadmin.gdc.goog DBCLUSTER_NAME \
  -n USER_PROJECT \
  -p '{"spec": {"availability": {"enableAutoFailover": AUTO_FAILOVER_ENABLED}}}' \
  --type=merge
Sustituye las siguientes variables:
DBCLUSTER_NAME: el nombre del clúster de bases de datos.USER_PROJECT: el nombre del proyecto de usuario en el que se ha creado el clúster de bases de datos.AUTO_FAILOVER_ENABLED: el ajuste de conmutación por error automática del clúster de bases de datos. Puedes definirtrueofalse. El valortruese define de forma predeterminada.