


Quando invii un job Managed Service for Apache Spark, Managed Service for Apache Spark raccoglie automaticamente l'output del job e lo rende disponibile. In questo modo, puoi esaminare rapidamente l'output dei job senza dover mantenere una connessione al cluster durante l'esecuzione dei job o esaminare file di log complicati.
Log di Spark
Esistono due tipi di log di Spark: i log del driver Spark e i log dell'esecutore Spark.
I log del driver Spark contengono l'output del job; i log dell'esecutore Spark contengono l'output dell'eseguibile o del programma di avvio del job, ad esempio un messaggio spark-submit "Applicazione inviata…", e possono essere utili per il debug degli errori dei job.
Il driver del job Managed Service for Apache Spark, che è distinto dal driver Spark, è un launcher per molti tipi di prestazione. Quando avvii i job Spark, viene eseguito come wrapper sull'eseguibile spark-submit sottostante, che avvia il driver Spark. Il driver Spark esegue il job sul cluster Managed Service for Apache Spark in modalità Spark client o cluster:
Modalità
client: il driver Spark esegue il job nel processospark-submite i log di Spark vengono inviati al driver del job Managed Service for Apache Spark.Modalità
cluster: il driver Spark esegue il job in un container YARN. I log del driver Spark non sono disponibili per il driver del job Managed Service for Apache Spark.
Panoramica delle proprietà dei job Managed Service for Apache Spark e Spark
| Proprietà | Valore | Predefinito | Descrizione |
|---|---|---|---|
dataproc:dataproc.logging.stackdriver.job.driver.enable |
true o false | false | Deve essere impostato al momento della creazione del cluster. Se true, l'output del driver del job si trova in Logging ed è associato alla risorsa del job; se false, l'output del driver del job non si trova in Logging.Nota: per attivare i log del driver del job in Logging, sono necessarie anche le seguenti impostazioni delle proprietà del cluster, che vengono impostate per impostazione predefinita quando viene creato un cluster: dataproc:dataproc.logging.stackdriver.enable=true
e dataproc:jobs.file-backed-output.enable=true
|
dataproc:dataproc.logging.stackdriver.job.yarn.container.enable |
true o false | false | Deve essere impostato al momento della creazione del cluster.
Se true, i log dei container YARN del job sono associati alla risorsa del job; se false, i log dei container YARN del job sono associati alla risorsa del cluster. |
spark:spark.submit.deployMode |
client o cluster | client | Controlla la modalità Spark client o cluster. |
Job Spark inviati utilizzando l'API Managed Service for Apache Spark jobs
Le tabelle in questa sezione elencano l'effetto di diverse impostazioni delle proprietà sulla destinazione dell'output del driver dei job di Managed Service for Apache Spark quando i job vengono inviati tramite l'API Managed Service for Apache Spark jobs, che include l'invio dei job tramite la consoleGoogle Cloud , gcloud CLI e le librerie client di Cloud.
L'elenco Servizio gestito per Apache Spark e le proprietà di Spark può essere impostato con il--properties flag quando viene creato un cluster e verrà applicato a tutti i job Spark eseguiti sul cluster; le proprietà Spark possono anche essere impostate con--properties flag (senza il prefisso "spark:") quando un job viene inviato al servizio gestito per Apache Sparkjobs API e si applicherà solo al lavoro.
Output del driver del job Managed Service for Apache Spark
Le tabelle seguenti elencano l'effetto delle diverse impostazioni delle proprietà sulla destinazione dell'output del driver del job Managed Service for Apache Spark.
dataproc: |
Output |
|---|---|
| false (predefinito) |
|
| true |
|
Log del driver Spark
Le tabelle seguenti elencano l'effetto delle diverse impostazioni delle proprietà sulla destinazione dei log del driver Spark.
spark: |
dataproc: |
dataproc: |
Output del driver |
|---|---|---|---|
| client | false (predefinito) | true o false |
|
| client | true | true o false |
|
| cluster | false (predefinito) | false |
|
| cluster | true | true |
|
Log degli esecutori Spark
Le tabelle seguenti elencano l'effetto delle diverse impostazioni delle proprietà sulla destinazione dei log dell'esecutore Spark.
dataproc: |
Log dell'esecutore |
|---|---|
| false (predefinito) | In Logging: yarn-userlogs nella risorsa cluster |
| true | In Logging dataproc.job.yarn.container nella risorsa del job |
Job Spark inviati senza utilizzare l'API Managed Service for Apache Spark jobs
Questa sezione elenca l'effetto delle diverse impostazioni delle proprietà sulla destinazione dei log dei job Spark quando i job vengono inviati senza utilizzare l'API Managed Service for Apache Spark jobs, ad esempio quando si invia un job direttamente su un nodo del cluster utilizzando spark-submit o quando si utilizza un notebook Jupyter o Zeppelin. Questi job non hanno ID job o driver Managed Service for Apache Spark.
Log del driver Spark
Le tabelle seguenti elencano l'effetto delle diverse impostazioni delle proprietà sulla destinazione dei log del driver Spark per i job non inviati tramite l'API Managed Service for Apache Spark jobs.
spark: |
Output del driver |
|---|---|
| client |
|
| cluster |
|
Log degli esecutori Spark
Quando i job Spark non vengono inviati tramite l'API Managed Service for Apache Spark jobs, i log dell'esecutore si trovano in Logging yarn-userlogs nella risorsa del cluster.
Visualizza l'output del job
Puoi accedere all'output dei job di Managed Service for Apache Spark nella console Google Cloud , in gcloud CLI, Cloud Storage o Logging.
Console
Per visualizzare l'output del job, vai alla sezione Job di Managed Service for Apache Spark del tuo progetto, quindi fai clic sull'ID job per visualizzare l'output del job.
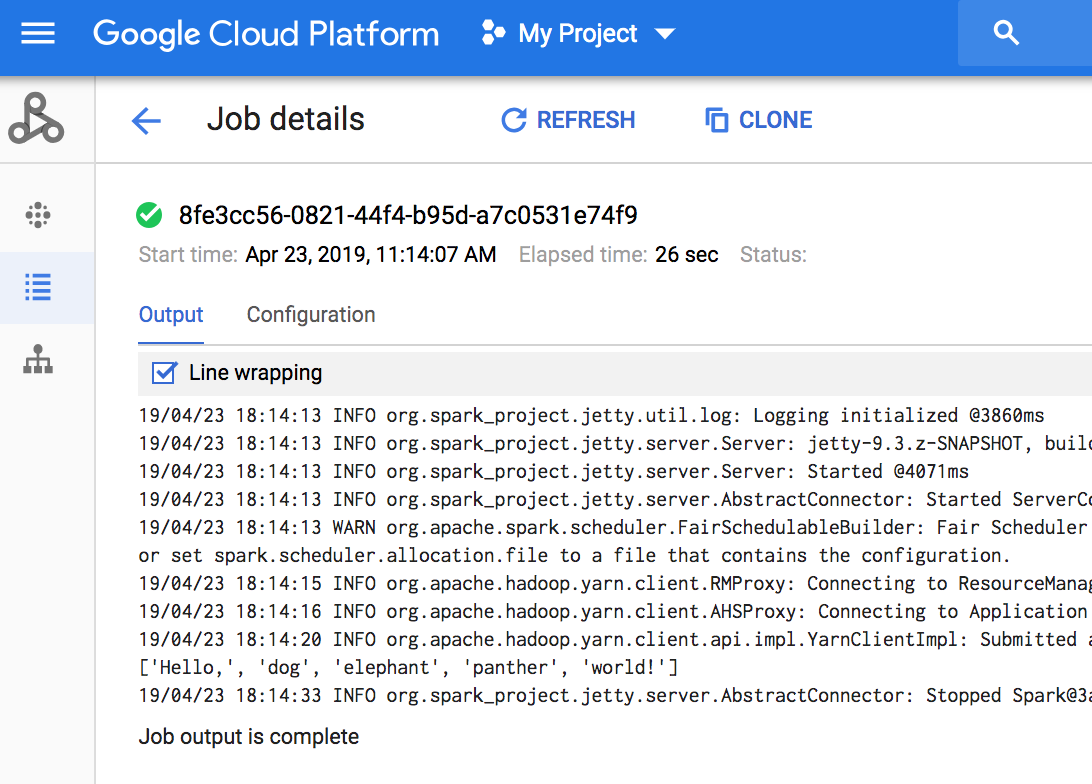
Se il job è in esecuzione, l'output del job viene aggiornato periodicamente con nuovi contenuti.
Comando g-cloud
Quando invii un job con il comando gcloud dataproc jobs submit, l'output del job viene visualizzato nella console. Puoi "ricollegarti"
all'output in un secondo momento, su un altro computer o in
una nuova finestra passando l'ID del job al
comando
gcloud dataproc jobs wait. L'ID job è un GUID, ad esempio 5c1754a5-34f7-4553-b667-8a1199cb9cab. Ecco un esempio.
gcloud dataproc jobs wait 5c1754a5-34f7-4553-b667-8a1199cb9cab \
    --project my-project-id --region my-cluster-region
Waiting for job output...
... INFO gcs.GoogleHadoopFileSystemBase: GHFS version: 1.4.2-hadoop2
... 16:47:45 INFO client.RMProxy: Connecting to ResourceManager at my-test-cluster-m/
...
Cloud Storage
L'output del job viene archiviato in Cloud Storage nel bucket di gestione temporanea o nel bucket specificato al momento della creazione del cluster. Un link all'output del job in Cloud Storage viene fornito nel campo Job.driverOutputResourceUri restituito da:
- una richiesta API jobs.get.
- un comando gcloud dataproc jobs describe job-id.
$ gcloud dataproc jobs describe spark-pi
...
driverOutputResourceUri: gs://dataproc-nnn/jobs/spark-pi/driveroutput
...