


סקירה כללית
השירות המנוהל ל-Apache Spark Persistent History Server (PHS) מספק ממשקי אינטרנט לצפייה בהיסטוריית המשימות של משימות שהופעלו באשכולות פעילים או שנמחקו של השירות המנוהל ל-Apache Spark. הוא זמין בגרסת תמונה 1.5 של Managed Service for Apache Spark ואילך, ופועל באשכול Managed Service for Apache Spark עם צומת יחיד. הוא מספק ממשקי אינטרנט לקבצים ולנתונים הבאים:
קבצים של היסטוריית משימות MapReduce ו-Spark
קבצים של היסטוריית משימות Flink (כדי ליצור אשכול Managed Service for Apache Spark להרצת משימות Flink, אפשר לעיין במאמר בנושא רכיב Flink אופציונלי של Dataproc)
קבצים של נתוני ציר הזמן של האפליקציה שנוצרו על ידי YARN Timeline Service v2 ואוחסנו במופע Bigtable.
יומני צבירה של YARN
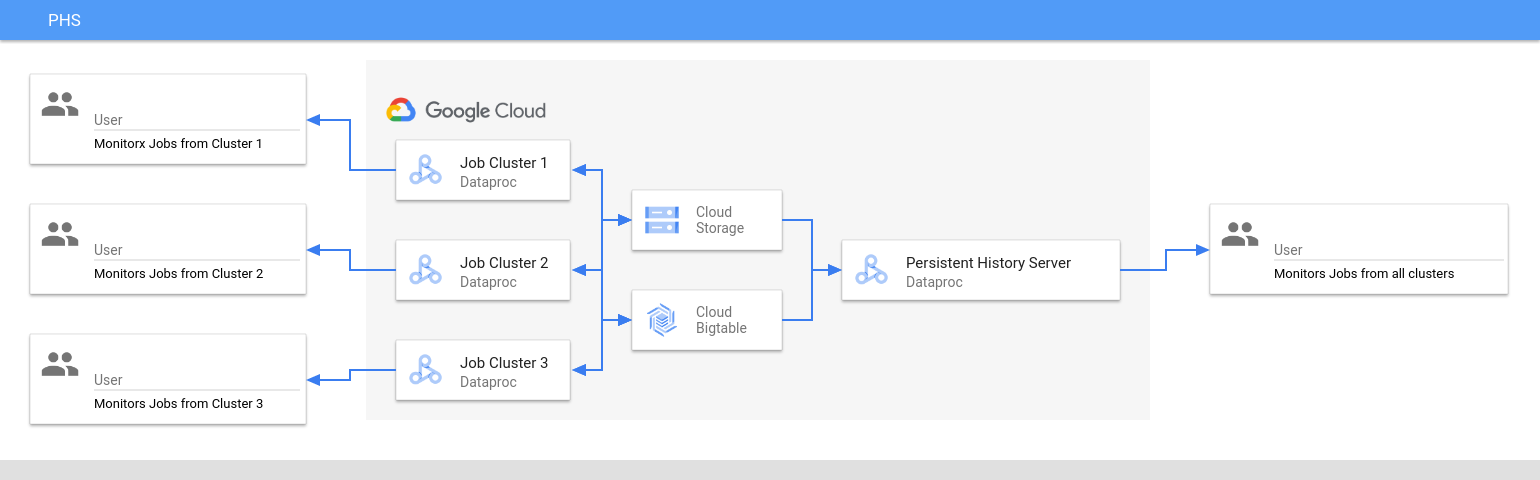
ה-Persistent History Server ניגש לקבצים של היסטוריית משימות Spark ו-MapReduce, לקבצים של היסטוריית משימות Flink ולקובצי יומן YARN שנכתבו ל-Cloud Storage במהלך משך החיים של אשכולות משימות Managed Service for Apache Spark, ומציג אותם.
מגבלות
גרסת תמונת האשכול PHS וגרסת תמונת האשכולות של המשימות ב-Managed Service for Apache Spark צריכות להיות זהות. לדוגמה, אפשר להשתמש באשכול PHS של גרסת תמונה של Managed Service for Apache Spark 2.0 כדי להציג קבצים של היסטוריית משימות של משימות שהורצו באשכולות משימות של גרסת תמונה של Managed Service for Apache Spark 2.0 שנמצאים בפרויקט שבו נמצא אשכול ה-PHS.
ב-PHS cluster אין תמיכה ב-Kerberos ובאימות אישי.
יצירת אשכול PHS של Managed Service for Apache Spark
אפשר להריץ את הפקודה gcloud dataproc clusters create במסוף מקומי או ב-Cloud Shell עם הדגלים ומאפייני האשכול הבאים כדי ליצור אשכול של שרת היסטוריה מתמשך של Managed Service for Apache Spark עם צומת יחיד.
gcloud dataproc clusters create CLUSTER_NAME \
    --project=PROJECT \
    --region=REGION \
    --single-node \
    --enable-component-gateway \
    --optional-components=COMPONENT \
    --properties=PROPERTIES
- CLUSTER_NAME: מציינים את השם של אשכול ה-PHS.
- PROJECT: מציינים את הפרויקט שאליו רוצים לשייך את אשכול ה-PHS. הפרויקט הזה צריך להיות זהה לפרויקט שמשויך לאשכול שמריץ את העבודות (ראו יצירת אשכול של עבודות Dataproc).
- REGION: מציינים אזור של Compute Engine שבו ימוקם אשכול ה-PHS.
-
--single-node: אשכול PHS הוא אשכול עם צומת יחיד ב-Dataproc. -
--enable-component-gateway: הדגל הזה מפעיל ממשקי אינטרנט של Component Gateway באשכול PHS. - COMPONENT: משתמשים בדגל הזה כדי להתקין רכיב אופציונלי אחד או יותר באשכול. כדי להציג קבצים של היסטוריית משימות Flink, צריך לציין את רכיב האופציונלי
FLINKכדי להפעיל את שירות האינטרנט של Flink HistoryServer באשכול PHS. - PROPERTIES. מציינים מאפיין אשכול אחד או יותר.
אופציונלי, מוסיפים את הדגל --image-version כדי לציין את גרסת התמונה של אשכול PHS. גרסת התמונה של PHS צריכה להיות זהה לגרסת התמונה של אשכולות המשימות של Managed Service for Apache Spark. מידע נוסף על מגבלות
הערות:
- בדוגמאות לערכי המאפיינים שבקטע הזה נעשה שימוש בתו כללי לחיפוש '*' כדי לאפשר ל-PHS להתאים לכמה ספריות בדלי שצוין, שנכתבו על ידי אשכולות שונים של משימות (אבל כדאי לעיין בשיקולים לגבי יעילות השימוש בתו כללי לחיפוש).
- בדוגמאות הבאות מוצגים דגלים נפרדים של
--propertiesכדי להקל על הקריאה. השיטה המומלצת לשימוש ב-gcloud dataproc clusters createכדי ליצור אשכול Managed Service for Apache Spark היא להשתמש בדגל--propertiesאחד כדי לציין רשימה של מאפיינים מופרדים בפסיקים (ראו עיצוב מאפייני האשכול).
מאפיינים:
-
yarn:yarn.nodemanager.remote-app-log-dir=gs://bucket-name/*/yarn-logs: מוסיפים את המאפיין הזה כדי לציין את המיקום ב-Cloud Storage שבו PHS יגש ליומני YARN שנכתבו על ידי אשכולות של משימות.
spark:spark.history.fs.logDirectory=gs://bucket-name/*/spark-job-history: מוסיפים את המאפיין הזה כדי להפעיל היסטוריית משימות מתמשכת של Spark. במאפיין הזה מצוין המיקום שבו PHS יגש ליומני היסטוריית משימות Spark שנכתבו על ידי אשכולות משימות.באשכולות של Managed Service for Apache Spark 2.0+, צריך להגדיר גם את שתי המאפיינים הבאים כדי להפעיל את יומני ההיסטוריה של PHS Spark (ראו אפשרויות ההגדרה של Spark History Server). הערך
spark.history.custom.executor.log.urlהוא ערך מילולי שמכיל {{PLACEHOLDERS}} למשתנים שיוגדרו על ידי השרת של היסטוריית ההתמדה. המשתנים האלה לא מוגדרים על ידי המשתמשים. צריך להעביר את ערך המאפיין כמו שמוצג.--properties=spark:spark.history.custom.executor.log.url.applyIncompleteApplication=false
--properties=spark:spark.history.custom.executor.log.url={{YARN_LOG_SERVER_URL}}/{{NM_HOST}}:{{NM_PORT}}/{{CONTAINER_ID}}/{{CONTAINER_ID}}/{{USER}}/{{FILE_NAME}}
mapred:mapreduce.jobhistory.read-only.dir-pattern=gs://bucket-name/*/mapreduce-job-history/done: מוסיפים את המאפיין הזה כדי להפעיל היסטוריה מתמשכת של עבודות MapReduce. המאפיין הזה מציין את המיקום ב-Cloud Storage שבו PHS יגש ליומני היסטוריית העבודות של MapReduce שנכתבו על ידי אשכולות עבודות.
dataproc:yarn.atsv2.bigtable.instance=projects/project-id/instance_id/bigtable-instance-id: אחרי שמגדירים את Yarn Timeline Service v2, מוסיפים את המאפיין הזה כדי להשתמש באשכול PHS לצפייה בנתוני ציר הזמן בממשקי האינטרנט של YARN Application Timeline Service V2 ושל Tez (ראו ממשקי אינטרנט של Component Gateway).
flink:historyserver.archive.fs.dir=gs://bucket-name/*/flink-job-history/completed-jobs: המאפיין הזה משמש להגדרת FlinkHistoryServerכדי לעקוב אחרי רשימה של ספריות שמופרדות בפסיקים.
דוגמאות לנכסים:
--properties=spark:spark.history.fs.logDirectory=gs://bucket-name/*/spark-job-history
--properties=mapred:mapreduce.jobhistory.read-only.dir-pattern=gs://bucket-name/*/mapreduce-job-history/done
--properties=flink:flink.historyserver.archive.fs.dir=gs://bucket-name/*/flink-job-history/completed-jobs
יצירת אשכול משימות של Managed Service for Apache Spark
כדי ליצור אשכול משימות של Managed Service for Apache Spark שמריץ משימות וכותב קבצים של היסטוריית משימות ל-Persistent History Server (PHS), אפשר להריץ את הפקודה הבאה בטרמינל מקומי או ב-Cloud Shell.
gcloud dataproc clusters create CLUSTER_NAME \ --project=PROJECT \ --region=REGION \ --optional-components=COMPONENT \ --enable-component-gateway \ --properties=PROPERTIES \ other args ...
- CLUSTER_NAME: מציינים את השם של אשכול המשימות.
- PROJECT: ציון הפרויקט שמשויך לאשכול המשימות.
- REGION: מציינים את האזור של Compute Engine שבו ימוקם אשכול העבודות.
-
--enable-component-gateway: הדגל הזה מפעיל את ממשקי האינטרנט של Component Gateway באשכול העבודות. - COMPONENT: משתמשים בדגל הזה כדי להתקין רכיב אופציונלי אחד או יותר באשכול. מציינים את
FLINKהרכיב האופציונלי כדי להריץ משימות של Flink באשכול. PROPERTIES: מוסיפים אחת או יותר ממאפייני האשכול הבאים כדי להגדיר מיקומי Cloud Storage שאינם ברירת מחדל שקשורים ל-PHS ומאפיינים אחרים של אשכולות משימות.
הערות:
- בדוגמאות לערכי המאפיינים שבקטע הזה נעשה שימוש בתו כללי לחיפוש '*' כדי לאפשר ל-PHS להתאים לכמה ספריות בדלי שצוין, שנכתבו על ידי אשכולות שונים של משימות (אבל כדאי לעיין בשיקולים לגבי יעילות השימוש בתו כללי לחיפוש).
- בדוגמאות הבאות מוצגים דגלים נפרדים של
--propertiesכדי להקל על הקריאה. השיטה המומלצת לשימוש ב-gcloud dataproc clusters createכדי ליצור אשכול Managed Service for Apache Spark היא להשתמש בדגל--propertiesאחד כדי לציין רשימה של מאפיינים מופרדים בפסיקים (ראו עיצוב מאפייני האשכול).
מאפיינים:
-
yarn:yarn.nodemanager.remote-app-log-dir: כברירת מחדל, יומני YARN מצטברים מופעלים באשכולות של משימות Managed Service for Apache Spark ונכתבים במאגר הזמני של האשכול. מוסיפים את המאפיין הזה כדי לציין מיקום אחר ב-Cloud Storage שבו האשכול יכתוב יומני צבירה לגישה על ידי Persistent History Server.--properties=yarn:yarn.nodemanager.remote-app-log-dir=gs://bucket-name/directory-name/yarn-logs
-
spark:spark.history.fs.logDirectoryו-spark:spark.eventLog.dir: כברירת מחדל, קבצים של היסטוריית עבודות ב-Spark נשמרים באשכולtemp bucketבספרייה/spark-job-history. אתם יכולים להוסיף את המאפיינים האלה כדי לציין מיקומים שונים ב-Cloud Storage עבור הקבצים האלה. אם משתמשים בשני הנכסים, הם צריכים להצביע על ספריות באותה קטגוריה.--properties=spark:spark.history.fs.logDirectory=gs://bucket-name/directory-name/spark-job-history
--properties=spark:spark.eventLog.dir=gs://bucket-name/directory-name/spark-job-history
-
mapred:mapreduce.jobhistory.done-dirו-mapred:mapreduce.jobhistory.intermediate-done-dir: כברירת מחדל, קבצים של היסטוריית משימות MapReduce נשמרים באשכולtemp bucketבספריות/mapreduce-job-history/doneו-/mapreduce-job-history/intermediate-done. המיקום הזמניmapreduce.jobhistory.intermediate-done-dirהוא אחסון זמני. הקבצים הזמניים מועברים למיקוםmapreduce.jobhistory.done-dirכשהמשימה של MapReduce מסתיימת. אתם יכולים להוסיף את המאפיינים האלה כדי לציין מיקומים שונים ב-Cloud Storage לקבצים האלה. אם משתמשים בשני המאפיינים, הם צריכים להפנות לספריות באותה קטגוריה.--properties=mapred:mapreduce.jobhistory.done-dir=gs://bucket-name/directory-name/mapreduce-job-history/done
--properties=mapred:mapreduce.jobhistory.intermediate-done-dir=gs://bucket-name/directory-name/mapreduce-job-history/intermediate-done
-
spark:spark.history.fs.gs.outputstream.type: המאפיין הזה חל על אשכולות של גרסאות תמונה של2.0ושל2.1שמשתמשים בגרסה2.0.xשל המחבר ל-Cloud Storage (גרסת המחבר שמוגדרת כברירת מחדל לאשכולות של גרסאות תמונה של2.0ושל2.1). הוא קובע איך משימות Spark שולחות נתונים ל-Cloud Storage. הגדרת ברירת המחדל היאBASIC, ששולחת נתונים ל-Cloud Storage אחרי השלמת העבודה. אם הערך שמוגדר הואFLUSHABLE_COMPOSITE, הנתונים מועתקים ל-Cloud Storage במרווחי זמן קבועים בזמן שהמשימה פועלת, בהתאם לערך שמוגדר ב-spark:spark.history.fs.gs.outputstream.sync.min.interval.ms.--properties=spark:spark.history.fs.gs.outputstream.type=FLUSHABLE_COMPOSITE
-
spark:spark.history.fs.gs.outputstream.sync.min.interval.ms: המאפיין הזה חל על אשכולות של גרסאות תמונה של2.0ושל2.1שמשתמשים בגרסה2.0.xשל Cloud Storage connector (גרסת ברירת המחדל של המחבר לאשכולות של גרסאות תמונה של2.0ושל2.1). היא קובעת את התדירות באלפיות השנייה שבה הנתונים מועברים ל-Cloud Storage כשמגדירים אתspark:spark.history.fs.gs.outputstream.typeלערךFLUSHABLE_COMPOSITE. ערך ברירת המחדל של מרווח הזמן הוא5000ms. אפשר לציין את ערך מרווח הזמן במילישניות עם או בלי הסיומתms.--properties=spark:spark.history.fs.gs.outputstream.sync.min.interval.ms=INTERVALms
-
spark:spark.history.fs.gs.outputstream.sync.min.interval: המאפיין הזה חל על2.2ומעלה של אשכולות גרסאות תמונה שמשתמשים בגרסה3.0.xשל מחבר Cloud Storage (גרסת המחבר שמוגדרת כברירת מחדל לאשכולות גרסאות תמונה של2.2). הוא מחליף את הנכס הקודםspark:spark.history.fs.gs.outputstream.sync.min.interval.msותומך בערכים עם סיומת של שעה, כמוms,sו-m. היא קובעת את התדירות שבה הנתונים מועברים ל-Cloud Storage כשהערך שלspark:spark.history.fs.gs.outputstream.typeמוגדר ל-FLUSHABLE_COMPOSITE.--properties=spark:spark.history.fs.gs.outputstream.sync.min.interval=INTERVAL
-
dataproc:yarn.atsv2.bigtable.instance: אחרי ההגדרה של Yarn Timeline Service v2, מוסיפים את המאפיין הזה כדי לכתוב נתונים של ציר הזמן של YARN למופע Bigtable שצוין לצפייה בממשקי האינטרנט של YARN Application Timeline Service V2 ושל Tez באשכול PHS. הערה: יצירת האשכול תיכשל אם מופע Bigtable לא קיים.--properties=dataproc:yarn.atsv2.bigtable.instance=projects/project-id/instance_id/bigtable-instance-id
-
flink:jobhistory.archive.fs.dir: JobManager של Flink מארכב משימות של Flink שהושלמו על ידי העלאת פרטי המשימה המאורכבים לספרייה במערכת הקבצים. משתמשים במאפיין הזה כדי להגדיר את ספריית הארכיון ב-flink-conf.yaml.--properties=flink:jobmanager.archive.fs.dir=gs://bucket-name/job-cluster-1/flink-job-history/completed-jobs
שימוש ב-PHS עם עומסי עבודה של אצוות Spark
כדי להשתמש ב-Persistent History Server עם Managed Service for Apache Spark Serverless לעומסי עבודה של Spark batch:
כששולחים עומס עבודה של אצווה ב-Spark, בוחרים או מציינים את אשכול ה-PHS.
שימוש ב-PHS עם Managed Service for Apache Spark ב-Google Kubernetes Engine
כדי להשתמש ב-Persistent History Server עם Managed Service for Apache Spark on GKE:
כשיוצרים Managed Service for Apache Spark באשכול וירטואלי של GKE, צריך לבחור או לציין את אשכול PHS.
ממשקי אינטרנט של Component Gateway
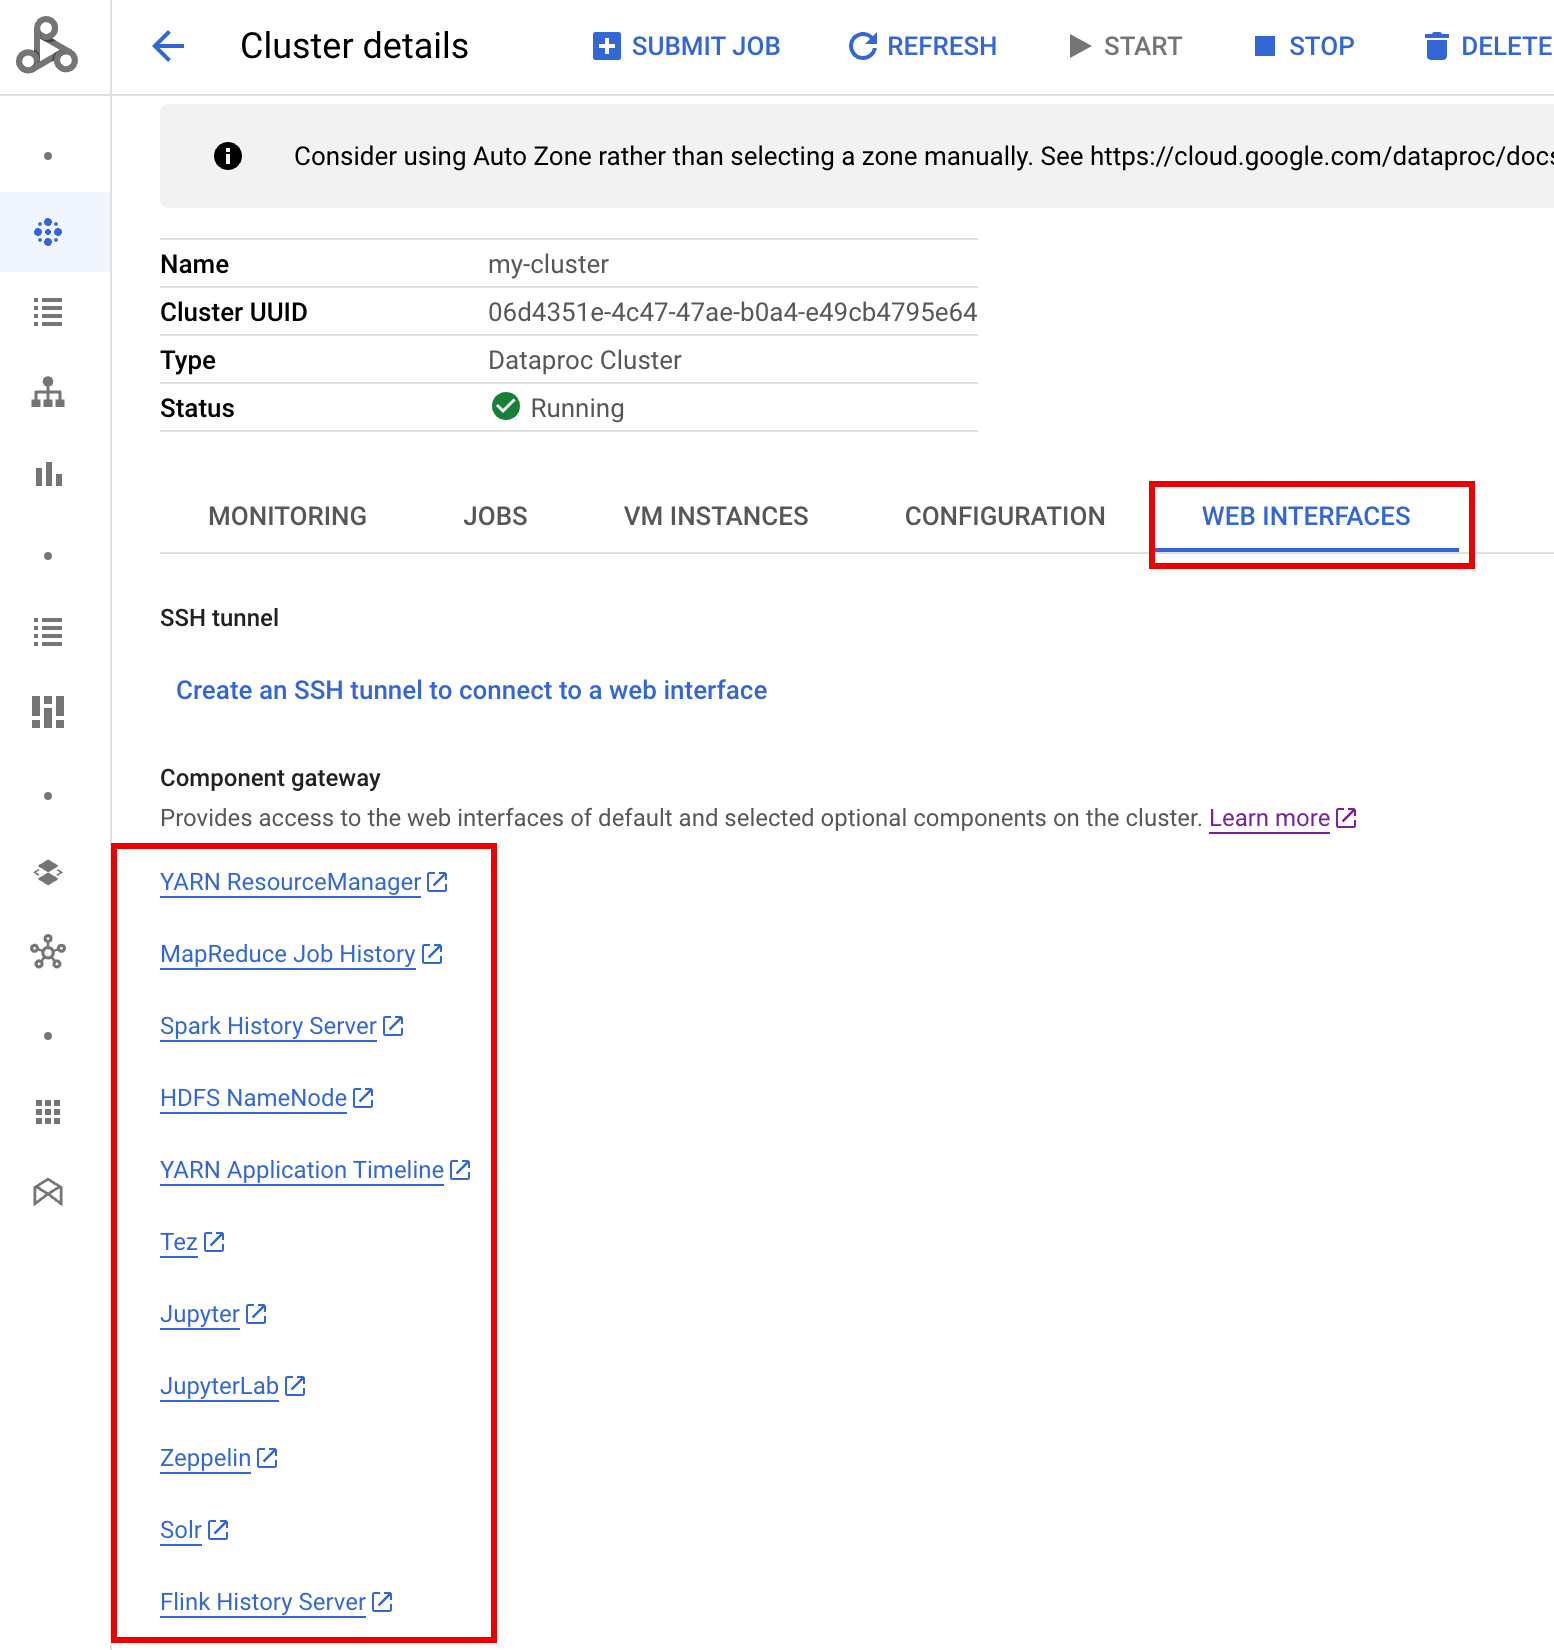
במסוף Google Cloud , בדף Managed Service for Apache Spark Clusters, לוחצים על שם אשכול PHS כדי לפתוח את הדף Cluster details. בכרטיסייה Web Interfaces, בוחרים את הקישורים של שער הרכיבים כדי לפתוח ממשקי אינטרנט שפועלים באשכול PHS.
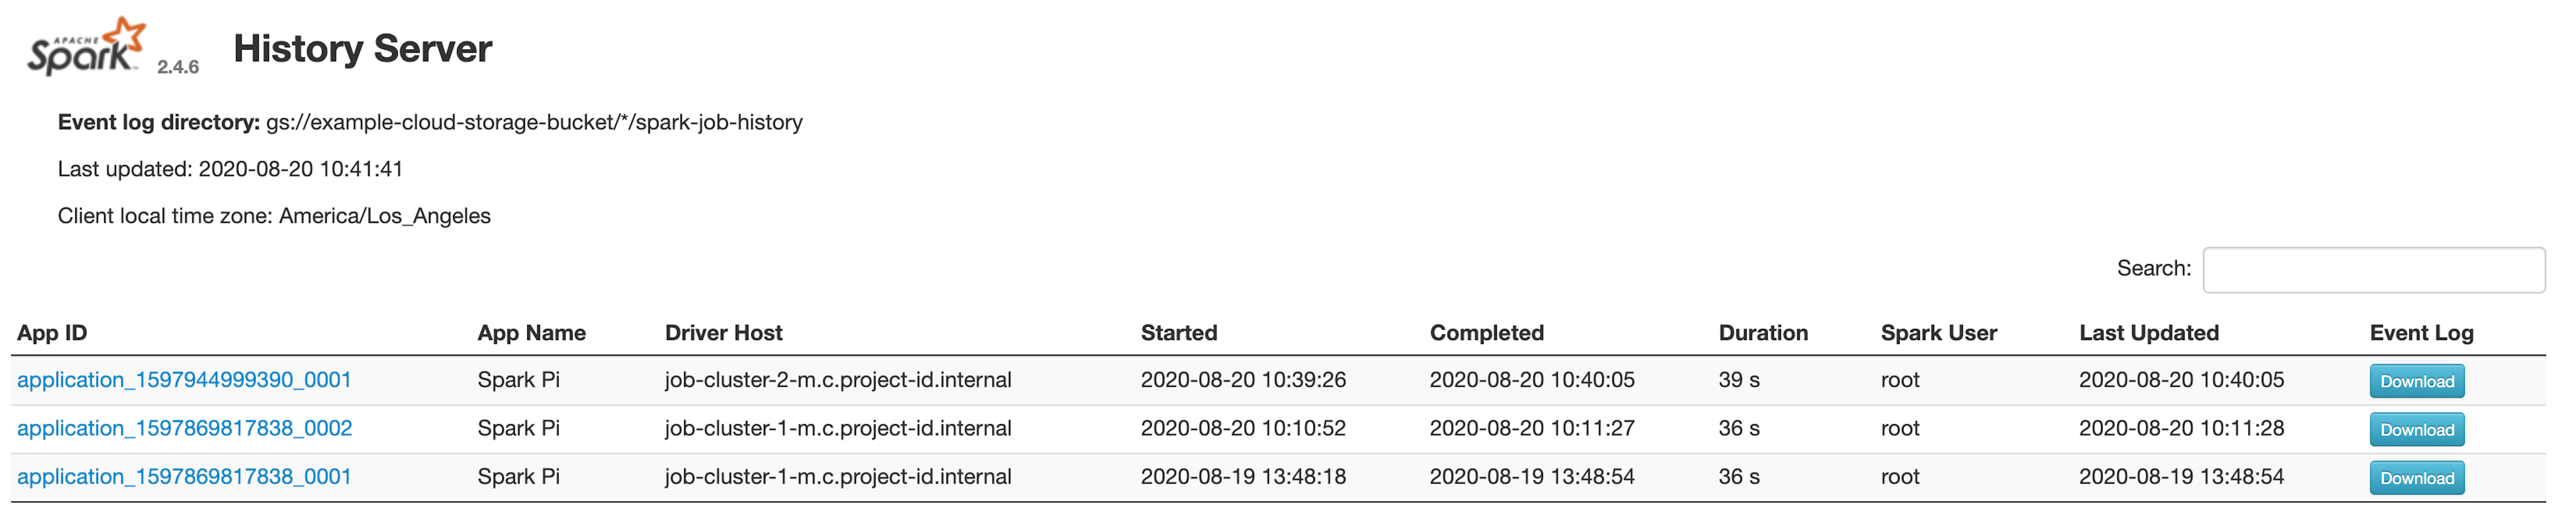
ממשק האינטרנט של Spark History Server
בצילום המסך הבא מוצג ממשק האינטרנט של Spark History Server עם קישורים למשימות Spark שמופעלות ב-job-cluster-1 וב-job-cluster-2 אחרי הגדרת המיקומים של job-cluster-1 spark.history.fs.logDirectory ו-job-cluster-2 spark:spark.eventLog.dir ושל אשכול PHS spark.history.fs.logDirectory באופן הבא:
| job-cluster-1 | gs://example-cloud-storage-bucket/job-cluster-1/spark-job-history |
| job-cluster-2 | gs://example-cloud-storage-bucket/job-cluster-2/spark-job-history |
| phs-cluster | gs://example-cloud-storage-bucket/*/spark-job-history |
חיפוש לפי שם האפליקציה
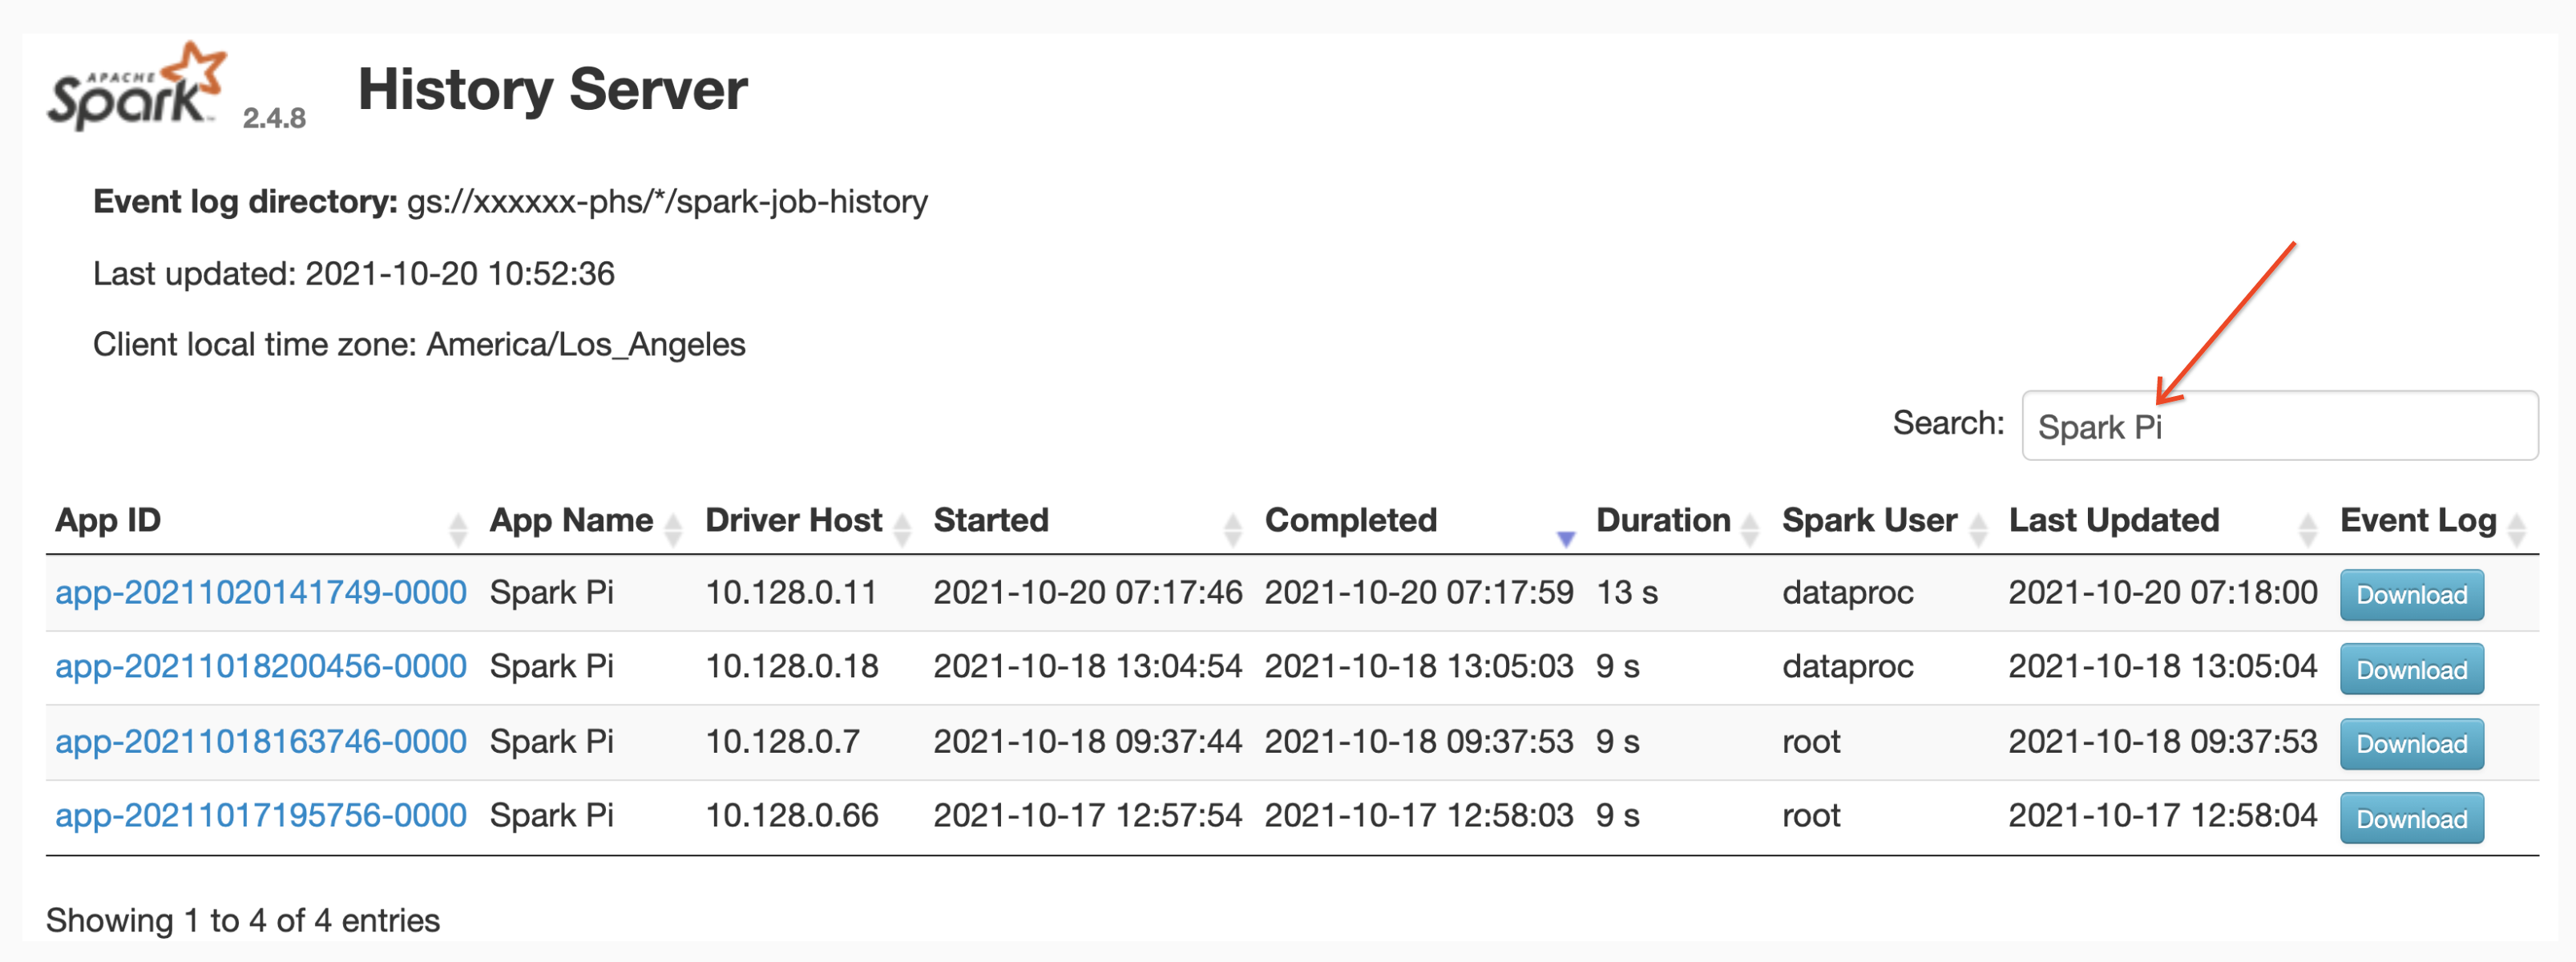
אפשר להציג רשימה של משימות לפי שם האפליקציה בממשק האינטרנט של Spark History Server. לשם כך, מזינים את שם האפליקציה בתיבת החיפוש. אפשר להגדיר את שם האפליקציה באחת מהדרכים הבאות (לפי סדר העדיפות):
- הגדרה בתוך קוד האפליקציה בזמן יצירת הקשר של Spark
- המאפיין spark.app.name מוגדר כשמגישים את העבודה
- הערך מוגדר על ידי Managed Service for Apache Spark לשם המשאב המלא של REST עבור משימה (
projects/project-id/regions/region/jobs/job-id)
המשתמשים יכולים להזין מונח של שם אפליקציה או משאב בתיבת החיפוש כדי למצוא משרות ולראות רשימה שלהן.
יומני אירועים
בממשק האינטרנט של Spark History Server יש לחצן Event Log שאפשר ללחוץ עליו כדי להוריד יומני אירועים של Spark. היומנים האלה שימושיים לבדיקת מחזור החיים של אפליקציית Spark.
משימות Spark
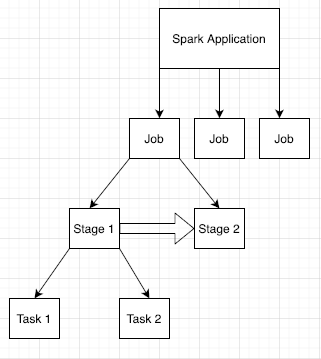
אפליקציות Spark מחולקות לכמה עבודות, שכל אחת מהן מחולקת לכמה שלבים. כל שלב יכול לכלול כמה משימות שמופעלות בצמתים של מנוע ההפעלה (עובדים).
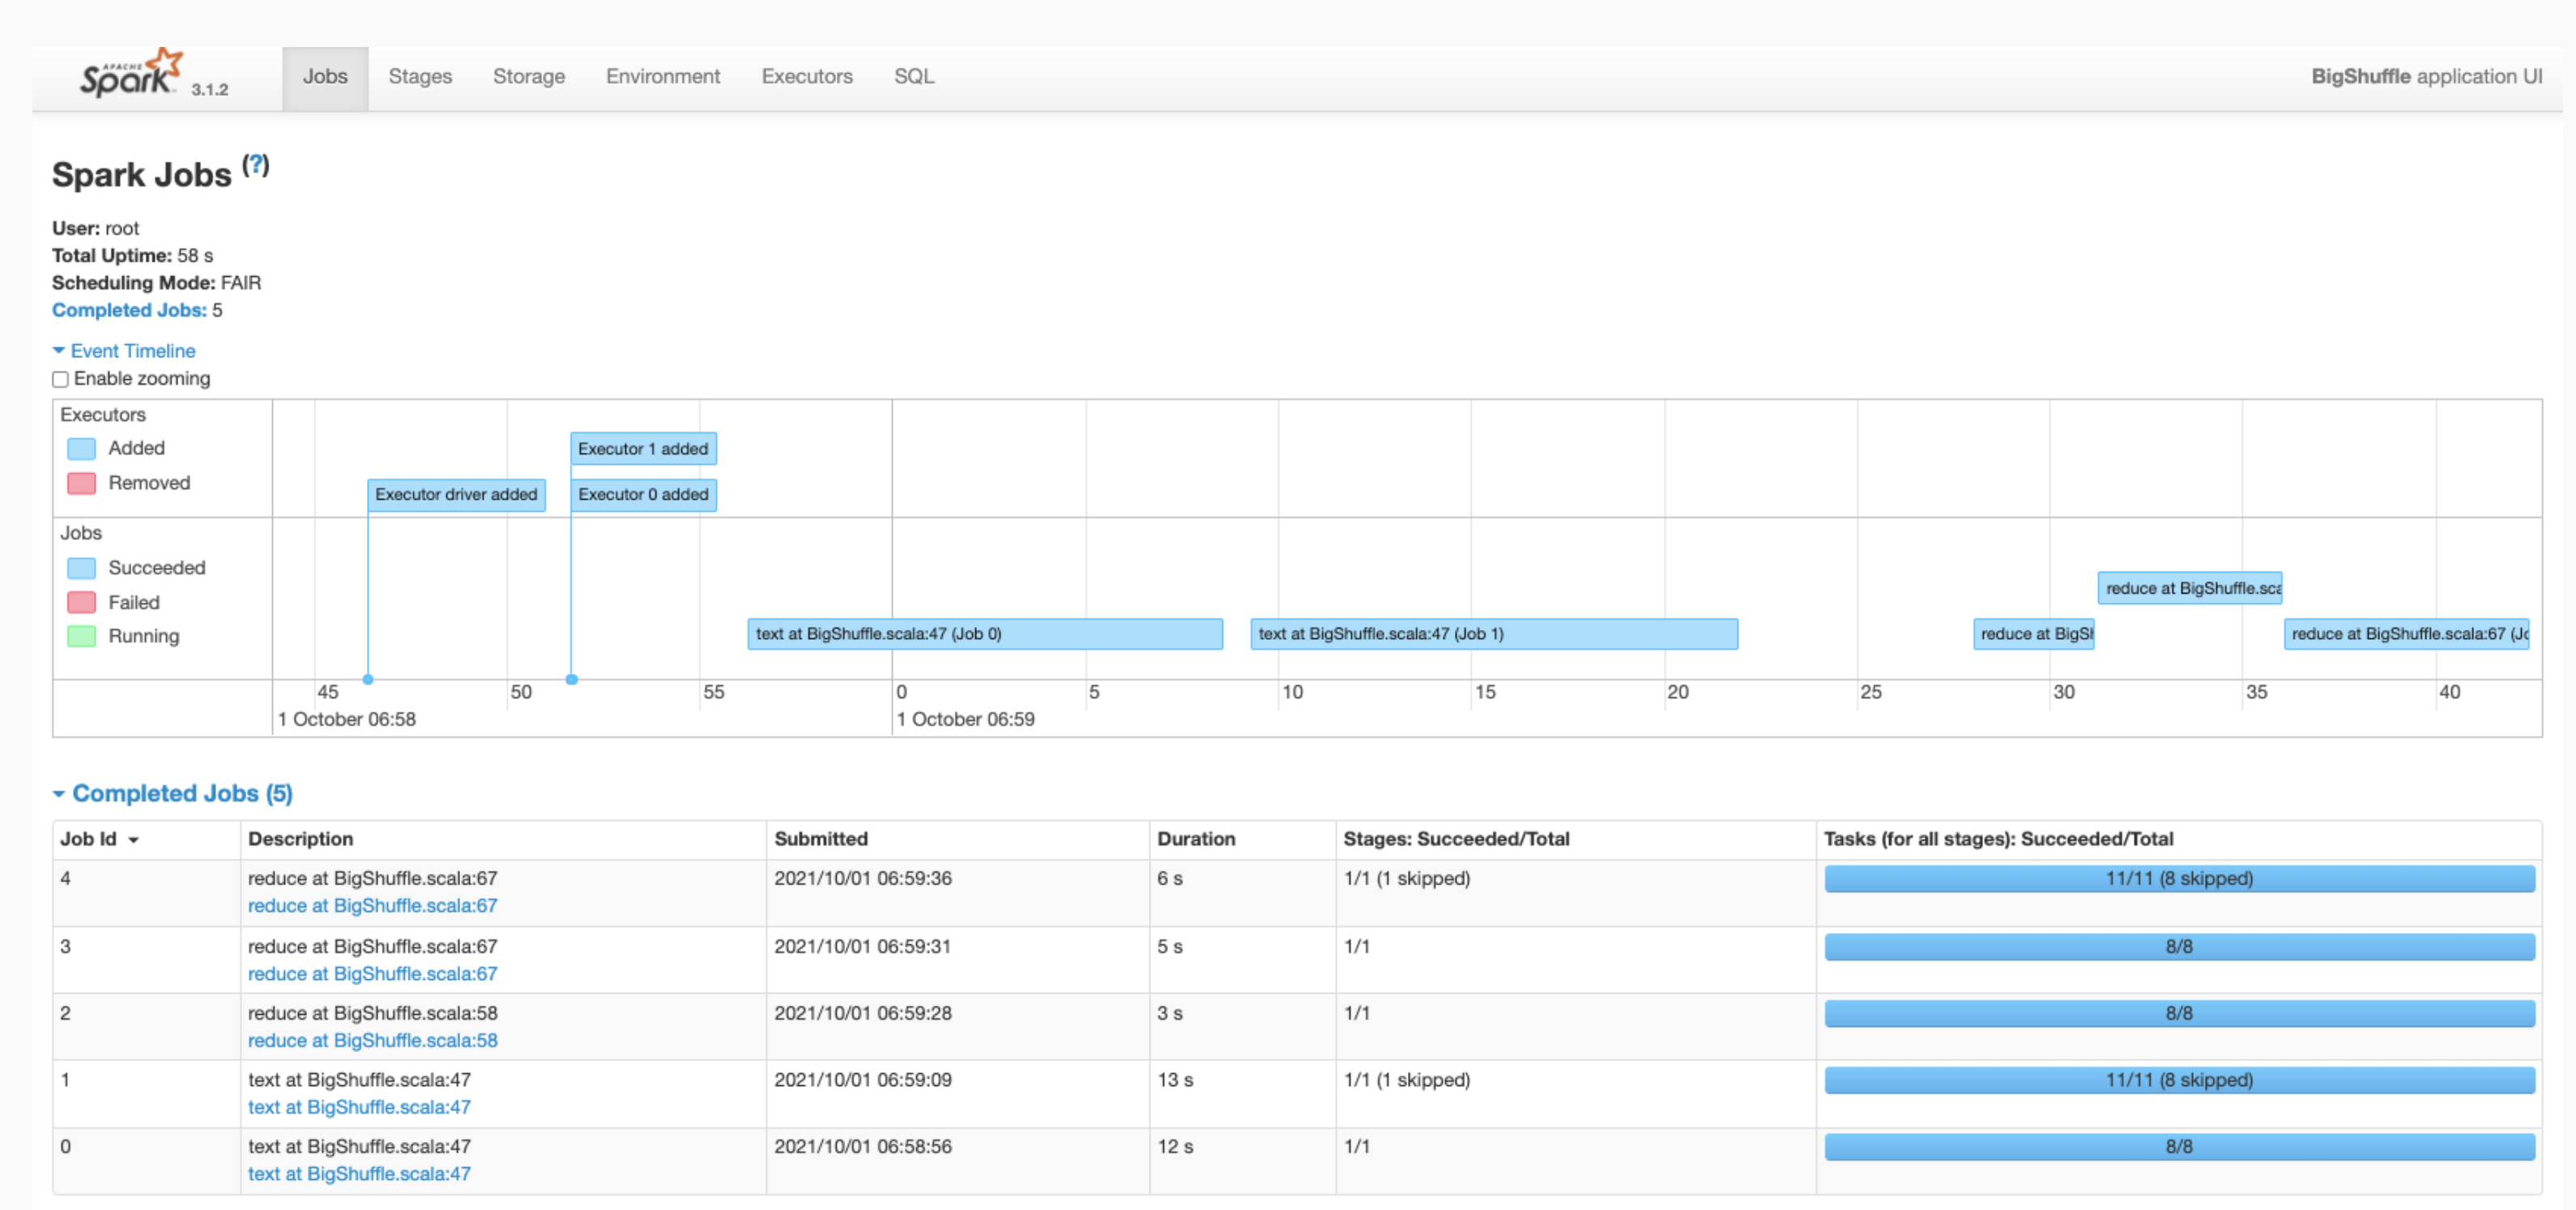
לוחצים על מזהה אפליקציית Spark בממשק האינטרנט כדי לפתוח את הדף Spark Jobs (משימות Spark), שבו מוצגים ציר זמן של אירועים וסיכום של משימות באפליקציה.
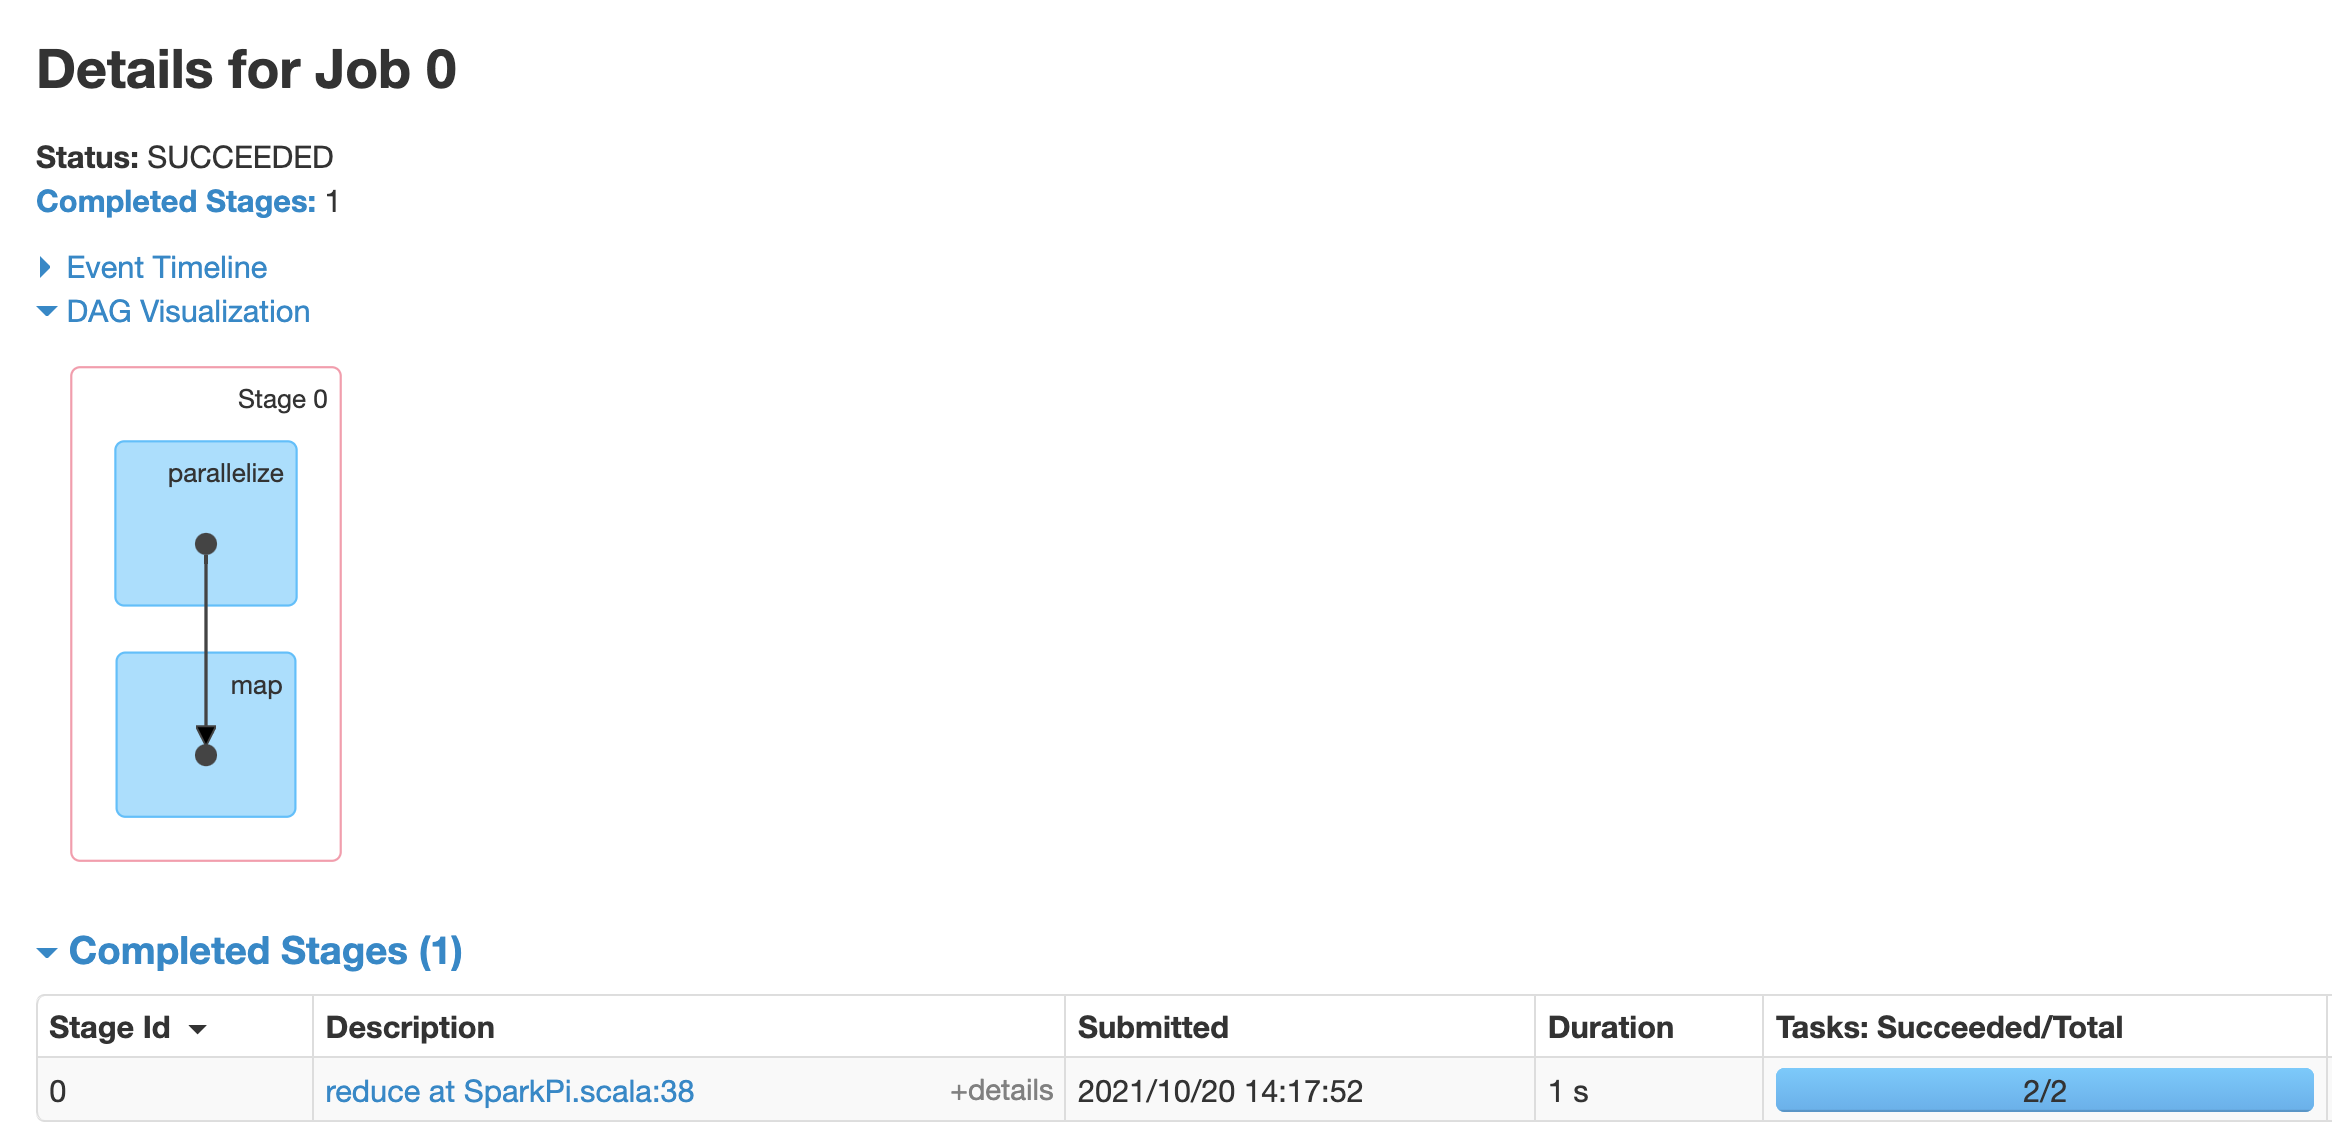
לוחצים על משרה כדי לפתוח את הדף 'פרטי משרה' עם גרף אציקלי מכוון (DAG) וסיכום של שלבי המשרה.
לוחצים על שלב או משתמשים בכרטיסייה Stages (שלבים) כדי לבחור שלב ולפתוח את דף הפרטים של השלב.
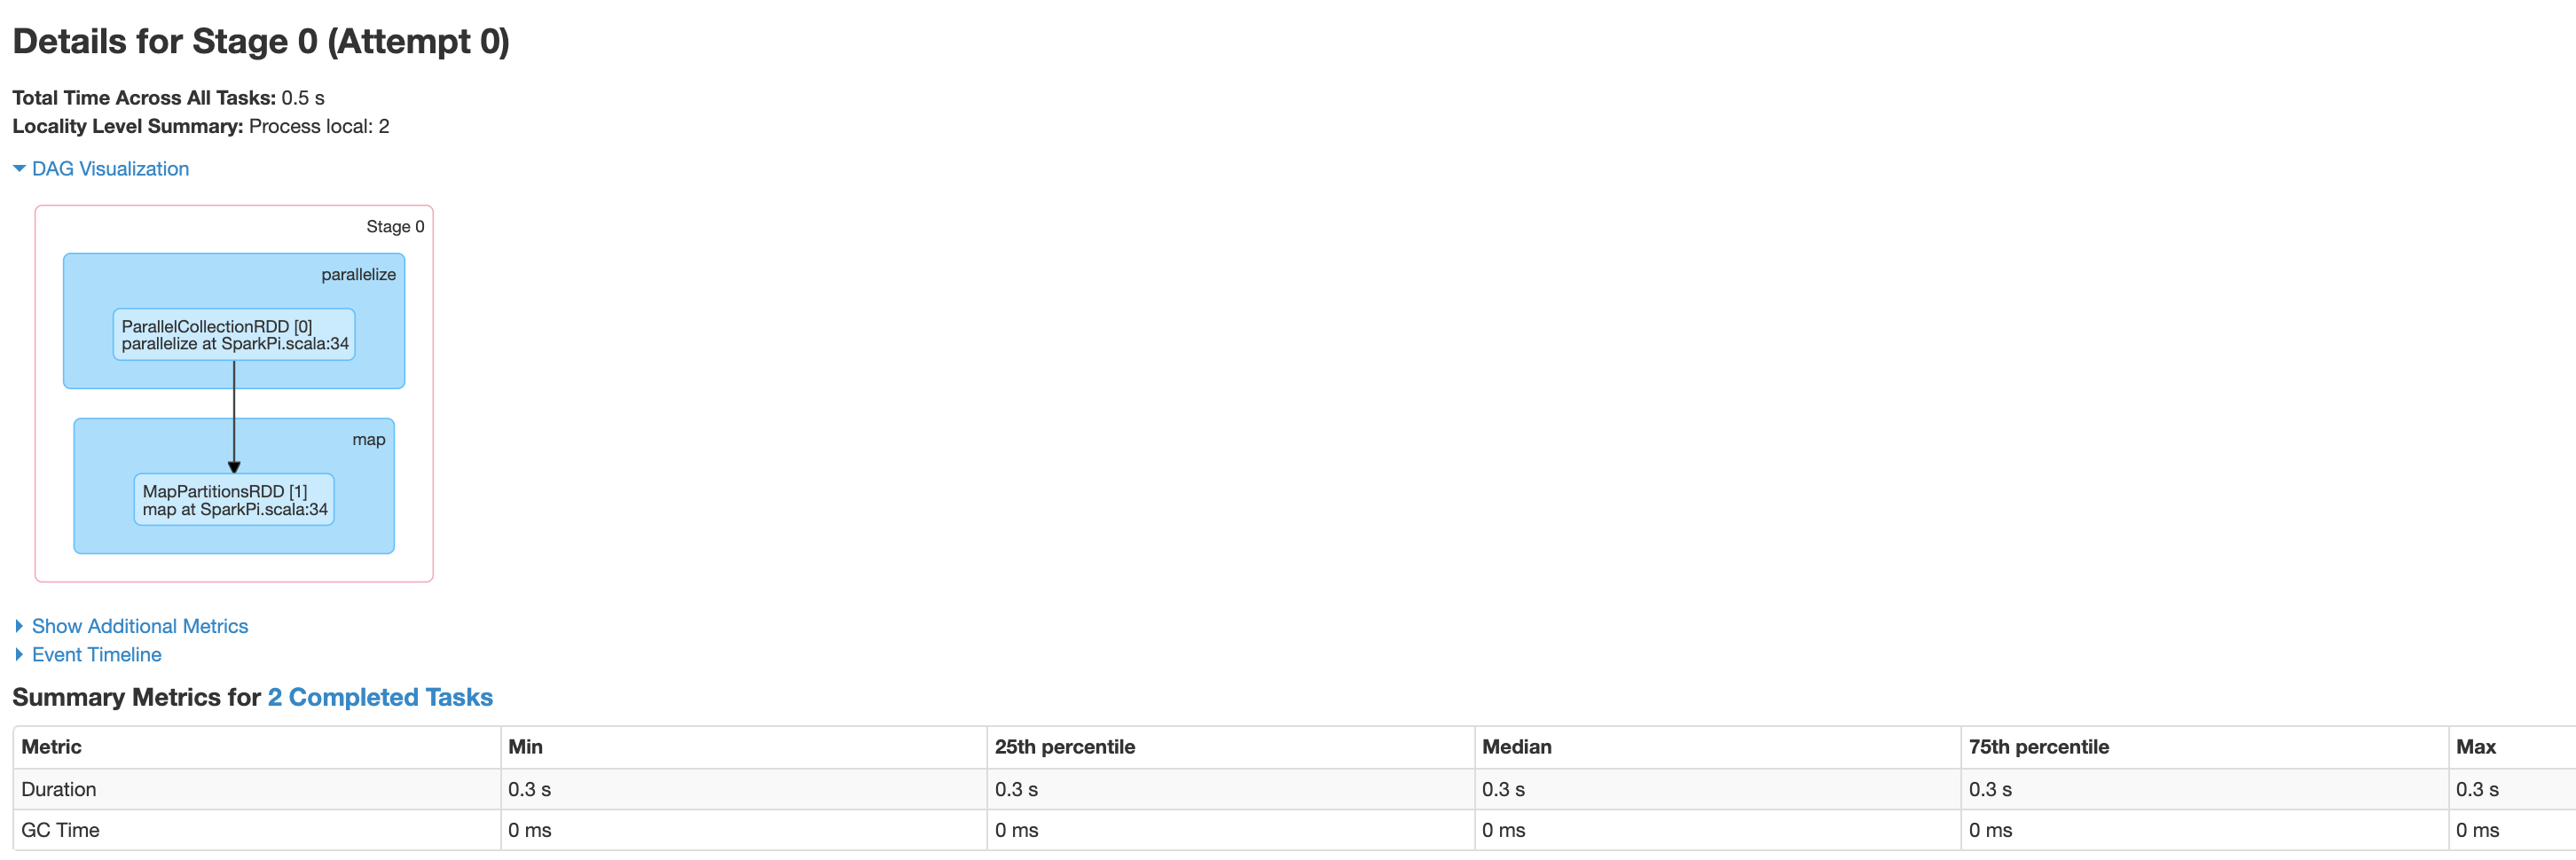
הכרטיסייה 'פרטי השלב' כוללת תרשים DAG, ציר זמן של אירועים ומדדים של המשימות בשלב. בדף הזה אפשר לפתור בעיות שקשורות למשימות שנתקעות, לעיכובים בתזמון ולשגיאות שקשורות לחוסר זיכרון. בכלי להמחשת DAG מוצגת שורת הקוד שממנה נגזר השלב, וכך אפשר לעקוב אחרי בעיות עד לקוד.
לוחצים על הכרטיסייה Executors כדי לקבל מידע על הצמתים של מנהל התוכנה והמבצעים באפליקציית Spark.
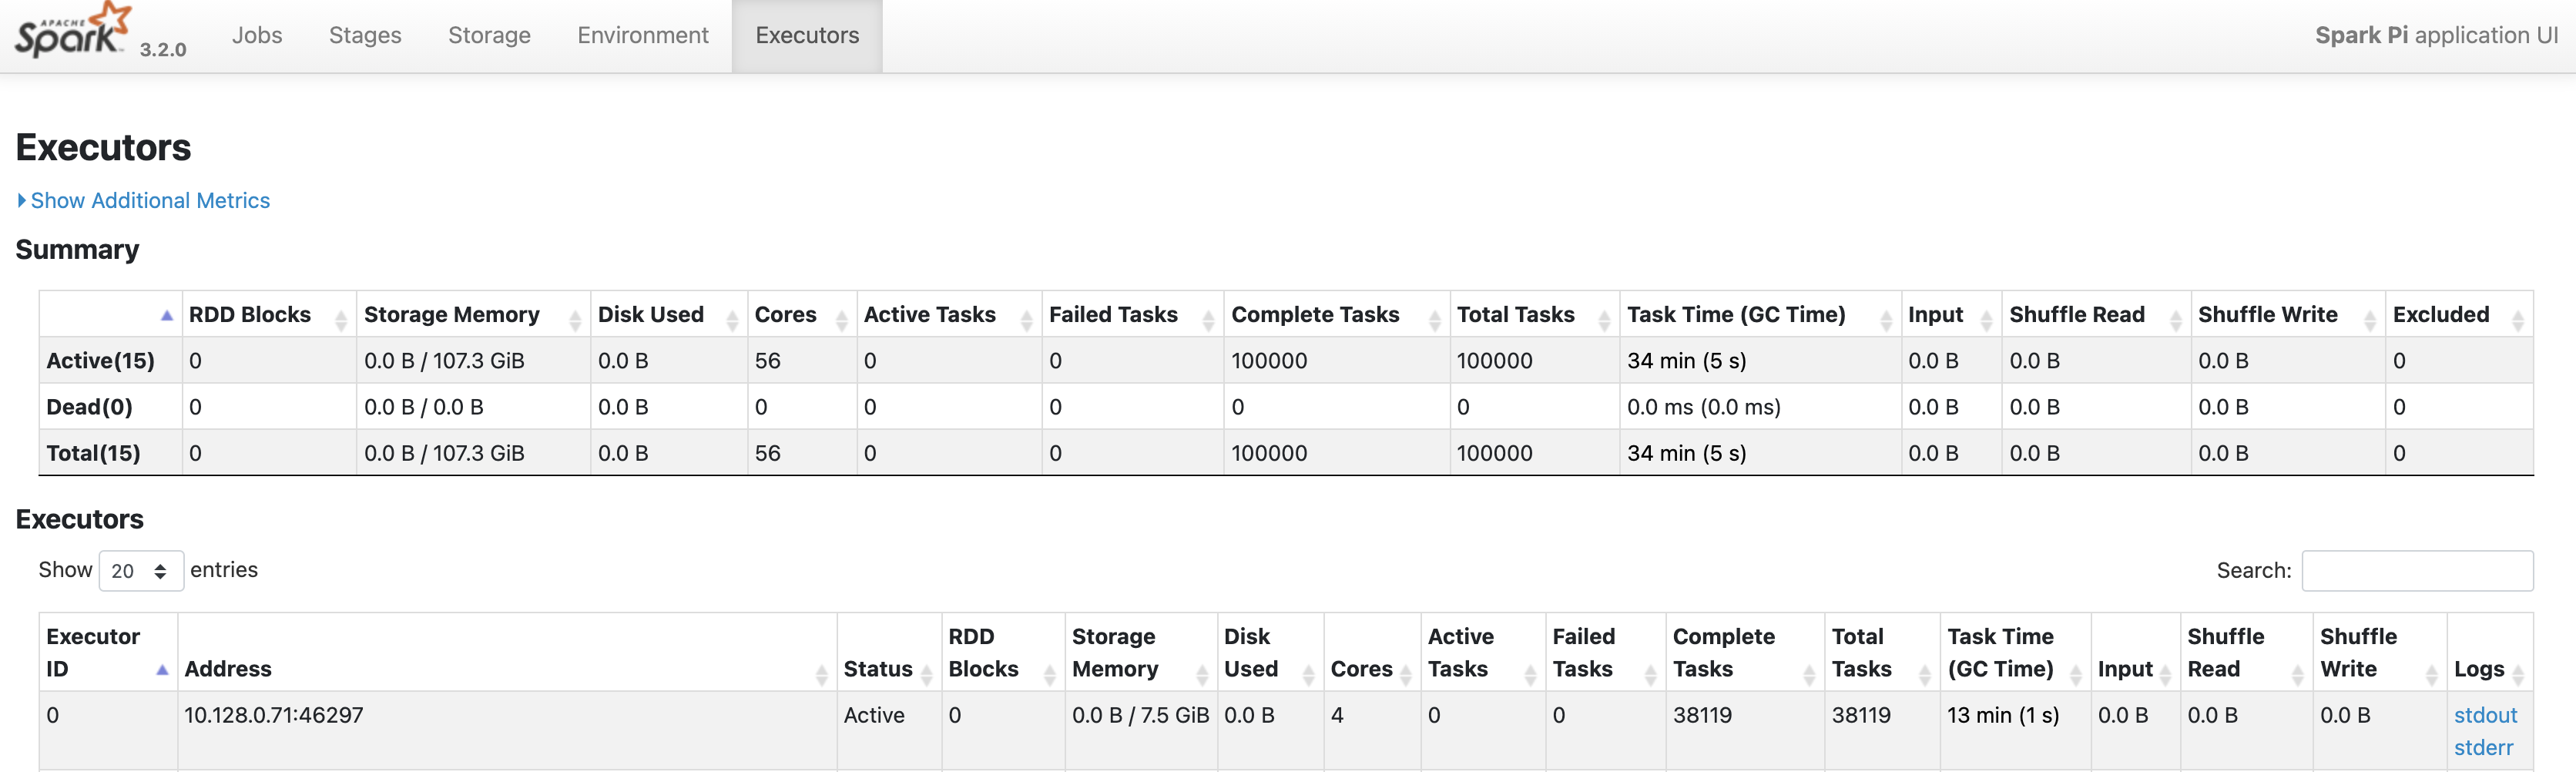
בין הפרטים החשובים שמופיעים בדף הזה אפשר למצוא את מספר ליבות המעבד ואת מספר המשימות שהופעלו בכל רכיב Executor.
ממשק האינטרנט של Tez
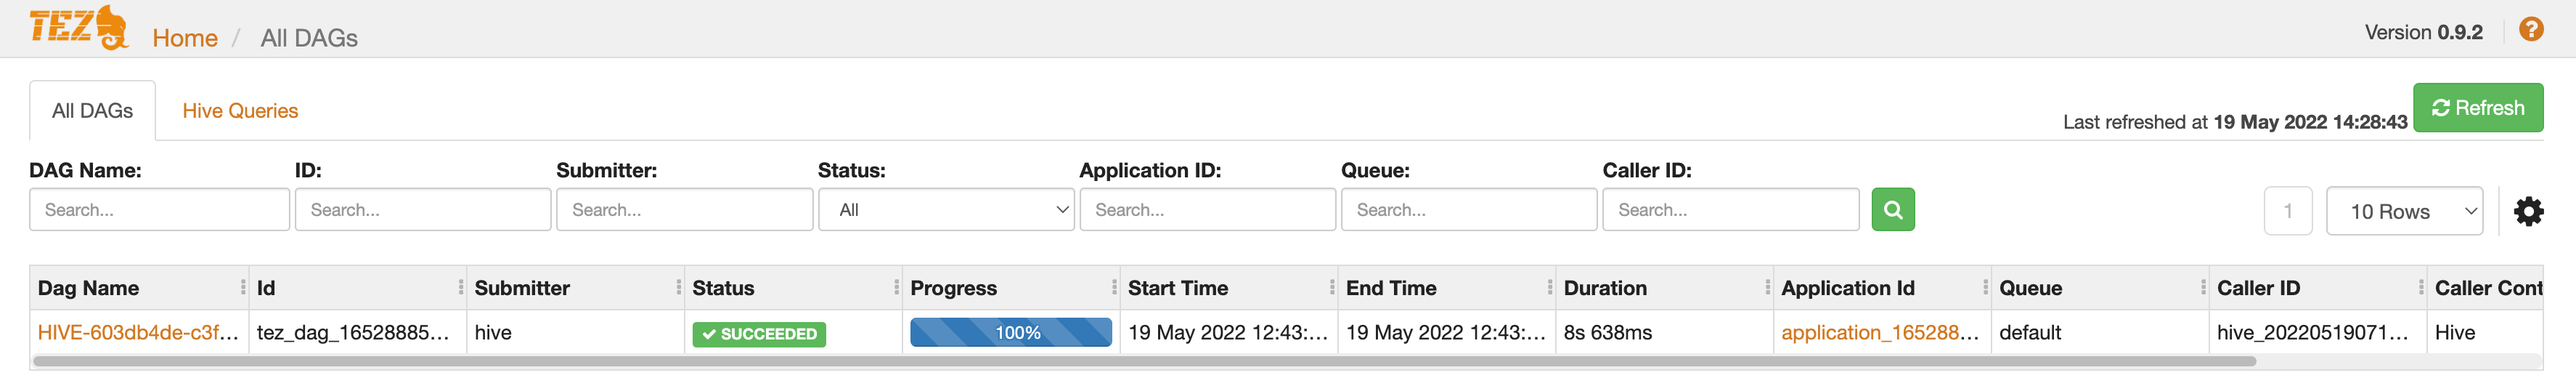
Tez הוא מנוע ההפעלה שמוגדר כברירת מחדל ל-Hive ול-Pig ב-Managed Service for Apache Spark. שליחת משימת Hive באשכול משימות של Managed Service for Apache Spark מפעילה אפליקציית Tez.
אם הגדרתם את Yarn Timeline Service v2 והגדרתם את המאפיין dataproc:yarn.atsv2.bigtable.instance כשנוצרו אשכולות של משימות PHS ו-Managed Service for Apache Spark, YARN כותב נתונים שנוצרו בציר הזמן של משימות Hive ו-Pig למופע Bigtable שצוין לצורך אחזור והצגה בממשק האינטרנט של Tez שפועל בשרת PHS.
ממשק האינטרנט של YARN Application Timeline V2
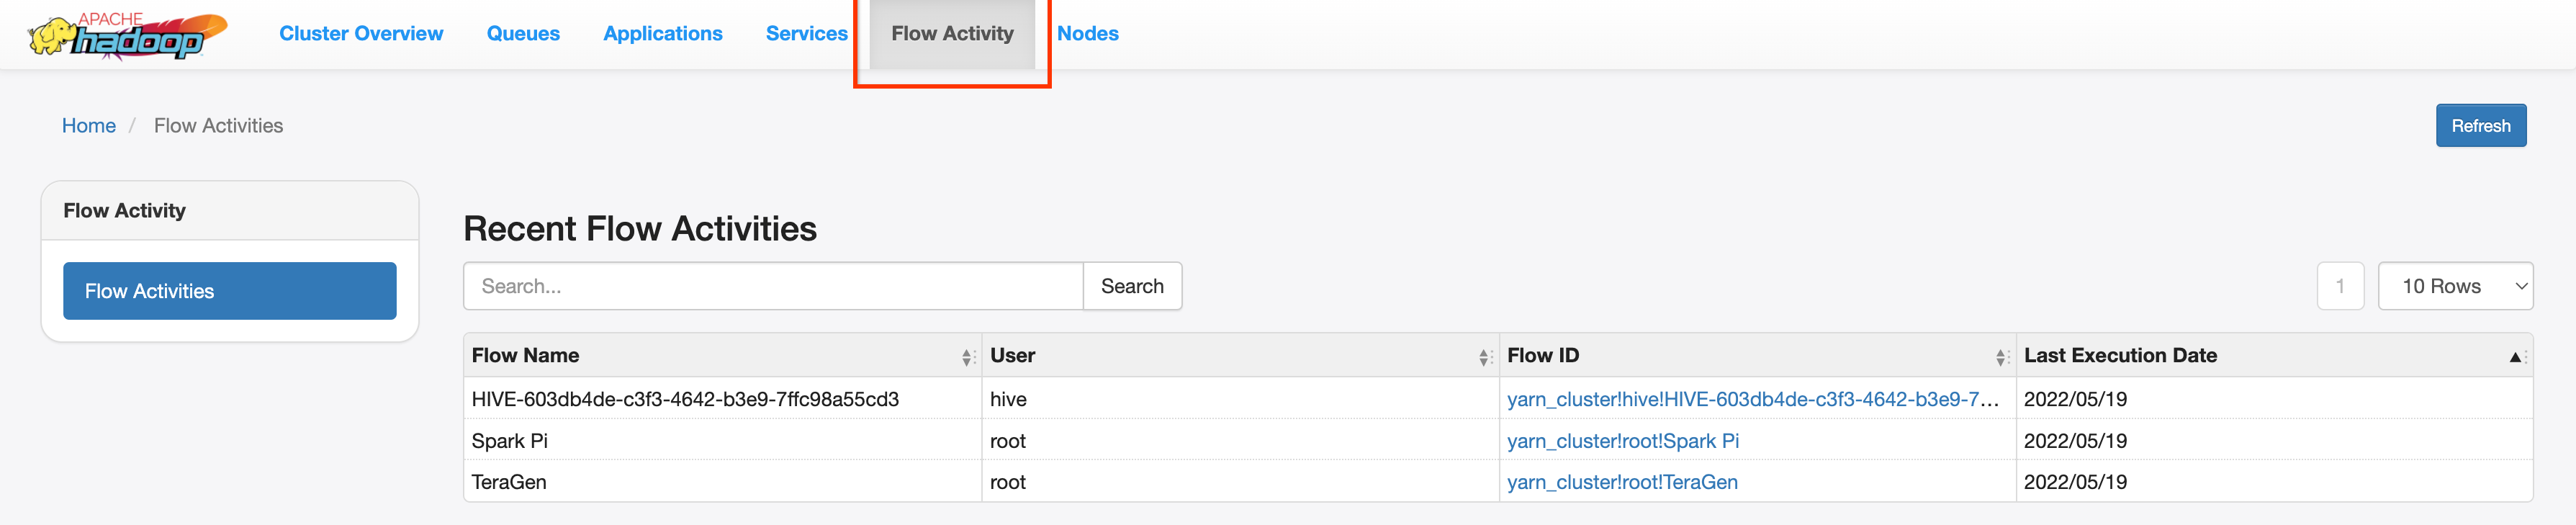
אם הגדרתם את Yarn Timeline Service v2 והגדרתם את המאפיין dataproc:yarn.atsv2.bigtable.instance כשנוצרו אשכולות של משימות PHS ו-Managed Service for Apache Spark, YARN כותב נתונים של ציר זמן של משימות שנוצרו למופע Bigtable שצוין לצורך אחזור והצגה בממשק האינטרנט של YARN Application Timeline Service שפועל בשרת PHS. משימות של Managed Service for Apache Spark מפורטות בכרטיסייה Flow Activity בממשק האינטרנט.
הגדרת Yarn Timeline Service v2
כדי להגדיר את Yarn Timeline Service v2, צריך להגדיר מופע Bigtable ולבדוק את התפקידים של חשבון השירות, אם צריך, באופן הבא:
בודקים את התפקידים של חשבון השירות, אם צריך. לחשבון השירות של המכונה הווירטואלית שמשמש את המכונות הווירטואליות באשכול Dataproc יש את ההרשאות הנדרשות ליצירה ולהגדרה של מופע Bigtable עבור YARN Timeline Service. אם יוצרים את העבודה או את אשכול PHS באמצעות חשבון שירות של מכונה וירטואלית בהתאמה אישית, לחשבון צריך להיות מוקצה התפקיד Bigtable
AdministratorאוBigtable User.
סכימת הטבלה הנדרשת
כדי להשתמש ב-Managed Service for Apache Spark PHS עם YARN Timeline Service v2, צריך ליצור סכימה ספציפית במופע Bigtable. Managed Service for Apache Spark יוצר את הסכימה הנדרשת כשיוצרים אשכול של משימות או אשכול PHS עם המאפיין dataproc:yarn.atsv2.bigtable.instance שמוגדר להצביע על מופע Bigtable.
זו הסכימה הנדרשת של מופע Bigtable:
| Tables | קבוצות עמודות |
|---|---|
| prod.timelineservice.application | c,i,m |
| prod.timelineservice.app_flow | m |
| prod.timelineservice.entity | c,i,m |
| prod.timelineservice.flowactivity | i |
| prod.timelineservice.flowrun | i |
| prod.timelineservice.subapplication | c,i,m |
איסוף אשפה של Bigtable
אפשר להגדיר איסוף נתונים מיותרים ב-Bigtable לפי גיל לטבלאות ATSv2:
מתקינים את cbt, (כולל יצירת
.cbrtc file).יוצרים את מדיניות איסוף האשפה לפי גיל ב-ATSv2:
export NUMBER_OF_DAYS = number \
cbt setgcpolicy prod.timelineservice.application c maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.application i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.application m maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.app_flow m maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.entity c maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.entity i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.entity m maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.flowactivity i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.flowrun i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.subapplication c maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.subapplication i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.subapplication m maxage=${NUMBER_OF_DAYS}
הערות:
NUMBER_OF_DAYS: מספר הימים המקסימלי הוא 30d.