


במאמר הזה מוסבר איך לעדכן משימת סטרימינג פעילה. יכול להיות שתרצו לעדכן את משימת Dataflow הקיימת מהסיבות הבאות:
- אתם רוצים לשפר את קוד צינור עיבוד הנתונים.
- אתם רוצים לתקן באגים בקוד של צינור עיבוד הנתונים.
- אתם רוצים לעדכן את צינור עיבוד הנתונים כדי לטפל בשינויים בפורמט הנתונים, או כדי להביא בחשבון גרסה או שינויים אחרים במקור הנתונים.
- אתם רוצים לתקן פרצת אבטחה שקשורה למערכת הפעלה שמותאמת לקונטיינרים בכל ה-workers של Dataflow.
- אתם רוצים לשנות את קנה המידה של צינור עיבוד נתונים בסטרימינג של Apache Beam כדי להשתמש במספר שונה של קובצי worker.
יש שתי דרכים לעדכן משרות:
- עדכון משימה במהלך הריצה: במשימות סטרימינג שמשתמשות ב-Streaming Engine, אפשר לעדכן את אפשרויות המשימה
min-num-workersו-max-num-workersבלי לעצור את המשימה או לשנות את מזהה המשימה. - משימה חלופית: כדי להריץ קוד מעודכן של צינור עיבוד נתונים או לעדכן אפשרויות של משימות שלא נתמכות בעדכונים של משימות פעילות, מפעילים משימה חדשה שמחליפה את המשימה הקיימת. כדי לוודא שהמשימה החלופית תקינה, לפני שמפעילים את המשימה החדשה, מאמתים את תרשים המשימה שלה.
כשמעדכנים את המשימה, שירות Dataflow מבצע בדיקת תאימות בין המשימה שכבר פועלת לבין המשימה החלופית הפוטנציאלית. בדיקת התאימות מוודאת שאפשר להעביר מהמשימה הקודמת למשימה החלופית דברים כמו מידע על מצב הביניים ונתונים שנשמרו במאגר נתונים זמני.
אפשר גם להשתמש בתשתית הרישום המובנית של Apache Beam SDK כדי לתעד מידע כשמעדכנים את המשימה. מידע נוסף זמין במאמר עבודה עם יומני צינור עיבוד נתונים.
כדי לזהות בעיות בקוד של צינור עיבוד הנתונים, משתמשים ברמת הרישום ביומן DEBUG.
- הוראות לעדכון משימות סטרימינג שמשתמשות בתבניות קלאסיות מפורטות במאמר עדכון משימת סטרימינג של תבנית בהתאמה אישית.
- כדי לעדכן משימות סטרימינג שמשתמשות בתבניות Flex, פועלים לפי ההוראות ל-CLI של gcloud שבדף הזה, או לפי ההוראות במאמר עדכון משימה של תבנית Flex.
עדכון אפשרות למשרה פעילה
במשימת סטרימינג שמשתמשת ב-Streaming Engine, אתם יכולים לעדכן את האפשרויות הבאות בלי לעצור את המשימה או לשנות את המזהה שלה:
-
min-num-workers: המספר המינימלי של מכונות Compute Engine. -
max-num-workers: המספר המקסימלי של מכונות Compute Engine. -
worker-utilization-hint: יעד ניצול המעבד (CPU), בטווח [0.1, 0.9] -
latency-tier: רמת זמן האחזור, שקובעת את סף הצבר. ערכים:low_latency(ברירת המחדל, פחות מ-15 שניות),medium_latency(פחות מ-2 דקות) אוhigh_latency(פחות מ-10 דקות).
כדי לבצע עדכונים אחרים במשרה, צריך להחליף את המשרה הנוכחית במשרה המעודכנת. מידע נוסף זמין במאמר הפעלת משימה חלופית.
ביצוע עדכון תוך כדי טיסה
כדי לעדכן את אפשרויות המשימה בזמן שהיא פועלת:
gcloud
משתמשים בפקודה gcloud dataflow jobs update-options:
gcloud dataflow jobs update-options \
  --region=REGION \
  --min-num-workers=MINIMUM_WORKERS \
  --max-num-workers=MAXIMUM_WORKERS \
  --worker-utilization-hint=TARGET_UTILIZATION \
  --latency-tier=TIER \
  JOB_ID
מחליפים את מה שכתוב בשדות הבאים:
- REGION: מזהה האזור של המשימה
- MINIMUM_WORKERS: המספר המינימלי של מכונות Compute Engine
- MAXIMUM_WORKERS: המספר המקסימלי של מכונות Compute Engine
- TARGET_UTILIZATION: ערך בטווח [0.1, 0.9]
- TIER: רמת זמן האחזור הרצויה. אחד מהערכים הבאים:
low_latency,medium_latencyאוhigh_latency - JOB_ID: מזהה המשימה שרוצים לעדכן
אפשר גם לעדכן את --min-num-workers, --max-num-workers, --worker-utilization-hint או --latency-tier בנפרד.
REST
משתמשים ב-method projects.locations.jobs.update:
PUT https://dataflow.googleapis.com/v1b3/projects/PROJECT_ID/locations/REGION/jobs/JOB_ID?updateMask=MASK
{
  "runtime_updatable_params": {
    "min_num_workers": MINIMUM_WORKERS,
    "max_num_workers": MAXIMUM_WORKERS,
    "worker_utilization_hint": TARGET_UTILIZATION,
    "latency_tier": TIER
  }
}
מחליפים את מה שכתוב בשדות הבאים:
- MASK: רשימה מופרדת בפסיקים של הפרמטרים שרוצים לעדכן, מתוך הפרמטרים הבאים:
runtime_updatable_params.max_num_workersruntime_updatable_params.min_num_workersruntime_updatable_params.worker_utilization_hint
- PROJECT_ID: מזהה הפרויקט ב- Google Cloud של משימת Dataflow
- REGION: מזהה האזור של המשימה
- JOB_ID: מזהה המשימה שרוצים לעדכן
- MINIMUM_WORKERS: המספר המינימלי של מכונות Compute Engine
- MAXIMUM_WORKERS: המספר המקסימלי של מכונות Compute Engine
- TARGET_UTILIZATION: ערך בטווח [0.1, 0.9]
- TIER: רמת זמן האחזור הרצויה. אחד מהערכים הבאים:
low_latency,medium_latencyאוhigh_latency
אפשר גם לעדכן את min_num_workers, max_num_workers, worker_utilization_hint או latency_tier בנפרד.
מציינים אילו פרמטרים לעדכן בפרמטר השאילתה updateMask, וכוללים את הערכים המעודכנים בשדה runtimeUpdatableParams של גוף הבקשה. בדוגמה הבאה מעדכנים את min_num_workers:
PUT https://dataflow.googleapis.com/v1b3/projects/my_project/locations/us-central1/jobs/job1?updateMask=runtime_updatable_params.min_num_workers
{
  "runtime_updatable_params": {
    "min_num_workers": 5
  }
}
כדי שאפשר יהיה לעדכן משימה תוך כדי ריצה, היא צריכה להיות במצב ריצה. אם המשימה לא התחילה או שהיא כבר בוטלה, תופיע הודעת שגיאה. באופן דומה, אם אתם מפעילים משימה חלופית, המתינו עד שהיא תתחיל לפעול לפני שתשלחו עדכונים תוך כדי ריצה למשימה החדשה.
אחרי ששולחים בקשת עדכון, מומלץ לחכות שהבקשה תושלם לפני ששולחים עדכון נוסף. כדי לראות מתי הבקשה הושלמה, אפשר לעיין ביומני המשימות.
אימות של משימת החלפה
כדי לוודא שהמשימה החלופית תקינה, לפני שמפעילים את המשימה החדשה, מאמתים את תרשים המשימה שלה. ב-Dataflow, תרשים משימה הוא ייצוג גרפי של צינור עיבוד נתונים. אימות תרשים המשימות מפחית את הסיכון לשגיאות או לכשלים בצינור עיבוד הנתונים אחרי העדכון. בנוסף, אתם יכולים לאמת את העדכונים בלי לעצור את המשימה המקורית, כדי שהמשימה לא תושבת.
כדי לאמת את תרשים המשימה, פועלים לפי השלבים להפעלת משימה חלופית. כוללים את אפשרות השירות של Dataflow graph_validate_only בפקודת העדכון.
Java
- מעבירים את האפשרות
--update. - מגדירים את האפשרות
--jobNameב-PipelineOptionsלאותו שם של המשימה שרוצים לעדכן. - מגדירים את האפשרות
--regionלאותו אזור של המשימה שרוצים לעדכן. - לכלול את אפשרות השירות
--dataflowServiceOptions=graph_validate_only. - אם שמות הטרנספורמציות בצינור עיבוד הנתונים השתנו, צריך לספק מיפוי טרנספורמציות ולהעביר אותו באמצעות האפשרות
--transformNameMapping. - אם אתם שולחים משימה חלופית שמשתמשת בגרסה מאוחרת יותר של Apache Beam SDK, הגדירו את
--updateCompatibilityVersionלגרסת Apache Beam SDK שבה השתמשתם במשימה המקורית.
Python
- מעבירים את האפשרות
--update. - מגדירים את האפשרות
--job_nameב-PipelineOptionsלאותו שם של המשימה שרוצים לעדכן. - מגדירים את האפשרות
--regionלאותו אזור של המשימה שרוצים לעדכן. - לכלול את אפשרות השירות
--dataflow_service_options=graph_validate_only. - אם שמות הטרנספורמציות בצינור עיבוד הנתונים השתנו, צריך לספק מיפוי טרנספורמציות ולהעביר אותו באמצעות האפשרות
--transform_name_mapping. - אם אתם שולחים משימה חלופית שמשתמשת בגרסה מאוחרת יותר של Apache Beam SDK, הגדירו את
--updateCompatibilityVersionלגרסת Apache Beam SDK שבה השתמשתם במשימה המקורית.
המשך
- מעבירים את האפשרות
--update. - מגדירים את האפשרות
--job_nameלאותו שם של המשימה שרוצים לעדכן. - מגדירים את האפשרות
--regionלאותו אזור של המשימה שרוצים לעדכן. - לכלול את אפשרות השירות
--dataflow_service_options=graph_validate_only. - אם שמות הטרנספורמציות בצינור עיבוד הנתונים השתנו, צריך לספק מיפוי טרנספורמציות ולהעביר אותו באמצעות האפשרות
--transform_name_mapping.
gcloud
כדי לאמת את תרשים המשימה של משימת תבנית Flex, משתמשים בפקודה gcloud dataflow flex-template run עם האפשרות additional-experiments:
- מעבירים את האפשרות
--update. - מגדירים את JOB_NAME לאותו שם של המשימה שרוצים לעדכן.
- מגדירים את האפשרות
--regionלאותו אזור של המשימה שרוצים לעדכן. - כוללים את האפשרות
--additional-experiments=graph_validate_only. - אם שמות הטרנספורמציות בצינור עיבוד הנתונים השתנו, צריך לספק מיפוי טרנספורמציות ולהעביר אותו באמצעות האפשרות
--transform-name-mappings.
לדוגמה:
gcloud dataflow flex-template run JOB_NAME --additional-experiments=graph_validate_only
מחליפים את JOB_NAME בשם המשימה שרוצים לעדכן.
REST
משתמשים בשדה additionalExperiments באובייקט FlexTemplateRuntimeEnvironment (תבניות Flex) או באובייקט RuntimeEnvironment.
{
  additionalExperiments : ["graph_validate_only"]
  ...
}
האפשרות graph_validate_only בשירות מאמתת רק עדכונים של צינור עיבוד הנתונים. אל תשתמשו באפשרות הזו כשאתם יוצרים או מפעילים צינורות עיבוד נתונים. כדי לעדכן את צינור עיבוד הנתונים, מפעילים משימה חלופית בלי אפשרות השירות graph_validate_only.
אם האימות של תרשים המשימה מצליח, במצב המשימה וביומני המשימה מוצגים הסטטוסים הבאים:
- מצב המשימה הוא
JOB_STATE_DONE. - במסוף Google Cloud , הערך של Job status הוא
Succeeded. ההודעה הבאה מופיעה ביומני המשימות:
Workflow job: JOB_ID succeeded validation. Marking graph_validate_only job as Done.
אם האימות של תרשים המשימה נכשל, בסטטוס המשימה וביומני המשימה מופיעים הסטטוסים הבאים:
- מצב המשימה הוא
JOB_STATE_FAILED. - במסוף Google Cloud , הערך של Job status הוא
Failed. - ביומני המשימות תופיע הודעה שמתארת את שגיאת חוסר התאימות. תוכן ההודעה תלוי בשגיאה.
הפעלת משימת החלפה
יכול להיות שתחליפו משרה קיימת מהסיבות הבאות:
- כדי להריץ קוד מעודכן של צינור עיבוד נתונים.
- כדי לעדכן אפשרויות של משימות שלא תומכות בעדכונים תוך כדי הפעלה.
כדי לוודא שהמשימה החלופית תקינה, לפני שמפעילים את המשימה החדשה מאמתים את תרשים המשימה שלה.
כשמפעילים משימה חלופית, מגדירים את אפשרויות הפייפליין הבאות כדי לבצע את תהליך העדכון, בנוסף לאפשרויות הרגילות של המשימה:
Java
- מעבירים את האפשרות
--update. - מגדירים את האפשרות
--jobNameב-PipelineOptionsלאותו שם של המשימה שרוצים לעדכן. - מגדירים את האפשרות
--regionלאותו אזור של המשימה שרוצים לעדכן. - אם שמות הטרנספורמציות בצינור עיבוד הנתונים השתנו, צריך לספק מיפוי טרנספורמציות ולהעביר אותו באמצעות האפשרות
--transformNameMapping. - אם אתם שולחים משימה חלופית שמשתמשת בגרסה מאוחרת יותר של Apache Beam SDK, הגדירו את
--updateCompatibilityVersionלגרסת Apache Beam SDK שבה השתמשתם במשימה המקורית.
Python
- מעבירים את האפשרות
--update. - מגדירים את האפשרות
--job_nameב-PipelineOptionsלאותו שם של המשימה שרוצים לעדכן. - מגדירים את האפשרות
--regionלאותו אזור של המשימה שרוצים לעדכן. - אם שמות הטרנספורמציות בצינור עיבוד הנתונים השתנו, צריך לספק מיפוי טרנספורמציות ולהעביר אותו באמצעות האפשרות
--transform_name_mapping. - אם אתם שולחים משימה חלופית שמשתמשת בגרסה מאוחרת יותר של Apache Beam SDK, הגדירו את
--updateCompatibilityVersionלגרסת Apache Beam SDK שבה השתמשתם במשימה המקורית.
המשך
- מעבירים את האפשרות
--update. - מגדירים את האפשרות
--job_nameלאותו שם של המשימה שרוצים לעדכן. - מגדירים את האפשרות
--regionלאותו אזור של המשימה שרוצים לעדכן. - אם שמות הטרנספורמציות בצינור עיבוד הנתונים השתנו, צריך לספק מיפוי טרנספורמציות ולהעביר אותו באמצעות האפשרות
--transform_name_mapping.
gcloud
כדי לעדכן משימה של תבנית Flex באמצעות ה-CLI של gcloud, משתמשים בפקודה gcloud dataflow flex-template run. אי אפשר לעדכן משימות אחרות באמצעות ה-CLI של gcloud.
- מעבירים את האפשרות
--update. - מגדירים את JOB_NAME לאותו שם של המשימה שרוצים לעדכן.
- מגדירים את האפשרות
--regionלאותו אזור של המשימה שרוצים לעדכן. - אם שמות הטרנספורמציות בצינור עיבוד הנתונים השתנו, צריך לספק מיפוי טרנספורמציות ולהעביר אותו באמצעות האפשרות
--transform-name-mappings.
REST
כאן מוסבר איך לעדכן משימות שלא מבוססות על תבניות באמצעות ה-API בארכיטקטורת REST. כדי להשתמש ב-API בארכיטקטורת REST כדי לעדכן משימה של תבנית קלאסית, קראו את המאמר עדכון משימת סטרימינג של תבנית בהתאמה אישית. כדי להשתמש ב-API בארכיטקטורת REST כדי לעדכן משימה של תבנית Flex, קראו את המאמר עדכון משימה של תבנית Flex.
מאחזרים את המשאב
jobשל המשימה שרוצים להחליף באמצעות השיטהprojects.locations.jobs.get. כוללים את הפרמטר של השאילתהviewעם הערךJOB_VIEW_DESCRIPTION. הכללתJOB_VIEW_DESCRIPTIONמגבילה את כמות הנתונים בתגובה, כדי שהבקשה הבאה לא תחרוג ממגבלות הגודל. אם אתם צריכים מידע מפורט יותר על המשימה, השתמשו בערךJOB_VIEW_ALL.GET https://dataflow.googleapis.com/v1b3/projects/PROJECT_ID/locations/REGION/jobs/JOB_ID?view=JOB_VIEW_DESCRIPTIONמחליפים את הערכים הבאים:
- PROJECT_ID: מזהה הפרויקט ב- Google Cloud של משימת Dataflow
- REGION: האזור של המשימה שרוצים לעדכן
- JOB_ID: מזהה המשימה שרוצים לעדכן
כדי לעדכן את המשימה, משתמשים ב-method
projects.locations.jobs.create. בגוף הבקשה, משתמשים במשאבjobשאחזרתם.POST https://dataflow.googleapis.com/v1b3/projects/PROJECT_ID/locations/REGION/jobs { "id": JOB_ID, "replaceJobId": JOB_ID, "name": JOB_NAME, "type": "JOB_TYPE_STREAMING", "transformNameMapping": { string: string, ... }, }מחליפים את מה שכתוב בשדות הבאים:
- JOB_ID: מזהה המשימה שזהה למזהה של המשימה שרוצים לעדכן.
- JOB_NAME: שם המשימה, שזהה לשם המשימה שרוצים לעדכן.
אם שמות הטרנספורמציות בצינור עיבוד הנתונים השתנו, צריך לספק מיפוי טרנספורמציות ולהעביר אותו באמצעות השדה
transformNameMapping.אופציונלי: כדי לשלוח את הבקשה באמצעות curl (ב-Linux, ב-macOS או ב-Cloud Shell), שומרים את הבקשה בקובץ JSON ואז מריצים את הפקודה הבאה:
curl -X POST -d "@FILE_PATH" -H "Content-Type: application/json" -H "Authorization: Bearer $(gcloud auth print-access-token)" https://dataflow.googleapis.com/v1b3/projects/PROJECT_ID/locations/REGION/jobsמחליפים את FILE_PATH בנתיב לקובץ ה-JSON שמכיל את גוף הבקשה.
צריך לציין את שם המשרה החלופית
Java
כשמפעילים את המשימה החלופית, הערך שמעבירים לאפשרות --jobName חייב להיות זהה לשם של המשימה שרוצים להחליף.
Python
כשמפעילים את המשימה החלופית, הערך שמעבירים לאפשרות --job_name חייב להיות זהה לשם של המשימה שרוצים להחליף.
המשך
כשמפעילים את המשימה החלופית, הערך שמעבירים לאפשרות --job_name חייב להיות זהה לשם של המשימה שרוצים להחליף.
gcloud
כשמפעילים את המשימה החלופית, הערך של JOB_NAME חייב להיות זהה לשם המשימה שרוצים להחליף.
REST
מגדירים את הערך של השדה replaceJobId למזהה המשימה של המשימה שרוצים לעדכן. כדי למצוא את הערך הנכון של שם המשימה, בוחרים את המשימה הקודמת בממשק המעקב של Dataflow.
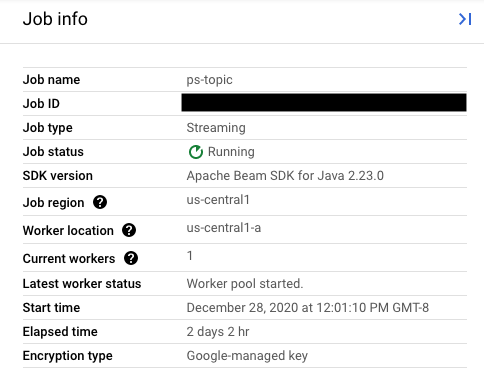
לאחר מכן, בחלונית הצדדית Job info, מאתרים את השדה מזהה משימה.
כדי למצוא את הערך הנכון של שם המשימה, בוחרים את המשימה הקודמת בממשק המעקב של Dataflow. אחר כך, בחלונית הצדדית Job info, מאתרים את השדה Job name:
לחלופין, אפשר לשלוח שאילתה לרשימה של משימות קיימות באמצעות ממשק שורת הפקודה של Dataflow.
מזינים את הפקודה gcloud dataflow jobs list בחלון ה-shell או הטרמינל כדי לקבל רשימה של משימות Dataflow בפרויקט Google Cloud, ומוצאים את השדה NAME של המשימה שרוצים להחליף:
JOB_ID                                    NAME                        TYPE       CREATION_TIME        STATE    REGION
2020-12-28_12_01_09-yourdataflowjobid     ps-topic                    Streaming  2020-12-28 20:01:10  Running  us-central1
יצירת מיפוי טרנספורמציה
אם בצינור העיבוד הנתונים החלופי משתנים שמות של טרנספורמציות מהשמות בצינור עיבוד הנתונים הקודם, שירות Dataflow דורש מיפוי טרנספורמציות. מיפוי הטרנספורמציה ממפה את הטרנספורמציות בעלות השם בקוד של צינור עיבוד הנתונים הקודם לשמות בקוד של צינור עיבוד הנתונים החלופי.
Java
מעבירים את המיפוי באמצעות האפשרות --transformNameMapping בשורת הפקודה, בפורמט הכללי הבא:
--transformNameMapping= .
{"oldTransform1":"newTransform1","oldTransform2":"newTransform2",...}
צריך לספק רשומות מיפוי ב---transformNameMapping רק לשמות של טרנספורמציות שהשתנו בין צינור עיבוד הנתונים הקודם לבין צינור עיבוד הנתונים החלופי.
כשמריצים עם --transformNameMapping, יכול להיות שצריך להוסיף תו בריחה למירכאות בהתאם למעטפת. לדוגמה, ב-Bash:
--transformNameMapping='{"oldTransform1":"newTransform1",...}'
Python
מעבירים את המיפוי באמצעות האפשרות --transform_name_mapping בשורת הפקודה, בפורמט הכללי הבא:
--transform_name_mapping= .
{"oldTransform1":"newTransform1","oldTransform2":"newTransform2",...}
צריך לספק רשומות מיפוי ב---transform_name_mapping רק לשמות של טרנספורמציות שהשתנו בין צינור עיבוד הנתונים הקודם לבין צינור עיבוד הנתונים החלופי.
כשמריצים עם --transform_name_mapping, יכול להיות שצריך להוסיף תו בריחה למירכאות בהתאם למעטפת. לדוגמה, ב-Bash:
--transform_name_mapping='{"oldTransform1":"newTransform1",...}'
המשך
מעבירים את המיפוי באמצעות האפשרות --transform_name_mapping בשורת הפקודה, בפורמט הכללי הבא:
--transform_name_mapping= .
{"oldTransform1":"newTransform1","oldTransform2":"newTransform2",...}
צריך לספק רשומות מיפוי ב---transform_name_mapping רק לשמות של טרנספורמציות שהשתנו בין צינור עיבוד הנתונים הקודם לבין צינור עיבוד הנתונים החלופי.
כשמריצים עם --transform_name_mapping, יכול להיות שצריך להוסיף תו בריחה למירכאות בהתאם למעטפת. לדוגמה, ב-Bash:
--transform_name_mapping='{"oldTransform1":"newTransform1",...}'
gcloud
מעבירים את המיפוי באמצעות האפשרות --transform-name-mappings, בפורמט הכללי הבא:
--transform-name-mappings= .
{"oldTransform1":"newTransform1","oldTransform2":"newTransform2",...}
צריך לספק רשומות מיפוי ב---transform-name-mappings רק לשמות של טרנספורמציות שהשתנו בין צינור עיבוד הנתונים הקודם לבין צינור עיבוד הנתונים החלופי.
כשמריצים עם --transform-name-mappings, יכול להיות שצריך להוסיף תו בריחה (escape) למירכאות בהתאם למעטפת. לדוגמה, ב-Bash:
--transform-name-mappings='{"oldTransform1":"newTransform1",...}'
REST
מעבירים את המיפוי באמצעות השדה transformNameMapping, בפורמט הכללי הבא:
"transformNameMapping": {
  oldTransform1: newTransform1,
  oldTransform2: newTransform2,
  ...
}
צריך לספק רשומות מיפוי ב-transformNameMapping רק לשמות של טרנספורמציות שהשתנו בין צינור עיבוד הנתונים הקודם לבין צינור עיבוד הנתונים החלופי.
הגדרת שמות הטרנספורמציות
שם הטרנספורמציה בכל מופע במפה הוא השם שסיפקתם כשהחלתם את הטרנספורמציה בצינור עיבוד הנתונים. לדוגמה:
Java
  .apply("FormatResults", ParDo
    .of(new DoFn<KV<String, Long>>, String>() {
      ...
     }
  }))
Python
| 'FormatResults' >> beam.ParDo(MyDoFn())
המשך
  // In Go, this is always the package-qualified name of the DoFn itself.
  // For example, if the FormatResults DoFn is in the main package, its name
  // is "main.FormatResults".
  beam.ParDo(s, FormatResults, results)
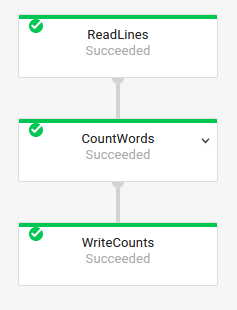
אפשר גם לקבל את שמות הטרנספורמציות של המשימה הקודמת על ידי בדיקת תרשים הביצוע של המשימה בממשק המעקב של Dataflow:
מתן שמות לטרנספורמציות מורכבות
שמות הטרנספורמציות הם היררכיים, ומבוססים על היררכיית הטרנספורמציות בצינור עיבוד הנתונים. אם בצינור עיבוד הנתונים יש טרנספורמציה מורכבת, הטרנספורמציות המקוננות נקראות לפי הטרנספורמציה שמכילה אותן. לדוגמה, נניח שהצינור מכיל טרנספורמציה מורכבת בשם CountWidgets, שמכילה טרנספורמציה פנימית בשם Parse. השם המלא של הטרנספורמציה הוא CountWidgets/Parse, וצריך לציין את השם המלא הזה במיפוי הטרנספורמציה.
אם בצינור עיבוד הנתונים החדש ממפים טרנספורמציה מורכבת לשם אחר, כל הטרנספורמציות בתצוגת עץ משנות את השם באופן אוטומטי. אתם צריכים לציין את השמות שהשתנו של הטרנספורמציות הפנימיות במיפוי הטרנספורמציות.
שינוי המבנה של היררכיית הטרנספורמציה
אם בצינור עיבוד הנתונים החלופי יש היררכיית טרנספורמציה שונה מזו שבצינור עיבוד הנתונים הקודם, צריך להצהיר על המיפוי באופן מפורש. יכול להיות שיש לכם היררכיית טרנספורמציה שונה כי שיניתם את הקוד של הטרנספורמציות המורכבות, או כי הצינור תלוי בטרנספורמציה מורכבת מספרייה שהשתנתה.
לדוגמה, נניח שהצינור הקודם הפעיל טרנספורמציה מורכבת, CountWidgets, שהכילה טרנספורמציה פנימית בשם Parse. הצינור החלופי משחזר את CountWidgets, ומקנן את Parse בתוך טרנספורמציה אחרת בשם Scan. כדי שהעדכון יצליח, צריך למפות באופן מפורש את שם הטרנספורמציה המלא בצינור עיבוד הנתונים הקודם (CountWidgets/Parse) לשם הטרנספורמציה בצינור עיבוד הנתונים החדש (CountWidgets/Scan/Parse):
Java
--transformNameMapping={"CountWidgets/Parse":"CountWidgets/Scan/Parse"}
אם מוחקים טרנספורמציה לגמרי בצינור עיבוד הנתונים החלופי, צריך לספק מיפוי null. נניח שצינור עיבוד הנתונים החלופי מסיר לגמרי את הטרנספורמציה CountWidgets/Parse:
--transformNameMapping={"CountWidgets/Parse":""}
Python
--transform_name_mapping={"CountWidgets/Parse":"CountWidgets/Scan/Parse"}
אם מוחקים טרנספורמציה לגמרי בצינור עיבוד הנתונים החלופי, צריך לספק מיפוי null. נניח שצינור עיבוד הנתונים החלופי מסיר לגמרי את הטרנספורמציה CountWidgets/Parse:
--transform_name_mapping={"CountWidgets/Parse":""}
המשך
--transform_name_mapping={"CountWidgets/main.Parse":"CountWidgets/Scan/main.Parse"}
אם מוחקים טרנספורמציה לגמרי בצינור עיבוד הנתונים החלופי, צריך לספק מיפוי null. נניח שצינור עיבוד הנתונים החלופי מסיר לגמרי את הטרנספורמציה CountWidgets/Parse:
--transform_name_mapping={"CountWidgets/main.Parse":""}
gcloud
--transform-name-mappings={"CountWidgets/Parse":"CountWidgets/Scan/Parse"}
אם מוחקים טרנספורמציה לגמרי בצינור עיבוד הנתונים החלופי, צריך לספק מיפוי null. נניח שצינור עיבוד הנתונים החלופי מסיר לגמרי את הטרנספורמציה CountWidgets/Parse:
--transform-name-mappings={"CountWidgets/main.Parse":""}
REST
"transformNameMapping": {
  CountWidgets/Parse: CountWidgets/Scan/Parse
}
אם מוחקים טרנספורמציה לגמרי בצינור עיבוד הנתונים החלופי, צריך לספק מיפוי null. נניח שצינור עיבוד הנתונים החלופי מסיר לגמרי את הטרנספורמציה CountWidgets/Parse:
"transformNameMapping": {
  CountWidgets/main.Parse: null
}
מה קורה כשמחליפים משרה
כשמחליפים משימה קיימת, משימה חדשה מריצה את קוד הצינור המעודכן. שירות Dataflow שומר את שם המשימה, אבל מריץ את המשימה החלופית עם מזהה משימה מעודכן. התהליך הזה עלול לגרום לזמן השבתה בזמן שהמשימה הקיימת נעצרת, בדיקת התאימות פועלת והמשימה החדשה מתחילה.
במשרה החלופית נשמרים הפריטים הבאים:
- נתוני מצב ביניים מהמשימה הקודמת. מטמונים בזיכרון לא נשמרים.
- רשומות נתונים שנשמרו במאגר או מטא-נתונים שנמצאים כרגע "במעבר" מהמשימה הקודמת. לדוגמה, יכול להיות שחלק מהרשומות בצינור עיבוד הנתונים יאוחסנו במאגר נתונים זמני בזמן ההמתנה לפתרון של חלון.
- עדכונים לאפשרויות של משימות פעילות שהחלתם על המשימה הקודמת.
אם צינור עיבוד הנתונים מכיל מחברים של Managed I/O, Dataflow בודק אם יש עדכונים למחברים ומשתמש באופן אוטומטי בגרסה התקינה האחרונה שידועה. מידע נוסף מופיע במאמר שדרוגים אוטומטיים.
נתונים של מצב ביניים
נתוני המצב של שלב הביניים מהמשימה הקודמת נשמרים. נתוני המצב לא כוללים מטמונים בזיכרון. אם אתם רוצים לשמור את נתוני המטמון בזיכרון כשאתם מעדכנים את הפייפליין, כפתרון עקיף, אתם יכולים לארגן את הקוד מחדש בפייפליין כדי להמיר את המטמונים לנתוני מצב או לקלט צדדי. למידע נוסף על השימוש בקלט צדדי, ראו תבניות קלט צדדי במסמכי התיעוד של Apache Beam.
בפייפליינים זורמים יש מגבלות גודל ל-ValueState ולקלט צדדי.
לכן, אם יש לכם מטמונים גדולים שאתם רוצים לשמור, יכול להיות שתצטרכו להשתמש באחסון חיצוני, כמו Memorystore או Bigtable.
נתונים בטיסה
נתונים "במעבר" עדיין מעובדים על ידי הטרנספורמציות בצינור עיבוד הנתונים החדש. עם זאת, יכול להיות שטרנספורמציות נוספות שתוסיפו בקוד של צינור עיבוד הנתונים החלופי יפעלו או לא יפעלו, בהתאם למקום שבו הרשומות נשמרות במאגר הנתונים הזמני. בדוגמה הזו, בצינור עיבוד הנתונים הקיים יש את הטרנספורמציות הבאות:
Java
  p.apply("Read", ReadStrings())
   .apply("Format", FormatStrings());
Python
  p | 'Read' >> beam.io.ReadFromPubSub(subscription=known_args.input_subscription)
    | 'Format' >> FormatStrings()
המשך
   beam.ParDo(s, ReadStrings)
   beam.ParDo(s, FormatStrings)
אתם יכולים להחליף את המשימה בקוד צינור עיבוד נתונים חדש, באופן הבא:
Java
  p.apply("Read", ReadStrings())
   .apply("Remove", RemoveStringsStartingWithA())
   .apply("Format", FormatStrings());
Python
  p | 'Read' >> beam.io.ReadFromPubSub(subscription=known_args.input_subscription)
    | 'Remove' >> RemoveStringsStartingWithA()
    | 'Format' >> FormatStrings()
המשך
  beam.ParDo(s, ReadStrings)
  beam.ParDo(s, RemoveStringsStartingWithA)
  beam.ParDo(s, FormatStrings)
למרות שמוסיפים טרנספורמציה כדי לסנן מחרוזות שמתחילות באות "A", הטרנספורמציה הבאה (FormatStrings) עדיין עשויה לראות מחרוזות במאגר או בתהליך שמתחילות באות "A" שהועברו מהמשימה הקודמת.
שינוי החלונות
אפשר לשנות את האסטרטגיות של החלונות והטריגרים של רכיבי ה-PCollection בצינור עיבוד הנתונים החלופי, אבל צריך להיזהר.
שינוי של אסטרטגיות החלונות או הטריגרים לא משפיע על נתונים שכבר נמצאים במאגר או בתהליך.
מומלץ לנסות לבצע רק שינויים קטנים בחלונות של צינור עיבוד הנתונים, כמו שינוי משך הזמן של חלונות קבועים או חלונות הזזה. אם תבצעו שינויים משמעותיים בחלונות או בטריגרים, כמו שינוי האלגוריתם של החלונות, יכול להיות שתקבלו תוצאות בלתי צפויות בפלט של צינור עיבוד הנתונים.
בדיקת התאמה למשרה
כשמפעילים את משימת ההחלפה, שירות Dataflow בודק את התאימות בין משימת ההחלפה לבין המשימה הקודמת. אם בדיקת התאימות עוברת בהצלחה, המשימה הקודמת נעצרת. לאחר מכן, המשימה החלופית מופעלת בשירות Dataflow, תוך שמירה על אותו שם משימה. אם בדיקת התאימות נכשלת, המשימה הקודמת ממשיכה לפעול בשירות Dataflow והמשימה החלופית מחזירה שגיאה.
Java
בגלל מגבלה, צריך להשתמש בהפעלה חוסמת כדי לראות שגיאות של ניסיונות עדכון שנכשלו במסוף או בטרמינל. הפתרון העקיף הנוכחי כולל את השלבים הבאים:
- משתמשים ב-pipeline.run().waitUntilFinish() בקוד של צינור עיבוד הנתונים.
- מריצים את תוכנית צינור העיבוד החלופי עם האפשרות
--update. - מחכים עד שהמשרה החלופית תעבור בהצלחה את בדיקת התאימות.
- כדי לצאת מתהליך ה-runner החוסם, מקלידים
Ctrl+C.
לחלופין, אפשר לעקוב אחרי מצב המשימה החלופית בממשק המעקב של Dataflow. אם המשימה התחילה בהצלחה, היא גם עברה את בדיקת התאימות.
Python
בגלל מגבלה, צריך להשתמש בהפעלה חוסמת כדי לראות שגיאות של ניסיונות עדכון שנכשלו במסוף או בטרמינל. הפתרון העקיף הנוכחי כולל את השלבים הבאים:
- משתמשים ב-pipeline.run().wait_until_finish() בקוד של צינור עיבוד הנתונים.
- מריצים את תוכנית צינור העיבוד החלופי עם האפשרות
--update. - מחכים עד שהמשרה החלופית תעבור בהצלחה את בדיקת התאימות.
- כדי לצאת מתהליך ה-runner החוסם, מקלידים
Ctrl+C.
לחלופין, אפשר לעקוב אחרי מצב המשימה החלופית בממשק המעקב של Dataflow. אם המשימה התחילה בהצלחה, היא גם עברה את בדיקת התאימות.
המשך
בגלל מגבלה, צריך להשתמש בהפעלה חוסמת כדי לראות שגיאות של ניסיונות עדכון שנכשלו במסוף או בטרמינל.
באופן ספציפי, צריך לציין הפעלה ללא חסימה באמצעות הדגלים --execute_async או --async. הפתרון העקיף הנוכחי כולל את השלבים הבאים:
- מריצים את תוכנית צינור עיבוד הנתונים החלופית עם האפשרות
--updateובלי הדגלים--execute_asyncאו--async. - מחכים עד שהמשרה החלופית תעבור בהצלחה את בדיקת התאימות.
- כדי לצאת מתהליך ה-runner החוסם, מקלידים
Ctrl+C.
gcloud
בגלל מגבלה, צריך להשתמש בהפעלה חוסמת כדי לראות שגיאות של ניסיונות עדכון שנכשלו במסוף או בטרמינל. הפתרון העקיף הנוכחי כולל את השלבים הבאים:
- בצינורות עיבוד נתונים ב-Java, משתמשים ב-pipeline.run().waitUntilFinish() בקוד של צינור עיבוד הנתונים. בצינורות עיבוד נתונים ב-Python, משתמשים ב-pipeline.run().wait_until_finish() בקוד של צינור עיבוד הנתונים. בצינורות עיבוד נתונים ב-Go, פועלים לפי השלבים בכרטיסייה Go.
- מריצים את תוכנית צינור העיבוד החלופי עם האפשרות
--update. - מחכים עד שהמשרה החלופית תעבור בהצלחה את בדיקת התאימות.
- כדי לצאת מתהליך ה-runner החוסם, מקלידים
Ctrl+C.
REST
בגלל מגבלה, צריך להשתמש בהפעלה חוסמת כדי לראות שגיאות של ניסיונות עדכון שנכשלו במסוף או בטרמינל. הפתרון העקיף הנוכחי כולל את השלבים הבאים:
- בצינורות עיבוד נתונים ב-Java, משתמשים ב-pipeline.run().waitUntilFinish() בקוד של צינור עיבוד הנתונים. בצינורות עיבוד נתונים ב-Python, משתמשים ב-pipeline.run().wait_until_finish() בקוד של צינור עיבוד הנתונים. בצינורות עיבוד נתונים ב-Go, פועלים לפי השלבים בכרטיסייה Go.
- מריצים את תוכנית צינור עיבוד הנתונים החלופית עם השדה
replaceJobId. - מחכים עד שהמשרה החלופית תעבור בהצלחה את בדיקת התאימות.
- כדי לצאת מתהליך ה-runner החוסם, מקלידים
Ctrl+C.
בבדיקת התאימות נעשה שימוש במיפוי הטרנספורמציה שסופק כדי לוודא ש-Dataflow יכול להעביר נתוני מצב ביניים מהשלבים במשימה הקודמת למשימה החלופית. בדיקת התאימות גם מוודאת שכל ה-PCollection בצינור עיבוד הנתונים משתמשים באותם מקודדים.
שינוי של Coder עלול לגרום לכישלון בבדיקת התאימות, כי יכול להיות שנתונים בתהליך או רשומות במאגר לא יעברו סריאליזציה נכונה בצינור עיבוד הנתונים החלופי.
מניעת בעיות תאימות
הבדלים מסוימים בין צינור עיבוד הנתונים הקודם לבין צינור עיבוד הנתונים החלופי יכולים לגרום לכשל בבדיקת התאימות. ההבדלים האלה כוללים:
- שינוי תרשים צינור עיבוד הנתונים בלי לספק מיפוי. כשמעדכנים משימה, Dataflow מנסה להתאים בין הטרנספורמציות במשימה הקודמת לבין הטרנספורמציות במשימה החלופית. תהליך ההתאמה הזה עוזר ל-Dataflow להעביר נתונים של מצב ביניים בכל שלב. אם משנים את השם של שלבים או מסירים אותם, צריך לספק מיפוי טרנספורמציה כדי ש-Dataflow יוכל להתאים את נתוני המצב בהתאם.
- שינוי קלט הצד של שלב. אם מוסיפים קלט צדדי לטרנספורמציה בצינור עיבוד הנתונים החלופי או מסירים אותו ממנה, בדיקת התאימות נכשלת.
- שינוי ה-Coder של שלב. כשמעדכנים משימה, Dataflow שומר את כל רשומות הנתונים שמאוחסנות כרגע במאגר הנתונים הזמני ומטפל בהן במשימה החלופית. לדוגמה, יכול להיות שנתונים יישמרו במאגר הנתונים בזמן שהחלון נפתר. אם במשימה החלופית נעשה שימוש בקידוד נתונים שונה או לא תואם, Dataflow לא יכול לבצע סריאליזציה או דה-סריאליזציה של הרשומות האלה.
הסרת פעולה "עם שמירת מצב" מהצינור. אם תסירו פעולות עם שמירת מצב מהצינור, יכול להיות שהמשימה החלופית תיכשל בבדיקת התאימות. כדי לשפר את היעילות, Dataflow יכול למזג כמה שלבים יחד. אם מסירים פעולה שתלויה במצב מתוך שלב משולב, הבדיקה נכשלת. פעולות עם שמירת מצב כוללות:
- טרנספורמציות שיוצרות או צורכות קלט צדדי.
- קריאות קלט/פלט.
- טרנספורמציות שמשתמשות במצב עם מפתח.
- טרנספורמציות שכוללות מיזוג חלונות.
שינוי משתני
DoFnעם שמירת מצב. במשימות סטרימינג מתמשכות, אם הצינור כוללDoFns עם שמירת מצב, שינוי המשתנים שלDoFnעם שמירת מצב עלול לגרום לצינור להיכשל.ניסיון להריץ את המשימה החלופית באזור גיאוגרפי אחר. מריצים את המשימה החלופית באותו אזור שבו הרצתם את המשימה הקודמת, אחרת המשימה החלופית תיכשל.
עדכון סכימות
ב-Apache Beam, ל-PCollection יכולות להיות סכימות עם שדות בעלי שמות, ובמקרה כזה אין צורך במקודדים מפורשים. אם השמות והסוגים של השדות בסכימה מסוימת לא השתנו (כולל שדות בתצוגת עץ), הסכימה הזו לא תגרום לכישלון של בדיקת העדכון. עם זאת, יכול להיות שהעדכון עדיין ייחסם אם קטעים אחרים בצינור עיבוד הנתונים החדש לא תואמים.
פיתוח סכימות
לפעמים צריך לשנות את הסכימה של PCollection בגלל שינויים בדרישות העסקיות. שירות Dataflow מאפשר לבצע את השינויים הבאים בסכימה כשמעדכנים צינור עיבוד נתונים:
- הוספת שדה חדש אחד או יותר לסכימה, כולל שדות בתצוגת עץ.
- הפיכת שדה חובה (שלא יכול להיות ריק) לשדה אופציונלי (שיכול להיות ריק).
במהלך העדכון, אי אפשר להסיר שדות, לשנות שמות של שדות או לשנות סוגי שדות.
העברת נתונים נוספים לפעולת ParDo קיימת
אתם יכולים להעביר נתונים נוספים (מחוץ לפס) לפעולת ParDo קיימת באמצעות אחת מהשיטות הבאות, בהתאם לתרחיש לדוגמה:
- מבצעים סריאליזציה של המידע כשדות במחלקת המשנה של
DoFn. - כל המשתנים שהשיטות מפנות אליהם ב-
DoFnאנונימי עוברים סריאליזציה באופן אוטומטי. - עיבוד נתונים בתוך
DoFn.startBundle(). - מעבירים נתונים באמצעות
ParDo.withSideInputs.
מידע נוסף זמין בדפים הבאים:
- מדריך התכנות של Apache Beam: ParDo, ובמיוחד הקטעים שעוסקים ביצירת DoFn וקלט צדדי.
- הפניית Apache Beam SDK ל-Java: ParDo