


Em pipelines de streaming distribuídos, pode ser difícil identificar qual etapa específica, chamada de serviço externo ou embaralhamento de worker causa picos de latência usando apenas métricas agregadas. Ao usar o rastreamento distribuído do OpenTelemetry no Dataflow, é possível rastrear elementos individuais de ponta a ponta em transformações de pipeline, limites de rede e serviços integrados com um único ID de rastreamento. Essa visibilidade ajuda a identificar gargalos de desempenho, otimizar os custos de execução do pipeline e resolver problemas complexos de cargas de trabalho de streaming.
Use as informações a seguir para ativar, configurar e usar o rastreamento distribuído do OpenTelemetry nos pipelines do Apache Beam.
Casos de uso
O rastreamento distribuído no Dataflow é especialmente útil nos seguintes cenários:
- Cargas de trabalho de streaming:acompanhe o tempo de processamento por elemento e identifique etapas que introduzem picos de atraso ou latência.
- Rastreamento de chamadas de serviços externos no código do usuário:meça as durações de execução
quando seu pipeline chamar bancos de dados externos, microsserviços ou APIs de IA generativa
no código do usuário (como em um
DoFn). Por exemplo, você pode medir o tempo de chamadas para bancos de dados externos (como Spanner ou Bigtable), microsserviços (usando HTTP ou gRPC) ou APIs de IA generativa (como o Gemini). Para mais informações, consulte Escrever rastreamentos personalizados em DoFns e Integrar com bibliotecas de cliente. - Otimização de custos e desempenho:exponha as durações de operações específicas em
PTransforminstâncias sob carga real para identificar serialização ineficiente, consultas lentas ou disputa de linhas de execução de worker. - Pipelines de fluxo de trabalho e agentes complexos:tenha visibilidade dos pipelines com várias ramificações, loops de agentes iterativos e junções para determinar qual transformação ou ramificação leva mais tempo.
Limitações
O rastreamento distribuído no Dataflow tem as seguintes limitações:
- Esse recurso foi projetado e verificado apenas para pipelines de streaming.
- Para usar esse recurso, é necessário usar o SDK do Beam para Java (versão 2.76.0 ou mais recente).
- A propagação de contexto entre etapas exige o Streaming Java Runner (antes chamado de Runner v1). O Portable Runner (antes chamado de Runner v2) redefine o contexto de traces nos limites de redistribuição.
- O rastreamento integrado do OpenTelemetry nos conectores de E/S do Beam é compatível apenas com os seguintes conectores: Pub/Sub, Apache Kafka e fluxo de alterações do Spanner. Para o Apache Kafka, o rastreamento só é compatível quando você usa o conector
KafkaIOdiretamente. Ele não é compatível com o uso de E/S gerenciada para Kafka. Outros conectores de E/S (comoBigtableIO) não têm rastreamento de conector integrado. Para rastrear operações com esses serviços, instrumente suas chamadas no código do usuário (como em umDoFn). - Operações que combinam vários elementos em um só não propagam um único contexto de traces. Isso inclui operações como
GroupByKey,CoGroupByKeyeCombine. - O contexto não é propagado entre a definição de um timer (
Timer.set()) e a execução do método de callback@OnTimer.
Pré-requisitos
Para usar o rastreamento distribuído no Dataflow, verifique se o ambiente atende aos seguintes requisitos:
- Seu trabalho precisa atender aos seguintes requisitos:
- É um pipeline de streaming
- Usa o Streaming Java Runner (antes chamado de Runner v1)
- Usa a versão 2.76.0 ou mais recente do SDK do Apache Beam para Java.
Se você exportar traces para o Cloud Trace, ative a API Telemetry (
telemetry.googleapis.com) no seu projeto Google Cloud .Funções necessárias para ativar APIs
Para ativar APIs, você precisa da permissão
serviceusage.services.enable. Se você criou o projeto, provavelmente já tem essa permissão pelo papel de Proprietário (roles/owner). Caso contrário, é possível receber essa permissão pelo papel de Administrador do Service Usage (roles/serviceusage.serviceUsageAdmin). Saiba como conceder papéis.A conta de serviço do worker precisa ter o papel de agente do Cloud Trace (
roles/cloudtrace.agent), que inclui a permissãocloudtrace.traces.patch.
Principais conceitos
O rastreamento distribuído depende dos seguintes conceitos do OpenTelemetry:
- Trace
- Uma representação de uma transação ou fluxo de trabalho completo à medida que ele flui por um sistema distribuído. Um trace consiste em um ou mais períodos.
- Período
- O elemento básico de um trace, representando uma única unidade de trabalho. Por exemplo, uma execução de transformação, uma chamada de método ou uma solicitação RPC.
- Contexto
- O estado propagado entre linhas de execução e limites de API. Isso inclui o ID do trace e o ID do período.
- Propagador
- O mecanismo usado para injetar e extrair a representação de contexto em limites de rede. Por exemplo, o contexto de rastreamento do W3C.
- Exportador
- Um componente que envia dados de intervalo coletados para um back-end de rastreamento, como o Cloud Trace ou um OpenTelemetry Collector auto-hospedado.
- Sampler
- Um mecanismo que controla o volume de rastreamentos determinando quais rastreamentos são gravados e exportados. Por exemplo, uma taxa de amostragem de 1%.
Ativar o rastreamento do OpenTelemetry
Para ativar o rastreamento do OpenTelemetry com as configurações padrão, configure as opções e os experimentos de pipeline necessários ao enviar o job. A configuração padrão exporta para o Cloud Trace com amostragem de 1%.
Para modificar os valores padrão, consulte Definir e modificar propriedades de rastreamento.
Configure opções de pipeline e experimentos ao executar o job.
Job de modelo não flexível
Transmita as seguintes flags de experimento ao enviar um job:
--experiments=enable_otel_defaults,element_metadata_supported,disable_portable_worker
Job de modelo Flex
Transmita os experimentos usando a flag
--additional-experimentsno comandogcloud:gcloud dataflow flex-template run JOB_NAME \ --template-file-gcs-location=gs://BUCKET_NAME/templates/TEMPLATE_NAME.json \ --additional-experiments="enable_otel_defaults,element_metadata_supported,disable_portable_worker" \ --region=REGIONSubstitua:
- JOB_NAME: o nome do job do Dataflow.
- BUCKET_NAME: o bucket do Cloud Storage que contém seu modelo.
- TEMPLATE_NAME: o nome do arquivo do modelo flexível.
- REGION: a Google Cloud região em que você quer executar o job.
Esses experimentos configuram os seguintes comportamentos:
enable_otel_defaults: configura os padrões do OpenTelemetry, incluindo o exportador do Cloud Trace e a amostragem de 1%.element_metadata_supported: permite a serialização e a propagação de metadados (como contexto de traces) em todas as etapas do pipeline.disable_portable_worker: força o uso do Dataflow Streaming Java Runner (antes chamado de Runner v1).
Se você usa o SDK do Beam para Java versões 2.76.0 ou 2.77.0, adicione as dependências necessárias do OpenTelemetry à sua configuração do build.
Devido a um problema nas versões 2.76.0 e 2.77.0, é necessário adicionar as seguintes dependências ao arquivo
pom.xmlpara que os rastreamentos sejam exportados. Para mais informações, consulte Gerenciar dependências de pipeline.<dependency> <groupId>io.opentelemetry</groupId> <artifactId>opentelemetry-sdk-extension-autoconfigure</artifactId> <scope>compile</scope> </dependency> <dependency> <groupId>io.opentelemetry</groupId> <artifactId>opentelemetry-exporter-otlp</artifactId> <version>1.62.0</version> <scope>compile</scope> </dependency> <dependency> <groupId>org.apache.beam</groupId> <artifactId>beam-sdks-java-extensions-opentelemetry-gcp-auth-extension</artifactId> <scope>compile</scope> </dependency>Ative explicitamente o rastreamento do OpenTelemetry em conectores de E/S compatíveis no código do pipeline:
Pub/Sub
Para ativar o rastreamento ao ler ou gravar no Pub/Sub:
// Reading from Pub/Sub
pipeline.apply("ReadFromPubSub",
    PubsubIO.readMessages()
        .withEnableOpenTelemetryTracing()
        .fromSubscription("projects/PROJECT_ID/subscriptions/SUBSCRIPTION_ID"));

// Writing to Pub/Sub
pipeline.apply("WriteToPubSub",
    PubsubIO.writeStrings()
        .withEnableOpenTelemetryTracing()
        .to("projects/PROJECT_ID/topics/TOPIC_ID"));
Substitua:
- PROJECT_ID: o ID do seu projeto do Google Cloud .
- SUBSCRIPTION_ID: o nome da sua assinatura do Pub/Sub.
- TOPIC_ID: o nome do tópico do Pub/Sub.
Detalhes da propagação de contexto:
- Editor upstream:ao publicar mensagens de um aplicativo externo, injete o contexto de rastreamento do W3C nos atributos de mensagem do Pub/Sub. Para mais informações, consulte Rastreamento do OpenTelemetry do Pub/Sub.
- Atributos:o Beam espera e preenche os
seguintes atributos:
googclient_traceparent: carrega o cabeçalhotraceparentdo W3C.googclient_tracestate: carrega o cabeçalhotracestatedo W3C.
- Para formatação de cabeçalho, consulte a especificação do contexto de rastreamento do W3C.
Apache Kafka
Para ativar o rastreamento ao ler ou gravar no Apache Kafka:
// Reading from Kafka
pipeline.apply("ReadFromKafka",
    KafkaIO.<String, String>read()
        .withEnableOpenTelemetryTracing()
        // ... additional configuration
        );

// Writing to Kafka
pipeline.apply("WriteToKafka",
    KafkaIO.<String, String>write()
        .withEnableOpenTelemetryTracing()
        // ... additional configuration
        );
Detalhes da propagação de contexto:
- O
KafkaIOusa cabeçalhos de registro padrão do Kafka para propagar o contexto. - Ele espera e injeta cabeçalhos em conformidade com a
especificação de contexto de rastreamento do W3C:
traceparent: identifica o contexto de traces de entrada.tracestate: fornece metadados adicionais de roteamento e filtragem específicos do fornecedor.
Spanner
Para ativar o rastreamento ao ler fluxo de alterações do Spanner:
pipeline.apply("ReadChangeStream",
    SpannerIO.readChangeStream()
        .withSpannerConfig(spannerConfig)
        .withEnableOpenTelemetryTracing(true)
        .withChangeStreamName("CHANGE_STREAM_NAME"));
Substitua:
- CHANGE_STREAM_NAME: o nome do fluxo de alterações do Spanner.
Detalhes da criação do período:
- A ativação do rastreamento inicia um novo rastreamento e um intervalo para cada registro de mutação do banco de dados lido pelo leitor de captura de dados alterados (CDC).
- Os ciclos de pesquisa do leitor do Spanner que não retornam novos registros também podem produzir períodos de rastreamento que podem ser filtrados na interface do Cloud Trace.
Definir e modificar propriedades de rastreamento
Quando você especifica enable_otel_defaults, o Dataflow aplica as seguintes propriedades padrão:
| Propriedade | Valor padrão | Descrição |
|---|---|---|
otel.traces.exporter |
otlp |
Exporta traces usando o protocolo OpenTelemetry (OTLP). |
otel.exporter.otlp.endpoint |
https://telemetry.googleapis.com |
Segmenta o receptor OTLP do Cloud Trace. |
google.cloud.project |
Seu ID do projeto | O projeto Google Cloud em que os rastreamentos são armazenados. |
otel.traces.sampler.arg |
0.01 (1%) |
Registra 1 a cada 100 rastreamentos. |
otel.service.name |
options.getAppName() |
O nome do serviço associado aos períodos, derivado da opção appName do pipeline. |
Para personalizar a configuração do OpenTelemetry, transmita uma lista de propriedades separadas por ponto e vírgula para a opção de pipeline --openTelemetryProperties.
O exemplo a seguir configura todas as propriedades padrão explicitamente:
--openTelemetryProperties="otel.traces.exporter=otlp;otel.exporter.otlp.endpoint=https://telemetry.googleapis.com;google.cloud.project=PROJECT_ID;otel.traces.sampler.arg=0.01;otel.service.name=CUSTOM_SERVICE_NAME;otel.java.global-autoconfigure.enabled=true"
Definir um nome de serviço personalizado
Por padrão, o nome do serviço de rastreamento é derivado da opção appName do pipeline
(--appName=YourPipelineName). É possível substituir esse
valor definindo a propriedade otel.service.name:
--openTelemetryProperties="otel.service.name=CUSTOM_SERVICE_NAME"
Mudar a taxa e as propriedades de amostragem
Definir uma taxa de amostragem mais alta fornece informações de rastreamento mais robustas.
No entanto, taxas de amostragem altas (como 1.0 ou always_on) aumentam significativamente o volume de dados de rastreamento enviados ao Cloud Trace, o que pode aumentar seus custos de Google Cloud . Use taxas de amostragem altas apenas para depuração de curto prazo e reduza-as para cargas de trabalho de produção.
O exemplo a seguir configura a taxa de amostragem explicitamente. Nesse caso, você precisa fornecer uma lista completa de argumentos:
--openTelemetryProperties="otel.traces.exporter=otlp;otel.exporter.otlp.endpoint=https://telemetry.googleapis.com;google.cloud.project=PROJECT_ID;otel.traces.sampler.arg=0.02;otel.service.name=CUSTOM_SERVICE_NAME;otel.java.global-autoconfigure.enabled=true"
Exportar para back-ends de terceiros
Para enviar rastreamentos a um back-end de rastreamento gerenciado externo ou a um coletor do OpenTelemetry auto-hospedado em vez do Cloud Trace:
- Omitir o seguinte experimento:
--experiments=enable_otel_defaults. Configure manualmente as propriedades do exportador usando
--openTelemetryProperties:--openTelemetryProperties="otel.traces.exporter=otlp;otel.exporter.otlp.endpoint=http://COLLECTOR_HOST:4317;otel.traces.sampler=parentbased_always_on"
Extensão de autenticaçãoGoogle Cloud
O ambiente de execução do Beam inclui uma extensão de autenticação Google Cloud que autentica automaticamente solicitações do protocolo OpenTelemetry (OTLP) enviadas para APIs do Google, como telemetry.googleapis.com.
- Ao usar os padrões:a autenticação do Google Cloud é ativada automaticamente.
- Ao exportar para endpoints que não são do Google:se
enable_otel_defaultsfor omitido, o Beam vai desativar a extensão de autenticação Google Cloud definindo a propriedade do sistemagoogle.otel.auth.target.signals=none. - Configuração manual:defina a propriedade do sistema
google.otel.auth.target.signalscomonone(desativada) outrace(ativada apenas para rastreamentos).
Escrever rastreamentos personalizados em DoFns
É possível criar intervalos personalizados no código do usuário, como em um DoFn, para
medir operações específicas. Isso inclui chamadas para APIs externas ou lógica de computação intensiva.
Exemplo de implementação de DoFn
import io.opentelemetry.api.trace.Span;
import io.opentelemetry.api.trace.StatusCode;
import io.opentelemetry.api.trace.Tracer;
import io.opentelemetry.context.Scope;
import org.apache.beam.sdk.options.PipelineOptions;
import org.apache.beam.sdk.options.SdkHarnessOptions;
import org.apache.beam.sdk.transforms.DoFn;

public class InvestigateTransactionDoFn extends DoFn<Transaction, RiskAssessment> {
  private transient Tracer tracer;

  @Setup
  public void setup(PipelineOptions options) {
    // Obtain the Tracer instance from SdkHarnessOptions
    this.tracer = options
        .as(SdkHarnessOptions.class)
        .getOpenTelemetry()
        .getTracer("org.apache.beam.examples.adk.aml");
  }

  @ProcessElement
  public void processElement(@Element Transaction tx, OutputReceiver<RiskAssessment> out) {
    // Create and start a custom span as a child of the active context
    Span span = tracer.spanBuilder("InvestigateTransactionDoFn:Analyze")
        .setAttribute("transaction.id", tx.getId())
        .setAttribute("transaction.amount", tx.getAmount())
        .startSpan();

    // Make the span current in the execution thread
    try (Scope scope = span.makeCurrent()) {
      // Perform your logic (such as calling an external service)
      RiskAssessment assessment = analyzeTransactionWithLLM(tx);
      out.output(assessment);
    } catch (Exception e) {
      // Record exception details and set error status on the span
      span.recordException(e);
      span.setStatus(StatusCode.ERROR, e.getMessage());
      throw e;
    } finally {
      // Always end the span
      span.end();
    }
  }

  private RiskAssessment analyzeTransactionWithLLM(Transaction tx) {
    // Application analysis logic
    return new RiskAssessment();
  }
}
Integrar com bibliotecas de cliente
Quando um DoFn invoca bibliotecas externas que também são compatíveis com o OpenTelemetry, como bibliotecas de cliente Google Cloud , configure o cliente para usar a instância do OpenTelemetry do pipeline para que os períodos filhos sejam vinculados diretamente ao rastreamento do pipeline.
Exemplo de cliente Java do Spanner
Para executar consultas manuais do Spanner em um DoFn e vincular esses
períodos ao rastreamento de pipeline ativo, inicialize SpannerOptions com a
instância OpenTelemetry do pipeline:
import com.google.cloud.spanner.DatabaseClient;
import com.google.cloud.spanner.DatabaseId;
import com.google.cloud.spanner.ResultSet;
import com.google.cloud.spanner.Spanner;
import com.google.cloud.spanner.SpannerOptions;
import com.google.cloud.spanner.Statement;
import org.apache.beam.sdk.options.PipelineOptions;
import org.apache.beam.sdk.options.SdkHarnessOptions;
import org.apache.beam.sdk.transforms.DoFn;

public class SpannerEnrichmentDoFn extends DoFn<String, String> {
  private transient Spanner spanner;
  private transient DatabaseClient dbClient;
  private final String instanceId;
  private final String databaseId;

  public SpannerEnrichmentDoFn(String instanceId, String databaseId) {
    this.instanceId = instanceId;
    this.databaseId = databaseId;
  }

  @Setup
  public void setup(PipelineOptions pipelineOptions) {
    // Build SpannerOptions leveraging the pipeline's active OpenTelemetry instance
    SpannerOptions options =
        SpannerOptions.newBuilder()
            .setOpenTelemetry(pipelineOptions
                .as(SdkHarnessOptions.class)
                .getOpenTelemetry())
            .setEnableEndToEndTracing(true)
            .setEnableExtendedTracing(true)
            .build();

    this.spanner = options.getService();
    DatabaseId db = DatabaseId.of(options.getProjectId(), instanceId, databaseId);
    this.dbClient = spanner.getDatabaseClient(db);
  }

  @ProcessElement
  public void processElement(@Element String inputId, OutputReceiver<String> out) {
    Statement statement = Statement.newBuilder(
        "SELECT Details FROM AccountTable WHERE AccountId = @id")
        .bind("id").to(inputId)
        .build();

    // Spanner queries automatically generate child spans linked to the active trace
    try (ResultSet rs = dbClient.singleUse().executeQuery(statement)) {
      while (rs.next()) {
        out.output(rs.getString("Details"));
      }
    }
  }

  @Teardown
  public void tearDown() {
    if (spanner != null) {
      spanner.close();
    }
  }
}
Propagação de contexto entre etapas
Em pipelines de dados distribuídos, é essencial transmitir o contexto de traces entre limites de worker e operações de redistribuição para ter visibilidade de ponta a ponta.
Quando você insere Redistribute.arbitrarily() no pipeline, o contexto de rastreamento ativo é serializado em metadados de elementos, transmitido pela rede e desserializado na VM de worker receptora. Isso garante a continuidade ininterrupta do rastreamento em todas as etapas.
O exemplo a seguir ilustra como o contexto de traces é propagado pelas etapas do pipeline:
- Extrair contexto:
KafkaIO.read()lê um registro recebido e extrai o contexto de traces dos cabeçalhos da mensagem. - Processar e criar spans:
DoFn Aprocessa o elemento em um trace span ativo. - Propagação entre workers:o
Redistribute.arbitrarily()serializa o contexto de traces ativo nos metadados do elemento e redistribui o elemento na rede. - Continuar o trace:
DoFn Brecebe o elemento em uma VM de worker, desserializa o contexto de traces e continua o processamento no mesmo ID de trace.
Ver traces no Cloud Trace
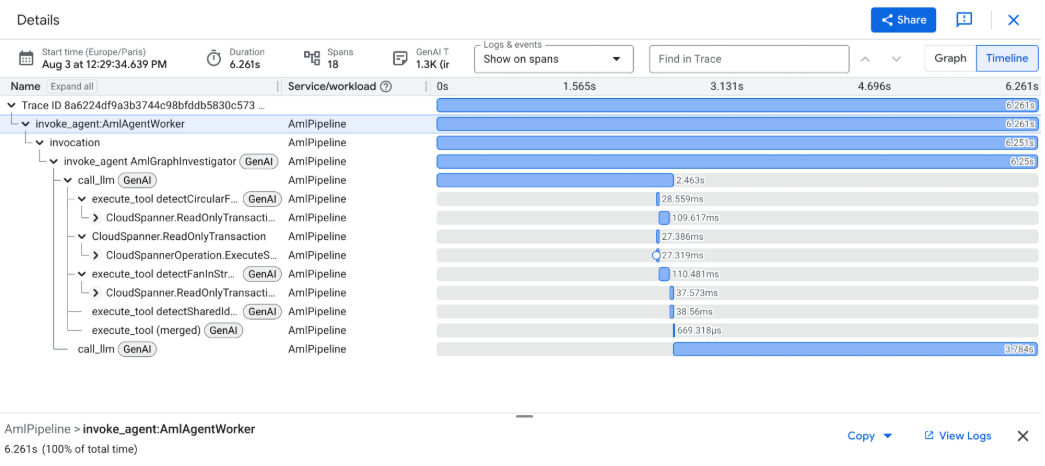
Depois de ativar o rastreamento, veja os rastreamentos de pipeline no console do Google Cloud :
No console Google Cloud , acesse a página Explorador de traces.
Na caixa de filtro, filtre por
Service: SERVICE_NAME. Esse SERVICE_NAME corresponde aoappNamedo pipeline ou aootel.service.nameconfigurado.Ou pesquise um ID de rastreamento específico.
Selecione um rastreamento na lista de resultados para conferir a linha do tempo detalhada.
O gráfico de linha do tempo mostra:
- Intervalos do executor:intervalos gerados pelo tempo de execução do Beam.
Por exemplo,
PubSubIO.ReadeProcessElement. - Intervalos personalizados:intervalos criados nas suas implementações de
DoFn. Por exemplo,InvestigateTransactionDoFn:Analyze. Abrangências da biblioteca de cliente:abrangências secundárias geradas por bibliotecas de cliente integradas. Por exemplo, consultas RPC do Spanner.
- Intervalos do executor:intervalos gerados pelo tempo de execução do Beam.
Por exemplo,
A seguir
- Saiba mais sobre como explorar e analisar traces distribuídos na documentação do Cloud Trace.
- Rastreie mensagens da ingestão ao processamento usando o rastreamento do Pub/Sub OpenTelemetry.
- Monitore a taxa de transferência do pipeline, a utilização da CPU e os detalhes de execução com a interface de monitoramento do Dataflow.
- Consulte registros operacionais e diagnostique erros usando Registros de pipeline do Dataflow.
- Investigue e resolva problemas de desempenho com Resolver problemas de jobs lentos ou travados e Detectar e resolver gargalos de pipeline.