


このドキュメントでは、AI を使用して音声入力に基づいてポッドキャストを生成するアプリケーションのアーキテクチャの概要について説明します。
このドキュメントは、メディア業界やマーケティング業界向けにクラウドで生成 AI アプリケーションを構築して管理するアーキテクト、デベロッパー、管理者を対象としています。このドキュメントは、生成 AI に関する基本的な知識があることを前提としています。
このドキュメントのデプロイセクションでは、マルチモーダル入出力形式を含む生成 AI ワークロードのコードサンプルを紹介します。
アーキテクチャ
次の図は、 Google Cloudのポッドキャスト プロデューサー アプリケーションのアーキテクチャを示しています。このアプリケーションは、AI を使用して音声ファイル(スポーツ イベントのライブ解説など)からポッドキャストを生成します。
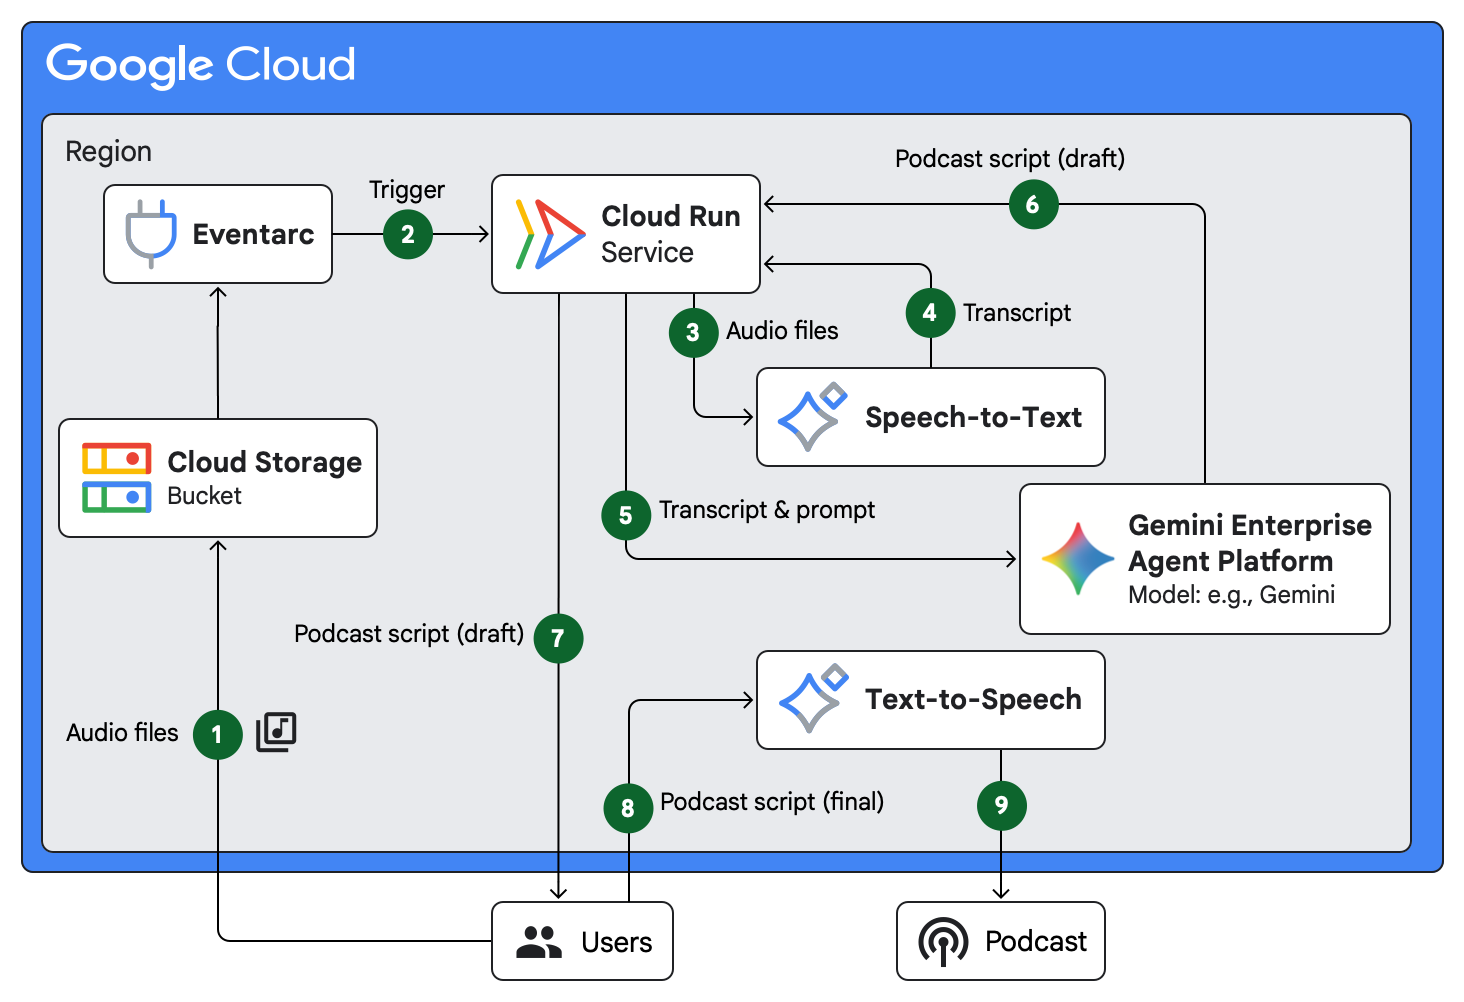
このアーキテクチャは、次のフローを示しています。
- ユーザーが Cloud Storage バケットに音声ファイルをアップロードします。
- Eventarc が Cloud Run サービスをトリガーします。
- Cloud Run サービスは、音声ファイルを Speech-to-Text に送信します。
- Speech-to-Text は、音声ファイルのタイムスタンプ付きの文字起こしを生成します。
Cloud Run サービスは、ポッドキャストのスクリプトを生成するプロンプトとともに、文字変換を Gemini Enterprise Agent Platform に送信します。
たとえば、解説の特定のキーワードに基づいて、スポーツ イベントのハイライトに関する 15 分間のポッドキャストのスクリプトを生成するプロンプトなどです。
Agent Platform の Gemini モデルが、ポッドキャスト スクリプトの下書きを生成します。
Cloud Run サービスは、下書きスクリプトをユーザーに送信します。
ユーザーは、スクリプトの下書きを確認して編集し、最終的なスクリプトを Text-to-Speech に送信します。
Text-to-Speech がポッドキャストの音声ファイルを生成します。
使用するプロダクト
このサンプル アーキテクチャでは、次の Google Cloud プロダクトを使用します。
- Speech-to-Text: Google の音声認識技術を使用して音声をテキストに変換する API。
- Gemini Enterprise Agent Platform: エンタープライズ グレードの AI エージェントを構築、スケーリング、管理、最適化できる包括的なプラットフォーム。
- Text-to-Speech: テキストから自然に聞こえる合成音声を作成する API。
- Cloud Storage: 低コストで無制限のオブジェクト ストア。さまざまなデータ型に対応しています。データには Google Cloudの内部および外部からアクセスでき、冗長性を確保するために複数のロケーションに複製されます。
- Cloud Run: Google のスケーラブルなインフラストラクチャ上でコンテナを直接実行できるサーバーレス コンピューティング プラットフォーム。
- Eventarc: イベントによってトリガーされたメッセージを非同期でルーティングするサーバーレス ソリューション。
設計上の考慮事項
このセクションでは、Google Cloud Well-Architected Framework に沿った設計要素、ベスト プラクティス、推奨事項について説明します。このリファレンス アーキテクチャを使用して、セキュリティ、信頼性、費用最適化、運用効率に関する特定の要件を満たすトポロジを開発する際は、この情報を考慮してください。
セキュリティ、プライバシー、コンプライアンス
ポッドキャスト生成ワークロードを保護し、プライバシーとコンプライアンスの要件を満たすには、次の推奨事項を検討してください。
- プロンプト、文字起こし、ポッドキャスト スクリプトをスクリーニングして、プロンプト インジェクション、ジェイルブレイクの試み、有害なコンテンツを検出するには、Model Armor を使用します。合成前に音声文字変換とドラフト スクリプトで個人を特定できる情報(PII)を検出して秘匿化するには、Sensitive Data Protection を使用します。
- 最小権限の原則に従うには、専用の Identity and Access Management(IAM)サービス アカウントを Eventarc トリガーと Cloud Run サービスに割り当てます。承認された呼び出し元とレビュー担当者にネットワーク アクセスを制限するには、Cloud Run の内向きの制御を構成し、IAM 認証を要求します。
信頼性
長尺の解説やポッドキャストの合成を確実に処理するには、次の推奨事項を検討してください。
- 長い解説の録音を確実に文字変換するには、非同期バッチ処理を検討してください。詳細については、長い音声ファイルをテキストに文字起こしするをご覧ください。
- エピソード全体を合成するには、スクリプトを小さなセグメントに分割するか、Long Audio Synthesis を使用して、出力音声を Cloud Storage に保存します。
- Eventarc は未確認の配信を再試行するため、Cloud Run HTTP ハンドラで同期マルチミニッツ メディア処理を行うと、タイムアウトが発生し、処理が重複する可能性があります。イベント配信を長時間実行処理から切り離すには、Workflows でマルチステップ タスクをオーケストレートするか、Cloud Run ジョブでバッチ ワークロードを実行します。
費用の最適化
スクリプトの生成とポッドキャスト音声の合成の費用を最適化するには、次の推奨事項を検討してください。
- ポッドキャスト スクリプトをすぐに生成する必要がない場合は、Agent Platform でバッチ推論を使用します。バッチ推論は、標準のオンライン推論よりも低コストで、大規模な音声文字変換ワークロードを非同期で処理します。
- 大量のポッドキャストを制作する際の合成コストを削減するには、Agent Platform の要件に基づいて適切なモデルを選択します。
運用効率
マルチモーダル パイプラインを効率化し、複数の話者による音声制作を簡素化するには、次の推奨事項を検討してください。
- 特別な Speech-to-Text 機能が必要ない場合は、Cloud Storage の音声 URI を Agent Platform の Gemini に直接渡すことで、パイプラインを簡素化できます。マルチモーダル音声認識を使用すると、Gemini はタイムスタンプを認識して長い音声ファイルを分析し、ポッドキャストのスクリプトを 1 ステップで作成できます。ワークロードでバッチ話者ダイアライゼーションやドメイン固有の名前のモデル適応が必要な場合は、専用の音声文字変換モデルで Speech-to-Text を使用します。
- 複雑な SSML チューニングを行わずに会話型のマルチホスト ポッドキャストを生成するには、Agent Platform で Gemini TTS を使用します。アプリケーションが Text-to-Speech を直接呼び出す場合は、Gemini TTS やその他の会話音声を使用して、自然な音声コントロールを実現することもできます。詳細については、サポートされている音声と言語をご覧ください。
デプロイ
音声やテキストなどのマルチモーダル入出力形式を含むワークロードに Google Cloud プロダクトを使用してみるには、次のコードサンプルを試してください。
次のステップ
- 生成 AI アーキテクチャ ガイドをさらに確認する。
- Google Cloudの AI ワークロードと ML ワークロードに固有のアーキテクチャ原則と推奨事項の概要について、Well-Architected Framework の AI と ML の視点を確認する。
- Cloud アーキテクチャ センターで、リファレンス アーキテクチャ、図、ベスト プラクティスを確認する。
協力者
著者: Kumar Dhanagopal | クロスプロダクト ソリューション デベロッパー
その他の寄稿者:
- Amina Mansour | グローバル デベロッパー リレーションズおよび戦略的コンテンツ担当テクニカル リード
- Megan O'Keefe | デベロッパー アドボケイト
- Samantha He | テクニカル ライター
- Shir Meir Lador | デベロッパー リレーションズ エンジニアリング マネージャー