


Dieses Dokument bietet eine allgemeine Architektur für eine Anwendung, die KI verwendet, um Podcasts basierend auf Audioeingaben zu generieren.
Die Zielgruppe für dieses Dokument umfasst Architekten, Entwickler und Administratoren, die generative KI-Anwendungen in der Cloud für die Medien- und Marketingbranche erstellen und verwalten. In diesem Dokument wird davon ausgegangen, dass Sie ein grundlegendes Verständnis von generativer KI haben.
Der Abschnitt Bereitstellung dieses Dokuments enthält Codebeispiele für generative KI-Arbeitslasten mit multimodalen Eingabe- und Ausgabeformaten.
Architektur
Das folgende Diagramm zeigt eine Architektur für eine Podcast-Produzentenanwendung in Google Cloud. Die Anwendung verwendet KI, um Podcasts aus Audiodateien zu generieren, z. B. Live-Kommentare für ein Sportereignis.
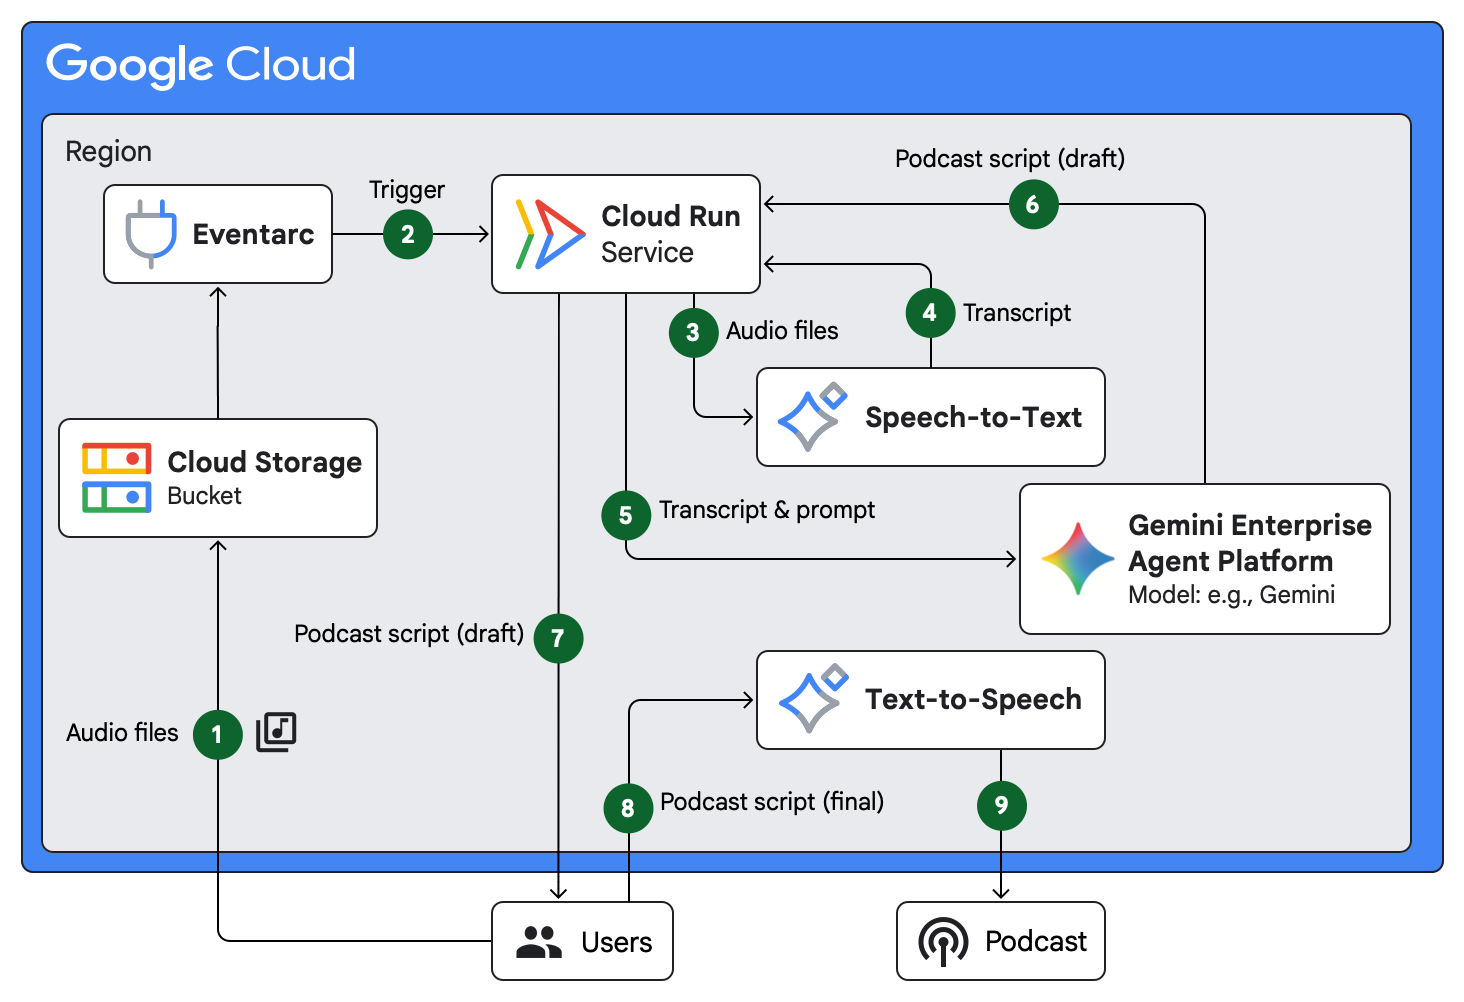
Die Architektur zeigt den folgenden Ablauf:
- Ein Nutzer lädt Audiodateien in einen Cloud Storage-Bucket hoch.
- Eventarc löst einen Cloud Run-Dienst aus.
- Der Cloud Run-Dienst sendet die Audiodateien an Speech-to-Text.
- Speech-to-Text erstellt Transkripte der Audiodateien mit Zeitstempeln.
Der Cloud Run-Dienst sendet die Transkripte an die Gemini Enterprise Agent Platform, zusammen mit einem Prompt, um ein Skript für einen Podcast zu generieren.
Der Prompt könnte beispielsweise lauten, ein Skript für einen 15-minütigen Podcast über die Highlights eines Sportereignisses basierend auf bestimmten Keywords im Kommentar zu erstellen.
Ein Gemini-Modell auf der Agent Platform erstellt einen Entwurf für ein Podcast-Skript.
Der Cloud Run-Dienst sendet den Skriptentwurf an den Nutzer.
Der Nutzer prüft und bearbeitet den Skriptentwurf und sendet das endgültige Skript dann an Text-to-Speech.
Text-to-Speech erstellt eine Podcast-Audiodatei.
Verwendete Produkte
In dieser Beispielarchitektur werden die folgenden Google Cloud Produkte verwendet:
- Speech-to-Text: Eine API, die die Spracherkennungstechnologien von Google verwendet, um Audioinhalte in Text umzuwandeln.
- Gemini Enterprise Agent Platform: Eine umfassende Plattform, mit der Sie KI-Agenten auf Unternehmensniveau erstellen, skalieren, verwalten und optimieren können.
- Text-to-Speech: Eine API zum Erstellen natürlich klingender, synthetischer menschlicher Sprache aus Text.
- Cloud Storage: Ein kostengünstiger, unbegrenzter Objektspeicher für verschiedene Datentypen. Auf Daten kann von innerhalb und außerhalb von Google Cloudzugegriffen werden. Sie werden zu Redundanzzwecken über Standorte hinweg repliziert.
- Cloud Run ist eine serverlose Computing-Plattform, mit der Sie Container direkt auf der skalierbaren Infrastruktur von Google ausführen können.
- Eventarc: Eine serverlose Lösung, um durch Ereignisse ausgelöste Nachrichten asynchron weiterzuleiten.
Designaspekte
In diesem Abschnitt werden Designfaktoren, Best Practices und Empfehlungen im Einklang mit dem Google Cloud Well-Architected Framework beschrieben. Berücksichtigen Sie diese Informationen, wenn Sie diese Referenzarchitektur verwenden, um eine Topologie zu entwickeln, die Ihren spezifischen Anforderungen an Sicherheit, Zuverlässigkeit, Kostenoptimierung und betriebliche Effizienz entspricht.
Sicherheit, Datenschutz und Compliance
Beachten Sie die folgenden Empfehlungen, um Ihre Arbeitslast für die Podcast-Erstellung zu sichern und Ihre Datenschutz- und Compliance-Anforderungen zu erfüllen:
- Mit Model Armor können Sie Prompts, Transkripte und Podcast-Skripts auf Prompt Injection, Jailbreaking-Versuche und schädliche Inhalte prüfen. Mit Sensitive Data Protection können Sie personenidentifizierbare Informationen in Transkripten und Skriptentwürfen vor der Synthese erkennen und entfernen.
- Weisen Sie dem Eventarc-Trigger und dem Cloud Run-Dienst dedizierte IAM-Dienstkonten (Identity and Access Management) zu, um das Prinzip der geringsten Berechtigung zu befolgen. Wenn Sie den Netzwerkzugriff auf autorisierte Aufrufer und Prüfer beschränken möchten, konfigurieren Sie die Cloud Run-Steuerung für eingehenden Traffic und legen Sie fest, dass eine IAM-Authentifizierung erforderlich ist.
Zuverlässigkeit
Beachten Sie die folgenden Empfehlungen, um eine zuverlässige Verarbeitung für lange Kommentare und Podcast-Synthese zu gewährleisten:
- Für die zuverlässige Transkription langer Kommentare sollten Sie die asynchrone Batchverarbeitung in Betracht ziehen. Weitere Informationen finden Sie unter Lange Audiodateien in Text transkribieren.
- Wenn Sie ganze Folgen synthetisieren möchten, teilen Sie die Skripts in kleinere Segmente auf oder verwenden Sie die Synthese langer Audioinhalte und speichern Sie die Audioausgabe dann in Cloud Storage.
- Da Eventarc nicht bestätigte Zustellungen wiederholt, kann die synchrone, mehrminütige Medienverarbeitung in einem Cloud Run-HTTP-Handler zu Zeitüberschreitungen und doppelter Arbeit führen. Wenn Sie die Ereignisbereitstellung von der langwierigen Verarbeitung entkoppeln möchten, können Sie mehrstufige Aufgaben mit Workflows orchestrieren oder Batcharbeitslasten in Cloud Run-Jobs ausführen.
Kostenoptimierung
Beachten Sie die folgenden Empfehlungen, um die Kosten für das Generieren von Skripts und das Synthetisieren von Podcast-Audio zu optimieren:
- Wenn Podcast-Skripts nicht sofort generiert werden müssen, verwenden Sie die Batch-Inferenz auf der Agent Platform. Bei der Batch-Inferenz werden große Transkript-Arbeitslasten asynchron zu geringeren Kosten als bei der Standard-Online-Inferenz verarbeitet.
- Wenn Sie die Synthesekosten für die Produktion von Podcasts mit hohem Volumen senken möchten, wählen Sie auf der Agent Platform ein geeignetes Modell aus, das Ihren Anforderungen entspricht.
Betriebliche Effizienz
Beachten Sie die folgenden Empfehlungen, um Ihre multimodale Pipeline zu optimieren und die Audioproduktion mit mehreren Sprechern zu vereinfachen:
- Wenn Sie keine speziellen Speech-to-Text-Funktionen benötigen, können Sie die Pipeline vereinfachen, indem Sie Cloud Storage-Audio-URIs direkt an Gemini auf der Agent Platform übergeben. Mit dem multimodalen Audioverständnis kann Gemini lange Audiodateien mit Zeitstempeln analysieren und in einem Schritt Podcast-Skripts erstellen. Verwenden Sie Speech-to-Text mit speziellen Transkriptionsmodellen, wenn Ihre Arbeitslast eine Batch-Sprecherdiarisierung oder eine Modellanpassung für domainspezifische Namen erfordert.
- Wenn Sie Podcasts mit mehreren Hosts im Gesprächsstil ohne komplexe SSML-Abstimmung erstellen möchten, verwenden Sie Gemini TTS auf der Agent Platform. Wenn Ihre Anwendung Text-to-Speech direkt aufruft, können Sie auch Gemini TTS oder andere Konversationsstimmen für eine natürliche Sprachsteuerung verwenden. Weitere Informationen finden Sie unter Unterstützte Stimmen und Sprachen.
Bereitstellung
Wenn Sie mit der Verwendung von Google Cloud -Produkten für Arbeitslasten mit multimodalen Eingabe- und Ausgabeformaten wie Audio und Text experimentieren möchten, probieren Sie die folgenden Codebeispiele aus:
- Transkript eines Audiointerviews erstellen
- Podcast mit mehreren Sprechern mit der Gemini API und der Text-to-Speech API generieren
- Audio aufnehmen und eine Übersetzung generieren
Nächste Schritte
- Weitere Leitfäden zur Architektur generativer KI
- Eine Übersicht über Architekturprinzipien und Empfehlungen, die speziell für KI- und ML-Arbeitslasten in Google Cloudgelten, finden Sie im Well-Architected Framework unter KI- und ML-Perspektive.
- Weitere Referenzarchitekturen, Diagramme und Best Practices finden Sie im Cloud-Architekturcenter.
Beitragende
Autor: Kumar Dhanagopal | Cross-product Solution Developer
Weitere Beitragende:
- Amina Mansour | Tech Lead, Global Developer Relations & Strategic Content
- Megan O'Keefe | Developer Advocate
- Samantha He | Technical Writer
- Shir Meir Lador | Developer Relations Engineering Manager