


Google Cloud Well-Architected Framework の信頼性の柱では、 Google Cloudで信頼性の高いワークロードを設計、デプロイ、管理するうえで役立つ原則と推奨事項について説明します。
このドキュメントは、クラウド アーキテクト、デベロッパー、プラットフォーム エンジニア、管理者、サイト信頼性エンジニアを対象としています。
信頼性とは、定義された条件内で意図された機能を一貫して実行し、サービスを中断することなく維持するシステムの能力です。信頼性に関するベスト プラクティスには、冗長性、フォールト トレラントな設計、モニタリング、自動復旧プロセスなどがあります。
信頼性の一部である復元力は、パフォーマンスを維持しながら、障害や予期しない中断に耐えて復旧するシステムの能力です。マルチリージョン デプロイ、自動バックアップ、障害復旧ソリューションなどのGoogle Cloud 機能は、システムの復元力を向上させるのに役立ちます。
信頼性は、次のような多くの理由からクラウド戦略にとって重要です。
- 最小限のダウンタイム: ダウンタイムは、収益の損失、生産性の低下、評判の低下を招く可能性があります。復元力のあるアーキテクチャは、システムが障害発生中の機能の継続や障害からの効率的な復旧を確実に行ううえで役立ちます。
- ユーザー エクスペリエンスの向上: ユーザーはテクノロジーによるシームレスなやり取りを期待しています。復元力のあるシステムは、一貫したパフォーマンスと可用性を維持し、需要の急増や予期しない問題が発生しても信頼性の高いサービスを提供できます。
- データの完全性: 障害が発生すると、データの損失やデータの破損が発生する可能性があります。復元力のあるシステムでは、バックアップ、冗長性、レプリケーションなどのメカニズムを実装してデータを保護し、正確でアクセス可能な状態を維持します。
- ビジネスの継続性: ビジネスは重要なオペレーションにおいてテクノロジーに依存しています。復元力のあるアーキテクチャを採用すると、致命的な障害が発生した後の継続性を保証するのに役立ちます。これにより、ビジネス機能が大幅な中断なく継続され、迅速な復旧をサポートできます。
- コンプライアンス: 多くの業界には、システムの可用性とデータ保護に関する規制要件があります。復元力のあるアーキテクチャを採用すると、システムの運用とセキュリティを確保することで、こうした基準を満たすことができます。
- 長期的な費用の削減: 復元力のあるアーキテクチャには初期投資が必要ですが、復元力により、費用のかかるダウンタイムを回避して事後対応の修正を回避し、リソースをより効率的に使用できるため、長期的には費用を削減できます。
組織の考え方
システムの信頼性を高めるには、計画と確立された戦略が必要です。この戦略には、他の取り組みと並行して信頼性を優先する教育と権限が含まれている必要があります。
開発、プロダクト マネージャー、運用、プラットフォーム エンジニアリング、サイト信頼性エンジニアリング(SRE)など、組織全体が信頼性に対して責任を負うことを明確に示します。マーケティングやセールスなど、ビジネスに特化したグループであっても信頼性に影響を与える可能性はあります。
すべてのチームは、アプリケーションの信頼性目標とリスクを理解する必要があります。各チームはこれらの要件に責任を負う必要があります。信頼性と通常のプロダクト機能開発との間に矛盾があれば、優先度を上げて対応し、適切にエスカレーションする必要があります。
すべての機能とチーム全体で信頼性を包括的に計画、管理します。信頼性の柱を含む Cloud Center of Excellence(CCoE、クラウド活用推進組織)の設立を検討してください。詳細については、Cloud Center of Excellence を使用して組織の Cloud Journey を最適化するをご覧ください。
信頼性の重点分野
信頼性の高いシステムを設計、デプロイ、管理するために行うアクティビティは、次の重点分野に分類できます。この柱の信頼性に関する原則と推奨事項は、これらの重点分野のいずれかに関連しています。
- スコープ設定: システムを理解するために、アーキテクチャの詳細な分析を行います。コンポーネント、コンポーネントの動作と相互作用、データとアクションがシステムをどのように流れるか、問題が発生する可能性のあることを理解する必要があります。潜在的な障害、ボトルネック、リスクを特定し、それによってそうした問題を軽減するための対策を講じることができます。
- オブザーバビリティ: システム障害を防ぐために、包括的で継続的なオブザーバビリティとモニタリングを実装します。このオブザーバビリティにより、トレンドを把握して潜在的な問題を事前に特定できます。
- レスポンス: 障害の影響を軽減するために、適切に対応して効率的に復旧します。自動レスポンスを使用すると、障害の影響を軽減することもできます。計画と管理を行っても、障害が発生する可能性はあります。
- 学習: 障害の再発を防ぐため、それぞれの経験から学び、適切な措置を講じます。
エージェント スキルを使用してワークロードを評価する
AI エージェントがこの柱の原則と推奨事項に照らしてクラウド ワークロードを評価できるようにするには、GitHub の Google Agent Skills リポジトリにある google-cloud-waf-reliability スキルを使用します。
スキルをインストールするには、エージェントのクライアントまたはターミナルで次のコマンドを実行します。
npx skills add google/skills --skill google-cloud-waf-reliability
プロンプトが表示されたら、スキルをインストールする AI エージェントを指定し、インストール スコープ(プロジェクトまたはグローバル)を設定します。
スキルがすでにインストールされている場合は、次のコマンドを実行して最新バージョンに更新できます。
npx skills update
基本原則
Well-Architected Framework の信頼性の柱の推奨事項は、次の基本原則にマッピングされています。
- ユーザー エクスペリエンスの目標に基づいて信頼性を定義する
- 信頼性の現実的な目標を設定する
- リソースの冗長性による高可用性システムを構築する
- 水平方向のスケーラビリティを活用する
- オブザーバビリティを使用して潜在的な障害を検出する
- グレースフル デグラデーションとなるように設計する
- 障害からの復元のテストを行う
- データ損失からの復元のテストを行う
- 徹底的な事後検証を実施する
寄稿者
著者:
- Laura Hyatt | カスタマー エンジニア兼 FSI
- Jose Andrade | カスタマー エンジニア兼 SRE スペシャリスト
- Gino Pelliccia | プリンシパル アーキテクト
その他の寄稿者:
- Andrés-Leonardo Martínez-Ortiz | テクニカル プログラム マネージャー
- Brian Kudzia | エンタープライズ インフラストラクチャ カスタマー エンジニア
- Daniel Lees | クラウド セキュリティ アーキテクト
- Filipe Gracio, PhD | カスタマー エンジニア兼 AI / ML スペシャリスト
- Gary Harmson | プリンシパル アーキテクト
- Kumar Dhanagopal | クロス プロダクト ソリューション デベロッパー
- Marwan Al Shawi | パートナー カスタマー エンジニア
- Nicolas Pintaux | カスタマー エンジニア、アプリケーション モダナイゼーション スペシャリスト
- Radhika Kanakam | Google Cloud Well-Architected Framework プログラム リード
- Ryan Cox | プリンシパル アーキテクト
- Samantha He | テクニカル ライター
- Wade Holmes | グローバル ソリューション ディレクター
- Zach Seils | ネットワーキング スペシャリスト
ユーザー エクスペリエンスの目標に基づいて信頼性を定義する
Google Cloud Well-Architected Framework の信頼性の柱におけるこの原則は、ユーザー エクスペリエンスを評価し、その結果を信頼性の目標と指標にマッピングするうえで役立ちます。
この原則は、信頼性のスコープ設定の重点分野に関連しています。
原則の概要
オブザーバビリティ ツールは大量のデータを提供しますが、すべてのデータがユーザーへの影響に直接関係しているわけではありません。たとえば、CPU 使用率が高くなったり、サーバー オペレーションが遅くなったり、タスクがクラッシュしたりすることがあります。ただし、これらの問題がユーザー エクスペリエンスに影響しない場合は、サービス停止には該当しません。
ユーザー エクスペリエンスを測定するには、内部システムの動作とユーザー向けの問題を区別する必要があります。ユーザー リクエストの成功率などの指標に注目します。CPU 使用率などのサーバー中心の指標のみに依存しないでください。サービスの信頼性について誤った結論を導く可能性があります。真の信頼性とは、ユーザーがアプリケーションやサービスを継続的かつ効果的に使用できることを意味します。
推奨事項
ユーザー エクスペリエンスを効果的に測定するには、次のセクションの推奨事項を検討してください。
ユーザー エクスペリエンスを測定する
サービスの信頼性を真に理解するには、ユーザーの実際の体験を反映する指標を優先します。たとえば、ユーザーのクエリ成功率、アプリケーションのレイテンシ、エラー率を測定します。
このデータは、ユーザーのデバイスまたはブラウザから直接収集するのが理想的です。この直接的なデータの収集が不可能な場合は、システム内のユーザーから測定ポイントを徐々に遠ざけていきます。たとえば、ロードバランサまたはフロントエンド サービスを測定ポイントとして使用できます。このアプローチにより、ユーザーに大きな影響を与える前に問題を特定して対処できます。
ユーザー ジャーニーを分析する
ユーザーがシステムをどのように操作しているかを把握するには、Cloud Trace などのトレースツールを使用します。アプリケーションでのユーザーのジャーニーを追跡することで、ユーザー エクスペリエンスを低下させる可能性のあるボトルネックやレイテンシの問題を特定できます。Cloud Trace は、サービス アーキテクチャの各ホップの詳細なパフォーマンス データをキャプチャします。このデータは、パフォーマンスの問題をより効率的に特定して対処するのに役立ち、より信頼性が高く満足度の高いユーザー エクスペリエンスにつながります。
信頼性の現実的な目標を設定する
Google Cloud Well-Architected Framework の信頼性の柱におけるこの原則は、 Google Cloudのワークロードで技術的に実現可能な信頼性目標を定義するうえで役立ちます。
この原則は、信頼性のスコープ設定の重点分野に関連しています。
原則の概要
ユーザーが満足できるほど十分に信頼できるシステムを設計します。直感に反するように思えるかもしれませんが、100% の信頼性を目標にすることは、多くの場合、最も効果的な戦略ではありません。信頼性を高めると、金銭的な投資とイノベーションの潜在的な制限の両面で、コストが大幅に増加する可能性があります。ユーザーが現在のサービスレベルにすでに満足している場合、満足度をさらに高めるための取り組みは、投資収益率が低くなる可能性があります。代わりに、リソースを他の場所で有効に活用できます。
ユーザーが満足する信頼性のレベルを判断し、段階的な改善の費用がメリットを上回り始めるポイントを判断する必要があります。この十分な信頼性のレベルを決定すると、リソースを戦略的に割り当て、ユーザーに大きな価値をもたらす機能と改善に集中できます。
推奨事項
現実的な信頼性目標を設定するには、次のサブセクションの推奨事項を検討してください。
一部の障害を許容し、コンポーネントに優先順位を付ける
99.99% の稼働時間などの高可用性を目指しますが、100% の稼働時間を目標に設定しないでください。一部の障害は避けられないことを認識する。
100% の稼働時間と 99.99% の目標の差は、障害の許容範囲です。このギャップは、多くの場合、エラー バジェットと呼ばれます。エラー バジェットは、リスクを冒してイノベーションを起こすのに役立ちます。これは、あらゆるビジネスが競争力を維持するために不可欠なことです。
システム内の最も重要なコンポーネントの信頼性を優先します。重要度の低いコンポーネントは障害に対する許容度が高くなることを受け入れる。
信頼性と費用のバランス
システムに最適な信頼性レベルを判断するには、費用対効果の分析を徹底的に行います。
システム要件、障害の影響、特定のアプリケーションに対する組織のリスク許容度などの要素を考慮します。目標復旧時間(RTO)や目標復旧時点(RPO)などの障害復旧指標を考慮してください。予算やその他の制約内で許容できる信頼性のレベルを決定します。
重要な信頼性機能を損なうことなく、効率を向上させ、費用を削減する方法を探します。
リソースの冗長性による高可用性システムを構築する
Google Cloud Well-Architected Framework の信頼性の柱におけるこの原則では、障害の回避に役立つリソースの冗長性を計画、構築、管理するための推奨事項が示されています。
この原則は、信頼性のスコープ設定の重点分野に関連しています。
原則の概要
必要な信頼性のレベルを決定したら、単一障害点を回避するようにシステムを設計する必要があります。システム内のすべての重要なコンポーネントは、複数のマシン、ゾーン、リージョンにレプリケートする必要があります。たとえば、重要なデータベースを 1 つのリージョンにのみ配置することはできません。また、メタデータ サーバーを 1 つのゾーンまたはリージョンにのみデプロイすることはできません。これらの例では、唯一のゾーンまたはリージョンで障害が発生すると、システムでグローバルな障害が発生します。
推奨事項
冗長システムを構築するには、以下のサブセクションの推奨事項を検討してください。
障害発生ドメインを特定してサービスを複製する
個々の VM からリージョンまで、システムの障害発生ドメインをマッピングし、障害発生ドメイン全体で冗長性を考慮して設計します。
高可用性を確保するには、複数のゾーンとリージョンにサービスとアプリケーションを分散して複製します。自動フェイルオーバー用にシステムを構成して、ゾーンまたはリージョンの停止が発生した場合でもサービスとアプリケーションを引き続き利用できるようにします。
マルチゾーン アーキテクチャとマルチリージョン アーキテクチャの例については、 Google Cloudのワークロードに適した信頼性の高いインフラストラクチャを設計するをご覧ください。
問題を迅速に検出して対処する
障害発生ドメインのステータスを継続的に追跡して、問題を迅速に検出して対処します。
Google Cloud Service Health ダッシュボードを使用すると、すべてのリージョンの Google Cloud サービスの現在のステータスをモニタリングできます。また、Personalized Service Health を使用して、プロジェクトに関連するインシデントを参照することもできます。ロードバランサを使用してリソースの健全性を検出し、トラフィックを正常なバックエンドに自動的に転送できます。詳細については、ヘルスチェックの概要をご覧ください。
フェイルオーバー シナリオをテストする
避難訓練のように、障害を定期的にシミュレートして、レプリケーションとフェイルオーバー戦略の有効性を検証します。
詳細については、リージョン MIG のゾーンの停止をシミュレーションすると GKE リージョン クラスタでゾーン障害をシミュレートするをご覧ください。
水平方向のスケーラビリティを活用する
Google Cloud Well-Architected Framework の信頼性の柱におけるこの原則では、水平方向のスケーラビリティを使用するうえで役に立つ推奨事項が示されています。水平スケーラビリティを使用すると、Google Cloud のワークロードを効率的にスケーリングし、パフォーマンスを維持できます。
この原則は、信頼性のスコープ設定の重点分野に関連しています。
原則の概要
システムを水平アーキテクチャに再設計します。トラフィックやデータの増加に対応するために、リソースを追加できます。使用していないリソースを削除することもできます。
水平スケーリングの価値を理解するには、垂直スケーリングの制限事項を考慮してください。
垂直スケーリングの一般的なシナリオは、重要なデータを含むプライマリ データベースとして MySQL データベースを使用することです。データベースの使用量が増加するにつれて、より多くの RAM と CPU が必要になります。最終的に、データベースはホストマシンのメモリ上限に達し、アップグレードが必要になります。このプロセスは、数回繰り返す必要がある場合があります。問題は、データベースの拡張量に厳しい制限があることです。VM のサイズは無制限ではありません。データベースは、リソースを追加できなくなるポイントに達する可能性があります。
リソースが無制限であっても、大規模な VM は単一障害点になる可能性があります。プライマリ データベース VM に問題があると、エラー レスポンスが発生したり、システム全体が停止してすべてのユーザーに影響が及んだりする可能性があります。リソースの冗長性による高可用性システムを構築するで説明されているように、単一障害点を回避します。
これらのスケーリング制限に加えて、垂直スケーリングは費用が高くなる傾向があります。コンピューティング能力とメモリ容量が大きいマシンを取得すると、費用が指数関数的に増加する可能性があります。
一方、水平スケーリングは費用を抑えることができます。スケーリングを考慮して設計されたシステムでは、水平スケーリングの可能性は実質的に無制限です。
推奨事項
単一 VM アーキテクチャから水平方向のマルチマシン アーキテクチャに移行するには、慎重に計画を立て、適切なツールを使用する必要があります。水平スケーリングを実現するには、以下のサブセクションの推奨事項を検討してください。
マネージド サービスを使用する
マネージド サービスを使用すると、水平スケーリングを手動で管理する必要がなくなります。たとえば、Compute Engine マネージド インスタンス グループ(MIG)を使用すると、VM を追加または削除してアプリケーションを水平方向にスケーリングできます。コンテナ化されたアプリケーションの場合、Cloud Run は、受信トラフィックに基づいてステートレス コンテナを自動的にスケーリングできるサーバーレス プラットフォームです。
モジュラー設計を推進する
モジュラー コンポーネントと明確なインターフェースにより、アプリケーション全体をスケーリングするのではなく、必要に応じて個々のコンポーネントをスケーリングできます。詳細については、パフォーマンス最適化の柱のモジュラー設計を促進するをご覧ください。
ステートレス設計を実装する
アプリケーションをステートレス(ローカルに保存されたデータがない)に設計します。これにより、データの整合性を気にすることなく、インスタンスを追加または削除できます。
オブザーバビリティを使用して潜在的な障害を検出する
Google Cloud Well-Architected Framework の信頼性の柱におけるこの原則では、エラーや障害が発生する可能性のある領域を事前に特定するうえで役に立つ推奨事項が示されています。
この原則は、信頼性のオブザーバビリティの重点分野に関連しています。
原則の概要
Google Cloudでワークロードの信頼性を維持し、向上させるには、指標、ログ、トレースを使用して効果的なオブザーバビリティを実装する必要があります。
- 指標は、特定の時間間隔でアプリケーションの追跡対象となるアクティビティの数値測定値です。たとえば、リクエスト率やエラー率などの技術指標を追跡して、サービスレベル指標(SLI)として使用できます。注文数や支払いの受領額など、アプリケーション固有のビジネス指標のトラッキングが必要な場合もあります。
- ログは、アプリケーションまたはシステム内で発生する個別のイベントのタイムスタンプ付きの記録です。イベントは、障害、エラー、状態変化のいずれかです。ログには指標が含まれる場合があり、ログを SLI に使用することもできます。
- トレースは、単一のユーザーまたはトランザクションが複数の個別のアプリケーションまたはアプリケーション コンポーネントを通過する過程を表します。これらのコンポーネントは、マイクロサービスの場合もあります。トレースを使用すると、ジャーニーで使用されたコンポーネント、ボトルネックの場所、ジャーニーにかかった時間を追跡できます。
指標、ログ、トレースは、システムの継続的なモニタリングすに役立ちます。包括的なモニタリングにより、エラーの発生場所と発生原因を特定できます。エラーが発生する前に、潜在的な障害を検出することもできます。
推奨事項
潜在的な障害を効率的に検出するには、次のサブセクションの推奨事項を検討してください。
包括的な分析情報を取得する
レスポンス時間やエラー率などの主要な指標を追跡するには、Cloud Monitoring と Cloud Logging を使用します。これらのツールは、指標がワークロードのニーズを常に満たしていることを確認するうえでも役立ちます。
データドリブンの意思決定を行うには、デフォルトのサービス指標を分析し、コンポーネントの依存関係と、それらがワークロード全体のパフォーマンスに与える影響を把握します。
モニタリング戦略をカスタマイズするには、Google Cloud SDK を使用して独自の指標を作成して公開します。
予防的トラブルシューティングを実施する
堅牢なエラー処理を実装し、 Google Cloudのワークロードのすべてのコンポーネントでロギングを有効にします。Cloud Storage アクセスログや VPC Flow Logs などのログを有効にします。
ロギングを構成する場合は、関連する費用を考慮してください。ロギング費用を制御するには、ログシンクに除外フィルタを構成し、特定のログが保存されないようにします。
リソース使用率を最適化する
CPU 使用量、ネットワーク I/O 指標、ディスク I/O 指標をモニタリングして、GKE、Compute Engine、Managed Service for Apache Spark などのサービスでリソースのプロビジョニング不足や過剰なプロビジョニングを検出します。サポートされているサービスの一覧については、Cloud Monitoring の概要をご覧ください。
アラートの優先順位付け
アラートの場合は、重要な指標に焦点を当て、適切なしきい値を設定して「アラート疲れ」を最小限に抑え、重大な問題にタイムリーに対応できるようにします。このターゲット アプローチにより、ワークロードの信頼性を事前に維持することができます。詳細については、アラートの概要をご覧ください。
グレースフル デグラデーションとなるように設計する
Google Cloud Well-Architected Framework の信頼性の柱におけるこの原則では、 Google Cloud ワークロードを正常にフェイルオーバーするように設計するうえで役に立つ推奨事項が示されています。
この原則は、信頼性のレスポンスの重点分野に関連しています。
原則の概要
グレースフル デグラデーションは、高負荷が発生したシステムが、パフォーマンスや精度が低下する可能性があるものの、機能し続ける設計アプローチです。グレースフル デグラデーションにより、システムの動作が最適でない場合でも、システムの可用性が継続され、完全な障害が防止されます。負荷が管理可能なレベルに戻ると、システムは完全な機能を再開します。
たとえば、負荷が高い期間中、Google 検索は、上位のウェブページからの結果を優先し、精度を犠牲にする可能性があります。負荷が減少すると、Google 検索は検索結果を再計算します。
推奨事項
グレースフル デグラデーションを考慮してシステムを設計するには、以下のサブセクションの推奨事項を検討してください。
スロットリングを実装する
レプリカが過負荷を個別に処理し、トラフィックが多いシナリオで受信リクエストをスロットリングできるようにします。このアプローチは、ゾーン間の過剰なトラフィックのシフトによって発生する連鎖的な障害を防ぐのに役立ちます。
Apigee などのツールを使用して、トラフィックが多い時間帯の API リクエストのレートを制御します。リクエストをスケールバックする方法を反映するように、ポリシールールを構成できます。
過剰なリクエストを早期にドロップする
バックエンド コンポーネントを保護するために、フロントエンド レイヤで過剰なリクエストをドロップするようにシステムを構成します。一部のリクエストをドロップすることで、グローバルな障害を防ぎ、システムをより適切に復旧できます。このアプローチでは、一部のユーザーにエラーが発生する可能性があります。ただし、回路遮断のようなアプローチとは対照的に、停止の影響を最小限に抑えることができます。このアプローチでは、過負荷時にすべてのトラフィックがドロップされます。
部分的なエラーと再試行を処理する
部分的なエラーと再試行をシームレスに処理するようにアプリケーションを構築します。この設計により、高負荷のシナリオでも、可能な限り多くのトラフィックを処理できます。
過負荷のシナリオをテストする
スロットルとリクエスト ドロップのメカニズムが効果的に機能することを確認するには、システムで過負荷状態を定期的にシミュレートします。テストにより、実際のトラフィックの急増にシステムが対応できることを確認できます。
トラフィックの急増をモニタリングする
分析ツールとモニタリング ツールを使用して、トラフィックの急増を予測し、過負荷になる前に対応します。早期の検出と対応により、需要の高い期間でもサービスの可用性を維持できます。
障害からの復元のテストを行う
Google Cloud Well-Architected Framework の信頼性の柱におけるこの原則では、障害発生時の復旧テストを設計して実行するうえで役に立つ推奨事項が示されています。
この原則は、信頼性の学習の重点分野に関連しています。
原則の概要
システムが障害から復旧できるようにするには、リージョン フェイルオーバー、リリース ロールバック、バックアップからのデータ復元などのテストを定期的に実行する必要があります。
このテストは、リージョン全体の停止など、信頼性に大きなリスクをもたらすイベントへの対応を練習するのに役立ちます。このテストは、中断中にシステムが意図したとおりに動作することを確認するのにも役立ちます。
リージョン全体が停止するような事態が発生した場合は、すべてのトラフィックを別のリージョンにフェイルオーバーする必要があります。ワークロードの通常のオペレーション中にデータが変更された場合は、プライマリ リージョンからフェイルオーバー リージョンに同期する必要があります。ユーザーがデータの損失やセッションの破損を経験しないように、複製されたデータが常に最新であることを確認する必要があります。また、ロード バランシング システムは、サービスを中断することなく、いつでもトラフィックをフェイルオーバー リージョンにシフトできる必要があります。リージョンが停止した後のダウンタイムを最小限に抑えるため、運用エンジニアは、ユーザー トラフィックをリージョンから手動で効率的に、できるだけ短時間で移行できる必要があります。このオペレーションは、リージョンのドレインと呼ばれることもあります。これは、リージョンへのインバウンド トラフィックを停止し、すべてのトラフィックを別の場所に移動することを意味します。
推奨事項
障害復旧のテストを設計して実行する場合は、次のサブセクションの推奨事項を検討してください。
テストの目的と範囲を定義する
テストで達成したいことを明確に定義します。たとえば、目標には次のようなものがあります。
- 目標復旧時間(RTO)と目標復旧時点(RPO)を検証します。詳細については、DR 計画の基本をご覧ください。
- さまざまな障害シナリオでシステムの復元力とフォールト トレランスを評価します。
- 自動フェイルオーバー メカニズムの有効性をテストします。
テストの対象となるコンポーネント、サービス、リージョンを決定します。スコープには、フロントエンド、バックエンド、データベースなどの特定のアプリケーション層を含めることができます。また、Cloud SQL インスタンスや GKE クラスタなどの特定の Google Cloud リソースを含めることもできます。また、サードパーティ API や Cloud Interconnect などの外部依存関係も指定する必要があります。
テスト環境を準備する
適切な環境を選択します。本番環境の設定を複製したステージング環境またはサンドボックス環境を選択することをおすすめします。本番環境でテストを実施する場合は、自動モニタリングや手動ロールバック手順などの安全対策を準備してください。
バックアップ プランを作成します。重要なデータベースとサービスのバックアップまたはスナップショットを作成して、テスト中のデータ損失を防ぎます。自動フェイルオーバー メカニズムが失敗した場合に、チームが手動で介入できるように準備してください。
テストの中断を防ぐため、IAM ロール、ポリシー、フェイルオーバー構成が正しく設定されていることを確認してください。テストツールとスクリプトに必要な権限が付与されていることを確認します。
オペレーション、DevOps、アプリケーション オーナーなどの関係者に、テストのスケジュール、範囲、潜在的な影響について通知します。関係者に、テストの推定タイムラインと想定される動作を伝えます。
障害シナリオをシミュレートする
Chaos Monkey などのツールを使用して、障害を計画して実行します。カスタム スクリプトを使用して、マルチゾーン GKE クラスタのプライマリ ノードのシャットダウンや Cloud SQL インスタンスの無効化など、重要なサービスの障害をシミュレートできます。スクリプトを使用して、テストの範囲に基づいてファイアウォール ルールまたは API 制限を使用することで、リージョン全体のネットワーク停止をシミュレートすることもできます。障害シナリオを段階的にエスカレーションして、さまざまな条件下でのシステム動作を観察します。
障害シナリオとともに負荷テストを導入して、サービス停止中の実際の使用状況を再現します。カスケード障害の影響をテストします。たとえば、バックエンド サービスが利用できない場合のフロントエンド システムの動作をテストします。
構成の変更を検証し、人為的ミスに対するシステムの復元力を評価するには、構成ミスを伴うシナリオをテストします。たとえば、DNS フェイルオーバー設定が正しくない場合や、IAM 権限が正しくない場合にテストを実行します。
システム動作をモニタリングする
ロードバランサ、ヘルスチェック、その他のメカニズムがトラフィックを再ルーティングする方法をモニタリングします。Cloud Monitoring や Cloud Logging などの Google Cloud ツールを使用して、テスト中に指標とイベントをキャプチャします。
障害シミュレーション中とシミュレーション後に、レイテンシ、エラー率、スループットの変化を観察し、パフォーマンスへの全体的な影響をモニタリングします。ユーザー エクスペリエンスの低下や不整合を特定します。
サービス停止やフェイルオーバーなどの重要なイベントでログが生成され、アラートがトリガーされることを確認します。このデータを使用して、アラート システムとインシデント対応システムの有効性を検証します。
RTO と RPO に照らして復元を検証する
障害発生後にシステムが通常のオペレーションを再開するまでにかかる時間を測定し、このデータを定義済みの RTO と比較して、ギャップを文書化します。
データの完全性と可用性が RPO と一致していることを確認します。データベースの整合性をテストするには、障害発生前後のデータベースのスナップショットまたはバックアップを比較します。
サービスの復元を評価し、ユーザーへの影響を最小限に抑えながら、すべてのサービスが機能する状態に復元されていることを確認します。
結果を文書化して分析する
各テストステップ、障害シナリオ、対応するシステム動作を文書化します。詳細な分析のために、タイムスタンプ、ログ、指標を含めます。
テスト中に確認されたボトルネック、単一障害点、予期しない動作を強調します。修正の優先順位付けに役立つように、重大度と影響度で問題を分類します。
システム アーキテクチャ、フェイルオーバー メカニズム、モニタリング設定の改善を提案します。テスト結果に基づいて、関連するフェイルオーバー ポリシーとハンドブックを更新します。関係者に事後検証レポートを提示する。レポートには、結果、得られた教訓、次のステップを要約する必要があります。詳細については、徹底的な事後分析を実施するをご覧ください。
反復によって継続的に改善する
継続的な信頼性と復元力を検証するには、定期的なテスト(四半期ごとなど)を計画します。
インフラストラクチャの変更、ソフトウェア アップデート、トラフィック負荷の増加など、さまざまなシナリオでテストを実行します。
CI/CD パイプラインを使用して信頼性テストを開発ライフサイクルに統合し、フェイルオーバー テストを自動化します。
事後分析では、関係者やエンドユーザーからのフィードバックを使用して、テストプロセスとシステムの復元力を改善します。
データ損失からの復元のテストを行う
Google Cloud Well-Architected Framework の信頼性の柱におけるこの原則では、データ損失からの復旧テストを設計して実行するうえで役に立つ推奨事項が示されています。
この原則は、信頼性の学習の重点分野に関連しています。
原則の概要
データが失われたり破損したりした状況からシステムを復旧できるようにするには、それらのシナリオのテストを実行する必要があります。データの損失は、ソフトウェアのバグや自然災害によって発生することがあります。このようなイベントが発生した後は、バックアップからデータを復元し、新しく復元されたデータを使用してすべてのサービスを再度起動する必要があります。
このタイプの復元テストの成否を判断するには、データの完全性、目標復旧時間(RTO)、目標復旧時点(RPO)の 3 つの基準を使用することをおすすめします。RTO 指標と RPO 指標の詳細については、DR 計画の基本をご覧ください。
データ復元テストの目的は、組織がビジネス継続性の要件を引き続き満たせることを定期的に確認することです。RTO と RPO の測定に加えて、データ復元テストには、復元されたデータを使用したアプリケーション スタック全体とすべての重要インフラ サービスのテストを含める必要があります。これは、デプロイされたアプリケーション全体がテスト環境で正しく動作することを確認するために必要です。
推奨事項
データ損失からの復元のテストを設計して実行する場合は、次のサブセクションの推奨事項を検討してください。
バックアップの整合性を検証し、復元プロセスをテストする
バックアップに、アプリケーションをすぐに復元できる一貫性のある使用可能なデータのスナップショットが含まれていることを確認する必要があります。データの完全性を検証するには、各バックアップ後に実行される自動整合性チェックを設定します。
バックアップをテストするには、非本番環境で復元します。バックアップを効率的に復元し、復元されたデータがアプリケーションの要件を満たすようにするには、データ復旧シナリオを定期的にシミュレートします。データ復元の手順を文書化し、障害発生時に手順を効果的に実行できるようにチームをトレーニングします。
定期的かつ頻繁なバックアップをスケジュールする
復元中のデータ損失を最小限に抑え、RPO 目標を達成するには、定期的にスケジュールされたバックアップが不可欠です。RPO に合わせてバックアップの頻度を設定します。たとえば、RPO が 15 分の場合、バックアップを少なくとも 15 分ごとに実行するようにスケジュールします。バックアップ間隔を最適化して、データ損失のリスクを軽減します。
Cloud Storage、Cloud SQL の自動バックアップ、Spanner バックアップなどの Google Cloud ツールを使用して、バックアップのスケジュール設定と管理を行います。重要なアプリケーションの場合は、Cloud SQL のポイントインタイム リカバリ(PITR)や大規模なデータセットの増分バックアップなど、ほぼ継続的なバックアップ ソリューションを使用します。
RPO を定義してモニタリングする
ビジネスニーズに基づいて明確な RPO を設定し、RPO の遵守をモニタリングします。バックアップ間隔が定義された RPO を超える場合は、Cloud Monitoring を使用してアラートを設定します。
バックアップの健全性をモニタリングする
Google Cloud Backup and DR サービスまたは同様のツールを使用して、バックアップの健全性を追跡し、バックアップが安全で信頼性の高い場所に保存されていることを確認します。復元性を強化するために、バックアップが複数のリージョンに複製されるようにします。
バックアップ以外のシナリオを計画する
バックアップを、アクティブ / アクティブ フェイルオーバー設定やクロスリージョン レプリケーションなどの障害復旧戦略と組み合わせることで、極端なケースでの復旧時間を短縮します。詳細については、災害復旧計画ガイドをご覧ください。
徹底的な事後検証を実施する
Google Cloud Well-Architected Framework の信頼性の柱におけるこの原則では、障害やインシデントの後に効果的な事後検証を実施するうえで役に立つ推奨事項が示されています。
この原則は、信頼性の学習の重点分野に関連しています。
原則の概要
事後検証は、インシデント、その影響、インシデントを軽減または解決するために講じた措置、根本原因、インシデントの再発を防ぐためのフォローアップ措置に関する書面による記録です。事後検証の目的は、失敗から学ぶことであり、責任を追及することではありません。
次の図は、ポストモーテムのワークフローを示しています。
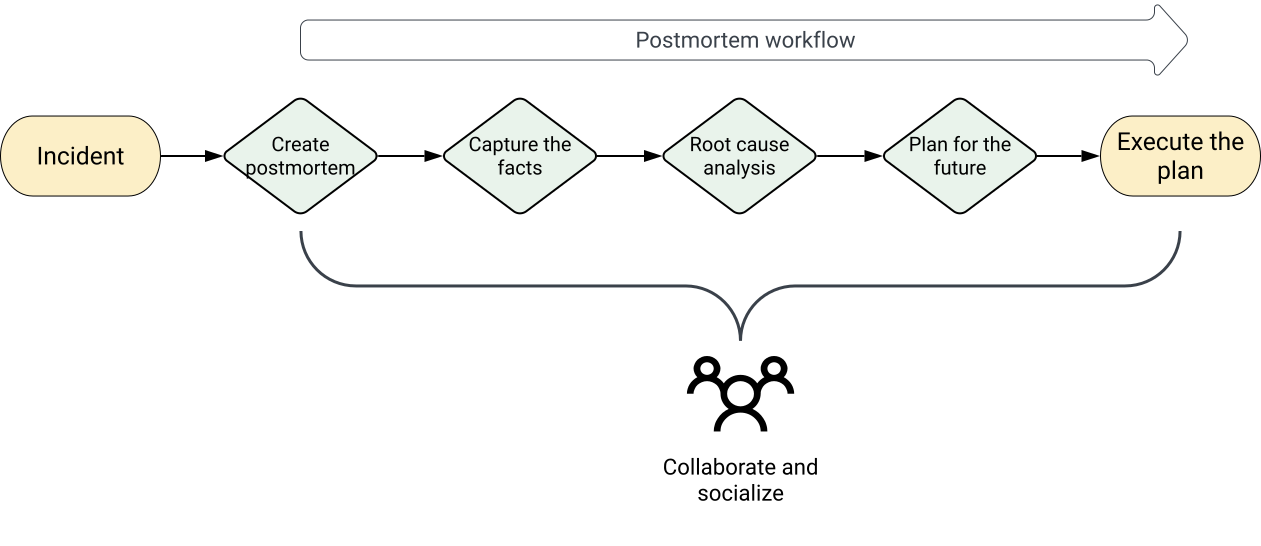
ポストモーテムのワークフローには、次のステップが含まれます。
- ポストモーテムを作成する
- 事実を把握する
- 根本原因を特定して分析する
- 将来を見据えて計画を立てる
- 計画を実行する
次のような重大なイベントと重大でないイベントの後に事後分析を実施します。
- ユーザーが認識できるダウンタイムまたはパフォーマンスの低下が、特定のしきい値を超えている。
- あらゆる種類のデータ損失。
- リリースのロールバックやトラフィックの再ルーティングなど、オンコール エンジニアによる介入。
- 定義されたしきい値を超える解決時間。
- モニタリングの失敗。通常、インシデントの手動検出を意味します。
推奨事項
インシデントが発生する前に事後検証の基準を定義して、事後検証が必要なタイミングを全員が把握できるようにします。
効果的な事後検証を行うには、次のサブセクションの推奨事項を検討してください。
過失を責めない事後検証を実施する
効果的なポストモーテムは、プロセス、ツール、テクノロジーに焦点を当て、個人やチームを非難しません。事後分析の目的は、技術と将来を改善することであり、誰が有罪かを見つけることではありません。誰にでも間違いはあります。目標は、ミスを分析し、そこから学ぶことです。
次の例は、責任を追及するフィードバックと、責任を追及しないフィードバックの違いを示しています。
- 責任を追及するフィードバック: 「複雑なバックエンド システム全体を書き直す必要があります。過去 3 四半期にわたって毎週のように不具合が発生しており、皆さん、その都度修正することにうんざりしていると思います。本当に、もう一度ページングされたら、自分で書き直します…」
- 非難のないフィードバック: 「バックエンド システム全体を書き換えるアクション アイテムにより、これらのページが引き続き発生するのを防ぐことができます。このバージョンのメンテナンス マニュアルは非常に長く、完全に習得するのは困難です。将来のオンコール エンジニアも、きっと私たちに感謝してくれるでしょう。」
事後検証レポートを対象者全員が読めるようにする
レポートに含める予定の各情報について、その情報が重要であり、何が起こったかをオーディエンスが理解するのに役立つかどうかを評価します。補足データや説明は、レポートの付録に移動できます。審査担当者は、必要に応じて追加情報をリクエストできます。
複雑なソリューションや過剰なエンジニアリングは避ける
問題の解決策を検討する前に、問題の重要性と再発の可能性を評価します。再発する可能性が低い問題を解決するためにシステムを複雑にすると、不安定性が増す可能性があります。
事後検証を可能な限り広く共有する
問題が未解決のままにならないように、ポストモーテムの結果を幅広い対象者に公開し、経営陣のサポートを得ます。事後検証の価値は、事後検証後に発生する学習に比例します。インシデントから学ぶ人が増えるほど、同様の障害が再発する可能性は低くなります。