


エンタープライズ データ マネジメントおよび分析プラットフォームは、セキュリティ管理を維持しながら機密情報を保存、分析、操作できるエンクレーブを提供します。エンタープライズ データメッシュ アーキテクチャを使用して、データ マネジメントと分析用のプラットフォームを Google Cloud にデプロイできます。このアーキテクチャは、 Google Cloud コンポーネントが既存のオンプレミス コンポーネントや運用プロセスとやり取りするハイブリッド環境で動作するように設計されています。
エンタープライズ データメッシュ アーキテクチャには、次のものが含まれます。
- 以下を構築するための一連の Terraform 構成、スクリプト、コードを含む GitHub リポジトリ。
- Google の Cloud Data Management Capabilities(CDMS)キー コントロール フレームワークの実装を使用できるガバナンス プロジェクト。
- インタラクティブなワークフローと本番環境ワークフローをサポートするデータ プラットフォームの例。
- 複数のデータドメインをサポートするデータ プラットフォーム内のプロデューサー環境。データドメインは、データ要素の論理グループです。
- 複数のコンシューマー プロジェクトをサポートするデータ プラットフォーム内のコンシューマー環境。
- Workload Identity 連携と Tink 暗号化ライブラリを使用して、データを Google Cloud に安全に転送するデータ転送サービス。
- 取り込みプロジェクト、非機密プロジェクト、機密プロジェクトを含むデータドメインの例。
- データアクセス システムの例。データ コンシューマーがデータセットへのアクセスをリクエストし、データオーナーがそれらのデータセットへのアクセスを許可できるようにします。この例には、それらのデータセットの IAM 権限を適宜変更するワークフロー マネージャーも含まれています。
- このアーキテクチャを使用して実装するアーキテクチャ、設計、セキュリティ管理、運用プロセスのガイド(このドキュメント)。
エンタープライズ データメッシュ アーキテクチャは、エンタープライズ基盤ブループリントとの互換性を確保できるように設計されています。エンタープライズ基盤ブループリントは、VPC ネットワークやロギングなど、このアーキテクチャが利用する多くの基本的サービスを提供します。Google Cloud 環境に必要な機能が備わっている場合は、エンタープライズ基盤ブループリントをデプロイせずに、このアーキテクチャをデプロイできます。
このドキュメントは、このアーキテクチャを使用して Google Cloudで包括的なデータサービスを構築してデプロイできるクラウド アーキテクト、データ サイエンティスト、データ エンジニア、セキュリティ アーキテクトを対象としています。このドキュメントは、データメッシュ、 Google Cloudデータサービス、 Google Cloud CDMC フレームワークの実装のコンセプトを理解していることを前提としています。
アーキテクチャ
エンタープライズ データメッシュ アーキテクチャは、データの取り込み、データ処理、ガバナンスを可能にする機能を提供するために、階層型のアプローチを採用しています。このアーキテクチャは、CI/CD ワークフローを通じてデプロイ、制御することを前提としています。次の図は、このアーキテクチャによってデプロイされたデータレイヤが環境内の他のレイヤとどのように関連しているかを示しています。
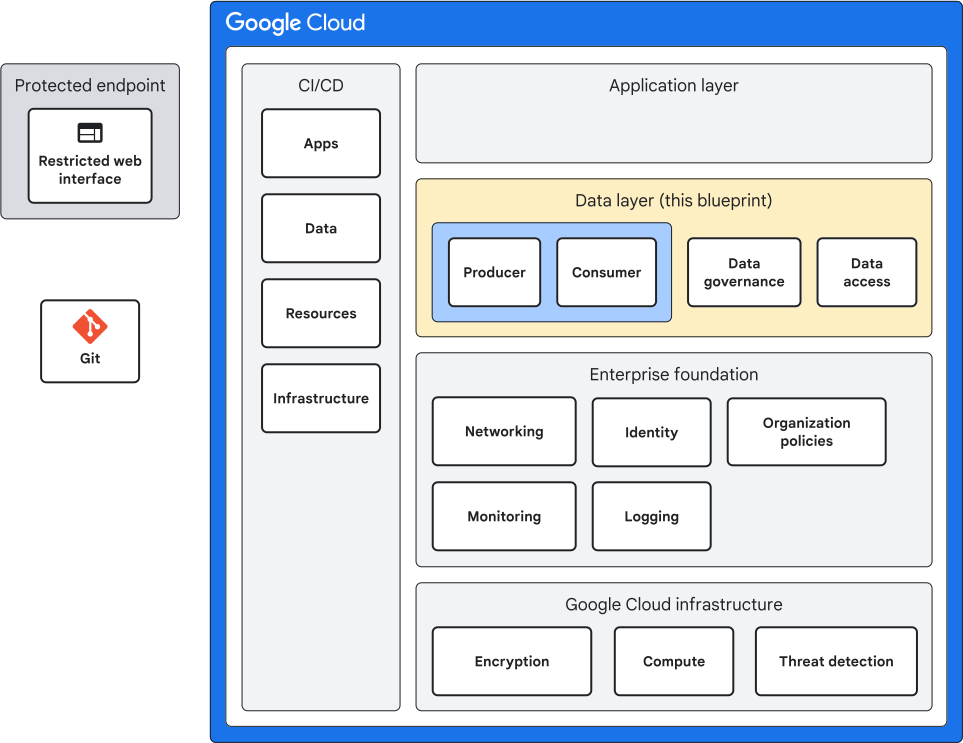
この図には次のものが含まれています。
- Google Cloud インフラストラクチャは、保存データの暗号化や転送中データの暗号化などのセキュリティ機能とともに、コンピューティングやストレージなどの基本的な構成要素を備えています。
- エンタープライズ基盤は、ID、ネットワーキング、ロギング、モニタリング、デプロイ システムといった、データ ワークロードに Google Cloud を導入するための一連の基本リソースを備えています。
- データレイヤは、データの取り込み、データストア、データアクセス制御、データ ガバナンス、データ モニタリング、データ共有などのさまざまな機能を提供します。
- アプリケーション レイヤは、データレイヤのアセットを使用するさまざまなアプリケーションを表します。
- CI/CD には、インフラストラクチャ、ワークフロー、ソフトウェア コンポーネントのプロビジョニング、構成、管理、デプロイを自動化するツールが用意されています。これらのコンポーネントにより、デプロイの一貫性、信頼性、監査可能性を保証し、手作業による誤りを最小限に抑えて、全体的な開発サイクルを加速できます。
データ環境の使用方法を示すために、アーキテクチャにはサンプルのデータ ワークフローが含まれています。サンプルデータ ワークフローでは、データ ガバナンス、データの取り込み、データ処理、データ共有、データ消費のプロセスについて説明します。
アーキテクチャに関する重要な決定事項
次の表に、アーキテクチャの概要を示します。
| 決定分野 | 決定 |
|---|---|
| Google Cloud アーキテクチャ | |
リソース階層 |
このアーキテクチャでは、エンタープライズ基盤ブループリントのリソース階層を使用します。 |
ネットワーキング |
このアーキテクチャには、Workload Identity 連携と Tink ライブラリを使用するデータ転送サービスの例が含まれています。 |
ロールと IAM 権限 |
このアーキテクチャには、セグメント化されたデータ プロデューサー ロール、データ コンシューマー ロール、データ ガバナンス ロール、データ プラットフォーム ロールが含まれています。 |
| 共通データサービス | |
メタデータ |
このアーキテクチャでは、Knowledge Catalog を使用してデータ メタデータを管理します。 |
ポリシーの一元管理 |
ポリシーを管理するために、このアーキテクチャでは Google Cloudの CDMC フレームワークの実装を使用します。 |
データアクセス管理 |
データへのアクセスを制御するため、アーキテクチャには、データ利用者がデータオーナーにデータアセットへのアクセスをリクエストする必要がある独立したプロセスが含まれています。 |
データ品質 |
このアーキテクチャでは、Cloud Data Quality Engine を使用して、指定されたテーブル列のデータ品質ルールを定義して実行し、正確性や完全性などの指標に基づいてデータ品質を測定します。 |
データ セキュリティ |
このアーキテクチャでは、タグ付け、暗号化、マスキング、トークン化、IAM 制御を使用してデータ セキュリティを実現します。 |
| データドメイン | |
データ環境 |
このアーキテクチャには 3 つの環境が含まれています。2 つの環境(非本番環境と本番環境)は、パイプラインによって駆動される運用環境です。1 つの環境(開発)はインタラクティブな環境です。 |
データオーナー |
データオーナーは、データアセットを取り込み、処理、公開し、アクセス権を付与します。 |
データ コンシューマ |
データ コンシューマーがデータアセットへのアクセスをリクエストします。 |
| オンボーディングとオペレーション | |
パイプライン |
このアーキテクチャでは、次のパイプラインを使用してリソースをデプロイします。
|
リポジトリ |
各パイプラインは個別のリポジトリを使用して、責任の分離を可能にします。 |
プロセスの流れ |
このプロセスでは、本番環境への変更に、送信者と承認者を含める必要があります。 |
| クラウド オペレーション | |
データ プロダクト スコアカード |
レポート エンジンは、データ プロダクトのスコアカードを生成します。 |
Cloud Logging |
このアーキテクチャでは、エンタープライズ基盤ブループリントのロギング インフラストラクチャを使用します。 |
Cloud Monitoring |
このアーキテクチャでは、エンタープライズ基盤ブループリントのモニタリング インフラストラクチャを使用します。 |
ID: ロールをグループにマッピングする
データメッシュは、エンタープライズ基盤ブループリントの既存の ID ライフサイクル管理、認可、認証アーキテクチャを活用します。ユーザーにはロールが直接割り当てられません。代わりに、グループが IAM でロールと権限を割り当てる主な方法となります。IAM のロールと権限は、基盤パイプラインでプロジェクトの作成時に割り当てられます。
データメッシュは、グループを 4 つの主要な領域(インフラストラクチャ、データ ガバナンス、ドメインベースのデータ プロデューサー、ドメインベースのコンシューマー)のいずれかに関連付けます。
これらのグループの権限スコープは次のとおりです。
- インフラストラクチャ グループの権限スコープは、データメッシュ全体です。
- データ ガバナンス グループの権限スコープは、データ ガバナンス プロジェクトです。
- ドメインベースのプロデューサーとコンシューマーの権限は、データドメインにスコープされます。
次の表に、このデータメッシュの実装で使用されるさまざまなロールと、それに関連する権限を示します。
インフラストラクチャ
| グループ | 説明 | ロール |
|---|---|---|
|
データメッシュの全体的な管理者 |
|
データ ガバナンス
| グループ | 説明 | ロール |
|---|---|---|
|
データ ガバナンス プロジェクトの管理者 |
データ ガバナンス プロジェクトに対する |
|
データ ガバナンス コンポーネントを構築して管理するデベロッパー |
データ ガバナンス プロジェクトに対する複数のロール( |
|
データ ガバナンス情報の閲覧者 |
|
|
ガバナンス プロジェクトのセキュリティ管理者 |
|
|
アスペクト タイプを使用する権限を持つグループ |
|
|
アスペクト タイプを使用し、アスペクトを追加する権限を持つグループ |
|
|
Security Command Center の通知用のサービス アカウント グループ |
なし。これはメンバーシップ用のグループです。この名前でサービス アカウントが作成され、必要な権限が付与されます。 |
ドメインベースのデータ プロデューサー
| グループ | 説明 | ロール |
|---|---|---|
|
特定のデータドメインの管理者 |
データドメイン プロジェクトに対する |
|
データドメイン内でデータ プロダクトを構築して管理するデベロッパー |
データドメイン プロジェクトに対する複数のロール( |
|
データドメイン情報の閲覧者 |
|
|
Knowledge Catalog エントリの編集者 |
Knowledge Catalog エントリを編集するロール |
|
データドメインのデータ スチュワード |
メタデータとデータ ガバナンスのアスペクトを管理するロール |
ドメインベースのデータ コンシューマ
| グループ | 説明 | ロール |
|---|---|---|
|
特定のコンシューマー プロジェクトの管理者 |
コンシューマー プロジェクトに対する |
|
コンシューマー プロジェクト内で作業するデベロッパー |
コンシューマー プロジェクトに対する複数のロール( |
|
コンシューマー プロジェクト情報の読み取り権限 |
|
組織構造
本番環境のオペレーションと商品データを区別するために、このアーキテクチャでは、ワークフローの開発とリリースに異なる環境を使用します。本番環境のオペレーションには、ワークフローのガバナンス、トレーサビリティ、再現性、ワークフローの結果の監査可能性が含まれます。本番環境データとは、組織の運営に必要な機密データのことです。すべての環境は、データの取り込みと操作を可能にするセキュリティ管理を備えるように設計されています。
データ サイエンティストとエンジニアを支援するため、このアーキテクチャにはインタラクティブ環境が含まれています。デベロッパーは、この環境を直接操作し、厳選されたソリューション カタログからサービスを追加できます。運用環境は、アーキテクチャと構成がコード化されたパイプラインを介して運用されます。
このアーキテクチャでは、データ ワークロードのデプロイのための基盤として、エンタープライズ基盤ブループリントの組織構造を使用します。次の図は、エンタープライズ データメッシュ アーキテクチャで使用される最上位のフォルダとプロジェクトを示しています。
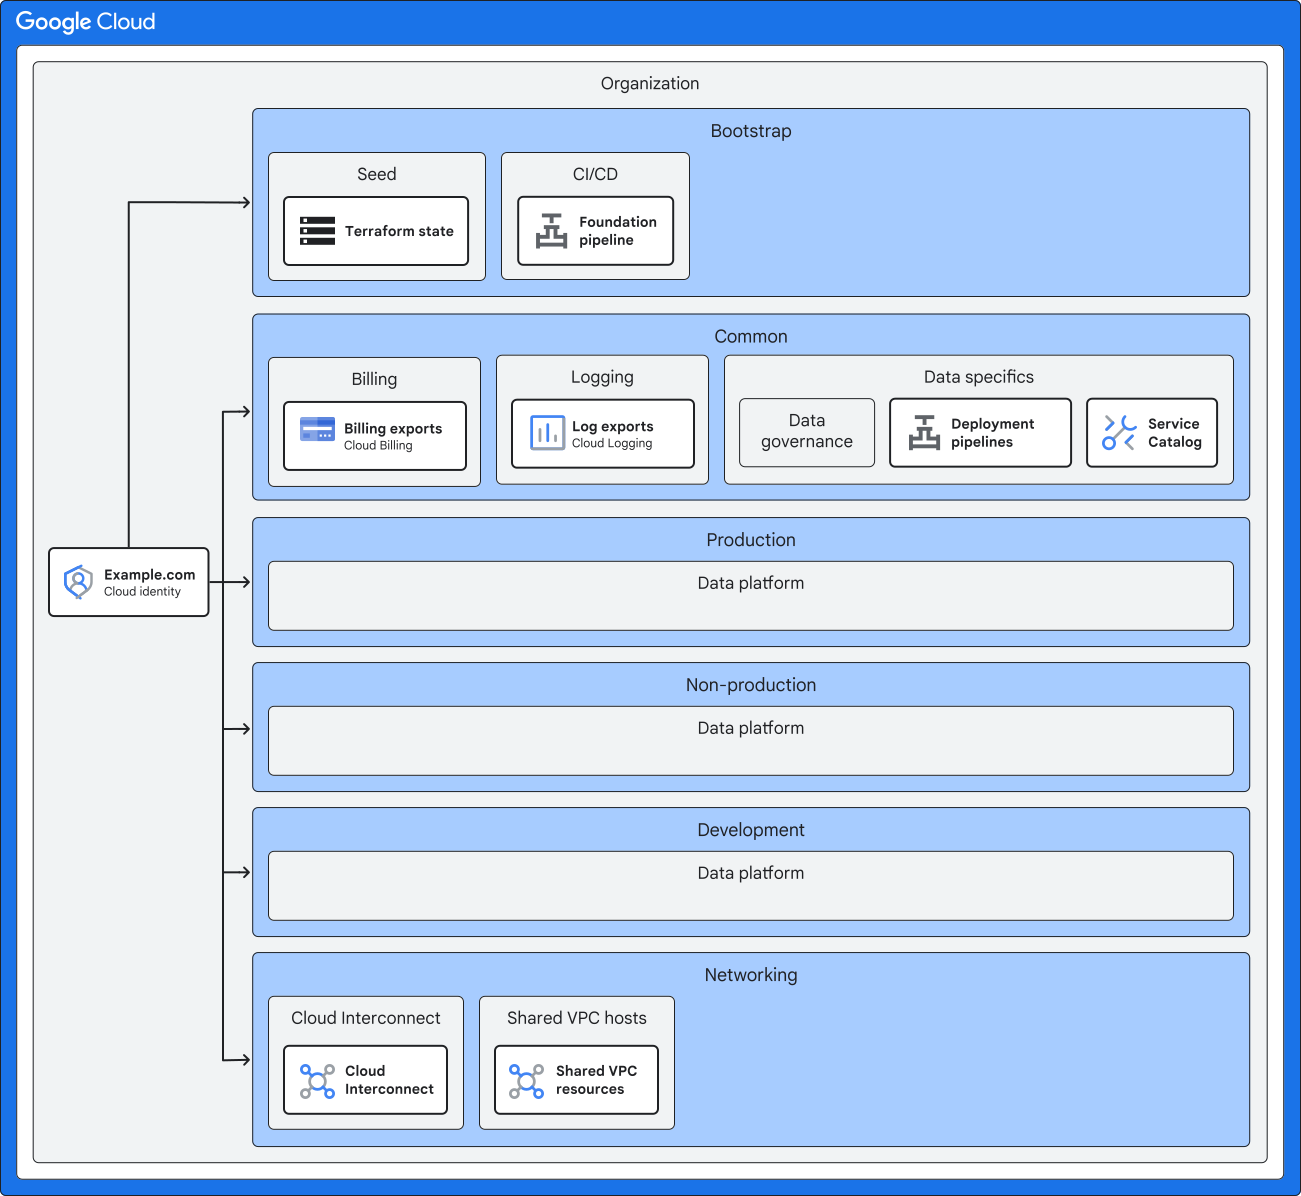
次の表に、アーキテクチャの一部である最上位のフォルダとプロジェクトを示します。
| フォルダ | コンポーネント | 説明 |
|---|---|---|
|
|
アーキテクチャのコード アーティファクトの構築に使用されるデプロイ パイプラインが含まれています。 |
|
インタラクティブ環境にリソースをデプロイするためにサービス カタログで使用されるインフラストラクチャが含まれています。 |
|
|
Google Cloudの CDMC フレームワークの実装で使用されるすべてのリソースが含まれます。 |
|
|
|
インタラクティブ モードでユースケースを開発するためのデータ プラットフォームのプロジェクトとリソースが含まれます。 |
|
|
運用環境にデプロイするユースケースをテストするためのデータ プラットフォームのプロジェクトとリソースが含まれます。 |
|
|
本番環境にデプロイするデータ プラットフォームのプロジェクトとリソースが含まれます。 |
データ プラットフォーム フォルダ
データ プラットフォーム フォルダには、すべてのデータプレーン コンポーネントと一部の CDMC リソースが含まれています。また、データ プラットフォーム フォルダとデータ ガバナンス プロジェクトには、CDMC リソースが含まれています。次の図は、データ プラットフォーム フォルダにデプロイされるフォルダとプロジェクトを示しています。
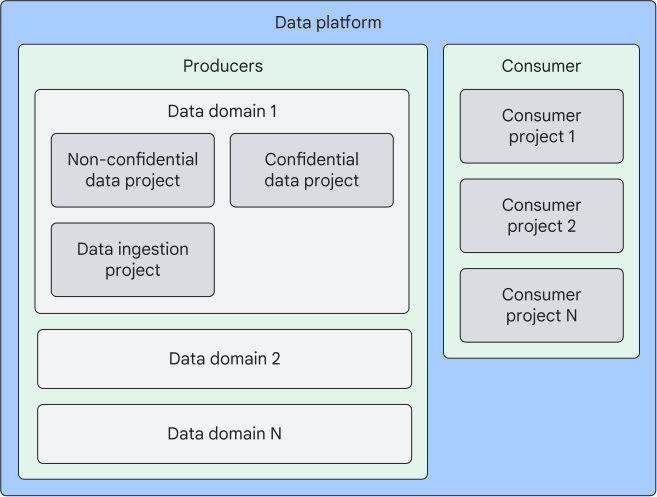
各データ プラットフォーム フォルダには、環境フォルダ(本番環境、非本番環境、開発環境)が含まれています。次の表に、各データ プラットフォーム フォルダ内のフォルダを示します。
| フォルダ | 説明 |
|---|---|
Producers |
データドメインが含まれます。 |
一般ユーザー |
コンシューマー プロジェクトが含まれています。 |
データドメイン |
特定のドメインに関連付けられたプロジェクトが含まれます。 |
Producers フォルダ
各プロデューサー フォルダには、1 つ以上のデータドメインが含まれます。データドメインとは、共通の意味、目的、ビジネス コンテキストを共有するデータ要素の論理的なグループを指します。データドメインを使用すると、組織内のデータアセットを分類して整理できます。次の図は、データドメインの構造を示しています。このアーキテクチャでは、各環境のデータ プラットフォーム フォルダにプロジェクトをデプロイします。
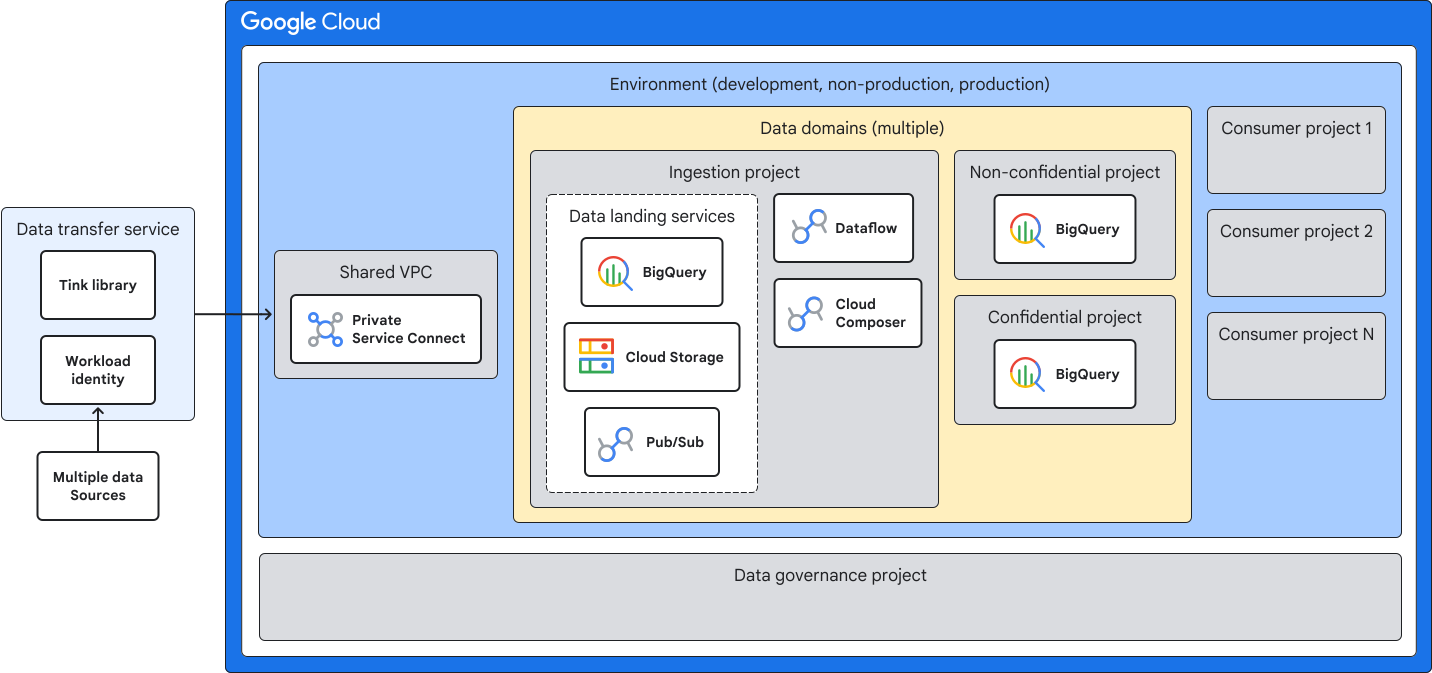
次の表に、各環境のデータ プラットフォーム フォルダにデプロイされるプロジェクトを示します。
| プロジェクト | 説明 |
|---|---|
取り込み |
取り込みプロジェクトは、データドメインにデータを取り込みます。このアーキテクチャでは、BigQuery、Cloud Storage、Pub/Sub にデータをストリーミングする方法の例を示します。取り込みプロジェクトには、取り込まれたデータの変換と移動をオーケストレートするために使用できる Dataflow と Managed Service for Apache Airflow の例も含まれています。 |
機密情報以外 |
機密ではないプロジェクトには、匿名化されたデータが含まれています。データのマスキング、コンテナ化、暗号化、トークン化、難読化を行うことができます。ポリシータグを使用して、データの表示方法を制御します。 |
機密 |
機密プロジェクトには、平文データが含まれています。アクセスは IAM 権限で制御できます。 |
コンシューマー フォルダ
コンシューマー フォルダには、コンシューマー プロジェクトが含まれています。コンシューマ プロジェクトは、必要な信頼境界に基づいてデータユーザーをセグメント化するメカニズムを提供します。各プロジェクトは個別のユーザー グループに割り当てられ、グループにはプロジェクトごとに必要なデータアセットへのアクセス権が割り当てられます。コンシューマー プロジェクトを使用して、グループのデータを収集、分析、拡張できます。
共通フォルダ
共通フォルダには、さまざまな環境やプロジェクトで使用されるサービスが含まれています。このセクションでは、エンタープライズ データメッシュを有効にするために共通フォルダに追加される機能について説明します。
CDMC アーキテクチャ
このアーキテクチャでは、データ ガバナンスに CDMC アーキテクチャを使用します。データ ガバナンス機能は、共通フォルダのデータ ガバナンス プロジェクトにあります。次の図は、CDMC アーキテクチャのコンポーネントを示しています。図中の番号は、 Google Cloudサービスが対応しているキー コントロールを表しています。
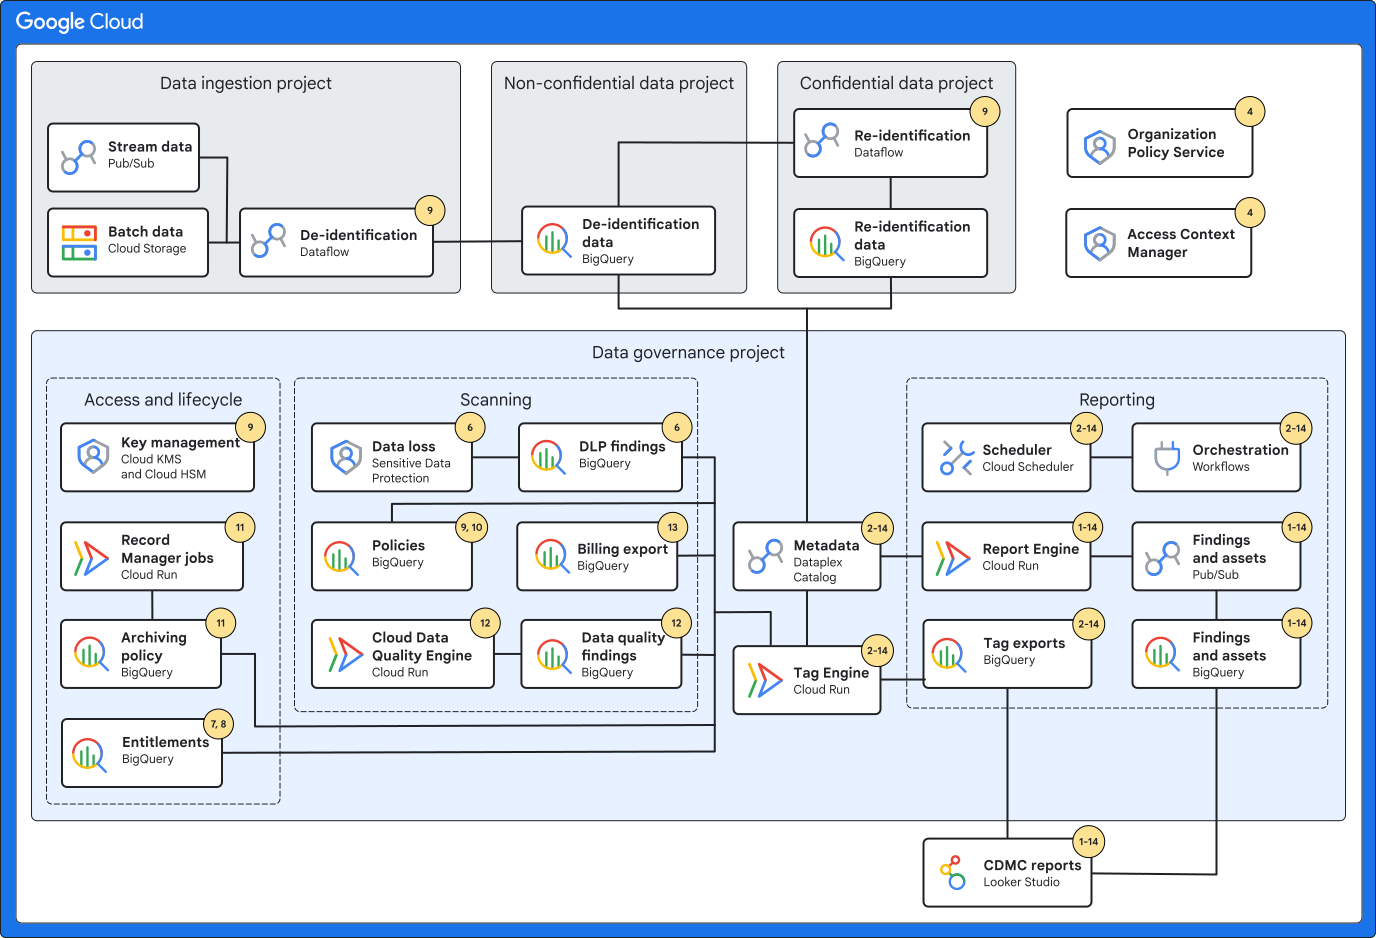
次の表に、エンタープライズ データメッシュ アーキテクチャで使用される CDMC アーキテクチャのコンポーネントを示します。
| CDMC コンポーネント | Google Cloud サービス | 説明 |
|---|---|---|
| アクセスとライフサイクル コンポーネント | ||
鍵管理 |
Cloud KMS |
機密データを保護する暗号鍵を安全に管理するサービス。 |
レコード マネージャー |
Cloud Run |
データ処理アクティビティの包括的なログと記録を保持し、組織がデータの使用状況を追跡して監査できるようにするアプリケーション。 |
アーカイブ ポリシー |
BigQuery |
データのストレージ ポリシーを含む BigQuery テーブル。 |
利用資格 |
BigQuery |
機密データにアクセスできるユーザーに関する情報を保存する BigQuery テーブル。このテーブルにより、ロールと権限に基づいて、承認されたユーザーのみが特定のデータにアクセスできるようになります。 |
| スキャン コンポーネント | ||
データ損失 |
Sensitive Data Protection |
アセットの機密データを検査するために使用されるサービス。 |
DLP の検出結果 |
BigQuery |
データ プラットフォーム内のデータ分類をカタログ化する BigQuery テーブル。 |
ポリシー |
BigQuery |
一貫したデータ ガバナンス プラクティス(データアクセス タイプなど)を含む BigQuery テーブル。 |
課金データのエクスポート |
BigQuery |
Cloud Billing からエクスポートされた費用情報を格納するテーブル。データアセットに関連付けられた費用指標の分析を可能にします。 |
Cloud Data Quality Engine |
Cloud Run |
テーブルと列のデータ品質チェックを実行するアプリケーション。 |
データ品質の検出結果 |
BigQuery |
定義されたデータ品質ルールとデータアセットの実際の品質との間で特定された不一致を記録する BigQuery テーブル。 |
| レポート コンポーネント | ||
スケジューラ |
Cloud Scheduler |
Cloud Data Quality Engine の実行タイミングと、Sensitive Data Protection の検査のタイミングを制御するサービス。 |
レポート エンジン |
Cloud Run |
CDMC フレームワークのコントロールへの準拠を追跡、測定するのに役立つレポートを生成するアプリケーション。 |
検出結果とアセット |
BigQuery と Pub/Sub |
データ マネジメント管理の不一致または不整合(欠落している側面、不適切な分類、コンプライアンスに準拠していないストレージ ロケーションなど)に関する BigQuery レポート。 |
タグのエクスポート |
BigQuery |
Knowledge Catalog から抽出されたアスペクト情報を含む BigQuery テーブル。 |
| その他のコンポーネント | ||
ポリシー管理 |
組織ポリシー サービス |
データを地理的に保存できる場所に関する制限を定義して適用するサービス。 |
属性ベースのアクセス ポリシー |
Access Context Manager |
属性ベースの詳細なアクセス ポリシーを定義して適用し、許可された場所とデバイスから承認されたユーザーのみが機密情報にアクセスできるようにするサービス。 |
メタデータ |
Knowledge Catalog |
データメッシュで使用されているテーブルに関するメタデータ情報を保存するサービス。 |
Engine のタグ設定 |
Cloud Run |
Knowledge Catalog の BigQuery テーブル エントリにアスペクトを追加するアプリケーション。 |
CDMC レポート |
データポータル |
アナリストが CDMC アーキテクチャ エンジンによって生成されたレポートを表示できるダッシュボード。 |
CDMC の実装
次の表に、このアーキテクチャが CDMC フレームワークのキー コントロールを実装する方法を示します。
| CDMC コントロール要件 | 実装 |
|---|---|
Report Engine は、非準拠のデータアセットを検出し、検出結果を Pub/Sub トピックにパブリッシュします。これらの検出結果は、データポータルを使用したレポート作成のために BigQuery にも読み込まれます。 |
|
Knowledge Catalog は、BigQuery から技術メタデータを自動的にキャプチャします。Tag Engine は、参照テーブルからオーナー名や機密レベルなどのビジネス メタデータ アスペクトを適用します。これにより、コンプライアンスのために、すべての機密データにオーナー情報がアノテーションされます。この自動化されたプロセスにより、機密データを特定し、適切なオーナー情報でラベル付けすることで、データ ガバナンスとコンプライアンスを確保できます。 |
|
Knowledge Catalog は、信頼できるソースである場合に |
|
組織ポリシー サービスは、データアセットに許可されるストレージ リージョンを定義し、Access Context Manager はユーザーのロケーションに基づいてアクセスを制限します。Knowledge Catalog は、承認されたストレージのロケーションをメタデータ アスペクトとして保存します。Report Engine は、これらの側面を BigQuery のデータアセットの実際のロケーションと比較し、不一致を Pub/Sub を使用して検出結果として公開します。Security Command Center は、定義されたポリシーの外部でデータが保存またはアクセスされた場合に脆弱性の検出結果を生成することで、追加のモニタリング レイヤを提供します。 |
|
Knowledge Catalog は、すべての BigQuery データアセットの技術メタデータを保存して更新し、継続的に同期される Data Catalog を効果的に作成します。Knowledge Catalog は、新しいテーブルやビュー、変更されたテーブルやビューがすぐにカタログに追加されるようにし、データアセットの最新のインベントリを維持します。 |
|
Sensitive Data Protection は、BigQuery データを検査し、機密情報の種類を特定します。これらの検出結果は、分類参照テーブルに基づいてランク付けされ、最も高い機密レベルが列レベルとテーブルレベルで Knowledge Catalog のアスペクトとして割り当てられます。Tag Engine は、新しいデータアセットが追加されるか、既存のデータアセットが変更されるたびに、機密性の側面で Knowledge Catalog を更新することで、このプロセスを管理します。このプロセスにより、機密性に基づいてデータの分類が常に更新されます。これは、Pub/Sub と統合されたレポートツールを使用してモニタリングおよびレポートできます。 |
|
BigQuery のポリシータグは、列レベルで機密データへのアクセスを制御し、割り当てられたポリシータグに基づいて、承認されたユーザーのみが特定のデータにアクセスできるようにします。IAM はデータ ウェアハウスへの全体的なアクセスを管理し、Knowledge Catalog は機密性分類を保存します。すべての機密データに対応するポリシータグがあることを確認するために定期的なチェックが実行され、不一致があれば Pub/Sub を使用して報告され、修正されます。 |
|
プロバイダと利用者の両方のデータ共有に関する合意事項は、専用の BigQuery データ ウェアハウスに保存され、利用目的を制御します。Knowledge Catalog は、プロバイダの契約情報を使用してデータアセットにラベルを付けます。一方、コンシューマー契約は、アクセス制御のために IAM バインディングにリンクされます。クエリラベルは利用目的を適用します。利用者が機密データをクエリするときに有効な目的を指定する必要があります。この目的は、BigQuery の利用資格に照らして検証されます。BigQuery の監査証跡は、すべてのデータアクセスを追跡し、データ共有に関する合意事項の遵守を保証します。 |
|
Google のデフォルトの保存データの暗号化は、ディスクに保存されているデータを保護するのに役立ちます。Cloud KMS は、鍵管理を強化するために顧客管理の暗号鍵(CMEK)をサポートしています。BigQuery は、匿名化のために列レベルの動的データ マスキングを実装し、データの取り込み時にアプリケーション レベルの匿名化をサポートします。Knowledge Catalog には、データアセットに適用される暗号化と匿名化の手法のメタデータ アスペクトが保存されます。自動チェックにより、暗号化と匿名化の方法が事前定義されたセキュリティ ポリシーに沿っていることが確認され、不一致は Pub/Sub を使用して検出結果として報告されます。 |
|
Knowledge Catalog は、影響評価に関連する情報(サブジェクトの場所や評価レポートのリンクなど)を含むアスペクトを使用して、機密データアセットにアノテーションを付けます。Tag Engine は、データの機密性と BigQuery のポリシー テーブルに基づいてこれらのアスペクトを適用します。このテーブルでは、データとサブジェクトの所在地に基づいて評価要件が定義されています。この自動化されたプロセスにより、影響評価要件の遵守状況を継続的にモニタリングして報告できるため、必要に応じてデータ保護影響評価(DPIA)または保護影響評価(PIA)を実施できます。 |
|
Knowledge Catalog は、保持ポリシーを使用してデータアセットにラベルを付け、保持期間と有効期限アクション(アーカイブやパージなど)を指定します。Record Manager は、定義されたアスペクトに基づいて BigQuery テーブルをパージまたはアーカイブすることで、これらのポリシーの適用を自動化します。この適用により、データ ライフサイクル ポリシーの遵守が保証され、データ保持要件のコンプライアンスが維持されます。不一致が検出されると、Pub/Sub を使用して報告されます。 |
|
Cloud Data Quality Engine は、指定されたテーブル列に対してデータ品質ルールを定義して実行し、正確性や完全性などの指標に基づいてデータ品質を測定します。これらのチェックの結果(成功率やしきい値など)は、Knowledge Catalog にアスペクトとして保存されます。これらの結果を保存することで、データ品質の継続的なモニタリングとレポートが可能になります。問題や許容可能なしきい値からの逸脱は、Pub/Sub を使用して検出結果として公開されます。 |
|
Knowledge Catalog には、データアセットの費用関連の指標(クエリ費用、ストレージ費用、データ下り(外向き)費用など)が保存されます。これらの指標は、Cloud Billing から BigQuery にエクスポートされたお支払い情報を使用して計算されます。費用関連の指標を保存すると、包括的な費用の追跡と分析が可能になり、費用ポリシーの遵守と効率的なリソース使用が実現します。異常は Pub/Sub を使用して報告されます。 |
|
Knowledge Catalog の組み込みのデータリネージ機能は、データアセットの来歴とリネージを追跡し、データのフローを視覚的に表します。さらに、データの取り込みスクリプトは、データの元のソースを特定し、Knowledge Catalog のアスペクトとして記録します。これにより、データの元のソースへのトレーサビリティが向上します。 |
データアクセス管理
このアーキテクチャのデータへのアクセスは、運用管理(Dataflow ジョブの実行など)をデータアクセス制御から分離する独立したプロセスによって制御されます。ユーザーの Google Cloud サービスへのアクセスは、環境または運用上の懸念事項によって定義され、クラウド エンジニアリング グループによってプロビジョニングおよび承認されます。ユーザーが Google Cloud データアセット(BigQuery テーブルなど)にアクセスすることは、プライバシー、規制、ガバナンスに関する懸念事項であり、プロデューサーとコンシューマー間のアクセス契約の対象となります。また、次のプロセスによって制御されます。次の図は、さまざまなソフトウェア コンポーネントの相互作用によってデータアクセスがプロビジョニングされる仕組みを示しています。
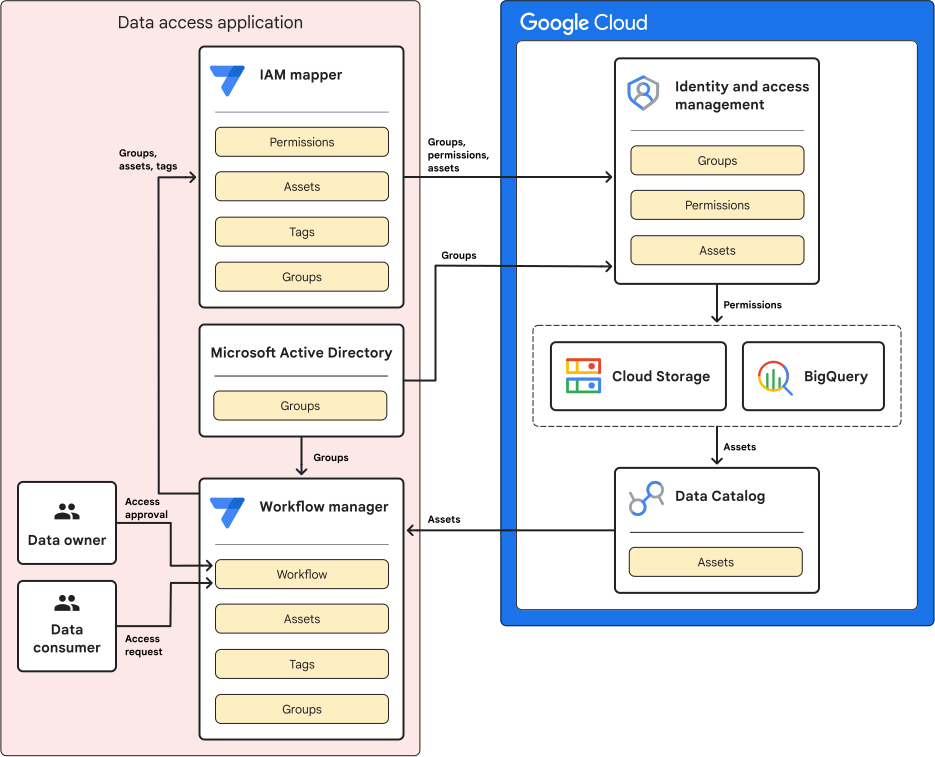
上の図に示すように、データアクセスのオンボーディングは次のプロセスで処理されます。
- クラウドデータ アセットは、Knowledge Catalog によって収集され、インベントリに登録されます。
- ワークフロー マネージャーは、Knowledge Catalog からデータアセットを取得します。
- データオーナーがワークフロー マネージャーにオンボーディングされている。
データアクセス管理のオペレーションは次のとおりです。
- データ コンシューマーが特定のアセットをリクエストします。
- アセットのデータオーナーにリクエストが通知されます。
- データオーナーがリクエストを承認または拒否します。
- リクエストが承認されると、ワークフロー マネージャーはグループ、アセット、関連付けられたタグを IAM マッパーに渡します。
- IAM マッパーは、ワークフロー マネージャーのタグを IAM 権限に変換し、指定されたグループにデータアセットの IAM 権限を付与します。
- ユーザーがデータアセットにアクセスしようとすると、IAM はグループの権限に基づいて Google Cloud アセットへのアクセスを評価します。
- 許可された場合、ユーザーはデータアセットにアクセスします。
ネットワーキング
データ セキュリティ プロセスは、ソース アプリケーションで開始されます。ソース アプリケーションは、オンプレミスまたはターゲットGoogle Cloud プロジェクトの外部の別の環境に存在する場合があります。ネットワーク転送が行われる前に、このアプリケーションは Workload Identity 連携を使用して Google Cloud APIs に対する認証を安全に行います。これらの認証情報を使用して Cloud KMS とやり取りし、必要な鍵を取得またはラップします。その後、Tink ライブラリを使用して、事前定義されたテンプレートに従って機密データ ペイロードの初期暗号化と匿名化を行います。
データ ペイロードが保護されたら、ペイロードを Google Cloud 取り込みプロジェクトに安全に転送する必要があります。オンプレミス アプリケーションの場合は、Cloud Interconnect または Cloud VPN を使用できます。Google Cloud ネットワーク内で、Private Service Connect を使用して、ターゲット プロジェクトの VPC ネットワーク内の取り込みエンドポイントにデータをルーティングします。Private Service Connect を使用すると、ソース アプリケーションはプライベート IP アドレスを使用して Google API に接続できるため、トラフィックがインターネットに公開されることはありません。
ネットワーク パス全体と、取り込みプロジェクト内のターゲット取り込みサービス(Cloud Storage、BigQuery、Pub/Sub)は、VPC Service Controls の境界によって保護されます。この境界はセキュリティ境界を適用し、ソースから取得された保護対象データが、その特定のプロジェクト内の承認されたGoogle Cloud サービスにのみ取り込まれるようにします。
ロギング
このアーキテクチャでは、エンタープライズ基盤ブループリントによって提供される Cloud Logging の機能を使用します。
パイプライン
エンタープライズ データメッシュ アーキテクチャでは、一連のパイプラインを使用して、インフラストラクチャ、オーケストレーション、データセット、データ パイプライン、アプリケーション コンポーネントをプロビジョニングします。このアーキテクチャのリソース デプロイ パイプラインでは、Infrastructure as Code(IaC)ツールとして Terraform を使用し、CI/CD サービスとして Cloud Build を使用して、Terraform 構成をアーキテクチャ環境にデプロイします。次の図は、パイプライン間の関係を示しています。
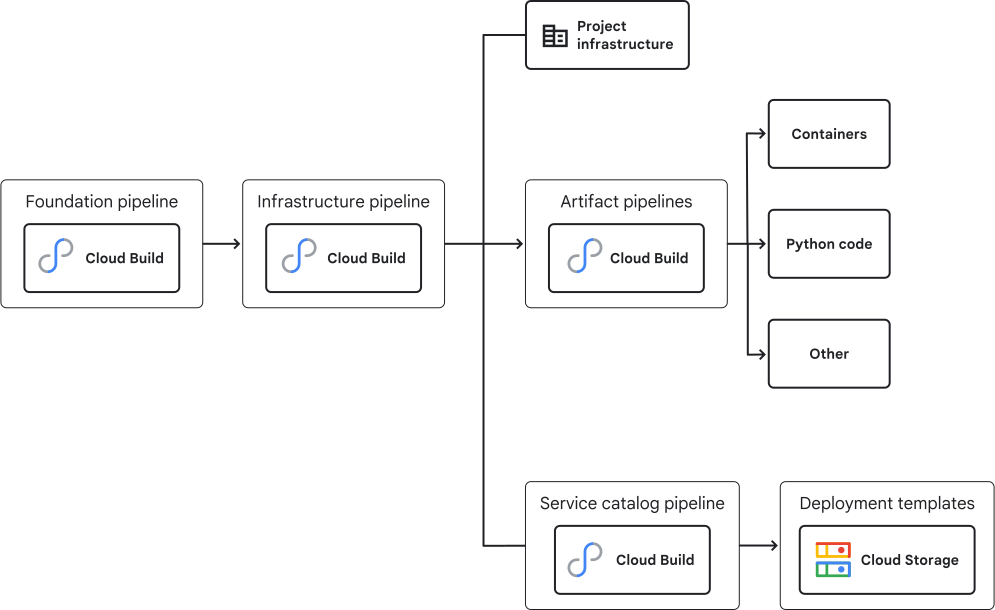
基盤パイプラインとインフラストラクチャ パイプラインは、エンタープライズ基盤ブループリントの一部です。次の表に、パイプラインの目的と、パイプラインがプロビジョニングするリソースを示します。
| パイプライン | プロビジョニング | リソース |
|---|---|---|
基盤パイプライン |
ブートストラップ |
|
インフラストラクチャ パイプライン |
基盤パイプライン |
|
サービス カタログ パイプライン |
インフラストラクチャ パイプライン |
|
アーティファクト パイプライン |
インフラストラクチャ パイプライン |
アーティファクト パイプラインは、データメッシュで使用されるコードベースのさまざまなコンテナやその他のコンポーネントを生成します。 |
各パイプラインには、コードと構成ファイルを pull する独自のリポジトリのセットがあります。各リポジトリには職務分掌があり、運用コードのデプロイの送信者と承認者は異なるグループの責任です。
サービス カタログを使用したインタラクティブなデプロイ
インタラクティブ環境は、アーキテクチャ内の開発環境であり、開発フォルダの下にあります。インタラクティブ環境のメイン インターフェースはサービス カタログです。これにより、デベロッパーは事前構成済みのテンプレートを使用して Google サービスをインスタンス化できます。これらの事前構成済みテンプレートは、サービス テンプレートと呼ばれます。サービス テンプレートを使用すると、CMEK 暗号化を必須にするなど、セキュリティ ポスチャーを適用できます。また、ユーザーが Google API に直接アクセスできないようにすることもできます。
次の図は、インタラクティブ環境のコンポーネントと、データ サイエンティストがリソースをデプロイする方法を示しています。
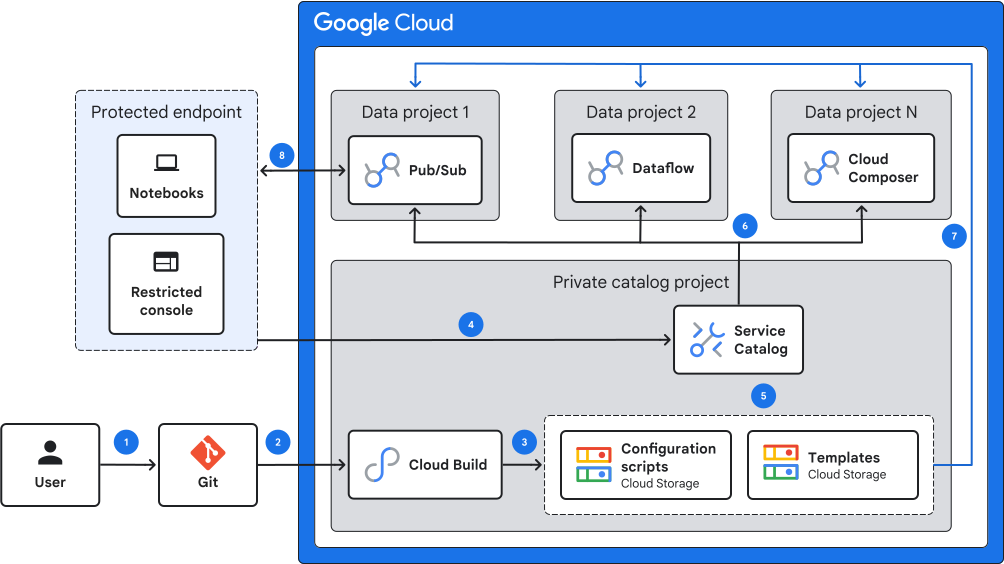
サービス カタログを使用してリソースをデプロイするには、次の手順を行います。
- MLOps エンジニアが Google Cloud用の Terraform リソース テンプレートを Git リポジトリに配置する。
- Git Commit コマンドにより、Cloud Build パイプラインがトリガーされる。
- Cloud Build がテンプレートと関連構成ファイルを Cloud Storage にコピーする。
- MLOps エンジニアがサービス カタログ ソリューションとサービス カタログを手動で設定する。エンジニアがインタラクティブ環境でサービス カタログをサービス プロジェクトと共有する。
- データ サイエンティストがサービス カタログからリソースを選択する。
- サービス カタログはテンプレートをインタラクティブ環境にデプロイする。
- リソースが必要な構成スクリプトを pull する。
- データ サイエンティストがリソースを操作する。
アーティファクト パイプライン
データの取り込みプロセスでは、Managed Airflow と Dataflow を使用して、データドメイン内のデータの移動と変換をオーケストレートします。アーティファクト パイプラインは、データの取り込みに必要なすべてのリソースをビルドし、サービスがアクセスできるようにリソースを適切な場所に移動します。アーティファクト パイプラインは、オーケストレーターが使用するコンテナ アーティファクトを作成します。
セキュリティ管理
エンタープライズ データメッシュ アーキテクチャでは、デフォルトの Google Cloud 機能、 Google Cloudサービス、エンタープライズ基盤ブループリントによって構成されたセキュリティ機能を含む、多層防御のセキュリティ モデルを採用しています。次の図は、このアーキテクチャのさまざまなセキュリティ管理のレイヤを示しています。
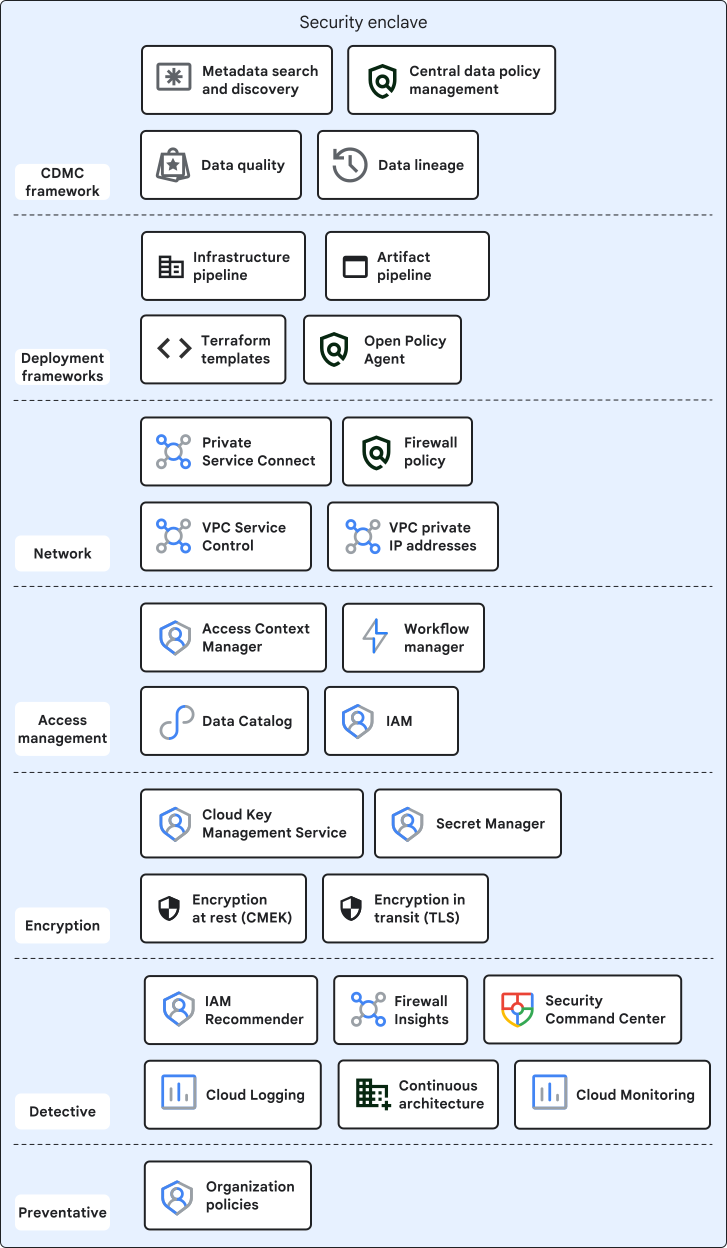
次の表に、各レイヤのリソースに関連付けられているセキュリティ対策を示します。
| 層 | リソース | セキュリティ対策 |
|---|---|---|
CDMC フレームワーク |
Google Cloud CDMC の実装 |
データアセットの保護、管理、制御に役立つガバナンス フレームワークを提供します。詳細については、CDMC キー コントロール フレームワークをご覧ください。 |
デプロイ |
インフラストラクチャ パイプライン |
インフラストラクチャのデプロイ、コンテナのビルド、データ パイプラインの作成を行う一連のパイプラインを提供します。パイプラインを使用することで、監査可能性、トレーサビリティ、再現性を確保できます。 |
アーティファクト パイプライン |
インフラストラクチャ パイプラインによってデプロイされないさまざまなコンポーネントをデプロイします。 |
|
Terraform テンプレート |
システム インフラストラクチャを構築します。 |
|
Open Policy Agent |
プラットフォームが選択したポリシーに準拠していることを確認するのに役立ちます。 |
|
ネットワーク |
Private Service Connect |
API レイヤと IP レイヤでアーキテクチャ リソースのデータの引き出しを保護します。プライベート IP アドレスを使用して Google Cloud APIs と通信できるため、インターネットへのトラフィックの漏洩を回避できます。 |
プライベート IP アドレスを割り当てられた VPC ネットワーク |
インターネットに接続された脅威にさらされるリスクを軽減します。 |
|
VPC Service Controls |
機密性の高いリソースをデータの引き出しから保護します。 |
|
ファイアウォール |
VPC ネットワークを不正アクセスから保護します。 |
|
アクセス管理 |
Access Context Manager |
誰がどのリソースにアクセスできるかを制御し、リソースの不正使用を防止します。 |
Workload Identity 連携 |
オンプレミス環境からプラットフォームにデータを転送するために外部認証情報が不要になります。 |
|
Knowledge Catalog |
ユーザーが利用できるアセットのインデックスを提供します。 |
|
IAM |
きめ細かいアクセスを提供します。 |
|
暗号化 |
Cloud KMS |
暗号鍵とシークレットを管理し、保存データの暗号化と転送データの暗号化によってデータを保護します。 |
Secret Manager |
IAM によって制御されるパイプラインのシークレット ストアを提供します。 |
|
保存データの暗号化 |
デフォルトでは、 Google Cloud は保存データを暗号化します。 |
|
転送データの暗号化 |
デフォルトでは、 Google Cloud は転送中のデータを暗号化します。 |
|
検出 |
Security Command Center |
Google Cloud組織内の構成ミスや悪意のある活動の検出に役立ちます。 |
継続的アーキテクチャ |
ユーザーが定義した一連の OPA ポリシーとの照合により、 Google Cloud 組織を継続的に確認します。 |
|
IAM Recommender |
ユーザー権限を分析し、最小権限の原則を適用するために権限の削減に関する提案を行います。 |
|
ファイアウォール インサイト |
全体的なセキュリティ ポスチャーを強化するため、ファイアウォール ルールを分析し、過度に制限の緩いファイアウォール ルールを特定して、より制限の厳しいファイアウォールを提案します。 |
|
Cloud Logging |
システムの活動を可視化して、異常や悪意のある活動の検出を実現します。 |
|
Cloud Monitoring |
不審な活動の特定に役立つ重要なシグナルとイベントを追跡します。 |
|
予防 |
組織ポリシー |
Google Cloud組織内のアクションを制御および制限できます。 |
Workflows
以降のセクションでは、データ プロデューサーのワークフローとデータ コンシューマーのワークフローの概要を説明します。これにより、データの機密性とユーザーロールに基づいて適切なアクセス制御を確保します。
データ プロデューサーのワークフロー
次の図は、BigQuery に転送される際のデータの保護方法を示しています。
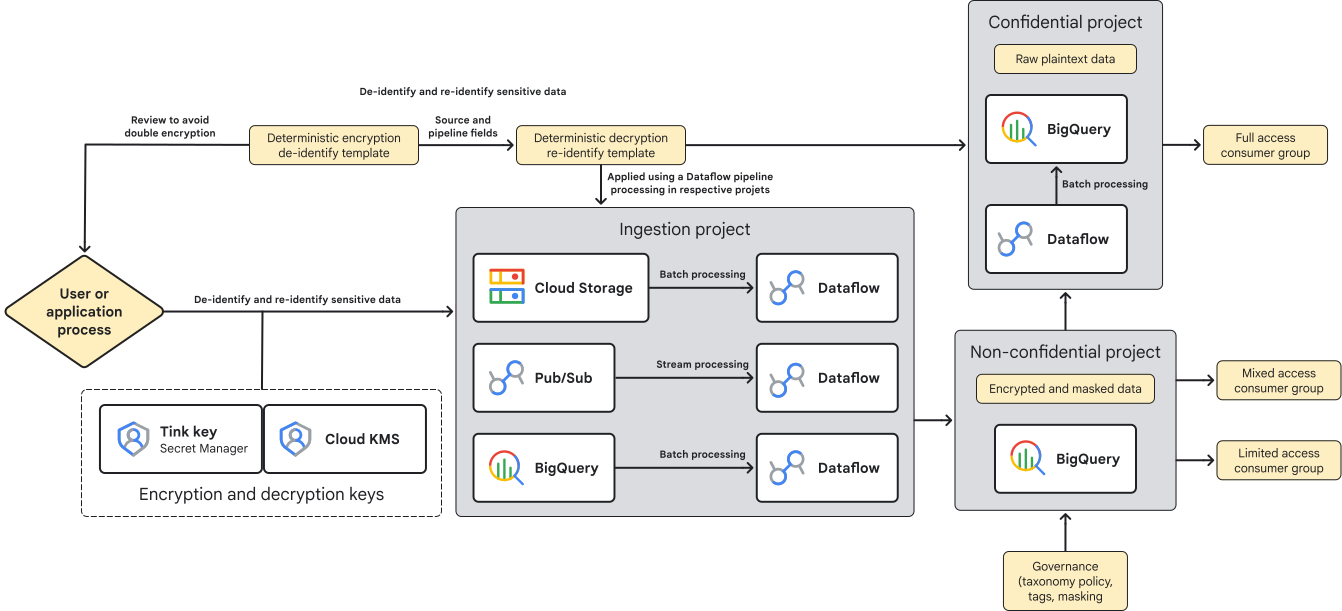
データ転送のワークフローは次のとおりです。
- Workload Identity 連携と統合されたアプリケーションは、Cloud KMS を使用してラップされた暗号鍵を復号します。
- アプリケーションは、Tink ライブラリを使用して、テンプレートを使用してデータを匿名化または暗号化します。
- アプリケーションは、 Google Cloudの取り込みプロジェクトにデータを転送します。
- データが Cloud Storage、BigQuery、または Pub/Sub に到着します。
- 取り込みプロジェクトでは、テンプレートを使用してデータが復号または再識別されます。
- 復号されたデータは、別の匿名化テンプレートに基づいて暗号化またはマスキングされ、機密性のないプロジェクトに配置されます。アスペクトとポリシータグは、Tag Engine によって必要に応じて適用されます。
- 機密ではないプロジェクトのデータが機密プロジェクトに転送され、再識別されます。
次のデータアクセスが許可されます。
- 機密プロジェクトにアクセスできるユーザーは、すべての未加工の平文データにアクセスできます。
- 機密情報以外のプロジェクトにアクセスできるユーザーは、データに関連付けられたポリシータグと権限に基づいて、マスクされたデータ、トークン化されたデータ、または暗号化されたデータにアクセスできます。
データ コンシューマーのワークフロー
次の手順では、コンシューマーが BigQuery に保存されているデータにアクセスする方法について説明します。
- データ コンシューマーは、Knowledge Catalog を使用してデータアセットを検索します。
- 探しているアセットが見つかったら、データ利用者はデータアセットへのアクセスをリクエストします。
- データ所有者は、アセットへのアクセスを許可するかどうかを決定します。
- コンシューマーがアクセス権を取得すると、ノートブックとソリューション カタログを使用して、データアセットを分析して変換できる環境を作成できます。
まとめ
GitHub リポジトリには、エンタープライズ基盤をデプロイした後にGoogle Cloud にデータメッシュをデプロイする詳細な手順が記載されています。アーキテクチャをデプロイするプロセスでは、既存のインフラストラクチャ リポジトリを変更し、新しいデータメッシュ固有のコンポーネントをデプロイします。
次の手順に沿って操作します。
- 次の前提条件をすべて満たします。
- Google Cloud CLI、Terraform、Tink、Java、Go をインストールします。
- エンタープライズ基盤ブループリント(v4.1)をデプロイします。
- 次のローカル リポジトリを維持します。
gcp-data-mesh-foundationsgcp-bootstrapgcp-environmentsgcp-networksgcp-orggcp-projects
- 既存の基盤ブループリントを変更してから、データメッシュ アプリケーションをデプロイします。各アイテムについて、次の操作を行います。
- ターゲット リポジトリで、
Planブランチをチェックアウトします。 - データメッシュ コンポーネントを追加するには、関連するファイルとディレクトリを
gcp-data-mesh-foundationsから適切な基盤ディレクトリにコピーします。必要に応じてファイルを上書きします。 - Terraform ファイル(
*.tfvarsや*.tfなど)のデータメッシュ変数、ロール、設定を更新します。GitHub トークンを環境変数として設定します。 - 各リポジトリで Terraform の初期化、計画、適用オペレーションを実行します。
- 変更を commit し、コードをリモート リポジトリに push して、pull リクエストを作成し、開発環境、非本番環境、本番環境にマージします。
- ターゲット リポジトリで、
次のステップ
- データメッシュ内のアーキテクチャと機能を確認する。
- Google Cloud から安全な BigQuery データ ウェアハウスにデータをインポートする。
- BigQuery データ ウェアハウスに CDMC のキー コントロール フレームワークを実装する。
- エンタープライズ基盤ブループリントを読む。