


Comme décrit dans la section Plans d'exécution de requêtes, le compilateur SQL transforme une instruction SQL en un plan d'exécution de requêtes, qui permet d'obtenir les résultats de la requête. Cette page décrit les bonnes pratiques à suivre pour créer des instructions SQL afin d'aider Spanner à trouver des plans d'exécution efficaces. Consultez le guide [Optimisation des requêtes][query_tuning] pour obtenir de l'aide sur l'amélioration des performances des requêtes.
Les exemples d'instructions SQL présentés sur cette page utilisent l'exemple de schéma suivant :
GoogleSQL
CREATE TABLE Singers (
 SingerId   INT64 NOT NULL,
 FirstName  STRING(1024),
 LastName   STRING(1024),
 SingerInfo BYTES(MAX),
 BirthDate  DATE
) PRIMARY KEY (SingerId);

CREATE TABLE Albums (
 SingerId     INT64 NOT NULL,
 AlbumId      INT64 NOT NULL,
 AlbumTitle   STRING(MAX),
 ReleaseDate  DATE
) PRIMARY KEY (SingerId, AlbumId),
INTERLEAVE IN PARENT Singers ON DELETE CASCADE;
Pour obtenir la documentation de référence SQL complète, consultez Syntaxe des instructions, Fonctions et opérateurs et Structure lexicale et syntaxe.
PostgreSQL
CREATE TABLE Singers (
 SingerId   BIGINT PRIMARY KEY,
 FirstName  VARCHAR(1024),
 LastName   VARCHAR(1024),
 SingerInfo BYTEA,
 BirthDate  TIMESTAMPTZ
);

CREATE TABLE Albums (
 SingerId        BIGINT NOT NULL,
 AlbumId         BIGINT NOT NULL,
 AlbumTitle      VARCHAR(1024),
 ReleaseDate     DATE,
 PRIMARY KEY(SingerId, AlbumId),
 FOREIGN KEY (SingerId) REFERENCES Singers(SingerId)
) INTERLEAVE IN PARENT Singers ON DELETE CASCADE;
Pour en savoir plus, consultez Le langage PostgreSQL dans Spanner.
Utiliser des paramètres de requête
Spanner accepte les paramètres de requête pour améliorer les performances et parer au risque d'injection SQL dans les requêtes conçues pour faire intervenir des entrées utilisateur. Vous pouvez utiliser des paramètres de requête pour remplacer des expressions arbitraires, mais pas pour remplacer des identifiants, des noms de colonnes, des noms de tables ni d'autres parties de la requête.
Les paramètres peuvent apparaître partout où une valeur littérale est attendue. Le même nom de paramètre peut être utilisé plusieurs fois dans une même instruction SQL.
En résumé, les paramètres de requête permettent d'exécuter des requêtes de différentes manières :
- Plans pré-optimisés : les requêtes qui utilisent des paramètres peuvent être exécutées plus rapidement à chaque appel, car le paramétrage permet à Spanner de mettre plus facilement en cache le plan d'exécution.
- Composition de requête simplifiée : vous n'avez pas besoin d'échapper les valeurs de chaîne lorsque vous les fournissez dans les paramètres de requête. Les paramètres de requête réduisent également le risque d'erreurs de syntaxe.
- Sécurité : les paramètres de requête renforcent la sécurité de vos requêtes en vous protégeant contre diverses attaques par injection SQL. Cette protection est particulièrement importante pour les requêtes que vous créez à partir d'entrées utilisateur.
Pour améliorer les performances, Spanner convertit les valeurs littérales codées en dur en SQL en paramètres si le plan d'exécution de requête optimal ne dépend pas des valeurs littérales spécifiques. Cela permet à Spanner de réduire la latence et les coûts de processeur en mettant en cache et en réutilisant le plan de requête. Toutefois, cela n'offre pas les mêmes protections injection SQL ni les avantages d'une composition de requête plus simple. Il est recommandé d'utiliser des paramètres de requête dans le code de l'application.
Comprendre comment Spanner exécute les requêtes
Spanner vous permet d'interroger des bases de données à l'aide d'instructions SQL déclaratives qui spécifient les données que vous souhaitez récupérer. Si vous souhaitez comprendre comment Spanner obtient les résultats, examinez le plan d'exécution de la requête. Un plan d'exécution de requête affiche le coût de calcul associé à chaque étape de la requête. Ces coûts vous permettent de déboguer les problèmes de performances des requêtes et d'optimiser vos requêtes. Pour en savoir plus, consultez Plans d'exécution des requêtes.
Vous pouvez récupérer les plans d'exécution de requêtes via la console Google Cloud ou les bibliothèques clientes.
Pour obtenir un plan d'exécution de requête pour une requête spécifique à l'aide de la consoleGoogle Cloud , procédez comme suit :
Ouvrez la page "Instances Spanner".
Sélectionnez les noms de l'instance Spanner et de la base de données que vous souhaitez interroger.
Cliquez sur Spanner Studio dans le panneau de navigation de gauche.
Saisissez la requête dans le champ de texte, puis cliquez sur Exécuter la requête.
Cliquez sur Explication
. La console Google Cloud affiche un plan d'exécution visuel pour votre requête.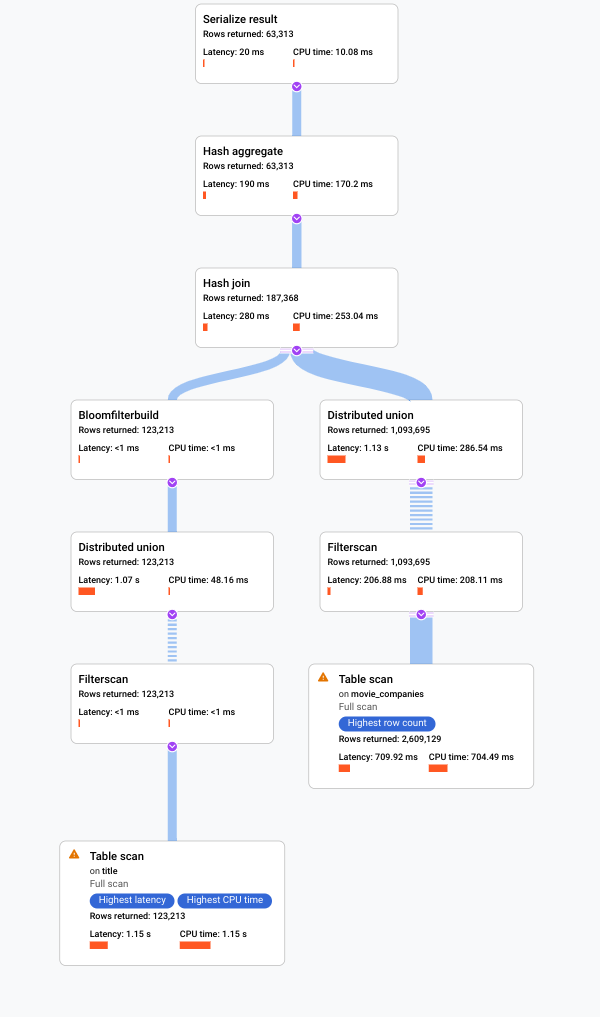
Pour en savoir plus sur l'interprétation des plans visuels et leur utilisation pour déboguer vos requêtes, consultez Ajuster une requête à l'aide du visualiseur de plan de requête.
Vous pouvez également afficher des exemples de plans de requête historiques et comparer les performances d'une requête au fil du temps pour certaines requêtes. Pour en savoir plus, consultez Plans de requête échantillonnés.
Utiliser des index secondaires
Comme d'autres bases de données relationnelles, Spanner propose des index secondaires, que vous pouvez utiliser pour récupérer des données à l'aide d'une instruction SQL ou de l'interface de lecture de Spanner. L'utilisation d'un index secondaire dans une requête SQL vous permet de spécifier comment vous souhaitez que Spanner obtienne les résultats. La spécification d'un index secondaire peut accélérer l'exécution des requêtes.
Par exemple, supposons que vous souhaitiez récupérer les ID de tous les chanteurs portant un nom de famille spécifique. La requête SQL pourrait être écrite de cette façon (par exemple) :
SELECT s.SingerId
FROM Singers AS s
WHERE s.LastName = 'Smith';
Cette requête renverrait les résultats attendus, mais cela pourrait prendre beaucoup de temps. Le temps d'exécution dépend du nombre de lignes de la table Singers et du nombre de lignes qui satisfont au prédicat WHERE s.LastName = 'Smith'.
S'il n'existe pas d'index secondaire contenant la colonne LastName à lire, le plan de requête lit l'intégralité de la table Singers pour trouver les lignes correspondant au prédicat. La lecture de l'intégralité de la table est appelée analyse complète de la table. Une analyse complète de la table est un moyen coûteux d'obtenir les résultats lorsque la table ne contient qu'un faible pourcentage de Singers portant ce nom de famille.
Pour améliorer les performances de cette requête, définissez un index secondaire sur la colonne du nom de famille, comme suit :
CREATE INDEX SingersByLastName ON Singers (LastName);
Étant donné que l'index secondaire SingersByLastName contient la colonne de table indexée LastName et la colonne de clé primaire SingerId, Spanner peut récupérer toutes les données de la table d'index beaucoup plus petite au lieu d'analyser l'intégralité de la table Singers.
Dans ce scénario, Spanner utilise automatiquement l'index secondaire SingersByLastName lors de l'exécution de la requête (à condition que trois jours se soient écoulés depuis la création de la base de données ; consultez la section Remarque sur les nouvelles bases de données).
Toutefois, il est préférable d'indiquer explicitement à Spanner d'utiliser cet index en spécifiant une directive d'index dans la clause FROM :
GoogleSQL
SELECT s.SingerId
FROM Singers@{FORCE_INDEX=SingersByLastName} AS s
WHERE s.LastName = 'Smith';
PostgreSQL
SELECT s.SingerId
FROM Singers /*@ FORCE_INDEX=SingersByLastName */ AS s
WHERE s.LastName = 'Smith';
Si vous utilisez des schémas nommés, utilisez la syntaxe suivante pour la clause FROM :
GoogleSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME@{FORCE_INDEX="NAMED_SCHEMA_NAME.TABLE_INDEX_NAME"}
PostgreSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME /*@ FORCE_INDEX = TABLE_INDEX_NAME */
Supposons maintenant que vous souhaitiez également récupérer le prénom du chanteur en plus de son identifiant. Même si la colonne FirstName ne fait pas partie de l'index, vous devez toujours spécifier la directive d'index comme auparavant, de la manière suivante :
GoogleSQL
SELECT s.SingerId, s.FirstName
FROM Singers@{FORCE_INDEX=SingersByLastName} AS s
WHERE s.LastName = 'Smith';
PostgreSQL
SELECT s.SingerId, s.FirstName
FROM Singers /*@ FORCE_INDEX=SingersByLastName */ AS s
WHERE s.LastName = 'Smith';
L'utilisation de l'index vous permet toujours de bénéficier d'un gain de performances, car Spanner n'a pas besoin d'effectuer une analyse complète de la table lors de l'exécution du plan de requête. Au lieu de cela, il sélectionne le sous-ensemble de lignes qui satisfont le prédicat à partir de l'index SingersByLastName, puis effectue une recherche à partir de la table de base Singers pour récupérer le prénom uniquement pour ce sous-ensemble de lignes.
Si vous souhaitez que Spanner n'ait pas à récupérer de lignes de la table de base, vous pouvez stocker une copie de la colonne FirstName dans l'index lui-même :
GoogleSQL
CREATE INDEX SingersByLastName ON Singers (LastName) STORING (FirstName);
PostgreSQL
CREATE INDEX SingersByLastName ON Singers (LastName) INCLUDE (FirstName);
L'utilisation d'une clause STORING (pour le dialecte GoogleSQL) ou d'une clause INCLUDE (pour le dialecte PostgreSQL) comme celle-ci entraîne des coûts de stockage supplémentaires, mais offre les avantages suivants :
- Les requêtes SQL qui utilisent l'index et sélectionnent les colonnes stockées dans la clause
STORINGouINCLUDEne nécessitent pas de jointure supplémentaire à la table de base. - Les appels de lecture qui utilisent l'index peuvent lire les colonnes stockées dans la clause
STORINGouINCLUDE.
Les exemples précédents illustrent comment les index secondaires peuvent accélérer les requêtes lorsque les lignes choisies par la clause WHERE d'une requête peuvent être rapidement identifiées à l'aide de l'index secondaire.
Les index secondaires peuvent également offrir des avantages en termes de performances pour certaines requêtes qui renvoient des résultats ordonnés. Par exemple, supposons que vous souhaitiez récupérer tous les titres d'albums et leurs dates de sortie par ordre croissant de date de sortie et par ordre décroissant de titre d'album. Vous pouvez écrire une requête SQL comme suit :
SELECT a.AlbumTitle, a.ReleaseDate
FROM Albums AS a
ORDER BY a.ReleaseDate, a.AlbumTitle DESC;
Sans index secondaire, cette requête nécessite une étape de tri potentiellement coûteuse dans le plan d'exécution. Vous pouvez accélérer l'exécution de la requête en définissant l'index secondaire suivant :
CREATE INDEX AlbumsByReleaseDateTitleDesc on Albums (ReleaseDate, AlbumTitle DESC);
Ensuite, réécrivez la requête pour utiliser l'index secondaire :
GoogleSQL
SELECT a.AlbumTitle, a.ReleaseDate
FROM Albums@{FORCE_INDEX=AlbumsByReleaseDateTitleDesc} AS a
ORDER BY a.ReleaseDate, a.AlbumTitle DESC;
PostgreSQL
SELECT a.AlbumTitle, a.ReleaseDate
FROM Albums /*@ FORCE_INDEX=AlbumsByReleaseDateTitleDesc */ AS s
ORDER BY a.ReleaseDate, a.AlbumTitle DESC;
Cette requête et cette définition d'index répondent aux deux critères suivants :
- Pour supprimer l'étape de tri, assurez-vous que la liste des colonnes de la clause
ORDER BYest un préfixe de la liste des clés d'index. - Pour éviter de revenir à la table de base pour récupérer les colonnes manquantes, assurez-vous que l'index couvre toutes les colonnes de la table utilisées par la requête.
Bien que les index secondaires puissent accélérer les requêtes courantes, leur ajout peut augmenter la latence de vos opérations de commit, car chaque index secondaire nécessite généralement l'intervention d'un nœud supplémentaire dans chaque commit. Pour la plupart des charges de travail, quelques index secondaires suffisent. Toutefois, vous devez déterminer si vous accordez plus d'importance à la latence de lecture ou d'écriture, et identifier les opérations les plus critiques pour votre charge de travail. Évaluez votre charge de travail pour vous assurer qu'elle fonctionne comme prévu.
Pour obtenir une documentation de référence complète sur les index secondaires, consultez la page Index secondaires.
Optimiser les recherches de clés de plage
Une requête SQL est couramment utilisée pour lire plusieurs lignes de Spanner en fonction d'une liste de clés connues.
Les bonnes pratiques suivantes vous aident à écrire des requêtes efficaces lors de la récupération de données par une plage de clés :
Si la liste de clés est fragmentée et non adjacente, utilisez les paramètres de requête et
UNNESTpour créer votre requête.Par exemple, si votre liste de clés correspond à
{1, 5, 1000}, écrivez la requête de la manière suivante :GoogleSQL
SELECT *
FROM Table AS t
WHERE t.Key IN UNNEST (@KeyList)
PostgreSQL
SELECT *
FROM Table AS t
WHERE t.Key IN UNNEST ($1)
Remarques :
L'opérateur de tableau UNNEST aplatit un tableau d'entrée en lignes d'éléments.
Le paramètre de requête, qui est
@KeyListpour GoogleSQL et$1pour PostgreSQL, peut accélérer votre requête, comme indiqué dans la bonne pratique précédente.Il est préférable d'utiliser UNNEST avec un seul paramètre plutôt que OR avec plusieurs paramètres.
Si la liste de clés est adjacente et se trouve dans une plage, spécifiez les limites inférieure et supérieure de la plage de clés dans la clause
WHERE.Par exemple, si votre liste de clés est
{1,2,3,4,5}, construisez la requête comme suit :GoogleSQL
SELECT *
FROM Table AS t
WHERE t.Key BETWEEN @min AND @max
PostgreSQL
SELECT *
FROM Table AS t
WHERE t.Key BETWEEN $1 AND $2
Cette requête n'est plus efficace que si les clés de la plage de clés sont adjacentes. En d'autres termes, si votre liste de clés est
{1, 5, 1000}, ne spécifiez pas les limites inférieure et supérieure comme dans la requête précédente, car la requête résultante analyserait toutes les valeurs comprises entre 1 et 1 000.
Optimiser les jointures
Les opérations de jointure peuvent être coûteuses, car elles peuvent augmenter considérablement le nombre de lignes que votre requête doit analyser, ce qui ralentit les requêtes. En plus des techniques que vous avez l'habitude d'utiliser dans d'autres bases de données relationnelles pour optimiser les requêtes de jointure, voici quelques bonnes pratiques pour une jointure plus efficace lorsque vous utilisez Spanner SQL :
- Si possible, joignez des données dans des tables entrelacées par clé primaire. Exemple :
SELECT s.FirstName, a.ReleaseDate
FROM Singers AS s JOIN Albums AS a ON s.SingerId = a.SingerId;
The rows in the interleaved table `Albums` are physically
stored in the same splits as the parent row in `Singers`, as discussed in
[Schema and Data Model](/spanner/docs/schema-and-data-model). Therefore, joins can be
completed locally without sending lots of data across the network.
Utilisez la directive de jointure si vous souhaitez forcer l'ordre de la jointure. Exemple :
GoogleSQL
SELECT *
FROM Singers AS s JOIN@{FORCE_JOIN_ORDER=TRUE} Albums AS a
ON s.SingerId = a.Singerid
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
PostgreSQL
SELECT *
FROM Singers AS s JOIN/*@ FORCE_JOIN_ORDER=TRUE */ Albums AS a
ON s.SingerId = a.Singerid
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
La directive de jointure
FORCE_JOIN_ORDERindique à Spanner d'utiliser l'ordre de jointure spécifié dans la requête (c'est-à-direSingers JOIN Albums, et nonAlbums JOIN Singers). Les résultats renvoyés sont les mêmes, quel que soit l'ordre choisi par Spanner. Toutefois, vous pouvez utiliser cette directive de jointure si vous remarquez dans le plan de requête que Spanner a modifié l'ordre de jointure et entraîné des conséquences indésirables, telles que des résultats intermédiaires plus volumineux, ou a manqué des opportunités de recherche de lignes.Utilisez une directive de jointure pour choisir une mise en œuvre de jointure. Lorsque vous utilisez SQL pour interroger plusieurs tables, Spanner utilise automatiquement une méthode de jointure susceptible d'améliorer l'efficacité de la requête. Toutefois, Google vous conseille de tester différents algorithmes de jointure. Le choix du bon algorithme de jointure peut améliorer la latence, la consommation de mémoire ou les deux. Cette requête illustre la syntaxe permettant d'utiliser une instruction JOIN avec l'indice
JOIN_METHODpour choisir unHASH JOIN:GoogleSQL
SELECT *
FROM Singers s JOIN@{JOIN_METHOD=HASH_JOIN} Albums AS a
ON a.SingerId = a.SingerId
PostgreSQL
SELECT *
FROM Singers s JOIN/*@ JOIN_METHOD=HASH_JOIN */ Albums AS a
ON a.SingerId = a.SingerId
Si vous utilisez un
HASH JOINou unAPPLY JOINet que vous avez une clauseWHEREtrès sélective d'un côté de votreJOIN, placez la table qui produit le plus petit nombre de lignes comme première table dans la clauseFROMde la jointure. Cette structure est utile, car dansHASH JOIN, Spanner choisit toujours la table de gauche comme table de compilation et la table de droite comme table de vérification. De même, pourAPPLY JOIN, Spanner sélectionne la table de gauche comme table externe et la table de droite comme table interne. En savoir plus sur ces types de jointures : [Jointure de hachage][hash_join] et [Jointure d'application][apply_join].Pour les requêtes critiques pour votre charge de travail, spécifiez la méthode de jointure et l'ordre de jointure les plus performants dans vos instructions SQL afin d'obtenir des performances plus cohérentes.
Optimiser les requêtes avec le pushdown de prédicat d'horodatage
Le pushdown de prédicat d'horodatage est une technique d'optimisation des requêtes utilisée dans Spanner pour améliorer l'efficacité des requêtes qui utilisent des horodatages et des données avec une règle de stockage par niveaux basée sur l'âge. Lorsque vous activez cette optimisation, les opérations de filtrage sur les colonnes d'horodatage sont effectuées le plus tôt possible dans le plan d'exécution de la requête. Cela peut réduire considérablement la quantité de données traitées et améliorer les performances globales des requêtes.
Avec le pushdown de prédicat d'horodatage, le moteur de base de données analyse la requête et identifie le filtre d'horodatage. Il "transmet" ensuite ce filtre à la couche de stockage, de sorte que seules les données pertinentes basées sur les critères de code temporel soient lues à partir du disque SSD. Cela réduit la quantité de données traitées et transférées, ce qui accélère l'exécution des requêtes.
Pour optimiser les requêtes afin qu'elles n'accèdent qu'aux données stockées sur SSD, les conditions suivantes doivent être remplies :
- Le pushdown du prédicat d'horodatage doit être activé pour la requête. Pour en savoir plus, consultez Conseils pour les instructions GoogleSQL et Conseils pour les instructions PostgreSQL.
La requête doit utiliser une restriction basée sur l'âge inférieure ou égale à l'âge spécifié dans la règle de débordement des données (définie avec l'option
ssd_to_hdd_spill_timespandans l'instruction LDDCREATE LOCALITY GROUPouALTER LOCALITY GROUP). Pour en savoir plus, consultez les instructions GoogleSQLLOCALITY GROUPet les instructions PostgreSQLLOCALITY GROUP.La colonne filtrée dans la requête doit être une colonne de code temporel contenant le code temporel de commit. Pour savoir comment créer une colonne de code temporel de commit, consultez Codes temporels de commit dans GoogleSQL et Codes temporels de commit dans PostgreSQL. Ces colonnes doivent être mises à jour en même temps que la colonne de code temporel et se trouver dans le même groupe de localité, qui dispose d'une règle de stockage par niveaux basée sur l'âge.
Si, pour une ligne donnée, certaines des colonnes interrogées résident sur un SSD et d'autres sur un HDD (car les colonnes sont mises à jour à des moments différents et vieillissent sur le HDD à des moments différents), les performances de la requête peuvent être moins bonnes lorsque vous utilisez l'indice. En effet, la requête doit renseigner les données des différentes couches de stockage. En raison de l'utilisation de l'indice, Spanner vieillit les données au niveau de la cellule individuelle (niveau de précision des lignes et des colonnes) en fonction du code temporel de commit de chaque cellule, ce qui ralentit la requête. Pour éviter ce problème, veillez à mettre à jour régulièrement toutes les colonnes interrogées à l'aide de cette technique d'optimisation dans la même transaction, afin que toutes les colonnes partagent le même horodatage de commit et bénéficient de l'optimisation.
Pour activer le pushdown de prédicat d'horodatage au niveau de l'instruction, utilisez un hint d'instruction dans votre requête. Exemple :
GoogleSQL
@{allow_timestamp_predicate_pushdown=TRUE}
SELECT s.SingerInfo
FROM Singers s
WHERE s.ModificationTime > TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 12 HOUR);
PostgreSQL
/*@allow_timestamp_predicate_pushdown=TRUE*/
SELECT s.SingerInfo
FROM Singers s
WHERE s.ModificationTime > CURRENT_TIMESTAMP - INTERVAL '12 hours';
Éviter les opérations de lecture de grande taille dans les transactions en lecture-écriture
Les transactions en lecture-écriture autorisent une séquence de zéro ou plusieurs lectures ou requêtes SQL et peuvent inclure un ensemble de mutations avant un appel à validation. Pour maintenir la cohérence de vos données, Spanner acquiert des verrous lors de la lecture et de l'écriture de lignes dans vos tables et index. Pour en savoir plus sur le verrouillage, consultez la section Cycle de vie des lectures et des écritures.
En raison du fonctionnement du verrouillage dans Spanner, l'exécution d'une lecture ou d'une requête SQL qui lit un grand nombre de lignes (par exemple, SELECT * FROM
Singers) signifie qu'aucune autre transaction ne peut écrire dans les lignes que vous avez lues tant que votre transaction n'est pas validée ou annulée.
De plus, comme votre transaction traite un grand nombre de lignes, elle est susceptible de prendre plus de temps qu'une transaction qui lit une plage de lignes beaucoup plus petite (par exemple, SELECT LastName FROM Singers WHERE SingerId = 7), ce qui aggrave encore le problème et réduit le débit du système.
Par conséquent, essayez d'éviter les lectures volumineuses (par exemple, les analyses de table complètes ou les opérations de jointure massives) dans vos transactions, sauf si vous êtes prêt à accepter un débit d'écriture inférieur.
Dans certains cas, le modèle suivant peut donner de meilleurs résultats :
- Effectuez vos lectures volumineuses dans une transaction en lecture seule. Les transactions en lecture seule permettent d'obtenir un débit global plus élevé, car elles n'utilisent pas de verrous.
- Facultatif : effectuez tout traitement requis sur les données que vous venez de lire.
- Démarrez une transaction en lecture-écriture.
- Vérifiez que les valeurs des lignes critiques n'ont pas changé depuis que vous avez effectué la transaction en lecture seule à l'étape 1.
- Si les lignes ont changé, annulez votre transaction et recommencez à l'étape 1.
- Si tout se passe bien, validez vos mutations.
Pour vous assurer d'éviter les lectures volumineuses dans les transactions en lecture-écriture, vous pouvez examiner les plans d'exécution générés par vos requêtes.
Utiliser ORDER BY pour garantir le classement de vos résultats SQL
Si vous attendez un certain ordre pour les résultats d'une requête SELECT, incluez explicitement la clause ORDER BY. Par exemple, si vous souhaitez lister tous les chanteurs par ordre de clé primaire, utilisez cette requête :
SELECT * FROM
Singers
ORDER BY SingerId;
Spanner ne garantit l'ordre des résultats que si la clause ORDER BY est présente dans la requête. En d'autres termes, considérez la requête suivante sans ORDER
BY :
SELECT * FROM Singers;
Spanner ne garantit pas que les résultats de cette requête seront dans l'ordre des clés primaires. En outre, l'ordre des résultats peut changer à tout moment et n'est pas garanti d'être cohérent d'un appel à l'autre. Si une requête comporte une clause ORDER BY et que Spanner utilise un index qui fournit l'ordre requis, Spanner ne trie pas explicitement les données. Par conséquent, ne vous inquiétez pas de l'impact sur les performances de l'inclusion de cette clause. Vous pouvez vérifier si une opération de tri explicite est incluse dans l'exécution en consultant le plan de requête.
Utiliser STARTS_WITH au lieu de LIKE
Étant donné que Spanner n'évalue pas les modèles LIKE paramétrés avant l'exécution, il doit lire toutes les lignes et les évaluer par rapport à l'expression LIKE pour filtrer les lignes qui ne correspondent pas.
Lorsqu'un modèle LIKE se présente sous la forme foo% (par exemple, il commence par une chaîne fixe et se termine par un seul caractère générique de pourcentage) et que la colonne est indexée, utilisez STARTS_WITH au lieu de LIKE. Cette option permet à Spanner d'optimiser plus efficacement le plan d'exécution de la requête.
Option déconseillée :
GoogleSQL
SELECT a.AlbumTitle FROM Albums a
WHERE a.AlbumTitle LIKE @like_clause;
PostgreSQL
SELECT a.AlbumTitle FROM Albums a
WHERE a.AlbumTitle LIKE $1;
Recommandé :
GoogleSQL
SELECT a.AlbumTitle FROM Albums a
WHERE STARTS_WITH(a.AlbumTitle, @prefix);
PostgreSQL
SELECT a.AlbumTitle FROM Albums a
WHERE STARTS_WITH(a.AlbumTitle, $2);
Utiliser des codes temporels de commit
Si votre application doit interroger des données écrites après une heure donnée, ajoutez des colonnes d'horodatage de commit aux tables concernées. Les codes temporels de commit permettent une optimisation de Spanner qui peut réduire les E/S des requêtes dont les clauses WHERE limitent les résultats aux lignes écrites plus récemment qu'une heure spécifique.
En savoir plus sur cette optimisation avec les bases de données utilisant le dialecte GoogleSQL ou avec les bases de données utilisant le dialecte PostgreSQL.