


Dans une base de données Spanner, Spanner crée automatiquement un index pour la clé primaire de chaque table. Par exemple, vous n'avez rien à faire pour indexer la clé primaire de Singers, car elle est automatiquement indexée pour vous.
Vous pouvez également créer des index secondaires pour d'autres colonnes. L'ajout d'un index secondaire sur une colonne facilite la recherche des données dans cette colonne. Par exemple, si vous devez rechercher rapidement un album par titre, vous devez créer un index secondaire sur AlbumTitle, afin que Spanner n'ait pas à analyser l'intégralité de la table.
Si la recherche de l'exemple précédent est effectuée dans une transaction en lecture-écriture, la recherche plus efficace évite également de maintenir des verrous sur l'ensemble de la table, ce qui permet d'insérer et de mettre à jour simultanément des lignes de la table en dehors de la plage de recherche AlbumTitle.
En plus des avantages qu'ils apportent aux recherches, les index secondaires peuvent également aider Spanner à exécuter des analyses plus efficacement, en permettant des analyses d'index plutôt que des analyses de table complètes.
Spanner stocke les données suivantes dans chaque index secondaire :
- toutes les colonnes clés de la table de base ;
- toutes les colonnes incluses dans l'index ;
- Toutes les colonnes spécifiées dans la clause facultative
STORING(bases de données utilisant le dialecte GoogleSQL) ouINCLUDE(bases de données utilisant le dialecte PostgreSQL) de la définition de l'index.
Au fil du temps, Spanner analyse vos tables pour s'assurer que vos index secondaires sont utilisés pour les requêtes appropriées.
Ajouter un index secondaire
Le moment le plus efficace pour ajouter un index secondaire est lors de la création de la table. Pour créer une table et ses index en même temps, envoyez les instructions LDD de la nouvelle table et des nouveaux index dans une seule requête à Spanner.
Dans Spanner, vous pouvez également ajouter un index secondaire à une table existante pendant que la base de données continue de diffuser du trafic. Comme pour toute autre modification de schéma dans Spanner, l'ajout d'un index à une base de données existante ne nécessite pas la mise hors connexion de la base de données et ne verrouille pas des colonnes ou des tables entières.
Chaque fois qu'un nouvel index est ajouté à une table existante, Spanner remplit automatiquement l'index pour refléter une vue à jour des données indexées. Spanner gère ce processus de remplissage pour vous. Il s'exécute en arrière-plan en utilisant les ressources des nœuds avec une priorité faible. La vitesse de remplissage de l'index s'adapte à l'évolution des ressources des nœuds lors de la création de l'index, et le remplissage n'affecte pas de manière significative les performances de la base de données.
La création d'un index peut prendre de quelques minutes à plusieurs heures. La création d'index étant une mise à jour du schéma, elle est soumise aux mêmes contraintes de performances que toute autre mise à jour de schéma. Le temps nécessaire à la création d'un index secondaire dépend de plusieurs facteurs :
- La taille de l'ensemble de données
- La capacité de calcul de l'instance
- La charge sur l'instance
Pour afficher la progression d'un processus de remplissage d'index, consultez la section sur la progression.
Notez que l'utilisation de la colonne commit timestamp en tant que première partie de l'index secondaire peut créer des hotspots et réduire les performances en écriture.
Utilisez l'instruction CREATE INDEX pour définir un index secondaire dans votre schéma. Voici quelques exemples :
Pour indexer tous les chanteurs (Singers) de la base de données par leur prénom et leur nom :
GoogleSQL
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
PostgreSQL
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
Pour créer un index de tous les titres (Songs) de la base de données selon la valeur SongName :
GoogleSQL
CREATE INDEX SongsBySongName ON Songs(SongName);
PostgreSQL
CREATE INDEX SongsBySongName ON Songs(SongName);
Pour n'indexer que les titres d'un chanteur particulier, entrelacez l'index dans la table Singers à l'aide de la clause INTERLEAVE IN :
GoogleSQL
CREATE INDEX SongsBySingerSongName ON Songs(SingerId, SongName),
    INTERLEAVE IN Singers;
PostgreSQL
CREATE INDEX SongsBySingerSongName ON Songs(SingerId, SongName)
    INTERLEAVE IN Singers;
Pour n'indexer que les titres d'un album particulier :
GoogleSQL
CREATE INDEX SongsBySingerAlbumSongName ON Songs(SingerId, AlbumId, SongName),
    INTERLEAVE IN Albums;
PostgreSQL
CREATE INDEX SongsBySingerAlbumSongName ON Songs(SingerId, AlbumId, SongName)
    INTERLEAVE IN Albums;
Pour indexer par ordre décroissant de SongName :
GoogleSQL
CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC),
    INTERLEAVE IN Albums;
PostgreSQL
CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC)
    INTERLEAVE IN Albums;
Notez que l'annotation DESC précédente ne s'applique qu'à SongName. Pour indexer par ordre décroissant d'autres clés d'index, annotez-les avec DESC : SingerId DESC, AlbumId DESC.
Notez également que PRIMARY_KEY est un mot réservé ne pouvant pas être utilisé comme nom d'index. Il s'agit du nom attribué au pseudo-index créé lorsqu'une table avec une spécification de clé primaire est créée.
Pour en savoir plus et découvrir les bonnes pratiques pour choisir entre des index non entrelacés et des index entrelacés, consultez Choisir entre des index entrelacés et des index globaux, Options d'index et Utiliser un index entrelacé sur une colonne dont la valeur augmente ou diminue de façon linéaire.
Index et entrelacement
Les index Spanner peuvent être entrelacés avec d'autres tables afin de colocaliser les lignes d'index avec celles d'une autre table. Comme pour l'entrelacement de tables Spanner, les colonnes de clé primaire du parent de l'index doivent être un préfixe des colonnes indexées, correspondant au type et à l'ordre de tri. Contrairement aux tables entrelacées, la correspondance des noms de colonnes n'est pas requise. Chaque ligne d'un index entrelacé est stockée physiquement avec la ligne parente associée.
Par exemple, considérons le schéma suivant :
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo PROTO<Singer>(MAX)
) PRIMARY KEY (SingerId);

CREATE TABLE Albums (
  SingerId     INT64 NOT NULL,
  AlbumId      INT64 NOT NULL,
  AlbumTitle   STRING(MAX),
  PublisherId  INT64 NOT NULL
) PRIMARY KEY (SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE TABLE Songs (
  SingerId     INT64 NOT NULL,
  AlbumId      INT64 NOT NULL,
  TrackId      INT64 NOT NULL,
  PublisherId  INT64 NOT NULL,
  SongName     STRING(MAX)
) PRIMARY KEY (SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE TABLE Publishers (
  Id            INT64 NOT NULL,
  PublisherName STRING(MAX)
) PRIMARY KEY (Id);
Pour indexer tous les Singers de la base de données par leur prénom et leur nom, vous devez créer un index. Voici comment définir l'index SingersByFirstLastName :
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
Si vous souhaitez créer un index de Songs sur (SingerId, AlbumId, SongName), vous pouvez procéder comme suit :
CREATE INDEX SongsBySingerAlbumSongName
    ON Songs(SingerId, AlbumId, SongName);
Vous pouvez également créer un index entrelacé avec un ancêtre de Songs, comme suit :
CREATE INDEX SongsBySingerAlbumSongName
    ON Songs(SingerId, AlbumId, SongName),
    INTERLEAVE IN Albums;
Vous pouvez également créer un index de Songs sur (PublisherId, SingerId, AlbumId, SongName) qui est entrelacé avec une table qui n'est pas un ancêtre de Songs, comme Publishers. Notez que la clé primaire de la table Publishers (id) n'est pas un préfixe des colonnes indexées dans l'exemple suivant. Cela est toujours autorisé, car Publishers.Id et Songs.PublisherId partagent le même type, le même ordre de tri et la même possibilité de valeur nulle.
CREATE INDEX SongsByPublisherSingerAlbumSongName
    ON Songs(PublisherId, SingerId, AlbumId, SongName),
    INTERLEAVE IN Publishers;
Choisir entre des index entrelacés et des index globaux
Lorsque vous créez un index secondaire dans Spanner, vous le définissez comme un index global (index par défaut, non entrelacé) ou un index entrelacé. Le choix du type d'index optimal est essentiel pour les performances de lecture et d'écriture.
Comparaison d'index
| Fonctionnalité | Index entrelacé | Index global |
|---|---|---|
| Emplacement de stockage | Colocalisé avec la ligne parente dans la même division (arborescence de lignes). | Stocké dans une table racine distincte, qui peut être divisée indépendamment de la table de base. |
| Exigences principales | La clé primaire de la table parente doit être un préfixe des clés d'index. | Aucune restriction sur les clés d'index. |
| Surcharge d'écriture | Faible Lorsqu'elles sont entrelacées dans un ancêtre de la table de base, les mises à jour sont généralement locales à la division, ce qui évite les validations en deux phases entre les divisions. Si l'entrelacement est effectué dans une table qui n'est pas un ancêtre, la surcharge d'écriture est plus élevée, car les mises à jour peuvent nécessiter des transactions distribuées. | Plus élevée. Les mises à jour s'étendent souvent sur différentes divisions, ce qui nécessite des transactions distribuées. |
| Application idéale | Requêtes limitées à une seule entité parente, par exemple "rechercher des photos pour l'utilisateur USER_NAME". | Requêtes qui effectuent une recherche dans l'ensemble de la base de données, par exemple "rechercher un utilisateur par adresse e-mail". |
Pourquoi les index entrelacés sont généralement préférés
Dans une base de données distribuée comme Spanner, la localité des données est essentielle pour les performances. Les index entrelacés sont généralement préférés, car ils préservent la localité des données :
- Lectures efficaces : si vos requêtes filtrent toujours par ID d'entité parente, un index entrelacé permet à Spanner de répondre à la requête en analysant uniquement la division contenant cette entité parente, plutôt que de consulter plusieurs divisions.
- Écritures efficaces : lorsque vous mettez à jour une ligne d'une table, Spanner doit également mettre à jour ses index secondaires. Si vous utilisez un index global, l'entrée d'index se trouve probablement dans un segment différent de celui de la ligne de base. Cela force Spanner à effectuer une transaction distribuée (validation en deux phases) entre les divisions, ce qui augmente la latence et l'utilisation du processeur. Si un index entrelacé est entrelacé dans un ancêtre de la table de base, l'entrée d'index est stockée dans la même division que la ligne de base, ce qui fait de l'écriture une opération locale.
Guide de décision
Suivez les consignes ci-dessous pour choisir le type d'index optimal pour votre cas d'utilisation :
Quand utiliser un index entrelacé ?
Utilisez un index entrelacé lorsqu'une ou plusieurs des conditions suivantes sont remplies :
- Vos requêtes incluent toujours un filtre sur la clé primaire de la table parente, par exemple
WHERE UserId = @userId AND .... - Les colonnes de clé primaire de la table parente peuvent naturellement être utilisées comme préfixe pour vos clés d'index.
- Vous souhaitez minimiser la latence d'écriture et la surcharge du processeur liée à la maintenance des index.
Exemple :
-- Indexing albums by title for a specific singer
CREATE INDEX AlbumsBySingerTitle ON Albums(SingerId, AlbumTitle),
  INTERLEAVE IN Singers;
Quand utiliser un index global ?
Utilisez un index global lorsqu'une ou plusieurs des conditions suivantes sont remplies :
- Vous devez interroger les données de l'ensemble de la base de données sans filtrer par entité parente (par exemple, une recherche globale).
- Les colonnes que vous souhaitez indexer ne partagent pas de préfixe avec une table parente.
Exemple :
-- Indexing all albums globally by title. For example, for a global search catalog.
CREATE INDEX AlbumsByTitle ON Albums(AlbumTitle);
Vérifier la progression du remplissage de l'index
Console
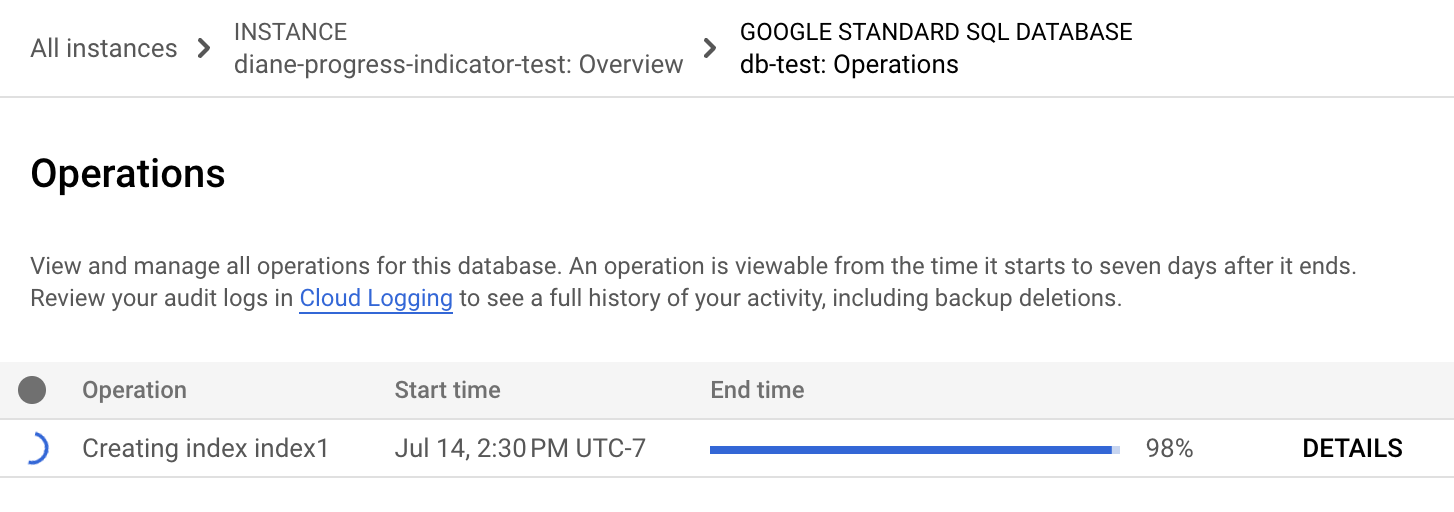
Dans le menu de navigation de Spanner, cliquez sur l'onglet Opérations. La page Opérations affiche la liste des opérations en cours.
Recherchez l'opération de backfill dans la liste. Si elle est toujours en cours d'exécution, l'indicateur de progression de la colonne Heure de fin indique le pourcentage de l'opération terminée, comme illustré dans l'image suivante :
gcloud
Utilisez gcloud spanner operations describe pour vérifier la progression d'une opération.
Obtenez l'ID de l'opération :
gcloud spanner operations list --instance=INSTANCE-NAME \
--database=DATABASE-NAME --type=DATABASE_UPDATE_DDL
Remplacez les éléments suivants :
- INSTANCE-NAME par le nom de l'instance Spanner.
- DATABASE-NAME par le nom de la base de données.
Remarques concernant l'utilisation :
Pour limiter la liste, spécifiez l'option
--filter. Exemple :--filter="metadata.name:example-db"ne liste que les opérations sur une base de données spécifique.--filter="error:*"ne liste que les opérations de sauvegarde ayant échoué.
Pour en savoir plus sur la syntaxe des filtres, consultez la page gcloud topic filters. Pour en savoir plus sur le filtrage des opérations de sauvegarde, consultez le champ
filterdans ListBackupOperationsRequest.L'option
--typen'est pas sensible à la casse.
La sortie ressemble à ceci :
OPERATION_ID     STATEMENTS                                                                                          DONE   @TYPE
_auto_op_123456  CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName)                                 False  UpdateDatabaseDdlMetadata
                CREATE INDEX SongsBySingerAlbumSongName ON Songs(SingerId, AlbumId, SongName), INTERLEAVE IN Albums
_auto_op_234567                                                                                                      True   CreateDatabaseMetadata
Exécuter
gcloud spanner operations describegcloud spanner operations describe \ --instance=INSTANCE-NAME \ --database=DATABASE-NAME \ projects/PROJECT-NAME/instances/INSTANCE-NAME/databases/DATABASE-NAME/operations/OPERATION_ID
Remplacez les éléments suivants :
- INSTANCE-NAME : nom de l'instance Spanner.
- DATABASE-NAME : nom de la base de données Spanner.
- PROJECT-NAME : nom du projet.
- OPERATION-ID : ID de l'opération que vous souhaitez vérifier.
La section
progressde la sortie indique le pourcentage d'avancement de l'opération. Le résultat ressemble à ceci :done: true ... progress: - endTime: '2021-01-22T21:58:42.912540Z' progressPercent: 100 startTime: '2021-01-22T21:58:11.053996Z' - progressPercent: 67 startTime: '2021-01-22T21:58:11.053996Z' ...
REST v1
Obtenez l'ID de l'opération :
  gcloud spanner operations list --instance=INSTANCE-NAME

  --database=DATABASE-NAME --type=DATABASE_UPDATE_DDL
Remplacez les éléments suivants :
- INSTANCE-NAME par le nom de l'instance Spanner.
- DATABASE-NAME par le nom de la base de données.
Avant d'utiliser les données de requête, effectuez les remplacements suivants :
- PROJECT-ID : ID du projet.
- INSTANCE-ID : ID de l'instance.
- DATABASE-ID : ID de la base de données.
- OPERATION-ID : ID de l'opération.
Méthode HTTP et URL :
GET https://spanner.googleapis.com/v1/projects/PROJECT-ID/instances/INSTANCE-ID/databases/DATABASE-ID/operations/OPERATION-ID
Pour envoyer votre requête, développez l'une des options suivantes :
Vous devriez recevoir une réponse JSON de ce type :
{
...
    "progress": [
      {
        "progressPercent": 100,
        "startTime": "2023-05-27T00:52:27.366688Z",
        "endTime": "2023-05-27T00:52:30.184845Z"
      },
      {
        "progressPercent": 100,
        "startTime": "2023-05-27T00:52:30.184845Z",
        "endTime": "2023-05-27T00:52:40.750959Z"
      }
    ],
...
  "done": true,
  "response": {
    "@type": "type.googleapis.com/google.protobuf.Empty"
  }
}
Pour gcloud et REST, vous pouvez trouver la progression de chaque instruction de backfill d'index dans la section progress. Pour chaque instruction du tableau d'instructions, il existe un champ correspondant dans le tableau de progression. L'ordre de ce tableau de progression correspond à l'ordre du tableau d'instructions. Une fois disponibles, les champs startTime, progressPercent et endTime sont renseignés en conséquence.
Notez que le résultat n'indique pas d'estimation du temps nécessaire pour terminer le backfill.
Si l'opération prend trop de temps, vous pouvez l'annuler. Pour en savoir plus, consultez Annuler la création d'un index.
Scénarios d'affichage de la progression du remplissage de l'index
Vous pouvez rencontrer différents scénarios lorsque vous essayez de vérifier la progression d'un remplissage d'index. Les instructions de création d'index qui nécessitent un remplissage d'index font partie des opérations de mise à jour de schéma. Plusieurs instructions peuvent faire partie d'une opération de mise à jour de schéma.
Le premier scénario est le plus simple : l'instruction de création d'index est la première instruction de l'opération de mise à jour du schéma. Comme l'instruction de création d'index est la première instruction, elle est la première à être traitée et exécutée en raison de l'ordre d'exécution.
Le champ startTime de l'instruction de création d'index est immédiatement renseigné avec l'heure de début de l'opération de mise à jour du schéma. Ensuite, le champ progressPercent de l'instruction de création d'index est renseigné lorsque la progression du remplissage de l'index est supérieure à 0%. Enfin, le champ endTime est renseigné une fois l'instruction validée.
Le deuxième scénario se produit lorsque l'instruction de création d'index n'est pas la première instruction de l'opération de mise à jour du schéma. Aucun champ lié à l'instruction de création d'index ne sera renseigné tant que les instructions précédentes n'auront pas été validées en raison de l'ordre d'exécution.
Comme dans le scénario précédent, une fois les instructions précédentes validées, le champ startTime de l'instruction de création d'index est renseigné en premier, suivi du champ progressPercent. Enfin, le champ endTime est renseigné une fois que l'instruction a fini d'être validée.
Annuler la création de l'index
Vous pouvez utiliser la Google Cloud CLI pour annuler la création d'un index. Pour récupérer la liste des opérations de mise à jour de schéma pour une base de données Spanner, utilisez la commande gcloud spanner operations list et incluez l'option --filter :
gcloud spanner operations list \
    --instance=INSTANCE \
    --database=DATABASE \
    --filter="@TYPE:UpdateDatabaseDdlMetadata"
Recherchez le OPERATION_ID pour l'opération que vous souhaitez annuler, puis utilisez la commande gcloud spanner operations cancel pour l'annuler :
gcloud spanner operations cancel OPERATION_ID \
    --instance=INSTANCE \
    --database=DATABASE
Afficher les index existants
Pour afficher des informations sur les index existants d'une base de données, vous pouvez utiliser la consoleGoogle Cloud ou la Google Cloud CLI :
Console
Accédez à la page Instances Spanner de la console Google Cloud .
Cliquez sur le nom de l'instance que vous souhaitez afficher.
Dans le volet de gauche, cliquez sur la base de données à afficher, puis sur la table que vous souhaitez consulter.
Cliquez sur l'onglet Index. La console Google Cloud affiche une liste d'index.
Facultatif : Pour obtenir des détails sur un index, par exemple les colonnes qu'il contient, cliquez sur le nom de l'index.
gcloud
Exécutez la commande gcloud spanner databases ddl describe :
    gcloud spanner databases ddl describe DATABASE \
        --instance=INSTANCE
La gcloud CLI affiche les instructions LDD (langage de définition de données) pour créer les tables et les index de la base de données. Les instructions CREATE
INDEX décrivent les index existants. Exemple :
--- |-
CREATE TABLE Singers (
SingerId INT64 NOT NULL,
FirstName STRING(1024),
LastName STRING(1024),
SingerInfo BYTES(MAX),
) PRIMARY KEY(SingerId)
---
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName)
Interroger avec un index spécifique
Les sections suivantes expliquent comment spécifier un index dans une instruction SQL et avec l'interface de lecture pour Spanner. Les exemples de ces sections supposent que vous avez ajouté une colonne MarketingBudget à la table Albums et que vous avez créé un index appelé AlbumsByAlbumTitle :
GoogleSQL
CREATE TABLE Albums (
  SingerId         INT64 NOT NULL,
  AlbumId          INT64 NOT NULL,
  AlbumTitle       STRING(MAX),
  MarketingBudget  INT64,
) PRIMARY KEY (SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);
PostgreSQL
CREATE TABLE Albums (
  SingerId         BIGINT NOT NULL,
  AlbumId          BIGINT NOT NULL,
  AlbumTitle       VARCHAR,
  MarketingBudget  BIGINT,
  PRIMARY KEY (SingerId, AlbumId)
) INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);
Spécifier un index dans une instruction SQL
Lorsque vous utilisez SQL pour interroger une table Spanner, Spanner se sert automatiquement de tous les index susceptibles d'améliorer l'efficacité de la requête. Par conséquent, vous n'avez pas besoin de spécifier d'index pour les requêtes SQL. Toutefois, pour les requêtes critiques pour votre charge de travail, Google vous conseille d'utiliser des directives FORCE_INDEX dans vos instructions SQL afin d'obtenir des performances plus cohérentes.
Dans certains cas, Spanner peut choisir un index qui augmente la latence des requêtes. Si vous suivez la [procédure de dépannage pour les régressions de performances][troubleshooting-query-performance-regressions] et décidez d'essayer un autre index pour la requête, vous pouvez spécifier l'index dans votre requête.
Pour spécifier un index dans une instruction SQL, utilisez l'indice FORCE_INDEX pour fournir une directive d'index. Les directives d'index utilisent la syntaxe suivante :
GoogleSQL
FROM MyTable@{FORCE_INDEX=MyTableIndex}
PostgreSQL
FROM MyTable /*@ FORCE_INDEX = MyTableIndex */
Vous pouvez également utiliser une directive d'index pour indiquer à Spanner d'analyser la table de base au lieu d'utiliser un index :
GoogleSQL
FROM MyTable@{FORCE_INDEX=_BASE_TABLE}
PostgreSQL
FROM MyTable /*@ FORCE_INDEX = _BASE_TABLE */
Vous pouvez utiliser une directive d'index pour indiquer à Spanner d'analyser un index dans une table avec des schémas nommés :
GoogleSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME@{FORCE_INDEX="NAMED_SCHEMA_NAME.TABLE_INDEX_NAME"}
PostgreSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME /*@ FORCE_INDEX = TABLE_INDEX_NAME */
L'exemple suivant illustre une requête SQL qui spécifie un index :
GoogleSQL
SELECT AlbumId, AlbumTitle, MarketingBudget
    FROM Albums@{FORCE_INDEX=AlbumsByAlbumTitle}
    WHERE AlbumTitle >= "Aardvark" AND AlbumTitle < "Goo";
PostgreSQL
SELECT AlbumId, AlbumTitle, MarketingBudget
    FROM Albums /*@ FORCE_INDEX = AlbumsByAlbumTitle */
    WHERE AlbumTitle >= 'Aardvark' AND AlbumTitle < 'Goo';
Une directive d'index peut forcer le processeur de requêtes de Spanner à lire des colonnes supplémentaires requises par la requête, mais non stockées dans l'index.
Le processeur de requêtes récupère ces colonnes en joignant l'index et la table de base. Pour éviter cette jointure supplémentaire, utilisez une clause STORING (bases de données utilisant le dialecte GoogleSQL) ou une clause INCLUDE (bases de données utilisant le dialecte PostgreSQL) pour stocker les colonnes supplémentaires dans l'index.
Dans l'exemple précédent, la colonne MarketingBudget n'est pas stockée dans l'index, mais la requête SQL sélectionne cette colonne. Par conséquent, Spanner doit rechercher la colonne MarketingBudget dans la table de base, puis la joindre aux données de l'index pour renvoyer les résultats de la requête.
Spanner génère une erreur si la directive d'index présente l'un des problèmes suivants :
- L'index n'existe pas.
- L'index se trouve dans une autre table de base.
- Il manque une expression de filtrage
NULLobligatoire dans la requête pour un indexNULL_FILTERED.
Les exemples suivants montrent comment écrire et exécuter des requêtes qui récupèrent les valeurs de AlbumId, AlbumTitle et MarketingBudget à l'aide de l'index AlbumsByAlbumTitle :
C++
C#
Go
Java
Node.js
PHP
Python
Ruby
Spécifiez un index dans l'interface de lecture.
Lorsque vous utilisez l'interface de lecture de Spanner et que vous souhaitez que Spanner utilise un index, vous devez spécifier l'index. L'interface de lecture ne sélectionne pas automatiquement l'index.
En outre, votre index doit contenir toutes les données qui apparaissent dans les résultats de la requête, à l'exception des colonnes qui font partie de la clé primaire. Cette restriction existe, car l'interface de lecture ne prend pas en charge les jointures entre l'index et la table de base. Si vous devez inclure d'autres colonnes dans les résultats de la requête, vous disposez de plusieurs options :
- Utilisez une clause
STORINGouINCLUDEpour stocker les colonnes supplémentaires dans l'index. - Effectuez une requête sans inclure les colonnes supplémentaires, puis utilisez les clés primaires pour envoyer une autre requête qui lit les colonnes supplémentaires.
Spanner renvoie les valeurs de l'index dans l'ordre de tri croissant par clé d'index. Pour récupérer les valeurs dans l'ordre décroissant, procédez comme suit :
Ajoutez à la clé d'index l'annotation
DESC: Exemple :CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle DESC);L'annotation
DESCs'applique à une seule clé d'index. Si l'index comprend plusieurs clés et si vous souhaitez que les résultats de la requête apparaissent dans l'ordre décroissant en fonction de toutes les clés, ajoutez une annotationDESCpour chaque clé.Si la lecture spécifie une plage de clés, assurez-vous que la plage de clés est également dans l'ordre décroissant. En d'autres termes, la valeur de la clé de début doit être supérieure à la valeur de la clé de fin.
L'exemple suivant montre comment extraire les valeurs de AlbumId et AlbumTitle à l'aide de l'index AlbumsByAlbumTitle :
C++
C#
Go
Java
Node.js
PHP
Python
Ruby
Créer un index pour les analyses d'index uniquement
Vous pouvez éventuellement utiliser la clause STORING (pour les bases de données utilisant le dialecte GoogleSQL) ou la clause INCLUDE (pour les bases de données utilisant le dialecte PostgreSQL) pour stocker une copie d'une colonne dans l'index. Ce type d'index offre des avantages pour les requêtes et les appels en lecture utilisant l'index, au prix d'un stockage supplémentaire :
- Les requêtes SQL qui utilisent l'index et sélectionnent les colonnes stockées dans la clause
STORINGouINCLUDEne nécessitent pas de jointure supplémentaire à la table de base. - Les appels
read()qui utilisent l'index peuvent lire les colonnes stockées par la clauseSTORING/INCLUDE.
Par exemple, supposons que vous ayez créé une autre version de AlbumsByAlbumTitle qui stocke une copie de la colonne MarketingBudget dans l'index (notez la clause STORING ou INCLUDE en gras) :
GoogleSQL
CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);
PostgreSQL
CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) INCLUDE (MarketingBudget);
Avec l'ancien index AlbumsByAlbumTitle, Spanner doit joindre l'index à la table de base, puis récupérer la colonne de la table de base. Avec le nouvel index AlbumsByAlbumTitle2, Spanner lit la colonne directement à partir de l'index, ce qui est plus efficace.
Si vous utilisez l'interface de lecture au lieu de SQL, le nouvel index AlbumsByAlbumTitle2 vous permet également de lire directement la colonne MarketingBudget :
C++
C#
Go
Java
Node.js
PHP
Python
Ruby
Modifier un index
Vous pouvez utiliser l'instruction ALTER INDEX pour ajouter des colonnes supplémentaires à un index existant ou supprimer des colonnes. Cela peut mettre à jour la liste des colonnes définie par la clause STORING (bases de données au dialecte GoogleSQL) ou la clause INCLUDE (bases de données au dialecte PostgreSQL) lorsque vous créez l'index. Vous ne pouvez pas utiliser cette instruction pour ajouter des colonnes à la clé d'index ou en supprimer. Par exemple, au lieu de créer un index AlbumsByAlbumTitle2, vous pouvez utiliser ALTER INDEX pour ajouter une colonne à AlbumsByAlbumTitle, comme illustré dans l'exemple suivant :
GoogleSQL
ALTER INDEX AlbumsByAlbumTitle ADD STORED COLUMN MarketingBudget
PostgreSQL
ALTER INDEX AlbumsByAlbumTitle ADD INCLUDE COLUMN MarketingBudget
Lorsque vous ajoutez une colonne à un index existant, Spanner utilise un processus de remplissage en arrière-plan. Pendant le backfill, la colonne de l'index n'est pas lisible. Vous n'obtiendrez donc peut-être pas l'amélioration des performances attendue. Vous pouvez utiliser la commande gcloud spanner operations pour lister l'opération de longue durée et afficher son état.
Pour en savoir plus, consultez Opération de description.
Vous pouvez également utiliser l'opération d'annulation pour annuler une opération en cours d'exécution.
Une fois le remplissage terminé, Spanner ajoute la colonne à l'index. À mesure que l'index s'agrandit, cela peut ralentir les requêtes qui l'utilisent.
L'exemple suivant montre comment supprimer une colonne d'un index :
GoogleSQL
ALTER INDEX AlbumsByAlbumTitle DROP STORED COLUMN MarketingBudget
PostgreSQL
ALTER INDEX AlbumsByAlbumTitle DROP INCLUDE COLUMN MarketingBudget
Index des valeurs NULL
Par défaut, Spanner indexe les valeurs NULL. Par exemple, reprenez la définition de l'index SingersByFirstLastName dans la table Singers :
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
Toutes les lignes de Singers sont indexées même si FirstName et/ou LastName sont NULL.
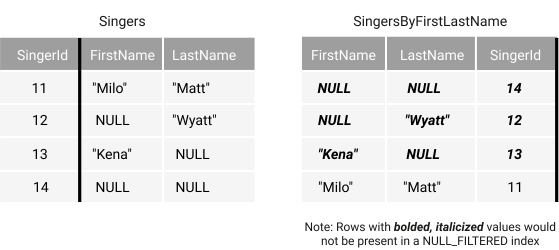
Lorsque des valeurs NULL sont indexées, vous pouvez effectuer des requêtes SQL efficaces et effectuer des lectures sur des données incluant des valeurs NULL. Par exemple, utilisez cette instruction de requête SQL pour trouver tous les Singers avec un FirstName NULL :
GoogleSQL
SELECT s.SingerId, s.FirstName, s.LastName
    FROM Singers@{FORCE_INDEX=SingersByFirstLastName} AS s
    WHERE s.FirstName IS NULL;
PostgreSQL
SELECT s.SingerId, s.FirstName, s.LastName
    FROM Singers /* @ FORCE_INDEX = SingersByFirstLastName */ AS s
    WHERE s.FirstName IS NULL;
Ordre de tri pour les valeurs NULL
Spanner trie NULL comme la plus petite valeur pour un type donné. Pour une colonne dans l'ordre croissant (ASC), les valeurs NULL sont triées en premier. Pour une colonne dans l'ordre décroissant (DESC), les valeurs NULL sont triées en dernier.
Désactiver l'indexation des valeurs NULL
GoogleSQL
Pour désactiver l'indexation des valeurs NULL, ajoutez le mot clé NULL_FILTERED à la définition de l'index. Les index NULL_FILTERED sont particulièrement utiles pour l'indexation des colonnes partiellement remplies, dont la plupart des lignes contiennent une valeur NULL. Dans ces cas, l'index NULL_FILTERED peut être considérablement plus petit et plus simple à maintenir qu'un index normal qui inclut des valeurs NULL.
Voici une autre définition de SingersByFirstLastName qui n'indexe pas les valeurs NULL :
CREATE NULL_FILTERED INDEX SingersByFirstLastNameNoNulls
    ON Singers(FirstName, LastName);
Le mot clé NULL_FILTERED s'applique à toutes les colonnes de la clé d'index. Vous ne pouvez pas spécifier le filtrage des valeurs NULL par colonne.
PostgreSQL
Pour filtrer les lignes contenant des valeurs nulles dans une ou plusieurs colonnes indexées, utilisez le prédicat WHERE COLUMN IS NOT NULL.
Les index filtrés par valeur nulle sont particulièrement utiles pour indexer des colonnes creuses, où la plupart des lignes contiennent une valeur NULL. Dans ce cas, l'index filtré sur les valeurs nulles peut être considérablement plus petit et plus efficace à gérer qu'un index normal incluant des valeurs NULL.
Voici une autre définition de SingersByFirstLastName qui n'indexe pas les valeurs NULL :
CREATE INDEX SingersByFirstLastNameNoNulls
    ON Singers(FirstName, LastName)
    WHERE FirstName IS NOT NULL
    AND LastName IS NOT NULL;
Le filtrage des valeurs NULL empêche Spanner de les utiliser pour certaines requêtes. Par exemple, Spanner n'utilise pas l'index pour cette requête, car l'index omet toutes les lignes Singers pour lesquelles LastName est NULL. Par conséquent, l'utilisation de l'index empêcherait la requête de renvoyer les lignes correctes :
GoogleSQL
FROM Singers@{FORCE_INDEX=SingersByFirstLastNameNoNulls}
    WHERE FirstName = "John";
PostgreSQL
FROM Singers /*@ FORCE_INDEX = SingersByFirstLastNameNoNulls */
    WHERE FirstName = 'John';
Pour permettre à Spanner d'utiliser l'index, vous devez réécrire la requête afin qu'elle exclue les lignes qui sont également exclues de l'index :
GoogleSQL
SELECT FirstName, LastName
    FROM Singers@{FORCE_INDEX=SingersByFirstLastNameNoNulls}
    WHERE FirstName = 'John' AND LastName IS NOT NULL;
PostgreSQL
SELECT FirstName, LastName
    FROM Singers /*@ FORCE_INDEX = SingersByFirstLastNameNoNulls */
    WHERE FirstName = 'John' AND LastName IS NOT NULL;
Champs proto d'index
Utilisez des colonnes générées pour indexer les champs des tampons de protocole stockés dans des colonnes PROTO, à condition que les champs indexés utilisent les types de données primitifs ou ENUM.
Si vous définissez un index sur un champ de message de protocole, vous ne pouvez pas modifier ni supprimer ce champ du schéma proto. Pour en savoir plus, consultez Mises à jour des schémas contenant un index sur des champs proto.
Voici un exemple de table Singers avec une colonne de message proto SingerInfo. Pour définir un index sur le champ nationality de PROTO, vous devez créer une colonne générée stockée :
GoogleSQL
CREATE PROTO BUNDLE (googlesql.example.SingerInfo, googlesql.example.SingerInfo.Residence);

CREATE TABLE Singers (
  SingerId INT64 NOT NULL,
  ...
  SingerInfo googlesql.example.SingerInfo,
  SingerNationality STRING(MAX) AS (SingerInfo.nationality) STORED
) PRIMARY KEY (SingerId);
Il comporte la définition suivante du type de proto googlesql.example.SingerInfo :
GoogleSQL
package googlesql.example;

message SingerInfo {
optional string    nationality = 1;
repeated Residence residence   = 2;

  message Residence {
    required int64  start_year   = 1;
    optional int64  end_year     = 2;
    optional string city         = 3;
    optional string country      = 4;
  }
}
Ensuite, définissez un index sur le champ nationality du proto :
GoogleSQL
CREATE INDEX SingersByNationality ON Singers(SingerNationality);
La requête SQL suivante lit les données à l'aide de l'index précédent :
GoogleSQL
SELECT s.SingerId, s.FirstName
FROM Singers AS s
WHERE s.SingerNationality = "English";
Remarques :
- Utilisez une directive d'index pour accéder aux index des champs des colonnes de tampon de protocole.
- Vous ne pouvez pas créer d'index sur des champs de tampon de protocole répétés.
Mises à jour des schémas contenant un index sur des champs proto
Si vous définissez un index sur un champ de message de protocole, vous ne pouvez pas modifier ni supprimer ce champ du schéma proto. En effet, une fois l'index défini, la vérification du type est effectuée chaque fois que le schéma est mis à jour. Spanner capture les informations de type pour tous les champs du chemin d'accès qui sont utilisés dans la définition de l'index.
Index uniques
Les index peuvent être déclarés comme UNIQUE. Les index UNIQUE ajoutent une contrainte aux données indexées qui interdit les entrées en double pour une clé d'index donnée.
Cette contrainte est appliquée par Spanner au moment de la validation de la transaction.
Plus précisément, toute transaction qui entraînerait l'existence de plusieurs entrées d'index pour une même clé verra son commit échouer.
Si une table contient des données violant la contrainte UNIQUE, la tentative de création d'un index UNIQUE échouera.
Remarque sur les index UNIQUE NULL_FILTERED
Un index UNIQUE NULL_FILTERED n'applique pas l'unicité des clés d'index lorsqu'au moins l'une des parties de la clé de l'index est NULL.
Par exemple, supposons que vous ayez créé la table et l'index suivants :
GoogleSQL
CREATE TABLE ExampleTable (
  Key1 INT64 NOT NULL,
  Key2 INT64,
  Key3 INT64,
  Col1 INT64,
) PRIMARY KEY (Key1, Key2, Key3);

CREATE UNIQUE NULL_FILTERED INDEX ExampleIndex ON ExampleTable (Key1, Key2, Col1);
PostgreSQL
CREATE TABLE ExampleTable (
  Key1 BIGINT NOT NULL,
  Key2 BIGINT,
  Key3 BIGINT,
  Col1 BIGINT,
  PRIMARY KEY (Key1, Key2, Key3)
);

CREATE UNIQUE INDEX ExampleIndex ON ExampleTable (Key1, Key2, Col1)
    WHERE Key1 IS NOT NULL
    AND Key2 IS NOT NULL
    AND Col1 IS NOT NULL;
Les deux lignes suivantes dans ExampleTable ont les mêmes valeurs pour les clés d'index secondaires Key1, Key2 et Col1 :
1, NULL, 1, 1
1, NULL, 2, 1
Comme Key2 est NULL et que l'index est filtré sur les valeurs nulles, les lignes ne seront pas présentes dans l'index ExampleIndex. Comme elles ne sont pas insérées dans l'index, celui-ci ne les rejettera pas pour non-respect de l'unicité sur (Key1, Key2,
Col1).
Si vous souhaitez que l'index applique l'unicité des valeurs du tuple (Key1, Key2, Col1), vous devez annoter Key2 avec NOT NULL dans la définition de la table ou créer l'index sans filtrer les valeurs nulles.
Créer un index basé sur une expression scalaire
Un index d'expression vous permet de créer un index basé sur une expression scalaire qui s'applique à une ou plusieurs colonnes de table. Cela est utile, car vous n'avez plus besoin de créer ni de gérer une colonne générée dédiée dans votre table uniquement à des fins d'indexation.
Les index sur les colonnes générées et les index d'expression peuvent être utiles pour indexer des champs spécifiques dans une colonne JSON. Vous pouvez créer un index sur une valeur extraite d'un objet JSON, ce qui permet à l'optimiseur de requêtes d'effectuer efficacement des recherches basées sur cette valeur.
Dans cet exemple, une colonne générée nommée VenueCity, basée sur le champ city du fichier JSON, est créée uniquement dans le but de la placer dans un index :
GoogleSQL
CREATE TABLE Venues (
  Id INT64 NOT NULL,
  VenueData JSON,
  VenueCity STRING AS (JSON_VALUE(VenueData.address.city))
) PRIMARY KEY (Id);

CREATE INDEX VenuesByCity ON Venues(VenueCity);
PostgreSQL
CREATE TABLE Venues (
  Id BIGINT NOT NULL PRIMARY KEY,
  VenueData JSONB,
  VenueCity VARCHAR GENERATED ALWAYS AS (VenueData -> 'address' ->> 'city')
);

CREATE INDEX VenuesByCity ON Venues(VenueCity);
Pour y parvenir plus efficacement, vous pouvez définir l'index directement, et Spanner gère implicitement le mécanisme sous-jacent :
GoogleSQL
CREATE TABLE Venues (
  Id INT64 NOT NULL,
  VenueData JSON
) PRIMARY KEY (Id);

CREATE INDEX VenuesByCity ON Venues((JSON_VALUE(VenueData.address.city)));
PostgreSQL
CREATE TABLE Venues (
  Id BIGINT NOT NULL PRIMARY KEY,
  VenueData JSONB
);

CREATE INDEX VenuesByCity ON Venues((VenueData -> 'address' ->> 'city'));
Dans les deux cas, votre requête peut utiliser l'index VenuesByCity pour une exécution plus rapide :
GoogleSQL
SELECT Id
FROM Venues
WHERE JSON_VALUE(VenueData.address.city) = 'Seattle';
PostgreSQL
SELECT Id
FROM Venues
WHERE VenueData -> 'address' ->> 'city' = 'Seattle';
Les index d'expression peuvent comporter des colonnes qui sont un mélange d'expressions et de références de colonnes directes. Cela permet à davantage de requêtes d'utiliser l'index pour une exécution plus rapide.
GoogleSQL
CREATE TABLE Venues (
  Id INT64 NOT NULL,
  VenueName STRING(MAX),
  VenueData JSON
) PRIMARY KEY (Id);

CREATE INDEX VenuesByCity ON Venues(
  VenueName,
  (JSON_VALUE(VenueData.address.city)),
  (JSON_VALUE(VenueData.address.state))
);
PostgreSQL
CREATE TABLE Venues (
  Id BIGINT NOT NULL PRIMARY KEY,
  VenueName VARCHAR,
  VenueData JSONB
);

CREATE INDEX VenuesIdx ON Venues(
  VenueName,
  (VenueData -> 'address' ->> 'city'),
  (VenueData -> 'address' ->> 'state'),
);
Supprimer un index
Utilisez l'instruction DROP INDEX pour supprimer un index secondaire de votre schéma.
Pour supprimer l'index nommé SingersByFirstLastName :
DROP INDEX SingersByFirstLastName;
Indexez pour une analyse plus rapide
Lorsque Spanner doit effectuer une analyse de table (plutôt qu'une recherche indexée) pour récupérer les valeurs d'une ou de plusieurs colonnes, vous pouvez obtenir des résultats plus rapidement si un index existe pour ces colonnes, et dans l'ordre spécifié par la requête. Si vous effectuez fréquemment des requêtes nécessitant des analyses, envisagez de créer des index secondaires pour que ces analyses soient plus efficaces.
En particulier, si vous avez besoin que Spanner analyse fréquemment la clé primaire d'une table ou un autre index dans l'ordre inverse, vous pouvez augmenter son efficacité grâce à un index secondaire qui rend l'ordre choisi explicite.
Par exemple, la requête suivante renvoie toujours un résultat rapide, même si Spanner doit analyser Songs pour trouver la valeur la plus faible de SongId :
SELECT SongId FROM Songs LIMIT 1;
SongId est la clé primaire de la table, stockée (comme toutes les clés primaires) par ordre croissant. Spanner peut analyser l'index de cette clé et trouver rapidement le premier résultat.
Toutefois, sans l'aide d'un index secondaire, la requête suivante ne serait pas renvoyée aussi rapidement, en particulier si Songs contient beaucoup de données :
SELECT SongId FROM Songs ORDER BY SongId DESC LIMIT 1;
Même si SongId est la clé primaire de la table, Spanner n'a aucun moyen de récupérer la valeur la plus élevée de la colonne sans recourir à une analyse complète de la table.
L'ajout de l'index suivant permettrait à cette requête de renvoyer des résultats plus rapidement :
CREATE INDEX SongIdDesc On Songs(SongId DESC);
Une fois cet index en place, Spanner l'utilisera pour renvoyer un résultat pour la deuxième requête beaucoup plus rapidement.
Étapes suivantes
- Découvrez les bonnes pratiques SQL pour Spanner.
- Comprendre les plans d'exécution des requêtes pour Spanner.
- Découvrez comment dépanner les régressions de performances dans les requêtes SQL.