次要索引

在 Spanner 資料庫中,Spanner 會自動為每個資料表的主鍵建立索引。舉例來說,您不需要執行任何操作,即可為 Singers 的主鍵建立索引,因為系統會自動為您建立索引。

您也可以為其他資料欄建立次要索引。對資料欄新增次要索引,即可更有效率地查詢該資料欄的資料。舉例來說,如果您需要依標題快速查詢專輯,請在 AlbumTitle 上建立次要索引,這樣 Spanner 就不需要掃描整個資料表。

如果上一個範例中的查詢是在讀寫交易中完成,則更有效率的查詢也可避免保留整個資料表的鎖定,進而允許對 AlbumTitle 查詢範圍以外的資料列進行並行插入和更新。

除了提升查詢效率,次要索引也能協助 Spanner 更有效率地執行掃描,啟用索引掃描,而非完整資料表掃描。

Spanner 會在每個次要索引中儲存下列資料:

Spanner 會持續分析資料表,確保次要索引能用於適當的查詢。

新增次要索引

建立資料表時,是新增次要索引最有效率的時機。如要同時建立資料表和索引,請在單一要求中,將新資料表和新索引的 DDL 陳述式傳送至 Spanner。

在 Spanner 中,您也可以在現有資料表新增次要索引,同時讓資料庫持續處理流量。如同 Spanner 中的其他結構定義變更,在現有資料庫中新增索引時,不需要讓資料庫離線,也不會鎖定整個資料欄或資料表。

每當現有資料表新增索引時,Spanner 會自動補充或填入索引,反映索引資料的最新檢視畫面。Spanner 會為您管理這項補充程序,並在背景中使用低優先順序的節點資源執行。建立索引時,索引補充速度會根據節點資源的變化調整,且補充作業不會大幅影響資料庫效能。

建立索引所需要的時間從幾分鐘到數小時不等,由於建立索引屬於結構定義更新,因此與其他結構定義更新一樣,受到相同的效能限制。建立次要索引所需的時間取決於多項因素:

  • 資料集大小
  • 執行個體的運算能力
  • 執行個體的負載

如要查看索引補充程序的進度,請參閱進度一節。

請注意,如果將修訂版本時間戳記欄做為次要索引的第一部分,可能會產生熱點並降低寫入效能。

使用 CREATE INDEX 陳述式,在結構定義中定義次要索引。例如:

如要依名字和姓氏為資料庫中的所有Singers建立索引,請按照下列步驟操作:

GoogleSQL

CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);

PostgreSQL

CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);

如要依 SongName 的值建立資料庫中所有 Songs 的索引,請按照下列步驟操作:

GoogleSQL

CREATE INDEX SongsBySongName ON Songs(SongName);

PostgreSQL

CREATE INDEX SongsBySongName ON Songs(SongName);

如要只為特定歌手的歌曲建立索引,請使用 INTERLEAVE IN 子句,在資料表 Singers 中交錯索引:

GoogleSQL

CREATE INDEX SongsBySingerSongName ON Songs(SingerId, SongName),
    INTERLEAVE IN Singers;

PostgreSQL

CREATE INDEX SongsBySingerSongName ON Songs(SingerId, SongName)
    INTERLEAVE IN Singers;

只為特定專輯的歌曲建立索引:

GoogleSQL

CREATE INDEX SongsBySingerAlbumSongName ON Songs(SingerId, AlbumId, SongName),
    INTERLEAVE IN Albums;

PostgreSQL

CREATE INDEX SongsBySingerAlbumSongName ON Songs(SingerId, AlbumId, SongName)
    INTERLEAVE IN Albums;

如要依 SongName 遞減順序建立索引:

GoogleSQL

CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC),
    INTERLEAVE IN Albums;

PostgreSQL

CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC)
    INTERLEAVE IN Albums;

請注意,先前的 DESC 註解僅適用於 SongName。如要依其他索引鍵的遞減順序建立索引,請使用 DESC 加上註解:SingerId DESC, AlbumId DESC。

另請注意,PRIMARY_KEY 是保留字,不得做為索引名稱。建立具有 PRIMARY KEY 規格的資料表時,系統會建立虛擬索引,並為其命名

如要進一步瞭解選擇非交錯索引和交錯索引的最佳做法,請參閱「選擇交錯索引和全域索引」、「索引選項」和「在值單調遞增或遞減的資料欄上使用交錯索引」。

索引和交錯

Spanner 索引可以與其他資料表交錯,以便將索引資料列與另一個資料表的資料列共置。與 Spanner 資料表交錯類似,索引父項的主鍵欄必須是索引欄的前置字串,且類型和排列順序必須相符。與交錯資料表不同,資料欄名稱不一定要相符。交錯索引的每個資料列,都會與相關聯的父項資料列一起儲存在實體位置。

舉例來說,假設有以下結構定義:

CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo PROTO<Singer>(MAX)
) PRIMARY KEY (SingerId);

CREATE TABLE Albums (
  SingerId     INT64 NOT NULL,
  AlbumId      INT64 NOT NULL,
  AlbumTitle   STRING(MAX),
  PublisherId  INT64 NOT NULL
) PRIMARY KEY (SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE TABLE Songs (
  SingerId     INT64 NOT NULL,
  AlbumId      INT64 NOT NULL,
  TrackId      INT64 NOT NULL,
  PublisherId  INT64 NOT NULL,
  SongName     STRING(MAX)
) PRIMARY KEY (SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE TABLE Publishers (
  Id            INT64 NOT NULL,
  PublisherName STRING(MAX)
) PRIMARY KEY (Id);

如要依姓氏和名字為資料庫中的所有 Singers 建立索引,您必須建立索引。定義索引 SingersByFirstLastName 的方法如下:

CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);

如要在 (SingerId, AlbumId, SongName) 上建立 Songs 的索引,請執行下列操作:

CREATE INDEX SongsBySingerAlbumSongName
    ON Songs(SingerId, AlbumId, SongName);

或者,您也可以建立與 Songs 祖先交錯的索引,例如:

CREATE INDEX SongsBySingerAlbumSongName
    ON Songs(SingerId, AlbumId, SongName),
    INTERLEAVE IN Albums;

此外,您也可以在 (PublisherId, SingerId, AlbumId, SongName) 上建立 Songs 的索引,並與非 Songs 祖系的資料表 (例如 Publishers) 交錯。請注意,在以下範例中,Publishers 資料表的主鍵 (id) 並非索引資料欄的前置字串。這項操作仍可行,因為 Publishers.Id 和 Songs.PublisherId 的類型、排列順序和是否可為空值都相同。

CREATE INDEX SongsByPublisherSingerAlbumSongName
    ON Songs(PublisherId, SingerId, AlbumId, SongName),
    INTERLEAVE IN Publishers;

選擇交錯索引或全域索引

在 Spanner 中建立次要索引時,您可以將其定義為全域索引 (預設的非交錯索引) 或交錯索引。選擇最佳索引類型,對讀取和寫入效能至關重要。

索引比較

功能 交錯索引 全球指數
儲存位置 與父項資料列位於同一個分割區 (資料列樹狀結構)。 儲存在獨立的根資料表中,可與基礎資料表分開分割。
重要規定 父項資料表的主鍵必須是索引鍵的前置字串。 索引鍵沒有任何限制。
寫入負擔 低:在基礎資料表的祖系中交錯時,更新通常會在本機進行,避免跨分割進行兩階段修訂。如果交錯在非上層資料表中,寫入負擔會較高,因為更新可能需要分散式交易。 更高。更新作業通常會跨越不同的分割,因此需要分散式交易。
適用情境 查詢範圍限於單一上層實體,例如「尋找使用者 USER_NAME 的相片」。 在整個資料庫中搜尋的查詢,例如「依電子郵件地址尋找使用者」。

為什麼通常建議使用交錯索引

在 Spanner 等分散式資料庫中,資料位置是影響效能的關鍵。交錯索引通常是首選,因為可以保留資料位置:

  • 有效率的讀取:如果查詢一律依上層實體的 ID 篩選,交錯索引可讓 Spanner 僅掃描包含該上層實體的分割,而非查詢多個分割,即可滿足查詢。
  • 有效率的寫入作業:更新資料表中的資料列時,Spanner 也必須更新次要索引。如果使用全域索引,索引項目可能位於與基本資料列不同的分割區。這會強制 Spanner 跨分割執行分散式交易 (兩階段修訂),進而增加延遲時間和 CPU 使用率。如果交錯式索引交錯在基礎資料表的祖系中,索引項目會儲存在與基礎資料列相同的分割區中,因此寫入作業會是本機作業。

決策指南

請按照下列規範,選擇最適合您用途的索引類型:

交錯索引的使用時機

如果符合下列一或多項條件,請使用交錯索引:

  • 查詢一律包含父項資料表主鍵的篩選器,例如 WHERE UserId = @userId AND ...。
  • 父項資料表的主鍵欄自然可以做為索引鍵的前置字串。
  • 您希望盡可能縮短寫入延遲時間,並降低索引維護的 CPU 負擔。

範例:

-- Indexing albums by title for a specific singer
CREATE INDEX AlbumsBySingerTitle ON Albums(SingerId, AlbumTitle),
  INTERLEAVE IN Singers;

使用全域索引的時機

如果符合下列一或多項條件,請使用全域索引:

  • 您需要查詢整個資料庫的資料,而不依上層實體篩選,例如全域搜尋。
  • 要建立索引的資料欄與任何上層資料表都沒有相同的前置字串。

範例:

-- Indexing all albums globally by title. For example, for a global search catalog.
CREATE INDEX AlbumsByTitle ON Albums(AlbumTitle);

查看索引補充進度

控制台

  1. 在 Spanner 導覽選單中,按一下「作業」分頁標籤。「Operations」(作業) 頁面會顯示執行中的作業清單。

  2. 在清單中找出補充作業。如果作業仍在執行中,「End time」(結束時間) 欄中的進度指標會顯示已完成作業的百分比,如下圖所示:
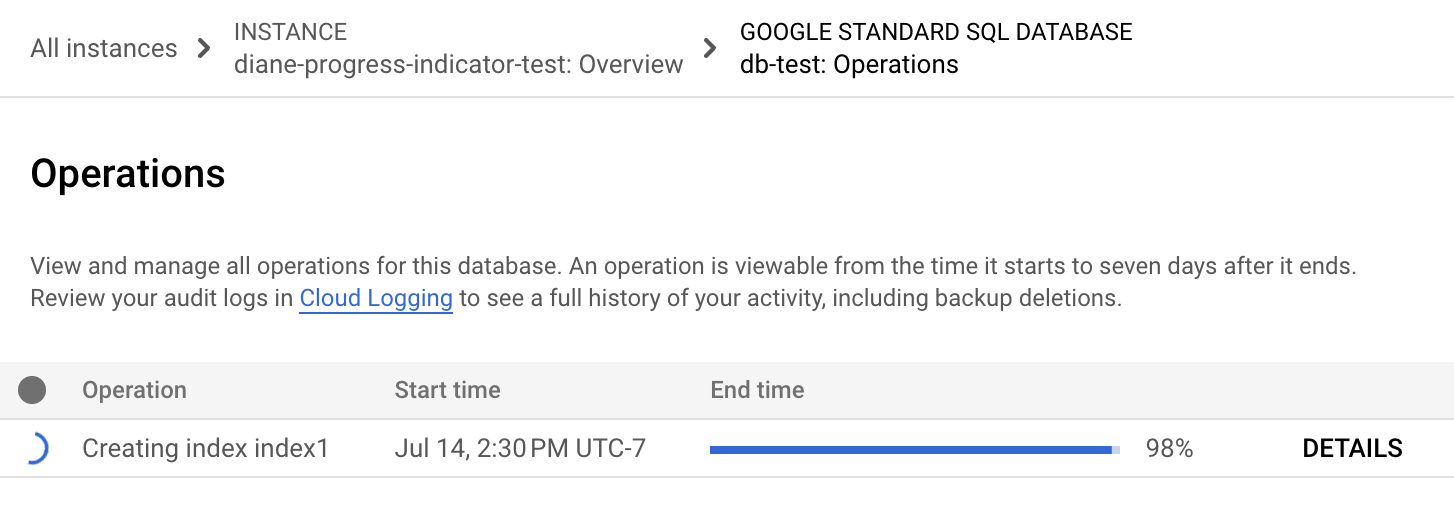
    進度指標顯示進度為 98%

gcloud

使用 gcloud spanner operations describe 檢查作業進度。

  1. 取得作業 ID:

    gcloud spanner operations list --instance=INSTANCE-NAME \
    --database=DATABASE-NAME --type=DATABASE_UPDATE_DDL

    更改下列內容:

    • INSTANCE-NAME:Spanner 執行個體名稱。
    • DATABASE-NAME:資料庫名稱。

    使用須知:

    • 如要限制清單,請指定 --filter 旗標。例如:

      • --filter="metadata.name:example-db" 只會列出特定資料庫的作業。
      • --filter="error:*" 只會列出失敗的備份作業。

      如要瞭解篩選器語法,請參閱「gcloud topic filters」。如要瞭解如何篩選備份作業,請參閱 ListBackupOperationsRequest 中的 filter 欄位。

    • --type 旗標不區分大小寫。

    輸出看起來類似以下內容:

    OPERATION_ID     STATEMENTS                                                                                          DONE   @TYPE
    _auto_op_123456  CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName)                                 False  UpdateDatabaseDdlMetadata
                    CREATE INDEX SongsBySingerAlbumSongName ON Songs(SingerId, AlbumId, SongName), INTERLEAVE IN Albums
    _auto_op_234567                                                                                                      True   CreateDatabaseMetadata
    
  2. 執行 gcloud spanner operations describe:

    gcloud spanner operations describe \
    --instance=INSTANCE-NAME \
    --database=DATABASE-NAME \
    projects/PROJECT-NAME/instances/INSTANCE-NAME/databases/DATABASE-NAME/operations/OPERATION_ID

    更改下列內容:

    • INSTANCE-NAME:Spanner 執行個體名稱。
    • DATABASE-NAME:Spanner 資料庫名稱。
    • PROJECT-NAME:專案名稱。
    • OPERATION-ID:要檢查的作業 ID。

    輸出內容中的 progress 區段會顯示作業完成百分比。輸出內容大致如下:

    done: true
    ...
      progress:
      - endTime: '2021-01-22T21:58:42.912540Z'
        progressPercent: 100
        startTime: '2021-01-22T21:58:11.053996Z'
      - progressPercent: 67
        startTime: '2021-01-22T21:58:11.053996Z'
    ...
    

REST v1

取得作業 ID:

  gcloud spanner operations list --instance=INSTANCE-NAME 
--database=DATABASE-NAME --type=DATABASE_UPDATE_DDL

更改下列內容:

  • INSTANCE-NAME:Spanner 執行個體名稱。
  • DATABASE-NAME:資料庫名稱。

使用任何要求資料之前,請先修改下列項目的值:

  • PROJECT-ID:專案 ID。
  • INSTANCE-ID:執行個體 ID。
  • DATABASE-ID:資料庫 ID。
  • OPERATION-ID:作業 ID。

HTTP 方法和網址:

GET https://spanner.googleapis.com/v1/projects/PROJECT-ID/instances/INSTANCE-ID/databases/DATABASE-ID/operations/OPERATION-ID

請展開以下其中一個選項,以傳送要求:

您應該會收到如下的 JSON 回覆:

{
...
    "progress": [
      {
        "progressPercent": 100,
        "startTime": "2023-05-27T00:52:27.366688Z",
        "endTime": "2023-05-27T00:52:30.184845Z"
      },
      {
        "progressPercent": 100,
        "startTime": "2023-05-27T00:52:30.184845Z",
        "endTime": "2023-05-27T00:52:40.750959Z"
      }
    ],
...
  "done": true,
  "response": {
    "@type": "type.googleapis.com/google.protobuf.Empty"
  }
}

如果是 gcloud 和 REST,您可以在 progress 區段中查看每個索引補充陳述式的進度。陳述式陣列中的每個陳述式,在進度陣列中都有對應的欄位。這個進度陣列順序會對應至陳述式陣列的順序。startTime、progressPercent 和 endTime 欄位會隨之填入。請注意,輸出內容不會顯示回填進度完成的預估時間。

如果作業時間過長,可以取消。詳情請參閱「取消建立索引」。

查看索引補充進度的情境

嘗試查看索引補充進度時,可能會遇到不同情況。需要索引補充作業的索引建立陳述式,是結構定義更新作業的一部分,而結構定義更新作業可能包含多個陳述式。

第一種情況最簡單,也就是索引建立陳述式是結構定義更新作業中的第一個陳述式。由於索引建立陳述式是第一個陳述式,因此會根據執行順序,最先處理及執行。索引建立陳述式的 startTime 欄位會立即填入結構定義更新作業的開始時間。接著,當索引補充作業的進度超過 0% 時,系統會填入索引建立陳述式的 progressPercent 欄位。最後,提交陳述式後,系統會填入 endTime 欄位。

第二種情況是,索引建立陳述式不是結構定義更新作業中的第一個陳述式。由於執行順序的關係,在先前的陳述式提交之前,系統不會填入與索引建立陳述式相關的任何欄位。與前一個情境類似,提交先前的陳述式後,系統會先填入索引建立陳述式的 startTime 欄位,再填入 progressPercent 欄位。最後,陳述式完成修訂後,系統會填入 endTime 欄位。

取消建立索引

您可以使用 Google Cloud CLI 取消建立索引。如要擷取 Spanner 資料庫的結構定義更新作業清單,請使用 gcloud spanner operations list 指令,並加入 --filter 選項:

gcloud spanner operations list \
    --instance=INSTANCE \
    --database=DATABASE \
    --filter="@TYPE:UpdateDatabaseDdlMetadata"

找出要取消作業的 OPERATION_ID,然後使用 gcloud spanner operations cancel 指令取消作業:

gcloud spanner operations cancel OPERATION_ID \
    --instance=INSTANCE \
    --database=DATABASE

查看現有索引

如要查看資料庫中現有索引的資訊,可以使用Google Cloud 控制台或 Google Cloud CLI:

控制台

  1. 前往 Google Cloud 控制台的 Spanner「Instances」(執行個體) 頁面。

    前往「Instances」(執行個體) 頁面

  2. 按一下要查看的執行個體名稱。

  3. 在左側窗格中,依序點選要查看的資料庫和資料表。

  4. 按一下「Indexes」(索引) 分頁標籤。 Google Cloud 控制台會顯示索引清單。

  5. 選用:如要查看索引的詳細資料 (例如包含的資料欄),請按一下索引名稱。

gcloud

使用 gcloud spanner databases ddl describe 指令:

    gcloud spanner databases ddl describe DATABASE \
        --instance=INSTANCE

gcloud CLI 會輸出資料定義語言 (DDL) 陳述式,用於建立資料庫的資料表和索引。CREATE INDEX 陳述式會說明現有索引。例如:

    --- |-
  CREATE TABLE Singers (
    SingerId INT64 NOT NULL,
    FirstName STRING(1024),
    LastName STRING(1024),
    SingerInfo BYTES(MAX),
  ) PRIMARY KEY(SingerId)
---
  CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName)

使用特定索引查詢

以下各節說明如何在 SQL 陳述式中指定索引,以及如何使用 Spanner 的讀取介面。這些章節中的範例假設您已在 Albums 資料表中新增 MarketingBudget 資料欄,並建立名為 AlbumsByAlbumTitle 的索引:

GoogleSQL

CREATE TABLE Albums (
  SingerId         INT64 NOT NULL,
  AlbumId          INT64 NOT NULL,
  AlbumTitle       STRING(MAX),
  MarketingBudget  INT64,
) PRIMARY KEY (SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

PostgreSQL

CREATE TABLE Albums (
  SingerId         BIGINT NOT NULL,
  AlbumId          BIGINT NOT NULL,
  AlbumTitle       VARCHAR,
  MarketingBudget  BIGINT,
  PRIMARY KEY (SingerId, AlbumId)
) INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

在 SQL 陳述式中指定索引

使用 SQL 查詢 Spanner 資料表時,Spanner 會自動使用任何可能提高查詢效率的索引。因此,您不必為 SQL 查詢指定索引。不過,如果查詢對工作負載至關重要,Google 建議您在 SQL 陳述式中使用 FORCE_INDEX 指令,確保效能更穩定。

在少數情況下,Spanner 可能會選擇導致查詢延遲時間增加的索引。如果您按照 [效能迴歸疑難排解步驟][troubleshooting-query-performance-regressions]操作,並決定嘗試使用其他索引進行查詢,則可以將索引指定為查詢的一部分。

如要在 SQL 陳述式中指定索引,請使用 FORCE_INDEX 提示提供索引指令。索引指令使用下列語法:

GoogleSQL

FROM MyTable@{FORCE_INDEX=MyTableIndex}

PostgreSQL

FROM MyTable /*@ FORCE_INDEX = MyTableIndex */

您也可以使用索引指令,指示 Spanner 掃描基礎資料表,而非使用索引:

GoogleSQL

FROM MyTable@{FORCE_INDEX=_BASE_TABLE}

PostgreSQL

FROM MyTable /*@ FORCE_INDEX = _BASE_TABLE */

您可以使用索引指令,指示 Spanner 掃描具有命名結構定義的資料表中的索引:

GoogleSQL

FROM NAMED_SCHEMA_NAME.TABLE_NAME@{FORCE_INDEX="NAMED_SCHEMA_NAME.TABLE_INDEX_NAME"}

PostgreSQL

FROM NAMED_SCHEMA_NAME.TABLE_NAME /*@ FORCE_INDEX = TABLE_INDEX_NAME */

以下範例顯示指定索引的 SQL 查詢:

GoogleSQL

SELECT AlbumId, AlbumTitle, MarketingBudget
    FROM Albums@{FORCE_INDEX=AlbumsByAlbumTitle}
    WHERE AlbumTitle >= "Aardvark" AND AlbumTitle < "Goo";

PostgreSQL

SELECT AlbumId, AlbumTitle, MarketingBudget
    FROM Albums /*@ FORCE_INDEX = AlbumsByAlbumTitle */
    WHERE AlbumTitle >= 'Aardvark' AND AlbumTitle < 'Goo';

索引指令可能會強制 Spanner 的查詢處理器讀取查詢所需的其他資料欄,但這些資料欄並未儲存在索引中。查詢處理器會彙整索引和基礎資料表,擷取這些資料欄。如要避免這項額外彙整作業,請使用 STORING 子句 (GoogleSQL 方言資料庫) 或 INCLUDE 子句 (PostgreSQL 方言資料庫),將額外資料欄儲存在索引中。

在上述範例中,MarketingBudget 資料欄並未儲存在索引中,但 SQL 查詢會選取這個資料欄。因此,Spanner 必須在基礎資料表中查詢 MarketingBudget 資料欄,然後將其與索引中的資料彙整,才能傳回查詢結果。

如果索引指令有下列任一問題,Spanner 會引發錯誤:

下列範例說明如何編寫及執行查詢,使用索引 AlbumsByAlbumTitle 擷取 AlbumId、AlbumTitle 和 MarketingBudget 的值:

C++

void QueryUsingIndex(google::cloud::spanner::Client client) {
  namespace spanner = ::google::cloud::spanner;

  spanner::SqlStatement select(
      "SELECT AlbumId, AlbumTitle, MarketingBudget"
      " FROM Albums@{FORCE_INDEX=AlbumsByAlbumTitle}"
      " WHERE AlbumTitle >= @start_title AND AlbumTitle < @end_title",
      {{"start_title", spanner::Value("Aardvark")},
       {"end_title", spanner::Value("Goo")}});
  using RowType =
      std::tuple<std::int64_t, std::string, std::optional<std::int64_t>>;
  auto rows = client.ExecuteQuery(std::move(select));
  for (auto& row : spanner::StreamOf<RowType>(rows)) {
    if (!row) throw std::move(row).status();
    std::cout << "AlbumId: " << std::get<0>(*row) << "\t";
    std::cout << "AlbumTitle: " << std::get<1>(*row) << "\t";
    auto marketing_budget = std::get<2>(*row);
    if (marketing_budget) {
      std::cout << "MarketingBudget: " << *marketing_budget << "\n";
    } else {
      std::cout << "MarketingBudget: NULL\n";
    }
  }
  std::cout << "Read completed for [spanner_query_data_with_index]\n";
}

C#


using Google.Cloud.Spanner.Data;
using System.Collections.Generic;
using System.Threading.Tasks;

public class QueryDataWithIndexAsyncSample
{
    public class Album
    {
        public int AlbumId { get; set; }
        public string AlbumTitle { get; set; }
        public long MarketingBudget { get; set; }
    }

    public async Task<List<Album>> QueryDataWithIndexAsync(string projectId, string instanceId, string databaseId,
        string startTitle, string endTitle)
    {
        string connectionString = $"Data Source=projects/{projectId}/instances/{instanceId}/databases/{databaseId}";
        using var connection = new SpannerConnection(connectionString);
        using var cmd = connection.CreateSelectCommand(
            "SELECT AlbumId, AlbumTitle, MarketingBudget FROM Albums@ "
            + "{FORCE_INDEX=AlbumsByAlbumTitle} "
            + $"WHERE AlbumTitle >= @startTitle "
            + $"AND AlbumTitle < @endTitle",
            new SpannerParameterCollection
            {
                { "startTitle", SpannerDbType.String, startTitle },
                { "endTitle", SpannerDbType.String, endTitle }
            });

        var albums = new List<Album>();
        using var reader = await cmd.ExecuteReaderAsync();
        while (await reader.ReadAsync())
        {
            albums.Add(new Album
            {
                AlbumId = reader.GetFieldValue<int>("AlbumId"),
                AlbumTitle = reader.GetFieldValue<string>("AlbumTitle"),
                MarketingBudget = reader.IsDBNull(reader.GetOrdinal("MarketingBudget")) ? 0 : reader.GetFieldValue<long>("MarketingBudget")
            });
        }
        return albums;
    }
}

Go


import (
	"context"
	"fmt"
	"io"
	"strconv"

	"cloud.google.com/go/spanner"
	"google.golang.org/api/iterator"
)

func queryUsingIndex(w io.Writer, db string) error {
	ctx := context.Background()
	client, err := spanner.NewClient(ctx, db)
	if err != nil {
		return err
	}
	defer client.Close()

	stmt := spanner.Statement{
		SQL: `SELECT AlbumId, AlbumTitle, MarketingBudget
			FROM Albums@{FORCE_INDEX=AlbumsByAlbumTitle}
			WHERE AlbumTitle >= @start_title AND AlbumTitle < @end_title`,
		Params: map[string]interface{}{
			"start_title": "Aardvark",
			"end_title":   "Goo",
		},
	}
	iter := client.Single().Query(ctx, stmt)
	defer iter.Stop()
	for {
		row, err := iter.Next()
		if err == iterator.Done {
			break
		}
		if err != nil {
			return err
		}
		var albumID int64
		var marketingBudget spanner.NullInt64
		var albumTitle string
		if err := row.ColumnByName("AlbumId", &albumID); err != nil {
			return err
		}
		if err := row.ColumnByName("AlbumTitle", &albumTitle); err != nil {
			return err
		}
		if err := row.ColumnByName("MarketingBudget", &marketingBudget); err != nil {
			return err
		}
		budget := "NULL"
		if marketingBudget.Valid {
			budget = strconv.FormatInt(marketingBudget.Int64, 10)
		}
		fmt.Fprintf(w, "%d %s %s\n", albumID, albumTitle, budget)
	}
	return nil
}

Java

static void queryUsingIndex(DatabaseClient dbClient) {
  Statement statement =
      Statement
          // We use FORCE_INDEX hint to specify which index to use. For more details see
          // https://cloud.google.com/spanner/docs/query-syntax#from-clause
          .newBuilder(
              "SELECT AlbumId, AlbumTitle, MarketingBudget "
                  + "FROM Albums@{FORCE_INDEX=AlbumsByAlbumTitle} "
                  + "WHERE AlbumTitle >= @StartTitle AND AlbumTitle < @EndTitle")
          // We use @BoundParameters to help speed up frequently executed queries.
          //  For more details see https://cloud.google.com/spanner/docs/sql-best-practices
          .bind("StartTitle")
          .to("Aardvark")
          .bind("EndTitle")
          .to("Goo")
          .build();
  try (ResultSet resultSet = dbClient.singleUse().executeQuery(statement)) {
    while (resultSet.next()) {
      System.out.printf(
          "%d %s %s\n",
          resultSet.getLong("AlbumId"),
          resultSet.getString("AlbumTitle"),
          resultSet.isNull("MarketingBudget") ? "NULL" : resultSet.getLong("MarketingBudget"));
    }
  }
}

Node.js

/**
 * TODO(developer): Uncomment these variables before running the sample.
 */
// const instanceId = 'my-instance';
// const databaseId = 'my-database';
// const projectId = 'my-project-id';
// const startTitle = 'Ardvark';
// const endTitle = 'Goo';

// Imports the Google Cloud Spanner client library
const {Spanner} = require('@google-cloud/spanner');

// Instantiates a client
const spanner = new Spanner({
  projectId: projectId,
});

async function queryDataWithIndex() {
  // Gets a reference to a Cloud Spanner instance and database
  const instance = spanner.instance(instanceId);
  const database = instance.database(databaseId);

  const query = {
    sql: `SELECT AlbumId, AlbumTitle, MarketingBudget
                FROM Albums@{FORCE_INDEX=AlbumsByAlbumTitle}
                WHERE AlbumTitle >= @startTitle AND AlbumTitle <= @endTitle`,
    params: {
      startTitle: startTitle,
      endTitle: endTitle,
    },
  };

  // Queries rows from the Albums table
  try {
    const [rows] = await database.run(query);

    rows.forEach(row => {
      const json = row.toJSON();
      const marketingBudget = json.MarketingBudget
        ? json.MarketingBudget
        : null; // This value is nullable
      console.log(
        `AlbumId: ${json.AlbumId}, AlbumTitle: ${json.AlbumTitle}, MarketingBudget: ${marketingBudget}`,
      );
    });
  } catch (err) {
    console.error('ERROR:', err);
  } finally {
    // Close the database when finished.
    database.close();
  }
}
queryDataWithIndex();

PHP

use Google\Cloud\Spanner\SpannerClient;

/**
 * Queries sample data from the database using SQL and an index.
 *
 * The index must exist before running this sample. You can add the index
 * by running the `add_index` sample or by running this DDL statement against
 * your database:
 *
 *     CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle)
 *
 * Example:
 * ```
 * query_data_with_index($instanceId, $databaseId);
 * ```
 *
 * @param string $instanceId The Spanner instance ID.
 * @param string $databaseId The Spanner database ID.
 * @param string $startTitle The start of the title index.
 * @param string $endTitle   The end of the title index.
 */
function query_data_with_index(
    string $instanceId,
    string $databaseId,
    string $startTitle = 'Aardvark',
    string $endTitle = 'Goo'
): void {
    $spanner = new SpannerClient();
    $instance = $spanner->instance($instanceId);
    $database = $instance->database($databaseId);

    $parameters = [
        'startTitle' => $startTitle,
        'endTitle' => $endTitle
    ];

    $results = $database->execute(
        'SELECT AlbumId, AlbumTitle, MarketingBudget ' .
        'FROM Albums@{FORCE_INDEX=AlbumsByAlbumTitle} ' .
        'WHERE AlbumTitle >= @startTitle AND AlbumTitle < @endTitle',
        ['parameters' => $parameters]
    );

    foreach ($results as $row) {
        printf('AlbumId: %s, AlbumTitle: %s, MarketingBudget: %d' . PHP_EOL,
            $row['AlbumId'], $row['AlbumTitle'], $row['MarketingBudget']);
    }
}

Python

def query_data_with_index(
    instance_id, database_id, start_title="Aardvark", end_title="Goo"
):
    """Queries sample data from the database using SQL and an index.

    The index must exist before running this sample. You can add the index
    by running the `add_index` sample or by running this DDL statement against
    your database:

        CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle)

    This sample also uses the `MarketingBudget` column. You can add the column
    by running the `add_column` sample or by running this DDL statement against
    your database:

        ALTER TABLE Albums ADD COLUMN MarketingBudget INT64

    """
    spanner_client = spanner.Client()
    instance = spanner_client.instance(instance_id)
    database = instance.database(database_id)

    params = {"start_title": start_title, "end_title": end_title}
    param_types = {
        "start_title": spanner.param_types.STRING,
        "end_title": spanner.param_types.STRING,
    }

    with database.snapshot() as snapshot:
        results = snapshot.execute_sql(
            "SELECT AlbumId, AlbumTitle, MarketingBudget "
            "FROM Albums@{FORCE_INDEX=AlbumsByAlbumTitle} "
            "WHERE AlbumTitle >= @start_title AND AlbumTitle < @end_title",
            params=params,
            param_types=param_types,
        )

        for row in results:
            print("AlbumId: {}, AlbumTitle: {}, " "MarketingBudget: {}".format(*row))

小茹

# project_id  = "Your Google Cloud project ID"
# instance_id = "Your Spanner instance ID"
# database_id = "Your Spanner database ID"
# start_title = "An album title to start with such as 'Ardvark'"
# end_title   = "An album title to end with such as 'Goo'"

require "google/cloud/spanner"

spanner = Google::Cloud::Spanner.new project: project_id
client  = spanner.client instance_id, database_id

sql_query = "SELECT AlbumId, AlbumTitle, MarketingBudget
             FROM Albums@{FORCE_INDEX=AlbumsByAlbumTitle}
             WHERE AlbumTitle >= @start_title AND AlbumTitle < @end_title"

params      = { start_title: start_title, end_title: end_title }
param_types = { start_title: :STRING,     end_title: :STRING }

client.execute(sql_query, params: params, types: param_types).rows.each do |row|
  puts "#{row[:AlbumId]} #{row[:AlbumTitle]} #{row[:MarketingBudget]}"
end

在讀取介面中指定索引

使用 Spanner 的讀取介面時,如要 Spanner 使用索引,則必須指定索引。讀取介面不會自動選取索引。

此外,索引必須包含查詢結果中顯示的所有資料,但不包括主鍵中的資料欄。這項限制是因為讀取介面不支援索引和基礎資料表之間的彙整。如需在查詢結果中加入其他資料欄,可以採取下列幾種做法:

  • 使用 STORING 或 INCLUDE 子句,將其他資料欄儲存在索引中。
  • 查詢時不納入額外資料欄,然後使用主鍵傳送另一個查詢,讀取額外資料欄。

Spanner 會依索引鍵,以遞增排列順序傳回索引中的值。如要以遞減順序擷取值,請完成下列步驟:

  • 使用 DESC 為索引鍵加上註解。例如:

    CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle DESC);
    

    DESC 註解適用於單一索引鍵。如果索引包含多個鍵,且您希望查詢結果依據所有鍵以遞減順序顯示,請為每個鍵加入 DESC 註解。

  • 如果讀取作業指定了鍵範圍,請確保鍵範圍也按照遞減順序排列。換句話說,起始鍵的值必須大於結束鍵的值。

以下範例說明如何使用索引 AlbumsByAlbumTitle 擷取 AlbumId 和 AlbumTitle 的值:

C++

void ReadDataWithIndex(google::cloud::spanner::Client client) {
  namespace spanner = ::google::cloud::spanner;

  auto rows =
      client.Read("Albums", google::cloud::spanner::KeySet::All(),
                  {"AlbumId", "AlbumTitle"},
                  google::cloud::Options{}.set<spanner::ReadIndexNameOption>(
                      "AlbumsByAlbumTitle"));
  using RowType = std::tuple<std::int64_t, std::string>;
  for (auto& row : spanner::StreamOf<RowType>(rows)) {
    if (!row) throw std::move(row).status();
    std::cout << "AlbumId: " << std::get<0>(*row) << "\t";
    std::cout << "AlbumTitle: " << std::get<1>(*row) << "\n";
  }
  std::cout << "Read completed for [spanner_read_data_with_index]\n";
}

C#


using Google.Cloud.Spanner.Data;
using System.Collections.Generic;
using System.Threading.Tasks;

public class QueryDataWithIndexAsyncSample
{
    public class Album
    {
        public int AlbumId { get; set; }
        public string AlbumTitle { get; set; }
        public long MarketingBudget { get; set; }
    }

    public async Task<List<Album>> QueryDataWithIndexAsync(string projectId, string instanceId, string databaseId,
        string startTitle, string endTitle)
    {
        string connectionString = $"Data Source=projects/{projectId}/instances/{instanceId}/databases/{databaseId}";
        using var connection = new SpannerConnection(connectionString);
        using var cmd = connection.CreateSelectCommand(
            "SELECT AlbumId, AlbumTitle, MarketingBudget FROM Albums@ "
            + "{FORCE_INDEX=AlbumsByAlbumTitle} "
            + $"WHERE AlbumTitle >= @startTitle "
            + $"AND AlbumTitle < @endTitle",
            new SpannerParameterCollection
            {
                { "startTitle", SpannerDbType.String, startTitle },
                { "endTitle", SpannerDbType.String, endTitle }
            });

        var albums = new List<Album>();
        using var reader = await cmd.ExecuteReaderAsync();
        while (await reader.ReadAsync())
        {
            albums.Add(new Album
            {
                AlbumId = reader.GetFieldValue<int>("AlbumId"),
                AlbumTitle = reader.GetFieldValue<string>("AlbumTitle"),
                MarketingBudget = reader.IsDBNull(reader.GetOrdinal("MarketingBudget")) ? 0 : reader.GetFieldValue<long>("MarketingBudget")
            });
        }
        return albums;
    }
}

Go


import (
	"context"
	"fmt"
	"io"

	"cloud.google.com/go/spanner"
	"google.golang.org/api/iterator"
)

func readUsingIndex(w io.Writer, db string) error {
	ctx := context.Background()
	client, err := spanner.NewClient(ctx, db)
	if err != nil {
		return err
	}
	defer client.Close()

	iter := client.Single().ReadUsingIndex(ctx, "Albums", "AlbumsByAlbumTitle", spanner.AllKeys(),
		[]string{"AlbumId", "AlbumTitle"})
	defer iter.Stop()
	for {
		row, err := iter.Next()
		if err == iterator.Done {
			return nil
		}
		if err != nil {
			return err
		}
		var albumID int64
		var albumTitle string
		if err := row.Columns(&albumID, &albumTitle); err != nil {
			return err
		}
		fmt.Fprintf(w, "%d %s\n", albumID, albumTitle)
	}
}

Java

static void readUsingIndex(DatabaseClient dbClient) {
  try (ResultSet resultSet =
      dbClient
          .singleUse()
          .readUsingIndex(
              "Albums",
              "AlbumsByAlbumTitle",
              KeySet.all(),
              Arrays.asList("AlbumId", "AlbumTitle"))) {
    while (resultSet.next()) {
      System.out.printf("%d %s\n", resultSet.getLong(0), resultSet.getString(1));
    }
  }
}

Node.js

/**
 * TODO(developer): Uncomment these variables before running the sample.
 */
// const instanceId = 'my-instance';
// const databaseId = 'my-database';
// const projectId = 'my-project-id';

// Imports the Google Cloud Spanner client library
const {Spanner} = require('@google-cloud/spanner');

// Instantiates a client
const spanner = new Spanner({
  projectId: projectId,
});

async function readDataWithIndex() {
  // Gets a reference to a Cloud Spanner instance and database
  const instance = spanner.instance(instanceId);
  const database = instance.database(databaseId);

  const albumsTable = database.table('Albums');

  const query = {
    columns: ['AlbumId', 'AlbumTitle'],
    keySet: {
      all: true,
    },
    index: 'AlbumsByAlbumTitle',
  };

  // Reads the Albums table using an index
  try {
    const [rows] = await albumsTable.read(query);

    rows.forEach(row => {
      const json = row.toJSON();
      console.log(`AlbumId: ${json.AlbumId}, AlbumTitle: ${json.AlbumTitle}`);
    });
  } catch (err) {
    console.error('ERROR:', err);
  } finally {
    // Close the database when finished.
    database.close();
  }
}
readDataWithIndex();

PHP

use Google\Cloud\Spanner\SpannerClient;

/**
 * Reads sample data from the database using an index.
 *
 * The index must exist before running this sample. You can add the index
 * by running the `add_index` sample or by running this DDL statement against
 * your database:
 *
 *     CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle)
 *
 * Example:
 * ```
 * read_data_with_index($instanceId, $databaseId);
 * ```
 *
 * @param string $instanceId The Spanner instance ID.
 * @param string $databaseId The Spanner database ID.
 */
function read_data_with_index(string $instanceId, string $databaseId): void
{
    $spanner = new SpannerClient();
    $instance = $spanner->instance($instanceId);
    $database = $instance->database($databaseId);

    $keySet = $spanner->keySet(['all' => true]);
    $results = $database->read(
        'Albums',
        $keySet,
        ['AlbumId', 'AlbumTitle'],
        ['index' => 'AlbumsByAlbumTitle']
    );

    foreach ($results->rows() as $row) {
        printf('AlbumId: %s, AlbumTitle: %s' . PHP_EOL,
            $row['AlbumId'], $row['AlbumTitle']);
    }
}

Python

def read_data_with_index(instance_id, database_id):
    """Reads sample data from the database using an index.

    The index must exist before running this sample. You can add the index
    by running the `add_index` sample or by running this DDL statement against
    your database:

        CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle)

    """
    spanner_client = spanner.Client()
    instance = spanner_client.instance(instance_id)
    database = instance.database(database_id)

    with database.snapshot() as snapshot:
        keyset = spanner.KeySet(all_=True)
        results = snapshot.read(
            table="Albums",
            columns=("AlbumId", "AlbumTitle"),
            keyset=keyset,
            index="AlbumsByAlbumTitle",
        )

        for row in results:
            print("AlbumId: {}, AlbumTitle: {}".format(*row))

小茹

# project_id  = "Your Google Cloud project ID"
# instance_id = "Your Spanner instance ID"
# database_id = "Your Spanner database ID"

require "google/cloud/spanner"

spanner = Google::Cloud::Spanner.new project: project_id
client  = spanner.client instance_id, database_id

result = client.read "Albums", [:AlbumId, :AlbumTitle],
                     index: "AlbumsByAlbumTitle"

result.rows.each do |row|
  puts "#{row[:AlbumId]} #{row[:AlbumTitle]}"
end

建立索引,以便執行僅限索引掃描

您也可以視需要使用 STORING 子句 (適用於 GoogleSQL 方言資料庫) 或 INCLUDE 子句 (適用於 PostgreSQL 方言資料庫),在索引中儲存資料欄副本。這類索引可為使用索引的查詢和讀取呼叫提供優勢,但會耗用額外儲存空間:

  • 如果 SQL 查詢使用索引,並選取儲存在 STORING 或 INCLUDE 子句中的資料欄,就不需要額外彙整至基礎資料表。
  • 使用索引的 read() 呼叫可以讀取 STORING/INCLUDE 子句儲存的資料欄。

舉例來說,假設您建立了 AlbumsByAlbumTitle 的替代版本,將 MarketingBudget 資料欄的副本儲存在索引中 (請注意粗體的 STORING 或 INCLUDE 子句):

GoogleSQL

CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);

PostgreSQL

CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) INCLUDE (MarketingBudget);

使用舊的 AlbumsByAlbumTitle 索引時,Spanner 必須將索引與基礎資料表彙整,然後從基礎資料表擷取資料欄。有了新的 AlbumsByAlbumTitle2 索引,Spanner 就能直接從索引讀取資料欄,效率更高。

如果您使用讀取介面而非 SQL,新的 AlbumsByAlbumTitle2 索引也可讓您直接讀取 MarketingBudget 資料欄:

C++

void ReadDataWithStoringIndex(google::cloud::spanner::Client client) {
  namespace spanner = ::google::cloud::spanner;

  auto rows =
      client.Read("Albums", google::cloud::spanner::KeySet::All(),
                  {"AlbumId", "AlbumTitle", "MarketingBudget"},
                  google::cloud::Options{}.set<spanner::ReadIndexNameOption>(
                      "AlbumsByAlbumTitle2"));
  using RowType =
      std::tuple<std::int64_t, std::string, std::optional<std::int64_t>>;
  for (auto& row : spanner::StreamOf<RowType>(rows)) {
    if (!row) throw std::move(row).status();
    std::cout << "AlbumId: " << std::get<0>(*row) << "\t";
    std::cout << "AlbumTitle: " << std::get<1>(*row) << "\t";
    auto marketing_budget = std::get<2>(*row);
    if (marketing_budget) {
      std::cout << "MarketingBudget: " << *marketing_budget << "\n";
    } else {
      std::cout << "MarketingBudget: NULL\n";
    }
  }
  std::cout << "Read completed for [spanner_read_data_with_storing_index]\n";
}

C#


using Google.Cloud.Spanner.Data;
using System.Collections.Generic;
using System.Threading.Tasks;

public class QueryDataWithStoringIndexAsyncSample
{
    public class Album
    {
        public int AlbumId { get; set; }
        public string AlbumTitle { get; set; }
        public long? MarketingBudget { get; set; }
    }

    public async Task<List<Album>> QueryDataWithStoringIndexAsync(string projectId, string instanceId, string databaseId)
    {
        string connectionString = $"Data Source=projects/{projectId}/instances/{instanceId}/databases/{databaseId}";

        using var connection = new SpannerConnection(connectionString);
        var cmd = connection.CreateSelectCommand(
            "SELECT AlbumId, AlbumTitle, MarketingBudget FROM Albums@ "
            + "{FORCE_INDEX=AlbumsByAlbumTitle2}");

        var albums = new List<Album>();
        using var reader = await cmd.ExecuteReaderAsync();
        while (await reader.ReadAsync())
        {
            albums.Add(new Album
            {
                AlbumId = reader.GetFieldValue<int>("AlbumId"),
                AlbumTitle = reader.GetFieldValue<string>("AlbumTitle"),
                MarketingBudget = reader.IsDBNull(reader.GetOrdinal("MarketingBudget")) ? 0 : reader.GetFieldValue<long>("MarketingBudget")
            });
        }
        return albums;
    }
}

Go


import (
	"context"
	"fmt"
	"io"
	"strconv"

	"cloud.google.com/go/spanner"
	"google.golang.org/api/iterator"
)

func readStoringIndex(w io.Writer, db string) error {
	ctx := context.Background()
	client, err := spanner.NewClient(ctx, db)
	if err != nil {
		return err
	}
	defer client.Close()

	iter := client.Single().ReadUsingIndex(ctx, "Albums", "AlbumsByAlbumTitle2", spanner.AllKeys(),
		[]string{"AlbumId", "AlbumTitle", "MarketingBudget"})
	defer iter.Stop()
	for {
		row, err := iter.Next()
		if err == iterator.Done {
			return nil
		}
		if err != nil {
			return err
		}
		var albumID int64
		var marketingBudget spanner.NullInt64
		var albumTitle string
		if err := row.Columns(&albumID, &albumTitle, &marketingBudget); err != nil {
			return err
		}
		budget := "NULL"
		if marketingBudget.Valid {
			budget = strconv.FormatInt(marketingBudget.Int64, 10)
		}
		fmt.Fprintf(w, "%d %s %s\n", albumID, albumTitle, budget)
	}
}

Java

static void readStoringIndex(DatabaseClient dbClient) {
  // We can read MarketingBudget also from the index since it stores a copy of MarketingBudget.
  try (ResultSet resultSet =
      dbClient
          .singleUse()
          .readUsingIndex(
              "Albums",
              "AlbumsByAlbumTitle2",
              KeySet.all(),
              Arrays.asList("AlbumId", "AlbumTitle", "MarketingBudget"))) {
    while (resultSet.next()) {
      System.out.printf(
          "%d %s %s\n",
          resultSet.getLong(0),
          resultSet.getString(1),
          resultSet.isNull("MarketingBudget") ? "NULL" : resultSet.getLong("MarketingBudget"));
    }
  }
}

Node.js

/**
 * TODO(developer): Uncomment these variables before running the sample.
 */
// const instanceId = 'my-instance';
// const databaseId = 'my-database';
// const projectId = 'my-project-id';

// Imports the Google Cloud Spanner client library
const {Spanner} = require('@google-cloud/spanner');

// Instantiates a client
const spanner = new Spanner({
  projectId: projectId,
});

// "Storing" indexes store copies of the columns they index
// This speeds up queries, but takes more space compared to normal indexes
// See the link below for more information:
// https://cloud.google.com/spanner/docs/secondary-indexes#storing_clause
async function readDataWithStoringIndex() {
  // Gets a reference to a Cloud Spanner instance and database
  const instance = spanner.instance(instanceId);
  const database = instance.database(databaseId);

  const albumsTable = database.table('Albums');

  const query = {
    columns: ['AlbumId', 'AlbumTitle', 'MarketingBudget'],
    keySet: {
      all: true,
    },
    index: 'AlbumsByAlbumTitle2',
  };

  // Reads the Albums table using a storing index
  try {
    const [rows] = await albumsTable.read(query);

    rows.forEach(row => {
      const json = row.toJSON();
      let rowString = `AlbumId: ${json.AlbumId}`;
      rowString += `, AlbumTitle: ${json.AlbumTitle}`;
      if (json.MarketingBudget) {
        rowString += `, MarketingBudget: ${json.MarketingBudget}`;
      }
      console.log(rowString);
    });
  } catch (err) {
    console.error('ERROR:', err);
  } finally {
    // Close the database when finished.
    database.close();
  }
}
readDataWithStoringIndex();

PHP

use Google\Cloud\Spanner\SpannerClient;

/**
 * Reads sample data from the database using an index with a storing
 * clause.
 *
 * The index must exist before running this sample. You can add the index
 * by running the `add_storing_index` sample or by running this DDL statement
 * against your database:
 *
 *     CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle)
 *     STORING (MarketingBudget)
 *
 * Example:
 * ```
 * read_data_with_storing_index($instanceId, $databaseId);
 * ```
 *
 * @param string $instanceId The Spanner instance ID.
 * @param string $databaseId The Spanner database ID.
 */
function read_data_with_storing_index(string $instanceId, string $databaseId): void
{
    $spanner = new SpannerClient();
    $instance = $spanner->instance($instanceId);
    $database = $instance->database($databaseId);

    $keySet = $spanner->keySet(['all' => true]);
    $results = $database->read(
        'Albums',
        $keySet,
        ['AlbumId', 'AlbumTitle', 'MarketingBudget'],
        ['index' => 'AlbumsByAlbumTitle2']
    );

    foreach ($results->rows() as $row) {
        printf('AlbumId: %s, AlbumTitle: %s, MarketingBudget: %d' . PHP_EOL,
            $row['AlbumId'], $row['AlbumTitle'], $row['MarketingBudget']);
    }
}

Python

def read_data_with_storing_index(instance_id, database_id):
    """Reads sample data from the database using an index with a storing
    clause.

    The index must exist before running this sample. You can add the index
    by running the `add_scoring_index` sample or by running this DDL statement
    against your database:

        CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle)
        STORING (MarketingBudget)

    """
    spanner_client = spanner.Client()
    instance = spanner_client.instance(instance_id)
    database = instance.database(database_id)

    with database.snapshot() as snapshot:
        keyset = spanner.KeySet(all_=True)
        results = snapshot.read(
            table="Albums",
            columns=("AlbumId", "AlbumTitle", "MarketingBudget"),
            keyset=keyset,
            index="AlbumsByAlbumTitle2",
        )

        for row in results:
            print("AlbumId: {}, AlbumTitle: {}, " "MarketingBudget: {}".format(*row))

小茹

# project_id  = "Your Google Cloud project ID"
# instance_id = "Your Spanner instance ID"
# database_id = "Your Spanner database ID"

require "google/cloud/spanner"

spanner = Google::Cloud::Spanner.new project: project_id
client  = spanner.client instance_id, database_id

result = client.read "Albums", [:AlbumId, :AlbumTitle, :MarketingBudget],
                     index: "AlbumsByAlbumTitle2"

result.rows.each do |row|
  puts "#{row[:AlbumId]} #{row[:AlbumTitle]} #{row[:MarketingBudget]}"
end

修改索引

您可以使用 ALTER INDEX 陳述式,在現有索引中新增或刪除資料欄。這項操作可更新建立索引時,由 STORING 子句 (GoogleSQL 方言資料庫) 或 INCLUDE 子句 (PostgreSQL 方言資料庫) 定義的資料欄清單。您無法使用這個陳述式,在索引鍵中新增或捨棄資料欄。舉例來說,您可以使用 ALTER INDEX 將資料欄新增至 AlbumsByAlbumTitle,而不是建立新的索引 AlbumsByAlbumTitle2,如以下範例所示:

GoogleSQL

ALTER INDEX AlbumsByAlbumTitle ADD STORED COLUMN MarketingBudget

PostgreSQL

ALTER INDEX AlbumsByAlbumTitle ADD INCLUDE COLUMN MarketingBudget

將新資料欄新增至現有索引時,Spanner 會使用背景回填程序。在補充期間,索引中的資料欄無法讀取,因此可能無法達到預期的效能提升。您可以使用 gcloud spanner operations 指令列出長時間執行的作業並查看其狀態。詳情請參閱「說明作業」。

您也可以使用取消作業,取消執行中的作業。

完成後,Spanner 會將資料欄新增至索引。隨著索引變大,使用索引的查詢速度可能會變慢。

以下範例說明如何從索引中捨棄資料欄:

GoogleSQL

ALTER INDEX AlbumsByAlbumTitle DROP STORED COLUMN MarketingBudget

PostgreSQL

ALTER INDEX AlbumsByAlbumTitle DROP INCLUDE COLUMN MarketingBudget

空值索引

根據預設,Spanner 會為 NULL 值建立索引。舉例來說,回想一下資料表 Singers 的索引 SingersByFirstLastName 定義:

CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);

即使 FirstName 或 LastName (或兩者) 為 NULL,系統仍會為 Singers 的所有資料列建立索引。
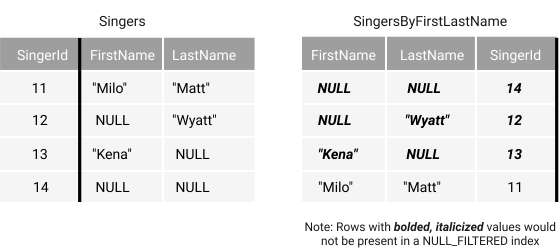
顯示從 NULL 篩選索引中省略的資料列。

為 NULL 值建立索引後,您就能對包含 NULL 值的資料執行高效的 SQL 查詢和讀取作業。舉例來說,使用這個 SQL 查詢陳述式,找出所有 NULL FirstName 的 Singers:

GoogleSQL

SELECT s.SingerId, s.FirstName, s.LastName
    FROM Singers@{FORCE_INDEX=SingersByFirstLastName} AS s
    WHERE s.FirstName IS NULL;

PostgreSQL

SELECT s.SingerId, s.FirstName, s.LastName
    FROM Singers /* @ FORCE_INDEX = SingersByFirstLastName */ AS s
    WHERE s.FirstName IS NULL;

空值的排列順序

Spanner 會將 NULL 視為任何指定類型的最小值。如果資料欄依遞增 (ASC) 順序排列,NULL 值會排在最前面。如果資料欄依遞減 (DESC) 順序排列,NULL 值會排在最後。

停用 NULL 值索引

GoogleSQL

如要停止為 null 值建立索引,請在索引定義中加入 NULL_FILTERED 這個關鍵字。NULL_FILTERED 索引特別適合用於為稀疏資料欄建立索引,其中大多數資料列都包含 NULL 值。在這種情況下,NULL_FILTERED 索引會比包含 NULL 值的正常索引小得多,維護效率也更高。

以下是 SingersByFirstLastName 的替代定義,不會為 NULL 值建立索引:

CREATE NULL_FILTERED INDEX SingersByFirstLastNameNoNulls
    ON Singers(FirstName, LastName);

NULL_FILTERED 關鍵字適用於所有索引鍵資料欄。您無法依資料欄指定NULL篩選。

PostgreSQL

如要篩除一或多個索引資料欄中含有空值的資料列,請使用 WHERE COLUMN IS NOT NULL 述詞。如果資料欄稀疏,且大多數資料列都包含 NULL 值,則特別適合使用空值篩選索引。在這種情況下,與包含 NULL 值的正常索引相比,空值篩選索引可能更小,維護效率也更高。

以下是 SingersByFirstLastName 的替代定義,不會為 NULL 值建立索引:

CREATE INDEX SingersByFirstLastNameNoNulls
    ON Singers(FirstName, LastName)
    WHERE FirstName IS NOT NULL
    AND LastName IS NOT NULL;

篩除 NULL 值可防止 Spanner 在某些查詢中使用該值。舉例來說,Spanner 不會將索引套用至這項查詢,因為索引會省略 LastName 為 NULL 的任何 Singers 資料列。因此,如果使用索引,查詢就無法傳回正確的資料列:

GoogleSQL

FROM Singers@{FORCE_INDEX=SingersByFirstLastNameNoNulls}
    WHERE FirstName = "John";

PostgreSQL

FROM Singers /*@ FORCE_INDEX = SingersByFirstLastNameNoNulls */
    WHERE FirstName = 'John';

如要讓 Spanner 使用索引,您必須重寫查詢,排除索引中也排除的資料列:

GoogleSQL

SELECT FirstName, LastName
    FROM Singers@{FORCE_INDEX=SingersByFirstLastNameNoNulls}
    WHERE FirstName = 'John' AND LastName IS NOT NULL;

PostgreSQL

SELECT FirstName, LastName
    FROM Singers /*@ FORCE_INDEX = SingersByFirstLastNameNoNulls */
    WHERE FirstName = 'John' AND LastName IS NOT NULL;

索引 proto 欄位

只要索引欄位使用原始或 ENUM 資料類型,您就能使用產生的資料欄,為儲存在 PROTO 資料欄中的通訊協定緩衝區欄位建立索引。

如果您在通訊協定訊息欄位定義索引,就無法從 Proto 結構定義修改或移除該欄位。詳情請參閱「更新包含 proto 欄位索引的結構定義」。

以下是 Singers 資料表的範例,其中包含 SingerInfo proto 訊息資料欄。如要在 PROTO 的 nationality 欄位定義索引,您需要建立儲存的生成資料欄:

GoogleSQL

CREATE PROTO BUNDLE (googlesql.example.SingerInfo, googlesql.example.SingerInfo.Residence);

CREATE TABLE Singers (
  SingerId INT64 NOT NULL,
  ...
  SingerInfo googlesql.example.SingerInfo,
  SingerNationality STRING(MAX) AS (SingerInfo.nationality) STORED
) PRIMARY KEY (SingerId);

其中包含 googlesql.example.SingerInfo Proto 類型的定義:

GoogleSQL

package googlesql.example;

message SingerInfo {
optional string    nationality = 1;
repeated Residence residence   = 2;

  message Residence {
    required int64  start_year   = 1;
    optional int64  end_year     = 2;
    optional string city         = 3;
    optional string country      = 4;
  }
}

接著,在 proto 的 nationality 欄位定義索引:

GoogleSQL

CREATE INDEX SingersByNationality ON Singers(SingerNationality);

下列 SQL 查詢會使用先前的索引讀取資料:

GoogleSQL

SELECT s.SingerId, s.FirstName
FROM Singers AS s
WHERE s.SingerNationality = "English";

注意:

  • 使用索引指令,存取通訊協定緩衝區資料欄欄位的索引。
  • 您無法在重複的通訊協定緩衝區欄位上建立索引。

更新包含 proto 欄位索引的結構定義

如果您在通訊協定訊息欄位定義索引,就無法從 proto 結構定義修改或移除該欄位。這是因為定義索引後,每次更新結構定義時,系統都會執行類型檢查。Spanner 會擷取路徑中所有欄位的類型資訊,這些欄位用於索引定義。

不重複的查詢

索引可以宣告為 UNIQUE。UNIQUE 索引會對要建立索引的資料新增限制,禁止指定索引鍵出現重複項目。Spanner 會在交易提交時強制執行這項限制。具體來說,如果任何交易會導致同一個索引鍵有多個索引項目,則無法提交。

如果資料表中的第一個物件包含非 UNIQUE 資料,將無法建立 UNIQUE 索引。

UNIQUE NULL_FILTERED 索引注意事項

如果索引的鍵部分至少有一個為 NULL,UNIQUE NULL_FILTERED 索引就不會強制要求索引鍵不重複。

舉例來說,假設您建立了下列資料表和索引:

GoogleSQL

CREATE TABLE ExampleTable (
  Key1 INT64 NOT NULL,
  Key2 INT64,
  Key3 INT64,
  Col1 INT64,
) PRIMARY KEY (Key1, Key2, Key3);

CREATE UNIQUE NULL_FILTERED INDEX ExampleIndex ON ExampleTable (Key1, Key2, Col1);

PostgreSQL

CREATE TABLE ExampleTable (
  Key1 BIGINT NOT NULL,
  Key2 BIGINT,
  Key3 BIGINT,
  Col1 BIGINT,
  PRIMARY KEY (Key1, Key2, Key3)
);

CREATE UNIQUE INDEX ExampleIndex ON ExampleTable (Key1, Key2, Col1)
    WHERE Key1 IS NOT NULL
    AND Key2 IS NOT NULL
    AND Col1 IS NOT NULL;

ExampleTable 中的下列兩個資料列,其次要索引鍵 Key1、Key2 和 Col1 具有相同的值:

1, NULL, 1, 1
1, NULL, 2, 1

由於 Key2 為 NULL,且索引已篩除空值,因此資料列不會出現在索引 ExampleIndex 中。由於這些資料不會插入索引,因此索引不會因違反 (Key1, Key2, Col1) 的唯一性而拒絕這些資料。

如要讓索引強制執行元組 (Key1、Key2、Col1) 值的唯一性,則必須在資料表定義中以 NOT NULL 註解 Key2,或在不篩選空值的情況下建立索引。

根據純量運算式建立索引

運算式索引可讓您根據純量運算式建立索引,並套用至一或多個資料表資料欄。這項功能的好處在於,您不必為了建立索引,而在資料表中建立及維護專用的生成資料欄。

產生的資料欄和運算式索引,可用於為 JSON 資料欄中的特定欄位建立索引。您可以針對從 JSON 物件擷取的值建立索引,讓查詢最佳化工具根據該值有效率地執行查詢。

在這個範例中,系統會根據 JSON 中的 city 欄位,建立名為 VenueCity 的生成資料欄,其唯一用途是放入索引:

GoogleSQL

CREATE TABLE Venues (
  Id INT64 NOT NULL,
  VenueData JSON,
  VenueCity STRING AS (JSON_VALUE(VenueData.address.city))
) PRIMARY KEY (Id);

CREATE INDEX VenuesByCity ON Venues(VenueCity);

PostgreSQL

CREATE TABLE Venues (
  Id BIGINT NOT NULL PRIMARY KEY,
  VenueData JSONB,
  VenueCity VARCHAR GENERATED ALWAYS AS (VenueData -> 'address' ->> 'city')
);

CREATE INDEX VenuesByCity ON Venues(VenueCity);

如要更有效率地達成這個目標,您可以直接定義索引,Spanner 會在背景處理基礎機制:

GoogleSQL

CREATE TABLE Venues (
  Id INT64 NOT NULL,
  VenueData JSON
) PRIMARY KEY (Id);

CREATE INDEX VenuesByCity ON Venues((JSON_VALUE(VenueData.address.city)));

PostgreSQL

CREATE TABLE Venues (
  Id BIGINT NOT NULL PRIMARY KEY,
  VenueData JSONB
);

CREATE INDEX VenuesByCity ON Venues((VenueData -> 'address' ->> 'city'));

在這兩種情況下,查詢都可以使用 VenuesByCity 索引加快執行速度:

GoogleSQL

SELECT Id
FROM Venues
WHERE JSON_VALUE(VenueData.address.city) = 'Seattle';

PostgreSQL

SELECT Id
FROM Venues
WHERE VenueData -> 'address' ->> 'city' = 'Seattle';

運算式索引可以包含運算式和直接資料欄參照的資料欄。這樣一來,更多查詢就能使用索引,加快執行速度。

GoogleSQL

CREATE TABLE Venues (
  Id INT64 NOT NULL,
  VenueName STRING(MAX),
  VenueData JSON
) PRIMARY KEY (Id);

CREATE INDEX VenuesByCity ON Venues(
  VenueName,
  (JSON_VALUE(VenueData.address.city)),
  (JSON_VALUE(VenueData.address.state))
);

PostgreSQL

CREATE TABLE Venues (
  Id BIGINT NOT NULL PRIMARY KEY,
  VenueName VARCHAR,
  VenueData JSONB
);

CREATE INDEX VenuesIdx ON Venues(
  VenueName,
  (VenueData -> 'address' ->> 'city'),
  (VenueData -> 'address' ->> 'state'),
);

捨棄索引

使用 DROP INDEX 陳述式,從結構定義中捨棄次要索引。

如要捨棄名為 SingersByFirstLastName 的索引,請執行下列操作:

DROP INDEX SingersByFirstLastName;

建立索引,加快掃描速度

當 Spanner 需要執行資料表掃描 (而非索引查詢) 來擷取一或多個資料欄的值時,如果這些資料欄有索引,且按照查詢指定的順序排列,您就能更快取得結果。如果您經常執行需要掃描的查詢,建議建立次要索引,提高掃描效率。

特別是,如果您需要 Spanner 頻繁地以反向順序掃描資料表的主鍵或其他索引,則可以透過次要索引提高其效率,使所選順序明確。

舉例來說,下列查詢一律會快速傳回結果,即使 Spanner 需要掃描 Songs 才能找出 SongId 的最低值:

SELECT SongId FROM Songs LIMIT 1;

SongId 是資料表的主鍵,會以遞增順序儲存 (與所有主鍵相同)。Spanner 可以掃描該鍵的索引,並快速找到第一個結果。

不過,如果沒有次要索引,下列查詢就不會那麼快傳回結果,尤其是 Songs 包含大量資料時:

SELECT SongId FROM Songs ORDER BY SongId DESC LIMIT 1;

雖然 SongId 是資料表的主鍵,但 Spanner 無法在不進行完整資料表掃描的情況下,擷取資料欄的最大值。

新增下列索引,可讓這項查詢更快傳回結果:

CREATE INDEX SongIdDesc On Songs(SongId DESC);

有了這個索引,Spanner 就能使用它,更快傳回第二個查詢的結果。

後續步驟