


本頁說明如何在 Spanner Graph 中管理無結構定義資料。此外,也提供最佳做法和疑難排解提示。建議您熟悉 Spanner Graph 結構定義和查詢。
無結構定義的資料管理功能可讓您建立彈性的圖表定義。您可以新增、更新或刪除節點和邊緣類型定義,不需變更結構定義。這種做法支援疊代開發,並減少結構定義管理負擔,同時保留熟悉的圖形查詢體驗。
無結構定義資料管理適用於下列情境:
管理經常變更的圖形,例如更新及新增元素標籤和屬性。
圖表包含多種節點和邊緣類型,因此建立及管理輸入表格相當繁瑣。
如要進一步瞭解何時應使用無結構定義資料管理,請參閱「無結構定義資料管理注意事項」。
建立無結構定義資料的模型
Spanner Graph 可讓您從資料表建立圖譜,將資料列對應至節點和邊緣。無結構定義的資料模型通常會使用單一節點資料表和單一邊緣資料表,並為標籤使用 STRING 資料欄,為屬性使用 JSON 資料欄,而不是為每個元素類型使用個別資料表。
建立輸入資料表
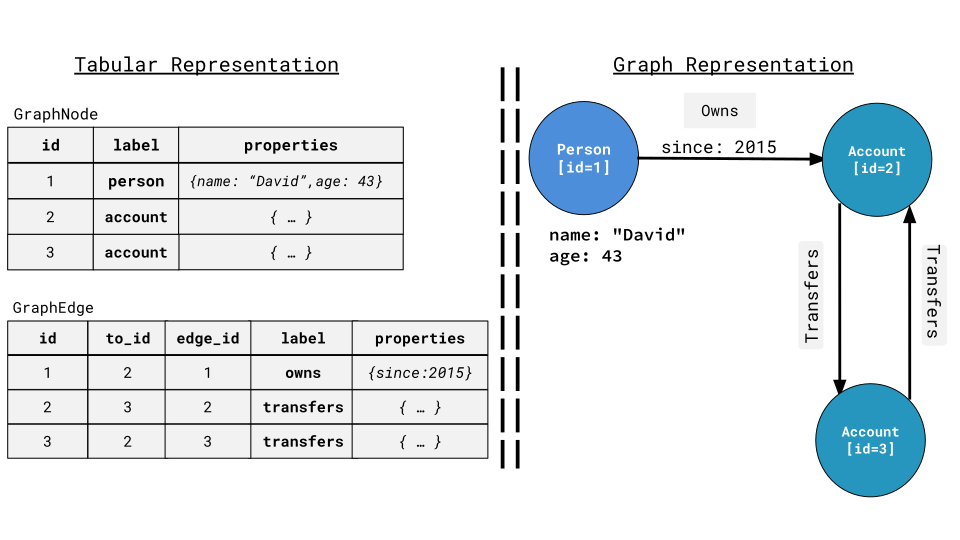
您可以建立單一 GraphNode 表格和單一 GraphEdge 表格來儲存無結構定義的資料,如下例所示。表格名稱僅供說明,你可以選擇自己的名稱。
CREATE TABLE GraphNode (
  id INT64 NOT NULL,
  label STRING(MAX) NOT NULL,
  properties JSON,
) PRIMARY KEY (id);

CREATE TABLE GraphEdge (
  id INT64 NOT NULL,
  dest_id INT64 NOT NULL,
  edge_id INT64 NOT NULL,
  label STRING(MAX) NOT NULL,
  properties JSON,
) PRIMARY KEY (id, dest_id, edge_id),
  INTERLEAVE IN PARENT GraphNode;
這個範例會執行下列動作:
將所有節點儲存在單一資料表
GraphNode中,並以不重複的id識別。將所有邊儲存在單一資料表
GraphEdge中,並以來源 (id)、目的地 (dest_id) 和其專屬 ID (edge_id) 的不重複組合來識別。edge_id會納入主鍵的一部分,允許從id到dest_id配對有多個邊。
節點和邊緣資料表都有各自的 label 和 properties 資料欄。這些資料欄的類型分別為 STRING 和 JSON。
如要進一步瞭解無結構定義資料管理的重要選項,請參閱「節點和邊緣的主鍵定義」。
建立屬性圖表
CREATE PROPERTY GRAPH 陳述式會將上一節中的輸入資料表對應為節點和邊緣。使用下列子句定義無結構定義資料的標籤和屬性:
DYNAMIC LABEL:從輸入資料表的STRING資料欄建立節點或邊緣的標籤。DYNAMIC PROPERTIES:從輸入資料表的JSON欄建立節點或邊緣的屬性。
以下範例說明如何使用這些子句建立圖表:
CREATE PROPERTY GRAPH FinGraph
  NODE TABLES (
    GraphNode
      DYNAMIC LABEL (label)
      DYNAMIC PROPERTIES (properties)
  )
  EDGE TABLES (
    GraphEdge
      SOURCE KEY (id) REFERENCES GraphNode(id)
      DESTINATION KEY (dest_id) REFERENCES GraphNode(id)
      DYNAMIC LABEL (label)
      DYNAMIC PROPERTIES (properties)
  );
定義動態標籤
DYNAMIC LABEL 子句會指定 STRING 已指定類型和格式的欄,用於儲存標籤值。
舉例來說,在 GraphNode 資料列中,如果 label 欄有 person 值,則會對應至圖表中的 Person 節點。同樣地,在 GraphEdge 列中,如果標籤欄的值為 owns,則會對應至圖表中的 Owns 邊緣。
如要進一步瞭解使用動態標籤時的限制,請參閱「限制」一節。
定義動態屬性
DYNAMIC PROPERTIES 子句會指定 JSON 資料類型資料欄來儲存屬性。JSON 鍵代表屬性名稱,JSON 值則代表屬性值。
舉例來說,當 GraphNode 列的 properties 欄有 JSON 值 '{"name": "David", "age": 43}' 時,Spanner 會將其對應至具有 age 和 name 屬性的節點,且這些屬性的值分別為 43 和 "David"。
無結構定義資料管理的注意事項
在下列情況下,您可能不適合使用無結構定義資料管理:
- 圖形資料的節點和邊緣類型定義明確,或標籤和屬性不需要經常更新。
- 資料已儲存在 Spanner,您想從現有資料表建立圖表,而非導入新的專用節點和邊緣資料表。
- 無結構定義資料的限制會阻礙採用。
此外,如果工作負載對寫入效能非常敏感,尤其是在屬性經常更新時,使用架構定義的屬性搭配原始資料型別 (例如 STRING 或 INT64),會比使用 JSON 型別的動態屬性更有效。
如要進一步瞭解如何在不使用動態資料標籤和屬性的情況下定義圖表結構定義,請參閱「Spanner Graph 結構定義總覽」。
查詢無結構定義的圖形資料
您可以使用Graph Query Language (GQL) 查詢無結構定義的圖形資料。您可以使用「Spanner Graph 查詢總覽」和 GQL 參考資料中的範例查詢,並進行有限的修改。
使用標籤比對節點和邊緣
您可以使用 GQL 中的標籤運算式,比對節點和邊緣。
下列查詢會比對標籤欄中含有 account 和 transfers 值的連結節點和邊緣。
GRAPH FinGraph
MATCH (a:Account {id: 1})-[t:Transfers]->(d:Account)
RETURN COUNT(*) AS result_count;
存取屬性
Spanner 會將 JSON 資料類型的頂層鍵和值模擬為屬性,例如以下範例中的 age 和 name。
JSON document |
Properties |
|
|
|
以下範例說明如何從 Person 節點存取 name 屬性。
GRAPH FinGraph
MATCH (person:Person {id: 1})
RETURN person.name;
查詢會傳回類似下列內容的結果:
"Tom"
依動態屬性篩選、比較及排序
您可以在 Spanner Graph 屬性篩選器,以及 WHERE、GROUP BY、ORDER BY 和 RETURN DISTINCT 子句中,直接使用動態屬性。這是因為 Spanner 會將動態屬性視為 JSON 資料類型的值,而該類型支援 JSON 比較和排序。
舉例來說,下列查詢會篩選 WHERE 子句中的布林值屬性 is_blocked 和字串屬性 order_number_str:
GRAPH FinGraph
MATCH (a:Account)-[t:Transfers]->()
WHERE a.is_blocked = false AND t.order_number_str = "302290001255747"
RETURN a.id AS account_id;
傳回的結果大致如下:
+------------+
| account_id |
+------------+
| 7          |
+------------+
您可以使用元素模式屬性篩選器,表示相同的等式條件:
GRAPH FinGraph
MATCH (a:Account {is_blocked: false})-[t:Transfers {order_number_str: "302290001255747"}]->()
RETURN a.id AS account_id;
您也可以直接在 GROUP BY、ORDER BY 和 RETURN DISTINCT 子句中使用動態屬性:
GROUP BY範例:GRAPH FinGraph MATCH (person:Person {country: "South Korea"}) RETURN person.city AS person_city, COUNT(*) AS cnt LIMIT 10;ORDER BY示例:GRAPH FinGraph MATCH (a:Account)-[t:Transfers]->(b:Account) RETURN a.id AS from_account, b.id AS to_account, t.amount ORDER BY t.amount DESC LIMIT 1;RETURN DISTINCT範例:GRAPH FinGraph MATCH -[t:Transfers]-> RETURN DISTINCT t.order_number_str AS order_number_str;
篩選、比較或排序動態屬性時,適用下列規則:
比較值必須與屬性的 JSON 類型和值相符。舉例來說,由於
order_number_str是以 JSONstring的形式儲存,因此與整數常值比較時,不會找到任何相符項目:GRAPH FinGraph MATCH (a:Account {is_blocked: false})-[t:Transfers {order_number_str: 302290001255747}]->() RETURN t.order_number_str;直接將
JSON布林屬性評估為獨立的WHERE條件 (例如WHERE a.is_blocked) 會傳回錯誤。請改為將屬性與布林常值 (例如WHERE a.is_blocked = true) 進行比較,或使用WHERE BOOL(a.is_blocked)明確轉換。如要瞭解比較、分組及排序
JSON值的詳細規則和限制,請參閱「JSON 比較和排序」和「JSON 比較強制轉換」。
轉換動態屬性資料類型
在下列情況中,將動態屬性轉換為 SQL 資料類型:
- 將屬性值轉換為不同的資料類型,以便比較或輸出,例如將 JSON 字串
"302290001255747"轉換為INT64整數,或傳回 SQL 資料類型,而非JSON。 - 在 SQL 函式、運算子或運算式中使用不支援
JSON運算元的屬性值,例如算術運算子 (+、-)、字串函式 (LOWER、LIKE)、匯總函式 (SUM、AVG) 或IN UNNEST。 - 在次要索引或唯一索引的屬性上定義產生的資料欄,因為
JSON運算式無法直接建立索引。
在以下範例中,order_number_str 會儲存為 JSON string,而查詢會使用 LAX_INT64 函式將其轉換為 INT64 整數,以便進行比較和傳回:
GRAPH FinGraph
MATCH (a:Account)-[t:Transfers]->()
WHERE a.is_blocked = true AND LAX_INT64(t.order_number_str) = 302290001255747
RETURN LAX_INT64(t.order_number_str) AS order_number_as_int64;
傳回的結果大致如下:
+-----------------------+
| order_number_as_int64 |
+-----------------------+
| 302290001255747       |
+-----------------------+
存取巢狀 JSON 屬性
Spanner 不會將巢狀 JSON 鍵和值模擬為屬性。在下列範例中,Spanner 不會將 JSON 鍵 city、state 和 country 視為屬性,因為這些鍵巢狀結構在 location 下方。不過,您可以使用 JSON 欄位存取運算子或 JSON 下標運算子存取這些欄位。
JSON document |
Properties |
|
|
|
|
|
以下範例說明如何使用 JSON 欄位存取運算子存取巢狀屬性。
GRAPH FinGraph
MATCH (person:Person {id: 1})
RETURN person.location.city;
這會傳回類似下列內容的結果:
"New York"
修改無結構定義資料
Spanner Graph 會將資料從資料表對應至圖形節點和邊。當您變更輸入資料表資料時,這項變更會直接導致對應的圖表資料發生突變。如要進一步瞭解圖表資料異動,請參閱「插入、更新或刪除 Spanner Graph 資料」。
查詢範例
本節提供範例,說明如何建立、更新及刪除圖表資料。
插入圖表資料
以下範例會插入 person 節點。標籤和屬性名稱須使用小寫。
INSERT INTO GraphNode (id, label, properties)
VALUES (4, "person", JSON'{"name": "David", "age": 43}');
更新圖表資料
以下範例會更新 Account 節點,並使用 JSON_SET 函式設定其 is_blocked 屬性。
UPDATE GraphNode
SET properties = JSON_SET(
  properties,
  '$.is_blocked', false
)
WHERE label = "account" AND id = 16;
以下範例會使用一組新屬性更新 person 節點。
UPDATE GraphNode
SET properties = JSON'{"name": "David", "age": 43}'
WHERE label = "person" AND id = 4;
以下範例使用 JSON_REMOVE 函式,從 Account 節點中移除 is_blocked 屬性。執行後,所有其他現有屬性都會保持不變。
UPDATE GraphNode
SET properties = JSON_REMOVE(
  properties,
  '$.is_blocked'
)
WHERE label = "account" AND id = 16;
刪除圖表資料
以下範例會刪除已轉移至遭封鎖帳戶的 Account 節點上的 Transfers 邊緣。
DELETE FROM GraphEdge
WHERE label = "transfers" AND id IN {
  GRAPH FinGraph
  MATCH (a:Account)-[:Transfers]->{1,2}(:Account {is_blocked: TRUE})
  RETURN a.id
}
已知限制
本節列出使用無結構定義資料管理的限制。
動態標籤的單一表格規定
如果節點定義使用動態標籤,則只能有一個節點資料表。這項限制也適用於邊緣資料表。Spanner 不允許下列行為:
- 定義具有動態標籤的節點資料表,以及任何其他節點資料表。
- 定義具有動態標籤的邊緣資料表,以及任何其他邊緣資料表。
- 定義多個節點資料表或多個邊緣資料表,且每個資料表都使用動態標籤。
舉例來說,下列程式碼在嘗試建立多個具有動態標籤的圖表節點時會失敗。
CREATE OR REPLACE PROPERTY GRAPH FinGraph
  NODE TABLES (
    GraphNodeOne
      DYNAMIC LABEL (label)
      DYNAMIC PROPERTIES (properties),
    GraphNodeTwo
      DYNAMIC LABEL (label)
      DYNAMIC PROPERTIES (properties),
    Account
      LABEL Account PROPERTIES(create_time)
  )
  EDGE TABLES (
    ...
  );
標籤名稱必須為小寫
標籤字串值必須以小寫形式儲存,才能進行比對。建議您在應用程式程式碼中,或使用結構定義限制強制執行這項規則。
雖然標籤字串值必須以小寫形式儲存,但在查詢中參照時不區分大小寫。
以下範例說明如何插入小寫值的標籤:
INSERT INTO GraphNode (id, label) VALUES (1, "account");
INSERT INTO GraphNode (id, label) VALUES (2, "account");
您可以使用不區分大小寫的標籤,比對 GraphNode 或 GraphEdge。
GRAPH FinGraph
MATCH (accnt:Account {id: 1})-[:Transfers]->(dest_accnt:Account)
RETURN dest_accnt.id;
屬性名稱必須為小寫
屬性名稱必須以小寫形式儲存。建議您在應用程式程式碼中或使用結構定義限制,強制執行這項規則。
雖然屬性名稱必須以小寫形式儲存,但在查詢中參照時不區分大小寫。
以下範例使用小寫插入 name 和 age 屬性。
INSERT INTO GraphNode (id, label, properties)
VALUES (25, "person", JSON '{"name": "Kim", "age": 27}');
在查詢文字中,屬性名稱不分大小寫。舉例來說,您可以使用 Age 或 age 存取屬性。
GRAPH FinGraph
MATCH (n:Person {Age: 27})
RETURN n.id;
其他限制
無結構定義資料的最佳做法
本節說明有助於建立無結構定義資料模型的最佳做法。
定義節點和邊的主鍵
節點的金鑰在所有圖表節點中不得重複。例如 INT64 或字串 UUID 欄。
如果兩個節點之間有多個邊緣,請為邊緣引入專屬 ID。結構定義範例使用應用程式邏輯 INT64
edge_id 欄。
建立節點和邊資料表的結構定義時,如果值不可變更,可以選擇將 label 欄納入主鍵欄。如果這麼做,由所有索引鍵資料欄組成的複合索引鍵,在所有節點或邊緣中都不得重複。這項技術可提升僅依標籤篩選的查詢效能。
如要進一步瞭解主鍵選擇,請參閱「選擇主鍵」。
為經常存取的屬性建立次要索引
如要提升篩選器中常用屬性的查詢效能,請針對產生的屬性欄建立次要索引。然後在圖表結構定義和查詢中使用。
以下範例說明如何將產生的 age 資料欄新增至 person 節點的 GraphNode 資料表。如果節點沒有 person 標籤,則值為 NULL。
ALTER TABLE GraphNode
ADD COLUMN person_age INT64 AS
(IF (label = "person", LAX_INT64(properties.age), NULL));
接著,下列 DDL 陳述式會為 person_age 建立 NULL FILTERED INDEX,並將其交錯至 GraphNode 資料表,以便在本機存取。
CREATE NULL_FILTERED INDEX IdxPersonAge
ON GraphNode(id, label, person_age), INTERLEAVE IN GraphNode;
GraphNode 表格包含可做為圖形節點屬性的新資料欄。如要在屬性圖譜定義中反映這點,請使用 CREATE OR
REPLACE PROPERTY GRAPH 陳述式。這會重新編譯定義,並將新的 person_age 資料欄納入為屬性。
詳情請參閱「更新現有的節點或邊緣定義」。
下列陳述式會重新編譯定義,並將新的 person_age 欄納為屬性。
CREATE OR REPLACE PROPERTY GRAPH FinGraph
NODE TABLES (
GraphNode
DYNAMIC LABEL (label)
DYNAMIC PROPERTIES (properties)
)
EDGE TABLES (
GraphEdge
SOURCE KEY (id) REFERENCES GraphNode (id)
DESTINATION KEY (dest_id) REFERENCES GraphNode (id)
DYNAMIC LABEL (label)
DYNAMIC PROPERTIES (properties)
);
以下範例會使用已建立索引的屬性執行查詢。
GRAPH FinGraph
MATCH (person:Person {person_age: 43})
RETURN person.id, person.name;
建立索引後,您可以視需要執行 ANALYZE 指令,讓查詢最佳化工具更新為最新的資料庫統計資料。
使用檢查限制確保資料完整性
Spanner 支援檢查限制等結構定義物件,可強制執行標籤和屬性資料完整性。本節列出檢查限制的建議,可與無結構定義資料搭配使用。
強制執行標籤值
建議您在標籤欄定義中使用 NOT NULL,避免出現未定義的標籤值。
CREATE TABLE GraphNode (
  id INT64 NOT NULL,
  label STRING(MAX) NOT NULL,
  properties JSON,
) PRIMARY KEY (id);
強制使用小寫標籤值和屬性名稱
由於標籤和屬性名稱必須以小寫值儲存,請執行下列任一操作:
- 在應用程式邏輯中強制執行檢查。
- 在結構定義中建立檢查限制。
查詢時,標籤和屬性名稱不區分大小寫。
以下範例說明如何將節點標籤限制新增至 GraphNode 資料表,確保標籤為小寫。
ALTER TABLE GraphNode ADD CONSTRAINT NodeLabelLowerCaseCheck
CHECK(LOWER(label) = label);
以下範例說明如何將檢查限制新增至邊緣屬性名稱。這項檢查會使用 JSON_KEYS 存取頂層索引鍵。COALESCE
如果 JSON_KEYS 傳回 NULL,則會將輸出內容轉換為空陣列,然後檢查每個鍵是否為小寫。
ALTER TABLE GraphEdge ADD CONSTRAINT EdgePropertiesLowerCaseCheck
CHECK(NOT array_includes(COALESCE(JSON_KEYS(properties, 1), []), key->key<>LOWER(key)));
強制要求屬性存在
建立限制,檢查標籤是否有屬性。
在以下範例中,限制會檢查 person 節點是否具有 name 屬性。
ALTER TABLE GraphNode
ADD CONSTRAINT NameMustExistForPersonConstraint
CHECK (IF(label = 'person', properties.name IS NOT NULL, TRUE));
強制執行不重複屬性
建立以屬性為基礎的限制,檢查節點或邊緣的屬性,在具有相同標籤的節點或邊緣中是否不重複。如要這麼做,請對屬性的生成資料欄使用 UNIQUE INDEX。
在下列範例中,不重複索引會檢查 name 和 country 屬性是否為任何 person 節點的不重複組合。
為
PersonName新增產生的資料欄。ALTER TABLE GraphNode ADD COLUMN person_name STRING(MAX) AS (IF(label = 'person', STRING(properties.name), NULL)) Hidden;為
PersonCountry新增產生的資料欄。ALTER TABLE GraphNode ADD COLUMN person_country STRING(MAX) AS (IF(label = 'person', STRING(properties.country), NULL)) Hidden;針對
PersonName和PersonCountry屬性建立NULL_FILTERED專屬索引。CREATE UNIQUE NULL_FILTERED INDEX NameAndCountryMustBeUniqueForPerson ON GraphNode (person_name, person_country);
強制執行屬性資料類型
如要強制執行屬性資料類型,請對標籤的屬性值設定資料類型限制,如以下範例所示。本範例使用 JSON_TYPE 函式,檢查 person 標籤的 name 屬性是否使用 STRING 型別。
ALTER TABLE GraphNode
ADD CONSTRAINT PersonNameMustBeStringTypeConstraint
CHECK (IF(label = 'person', JSON_TYPE(properties.name) = 'string', TRUE));
結合定義和動態標籤
Spanner 允許屬性圖中的節點同時具有定義的標籤 (在結構定義中定義) 和動態標籤 (衍生自資料)。自訂標籤即可運用這項彈性。
請參考下列結構定義,瞭解如何建立 GraphNode 資料表:
CREATE OR REPLACE PROPERTY GRAPH FinGraph
  NODE TABLES (
    GraphNode
      LABEL Entity -- Defined label
      DYNAMIC LABEL (label) -- Dynamic label from data column 'label'
      DYNAMIC PROPERTIES (properties)
  );
在這裡,從 GraphNode 建立的每個節點都有定義的標籤 Entity。此外,每個節點都有 dynamic 標籤,取決於標籤欄中的值。
接著,編寫查詢,根據任一標籤類型比對節點。舉例來說,下列查詢會使用定義的 Entity 標籤尋找節點:
GRAPH FinGraph
MATCH (node:Entity {id: 1}) -- Querying by the defined label
RETURN node.name;
即使這項查詢使用定義的標籤 Entity,請注意,相符節點也會根據資料攜帶動態標籤。
結構定義範例
您可以將本節中的結構定義範例當做範本,建立自己的結構定義。主要結構定義元件包括:
以下範例說明如何建立輸入資料表和屬性圖:
CREATE TABLE GraphNode (
  id INT64 NOT NULL,
  label STRING(MAX) NOT NULL,
  properties JSON
) PRIMARY KEY (id);

CREATE TABLE GraphEdge (
  id INT64 NOT NULL,
  dest_id INT64 NOT NULL,
  edge_id INT64 NOT NULL,
  label STRING(MAX) NOT NULL,
  properties JSON
) PRIMARY KEY (id, dest_id, edge_id),
  INTERLEAVE IN PARENT GraphNode;

CREATE PROPERTY GRAPH FinGraph
  NODE TABLES (
    GraphNode
      DYNAMIC LABEL (label)
      DYNAMIC PROPERTIES (properties)
  )
  EDGE TABLES (
    GraphEdge
      SOURCE KEY (id) REFERENCES GraphNode(id)
      DESTINATION KEY (dest_id) REFERENCES GraphNode(id)
      DYNAMIC LABEL (label)
      DYNAMIC PROPERTIES (properties)
  );
以下範例使用索引來改善反向邊緣遍歷。STORING (properties) 子句包含邊緣屬性的副本,可加快篩選這些屬性的查詢速度。如果查詢不需要 STORING (properties) 子句,可以省略。
CREATE INDEX R_EDGE ON GraphEdge (dest_id, id, edge_id) STORING (properties),
INTERLEAVE IN GraphNode;
以下範例使用標籤索引,加快依標籤比對節點的速度。
CREATE INDEX IDX_NODE_LABEL ON GraphNode (label);
以下範例會新增限制,強制使用小寫標籤和屬性。最後兩個範例使用 JSON_KEYS 函式。您也可以選擇在應用程式邏輯中強制執行小寫檢查。
ALTER TABLE GraphNode ADD CONSTRAINT node_label_lower_case
CHECK(LOWER(label) = label);

ALTER TABLE GraphEdge ADD CONSTRAINT edge_label_lower_case
CHECK(LOWER(label) = label);

ALTER TABLE GraphNode ADD CONSTRAINT node_property_keys_lower_case
CHECK(
  NOT array_includes(COALESCE(JSON_KEYS(properties, 1), []), key->key<>LOWER(key)));

ALTER TABLE GraphEdge ADD CONSTRAINT edge_property_keys_lower_case
CHECK(
  NOT array_includes(COALESCE(JSON_KEYS(properties, 1), []), key->key<>LOWER(key)));
使用 DML 最佳化動態屬性的批次更新
使用 JSON_SET 和 JSON_REMOVE 等函式修改動態屬性時,會涉及讀取-修改-寫入作業。與更新 STRING 或 INT64 類型的屬性相比,這可能會導致費用增加。
如果工作負載涉及使用 DML 批次更新動態屬性,請參考下列建議,以提升效能:
在單一 DML 陳述式中更新多個資料列,而非個別處理資料列。
更新廣泛的主鍵範圍時,請依主鍵將受影響的資料列分組及排序。使用每個 DML 更新不重疊的範圍,可減少鎖定爭用。
在 DML 陳述式中使用查詢參數,而非硬式編碼,以提升效能。
根據這些建議,以下範例說明如何使用單一 DML 陳述式,更新 100 個節點的 is_blocked 屬性。查詢參數包括:
@node_ids:GraphNode列的鍵,儲存在ARRAY參數中。在適用情況下,跨 DML 分組及排序可提升效能。@is_blocked_values:要更新的對應值,儲存在ARRAY參數中。
UPDATE GraphNode
SET properties = JSON_SET(
  properties,
  '$.is_blocked',
  CASE id
    WHEN @node_ids[OFFSET(0)] THEN @is_blocked_values[OFFSET(0)]
    WHEN @node_ids[OFFSET(1)] THEN @is_blocked_values[OFFSET(1)]
    ...
    WHEN @node_ids[OFFSET(99)] THEN @is_blocked_values[OFFSET(99)]
  END,
  create_if_missing => TRUE)
WHERE id IN UNNEST(@node_ids)
疑難排解
本節說明如何排解無結構定義資料的問題。
資源在TO_JSON結果中出現多次
問題
下列節點會將 birthday 和 name 屬性模擬為 JSON 欄中的動態屬性。圖形元素 JSON 結果中會出現重複的 birthday 和 name 屬性。
GRAPH FinGraph
MATCH (n: Person {id: 14})
RETURN SAFE_TO_JSON(n) AS n;
傳回的結果大致如下:
{
  …,
  "properties": {
    "birthday": "1991-12-21 00:00:00",
    "name": "Alex",
    "id": 14,
    "label": "person",
    "properties": {
      "birthday": "1991-12-21 00:00:00",
      "name": "Alex"
    }
  }
  …
}
可能原因
根據預設,系統會將基礎資料表的所有資料欄定義為屬性。使用 TO_JSON 或 SAFE_TO_JSON 傳回圖表元素會導致屬性重複。這是因為 JSON 資料欄 (properties) 是結構定義定義的屬性,而 JSON 的第一層鍵則模擬為動態屬性。
建議解決方案
為避免這種情況,請在定義結構定義中的屬性時,使用 PROPERTIES ALL COLUMNS EXCEPT 子句排除 properties 欄,如下列範例所示:
CREATE OR REPLACE PROPERTY GRAPH FinGraph
  NODE TABLES (
    GraphNode
      PROPERTIES ALL COLUMNS EXCEPT (properties)
      DYNAMIC LABEL (label)
      DYNAMIC PROPERTIES (properties)
  );
結構定義變更後,JSON 資料型別傳回的圖表元素不會重複。
GRAPH FinGraph
MATCH (n: Person {id: 1})
RETURN TO_JSON(n) AS n;
這項查詢會傳回下列結果:
{
  …
  "properties": {
    "birthday": "1991-12-21 00:00:00",
    "name": "Alex",
    "id": 1,
    "label": "person",
  }
}
後續步驟
- 如要進一步瞭解 JSON,請參閱「修改 JSON 資料」、「比較及排序 JSON 資料」和「JSON 函式清單」。
- 比較 Spanner Graph 和 openCypher。
- 遷移至 Spanner Graph。