


本頁面概略說明 Spanner 超過期限錯誤,包括錯誤定義、發生原因,以及如何疑難排解和解決問題。
存取 Spanner API 時,要求可能會因 DEADLINE_EXCEEDED 錯誤而失敗。這項錯誤表示未在設定的逾時期間內收到回應。
造成「超過期限」錯誤的原因有很多,例如 Spanner 執行個體超載、結構定義未最佳化,或查詢未最佳化。本頁面說明發生期限超過錯誤的常見情況,並提供調查及解決這些問題的指南。
Spanner 的期限和重試原則
Spanner 的期限和重試原則與許多其他系統不同。在 Spanner 中,您應指定逾時期限,做為回應有效的最長時間。不建議刻意設定過短的期限,只為了立即重試相同作業,因為這會導致作業永遠無法完成。在這種情況下,不建議採用下列策略和作業,因為這些做法會適得其反,並破壞 Spanner 的內部重試行為:
設定的期限太短。這表示作業無法彈性因應偶爾增加的尾端延遲時間,且無法在逾時前完成。請改為設定期限,也就是回應有用的最長時間。
設定過長的期限,並在期限超過前取消作業。這會導致系統重試,並浪費每次嘗試的工作。整體而言,這可能會對執行個體造成額外的重大負載。
什麼是超過期限錯誤?
使用 Spanner 用戶端程式庫時,底層 gRPC 層會處理通訊、封送處理、取消封送處理和期限強制執行。期限可讓應用程式指定願意等待要求完成的時間長度,超過期限後,要求就會終止,並顯示期限已過錯誤。
逾時設定指南說明如何在各個支援的 Spanner 用戶端程式庫中指定期限 (或逾時)。Spanner 用戶端程式庫會使用預設逾時和重試政策設定,這些設定定義於下列設定檔:
- spanner_grpc_service_config.json
- spanner_admin_instance_grpc_service_config.json
- spanner_admin_database_grpc_service_config.json
如要進一步瞭解 gRPC 期限,請參閱「gRPC 和期限」。
如何調查及解決常見的「超過期限」錯誤
下列問題類型可能會導致 DEADLINE_EXCEEDED 錯誤:
資料存取 API 問題
Spanner 執行個體必須針對特定工作負載進行適當設定,以免發生資料存取 API 問題。以下各節說明如何調查及解決不同的資料存取 API 問題。
查看 Spanner 執行個體 CPU 負載
當 CPU 使用率超過建議的健康狀態門檻時,要求延遲時間可能會大幅增加。您可以在 Google Cloud 控制台提供的監控控制台中,查看 Spanner CPU 使用率。您也可以根據執行個體的 CPU 使用率建立警告。
解析度
如要瞭解如何降低執行個體的 CPU 使用率,請參閱「降低 CPU 使用率」。
查看要求的端對端延遲時間細目
要求從用戶端傳送至 Spanner 伺服器並傳回時,需要經過多個網路躍點:從用戶端程式庫到 Google Front End (GFE);從 GFE 到 Spanner API 前端;最後從 Spanner API 前端到 Spanner 資料庫。如果上述任何階段發生網路問題,您可能會看到超過期限的錯誤。
您可以擷取每個階段的延遲時間。詳情請參閱「Spanner 要求中的延遲時間點」。如要找出 Spanner 發生延遲的位置,請參閱「找出 Spanner 發生延遲的位置」。
解析度
取得延遲時間細目後,您可以使用指標診斷延遲時間、瞭解發生原因,並找出解決方案。
Data API 問題
如果 Spanner Data API 的使用模式不理想,可能會導致超過期限錯誤。本節提供相關指南,說明如何檢查這些非最佳使用模式。
檢查耗用大量資源的查詢
如果嘗試執行耗費大量資源的查詢,但未在用戶端程式庫設定的逾時期限內執行,可能會導致超出期限錯誤。高成本查詢的例子包括但不限於:完整掃描大型資料表、跨多個大型資料表進行 cross join,或在非索引鍵資料欄上使用述詞執行查詢 (也是完整資料表掃描)。
您可以使用查詢統計資料表和交易統計資料表,檢查高成本查詢。這些資料表會顯示執行速度緩慢的查詢和交易相關資訊,例如平均讀取的資料列數、平均讀取的位元組數、平均掃描的資料列數等。此外,您也可以產生查詢執行計畫,進一步檢查查詢的執行方式。
解析度
如要最佳化查詢,請參閱 SQL 查詢最佳做法指南。您也可以使用先前所述的統計資料表和執行計畫取得的資料,最佳化查詢並變更資料庫的結構定義。這些最佳做法有助於縮短陳述式的執行時間,進而避免發生「超過期限」錯誤。
檢查鎖定爭用
Spanner 交易需要取得鎖定才能提交。如果應用程式以高處理量執行,交易可能會爭用相同資源,導致取得鎖定的等待時間增加,並影響整體效能。這可能會導致任何讀取或寫入要求超過期限。
您可以使用鎖定統計資料表,並查看下列網誌文章,找出高延遲讀寫交易的根本原因。在鎖定統計資料表中,您可以找到鎖定等待時間最長的資料列索引鍵。
這份鎖定衝突疑難排解指南說明如何找出正在存取鎖定衝突資料欄的交易。您也可以參閱使用交易標記進行疑難排解指南,瞭解哪些交易涉及鎖定衝突。
解析度
請採用這些最佳做法,減少鎖定爭用情形。此外,請針對一般讀取用途使用唯讀交易,避免與寫入作業發生鎖定衝突。讀寫交易應保留給寫入或混合讀寫工作流程。按照這些步驟操作,應可縮短交易執行時間的整體延遲,並減少超過期限的錯誤。
檢查結構定義是否未經最佳化
為 Spanner 資料庫設計最佳資料庫結構定義前,請先考量要在資料庫中執行的查詢類型。執行某些查詢時,次佳結構定義可能會導致效能問題。這些效能問題可能會導致要求無法在設定的期限內完成。
解析度
最佳結構定義設計取決於資料庫的讀取和寫入作業。無論結構定義具體內容為何,都應遵循結構定義設計最佳做法和 SQL 最佳做法指南。只要遵循這些指南,就能避免最常見的結構定義設計問題。效能不佳的其他根本原因包括主鍵選擇、資料表版面配置 (請參閱「使用交錯資料表加快存取速度」)、結構定義設計 (請參閱「針對效能最佳化結構定義」),以及 Spanner 執行個體中設定的節點效能 (請參閱 Spanner「效能總覽」)。
檢查是否有熱點
Spanner 是分散式資料庫,因此結構定義設計必須考量如何避免熱點。舉例來說,建立單調遞增的資料欄會限制 Spanner 可用於平均分配工作負載的分割數量。這些瓶頸可能會導致逾時。此外,您也可以使用 Key Visualizer 排解熱點造成的效能問題。
解析度
請參閱上一節「檢查未最佳化的結構定義」中列出的解決方法,做為解決這個問題的第一步。重新設計資料庫結構定義,並使用交錯索引,避免索引可能導致熱點。如果按照這些步驟操作後仍無法解決問題,請參閱選擇主鍵以避免熱點指南。最後,請避免採用不理想的流量模式,例如大範圍讀取,這可能會導致無法依據負載進行分割。
檢查逾時設定是否有誤
用戶端程式庫會為 Spanner 中的所有要求提供合理的逾時預設值。不過,您可能需要根據特定工作負載調整這些預設設定。建議您觀察查詢費用,並根據特定用途調整期限。
解析度
逾時的預設設定適用於大多數用途。使用者可以覆寫這些設定 (請參閱自訂逾時和重試指南),但不建議使用比預設值更積極的逾時設定。如果您決定變更逾時時間,請將其設為應用程式願意等待結果的實際時間。您可以嘗試設定較長的逾時時間,但請勿將逾時時間設為短於應用程式願意等待的實際時間,否則會導致作業更頻繁地重試。
Admin API 問題
與 Data API 要求相比,Admin API 要求是高成本作業。CreateInstance、CreateDatabase 或 CreateBackups 等管理員要求可能需要幾秒鐘才能傳回回應。Spanner 用戶端程式庫會為執行個體和資料庫管理員要求設定 60 分鐘的期限。這是為了確保伺服器有機會在用戶端重試或失敗前完成要求。
解析度
如果您使用 Google Spanner 用戶端程式庫存取管理員 API,請務必更新用戶端程式庫,並使用最新版本。如果您是透過自行建立的用戶端程式庫直接存取 Spanner API,請確保執行個體和資料庫管理員要求的期限設定不會比預設設定 (60 分鐘) 更嚴格。
Google Cloud 控制台問題
從 Google Cloud 控制台 Spanner Studio 頁面發出的查詢不得超過五分鐘。如果您建立的查詢需要耗費大量資源,且執行時間超過五分鐘,就會看到下列錯誤訊息:
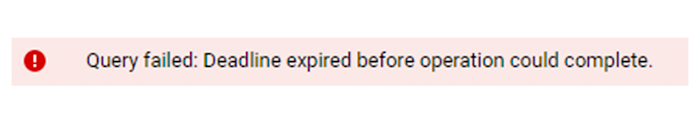
後端會取消失敗的查詢,並視需要復原交易。
解析度
您可以按照這份指南,採用最佳做法重寫 SQL 查詢。
Dataflow 問題
在 Apache Beam 中,讀取作業的預設逾時設定為兩小時,修訂作業則為 15 秒。與獨立用戶端程式庫期限逾時相比,這些設定可延長作業時間。不過,如果工作項目過大,仍可能發生逾時和超過期限的錯誤。如有需要,您可以自訂 Apache Beam 提交逾時設定。
解析度
如果步驟 ReadFromSpanner / Execute
query / Read from Spanner / Read from Partitions 發生期限超過錯誤,請查看查詢統計資料表,找出掃描大量資料列的查詢。然後修改這類查詢,嘗試縮短執行時間。
以下是 Dataflow 期限超出錯誤的另一個範例:
exception:
     org.apache.beam.sdk.util.UserCodeException:
     com.google.cloud.spanner.SpannerException: DEADLINE_EXCEEDED:
     io.grpc.StatusRuntimeException: DEADLINE_EXCEEDED: deadline exceeded after
     3599.999905380s.
     [remote_addr=batch-spanner.googleapis.com/172.217.5.234:443] at
 org.apache.beam.runners.dataflow.worker.GroupAlsoByWindowsParDoFn$1.output(GroupAlsoByWindowsParDoFn.java:184)
工作項目過大,導致逾時。在前述範例中,以下兩項建議可能會有幫助。首先,如果尚未啟用 Shuffle 服務,可以嘗試啟用。其次,您可以嘗試調整資料庫讀取作業的設定,例如 maxPartitions 和 partitionSizeBytes。詳情請參閱 PartitionOptions,嘗試縮減工作項目大小。如需範例,請參閱這個 Dataflow 範本。
其他「超過期限」疑難排解資源
如果完成疑難排解步驟後仍看到 DEADLINE_EXCEEDED 錯誤,請在下列情況下提交客服案件:
- Google Front End 延遲時間偏高,但 Spanner API 要求延遲時間偏低
- Spanner API 要求延遲時間偏高,但查詢延遲時間偏低
您也可以參考下列疑難排解資源: