


Cloud Monitoring 圖表中的事件註解可讓您將指標趨勢與系統活動 (例如部署、容錯移轉或當機) 建立關聯。「事件」是指影響系統運作的活動,可透過未解決的警告、Personalized Service Health 或記錄項目識別。資訊主頁可顯示多個註解,每個註解可列出多個事件。Compute Engine 和 Google Kubernetes Engine 等服務的「Observability」(觀測能力) 分頁也可以顯示註解,但並非所有事件類型都支援。
針對列出的每個事件類型,本文提供疑難排解內容和記錄查詢的連結,您可以在 Logs Explorer 或記錄檔警告政策中使用這些查詢。如需設定操作說明,請參閱「在資訊主頁上顯示事件」。
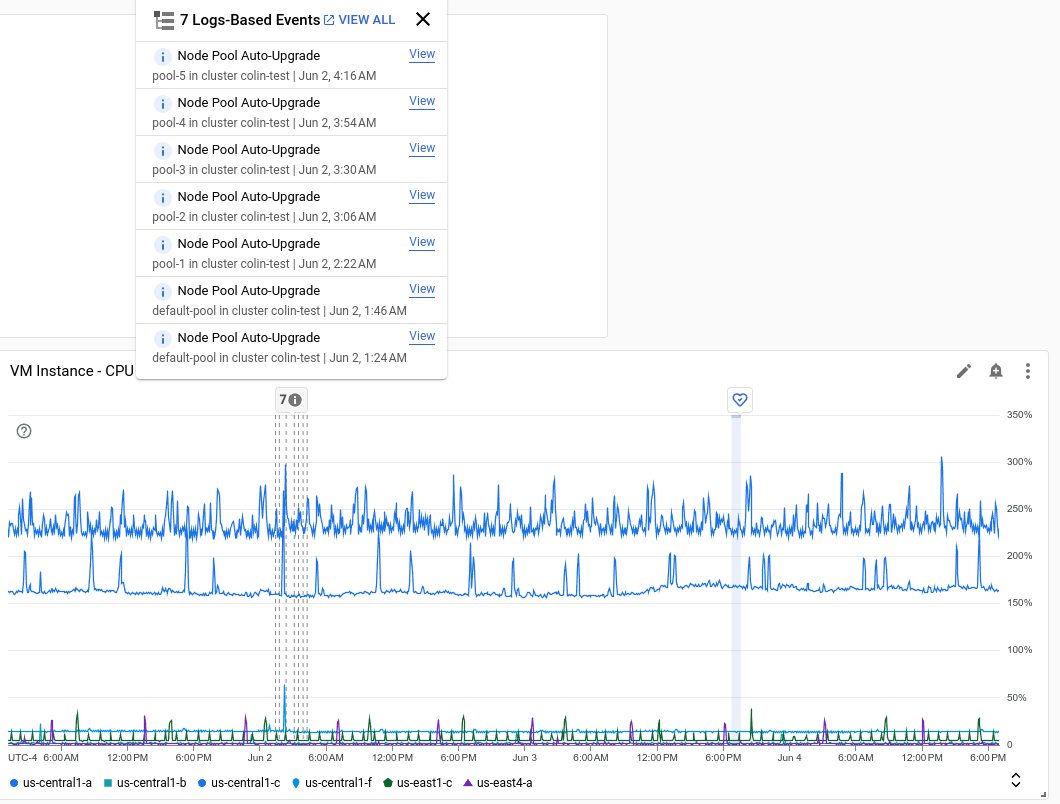
含有註解的資訊主頁範例
下方螢幕截圖顯示的圖表,呈現多個記錄事件和一個 Service Health 事件:
警示事件類型
本節說明可在資訊主頁上顯示的警告事件類型。
已開啟警告
「快訊開啟」事件可協助您將圖表資料與快訊開啟時間建立關聯。符合下列條件時,系統會顯示快訊開啟事件:
- 在資訊主頁指定的時間範圍內,開啟了對應的警告。
- 對應的警告未關閉。
在資訊主頁指定日期範圍外開啟的警告不會顯示。同樣地,如果警告在資訊主頁指定的日期範圍內開啟後又關閉,就不會顯示警告開啟事件。
快訊開啟事件的工具提示包含下列資訊:
- 警告政策的名稱。
- 摘要資訊 (如有)。例如門檻和測量值。
- 快訊的持續時間,以及快訊開啟的日期和時間。
- 指標和資源標籤。工具提示可能不會顯示所有標籤。
- 「查看」按鈕:點選後會開啟快訊的「詳細資料」頁面。
Google Kubernetes Engine 事件類型
本節說明可在資訊主頁上顯示的 Google Kubernetes Engine 事件類型。
已修補或更新的 GKE 工作負載
這個事件類型可協助您排解 GKE 工作負載 Deployment 或 StatefulSet 變更的問題,因為這些事件可能與效能迴歸或其他效能問題有關。建立、更新或刪除工作負載時,就會顯示這個事件類型。
如要為這個事件類型建立記錄式警告政策,請使用下列查詢:
log_id(cloudaudit.googleapis.com%2Factivity)
resource.type=k8s_cluster protoPayload.methodName=(
    io.k8s.apps.v1.deployments.create OR io.k8s.apps.v1.deployments.patch OR
    io.k8s.apps.v1.deployments.update OR io.k8s.apps.v1.deployments.delete OR
    io.k8s.apps.v1.statefulsets.create OR io.k8s.apps.v1.statefulsets.patch OR
    io.k8s.apps.v1.statefulsets.update OR io.k8s.apps.v1.statefulsets.delete OR
    io.k8s.apps.v1.daemonsets.create OR io.k8s.apps.v1.daemonsets.patch OR
    io.k8s.apps.v1.daemonsets.update OR io.k8s.apps.v1.daemonsets.delete
)
-protoPayload.authenticationInfo.principalEmail=("system:addon-manager" OR "system:serviceaccount:kube-system:namespace-controller")
-protoPayload.request.metadata.namespace=(kube-system OR gmp-system OR gmp-public OR gke-gmp-system OR istio-system)
-protoPayload.response.metadata.namespace=(kube-system OR gmp-system OR gmp-public OR gke-gmp-system OR istio-system)
-protoPayload.resourceName=~"namespaces/(kube-system|gmp-system|gmp-public|gke-gmp-system|istio-system)"
GKE Pod 異常終止
這個事件類型可協助您找出 GKE Pod 停止運作的問題,並進行疑難排解。Pod 異常終止的原因可能是記憶體用盡或應用程式發生錯誤。發生下列任一情況時,系統會顯示這個事件類型:
- Pod 狀態為
CrashLoopBackOff。 - Pod 以非零的結束代碼終止。
- Pod 因記憶體不足而終止。
- Pod 遭到剔除。
- readiness 或 liveness 探測失敗。
如要為這個事件類型建立記錄警告政策,請使用下列查詢:
(
    log_id(events)
    (
        (resource.type=k8s_pod jsonPayload.reason=(BackOff OR Unhealthy OR Killing OR Evicted)) OR
        (resource.type=k8s_node jsonPayload.reason=OOMKilling)
    )
    severity=WARNING
) OR (
    log_id(cloudaudit.googleapis.com%2Factivity) resource.type=k8s_cluster
    (protoPayload.methodName=io.k8s.core.v1.pods.eviction.create OR
        (protoPayload.methodName=io.k8s.core.v1.pods.delete
        protoPayload.response.status.containerStatuses.state.terminated.exitCode:*
        -protoPayload.response.status.containerStatuses.state.terminated.exitCode=0
        )
    )
)
如需疑難排解資訊,請參閱「疑難排解:CrashLoopBackOff」。
無法排定 GKE Pod
這個事件類型可協助您找出無法在節點排定的 Pod,並排解相關問題。如果 Pod 排程因下列任一原因失敗,就會顯示這個事件類型:
- 節點 CPU 不足。
- 節點記憶體不足。
- 沒有任何節點含有污點或容忍度。
- 節點的 Pod 數量達到上限。
- 節點集區已達大小上限。
如要為這個事件類型建立記錄警告政策,請使用下列查詢:
(
    log_id(events) resource.type=k8s_pod jsonPayload.reason=(NotTriggerScaleUp OR FailedScheduling)
) OR (
    log_id(container.googleapis.com/cluster-autoscaler-visibility)
    resource.type=k8s_cluster jsonPayload.noDecisionStatus.noScaleUp:*
)
如需疑難排解資訊,請參閱「疑難排解:無法排定 Pod」。
無法建立 GKE 容器
這個事件類型可協助您找出並排解無法建立 GKE 容器的問題。無法建立容器的原因可能包括磁碟區掛接失敗,或是映像檔提取失敗。
如要為這個事件類型建立記錄警告政策,請使用下列查詢:
log_id(events) resource.type=k8s_pod jsonPayload.reason=(Failed OR FailedMount) severity=WARNING
如需映像檔提取的疑難排解資訊,請參閱「排解映像檔提取問題」。
Pod 自動配置器擴充及縮減
這類事件可讓您瞭解水平 Pod 自動配置器重新調度資源的情況,也就是增加或減少工作負載的執行中 Pod 數量。詳情請參閱「水平自動調度 Pod 資源」。
如要為這個事件類型建立記錄警告政策,請使用下列查詢:
resource.type=k8s_cluster log_id(events)
jsonPayload.involvedObject.kind=HorizontalPodAutoscaler jsonPayload.reason=SuccessfulRescale
叢集自動配置器擴充及縮減
這項事件可讓您瞭解叢集自動配置器何時會擴充或縮減叢集節點集區中的節點數量。詳情請參閱「關於叢集自動調度資源」和「查看叢集自動配置器事件」。
如要為這個事件類型建立記錄警告政策,請使用下列查詢:
(resource.type=k8s_cluster log_id(container.googleapis.com%2Fcluster-autoscaler-visibility)
jsonPayload.decision:*)
建立及刪除叢集
這類事件會記錄 GKE 叢集的建立和刪除動作。詳情請參閱「建立 Autopilot 叢集」、「建立可用區叢集」和「刪除叢集」。
如要為這個事件類型建立記錄警告政策,請使用下列查詢:
resource.type=gke_cluster log_id(cloudaudit.googleapis.com%2Factivity)
protoPayload.methodName=(
    google.container.v1alpha1.ClusterManager.CreateCluster OR
    google.container.v1beta1.ClusterManager.CreateCluster OR
    google.container.v1.ClusterManager.CreateCluster OR
    google.container.v1alpha1.ClusterManager.DeleteCluster OR
    google.container.v1beta1.ClusterManager.DeleteCluster OR
    google.container.v1.ClusterManager.DeleteCluster
)
operation.first=true
更新叢集
這類事件會記錄 GKE 叢集的更新情形,包括控制層版本自動升級、手動升級和叢集設定變更。詳情請參閱「手動升級叢集或節點集區」和「標準叢集升級」。
如要為這個事件類型建立記錄警告政策,請使用下列查詢:
resource.type=gke_cluster log_id(cloudaudit.googleapis.com%2Factivity)
(
    protoPayload.methodName=(
        google.container.internal.ClusterManagerInternal.PatchCluster OR
        google.container.internal.ClusterManagerInternal.UpdateClusterInternal OR
        google.container.internal.ClusterManagerInternal.UpdateCluster
    )
) OR (
    protoPayload.methodName=(
        google.container.v1beta1.ClusterManager.UpdateCluster OR
        google.container.v1.ClusterManager.UpdateCluster
    )
    operation.first=true
)
protoPayload.metadata.operationType=(UPGRADE_MASTER OR REPAIR_CLUSTER OR UPDATE_CLUSTER)
更新節點集區
這類事件會記錄 GKE 節點集區的更新情形,包括節點集區版本自動升級、手動升級、設定變更和大小調整。詳情請參閱「手動升級叢集或節點集區」和「標準叢集升級」。
如要為這個事件類型建立記錄警告政策,請使用下列查詢:
resource.type=gke_nodepool log_id(cloudaudit.googleapis.com%2Factivity)
(
    protoPayload.methodName=(
        google.container.internal.ClusterManagerInternal.UpdateClusterInternal OR
        google.container.internal.ClusterManagerInternal.RepairNodePool
    )
) OR (
    protoPayload.methodName=(
        google.container.v1beta1.ClusterManager.UpdateNodePool OR
        google.container.v1.ClusterManager.UpdateNodePool OR
        google.container.v1beta1.ClusterManager.SetNodePoolSize OR
        google.container.v1.ClusterManager.SetNodePoolSize OR
        google.container.v1beta1.ClusterManager.SetNodePoolManagement OR
        google.container.v1.ClusterManager.SetNodePoolManagement OR
        google.container.v1beta1.ClusterManager.SetNodePoolAutoscaling OR
        google.container.v1.ClusterManager.SetNodePoolAutoscaling
    )
    operation.first=true
)
Cloud Run 事件類型
本節說明可在資訊主頁上顯示的 Cloud Run 事件類型。
Cloud Run 部署作業
這個事件類型可協助您找出並排解 Cloud Run 部署失敗的問題。部署作業可能會因多種原因而失敗,例如服務帳戶遭刪除、權限不正確、容器匯入失敗,或容器無法啟動。
如要為這個事件類型建立記錄式警告政策,請使用下列查詢:
log_id(cloudaudit.googleapis.com%2Factivity) resource.type=cloud_run_revision
protoPayload.methodName=google.cloud.run.v1.Services.ReplaceService
如需疑難排解資訊,請參閱「疑難排解:Cloud Run 問題」。
Cloud SQL 事件類型
本節說明可在資訊主頁顯示的 Cloud SQL 事件類型。
Cloud SQL 容錯移轉
這個事件類型可協助您找出發生手動或自動容錯移轉的時間。當執行個體或可用區發生故障,且待命執行個體成為新的主要執行個體時,就會發生容錯移轉。容錯移轉期間,Cloud SQL 會自動切換為從待命執行個體提供資料。
如要為這個事件類型建立記錄式警告政策,請使用下列查詢:
resource.type=cloudsql_database
(
    (
        log_id(cloudaudit.googleapis.com%2Factivity)
        protoPayload.methodName=cloudsql.instances.failover
        operation.last=true
    ) OR (
        log_id(cloudaudit.googleapis.com%2Fsystem_event)
        protoPayload.methodName=cloudsql.instances.autoFailover
    )
)
詳情請參閱「關於高可用性」。
Cloud SQL 啟動或停止
這個事件類型可協助您找出 Cloud SQL 執行個體何時手動啟動、停止或重新啟動。執行個體停止時,所有連線、開啟的檔案和執行中的作業都會一併停止。
如要為這個事件類型建立記錄警告政策,請使用下列查詢:
log_id(cloudaudit.googleapis.com%2Factivity) resource.type=cloudsql_database
protoPayload.methodName=cloudsql.instances.update operation.last=true
protoPayload.metadata.intents.intent=(START_INSTANCE OR STOP_INSTANCE)
詳情請參閱「關於高可用性」和「啟動、停止及重新啟動執行個體」。
Cloud SQL 儲存空間
這個事件類型可協助您找出與 Cloud SQL 儲存空間相關的事件,包括資料庫儲存空間已滿,以及資料庫因儲存空間用盡而關閉的情況。為防止資料損毀,如果資料庫的儲存空間用盡,而且未啟用自動增加儲存空間功能,就有可能關閉。
如要為這個事件類型建立記錄警告政策,請使用下列查詢:
resource.type=cloudsql_database
(
    (
        (log_id(cloudsql.googleapis.com%2Fpostgres.log) OR log_id(cloudsql.googleapis.com%2Fmysql.err))
        textPayload=~"No space left on device"
        severity=(ERROR OR EMERGENCY)
    ) OR (
        log_id(cloudaudit.googleapis.com%2Fsystem_event)
        protoPayload.methodName=cloudsql.instances.databaseShutdownOutOfStorage
    )
)
Cloud Interconnect 事件類型
本節說明可在資訊主頁顯示的 Cloud Interconnect 事件類型。
互連網路維護作業已開始
這個事件類型會追蹤互連網路基礎架構維護作業的開始時間。維護作業期間,虛擬區域網路 (VLAN) 連結的邊界閘道通訊協定 (BGP) 工作階段會停止運作。
如要為這個事件類型建立記錄警告政策,請使用下列查詢:
log_id("maintenance.googleapis.com/maintenance_events")
jsonPayload.resource.type="compute.googleapis.com/Interconnect"
jsonPayload.state="RUNNING"
labels."maintenance.googleapis.com/updated_fields" : "state"
詳情請參閱「基礎架構維護事件」。
已完成互連網路維護作業
這個事件類型會追蹤互連網路基礎架構維護作業的結束時間。某些維護事件後,邊緣裝置的乙太網路 MAC 位址可能會變更。
如要為這個事件類型建立記錄警告政策,請使用下列查詢:
log_id("maintenance.googleapis.com/maintenance_events")
jsonPayload.resource.type="compute.googleapis.com/Interconnect"
jsonPayload.state="SUCCEEDED"
labels."maintenance.googleapis.com/updated_fields" : "state"
詳情請參閱「基礎架構維護事件」。
Cloud VPN 事件類型
本節說明可在資訊主頁顯示的 Cloud VPN 事件類型。
VPN 維護作業
這個事件類型會追蹤 VPN 工作的基礎架構維護作業。包括維護作業開始和完成的事件。
如要為這個事件類型建立記錄警告政策,請使用下列查詢:
log_id("cloud.googleapis.com/ipsec_events")
resource.type="vpn_gateway"
(
    textPayload:"Starting VPN task maintenance" OR
    textPayload:"VPN task maintenance Completed"
)
VPN 流量選取器範圍已縮小
這個事件類型可協助您找出 Child SA 流量選取器範圍縮小的時間。包括本機和遠端流量選取器的事件。
如要為這個事件類型建立記錄警告政策,請使用下列查詢:
log_id("cloud.googleapis.com/ipsec_events")
resource.type="vpn_gateway"
(
    textPayload:"Warning: Local traffic selectors narrowed for Child SA" OR
    textPayload:"Warning: Remote traffic selectors narrowed for Child SA"
)
Compute Engine 事件類型
本節說明可在資訊主頁顯示的 Compute Engine 事件類型。
終止虛擬機器
這個事件類型可協助您找出虛擬機器 (VM) 終止事件,包括手動觸發的重設和停止作業、客體 OS 終止事件、維護作業終止事件和主機錯誤。
如要為這個事件類型建立記錄式警告政策,請使用下列查詢:
resource.type=gce_instance
(
    (
        log_id(cloudaudit.googleapis.com%2Factivity)
        protoPayload.methodName=(
            beta.compute.instances.reset OR v1.compute.instances.reset OR
            beta.compute.instances.stop OR v1.compute.instances.stop
        )
        operation.first=true
    ) OR (
        log_id(cloudaudit.googleapis.com%2Fsystem_event)
        protoPayload.methodName=(
            compute.instances.hostError OR
            compute.instances.guestTerminate OR
            compute.instances.terminateOnHostMaintenance
        )
    )
)
詳情請參閱「停止及啟動 VM」和「排解 VM 關機和重新啟動的問題」。
VM 執行個體啟動失敗
這類事件會記錄 Compute Engine VM 執行個體啟動失敗的情形,包括因多種錯誤而無法啟動的情況,例如資源用盡、IP 空間耗盡、超過配額,或是 Shielded VM 完整性有異狀。
如要為這個事件類型建立記錄式警告政策,請使用下列查詢:
resource.type=gce_instance
(
    (
        log_id(cloudaudit.googleapis.com%2Factivity)
        protoPayload.methodName=(beta.compute.instances.insert OR v1.compute.instances.insert)
        protoPayload.status.message=(ZONE_RESOURCE_POOL_EXHAUSTED OR IP_SPACE_EXHAUSTED OR QUOTA_EXCEEDED)
    ) OR (
        log_id(compute.googleapis.com%2Fshielded_vm_integrity)
        severity="ERROR"
    )
)
VM 執行個體訪客 OS 錯誤
這類事件會記錄特定 Compute Engine VM 執行個體訪客 OS 錯誤,相關內容列於序列控制台記錄檔。會記錄的錯誤包括磁碟空間已滿、檔案系統掛接失敗,以及導致 Linux 緊急模式啟動的開機失敗情況。
如要顯示這些事件,請在 VM 或專案中繼資料設定 serial-port-logging-enable=true,啟用以 Cloud Logging 記錄序列埠輸出內容的功能。詳情請參閱「啟用及停用序列埠輸出記錄功能」。
如要為這個事件類型建立記錄式警告政策,請使用下列查詢:
resource.type=gce_instance
log_id(serialconsole.googleapis.com%2Fserial_port_1_output)
textPayload=~("No space left on device" OR "Failed to mount" OR "You are in emergency mode")
代管執行個體群組更新
這個事件類型可協助您找出代管執行個體群組 (MIG) 的更新時間。例如新增或移除 VM,或更新大小限制。詳情請參閱「自動套用 MIG 中的 VM 設定更新」一文。
如要為這個事件類型建立記錄式警告政策,請使用下列查詢:
resource.type=gce_instance_group_manager
log_id(cloudaudit.googleapis.com%2Factivity) operation.first=true
protoPayload.methodName=(beta.compute.instanceGroupManagers.patch OR v1.compute.instanceGroupManagers.patch)
詳情請參閱「使用代管執行個體」和「排解代管執行個體群組問題」。
代管執行個體群組自動配置器
這類事件會追蹤 MIG 自動配置器的資源調度決策。可能包括 MIG 建議大小的變更,或是自動配置器本身的狀態異動。詳情請參閱「自動調整資源配置執行個體群組」。
如要為這個事件類型建立記錄式警告政策,請使用下列查詢:
resource.type=autoscaler log_id(cloudaudit.googleapis.com%2Fsystem_event)
protoPayload.methodName=(compute.autoscalers.resize OR compute.autoscalers.changeStatus)
Personalized Service Health 事件類型
本節說明可在資訊主頁上顯示的 Personalized Service Health 事件類型。
Google Cloud 事件
疑難排解時,您可能需要區分故障是由您擁有的服務引起,還是由您使用的Google Cloud 服務引起。在資訊主頁啟用 Personalized Service Health 註解後,即可查看 Google Cloud 服務的中斷情形或服務健康狀態事件。如要查看與 Service Health 整合的服務清單,請參閱「支援的 Google 產品」。
與其他事件類型不同, Google Cloud 事件並非透過分析記錄項目來識別。如要在這些事件發生時收到通知,請建立警告政策。您可以使用「Service Health Dashboard」頁面上的選項,選取預先設定的警告政策。詳情請參閱「快速入門導覽課程:設定快訊」。
Monitoring 會向 Service Health API 發出要求,然後篩選出與您查看的資料相關的事件,藉此找出 Google Cloud 事件。要求設定如下:
Relevance列舉設為RELATED、IMPACTED或PARTIALLY_RELATED。這項限制可確保資訊主頁只會顯示Google Cloud 專案使用的 Google Cloud 服務事件。DetailedState列舉未設為FALSE_POSITIVE。
Service Health 註解會顯示開始時間和持續時間。系統會變更圖表的背景顏色,以顯示時間長度。 Google Cloud 事件的工具提示會指出下列資訊:
- Google Cloud 服務。
- 事件是待處理或已解決。
- 活動日期和開始時間。
- 顯示受影響產品和位置數量的方塊。 如要列出受影響的產品或位置,請將滑鼠游標移至對應的方塊。
- 「View」(查看) 按鈕:選取後,系統會開啟事件的詳細資料頁面。
如要瞭解如何向 Service Health API 發出要求,請參閱「使用 Service Health 檢查服務中斷情形」。
如需疑難排解資訊,請參閱「排解 Service Health 的常見問題」。
運作時間檢查事件類型
本節說明可在資訊主頁上顯示的運作時間檢查事件類型。
運作時間檢查失敗
這個事件類型可協助您找出所設區域的運作時間檢查失敗情形。
如要為這個事件類型建立記錄警告政策,請使用下列查詢:
log_id(monitoring.googleapis.com%2Fuptime_checks)
(
  resource.type=uptime_url OR resource.type=gce_instance OR
  resource.type=gae_app OR resource.type=k8s_service OR
  resource.type=servicedirectory_service OR resource.type=cloud_run_revision OR
  resource.type=aws_ec2_instance OR resource.type=aws_elb_load_balancer
)
labels.uptime_result_type=UptimeCheckResult
severity=NOTICE
如需疑難排解資訊,請參閱「排解綜合監控和運作時間檢查問題」。
Agent for SAP 事件類型
本節說明可在資訊主頁顯示的 Agent for SAP 事件類型。
SAP 可用性
這個事件類型可協助您找出與 Agent for SAP 可用性相關的事件。SAP HANA、SAP NetWeaver 或 Pacemaker 叢集的可用性有異動時,就會觸發這些事件。
如要為這個事件類型建立記錄警告政策,請使用下列查詢:
log_id(google-cloud-sap-agent)
(
  resource.type=generic_node OR resource.type=gce_instance OR
  resource.type=aws_ec2_instance OR resource.type=baremetalsolution.googleapis.com/Instance
)
jsonPayload.metricEvent=true
jsonPayload.metric=(workload.googleapis.com/sap/hana/service OR workload.googleapis.com/sap/hana/availability OR
  workload.googleapis.com/sap/nw/service OR workload.googleapis.com/sap/nw/availability OR
  workload.googleapis.com/sap/cluster/nodes OR workload.googleapis.com/sap/cluster/resources)
SAP Backint
這個事件類型可協助您找出與 Agent for SAP Backint 相關的事件。所有 Backint 備份或復原作業都會寫入事件,詳細說明成功或失敗的情形,以及轉移作業統計資料。系統只會在失敗時列出記錄備份和復原事件,但無論成功或失敗,都會顯示資料備份和復原事件。
log_id(google-cloud-sap-agent-backint)
(
  resource.type=generic_node OR resource.type=gce_instance OR
  resource.type=aws_ec2_instance OR resource.type=baremetalsolution.googleapis.com/Instance
)
(jsonPayload.fileType=data OR (jsonPayload.fileType=log AND jsonPayload.success=false))
jsonPayload.message=SAP_BACKINT_FILE_TRANSFER
SAP 作業
這個事件類型可協助您找出與 Agent for SAP 作業相關的事件。SAP HANA 複製作業狀態有異動時,就會觸發這些事件。
如要為這個事件類型建立記錄警告政策,請使用下列查詢:
log_id(google-cloud-sap-agent)
(
  resource.type=generic_node OR resource.type=gce_instance OR
  resource.type=aws_ec2_instance OR resource.type=baremetalsolution.googleapis.com/Instance
)
jsonPayload.metricEvent=true
jsonPayload.metric=workload.googleapis.com/sap/hana/ha/replication
後續步驟
如要瞭解如何在資訊主頁上顯示事件,請參閱「在資訊主頁上顯示事件」。