


Mit dem BigQuery Connector for Apache Spark können Data Scientists die Leistungsfähigkeit der nahtlos skalierbaren SQL-Engine mit den Apache Spark Machine Learning-Funktionen kombinieren. In diesem Tutorial wird gezeigt, wie Sie mit Managed Service for Apache Spark, BigQuery und Apache Spark ML maschinelles Lernen für einen Datensatz durchführen.
Ziele
Verwenden Sie die lineare Regression, um ein Modell zum Geburtsgewicht als Funktion mit fünf Faktoren zu erstellen:- Schwangerschaftswochen
- Alter der Mutter
- Alter des Vaters
- Gewichtszunahme der Mutter während der Schwangerschaft
- Apgar-Score
Verwenden Sie die folgenden Tools:
- BigQuery, um die Eingabetabelle für die lineare Regression vorzubereiten, die in Ihr Google Cloud -Projekt geschrieben wird
- Python zum Abfragen und Verwalten von Daten in BigQuery
- Apache Spark, um auf die resultierende Tabelle für die lineare Regression zuzugreifen
- Spark ML zum Erstellen und Bewerten des Modells
- Managed Service for Apache Spark-PySpark-Job zum Aufrufen von Spark ML-Funktionen
Kosten
In diesem Dokument verwenden Sie die folgenden kostenpflichtigen Komponenten von Google Cloud:
- Compute Engine
- Managed Service for Apache Spark
- BigQuery
Mit dem Preisrechner können Sie eine Kostenschätzung für Ihre voraussichtliche Nutzung vornehmen.
Hinweis
In einem Managed Service for Apache Spark-Cluster sind die Spark-Komponenten, einschließlich Spark ML, installiert. Damit Sie einen Managed Service for Apache Spark-Cluster einrichten und den Code in diesem Beispiel ausführen können, müssen Sie Folgendes tun (oder getan haben):
- Melden Sie sich in Ihrem Google Cloud -Konto an. Wenn Sie mit Google Cloudnoch nicht vertraut sind, erstellen Sie einfach ein Konto, um die Leistungsfähigkeit unserer Produkte in der Praxis sehen und bewerten zu können. Neukunden erhalten außerdem ein Guthaben von 300 $, um Arbeitslasten auszuführen, zu testen und bereitzustellen.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
Enable the Dataproc, BigQuery, Compute Engine APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
Install the Google Cloud CLI.
-
If you're using an external identity provider (IdP), you must first sign in to the gcloud CLI with your federated identity.
-
To initialize the gcloud CLI, run the following command:
gcloud init -
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
Enable the Dataproc, BigQuery, Compute Engine APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
Install the Google Cloud CLI.
-
If you're using an external identity provider (IdP), you must first sign in to the gcloud CLI with your federated identity.
-
To initialize the gcloud CLI, run the following command:
gcloud init - Erstellen Sie einen Managed Service for Apache Spark-Cluster in Ihrem Projekt. Auf Ihrem Cluster sollte eine Managed Service for Apache Spark-Version mit Spark 2.0 oder höher ausgeführt werden (einschließlich Machine-Learning-Bibliotheken).
Teilmengen von BigQuery-Daten zur Geburtenstatistik erstellen
In diesem Abschnitt erstellen Sie ein Dataset in Ihrem Projekt, dann eine Tabelle in diesem Dataset, in das Sie eine Teilmenge der Daten zu Geburtenraten aus dem öffentlich zugänglichen BigQuery-Dataset natality kopieren. Später in dieser Anleitung verwenden Sie die Teilmengendaten in dieser Tabelle, um das Geburtsgewicht in Abhängigkeit vom Alter der Mutter, des Vaters und von den Schwangerschaftswochen vorherzusagen.
Sie können die Teilmenge der Daten über die Google Cloud Console oder durch Ausführen eines Python-Skripts auf Ihrem lokalen Computer erstellen.
Console
Erstellen Sie ein Dataset in Ihrem Projekt.
- Rufen Sie die Web-UI von BigQuery auf.
- Klicken Sie im linken Navigationsbereich auf den Namen Ihres Projekts und anschließend auf DATASET ERSTELLEN.
- Gehen Sie im Dialogfeld Dataset erstellen so vor:
- Geben Sie als Dataset ID (Dataset-ID) "natality_regression" ein.
- Wählen Sie unter Speicherort der Daten einen Standort für das Dataset aus. Der Standardwert für den Standort ist
US multi-region. Nachdem ein Dataset erstellt wurde, kann der Standort nicht mehr geändert werden. - Wählen Sie für Standard-Tabellenablauf eine der folgenden Optionen aus:
- Nie: (Standardeinstellung) Sie müssen die Tabelle manuell löschen.
- Anzahl Tage: Die Tabelle wird nach der angegebenen Anzahl von Tagen ab ihrer Erstellung gelöscht.
- Wählen Sie für Verschlüsselung eine der folgenden Optionen aus:
- Google-owned and Google-managed encryption key (Standard)
- Vom Kunden verwalteter Schlüssel: Siehe Daten mit Cloud KMS-Schlüsseln schützen.
- Klicken Sie auf Dataset erstellen.
Führen Sie eine Abfrage für das öffentliche "natality"-Dataset aus und speichern Sie die Abfrageergebnisse in einer neuen Tabelle in Ihrem Dataset.
- Kopieren Sie die folgende Abfrage und fügen Sie sie in den Abfrageeditor ein. Klicken Sie dann auf "Ausführen".
CREATE OR REPLACE TABLE natality_regression.regression_input as
SELECT
weight_pounds,
mother_age,
father_age,
gestation_weeks,
weight_gain_pounds,
apgar_5min
FROM
`bigquery-public-data.samples.natality`
WHERE
weight_pounds IS NOT NULL
AND mother_age IS NOT NULL
AND father_age IS NOT NULL
AND gestation_weeks IS NOT NULL
AND weight_gain_pounds IS NOT NULL
AND apgar_5min IS NOT NULL
- Nachdem die Abfrage abgeschlossen ist (nach etwa einer Minute), werden die Ergebnisse als BigQuery-Tabelle „regression_input“ im Dataset
natality_regressionin Ihrem Projekt gespeichert.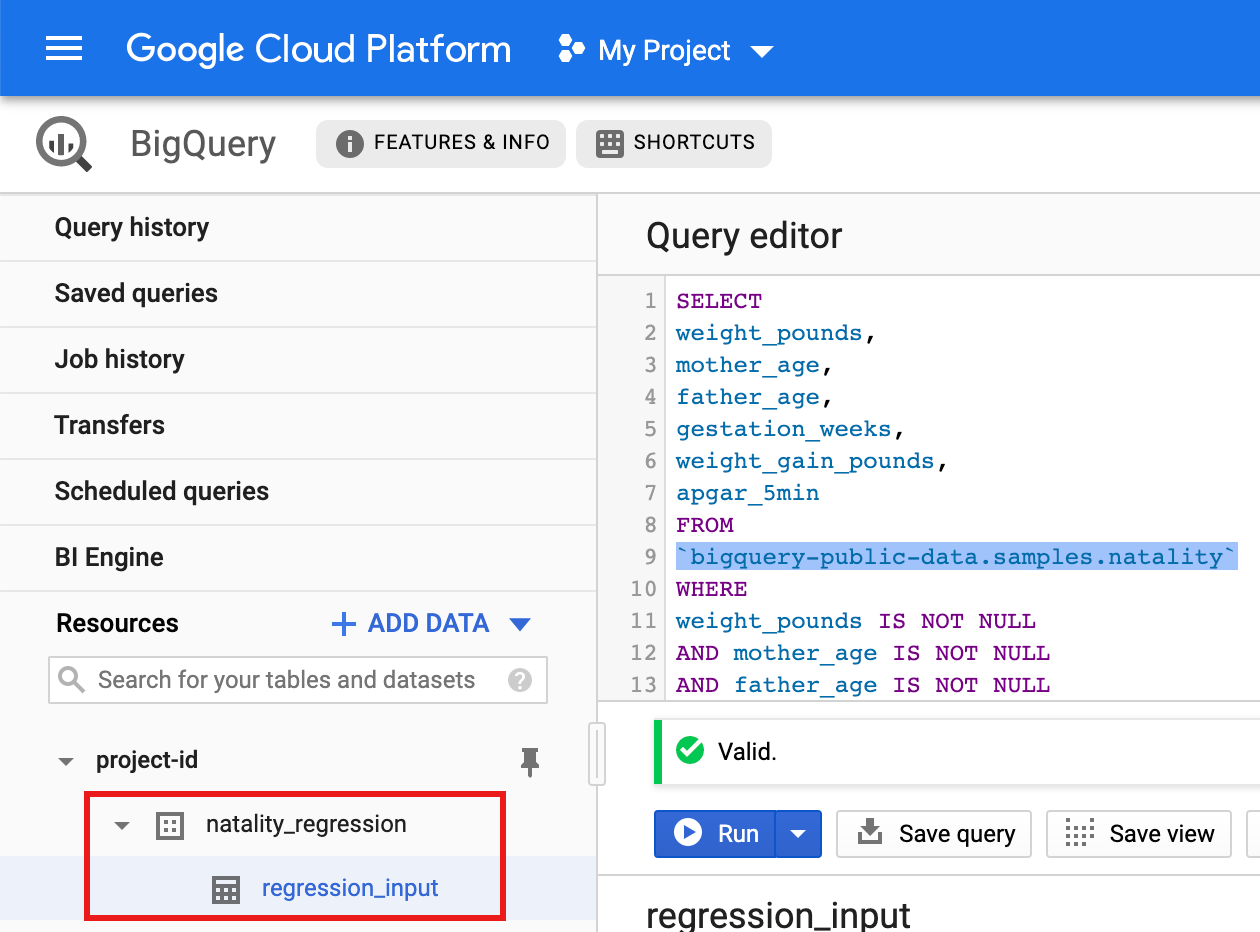
- Kopieren Sie die folgende Abfrage und fügen Sie sie in den Abfrageeditor ein. Klicken Sie dann auf "Ausführen".
Python
Bevor Sie dieses Beispiel ausprobieren, folgen Sie der Einrichtungsanleitung für Python in der Managed Service for Apache Spark-Kurzanleitung zur Verwendung von Clientbibliotheken. Weitere Informationen finden Sie in der Referenzdokumentation zur Managed Service for Apache Spark Python API.
Richten Sie zur Authentifizierung bei Managed Service for Apache Spark die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Eine Anleitung zum Installieren von Python und der Google Cloud-Clientbibliothek für Python (erforderlich zum Ausführen des Codes) finden Sie unter Python-Entwicklungsumgebung einrichten. Es wird empfohlen, eine
virtualenvvon Python zu installieren und zu verwenden.Kopieren Sie den nachfolgenden
natality_tutorial.py-Code und fügen Sie ihn in einepython-Shell auf Ihrem lokalen Computer ein. Drücken Sie in der Shell die<return>-Taste, um den Code auszuführen, mit dem das BigQuery-Dataset „natality_regression“ in Ihrem StandardprojektGoogle Cloud erstellt wird. Es enthält die Tabelle „regression_input“, die mit einer Teilmenge der öffentlichennatality-Daten gefüllt wird.Bestätigen Sie das Erstellen des Datasets
natality_regressionund der Tabelleregression_input.
Lineare Regression ausführen
In diesem Abschnitt führen Sie eine lineare PySpark-Regression aus, indem Sie den Job über die Google Cloud Console an Managed Service for Apache Spark senden oder den gcloud-Befehl über ein lokales Terminal ausführen.
Console
Kopieren Sie den folgenden Code und fügen Sie ihn in eine neue
natality_sparkml.py-Datei auf Ihrem lokalen Computer ein."""Run a linear regression using Apache Spark ML. In the following PySpark (Spark Python API) code, we take the following actions: * Load a previously created linear regression (BigQuery) input table into our Cloud Dataproc Spark cluster as an RDD (Resilient Distributed Dataset) * Transform the RDD into a Spark Dataframe * Vectorize the features on which the model will be trained * Compute a linear regression using Spark ML """ from pyspark.context import SparkContext from pyspark.ml.linalg import Vectors from pyspark.ml.regression import LinearRegression from pyspark.sql.session import SparkSession # The imports, above, allow us to access SparkML features specific to linear # regression as well as the Vectors types. # Define a function that collects the features of interest # (mother_age, father_age, and gestation_weeks) into a vector. # Package the vector in a tuple containing the label (`weight_pounds`) for that # row. def vector_from_inputs(r): return (r["weight_pounds"], Vectors.dense(float(r["mother_age"]), float(r["father_age"]), float(r["gestation_weeks"]), float(r["weight_gain_pounds"]), float(r["apgar_5min"]))) sc = SparkContext() spark = SparkSession(sc) # Read the data from BigQuery as a Spark Dataframe. natality_data = spark.read.format("bigquery").option( "table", "natality_regression.regression_input").load() # Create a view so that Spark SQL queries can be run against the data. natality_data.createOrReplaceTempView("natality") # As a precaution, run a query in Spark SQL to ensure no NULL values exist. sql_query = """ SELECT * from natality where weight_pounds is not null and mother_age is not null and father_age is not null and gestation_weeks is not null """ clean_data = spark.sql(sql_query) # Create an input DataFrame for Spark ML using the above function. training_data = clean_data.rdd.map(vector_from_inputs).toDF(["label", "features"]) training_data.cache() # Construct a new LinearRegression object and fit the training data. lr = LinearRegression(maxIter=5, regParam=0.2, solver="normal") model = lr.fit(training_data) # Print the model summary. print("Coefficients:" + str(model.coefficients)) print("Intercept:" + str(model.intercept)) print("R^2:" + str(model.summary.r2)) model.summary.residuals.show()
Kopieren Sie die lokale
natality_sparkml.py-Datei in einen Cloud Storage-Bucket in Ihrem Projekt.gcloud storage cp natality_sparkml.py gs://bucket-name
Führen Sie die Regression über die Seite Job senden von Managed Service for Apache Spark aus.
Fügen Sie im Feld Python-Hauptdatei den
gs://-URI des Cloud Storage-Buckets ein, in dem sich Ihre Kopie dernatality_sparkml.py-Datei befindet.Wählen Sie
PySparkals Jobtyp aus.Fügen Sie
gs://spark-lib/bigquery/spark-bigquery-latest_2.12.jarin das Feld Jar-Dateien ein. Dadurch wird der Spark-BigQuery-Connector der PySpark-Anwendung zur Laufzeit zur Verfügung gestellt, damit sie BigQuery-Daten in einem Spark-DataFrame lesen kann.Füllen Sie die Felder Job-ID, Region und Cluster aus.
Klicken Sie auf Submit (Senden), um den Job in Ihrem Cluster auszuführen.
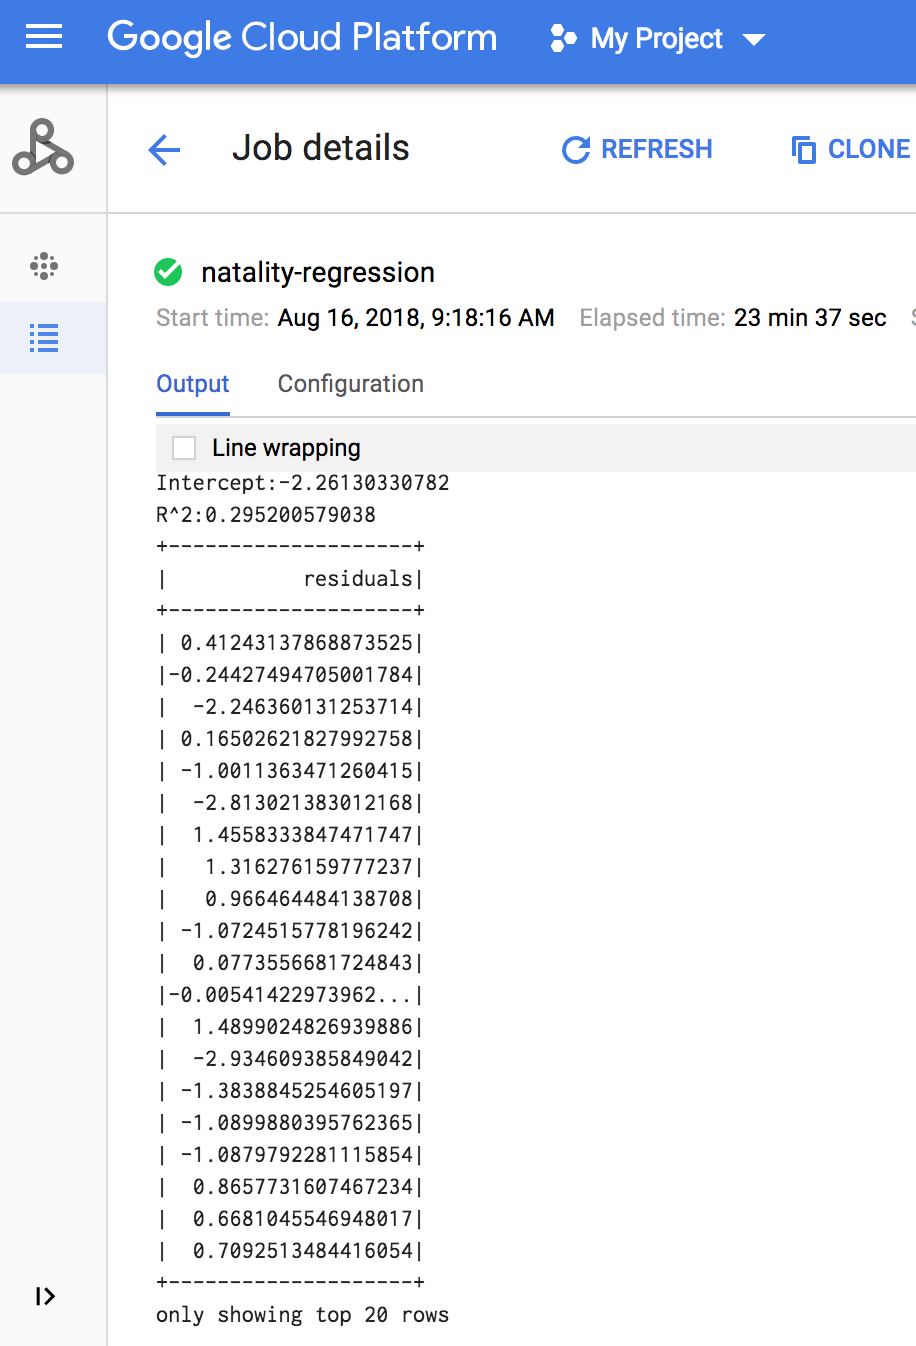
Wenn der Job abgeschlossen ist, wird die Zusammenfassung des linearen Regressionsausgabemodells im Fenster „Jobdetails“ von Managed Service for Apache Spark angezeigt.
gcloud
Kopieren Sie den folgenden Code und fügen Sie ihn in eine neue
natality_sparkml.py-Datei auf Ihrem lokalen Computer ein."""Run a linear regression using Apache Spark ML. In the following PySpark (Spark Python API) code, we take the following actions: * Load a previously created linear regression (BigQuery) input table into our Cloud Dataproc Spark cluster as an RDD (Resilient Distributed Dataset) * Transform the RDD into a Spark Dataframe * Vectorize the features on which the model will be trained * Compute a linear regression using Spark ML """ from pyspark.context import SparkContext from pyspark.ml.linalg import Vectors from pyspark.ml.regression import LinearRegression from pyspark.sql.session import SparkSession # The imports, above, allow us to access SparkML features specific to linear # regression as well as the Vectors types. # Define a function that collects the features of interest # (mother_age, father_age, and gestation_weeks) into a vector. # Package the vector in a tuple containing the label (`weight_pounds`) for that # row. def vector_from_inputs(r): return (r["weight_pounds"], Vectors.dense(float(r["mother_age"]), float(r["father_age"]), float(r["gestation_weeks"]), float(r["weight_gain_pounds"]), float(r["apgar_5min"]))) sc = SparkContext() spark = SparkSession(sc) # Read the data from BigQuery as a Spark Dataframe. natality_data = spark.read.format("bigquery").option( "table", "natality_regression.regression_input").load() # Create a view so that Spark SQL queries can be run against the data. natality_data.createOrReplaceTempView("natality") # As a precaution, run a query in Spark SQL to ensure no NULL values exist. sql_query = """ SELECT * from natality where weight_pounds is not null and mother_age is not null and father_age is not null and gestation_weeks is not null """ clean_data = spark.sql(sql_query) # Create an input DataFrame for Spark ML using the above function. training_data = clean_data.rdd.map(vector_from_inputs).toDF(["label", "features"]) training_data.cache() # Construct a new LinearRegression object and fit the training data. lr = LinearRegression(maxIter=5, regParam=0.2, solver="normal") model = lr.fit(training_data) # Print the model summary. print("Coefficients:" + str(model.coefficients)) print("Intercept:" + str(model.intercept)) print("R^2:" + str(model.summary.r2)) model.summary.residuals.show()
Kopieren Sie die lokale
natality_sparkml.py-Datei in einen Cloud Storage-Bucket in Ihrem Projekt.gcloud storage cp natality_sparkml.py gs://bucket-name
Senden Sie den PySpark-Job an Managed Service for Apache Spark, indem Sie den unten gezeigten
gcloud-Befehl in einem Terminalfenster auf Ihrem lokalen Computer ausführen.- Mit dem Wert des Flags --jars wird der Spark-BigQuery-Connector dem PySpark-Job zur Laufzeit zur Verfügung gestellt, damit er BigQuery-Daten in einem Spark-DataFrame lesen kann.
gcloud dataproc jobs submit pyspark \
    gs://your-bucket/natality_sparkml.py \
    --cluster=cluster-name \
    --region=region \
    --jars=gs://spark-lib/bigquery/spark-bigquery-with-dependencies_SCALA_VERSION-CONNECTOR_VERSION.jar
- Mit dem Wert des Flags --jars wird der Spark-BigQuery-Connector dem PySpark-Job zur Laufzeit zur Verfügung gestellt, damit er BigQuery-Daten in einem Spark-DataFrame lesen kann.
Die Ausgabe der linearen Regression (Modellübersicht) wird im Terminalfenster angezeigt, wenn der Job abgeschlossen ist.
<<< # Print the model summary.
... print "Coefficients:" + str(model.coefficients)
Coefficients:[0.0166657454602,-0.00296751984046,0.235714392936,0.00213002070133,-0.00048577251587]
<<< print "Intercept:" + str(model.intercept)
Intercept:-2.26130330748
<<< print "R^2:" + str(model.summary.r2)
R^2:0.295200579035
<<< model.summary.residuals.show()
+--------------------+
|           residuals|
+--------------------+
| -0.7234737533344147|
|  -0.985466980630501|
| -0.6669710598385468|
|  1.4162434829714794|
|-0.09373154375186754|
|-0.15461747949235072|
| 0.32659061654192545|
|  1.5053877697929803|
|  -0.640142797263989|
|   1.229530260294963|
|-0.03776160295256...|
| -0.5160734239126814|
| -1.5165972740062887|
|  1.3269085258245008|
|  1.7604670124710626|
|  1.2348130901905972|
|   2.318660276655887|
|  1.0936947030883175|
|  1.0169768511417363|
| -1.7744915698181583|
+--------------------+
only showing top 20 rows.
Bereinigen
Nachdem Sie die Anleitung abgeschlossen haben, können Sie die erstellten Ressourcen bereinigen, damit sie keine Kontingente mehr nutzen und keine Gebühren mehr anfallen. In den folgenden Abschnitten erfahren Sie, wie Sie diese Ressourcen löschen oder deaktivieren.
Projekt löschen
Am einfachsten vermeiden Sie weitere Kosten durch Löschen des für die Anleitung erstellten Projekts.
So löschen Sie das Projekt:
- Wechseln Sie in der Google Cloud -Console zur Seite Ressourcen verwalten.
- Wählen Sie in der Projektliste das Projekt aus, das Sie löschen möchten, und klicken Sie dann auf Löschen.
- Geben Sie im Dialogfeld die Projekt-ID ein und klicken Sie auf Shut down (Beenden), um das Projekt zu löschen.
Managed Service for Apache Spark-Cluster löschen
Siehe Cluster löschen.