


Questo documento descrive come installare e utilizzare l'estensione JupyterLab su una macchina o una VM autogestita che ha accesso ai servizi Google. Descrive inoltre come sviluppare ed eseguire il deployment del codice dei notebook Spark serverless.
Installa l'estensione in pochi minuti per usufruire delle seguenti funzionalità:
- Avvia i notebook Spark e BigQuery serverless per sviluppare rapidamente il codice
- Sfoglia e visualizza l'anteprima dei set di dati BigQuery in JupyterLab
- Modifica i file di Cloud Storage in JupyterLab
- Pianifica un notebook su Composer
Utilizza Google Cloud Data Agent Kit: oltre a JupyterLab, puoi anche sviluppare e gestire i workload di Managed Service for Apache Spark in VS Code utilizzando Data Agent Kit. Data Agent Kit ti consente di gestire l'intero ciclo di vita del workload dei dati nel tuo IDE o utilizzando un'interfaccia a riga di comando agentica supportata, inclusa la creazione di pipeline di dati.
Prima di iniziare
- Accedi al tuo account Google Cloud . Se non conosci Google Cloud, crea un account per valutare le prestazioni dei nostri prodotti in scenari reali. I nuovi clienti ricevono anche 300 $di crediti senza costi per l'esecuzione, il test e il deployment di workload.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that you have the permissions required to complete this guide.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Dataproc API, if it is not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
Install the Google Cloud CLI.
-
If you're using an external identity provider (IdP), you must first sign in to the gcloud CLI with your federated identity.
-
To initialize the gcloud CLI, run the following command:
gcloud init -
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that you have the permissions required to complete this guide.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Dataproc API, if it is not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
Install the Google Cloud CLI.
-
If you're using an external identity provider (IdP), you must first sign in to the gcloud CLI with your federated identity.
-
To initialize the gcloud CLI, run the following command:
gcloud init
Ruoli obbligatori
Per eseguire gli esempi in questa pagina sono necessari determinati ruoli IAM. A seconda delle policy dell'organizzazione, questi ruoli potrebbero essere già stati concessi. Per controllare le concessioni dei ruoli, consulta Devi concedere i ruoli?.
Per saperne di più sulla concessione dei ruoli, consulta Gestisci l'accesso a progetti, cartelle e organizzazioni.
Ruoli utente
Per ottenere le autorizzazioni necessarie per creare una sessione di blocco note interattivo, chiedi all'amministratore di concederti i seguenti ruoli IAM:
- Dataproc Editor (
roles/dataproc.editor) sul progetto - Utente dell'account di servizio (
roles/iam.serviceAccountUser) sul service account predefinito di Compute Engine
Ruolo service account
Per assicurarti che il account di servizio predefinito di Compute Engine disponga delle autorizzazioni necessarie per creare una sessione interattiva, chiedi all'amministratore di concedere il ruolo IAM Dataproc Worker (roles/dataproc.worker) al account di servizio predefinito di Compute Engine nel progetto.
Installa l'estensione JupyterLab
Puoi installare e utilizzare l'estensione JupyterLab su una macchina o una VM che ha accesso ai servizi Google, ad esempio la tua macchina locale o un'istanza VM di Compute Engine.
Per installare l'estensione, segui questi passaggi:
Scarica e installa Python versione 3.11 o successive da
python.org/downloads.- Verifica l'installazione di Python 3.11 o versioni successive.
python3 --version
- Verifica l'installazione di Python 3.11 o versioni successive.
Virtualizza l'ambiente Python.
pip3 install pipenv
- Crea una cartella di installazione.
mkdir jupyter
- Passa alla cartella di installazione.
cd jupyter
- Crea un ambiente virtuale.
pipenv shell
- Crea una cartella di installazione.
Installa JupyterLab nell'ambiente virtuale.
pipenv install jupyterlab
Installa l'estensione JupyterLab.
pipenv install bigquery-jupyter-plugin
jupyter lab
La pagina Avvio app di JupyterLab si apre nel browser. Contiene una sezione Job e sessioni Dataproc. Può anche contenere le sezioni Notebook Dataproc Serverless e Notebook dei cluster Dataproc se hai accesso ai notebook o ai cluster di Managed Service for Apache Spark con il componente facoltativo Jupyter in esecuzione nel tuo progetto.
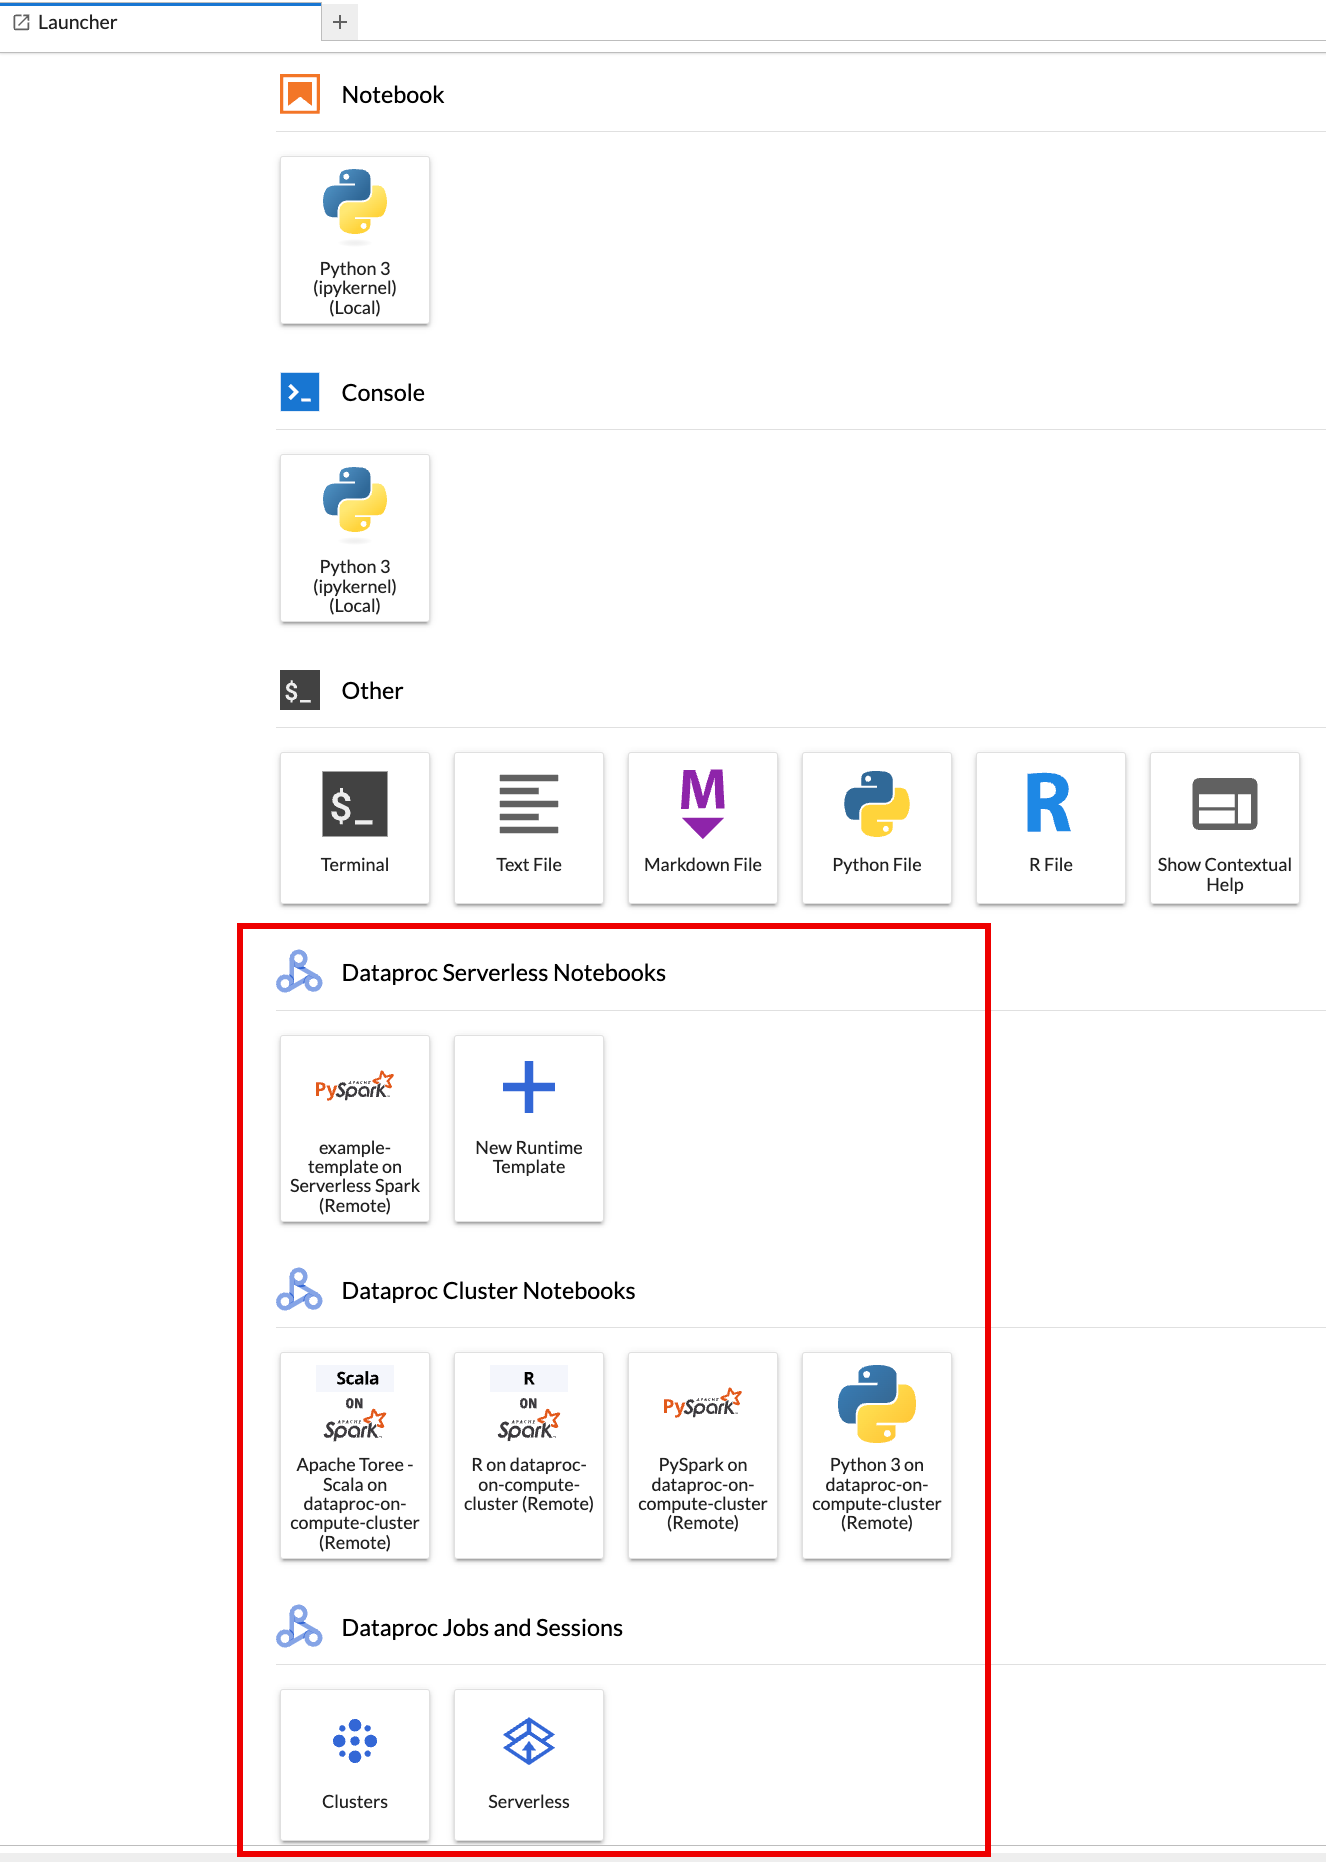
Per impostazione predefinita, la sessione interattiva viene eseguita nel progetto e nella regione che hai impostato quando hai eseguito
gcloud initin Prima di iniziare. Puoi modificare le impostazioni del progetto e della regione per le tue sessioni da JupyterLab Impostazioni > Google Cloud Impostazioni > Google Cloud Impostazioni progetto.Per applicare le modifiche, devi riavviare l'estensione.
Crea un template di runtime di Managed Service for Apache Spark
I template di runtime di Managed Service for Apache Spark (chiamati profili di runtime nella pagina Profili di runtime della consoleGoogle Cloud e template di sessione in Google Cloud CLI e nell'API Dataproc) contengono le impostazioni di configurazione per l'esecuzione del codice Spark in una sessione. Puoi creare e gestire i template di runtime utilizzando JupyterLab, la consoleGoogle Cloud o Google Cloud CLI.
JupyterLab
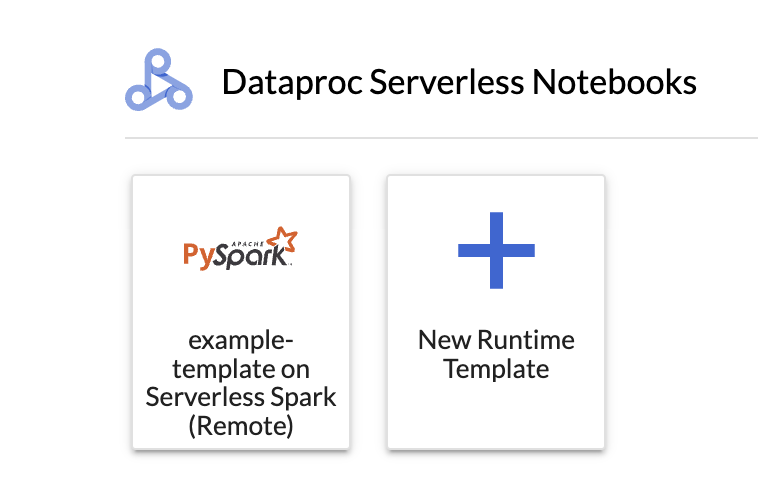
Fai clic sulla scheda
New runtime templatenella sezione Notebook Dataproc Serverless della pagina Avvio app di JupyterLab.
Compila il modulo Template di runtime.
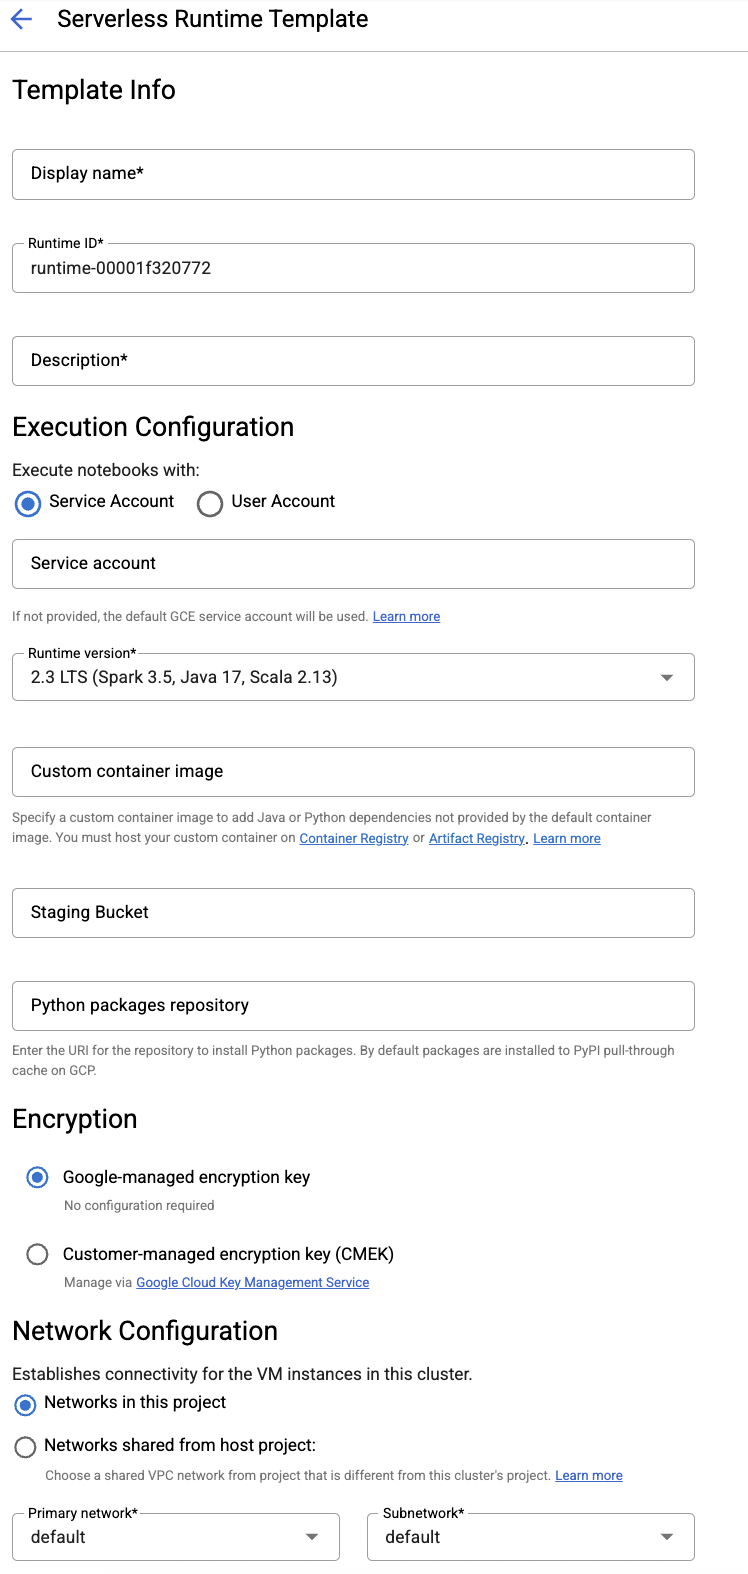
Informazioni sul template:
- Nome visualizzato, ID runtime e Descrizione: accetta o compila un nome visualizzato, un ID runtime e una descrizione del template.
Configurazione dell'esecuzione: seleziona Account utente per eseguire i notebook con l'identità utente anziché con l'identità del account di servizio Dataproc.
- Service account: se non specifichi un account di servizio, viene utilizzato il service account di servizio predefinito di Compute Engine.
- Versione runtime: conferma o seleziona la
2.3versione runtime. - Immagine container personalizzata: facoltativamente, specifica l'URI di un'immagine container personalizzata.
- Bucket di staging: facoltativamente, puoi specificare il nome di un bucket di staging Cloud Storage che verrà utilizzato da Managed Service for Apache Spark.
- Repository dei pacchetti Python: per impostazione predefinita, i pacchetti Python vengono scaricati e installati dalla cache pull-through PyPI quando gli utenti eseguono i comandi di installazione
pipnei loro notebook. Puoi specificare il repository di artefatti privato della tua organizzazione per i pacchetti Python da utilizzare come repository predefinito per i pacchetti Python.
Crittografia: accetta l'impostazione predefinita Google-owned and Google-managed encryption key o seleziona Chiave di crittografia gestita dal cliente (CMEK). Se scegli CMEK, seleziona o fornisci le informazioni sulla chiave.
Configurazione di rete: seleziona una subnet nel progetto o condivisa da un progetto host (puoi modificare il progetto da JupyterLab Impostazioni > Google Cloud Impostazioni > Google Cloud Impostazioni progetto. Puoi specificare i tag di rete da applicare alla rete specificata. Tieni presente che Managed Service for Apache Spark abilita l'accesso privato Google (PGA) sulla subnet specificata. Per i requisiti di connettività di rete, consulta Configurazione di rete di Managed Service for Apache Spark.
Configurazione della sessione: facoltativamente, puoi compilare questi campi per limitare la durata delle sessioni create con il template.
- Tempo di inattività massimo: il tempo di inattività massimo prima che la sessione venga terminata. Intervallo consentito: da 10 minuti a 336 ore (14 giorni).
- Tempo di sessione massimo: la durata massima di una sessione prima che venga terminata. Intervallo consentito: da 10 minuti a 336 ore (14 giorni).
Metastore: per utilizzare un servizio Dataproc Metastore con le tue sessioni, seleziona l'ID progetto e il servizio del metastore.
Server di cronologia permanente: puoi selezionare un server di cronologia Spark permanente disponibile per accedere ai log delle sessioni durante e dopo le sessioni.
Proprietà Spark: puoi selezionare e aggiungere le proprietà Allocazione delle risorse, Scalabilità automatica o GPU di Spark. Fai clic su Aggiungi proprietà per aggiungere altre proprietà Spark. Per saperne di più, consulta Proprietà di Spark.
Etichette: fai clic su Aggiungi etichetta per ogni etichetta da impostare sulle sessioni create con il template.
Fai clic su Salva per creare il modello.
Per visualizzare o eliminare un template di runtime.
- Fai clic su Impostazioni > Google Cloud Impostazioni.
La sezione Impostazioni di Dataproc > Modelli di runtime serverless mostra l'elenco dei modelli di runtime.
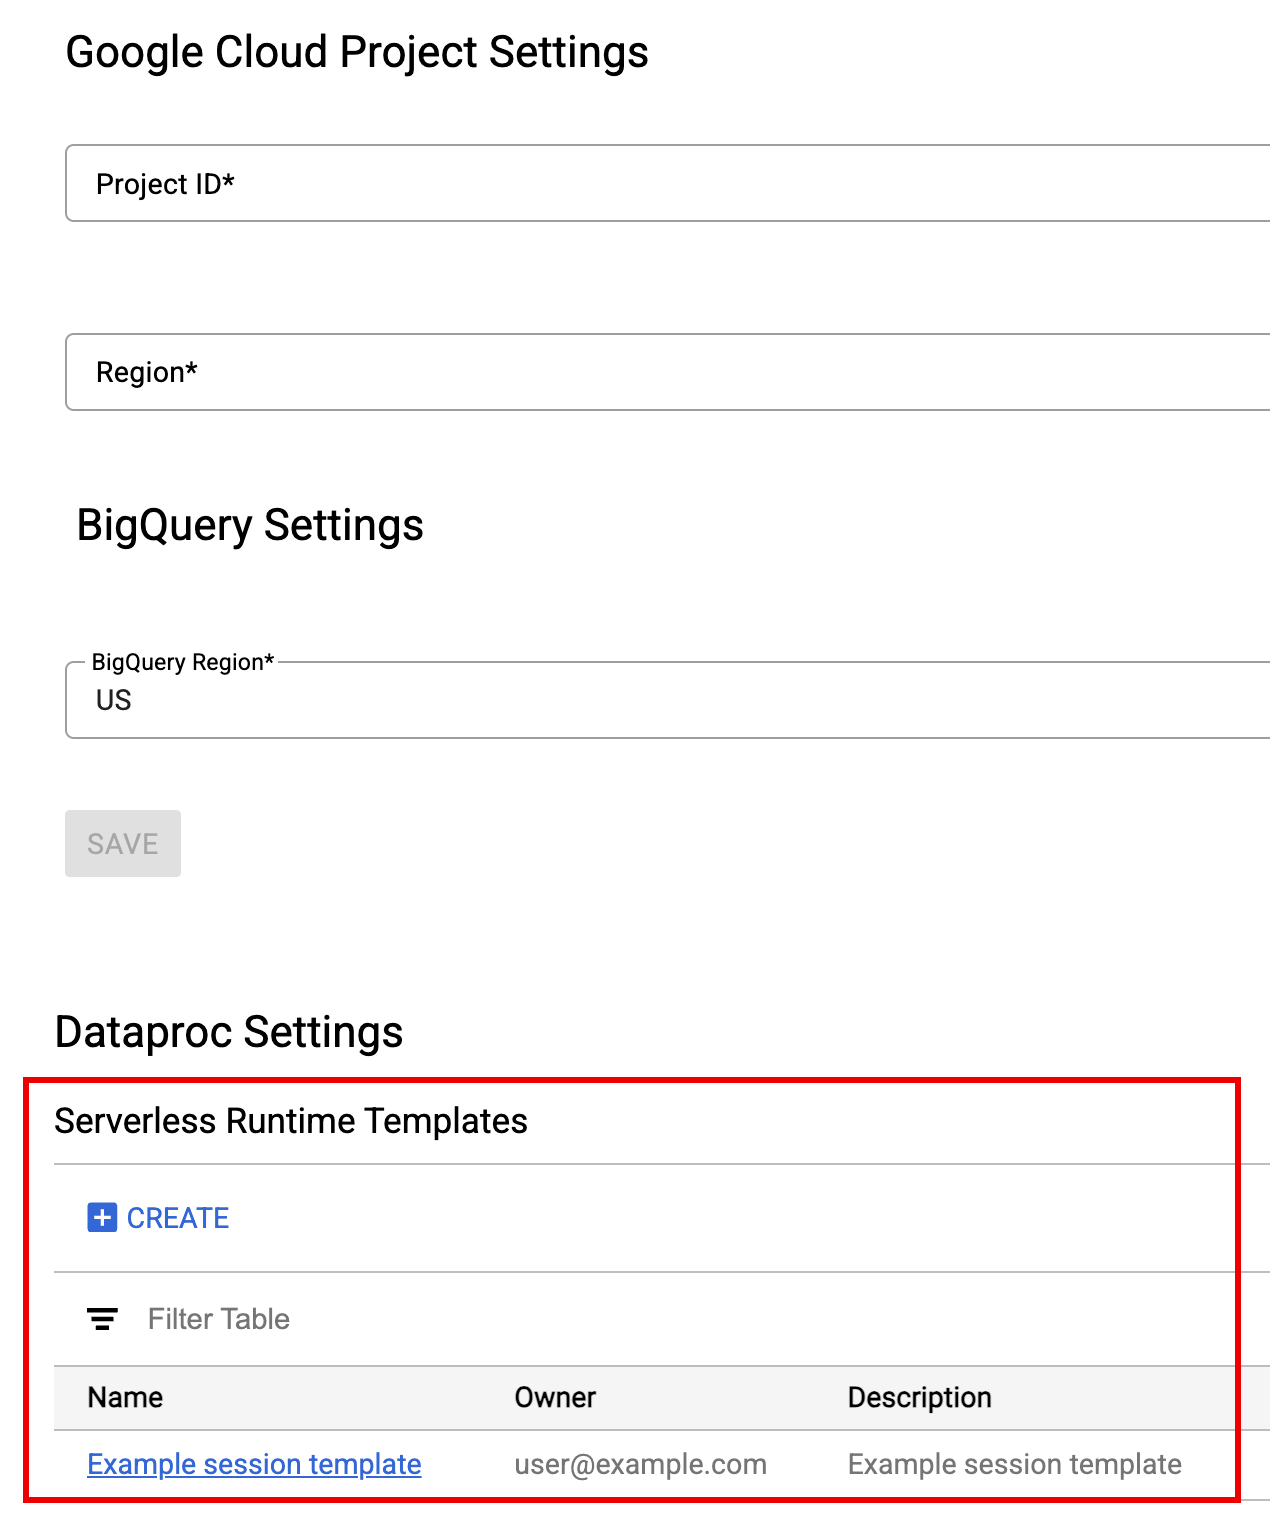
- Fai clic sul nome di un modello per visualizzarne i dettagli.
- Puoi eliminare un modello dal menu Azione del modello.
Apri e ricarica la pagina Avvio app di JupyterLab per visualizzare la scheda del modello di notebook salvato nella pagina Avvio app di JupyterLab.
gcloud
Crea un file YAML con la configurazione del template di runtime.
YAML semplice
environmentConfig:
  executionConfig:
    networkUri: default
jupyterSession:
  kernel: PYTHON
  displayName: Team A
labels:
  purpose: testing
description: Team A Development Environment
YAML complesso
description: Example session template
environmentConfig:
  executionConfig:
    serviceAccount: sa1
    # Choose either networkUri or subnetworkUri
    networkUri:
    subnetworkUri: default
    networkTags:
     - tag1
    kmsKey: key1
    idleTtl: 3600s
    ttl: 14400s
    stagingBucket: staging-bucket
  peripheralsConfig:
    metastoreService: projects/my-project-id/locations/us-central1/services/my-metastore-id
    sparkHistoryServerConfig:
      dataprocCluster: projects/my-project-id/regions/us-central1/clusters/my-cluster-id
jupyterSession:
  kernel: PYTHON
  displayName: Team A
labels:
  purpose: testing
runtimeConfig:
  version: "2.3"
  containerImage: gcr.io/my-project-id/my-image:1.0.1
  properties:
    "p1": "v1"
description: Team A Development Environment
Crea un modello di sessione (profilo di runtime) dal file YAML eseguendo il seguente comando gcloud beta dataproc session-templates import localmente o in Cloud Shell:
gcloud beta dataproc session-templates import TEMPLATE_ID \
    --source=YAML_FILE \
    --project=PROJECT_ID \
    --location=REGION
- Consulta gcloud beta dataproc session-templates per i comandi per descrivere, elencare, esportare ed eliminare i template di sessione (profili di runtime).
Avvia e gestisci i notebook
Dopo aver installato l'estensione JupyterLab di Managed Service for Apache Spark, puoi fare clic sulle schede dei modelli nella pagina Avvio app di JupyterLab per:
Avvia un notebook Jupyter
La sezione Notebook Dataproc Serverless nella pagina di Avvio app di JupyterLab mostra le schede dei modelli di notebook che corrispondono ai modelli di runtime di Managed Service for Apache Spark (consulta Crea un modello di runtime di Managed Service for Apache Spark).
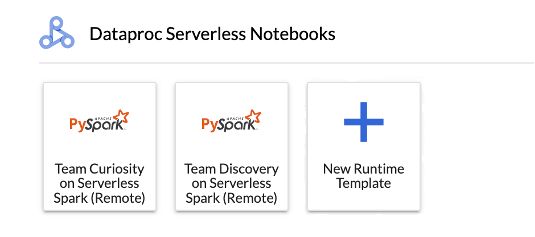
Fai clic su una scheda per creare una sessione Managed Service for Apache Spark e avviare un notebook. Al termine della creazione della sessione e quando il kernel del notebook è pronto per l'uso, lo stato del kernel cambia da
StartingaIdle (Ready).Scrivere e testare il codice del notebook.
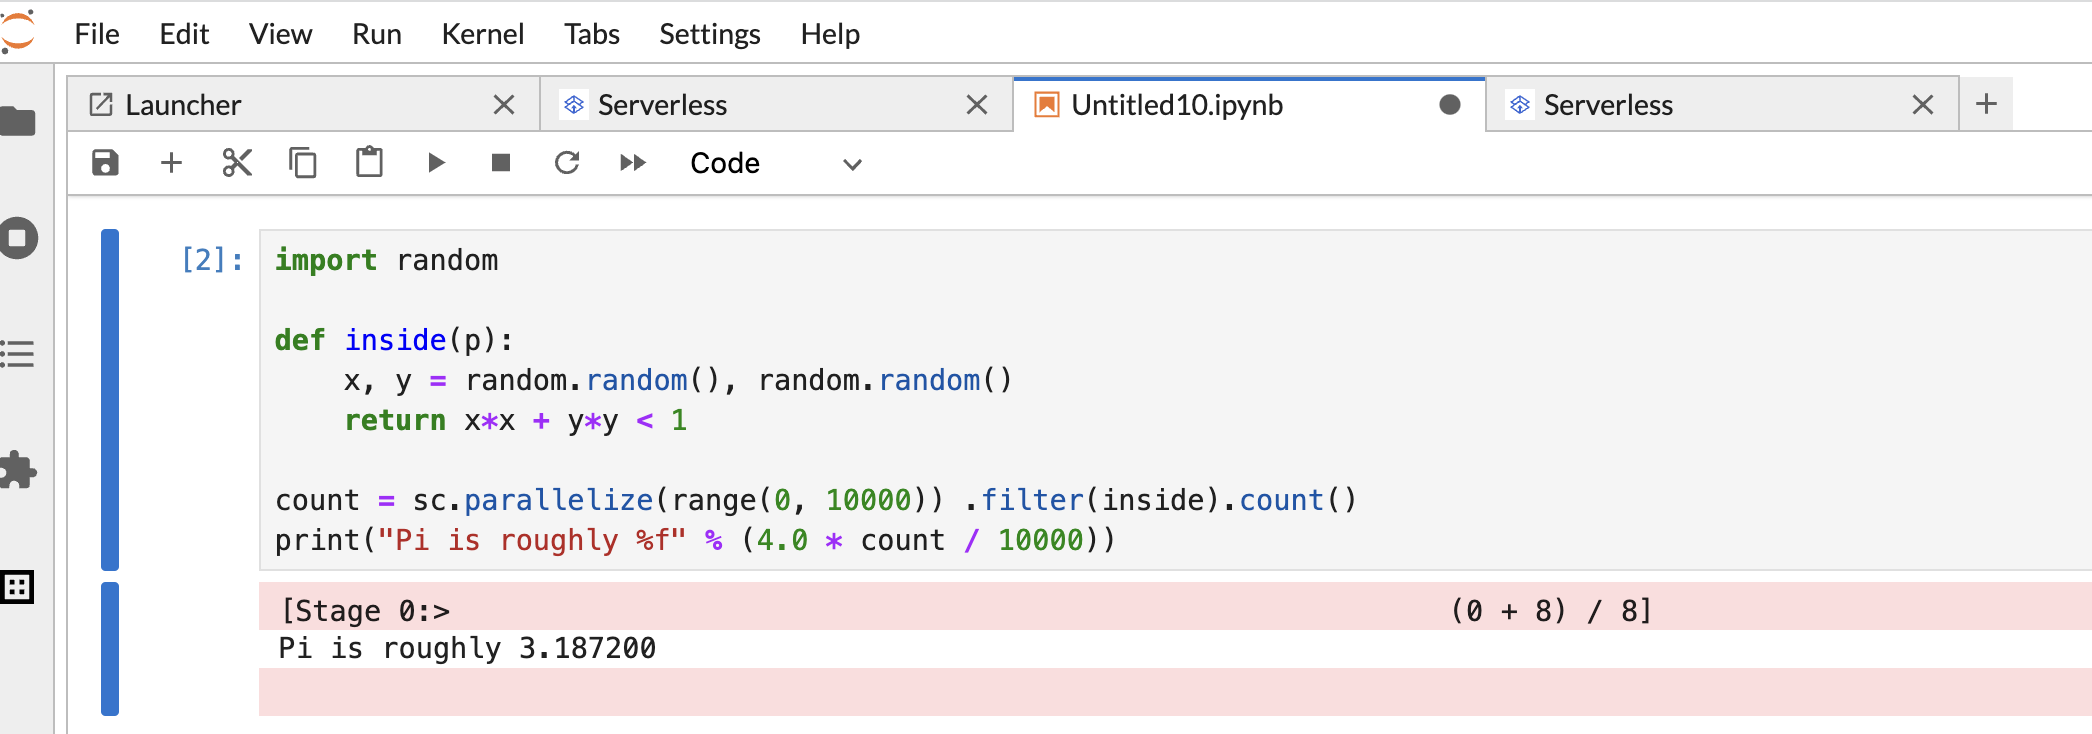
Copia e incolla il seguente codice PySpark
Pi estimationnella cella del blocco note PySpark, quindi premi Maiusc+Invio per eseguire il codice.import random def inside(p): x, y = random.random(), random.random() return x*x + y*y < 1 count = sc.parallelize(range(0, 10000)) .filter(inside).count() print("Pi is roughly %f" % (4.0 * count / 10000))
Risultato del notebook:
Dopo aver creato e utilizzato un notebook, puoi terminare la sessione del notebook facendo clic su Arresta kernel nella scheda Kernel.
- Per riutilizzare la sessione, crea un nuovo notebook scegliendo Notebook dal menu File>> Nuovo. Dopo aver creato il nuovo notebook, scegli la sessione esistente dalla finestra di dialogo di selezione del kernel. Il nuovo notebook riutilizzerà la sessione e manterrà il contesto della sessione del notebook precedente.
Se non termini la sessione, Managed Service for Apache Spark la termina alla scadenza del timer di inattività della sessione. Puoi configurare il tempo di inattività della sessione nella configurazione del template di runtime. Il tempo di inattività predefinito della sessione è di un'ora.
Avvia un notebook su un cluster
Se hai creato un cluster Jupyter Managed Service for Apache Spark, la pagina Avvio app di JupyterLab contiene una sezione Notebook del cluster Dataproc con schede kernel preinstallate.
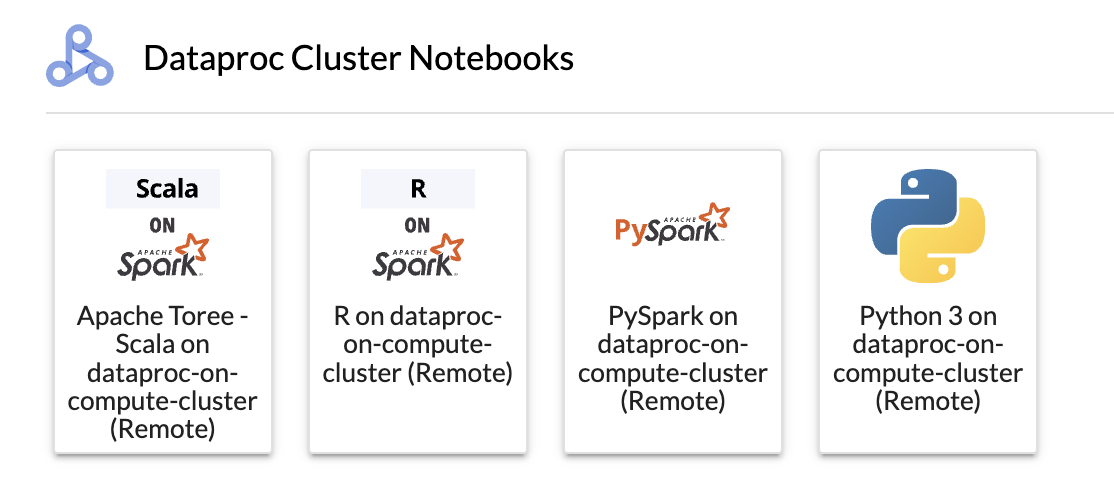
Per avviare un blocco note Jupyter sul cluster Managed Service for Apache Spark su Compute Engine:
Fai clic su una scheda nella sezione Notebook del cluster Dataproc.
Quando lo stato del kernel cambia da
StartingaIdle (Ready), puoi iniziare a scrivere ed eseguire il codice del notebook.Dopo aver creato e utilizzato un notebook, puoi terminare la sessione del notebook facendo clic su Arresta kernel nella scheda Kernel.
Gestisci i file di input e output in Cloud Storage
L'analisi dei dati esplorativi e la creazione di modelli ML spesso comportano input e output basati su file. Managed Service for Apache Spark accede a questi file su Cloud Storage.
Per accedere al browser Cloud Storage, fai clic sull'icona del browser Cloud Storage nella barra laterale della pagina Avvio app di JupyterLab, quindi fai doppio clic su una cartella per visualizzarne i contenuti.
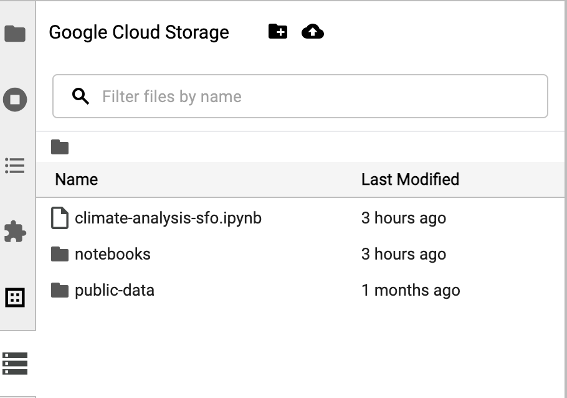
Puoi fare clic sui tipi di file supportati da Jupyter per aprirli e modificarli. Quando salvi le modifiche ai file, queste vengono scritte in Cloud Storage.
Per creare una nuova cartella Cloud Storage, fai clic sull'icona della nuova cartella, quindi inserisci il nome della cartella.
Per caricare i file in un bucket Cloud Storage o in una cartella, fai clic sull'icona di caricamento, quindi seleziona i file da caricare.
Sviluppa il codice del notebook Spark
Dopo aver installato l'estensione JupyterLab, puoi avviare i blocchi note Jupyter dalla pagina Avvio app di JupyterLab per sviluppare il codice dell'applicazione.
Sviluppo di codice PySpark e Python
I cluster Managed Service for Apache Spark supportano i kernel PySpark e Python.
Fai clic su una scheda PySpark nella sezione Notebook Dataproc Serverless o Notebook cluster Dataproc nella pagina Avvio app di JupyterLab per aprire un notebook PySpark.
Fai clic su una scheda del kernel Python nella sezione Notebook del cluster Dataproc nella pagina Avvio app di JupyterLab per aprire un notebook Python.
Sviluppo di codice SQL
Per aprire un notebook PySpark per scrivere ed eseguire codice SQL, nella pagina Avvio app di JupyterLab, nella sezione Dataproc Serverless Notebooks o Dataproc Cluster Notebook, fai clic sulla scheda del kernel PySpark.
Spark SQL magic: poiché il kernel PySpark che avvia i notebook Dataproc Serverless è precaricato con Spark SQL magic, invece di utilizzare spark.sql('SQL STATEMENT').show() per aggregare l'istruzione SQL, puoi digitare %%sparksql magic nella parte superiore di una cella, quindi digitare l'istruzione SQL nella cella.
BigQuery SQL: il connettore BigQuery Spark consente al codice del notebook di caricare i dati dalle tabelle BigQuery, eseguire l'analisi in Spark e quindi scrivere i risultati in una tabella BigQuery.
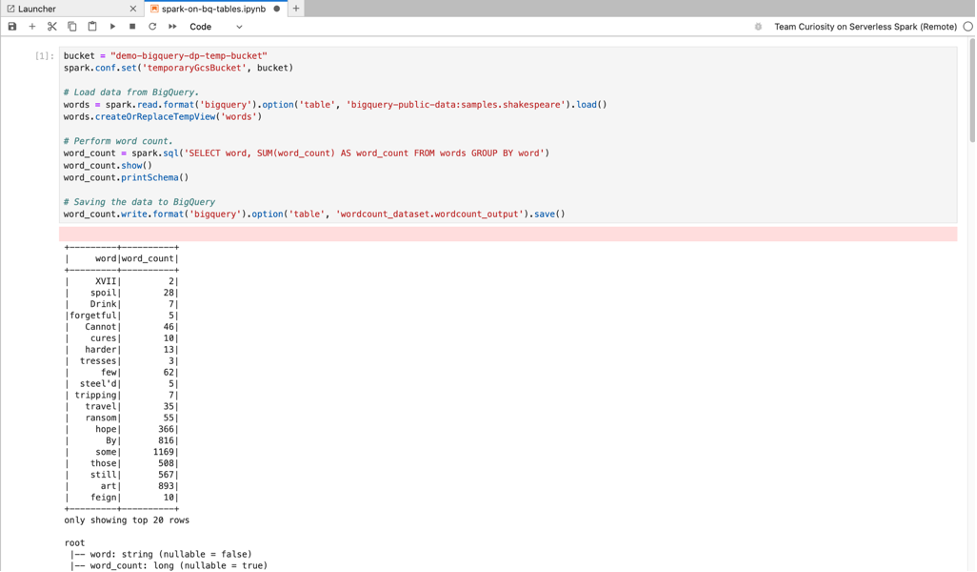
I runtime di Managed Service for Apache Spark 2.2 e versioni successive includono il connettore BigQuery Spark.
Se utilizzi un runtime precedente per avviare i notebook di Managed Service for Apache Spark, puoi installare il connettore Spark BigQuery aggiungendo la seguente proprietà Spark al template di runtime di Managed Service for Apache Spark:
spark.jars: gs://spark-lib/bigquery/spark-bigquery-with-dependencies_2.12-0.25.2.jar
Sviluppo di codice Scala
I cluster Managed Service for Apache Spark creati con le versioni immagine 2.0 e successive includono Apache Toree, un kernel Scala per la piattaforma Jupyter Notebook che fornisce l'accesso interattivo a Spark.
Fai clic sulla scheda Apache Toree nella sezione Notebook del cluster Dataproc della pagina Avvio app di JupyterLab per aprire un notebook per lo sviluppo di codice Scala.
Figura 1. Scheda del kernel Apache Toree nella pagina Avvio app di JupyterLab.
Sviluppa codice con l'estensione Visual Studio Code
Puoi utilizzare l'estensione Google Cloud Visual Studio Code (VS Code) per:
Sviluppa ed esegui il codice Spark nei notebook di Managed Service for Apache Spark.
Creare e gestire profili di runtime di Managed Service for Apache Spark (modelli di sessione), sessioni interattive e workload batch.
L'estensione Visual Studio Code è senza costi, ma ti vengono addebitati i costi per i serviziGoogle Cloud , tra cui Managed Service for Apache Spark, Managed Service for Apache Spark e le risorse Cloud Storage che utilizzi.
Utilizza VS Code con BigQuery: puoi anche utilizzare VS Code con BigQuery per:
- Sviluppare ed eseguire notebook BigQuery.
- Sfoglia, ispeziona e visualizza l'anteprima dei set di dati BigQuery.
Prima di iniziare
- Scarica e installa VS Code.
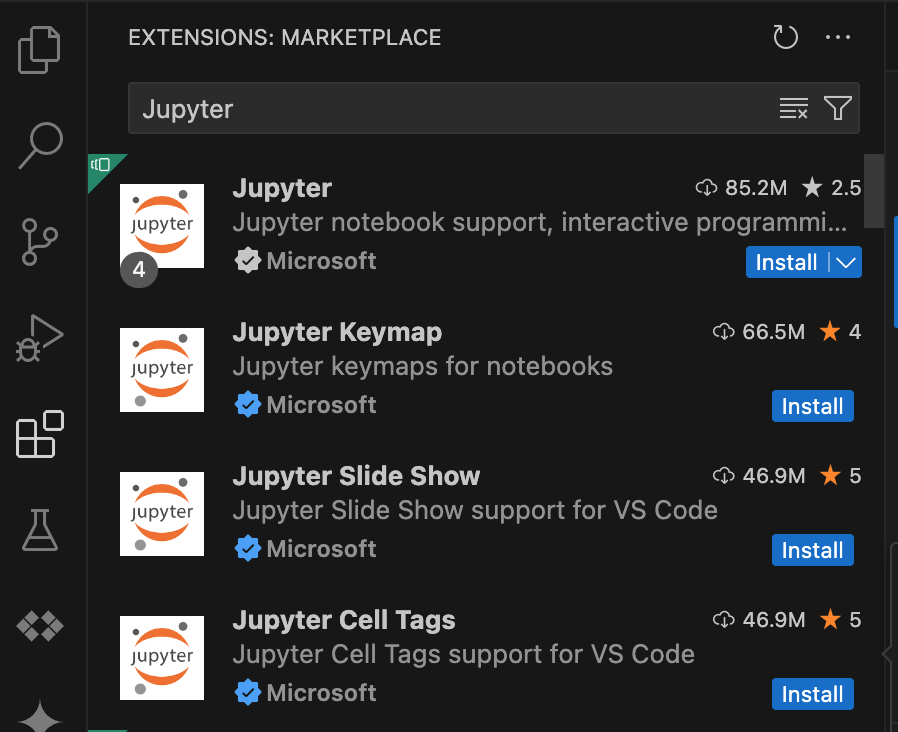
- Apri VS Code e, nella barra delle attività, fai clic su Estensioni.
Utilizzando la barra di ricerca, trova l'estensione Jupyter e fai clic su Installa. L'estensione Jupyter di Microsoft è una dipendenza obbligatoria.
Installa l'estensione Google Cloud
- Apri VS Code e, nella barra delle attività, fai clic su Estensioni.
Utilizzando la barra di ricerca, trova l'estensione Google Cloud Code e poi fai clic su Installa.
Se richiesto, riavvia VS Code.
L'icona Google Cloud Code è ora visibile nella barra delle attività di VS Code.
Configurare l'estensione
- Apri VS Code, quindi nella barra delle attività fai clic su Google Cloud Code.
- Apri la sezione Dataproc.
- Fai clic su Login to Google Cloud (Accedi a). Viene eseguito il reindirizzamento per accedere con le tue credenziali.
- Utilizza la barra delle applicazioni di primo livello per andare a Code > Settings > Settings > Extensions.
- Trova Google Cloud Code e fai clic sull'icona Manage per aprire il menu.
- Seleziona Settings (Impostazioni).
- Nei campi Progetto e Regione di Managed Service for Apache Spark, inserisci il nome del progetto Google Cloud e la regione da utilizzare per sviluppare i notebook e gestire le risorse di Managed Service for Apache Spark.
Sviluppa notebook
- Apri VS Code, quindi nella barra delle attività fai clic su Google Cloud Code.
- Apri la sezione Notebook, quindi fai clic su Nuovo notebook Spark serverless.
- Seleziona o crea un nuovo profilo di runtime (modello di sessione) da utilizzare per la sessione del notebook.
Viene creato un nuovo file
.ipynbcontenente il codice campione, che viene aperto nell'editor.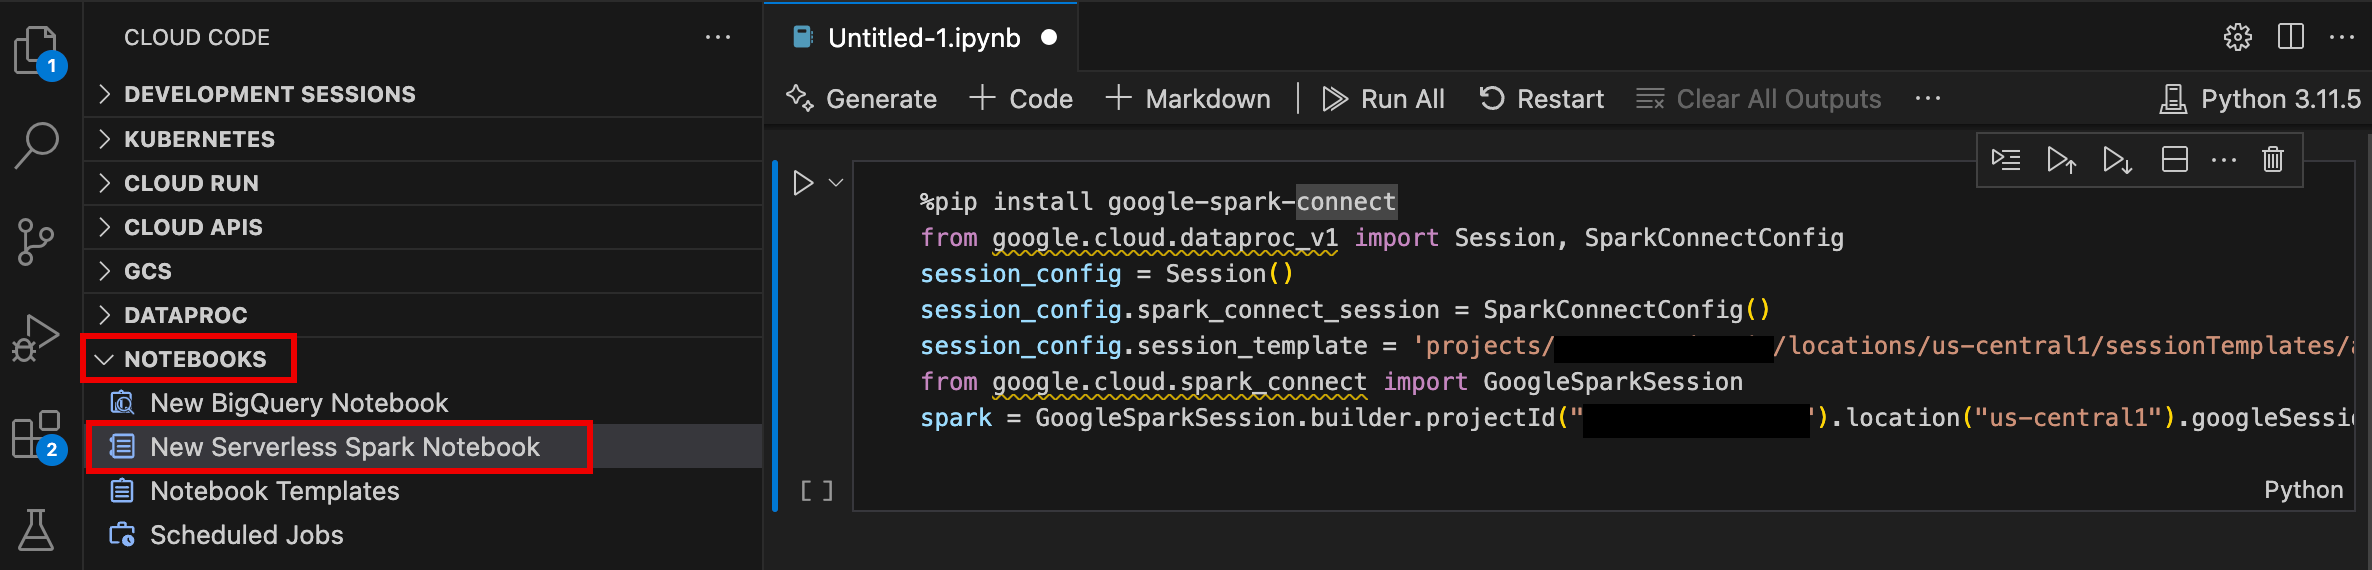
Ora puoi scrivere ed eseguire codice nel tuo blocco note di Managed Service for Apache Spark.
Crea e gestisci le risorse
- Apri VS Code, quindi nella barra delle attività fai clic su Google Cloud Code.
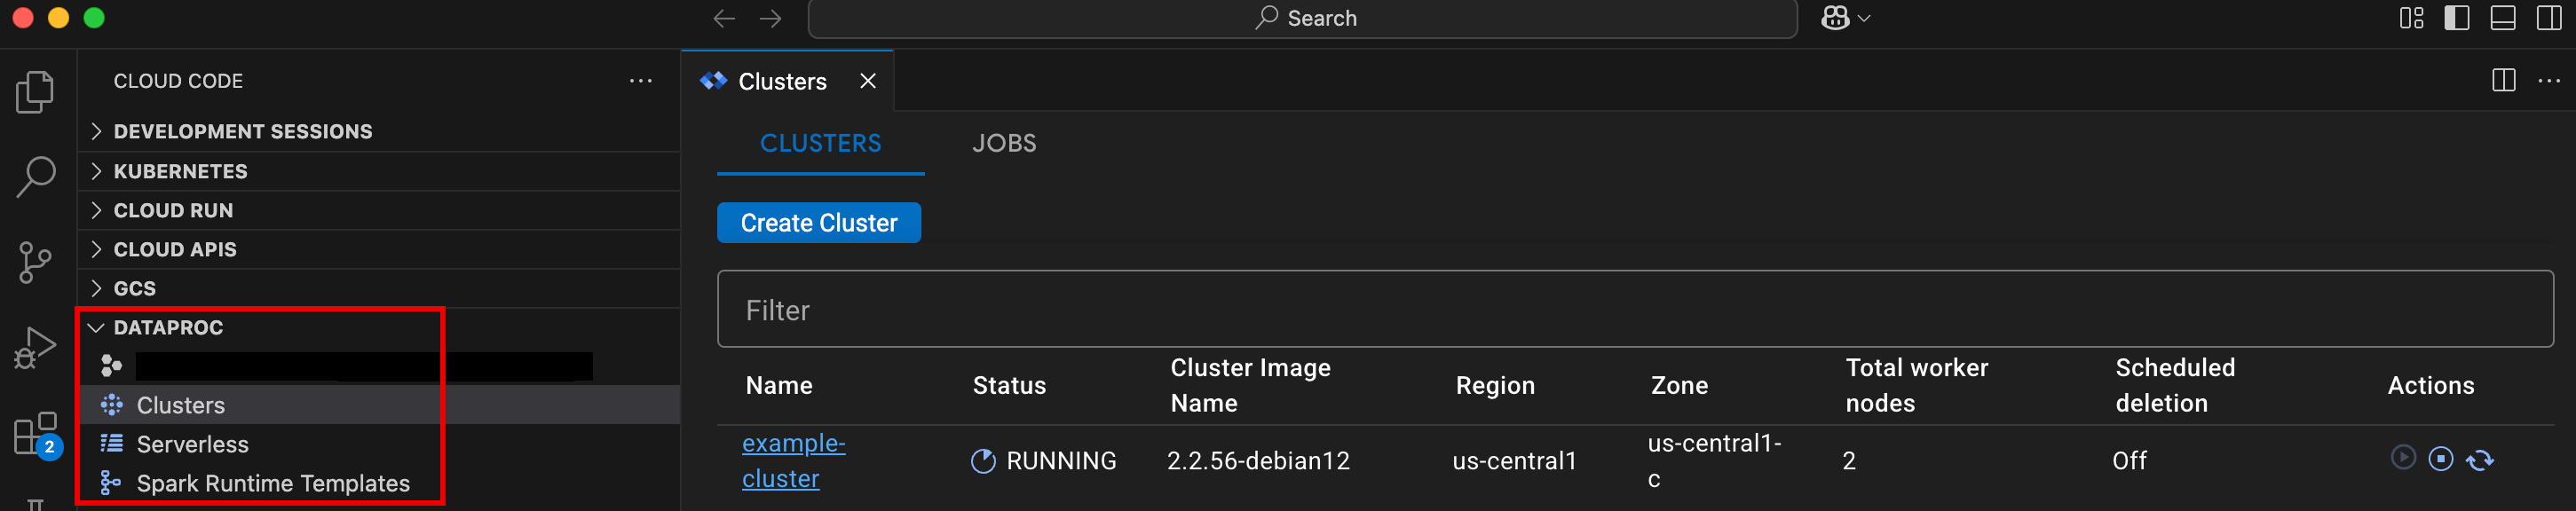
Apri la sezione Dataproc, quindi fai clic sui seguenti nomi di risorse:
Cluster: crea e gestisci cluster e job.
Serverless: crea e gestisci workload batch e sessioni interattive.
Modelli di runtime Spark: crea e gestisci i profili di runtime (modelli di sessione).
Esplora set di dati
Utilizza l'esploratore di set di dati di JupyterLab per visualizzare i set di dati del metastore BigLake.
Per aprire JupyterLab Dataset Explorer, fai clic sulla relativa icona nella barra laterale.
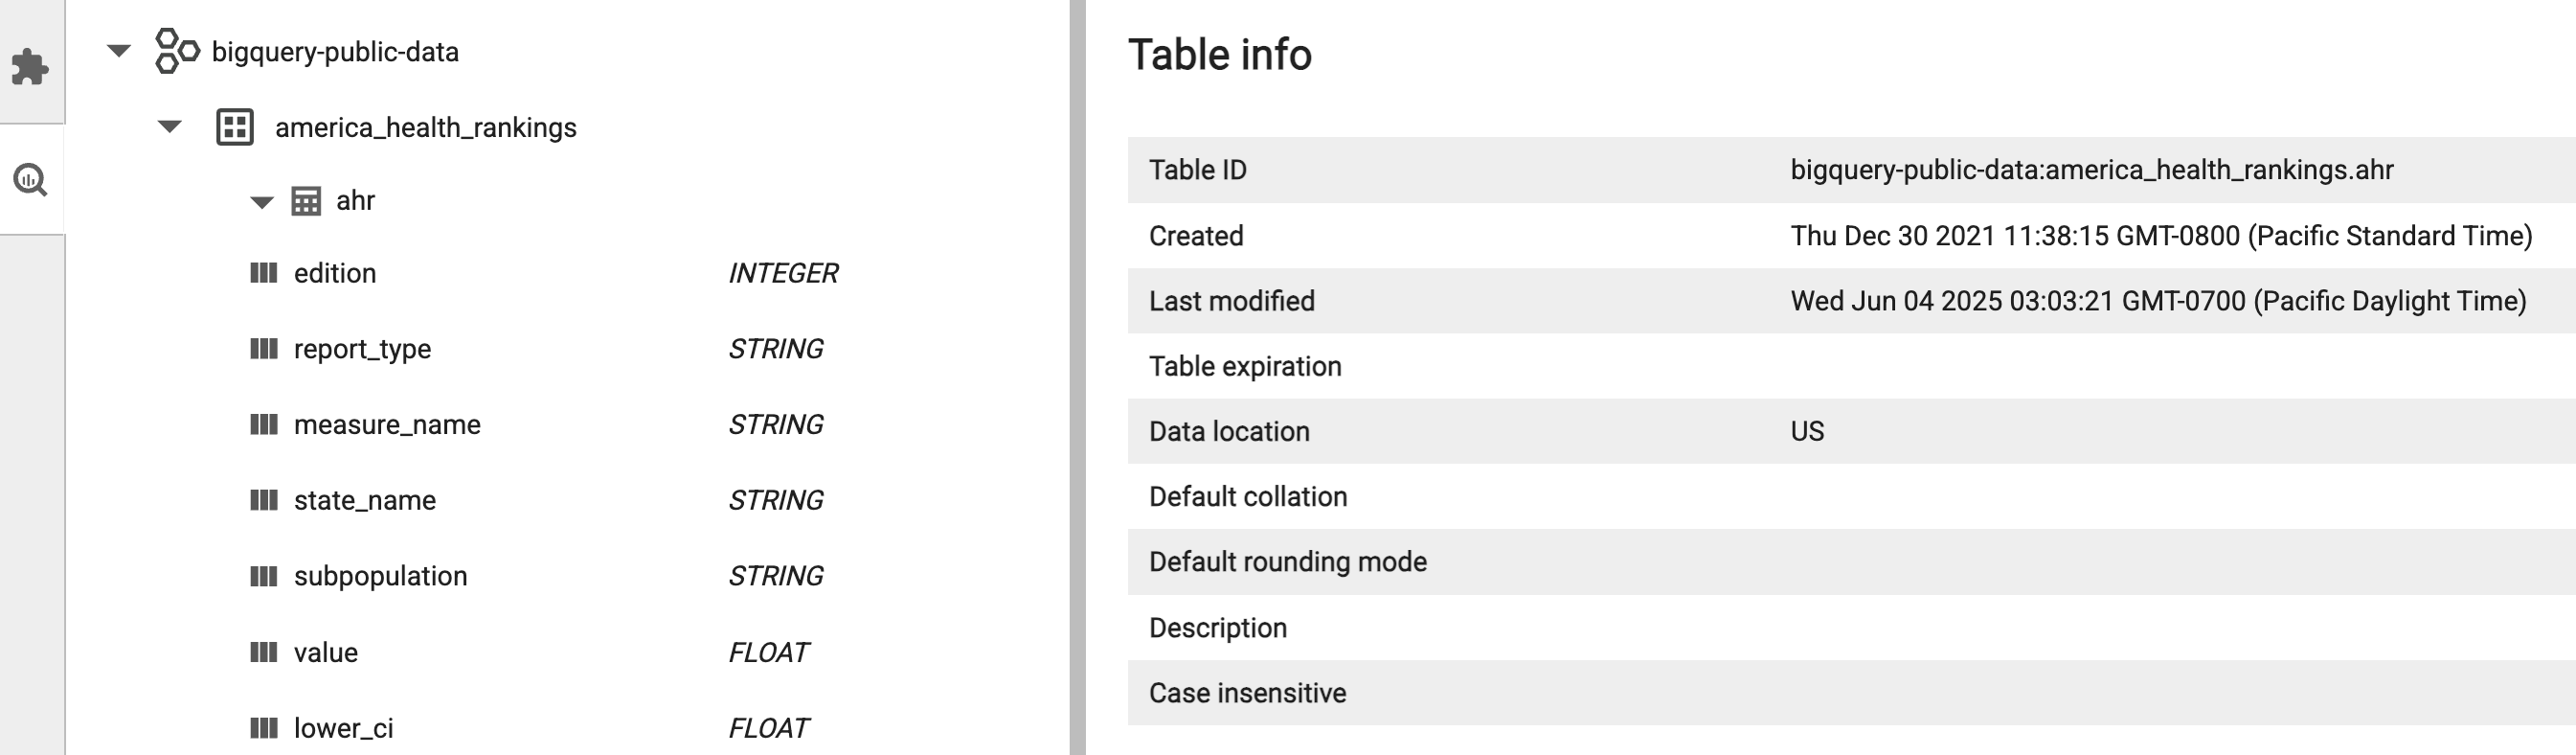
Puoi cercare un database, una tabella o una colonna in Explorer set di dati. Fai clic sul nome di un database, di una tabella o di una colonna per visualizzare i metadati associati.
Esegui il deployment del codice
Dopo aver installato l'estensione JupyterLab, puoi utilizzare JupyterLab per:
Esegui il codice del notebook sull'infrastruttura Managed Service for Apache Spark
Pianifica l'esecuzione del notebook su Managed Service for Apache Airflow
Invia job batch all'infrastruttura Managed Service for Apache Spark o al tuo cluster Managed Service for Apache Spark.
Pianifica l'esecuzione del notebook su Managed Airflow
Completa i passaggi seguenti per pianificare l'esecuzione del codice del notebook su Managed Airflow come job batch su Managed Service for Apache Spark o su un cluster Managed Service for Apache Spark.
Fai clic sul pulsante Job Scheduler in alto a destra nel blocco note.
Compila il modulo Crea un job pianificato per fornire le seguenti informazioni:
- Un nome univoco per il job di esecuzione del notebook
- L'ambiente Managed Airflow da utilizzare per il deployment del notebook
- Parametri di input se il notebook è parametrizzato
- Il template del cluster o del runtime serverless di Managed Service for Apache Spark da utilizzare per eseguire il notebook
- Se è selezionato un cluster, indica se arrestarlo dopo che il notebook ha terminato l'esecuzione sul cluster
- Numero di nuovi tentativi e ritardo tra i nuovi tentativi in minuti se l'esecuzione del notebook non riesce al primo tentativo
- Notifiche di esecuzione da inviare e l'elenco dei destinatari. Le notifiche vengono inviate utilizzando una configurazione SMTP di Airflow.
- La pianificazione dell'esecuzione del notebook
Fai clic su Crea.
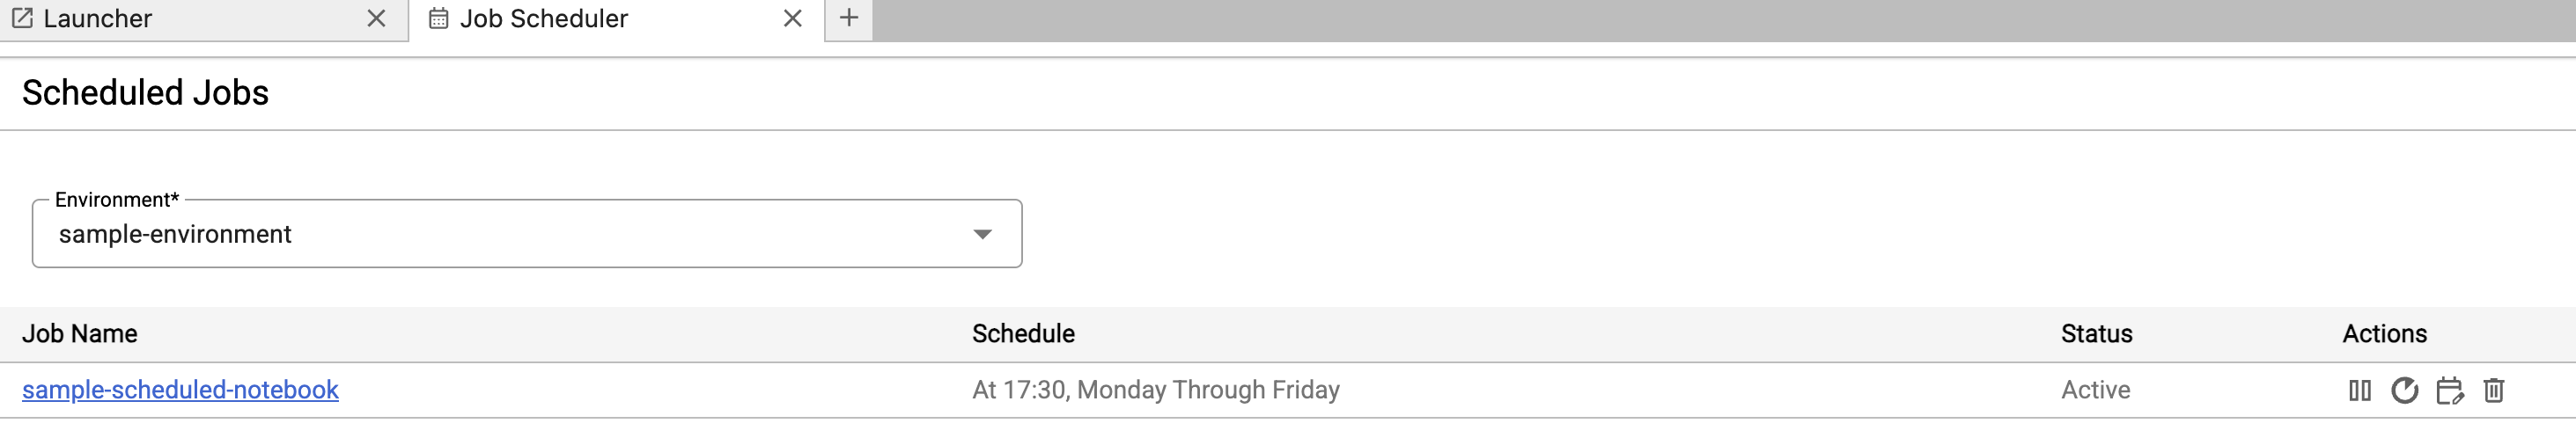
Dopo aver pianificato correttamente il notebook, il nome del job viene visualizzato nell'elenco dei job pianificati nell'ambiente Managed Airflow.
Invia un job batch a Managed Service for Apache Spark
Fai clic sulla scheda Serverless nella sezione Job e sessioni Dataproc nella pagina Avvio app di JupyterLab.
Fai clic sulla scheda Batch, poi su Crea batch e compila i campi Informazioni sul batch.
Fai clic su Invia per inviare il job.
Invia un job batch a un cluster Managed Service for Apache Spark
Fai clic sulla scheda Cluster nella sezione Job e sessioni Dataproc nella pagina Avvio app di JupyterLab.
Fai clic sulla scheda Job, quindi su Invia job.
Seleziona un Cluster, quindi compila i campi Job.
Fai clic su Invia per inviare il job.
Visualizza e gestisci le risorse
Dopo aver installato l'estensione JupyterLab, puoi visualizzare e gestire Managed Service for Apache Spark e Managed Service for Apache Spark dalla sezione Job e sessioni Dataproc nella pagina Avvio app di JupyterLab.
Fai clic sulla sezione Job e sessioni Dataproc per visualizzare le schede Cluster e Serverless.
Per visualizzare e gestire le sessioni di Managed Service for Apache Spark:
- Fai clic sulla scheda Serverless.
- Fai clic sulla scheda Sessioni, quindi su un ID sessione per aprire la pagina Dettagli sessione per visualizzare le proprietà della sessione, visualizzare i log Google Cloud in Esplora log e terminare una sessione. Nota: viene creata una sessione Managed Service for Apache Spark univoca per avviare ogni notebook Managed Service for Apache Spark.
Per visualizzare e gestire i batch di Managed Service for Apache Spark:
- Fai clic sulla scheda Batch per visualizzare l'elenco dei batch di Managed Service for Apache Spark nel progetto e nella regione attuali. Fai clic su un ID batch per visualizzare i dettagli del batch.
Per visualizzare e gestire i cluster Managed Service for Apache Spark:
- Fai clic sulla scheda Cluster. La scheda Cluster è selezionata per elencare i cluster Managed Service for Apache Spark attivi nel progetto e nella regione correnti. Puoi fare clic sulle icone nella colonna Azioni per avviare, arrestare o riavviare un cluster. Fai clic sul nome di un cluster per visualizzarne i dettagli. Puoi fare clic sulle icone nella colonna Azioni per clonare, interrompere o eliminare un job.
Per visualizzare e gestire i job Managed Service for Apache Spark:
- Fai clic sulla scheda Job per visualizzare l'elenco dei job nel progetto corrente. Fai clic su un ID job per visualizzare i dettagli del job.