


Google Cloud Data Agent Kit(DAK)を含む Jupyter ノートブックで PySpark DataFrame をインタラクティブに探索するには、Managed Service for Apache Spark で google-colabsqlviz Python パッケージを使用します。anywidget をベースに構築され、データポータルのグラフ作成エンジンを搭載した google-colabsqlviz は、プロットコードなしでノートブック セル出力内にインタラクティブな可視化をレンダリングします。
DataFrame を google-colabsqlviz に渡すと、グラフビューとデータテーブル ビューを切り替えたり、ディメンションと指標を構成したり、集計を適用したり、データをインタラクティブに並べ替えたりフィルタしたり、フィルタまたは集計されたグラフデータを新しい DataFrame にエクスポートしたりできます。
- マルチエンジン DataFrame のサポート: 1 つの API を使用して、
pyspark.sql.DataFrame(Spark Connect DataFrame を含む)、bigframes.pandas.DataFrame、pandas.DataFrameオブジェクトを可視化します。 - カーネル内実行と分散実行: ウィジェットは Google の CDN からデータポータルのグラフ作成 UI を読み込みますが、基になるデータはデータポータルに送信されません。すべての集計とフィルタは Python カーネルまたは Managed Service for Apache Spark セッションで実行され、グラフはノートブック クライアントでローカルにレンダリングされます。
- 環境の競合ゼロ:
pysparkやbigframesなどのオプションの分散エンジンは実行時に検出され、google-colabsqlvizのインストール時にアップグレードまたは上書きされません。
始める前に
google-colabsqlviz を使用した Spark Connect での PySpark DataFrame のレンダリングは、サーバーレス ランタイム バージョン 3.0 以降の Managed Service for Apache Spark インタラクティブ セッションでサポートされています。
次の手順に沿って、Data Agent Kit を使用して Visual Studio Code(VS Code)でノートブックを作成するか、JupyterLab などのサポートされている別の Jupyter ノートブック環境を使用します。
- Data Agent Kit(DAK)をセットアップして構成します。
- ノートブックを作成します。
- VS Code アクティビティ バーで [Data Agent Kit] をクリックし、[Apache Spark] を展開して、[+ New Spark Notebook] を選択します。
- [カーネルタイプを選択] で、[ローカル カーネル] をクリックします。
- [サーバーレス ランタイム テンプレートを選択] で、リストされているランタイム テンプレートの名前をクリックします。
- ノートブックのツールバーで [Select Kernel] をクリックし、[Python Environments...] をクリックして、ローカルの Python 環境を選択します。
ローカル環境に必要な Spark Connect パッケージと
google-colabsqlvizPython パッケージをインストールするには、ノートブック セルまたはローカル ターミナルで次のコマンドを実行します。ノートブック セル
%pip install -U 'google-cloud-spark-connect[interactive,client]'ローカル ターミナル
pip install -U 'google-cloud-spark-connect[interactive,client]'
データセットを読み込んで可視化する
ManagedSparkSession を起動してデータセットを pyspark.sql.DataFrame に読み込んだら、DataFrame を explore_dataframe 関数に渡してインタラクティブな可視化をレンダリングします。次の例では、サーバーレス セッションに接続し、Lakehouse の一般公開データセットから Palmer Penguins データセット(`lakehouse-public-data`.ml_datasets.penguins)を読み込みます。
# Importing managed_spark_connect automatically imports explore_dataframe
from google.cloud.managed_spark_connect import ManagedSparkSession

spark = (
    ManagedSparkSession.builder.projectId("PROJECT_ID")
    .location("REGION")
    .getOrCreate()
)

df = spark.read.table("`lakehouse-public-data`.ml_datasets.penguins")

explore_dataframe(df)
次のように置き換えます。
PROJECT_ID: 実際の Google Cloud プロジェクト ID。REGION: セッションの Managed Service for Apache Spark リージョン(例:us-central1)。
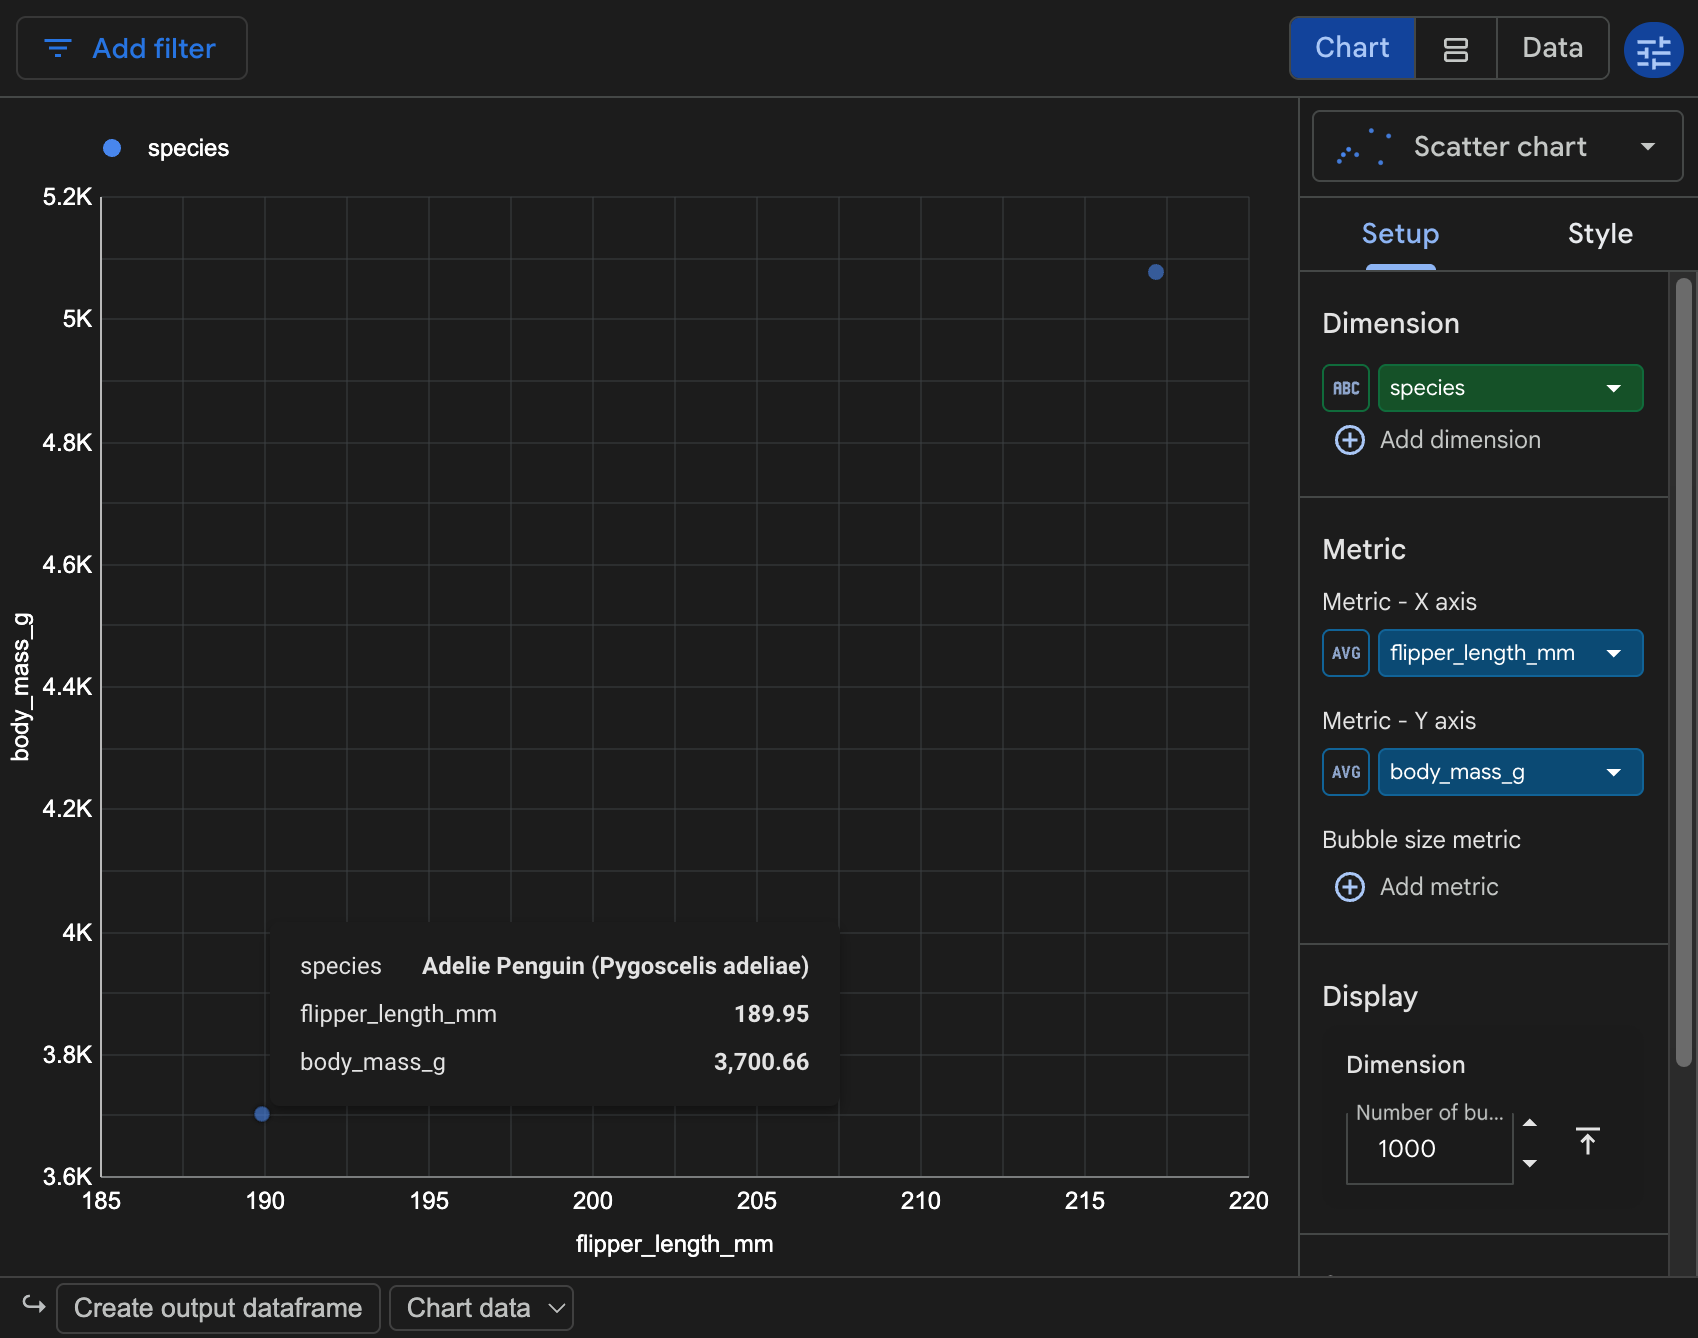
セルを実行すると、google-colabsqlviz は DataFrame スキーマを検査し、デフォルトの可視化を使用してセルの出力領域にインタラクティブな可視化ウィジェットをレンダリングします。penguins データセットの場合、species でグループ化された平均 flipper_length_mm と body_mass_g の散布図がレンダリングされます。
ウィジェット ツールバーで [データ] をクリックして、ページ分けされたテーブルで基になる DataFrame 行を検査します。[分割モード] を選択すると、グラフと基になるデータテーブルが一緒に表示されます。[グラフ] をクリックして、グラフビューに戻ります。
グラフを探索してカスタマイズする
ウィジェット インターフェースでグラフの種類、ディメンション、指標、集計、並べ替え、フィルタをカスタマイズし、結果のデータをノートブックの DataFrame にエクスポートできます。
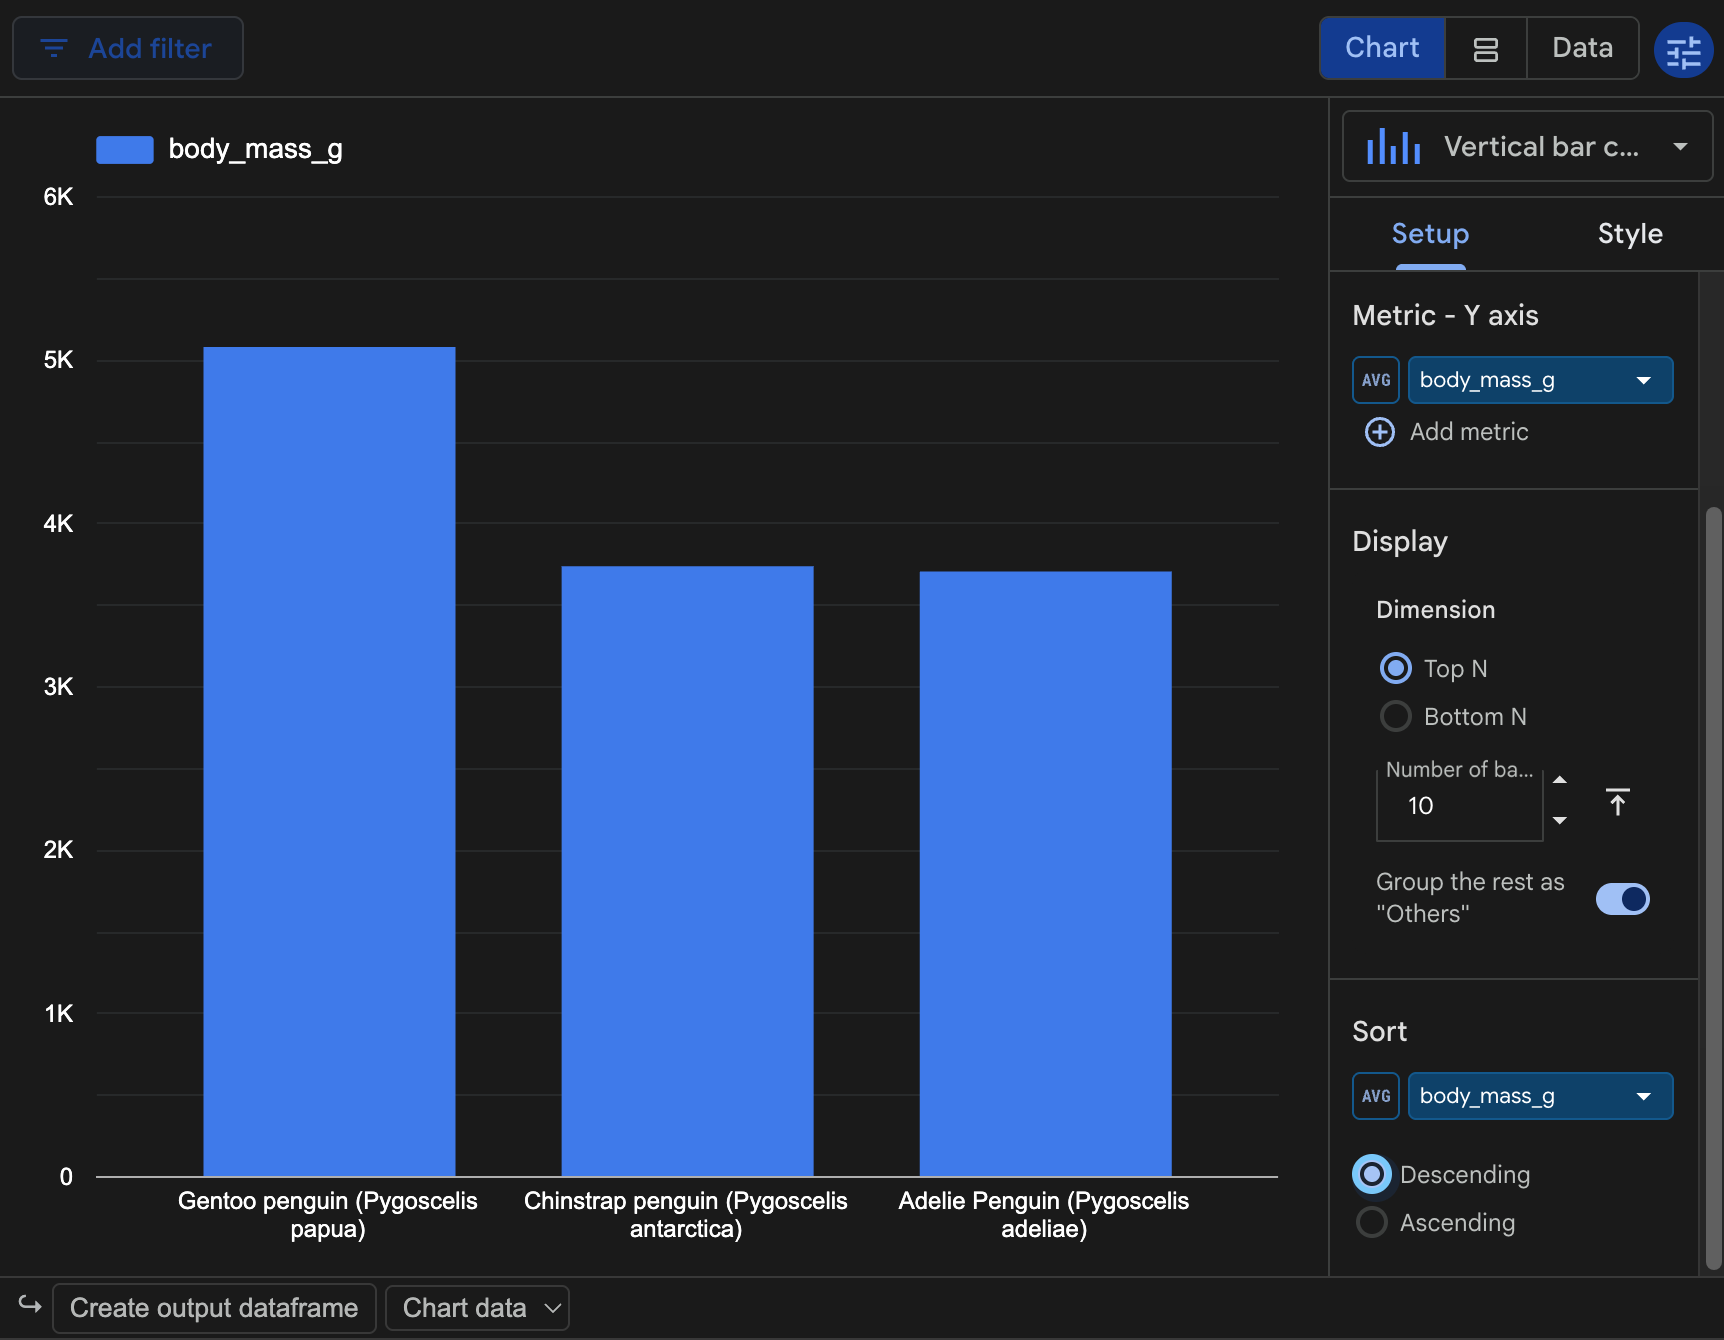
- グラフの種類を選択する: 構成設定パネルで、グラフの種類メニューをクリックし、[縦棒グラフ] などのグラフの種類を選択します。サポートされているグラフタイプの完全なリストについては、データポータルのグラフの種類をご覧ください。
- ディメンションと指標を構成する: [設定] タブで、
penguinsDataFrame のフィールドを構成します。- [ディメンション] を
speciesに設定したままにして、ペンギンの種ごとにレコードをグループ化します。 - [指標 - Y 軸] で、指標を
body_mass_gに設定し、集計を [AVG](平均)に設定して、各種の平均体重(グラム単位)を計算します。 - [ディメンションを追加] をクリックし、
islandまたはsexを選択して、複数のディメンションにわたってグラフを分類するか、指標の集計を [AVG] から [MAX] または [SUM] に変更します。
- [ディメンション] を
- ビジュアリゼーションを並べ替えてフィルタする:
- [設定] タブの [並べ替え] で、AVG 集計を含む
body_mass_gを選択し、[降順] を選択して、平均体重が最も高い順に種をランク付けします。 - ウィジェット ツールバーの [フィルタを追加] をクリックして、フィールド値(
body_mass_gが4000以上など)でレコードをフィルタします。または、ウィジェットの下部にある [出力データフレームを作成] をクリックして、集計されたグラフデータまたはフィルタされたデータを新しい DataFrame セルにエクスポートします。グラフのプロパティまたはフィルタを更新すると、google-colabsqlvizは DataFrame に対してクエリを再計算し、可視化を更新します。
- [設定] タブの [並べ替え] で、AVG 集計を含む
埋め込みグラフ インターフェースでグラフのプロパティ、集計、インタラクティブなコントロールを構成する方法については、次のドキュメントをご覧ください。
大規模な DataFrame の実行を構成する
pyspark.sql.DataFrame を explore_dataframe(df) に渡すと、google-colabsqlviz は DataFrame のサイズに基づいて 2 つの実行戦略から選択します。
- インメモリ マテリアライズ(小さい DataFrame のデフォルト): DataFrame が
256 MiB以下と推定され、最大 5,000,000 行を含む場合、google-colabsqlvizは DataFrame をカーネルメモリに 1 回収集します。その後のグラフタイプの変更、集計、並べ替え、フィルタリングは、最小限のレイテンシでメモリ内で実行され、新しい Spark ジョブはトリガーされません。 - 分散 Spark プッシュダウン(大規模な DataFrame のデフォルト): DataFrame がバイトまたは行の予算を超えると、
google-colabsqlvizは DataFrame を遅延状態に保ち、各グラフクエリ、フィルタ、並べ替え、ページネーション リクエストを、Managed Service for Apache Spark サーバーレス セッションで実行される PySpark オペレーションに変換します。この方法ではレイテンシが増加する可能性がありますが、より大きな DataFrame を可視化できます。
explore_dataframe(df) を呼び出す前に COLABSQLVIZ_PYSPARK_EAGER_MAX_BYTES 環境変数を設定することで、インメモリ マテリアライズのしきい値を調整または無効にできます。
import os

# Importing managed_spark_connect automatically imports explore_dataframe
from google.cloud.managed_spark_connect import ManagedSparkSession

# Set to "0" to disable upfront collection and push all chart queries to Spark,
# or set a custom byte limit, such as str(64 * 1024 * 1024) for 64 MiB.
os.environ["COLABSQLVIZ_PYSPARK_EAGER_MAX_BYTES"] = "0"

explore_dataframe(df)
次のステップ
- データポータルのグラフの種類を確認する。
- Data Agent Kit を使用してデータを変換する方法を確認する。
- サーバーレス Spark Connect クライアントを使用する方法を学習する。
- サーバーレス セッションで JupyterLab と VS Code を使用する方法を確認する。