En este documento, se muestra cómo ejecutar cargas de trabajo por lotes de Managed Service para Apache Spark SQL y PySpark para crear una tabla de Apache Iceberg con metadatos almacenados en el catálogo de tiempo de ejecución de Lakehouse. Para obtener información sobre otras formas de ejecutar código de Spark, consulta Ejecuta código de PySpark en un notebook de BigQuery y Ejecuta una carga de trabajo de Apache Spark.
Antes de comenzar
Si aún no lo hiciste, crea un proyecto de Google Cloud y un bucket de Cloud Storage.
Configura tu proyecto
- Accede a tu cuenta de Google Cloud . Si eres nuevo en Google Cloud, crea una cuenta para evaluar el rendimiento de nuestros productos en situaciones reales. Los clientes nuevos también obtienen $300 en créditos gratuitos para ejecutar, probar y, además, implementar cargas de trabajo.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
Enable the Dataproc, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
Enable the Dataproc, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.
Crea un bucket de Cloud Storage en tu proyecto.
- En la consola de Google Cloud , ve a la página Buckets de Cloud Storage.
- Haz clic en Crear.
- En la página Crear un bucket, ingresa la información de tu bucket. Para ir al paso siguiente, haz clic en Continuar.
-
En la sección Primeros pasos, haz lo siguiente:
- Ingresa un nombre único a nivel global que cumpla con los requisitos de nombre de los buckets.
- Para agregar una
etiqueta de bucket,
expande la sección Etiquetas (),
haz clic en add_box
Agregar etiqueta y especifica una
keyy unvaluepara tu etiqueta.
-
En la sección Elige dónde almacenar tus datos, haz lo siguiente:
- Selecciona un tipo de ubicación
- En el menú desplegable Tipo de ubicación, elige una ubicación en la que se almacenarán de forma permanente los datos de tu bucket.
- Si seleccionas el tipo de ubicación birregional, también puedes habilitar la replicación turbo con la casilla de verificación correspondiente.
- Para configurar la replicación bucket buckets, selecciona
Agregar replicación entre bucket a través del Servicio de transferencia de almacenamiento y
sigue estos pasos:
Configura la replicación entre buckets
- En el menú Bucket, selecciona un bucket.
En la sección Configuración de replicación, haz clic en Configurar para establecer los parámetros del trabajo de replicación.
Aparecerá el panel Configurar la replicación entre buckets.
- Para filtrar los objetos que se replicarán por prefijo de nombre de objeto, ingresa un prefijo del que quieras incluir o excluir objetos y, luego, haz clic en Agregar un prefijo.
- Para establecer una clase de almacenamiento para los objetos replicados, selecciona una clase de almacenamiento en el menú Clase de almacenamiento. Si omites este paso, los objetos replicados usarán la clase de almacenamiento del bucket de destino de forma predeterminada.
- Haz clic en Listo.
-
En la sección Elige cómo almacenar tus datos, haz lo siguiente:
- Selecciona una clase de almacenamiento predeterminada para el bucket o Autoclass para la administración automática de clases de almacenamiento de los datos de tu bucket.
- Para habilitar el espacio de nombres jerárquico, en la sección Optimiza el almacenamiento para cargas de trabajo con uso intensivo de datos, selecciona Habilitar el espacio de nombres jerárquico en este bucket.
- En la sección Elige cómo controlar el acceso a los objetos, selecciona si tu bucket aplica o no la prevención del acceso público y elige un método de control de acceso para los objetos del bucket.
-
En la sección Elige cómo proteger los datos de objetos, haz lo
siguiente:
- Selecciona cualquiera de las opciones de Protección de datos que
desees configurar para tu bucket.
- Para habilitar la eliminación no definitiva, haz clic en la casilla de verificación Política de eliminación no definitiva (para la recuperación de datos) y especifica la cantidad de días que deseas conservar los objetos después de la eliminación.
- Para configurar el Control de versiones de objetos, haz clic en la casilla de verificación Control de versiones de objetos (para el control de versión) y especifica la cantidad máxima de versiones por objeto y la cantidad de días después de los cuales vencen las versiones no actuales.
- Para habilitar la política de retención en objetos y buckets, haz clic en la casilla de verificación Retención (para cumplimiento) y, luego, haz lo siguiente:
- Para habilitar el bloqueo de retención de objetos, haz clic en la casilla de verificación Habilitar la retención de objetos.
- Para habilitar el bloqueo del bucket, haz clic en la casilla de verificación Establecer política de retención del bucket y elige una unidad de tiempo y una duración para el período de retención.
- Para elegir cómo se encriptarán los datos de tus objetos, expande la sección Encriptación de datos () y selecciona un método de encriptación de datos.
- Selecciona cualquiera de las opciones de Protección de datos que
desees configurar para tu bucket.
-
En la sección Primeros pasos, haz lo siguiente:
- Haz clic en Crear.
Otorga el rol de Editor de datos de BigQuery (
roles/bigquery.dataEditor) a la cuenta de servicio predeterminada de Compute Engine,PROJECT_NUMBER-compute@developer.gserviceaccount.com. Para obtener instrucciones, consulta Otorga un solo rol.Ejemplo de Google Cloud CLI:
gcloud projects add-iam-policy-binding PROJECT_ID \
    --member PROJECT_NUMBER-compute@developer.gserviceaccount.com \
--role roles/bigquery.dataEditor
Notas:
- PROJECT_ID y PROJECT_NUMBER se enumeran en la sección Información del proyecto del panel de la consola de Google Cloud .
Asignación de recursos de OSS a recursos de BigQuery
Ten en cuenta la siguiente asignación entre los términos de recursos de código abierto y de BigQuery:
| Recurso de OSS | Recurso de BigQuery |
|---|---|
| Espacio de nombres, base de datos | Conjunto de datos |
| Tabla particionada o no particionada | Tabla |
| Ver | Ver |
Crea una tabla de Iceberg
En esta sección, se muestra cómo crear una tabla de Iceberg con metadatos en el catálogo de tiempo de ejecución de Lakehouse con las cargas de trabajo por lotes de Spark SQL y PySpark de Managed Service para Apache Spark.
Spark SQL
Ejecuta una carga de trabajo de Spark SQL para crear una tabla de Iceberg
En los siguientes pasos, se muestra cómo ejecutar una carga de trabajo por lotes de SQL de Managed Service para Apache Spark para crear una tabla de Iceberg con metadatos de tabla almacenados en el catálogo de tiempo de ejecución de Lakehouse.
Copia los siguientes comandos de Spark SQL de forma local o en Cloud Shell en un archivo
iceberg-table.sql.USE CATALOG_NAME; CREATE NAMESPACE IF NOT EXISTS example_namespace; USE example_namespace; DROP TABLE IF EXISTS example_table; CREATE TABLE example_table (id int, data string) USING ICEBERG LOCATION 'gs://BUCKET/WAREHOUSE_FOLDER'; INSERT INTO example_table VALUES (1, 'first row'); ALTER TABLE example_table ADD COLUMNS (newDoubleCol double); DESCRIBE TABLE example_table;
Reemplaza lo siguiente:
- CATALOG_NAME: Es el nombre del catálogo de Iceberg.
- BUCKET y WAREHOUSE_FOLDER: Es el bucket y la carpeta de Cloud Storage que se usan como directorio del almacén de Iceberg.
Ejecuta el siguiente comando de forma local o en Cloud Shell desde el directorio que contiene
iceberg-table.sqlpara enviar la carga de trabajo de Spark SQL.gcloud dataproc batches submit spark-sql iceberg-table.sql \ --project=PROJECT_ID \ --region=REGION \ --deps-bucket=BUCKET_NAME \ --version=2.2 \ --subnet=SUBNET_NAME \ --properties="spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,spark.sql.catalog.CATALOG_NAME.catalog-impl=org.apache.iceberg.gcp.bigquery.BigQueryMetastoreCatalog,spark.sql.catalog.CATALOG_NAME.gcp_project=PROJECT_ID,spark.sql.catalog.CATALOG_NAME.gcp_location=LOCATION,spark.sql.catalog.CATALOG_NAME.warehouse=gs://BUCKET/WAREHOUSE_FOLDER"
Notas:
- PROJECT_ID: Es el ID del proyecto de Google Cloud . Los IDs de proyecto se enumeran en la sección Información del proyecto en el panel de la consola de Google Cloud .
- REGION: Es una región de Compute Engine disponible para ejecutar la carga de trabajo.
- BUCKET_NAME: Es el nombre de tu bucket de Cloud Storage. Spark sube
las dependencias de la carga de trabajo a una carpeta
/dependenciesen este bucket antes de ejecutar la carga de trabajo por lotes. El WAREHOUSE_FOLDER se encuentra en este bucket. --version: Versión 2.2 o posterior del entorno de ejecución de Managed Service para Apache Spark.- SUBNET_NAME: Es el nombre de una subred de VPC en la
REGION. Si omites esta marca, Managed Service para Apache Spark selecciona la subreddefaulten la región de la sesión. Managed Service para Apache Spark habilita el Acceso privado a Google (PGA) en la subred. Para conocer los requisitos de conectividad de red, consulta Configuración de red de Managed Service para Apache Spark. - LOCATION: Es una ubicación de BigQuery compatible. La ubicación predeterminada es "US".
--propertiesPropiedades del catálogo.
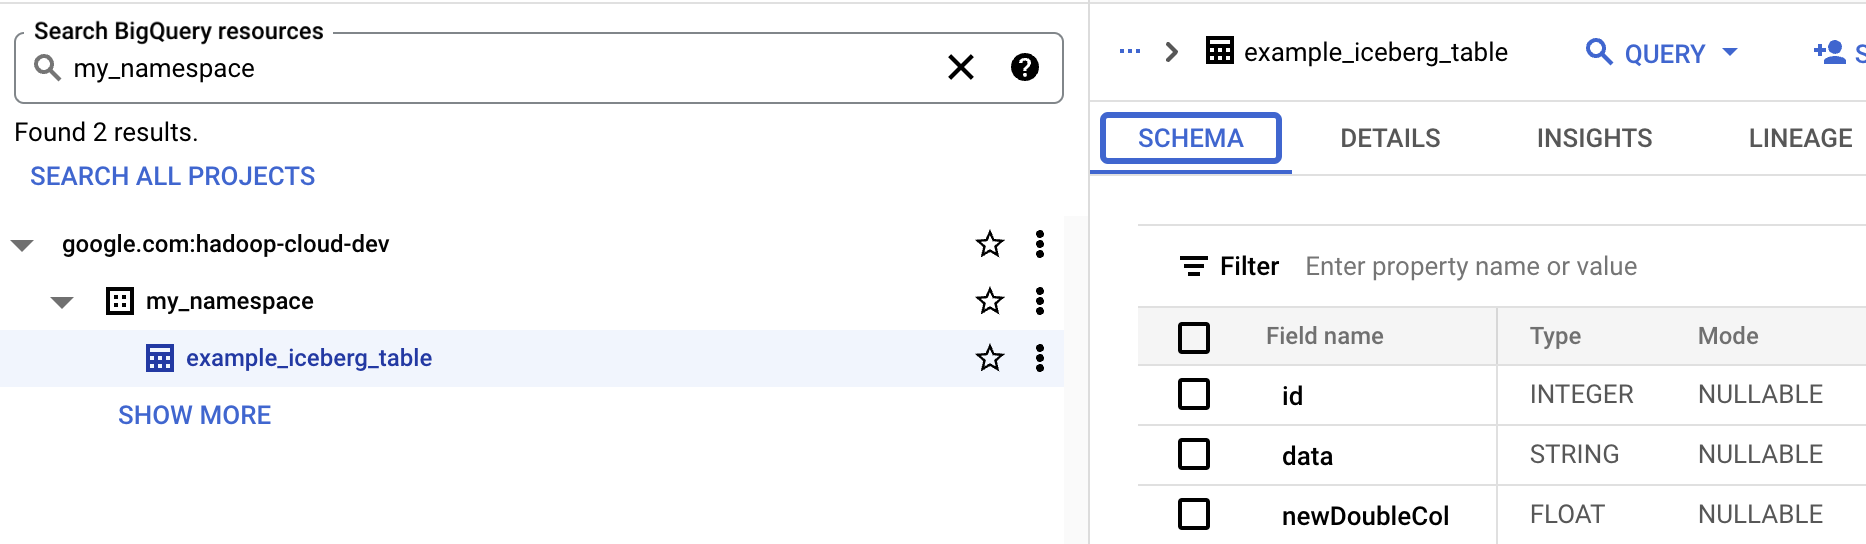
Visualiza los metadatos de la tabla en BigQuery
En la consola de Google Cloud , ve a la página BigQuery.
Visualiza los metadatos de la tabla de Iceberg.
PySpark
En los siguientes pasos, se muestra cómo ejecutar una carga de trabajo por lotes de PySpark de Managed Service para Apache Spark para crear una tabla de Iceberg con metadatos de tabla almacenados en el catálogo de tiempo de ejecución de Lakehouse.
- Copia el siguiente código de PySpark de forma local o en
Cloud Shell
en un archivo
iceberg-table.py.from pyspark.sql import SparkSession spark = SparkSession.builder.appName("iceberg-table-example").getOrCreate() catalog = "CATALOG_NAME" namespace = "NAMESPACE" spark.sql(f"USE `{catalog}`;") spark.sql(f"CREATE NAMESPACE IF NOT EXISTS `{namespace}`;") spark.sql(f"USE `{namespace}`;") # Create table and display schema spark.sql("DROP TABLE IF EXISTS example_iceberg_table") spark.sql("CREATE TABLE example_iceberg_table (id int, data string) USING ICEBERG") spark.sql("DESCRIBE example_iceberg_table;") # Insert table data. spark.sql("INSERT INTO example_iceberg_table VALUES (1, 'first row');") # Alter table, then display schema. spark.sql("ALTER TABLE example_iceberg_table ADD COLUMNS (newDoubleCol double);") spark.sql("DESCRIBE example_iceberg_table;")
Reemplaza lo siguiente:
- CATALOG_NAME y NAMESPACE: El nombre y el espacio de nombres del catálogo de Iceberg
se combinan para identificar la tabla de Iceberg (
catalog.namespace.table_name).
- CATALOG_NAME y NAMESPACE: El nombre y el espacio de nombres del catálogo de Iceberg
se combinan para identificar la tabla de Iceberg (
-
Ejecuta el siguiente comando de forma local o en
Cloud Shell
desde el directorio que contiene
iceberg-table.pypara enviar la carga de trabajo de PySpark.gcloud dataproc batches submit pyspark iceberg-table.py \ --project=PROJECT_ID \ --region=REGION \ --deps-bucket=BUCKET_NAME \ --version=2.2 \ --subnet=SUBNET_NAME \ --properties="spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,spark.sql.catalog.CATALOG_NAME.catalog-impl=org.apache.iceberg.gcp.bigquery.BigQueryMetastoreCatalog,spark.sql.catalog.CATALOG_NAME.gcp_project=PROJECT_ID,spark.sql.catalog.CATALOG_NAME.gcp_location=LOCATION,spark.sql.catalog.CATALOG_NAME.warehouse=gs://BUCKET/WAREHOUSE_FOLDER"Notas:
- PROJECT_ID: Es el ID del proyecto de Google Cloud . Los IDs de los proyectos se enumeran en la sección Información del proyecto en el panel de la consola de Google Cloud .
- REGION: Es una región de Compute Engine disponible para ejecutar la carga de trabajo.
- BUCKET_NAME: Es el nombre de tu bucket de Cloud Storage. Spark sube
las dependencias de la carga de trabajo a una carpeta
/dependenciesen este bucket antes de ejecutar la carga de trabajo por lotes. --version: Versión 2.2 o posterior del entorno de ejecución de Managed Service para Apache Spark.- SUBNET_NAME: Es el nombre de una subred de VPC en la
REGION. Si omites esta marca, Managed Service para Apache Spark selecciona la subreddefaulten la región de la sesión. Managed Service para Apache Spark habilita el Acceso privado a Google (PGA) en la subred. Para conocer los requisitos de conectividad de red, consulta Configuración de red de Managed Service para Apache Spark. - LOCATION: Es una ubicación de BigQuery compatible. La ubicación predeterminada es "US".
- BUCKET y WAREHOUSE_FOLDER: El bucket y la carpeta de Cloud Storage que se usan como el directorio del almacén de Iceberg.
--properties: Propiedades del catálogo.
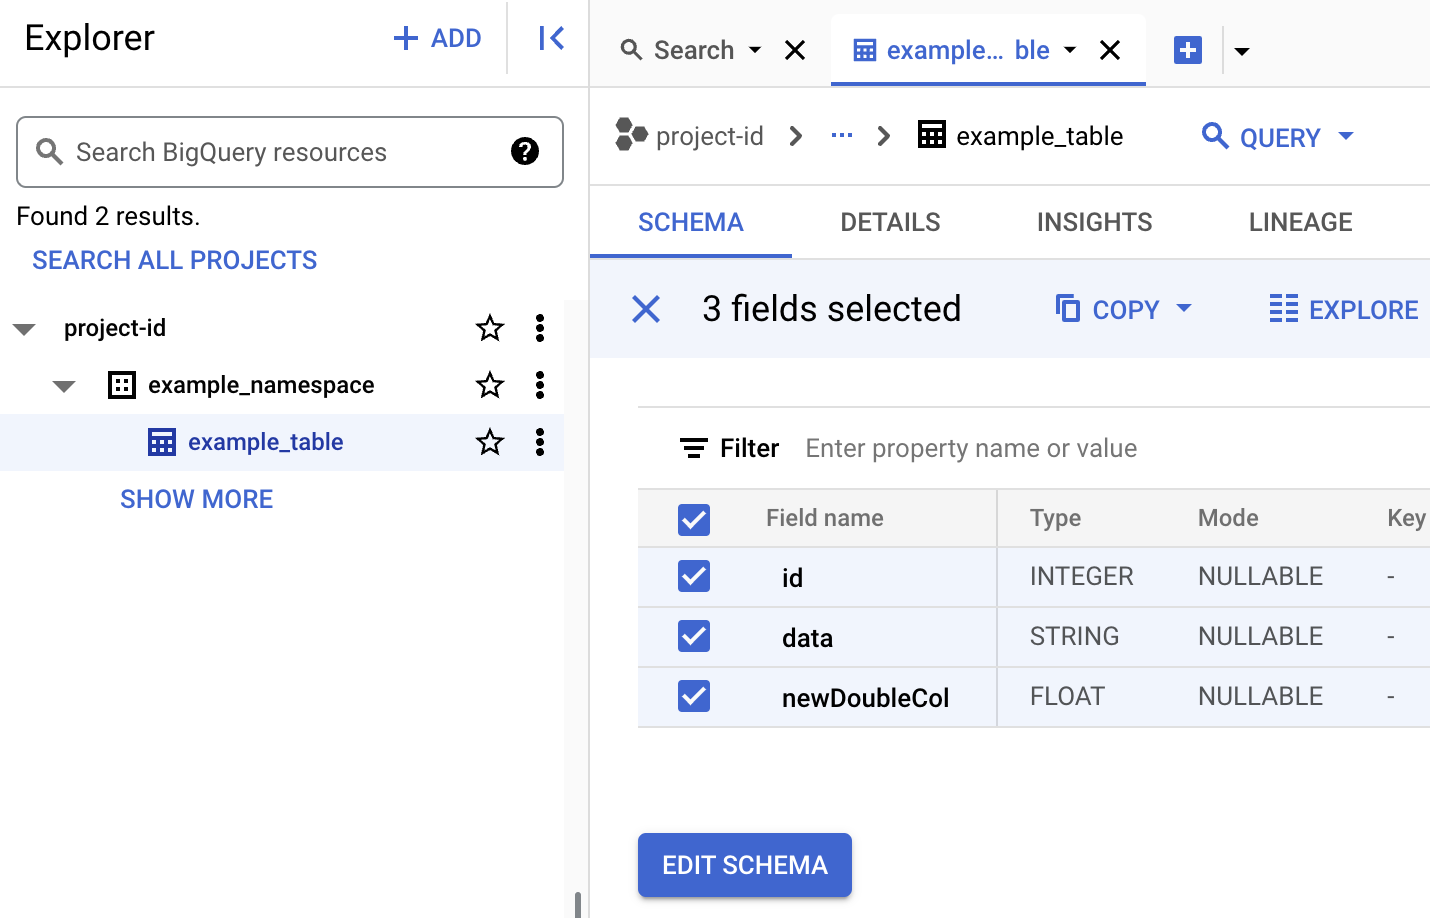
- Visualizar el esquema de la tabla en BigQuery
- En la consola de Google Cloud , ve a la página BigQuery. Ve a BigQuery Studio
- Visualiza los metadatos de la tabla de Iceberg.