In diesem Dokument wird beschrieben, wie Sie Managed Service for Apache Spark SQL- und PySpark-Batcharbeitslasten ausführen, um eine Apache Iceberg-Tabelle mit Metadaten zu erstellen, die im Lakehouse-Laufzeitkatalog gespeichert sind. Informationen zu anderen Möglichkeiten zum Ausführen von Spark-Code finden Sie unter PySpark-Code in einem BigQuery-Notebook ausführen und Apache Spark-Arbeitslast ausführen.
Hinweis
Erstellen Sie ein Google Cloud -Projekt und einen Cloud Storage-Bucket, falls noch nicht geschehen.
Projekt einrichten
- Melden Sie sich in Ihrem Google Cloud -Konto an. Wenn Sie mit Google Cloudnoch nicht vertraut sind, erstellen Sie ein Konto, um die Leistungsfähigkeit unserer Produkte in der Praxis sehen und bewerten zu können. Neukunden erhalten außerdem ein Guthaben von 300 $, um Arbeitslasten auszuführen, zu testen und bereitzustellen.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
Enable the Dataproc, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
Enable the Dataproc, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.
Erstellen Sie einen Cloud Storage-Bucket in Ihrem Projekt.
- Wechseln Sie in der Google Cloud Console unter „Cloud Storage“ zur Seite Buckets.
- Klicken Sie auf Erstellen.
- Geben Sie auf der Seite Bucket erstellen die Bucket-Informationen ein. Klicken Sie auf Weiter, um mit dem nächsten Schritt fortzufahren.
-
Führen Sie im Abschnitt Einstieg die folgenden Schritte aus:
- Geben Sie einen global eindeutigen Namen ein, der den Anforderungen für Bucket-Namen entspricht.
- So fügen Sie ein Bucket-Label hinzu: Maximieren Sie den Bereich Labels (), klicken Sie auf add_box
Label hinzufügen und geben Sie
keyundvaluefür Ihr Label an.
-
Gehen Sie im Bereich Speicherort für Daten auswählen so vor:
- Standorttyp auswählen.
- Wählen Sie im Drop-down-Menü Standorttyp einen Standort aus, an dem die Daten Ihres Buckets dauerhaft gespeichert werden.
- Wenn Sie den Standorttyp Dual-Region auswählen, können Sie auch die Turboreplikation aktivieren, indem Sie das entsprechende Kästchen anklicken.
- Wenn Sie die Bucket-übergreifende Replikation einrichten möchten, wählen Sie Bucket-übergreifende Replikation über Storage Transfer Service hinzufügen aus und führen Sie die folgenden Schritte aus:
Bucket-übergreifende Replikation einrichten
- Wählen Sie im Menü Bucket einen Bucket aus.
Klicken Sie im Bereich Replikationseinstellungen auf Konfigurieren, um die Einstellungen für den Replikationsjob zu konfigurieren.
Der Bereich Bucket-übergreifende Replikation konfigurieren wird angezeigt.
- Wenn Sie die zu replizierenden Objekte nach dem Objektnamenspräfix filtern möchten, geben Sie ein Präfix ein, mit dem Sie Objekte ein- oder ausschließen möchten, und klicken Sie dann auf Präfix hinzufügen.
- Wenn Sie eine Speicherklasse für die replizierten Objekte festlegen möchten, wählen Sie im Menü Speicherklasse eine Speicherklasse aus. Wenn Sie diesen Schritt überspringen, wird für replizierte Objekte standardmäßig die Speicherklasse des Ziel-Buckets verwendet.
- Klicken Sie auf Fertig.
-
Gehen Sie im Bereich Speicherort für Daten auswählen so vor:
- Wählen Sie eine Standardspeicherklasse für den Bucket oder Autoclass für die automatische Verwaltung der Speicherklassen Ihrer Bucket-Daten aus.
- Wenn Sie den hierarchischen Namespace aktivieren möchten, wählen Sie im Bereich Speicher für datenintensive Arbeitslasten optimieren die Option Hierarchischen Namespace für diesen Bucket aktivieren aus.
- Wählen Sie im Abschnitt Zugriff auf Objekte steuern aus, ob der Bucket Verhinderung des öffentlichen Zugriffs erzwingt, und wählen Sie eine Zugriffssteuerungsmethode für die Objekte Ihres Buckets aus.
-
Führen Sie im Bereich Auswählen, wie Objektdaten geschützt werden die folgenden Schritte aus:
- Wählen Sie unter Datenschutz die gewünschten Optionen für Ihren Bucket aus.
- Wenn Sie Vorläufiges Löschen aktivieren möchten, klicken Sie das Kästchen Richtlinie für vorläufiges Löschen (zur Datenwiederherstellung) an und geben Sie die Anzahl der Tage an, die Objekte nach dem Löschen beibehalten werden sollen.
- Wenn Sie die Objektversionsverwaltung festlegen möchten, klicken Sie das Kästchen Objektversionsverwaltung (zur Versionsverwaltung) an und geben Sie die maximale Anzahl von Versionen pro Objekt und die Anzahl der Tage an, nach denen die nicht aktuellen Versionen ablaufen.
- Klicken Sie auf das Kästchen Aufbewahrung (zur Einhaltung von Vorschriften), um die Aufbewahrungsrichtlinie für Objekte und Buckets zu aktivieren, und gehen Sie dann so vor:
- Klicken Sie auf das Kästchen Objektaufbewahrung aktivieren, um die Objektaufbewahrungssperre zu aktivieren.
- Wenn Sie Bucket Lock aktivieren möchten, klicken Sie das Kästchen Bucket-Aufbewahrungsrichtlinie festlegen an und wählen Sie eine Zeiteinheit und eine Zeitdauer für die Aufbewahrungsdauer aus.
- Wenn Sie auswählen möchten, wie Ihre Objektdaten verschlüsselt werden, maximieren Sie den Bereich Datenverschlüsselung () und wählen Sie eine Methode für die Datenverschlüsselung aus.
- Wählen Sie unter Datenschutz die gewünschten Optionen für Ihren Bucket aus.
-
Führen Sie im Abschnitt Einstieg die folgenden Schritte aus:
- Klicken Sie auf Erstellen.
Gewähren Sie dem Compute Engine-Standarddienstkonto (
PROJECT_NUMBER-compute@developer.gserviceaccount.com) die Rolle BigQuery-Datenbearbeiter (roles/bigquery.dataEditor). Eine Anleitung finden Sie unter Einzelne Rolle zuweisen.Beispiel für Google Cloud CLI:
gcloud projects add-iam-policy-binding PROJECT_ID \
    --member PROJECT_NUMBER-compute@developer.gserviceaccount.com \
--role roles/bigquery.dataEditor
Hinweise:
- PROJECT_ID und PROJECT_NUMBER werden im Bereich Projektinformationen im Google Cloud Console-Dashboard aufgeführt.
Zuordnung von OSS-Ressourcen zu BigQuery-Ressourcen
Beachten Sie die folgende Zuordnung zwischen Begriffen für Open-Source-Ressourcen und BigQuery-Ressourcen:
| OSS-Ressource | BigQuery-Ressource |
|---|---|
| Namespace, Datenbank | Dataset |
| Partitionierte oder nicht partitionierte Tabelle | Tabelle |
| Ansehen | Ansehen |
Iceberg-Tabelle erstellen
In diesem Abschnitt erfahren Sie, wie Sie mit Managed Service for Apache Spark Spark SQL- und PySpark-Batcharbeitslasten eine Iceberg-Tabelle mit Metadaten im Lakehouse-Laufzeitkatalog erstellen.
Spark SQL
Spark SQL-Arbeitslast ausführen, um eine Iceberg-Tabelle zu erstellen
In den folgenden Schritten wird gezeigt, wie Sie einen Managed Service for Apache Spark SQL-Batcharbeitslast ausführen, um eine Iceberg-Tabelle mit Tabellenmetadaten zu erstellen, die im Lakehouse Runtime-Katalog gespeichert sind.
Kopieren Sie die folgenden Spark SQL-Befehle lokal oder in Cloud Shell in eine
iceberg-table.sql-Datei.USE CATALOG_NAME; CREATE NAMESPACE IF NOT EXISTS example_namespace; USE example_namespace; DROP TABLE IF EXISTS example_table; CREATE TABLE example_table (id int, data string) USING ICEBERG LOCATION 'gs://BUCKET/WAREHOUSE_FOLDER'; INSERT INTO example_table VALUES (1, 'first row'); ALTER TABLE example_table ADD COLUMNS (newDoubleCol double); DESCRIBE TABLE example_table;
Ersetzen Sie Folgendes:
- CATALOG_NAME: Name des Iceberg-Katalogs.
- BUCKET und WAREHOUSE_FOLDER: Cloud Storage-Bucket und -Ordner, die als Iceberg-Warehouse-Verzeichnis verwendet werden.
Führen Sie den folgenden Befehl lokal oder in Cloud Shell aus dem Verzeichnis aus, das
iceberg-table.sqlenthält, um die Spark SQL-Arbeitslast zu übergeben.gcloud dataproc batches submit spark-sql iceberg-table.sql \ --project=PROJECT_ID \ --region=REGION \ --deps-bucket=BUCKET_NAME \ --version=2.2 \ --subnet=SUBNET_NAME \ --properties="spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,spark.sql.catalog.CATALOG_NAME.catalog-impl=org.apache.iceberg.gcp.bigquery.BigQueryMetastoreCatalog,spark.sql.catalog.CATALOG_NAME.gcp_project=PROJECT_ID,spark.sql.catalog.CATALOG_NAME.gcp_location=LOCATION,spark.sql.catalog.CATALOG_NAME.warehouse=gs://BUCKET/WAREHOUSE_FOLDER"
Hinweise:
- PROJECT_ID: Ihre Google Cloud Projekt-ID Projekt-IDs werden im Bereich Projektinformationen im Dashboard der Google Cloud Console aufgeführt.
- REGION: Eine verfügbare Compute Engine-Region zum Ausführen der Arbeitslast.
- BUCKET_NAME: Der Name Ihres Cloud Storage-Buckets Spark lädt Arbeitslastabhängigkeiten in einen
/dependencies-Ordner in diesem Bucket hoch, bevor die Batcharbeitslast ausgeführt wird. WAREHOUSE_FOLDER befindet sich in diesem Bucket. --version:Managed Service for Apache Spark-Laufzeitversion 2.2 oder höher.- SUBNET_NAME: Der Name eines VPC-Subnetzes in der
REGION. Wenn Sie dieses Flag weglassen, wählt Managed Service for Apache Spark dasdefault-Subnetz in der Sitzungsregion aus. Managed Service for Apache Spark aktiviert privaten Google-Zugriff im Subnetz. Informationen zu den Anforderungen an die Netzwerkverbindung finden Sie unter Netzwerkkonfiguration für Managed Service for Apache Spark. - LOCATION: Ein unterstützter BigQuery-Standort. Der standardmäßige Standort ist „US“.
--propertiesKatalogeigenschaften
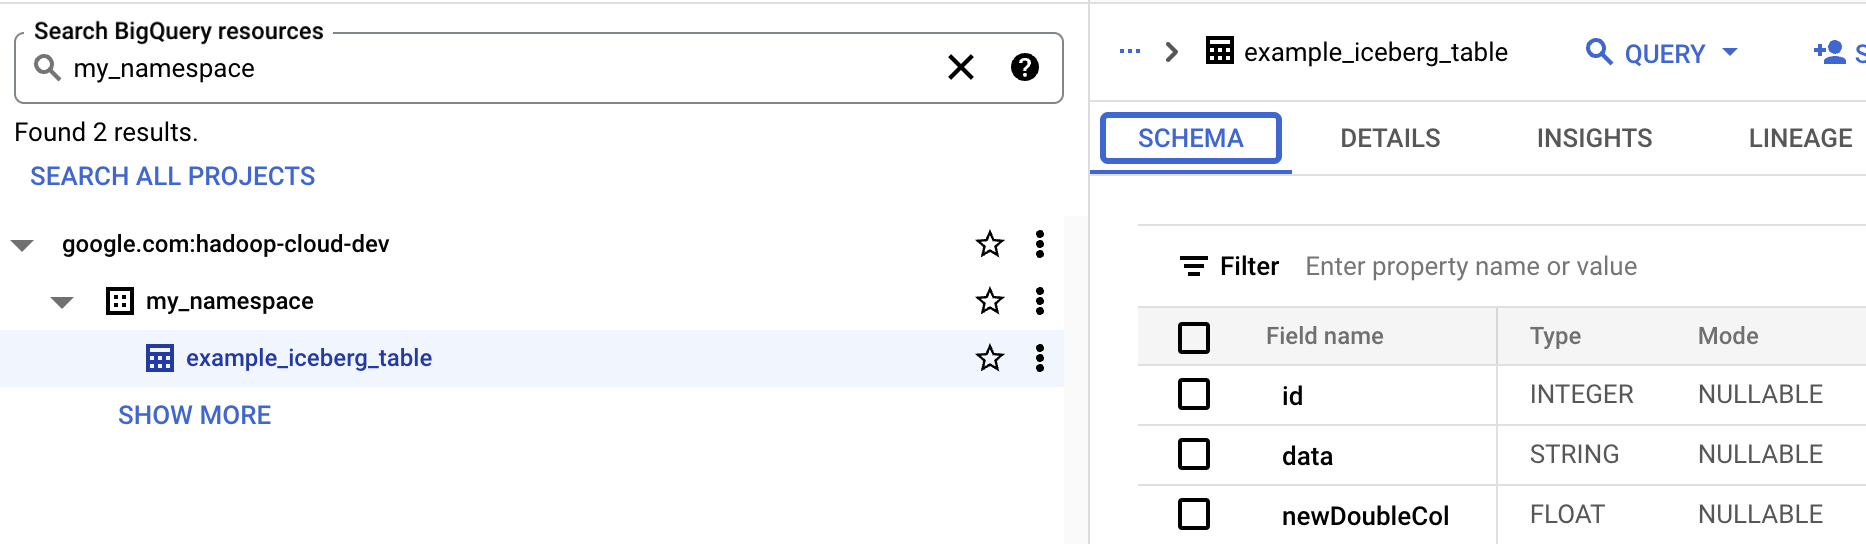
Tabellenmetadaten in BigQuery ansehen
Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
Iceberg-Tabellenmetadaten ansehen.
PySpark
In den folgenden Schritten wird beschrieben, wie Sie einen PySpark-Batch-Arbeitslast für Managed Service for Apache Spark ausführen, um eine Iceberg-Tabelle mit Tabellenmetadaten zu erstellen, die im Lakehouse-Laufzeitkatalog gespeichert sind.
- Kopieren Sie den folgenden PySpark-Code lokal oder in Cloud Shell in eine
iceberg-table.py-Datei.from pyspark.sql import SparkSession spark = SparkSession.builder.appName("iceberg-table-example").getOrCreate() catalog = "CATALOG_NAME" namespace = "NAMESPACE" spark.sql(f"USE `{catalog}`;") spark.sql(f"CREATE NAMESPACE IF NOT EXISTS `{namespace}`;") spark.sql(f"USE `{namespace}`;") # Create table and display schema spark.sql("DROP TABLE IF EXISTS example_iceberg_table") spark.sql("CREATE TABLE example_iceberg_table (id int, data string) USING ICEBERG") spark.sql("DESCRIBE example_iceberg_table;") # Insert table data. spark.sql("INSERT INTO example_iceberg_table VALUES (1, 'first row');") # Alter table, then display schema. spark.sql("ALTER TABLE example_iceberg_table ADD COLUMNS (newDoubleCol double);") spark.sql("DESCRIBE example_iceberg_table;")
Ersetzen Sie Folgendes:
- CATALOG_NAME und NAMESPACE: Der Name des Iceberg-Katalogs und der Namespace werden kombiniert, um die Iceberg-Tabelle (
catalog.namespace.table_name) zu identifizieren.
- CATALOG_NAME und NAMESPACE: Der Name des Iceberg-Katalogs und der Namespace werden kombiniert, um die Iceberg-Tabelle (
-
Führen Sie den folgenden Befehl lokal oder in Cloud Shell aus dem Verzeichnis mit
iceberg-table.pyaus, um die PySpark-Arbeitslast zu senden.gcloud dataproc batches submit pyspark iceberg-table.py \ --project=PROJECT_ID \ --region=REGION \ --deps-bucket=BUCKET_NAME \ --version=2.2 \ --subnet=SUBNET_NAME \ --properties="spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,spark.sql.catalog.CATALOG_NAME.catalog-impl=org.apache.iceberg.gcp.bigquery.BigQueryMetastoreCatalog,spark.sql.catalog.CATALOG_NAME.gcp_project=PROJECT_ID,spark.sql.catalog.CATALOG_NAME.gcp_location=LOCATION,spark.sql.catalog.CATALOG_NAME.warehouse=gs://BUCKET/WAREHOUSE_FOLDER"Hinweise:
- PROJECT_ID: Ihre Google Cloud Projekt-ID Projekt-IDs werden im Bereich Projektinformationen im Dashboard der Google Cloud Console aufgeführt.
- REGION: Eine verfügbare Compute Engine-Region zum Ausführen der Arbeitslast.
- BUCKET_NAME: Der Name Ihres Cloud Storage-Buckets Spark lädt Arbeitslastabhängigkeiten in den Ordner
/dependenciesin diesem Bucket hoch, bevor die Batcharbeitslast ausgeführt wird. --version:Managed Service for Apache Spark-Laufzeitversion 2.2 oder höher.- SUBNET_NAME: Der Name eines VPC-Subnetzes in der
REGION. Wenn Sie dieses Flag weglassen, wählt Managed Service for Apache Spark dasdefault-Subnetz in der Sitzungsregion aus. Managed Service for Apache Spark aktiviert privaten Google-Zugriff (PGA) im Subnetz. Informationen zu den Anforderungen an die Netzwerkverbindung finden Sie unter Netzwerkkonfiguration für Managed Service for Apache Spark. - LOCATION: Ein unterstützter BigQuery-Standort. Der standardmäßige Standort ist „US“.
- BUCKET und WAREHOUSE_FOLDER: Cloud Storage-Bucket und -Ordner, die als Iceberg-Warehouse-Verzeichnis verwendet werden.
--properties: Katalogattribute.
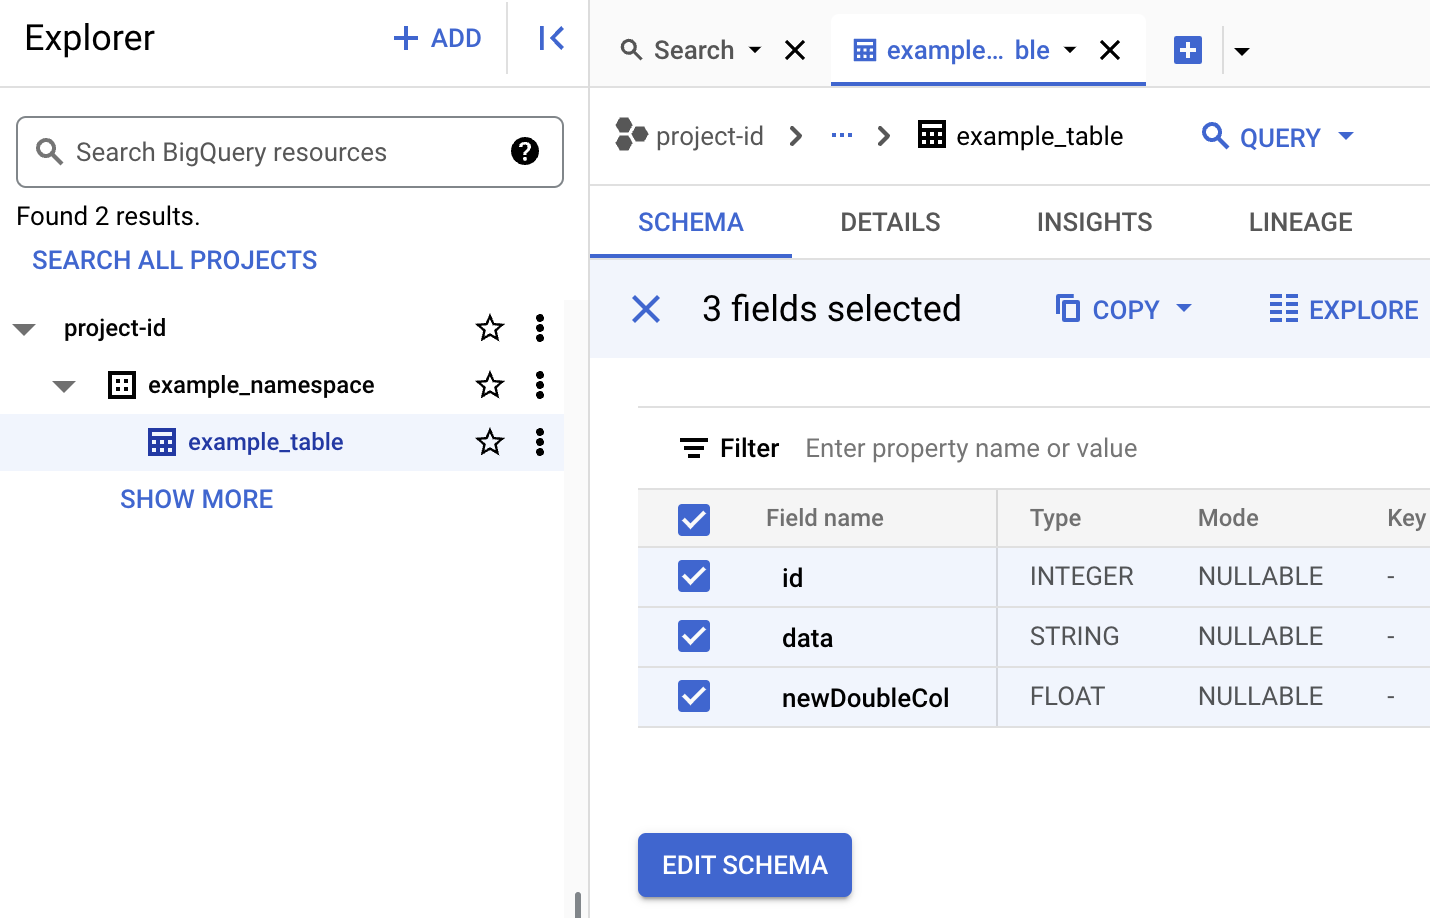
- Tabellenschema in BigQuery ansehen
- Rufen Sie in der Google Cloud Console die Seite BigQuery auf. Zu BigQuery Studio
- Iceberg-Tabellenmetadaten ansehen.