


Criar um lakehouse com o Spark e o catálogo do ambiente de execução do Lakehouse
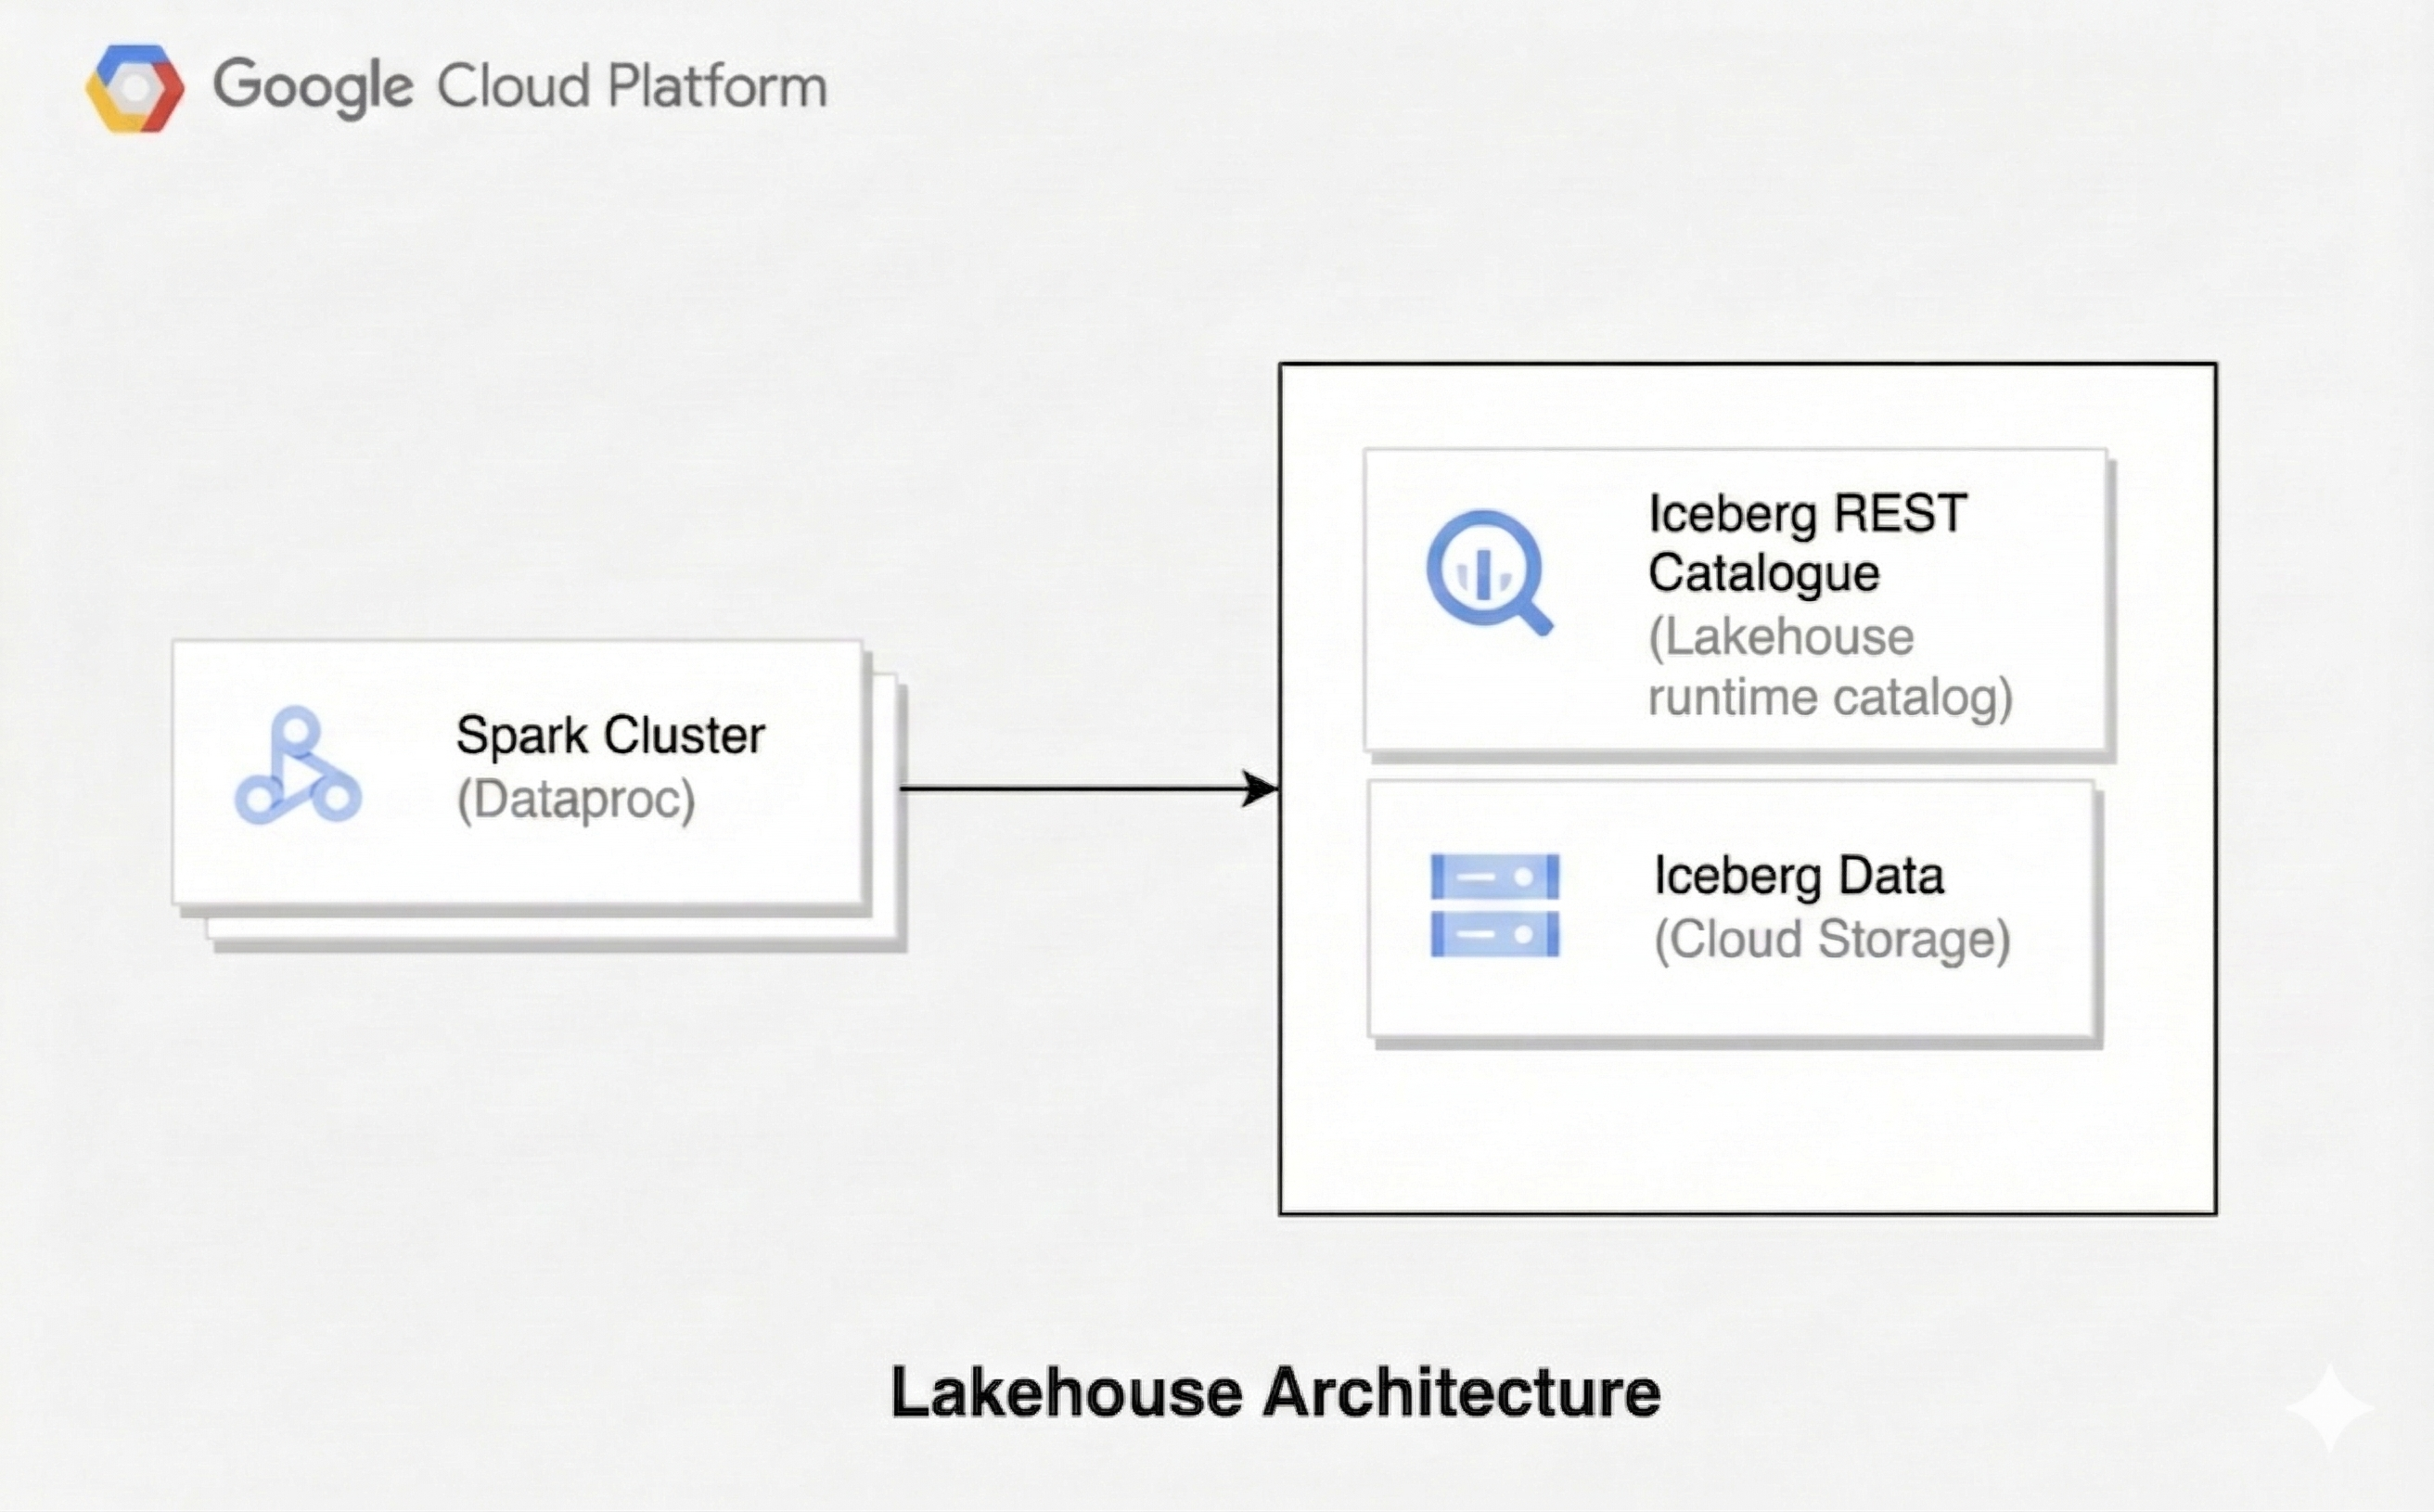
Uma arquitetura de lakehouse combina a flexibilidade de um data lake com os recursos de gerenciamento de dados de um data warehouse. Neste documento, mostramos como configurar um lakehouse no Google Cloud. Você usa o Apache Iceberg como formato de tabela, o Serviço Gerenciado para Apache Spark para processamento e o catálogo REST do Iceberg do catálogo do ambiente de execução do Lakehouse para gerenciamento unificado de metadados.
Essa arquitetura usa formatos de tabela abertos, como o Iceberg, para adicionar recursos de armazenamento em data warehouse, como transações e evolução de esquema, aos dados no Cloud Storage. Essa abordagem cria uma única fonte de verdade para seus dados que pode ser acessada por vários mecanismos.
Este documento aborda os catálogos criados no catálogo do ambiente de execução do Lakehouse. Para consultar tabelas do Iceberg gerenciadas pelo AWS Glue Data Catalog, Databricks Unity Catalog ou Snowflake Horizon Catalog usando catálogos federados do catálogo do ambiente de execução do Lakehouse, consulte Consultar catálogos federados com o Spark.
Antes de começar
- Faça login na sua conta do Google Cloud . Se você começou a usar o Google Cloudagora, crie uma conta para avaliar o desempenho dos nossos produtos em situações reais. Clientes novos também recebem US $300 em créditos para executar, testar e implantar cargas de trabalho.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that you have the permissions required to complete this guide.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Dataproc, BigLake, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that you have the permissions required to complete this guide.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Dataproc, BigLake, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.- Crie um bucket do Cloud Storage para armazenar dados do Iceberg.
- Crie um catálogo no catálogo do ambiente de execução do Lakehouse que aponte para seu bucket. Recomendamos um catálogo com vários buckets.
Funções exigidas
Alguns papéis do Identity and Access Management (IAM) são necessários para executar os exemplos nesta página. Dependendo das políticas da organização, essas funções podem já ter sido concedidas. Para verificar as concessões de papéis, consulte Você precisa conceder papéis?.
Para mais informações sobre a concessão de papéis, consulte Gerenciar o acesso a projetos, pastas e organizações.
Os papéis necessários dependem de como sua carga de trabalho é executada.
Os clusters do Serviço Gerenciado para Apache Spark e os ambientes de execução sem servidor do Serviço Gerenciado para Apache Spark 2.3 e anteriores executam cargas de trabalho como uma conta de serviço. Os tempos de execução sem servidor do Serviço Gerenciado para Apache Spark 3.0 e
versões mais recentes executam cargas de trabalho com suas credenciais de usuário final (EUC) por padrão. Portanto, você
concede papéis de acesso a dados à sua conta de usuário em vez de uma conta de serviço. Se
você especificar uma conta de serviço personalizada para um ambiente de execução 3.0 ou posterior, a carga de trabalho
será executada com as credenciais da conta de serviço. Para mais informações, consulte
Papéis de implantações sem servidor.
Papéis do usuário
Para receber as permissões necessárias para criar um cluster do Serviço Gerenciado para Apache Spark, enviar uma carga de trabalho em lote ou criar uma sessão interativa, peça ao administrador para conceder a você os seguintes papéis do IAM:
-
Use um cluster ou um ambiente de execução sem servidor 2.3 ou anterior:
- Editor do Dataproc (
roles/dataproc.editor) no projeto - Usuário da conta de serviço (
roles/iam.serviceAccountUser) na conta de serviço padrão do Compute Engine ou em uma conta de serviço personalizada
- Editor do Dataproc (
-
Usar um ambiente de execução sem servidor 3.0 ou posterior:
Editor do Dataproc sem servidor (
roles/dataproc.serverlessEditor) no projeto -
Use as credenciais da conta de serviço em um ambiente de execução sem servidor 3.0 ou posterior:
Usuário da conta de serviço (
roles/iam.serviceAccountUser) na conta de serviço personalizada
Se você usar um ambiente de execução sem servidor do Serviço Gerenciado para Apache Spark 3.0 ou posterior com credenciais de usuário final (o padrão), também precisará dos seguintes papéis de acesso aos dados:
Para receber as permissões necessárias para ler e gravar tabelas no catálogo com credenciais de usuário final, peça ao administrador para conceder a você os seguintes papéis do IAM:
-
Ler e gravar dados de tabela no modo de venda de credenciais:
Editor do BigLake (
roles/biglake.editor) no projeto que contém o catálogo -
Gerenciar recursos de catálogo e gravar dados de tabela no modo de venda sem credenciais:
- Editor do BigLake (
roles/biglake.editor) no projeto que contém o catálogo - Usuário de objetos do Storage (
roles/storage.objectUser) em todos os buckets do Cloud Storage associados ao catálogo
- Editor do BigLake (
Papéis da conta de serviço
Conceda os seguintes papéis à conta de serviço que executa sua carga de trabalho.
Os ambientes de execução sem servidor do Serviço Gerenciado para Apache Spark 3.0 e versões mais recentes precisam desses papéis apenas se a carga de trabalho for executada com credenciais da conta de serviço.
Para garantir que a conta de serviço padrão do Compute Engine ou uma conta de serviço personalizada tenha as permissões necessárias para executar jobs do Serviço Gerenciado para Apache Spark e ler e gravar tabelas no catálogo, peça ao administrador para conceder os seguintes papéis do IAM à conta de serviço padrão do Compute Engine ou a uma conta de serviço personalizada:
-
Execute jobs do Serviço Gerenciado para Apache Spark em um cluster ou um ambiente de execução sem servidor 2.3 ou anterior:
Worker do Dataproc (
roles/dataproc.worker) no projeto -
Execute jobs do Serviço Gerenciado para Apache Spark em um ambiente de execução sem servidor 3.0 ou posterior:
- Nó do Dataproc sem servidor (
roles/dataproc.serverlessNode) no projeto - Agente de serviço do nó do Dataproc Resource Manager (
roles/dataprocrm.nodeServiceAgent) no projeto
- Nó do Dataproc sem servidor (
-
Ler e gravar dados de tabela no modo de venda de credenciais:
Editor do BigLake (
roles/biglake.editor) no projeto que contém o catálogo -
Gerenciar recursos de catálogo e gravar dados de tabela no modo de venda sem credenciais:
- Editor do BigLake (
roles/biglake.editor) no projeto que contém o catálogo - Usuário de objetos do Storage (
roles/storage.objectUser) em todos os buckets do Cloud Storage associados ao catálogo
- Editor do BigLake (
Configurar o Serviço Gerenciado para Apache Spark e criar uma sessão do Spark
Configure um cluster do Serviço Gerenciado para Apache Spark, uma carga de trabalho em lote sem servidor do Serviço Gerenciado para Apache Spark ou uma sessão interativa sem servidor do Serviço Gerenciado para Apache Spark para usar o catálogo do ambiente de execução do Lakehouse, Catálogo REST do Iceberg. Todos os três
são compatíveis com a
propriedade de configuração simplificada
dataproc.lakehouse.catalog.CATALOG_NAME (recomendada), que permite que o Serviço Gerenciado para Apache Spark
leia a definição do catálogo e gere as propriedades do Spark do catálogo REST
do Iceberg. Apenas o formulário de cluster usa o prefixo dataproc:.
Versões de imagem e ambiente de execução compatíveis:
Tanto a configuração simplificada quanto a manual usam a autorização do Google para o Iceberg (GoogleAuthManager), que exige uma das seguintes versões:
- Clusters do Serviço Gerenciado para Apache Spark: versões de imagem
2.22.2.65e posteriores ou versões de imagem2.32.3.11e posteriores. - Cargas de trabalho em lote sem servidor e sessões interativas do Serviço Gerenciado para Apache Spark: ambientes de execução
2.22.2.60e mais recentes, ambientes de execução2.32.3.10e mais recentes ou ambientes de execução3.0.
Para cargas de trabalho em lote sem servidor e sessões interativas, os papéis necessários
dependem da versão do ambiente de execução. Os ambientes de execução 3.0 e mais recentes usam credenciais de usuário final por padrão. Para mais detalhes, consulte Papéis necessários.
Cluster
Crie um cluster do Serviço Gerenciado para Apache Spark com os componentes opcionais Iceberg e Jupyter usando propriedades de configuração simplificadas (recomendado) ou especificando manualmente as propriedades do catálogo no notebook.
Configuração simplificada usando propriedades (recomendado)
Crie o cluster com a propriedade do catálogo:
gcloud dataproc clusters create CLUSTER_NAME \
  --project=PROJECT_ID \
  --region=REGION \
  --image-version=IMAGE_VERSION \
  --optional-components=ICEBERG,JUPYTER \
  --enable-component-gateway \
  --properties='dataproc:dataproc.lineage.enabled=true,dataproc:dataproc.lakehouse.catalog.CATALOG_NAME=projects/PROJECT_ID/catalogs/CATALOG_ID,spark:spark.sql.defaultCatalog=CATALOG_NAME'
Substitua:
CLUSTER_NAME: um nome para o cluster.PROJECT_ID: o ID do projeto doGoogle Cloud .REGION: a região do Google Cloud cluster, por exemplo,us-central1.IMAGE_VERSION: a versão da imagem do Serviço Gerenciado para Apache Spark. Por exemplo,2.3-debian12. Consulte Versões de imagem e ambiente de execução compatíveis.CATALOG_NAME: um nome para o catálogo local do Spark, por exemplo,iceberg_catalog. Pode ser igual aCATALOG_ID.CATALOG_ID: o ID do catálogo que você criou em Antes de começar.
A propriedade dataproc:dataproc.lineage.enabled=true não é necessária para que o catálogo REST do Iceberg do catálogo do ambiente de execução do Lakehouse funcione corretamente. Ele é adicionado para rastreamento de linhagem no
exemplo de linhagem de dados.
Conecte-se ao cluster usando um notebook do Jupyter (um notebook do Vertex AI Workbench ou um notebook iniciado no cluster) e crie o SparkSession sem especificar as configurações do catálogo:
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("APP_NAME").getOrCreate()
Substitua APP_NAME pelo nome do seu aplicativo
Spark.
Configuração manual
Se você não usar a propriedade de configuração simplificada, crie o cluster
conforme descrito anteriormente sem dataproc:dataproc.lakehouse.catalog.
na flag --properties, conecte-se a um notebook do Jupyter e
configure o SparkSession manualmente, da seguinte maneira:
import pyspark
from pyspark.context import SparkContext
from pyspark.sql import SparkSession

catalog_name = "CATALOG_NAME"

spark = SparkSession.builder.appName("APP_NAME") \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
Substitua:
CATALOG_NAME: um nome para o catálogo local do Spark, por exemplo,iceberg_catalog.APP_NAME: o nome do aplicativo do Spark.WAREHOUSE_PATH: o caminho para o warehouse. Para catálogos de vários buckets (recomendado), usebl://projects/PROJECT_ID/catalogs/CATALOG_ID. Para catálogos de bucket único, usegs://CLOUD_STORAGE_BUCKET_NAME.PROJECT_ID: o ID do projeto do Google Cloud .
Configurar com o modo de venda de credenciais
Para usar a venda de credenciais, use um
catálogo no modo de venda de credenciais
e adicione o cabeçalho X-Iceberg-Access-Delegation às
solicitações do catálogo REST do Iceberg com um valor de
vended-credentials adicionando a seguinte linha ao
builder SparkSession:
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials')
O exemplo a seguir configura o SparkSession com
venda de credenciais:
from pyspark.sql import SparkSession

catalog_name = "CATALOG_NAME"

spark = SparkSession.builder.appName("APP_NAME") \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
A configuração simplificada adiciona esse cabeçalho quando o catálogo usa o modo de venda de credenciais. Para mais informações, consulte a seção
Cabeçalhos em RESTCatalog
da documentação do Iceberg.
Sem servidor
Envie uma carga de trabalho em lote do PySpark para o Serviço Gerenciado para Apache Spark sem servidor usando propriedades de configuração simplificadas (recomendado) ou especificando manualmente as propriedades do catálogo.
Configuração simplificada usando propriedades (recomendado)
Transmita a propriedade dataproc.lakehouse.catalog.CATALOG_NAME (sem o prefixo dataproc:) ao enviar a carga de trabalho em lote:
gcloud dataproc batches submit pyspark PYSPARK_FILE \
  --project=PROJECT_ID \
  --region=REGION \
  --version=RUNTIME_VERSION \
  --properties="dataproc.lakehouse.catalog.CATALOG_NAME=projects/PROJECT_ID/catalogs/CATALOG_ID,spark.sql.defaultCatalog=CATALOG_NAME"
Substitua:
PYSPARK_FILE: o caminho do Cloud Storagegs://para o arquivo do aplicativo PySpark.PROJECT_ID: o ID do projeto doGoogle Cloud .REGION: a região da sua carga de trabalho em lote.RUNTIME_VERSION: a versão do ambiente de execução sem servidor do Serviço Gerenciado para Apache Spark, por exemplo,3.0. Os papéis necessários dependem da versão do ambiente de execução. Consulte Versões de imagem e ambiente de execução compatíveis.CATALOG_NAME: um nome para o catálogo local do Spark, por exemplo,iceberg_catalog. Pode ser igual aCATALOG_ID.CATALOG_ID: o ID do catálogo que você criou em Antes de começar.
No arquivo do aplicativo PySpark, crie o SparkSession sem
especificar as configurações do catálogo:
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("APP_NAME").getOrCreate()
Configuração manual
Se você não usar a propriedade de configuração simplificada, especifique as propriedades do catálogo na flag --properties ao enviar sua carga de trabalho em lote:
gcloud dataproc batches submit pyspark PYSPARK_FILE \
  --project=PROJECT_ID \
  --region=REGION \
  --version=RUNTIME_VERSION \
  --properties="\
spark.sql.defaultCatalog=CATALOG_NAME,\
spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,\
spark.sql.catalog.CATALOG_NAME.type=rest,\
spark.sql.catalog.CATALOG_NAME.uri=https://biglake.googleapis.com/iceberg/v1/restcatalog,\
spark.sql.catalog.CATALOG_NAME.warehouse=WAREHOUSE_PATH,\
spark.sql.catalog.CATALOG_NAME.header.x-goog-user-project=PROJECT_ID,\
spark.sql.catalog.CATALOG_NAME.rest.auth.type=org.apache.iceberg.gcp.auth.GoogleAuthManager,\
spark.sql.catalog.CATALOG_NAME.io-impl=org.apache.iceberg.gcp.gcs.GCSFileIO,\
spark.sql.extensions=org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions"
Substitua WAREHOUSE_PATH pelo caminho
do seu data warehouse. Para catálogos de vários buckets (recomendado), use
bl://projects/PROJECT_ID/catalogs/CATALOG_ID.
Para catálogos de bucket único, use
gs://CLOUD_STORAGE_BUCKET_NAME.
Configurar com o modo de venda de credenciais
Para usar a venda de credenciais, use um
catálogo no modo de venda de credenciais
e adicione o cabeçalho X-Iceberg-Access-Delegation às
solicitações de catálogo REST do Iceberg com um valor de
vended-credentials adicionando a seguinte propriedade à
flag --properties:
spark.sql.catalog.CATALOG_NAME.header.X-Iceberg-Access-Delegation=vended-credentialsO exemplo a seguir envia uma carga de trabalho em lote com venda de credenciais:
gcloud dataproc batches submit pyspark PYSPARK_FILE \
  --project=PROJECT_ID \
  --region=REGION \
  --version=RUNTIME_VERSION \
  --properties="\
spark.sql.defaultCatalog=CATALOG_NAME,\
spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,\
spark.sql.catalog.CATALOG_NAME.type=rest,\
spark.sql.catalog.CATALOG_NAME.uri=https://biglake.googleapis.com/iceberg/v1/restcatalog,\
spark.sql.catalog.CATALOG_NAME.warehouse=WAREHOUSE_PATH,\
spark.sql.catalog.CATALOG_NAME.header.x-goog-user-project=PROJECT_ID,\
spark.sql.catalog.CATALOG_NAME.rest.auth.type=org.apache.iceberg.gcp.auth.GoogleAuthManager,\
spark.sql.catalog.CATALOG_NAME.io-impl=org.apache.iceberg.gcp.gcs.GCSFileIO,\
spark.sql.catalog.CATALOG_NAME.header.X-Iceberg-Access-Delegation=vended-credentials,\
spark.sql.extensions=org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions"
A configuração simplificada adiciona esse cabeçalho quando o catálogo usa o modo de venda de credenciais. Para mais informações, consulte a seção
Cabeçalhos no RESTCatalog
da documentação do Iceberg.
Sem servidor
Crie uma sessão interativa sem servidor do Serviço Gerenciado para Apache Spark em um
notebook com a API
DataprocSparkSession,
usando propriedades de configuração simplificadas (recomendado) ou especificando
manualmente as propriedades do catálogo.
Configuração simplificada usando propriedades (recomendado)
Em um notebook que tenha o pacote dataproc-spark-connect instalado, como
um notebook do BigQuery Studio ou do Vertex AI Workbench, transmita a
propriedade dataproc.lakehouse.catalog.CATALOG_NAME
(sem o prefixo dataproc:) ao criar a sessão:
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session

catalog_name = "CATALOG_NAME"

session_config = Session()
session_config.runtime_config.version = 'RUNTIME_VERSION'

spark = DataprocSparkSession.builder.appName("APP_NAME") \
.dataprocSessionConfig(session_config) \
.config(f'dataproc.lakehouse.catalog.{catalog_name}', 'projects/PROJECT_ID/catalogs/CATALOG_ID') \
.config('spark.sql.defaultCatalog', catalog_name) \
.getOrCreate()
Substitua:
CATALOG_NAME: um nome para o catálogo local do Spark, por exemplo,iceberg_catalog. Pode ser igual aCATALOG_ID.RUNTIME_VERSION: a versão do ambiente de execução sem servidor do Serviço Gerenciado para Apache Spark, por exemplo,3.0. Os papéis necessários dependem da versão do ambiente de execução (consulte Versões de imagem e ambiente de execução compatíveis).APP_NAME: o nome do aplicativo do Spark.PROJECT_ID: o ID do projeto do Google Cloud .CATALOG_ID: o ID do catálogo que você criou em Antes de começar.
Também é possível definir essas propriedades em um modelo de sessão.
Configuração manual
Se você não usar a propriedade de configuração simplificada, especifique as propriedades do catálogo ao criar a sessão:
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session

catalog_name = "CATALOG_NAME"

session_config = Session()
session_config.runtime_config.version = 'RUNTIME_VERSION'

spark = DataprocSparkSession.builder.appName("APP_NAME") \
.dataprocSessionConfig(session_config) \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
Substitua RUNTIME_VERSION conforme
descrito no exemplo de configuração simplificada anteriormente nesta guia.
Substitua WAREHOUSE_PATH pelo caminho
do seu data warehouse. Para catálogos de vários buckets (recomendado), use
bl://projects/PROJECT_ID/catalogs/CATALOG_ID.
Para catálogos de bucket único, use
gs://CLOUD_STORAGE_BUCKET_NAME.
Configurar com o modo de venda de credenciais
Para usar a venda de credenciais, use um
catálogo no modo de venda de credenciais
e adicione o cabeçalho X-Iceberg-Access-Delegation às
solicitações de catálogo REST do Iceberg com um valor de
vended-credentials adicionando a seguinte linha ao
criador de sessões:
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials')
O exemplo a seguir cria uma sessão com a venda de credenciais:
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session

catalog_name = "CATALOG_NAME"

session_config = Session()
session_config.runtime_config.version = 'RUNTIME_VERSION'

spark = DataprocSparkSession.builder.appName("APP_NAME") \
.dataprocSessionConfig(session_config) \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
A configuração simplificada adiciona esse cabeçalho quando o catálogo usa o modo de venda de credenciais. Para mais informações, consulte a seção
Cabeçalhos no RESTCatalog
da documentação do Iceberg.
Gerenciar dados com o Spark SQL
Depois de configurar a sessão do Spark, use o Spark SQL para realizar operações de gerenciamento de dados.
Como definir o catálogo:a propriedade dataproc.lakehouse.catalog. registra
o catálogo no Spark, mas não o torna o catálogo padrão. Os
exemplos na seção anterior definem spark.sql.defaultCatalog
(spark:spark.sql.defaultCatalog em um cluster) para que você possa usar
nomes de tabela não qualificados. Se você omitir essa propriedade, qualifique os nomes das tabelas com
o nome do catálogo, por exemplo,
CATALOG_NAME.NAMESPACE_NAME.base_table.
Crie um namespace No catálogo REST do Iceberg do catálogo do ambiente de execução do Lakehouse, um namespace corresponde a um conjunto de dados do BigQuery.
spark.sql("CREATE NAMESPACE IF NOT EXISTS NAMESPACE_NAME")
spark.sql("USE NAMESPACE_NAME")
Substitua
NAMESPACE_NAMEpelo nome do namespace, por exemplo,spark_lakehouse.Crie uma tabela base no formato Iceberg e insira dados.
spark.sql("DROP TABLE IF EXISTS base_table PURGE")
spark.sql("CREATE TABLE base_table (id LONG) USING iceberg")
spark.sql("INSERT INTO base_table VALUES 0, 1, 2, 3, 4")
spark.sql("SELECT * FROM base_table").show()
O resultado será o seguinte:
   +---+
   | id|
   +---+
   |  0|
   |  1|
   |  2|
   |  3|
   |  4|
   +---+
Crie outra tabela para novos dados.
spark.sql("DROP TABLE IF EXISTS newdata PURGE")
spark.sql("CREATE TABLE newdata(id LONG) USING iceberg")
spark.sql("INSERT INTO newdata VALUES 3, 4, 5, 6")
spark.sql("SELECT * FROM newdata").show()
O resultado será o seguinte:
   +---+
   | id|
   +---+
   |  3|
   |  4|
   |  5|
   |  6|
   +---+
Mescle os novos dados na tabela base.
spark.sql("""MERGE INTO base_table USING newdata
           ON base_table.id = newdata.id
           WHEN MATCHED THEN
             UPDATE SET base_table.id = newdata.id
           WHEN NOT MATCHED THEN INSERT * """)
spark.sql("SELECT * FROM base_table").show()
O resultado será o seguinte:
   +---+
   | id|
   +---+
   |  0|
   |  1|
   |  2|
   |  3|
   |  4|
   |  5|
   |  6|
   +---+
Atualize os registros na tabela base.
spark.sql(
     "UPDATE base_table SET id = (id + 100) WHERE (id % 2 == 0)"
 )
spark.sql("SELECT * FROM base_table").show()
O resultado será o seguinte:
   +---+
   | id|
   +---+
   |  3|
   |104|
   |  5|
   |106|
   |100|
   |102|
   |  1|
   +---+
Exclua registros da tabela base.
spark.sql("DELETE FROM base_table WHERE (id % 2 == 0)")
spark.sql("SELECT * FROM base_table").show()
O resultado será o seguinte:
   +---+
   | id|
   +---+
   |  3|
   |  5|
   |  1|
   +---+
Consultar um snapshot histórico
Recupere uma versão anterior de uma tabela consultando um ID de snapshot. Essa operação também é conhecida como viagem no tempo.
Recupere o ID do snapshot da versão da tabela antes das operações
MERGE,UPDATEeDELETE.snapshot_ids = spark.sql( "SELECT snapshot_id FROM `NAMESPACE_NAME`.`base_table`.snapshots" ).collect() oldest_snapshot_id = snapshot_ids[1]["snapshot_id"]Substitua
NAMESPACE_NAMEpelo namespace que você criou.Consulte a tabela usando o ID do snapshot recuperado.
df = (
     spark.read.format("iceberg")
     .option("versionAsOf", oldest_snapshot_id)
     .load("base_table")
 )
df.show()
A saída mostra o estado da tabela após a operação
MERGE, mas antes das operaçõesUPDATEouDELETE.+---+ | id| +---+ | 0| | 1| | 2| | 3| | 4| | 5| | 6| +---+
Descobrir a linhagem de dados
Usando o Serviço Gerenciado para Apache Spark 2.2 e versões de imagem mais recentes, é possível rastrear a movimentação de dados entre as tabelas do catálogo de ambiente de execução do Lakehouse e do catálogo REST do Iceberg com a linhagem de dados.
Exemplo de linhagem de dados
Crie tabelas Iceberg de origem e de destino e copie os dados.
spark.sql("DROP TABLE IF EXISTS source_table PURGE")
spark.sql("DROP TABLE IF EXISTS target_table PURGE")
spark.sql("CREATE TABLE source_table (id LONG) USING iceberg")
spark.sql("""CREATE TABLE target_table
  USING ICEBERG
  AS SELECT max(id) as top_id FROM source_table
  """)
No console do Google Cloud , acesse a página Pesquisa do Knowledge Catalog .
Pesquise uma das tabelas e clique na guia
Lineage: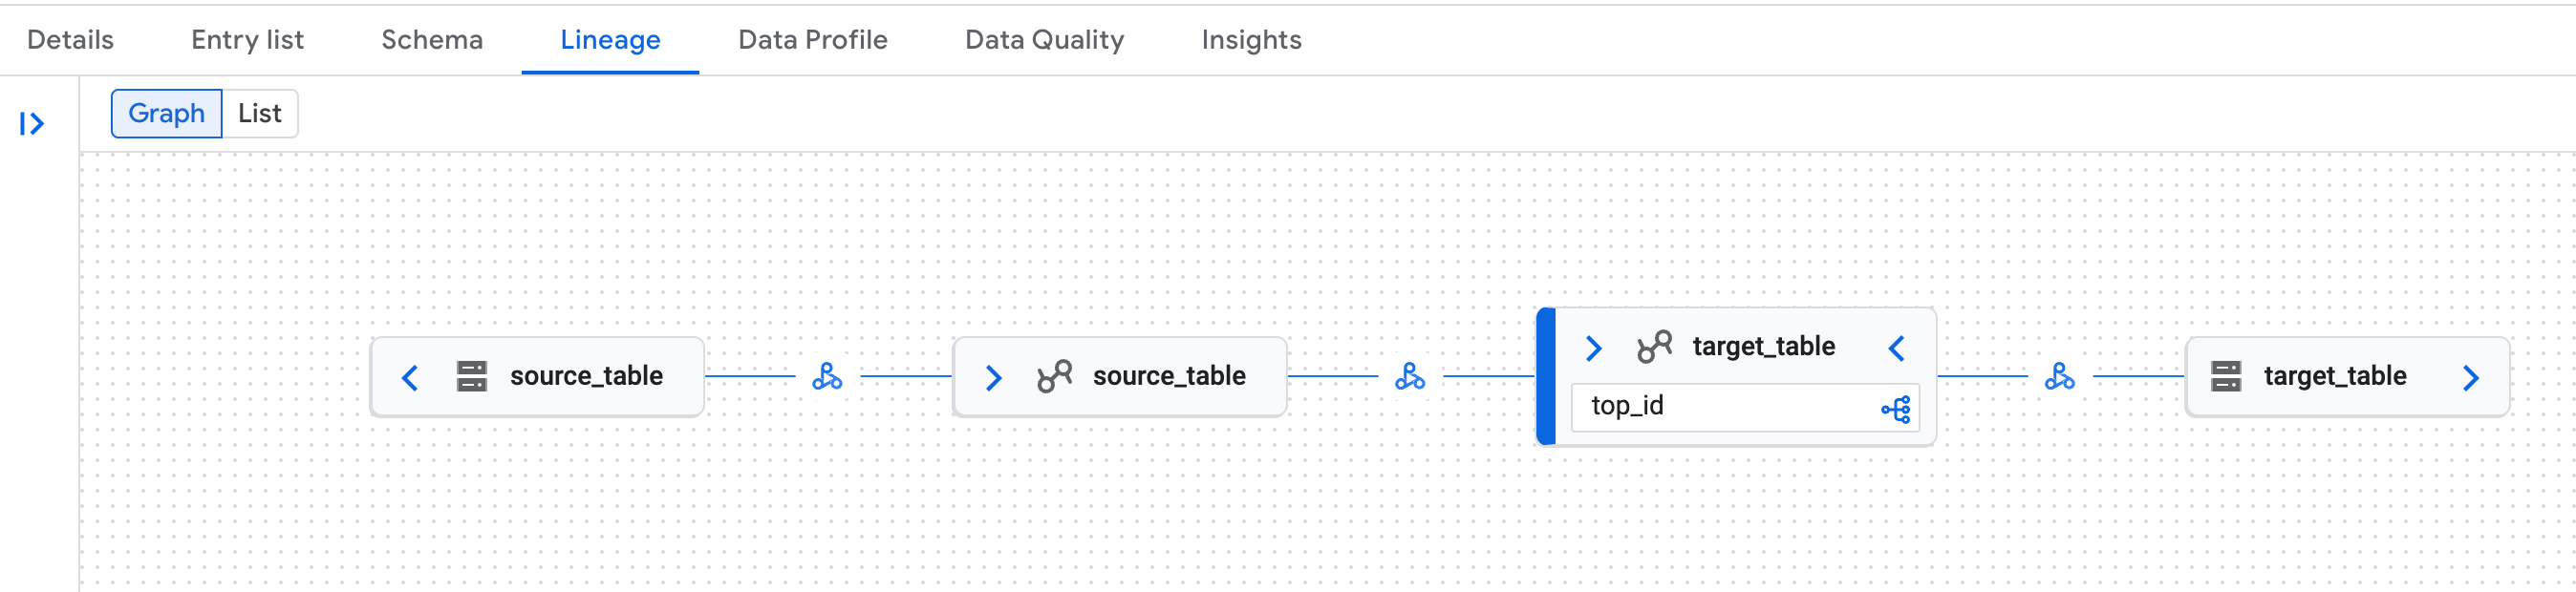
Exemplo de gráfico de linhagem de dados na página do Knowledge Catalog no console Google Cloud . A linhagem de dados reconhece as representações lógica (tabela do catálogo do ambiente de execução do Lakehouse) e física (Cloud Storage) das tabelas do catálogo REST do Iceberg do catálogo do ambiente de execução do Lakehouse.
Problemas conhecidos da linhagem de dados
Em alguns clusters do Serviço Gerenciado para Apache Spark, a linhagem de dados completa pode não ser gerada devido a um problema na biblioteca OpenLineage. Essa é uma limitação conhecida. Se isso afetar suas cargas de trabalho, entre em contato com o suporte do Google Cloud.
A seguir
- Saiba mais sobre o catálogo do ambiente de execução do Lakehouse Iceberg REST Catalog.
- Consultar catálogos federados com o Spark.
- Conheça os recursos do Apache Iceberg.
- Saiba como consultar dados do Iceberg no catálogo do ambiente de execução do Lakehouse.
- Saiba mais sobre a linhagem de dados e o Serviço Gerenciado para Apache Spark.