


Spark 및 Lakehouse 런타임 카탈로그로 레이크하우스 만들기
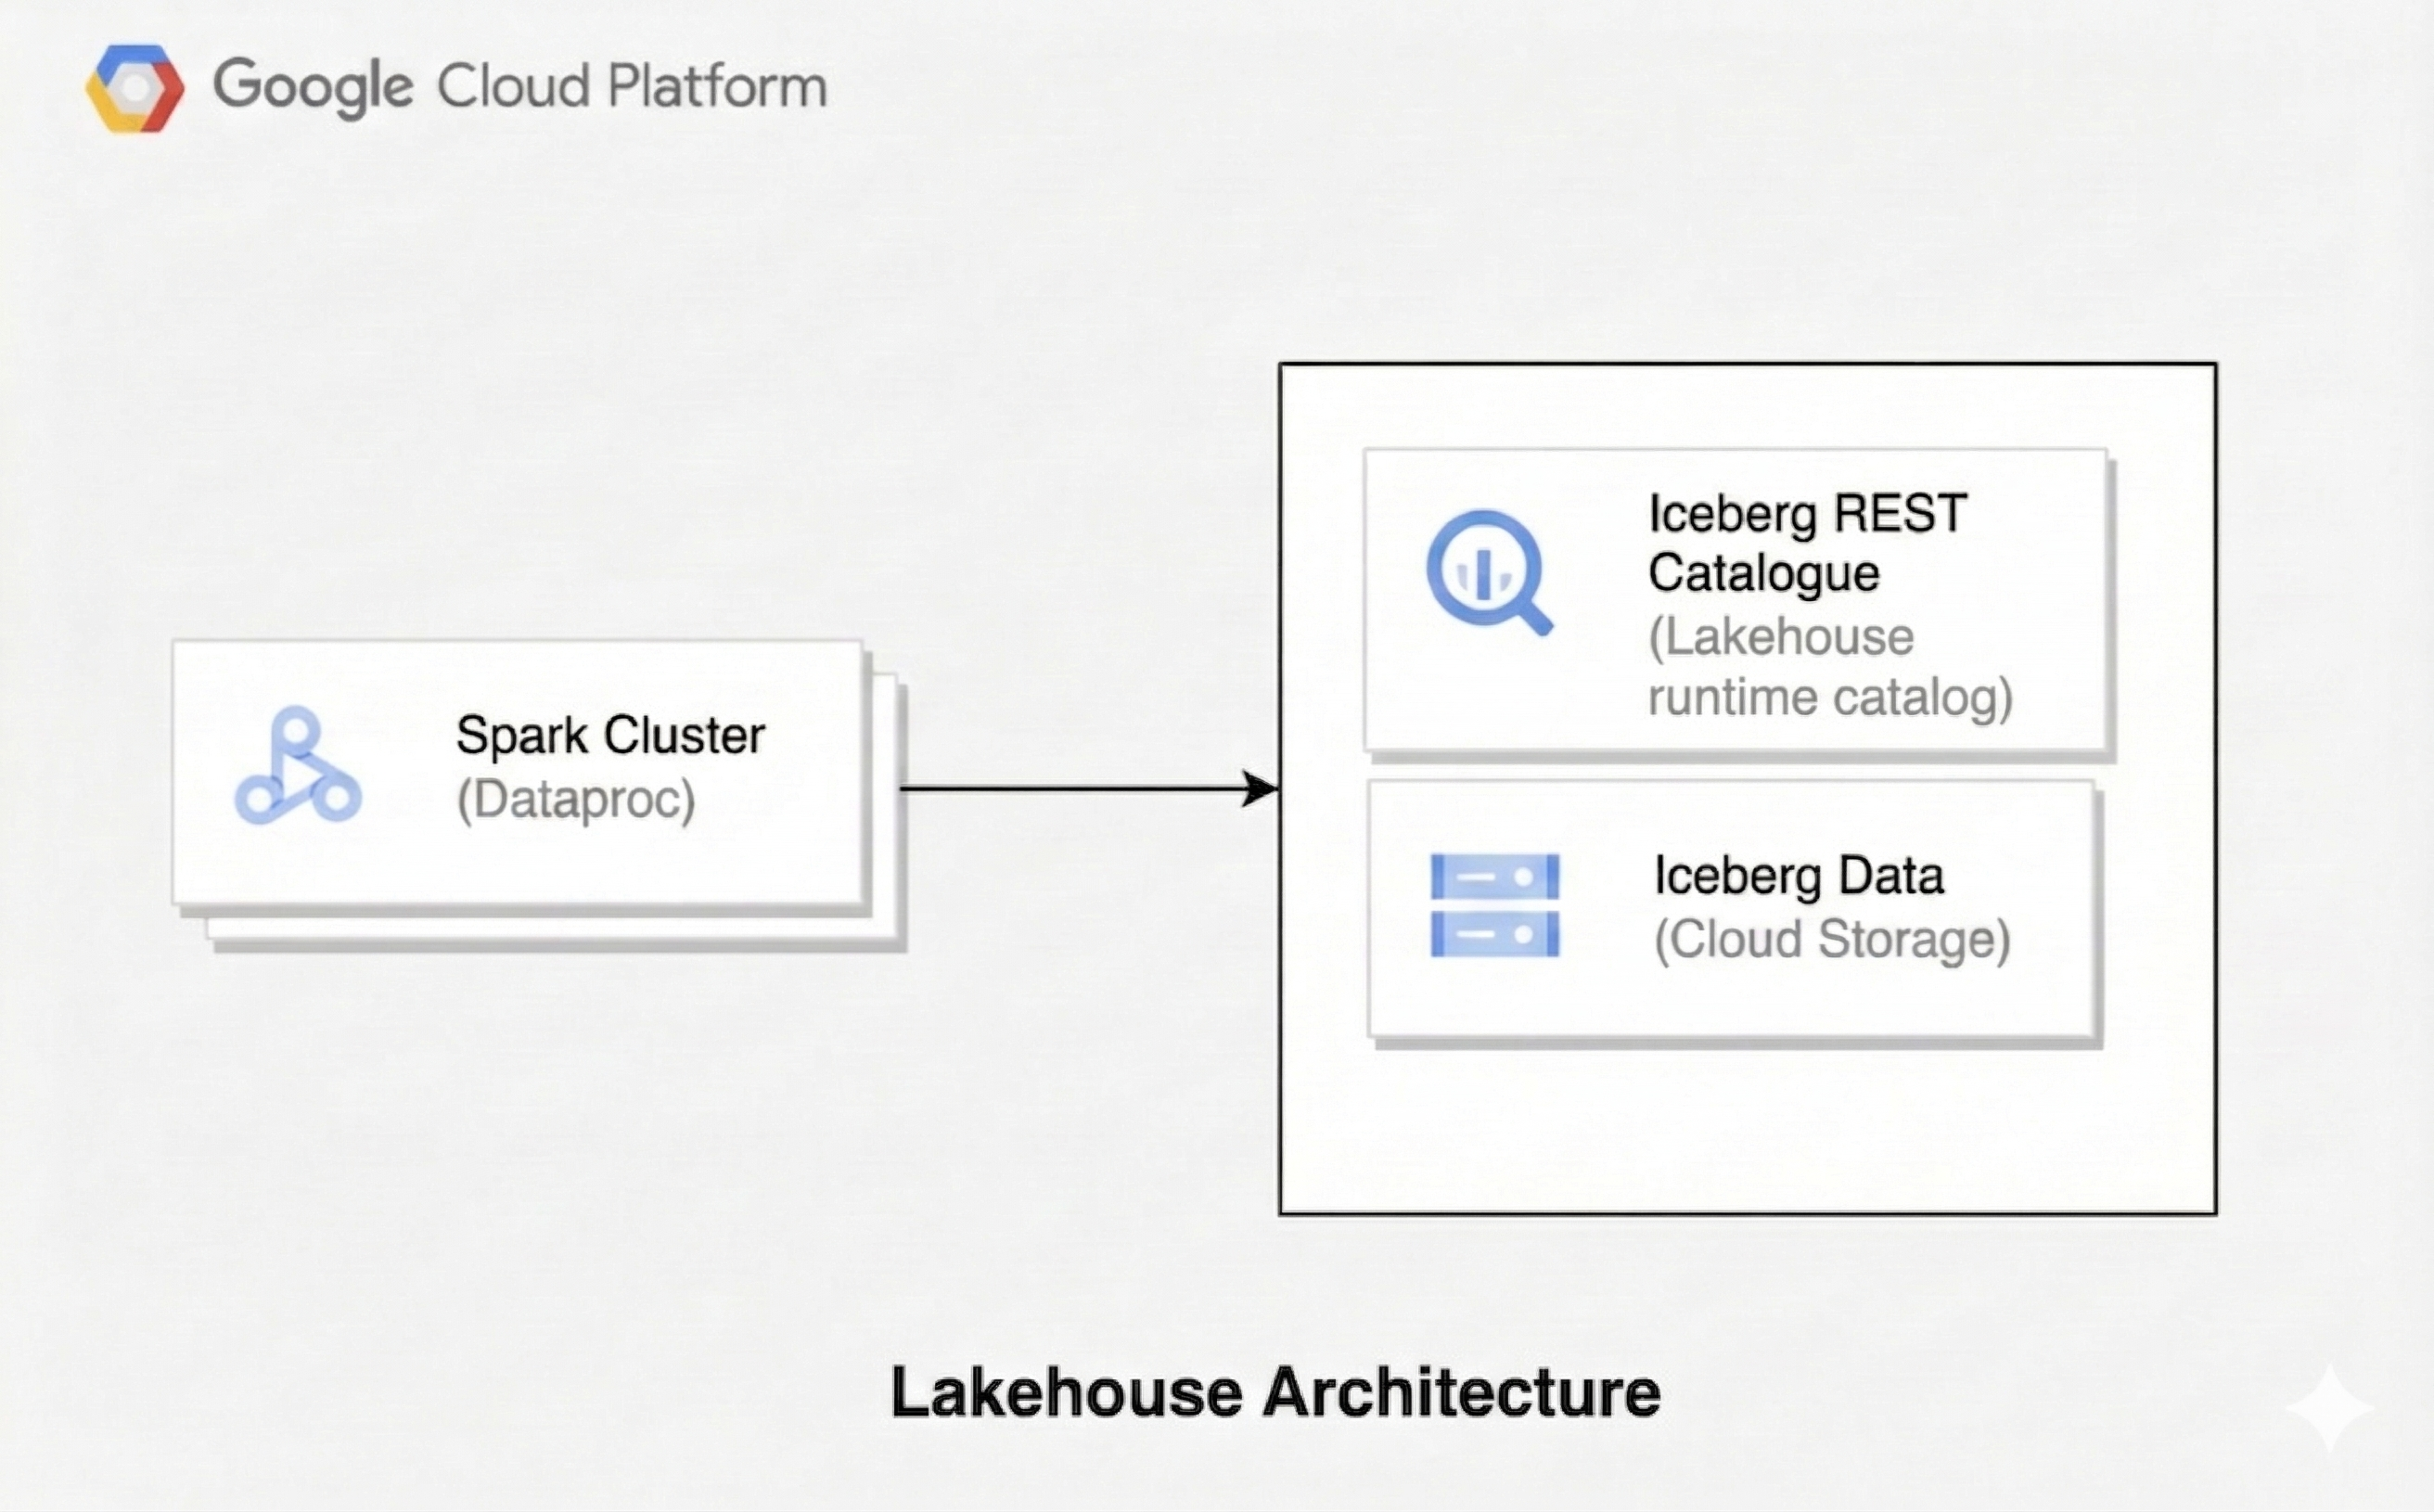
레이크하우스 아키텍처는 데이터 레이크의 유연성과 데이터 웨어하우스의 데이터 관리 기능을 결합합니다. 이 문서에서는 Google Cloud에서 레이크하우스를 설정하는 방법을 설명합니다. 테이블 형식으로 Apache Iceberg를, 처리에 Managed Service for Apache Spark를, 통합 메타데이터 관리에 Lakehouse 런타임 카탈로그 Iceberg REST 카탈로그를 사용합니다.
이 아키텍처는 Iceberg와 같은 개방형 테이블 형식을 사용하여 트랜잭션 및 스키마 변경과 같은 데이터 웨어하우징 기능을 Cloud Storage의 데이터에 추가합니다. 이 접근 방식을 사용하면 다양한 엔진이 액세스할 수 있는 데이터의 단일 정보 소스가 생성됩니다.
이 문서에서는 Lakehouse 런타임 카탈로그에서 만드는 카탈로그를 다룹니다. Lakehouse 런타임 카탈로그 페더레이션 카탈로그를 통해 AWS Glue Data Catalog, Databricks Unity Catalog 또는 Snowflake Horizon Catalog에서 관리하는 Iceberg 테이블을 쿼리하려면 Spark로 페더레이션 카탈로그 쿼리를 참조하세요.
시작하기 전에
- Google Cloud 계정에 로그인합니다. Google Cloud를 처음 사용하는 경우 계정을 만들고 Google 제품의 실제 성능을 평가해 보세요. 신규 고객에게는 워크로드를 실행, 테스트, 배포하는 데 사용할 수 있는 $300의 무료 크레딧이 제공됩니다.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that you have the permissions required to complete this guide.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Dataproc, BigLake, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that you have the permissions required to complete this guide.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Dataproc, BigLake, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.- Iceberg 데이터를 저장할 Cloud Storage 버킷을 만듭니다.
- 버킷을 가리키는 Lakehouse 런타임 카탈로그에 카탈로그를 만듭니다. 멀티 버킷 카탈로그를 사용하는 것이 좋습니다.
필요한 역할
이 페이지의 예시를 실행하려면 특정 Identity and Access Management (IAM) 역할이 필요합니다. 조직 정책에 따라 이러한 역할이 이미 부여되었을 수 있습니다. 역할 부여를 확인하려면 역할을 부여해야 하나요?를 참조하세요.
역할 부여에 대한 자세한 내용은 프로젝트, 폴더, 조직에 대한 액세스 관리를 참고하세요.
필요한 역할은 워크로드 실행 방식에 따라 다릅니다.
Managed Service for Apache Spark 클러스터 및 Managed Service for Apache Spark 서버리스 런타임 2.3 이하 버전은 워크로드를 서비스 계정으로 실행합니다. Managed Service for Apache Spark 서버리스 런타임 3.0 이상은 기본적으로 최종 사용자 인증 정보 (EUC)를 사용하여 워크로드를 실행하므로 서비스 계정 대신 사용자 계정에 데이터 액세스 역할을 부여합니다. 3.0 이상 런타임에 커스텀 서비스 계정을 지정하면 워크로드가 서비스 계정 사용자 인증 정보로 실행됩니다. 자세한 내용은 서버리스 배포 역할을 참조하세요.
사용자 역할
Apache Spark용 관리형 서비스 클러스터를 만들거나, 일괄 워크로드를 제출하거나, 대화형 세션을 만드는 데 필요한 권한을 얻으려면 관리자에게 다음 IAM 역할을 부여해 달라고 요청하세요.
-
클러스터 또는 서버리스 런타임 2.3 이하를 사용합니다.
- 프로젝트에 대한 Dataproc 편집자 (
roles/dataproc.editor) - Compute Engine 기본 서비스 계정 또는 커스텀 서비스 계정의 서비스 계정 사용자 (
roles/iam.serviceAccountUser)
- 프로젝트에 대한 Dataproc 편집자 (
-
서버리스 런타임 3.0 이상 사용: 프로젝트에 대한 서버리스 Dataproc 편집자 (
roles/dataproc.serverlessEditor) -
서버리스 런타임 3.0 이상에서 서비스 계정 사용자 인증 정보 사용: 커스텀 서비스 계정에 대한 서비스 계정 사용자 (
roles/iam.serviceAccountUser)
최종 사용자 사용자 인증 정보 (기본값)와 함께 Managed Service for Apache Spark 서버리스 런타임 3.0 이상을 사용하는 경우 다음 데이터 액세스 역할도 필요합니다.
최종 사용자 인증 정보로 카탈로그의 테이블을 읽고 쓰는 데 필요한 권한을 얻으려면 관리자에게 다음 IAM 역할을 부여해 달라고 요청하세요.
-
인증 정보 제공 모드에서 테이블 데이터 읽기 및 쓰기: 카탈로그가 포함된 프로젝트에 대한 BigLake 편집자 (
roles/biglake.editor) -
비사용자 인증 정보 벤더 제공 모드에서 카탈로그 리소스 관리 및 테이블 데이터 쓰기:
- 카탈로그가 포함된 프로젝트에 대한 BigLake 편집자 (
roles/biglake.editor) - 카탈로그와 연결된 모든 Cloud Storage 버킷에 대한 스토리지 객체 사용자 (
roles/storage.objectUser)
- 카탈로그가 포함된 프로젝트에 대한 BigLake 편집자 (
서비스 계정 역할
워크로드를 실행하는 서비스 계정에 다음 역할을 부여합니다.
Managed Service for Apache Spark 서버리스 런타임 3.0 이상에서는 워크로드가 서비스 계정 사용자 인증 정보로 실행되는 경우에만 이러한 역할이 필요합니다.
Compute Engine 기본 서비스 계정 또는 커스텀 서비스 계정에 Managed Service for Apache Spark 작업을 실행하고 카탈로그의 테이블을 읽고 쓰는 데 필요한 권한이 있는지 확인하려면 관리자에게 Compute Engine 기본 서비스 계정 또는 커스텀 서비스 계정에 다음 IAM 역할을 부여해 달라고 요청하세요.
-
클러스터 또는 서버리스 런타임 2.3 이하에서 Managed Service for Apache Spark 작업 실행: 프로젝트에 대한 Dataproc 작업자 (
roles/dataproc.worker) -
서버리스 런타임 3.0 이상에서 Managed Service for Apache Spark 작업을 실행합니다.
- 프로젝트에 대한 Dataproc Serverless 노드 (
roles/dataproc.serverlessNode) - 프로젝트에 대한 Dataproc Resource Manager 노드 서비스 에이전트 (
roles/dataprocrm.nodeServiceAgent)
- 프로젝트에 대한 Dataproc Serverless 노드 (
-
사용자 인증 정보 자동 판매 모드에서 테이블 데이터 읽기 및 쓰기: 카탈로그가 포함된 프로젝트에 대한 BigLake 편집자 (
roles/biglake.editor) -
비사용자 인증 정보 벤더 제공 모드에서 카탈로그 리소스 관리 및 테이블 데이터 쓰기:
-
카탈로그가 포함된 프로젝트에 대한 BigLake 편집자 (
roles/biglake.editor) - 카탈로그와 연결된 모든 Cloud Storage 버킷에 대한 스토리지 객체 사용자 (
roles/storage.objectUser)
-
카탈로그가 포함된 프로젝트에 대한 BigLake 편집자 (
Managed Service for Apache Spark 구성 및 Spark 세션 만들기
Lakehouse 런타임 카탈로그 Iceberg REST 카탈로그를 사용하도록 Managed Service for Apache Spark 클러스터, Managed Service for Apache Spark 서버리스 일괄 워크로드 또는 Managed Service for Apache Spark 서버리스 대화형 세션을 구성합니다. 세 가지 모두 dataproc.lakehouse.catalog.CATALOG_NAME 간소화된 구성 속성 (권장)을 지원하므로 Managed Service for Apache Spark가 카탈로그 정의를 읽고 Iceberg REST 카탈로그 Spark 속성을 생성할 수 있습니다. 클러스터 형식만 dataproc: 접두사를 사용합니다.
간소화된 구성과 수동 구성 모두 Iceberg용 Google 승인 (GoogleAuthManager)을 사용하며, 다음 버전 중 하나가 필요합니다.
- Managed Service for Apache Spark 클러스터:
2.2이미지 버전2.2.65이상 또는2.3이미지 버전2.3.11이상 - Managed Service for Apache Spark 서버리스 일괄 워크로드 및 대화형 세션:
2.2런타임2.2.60이상,2.3런타임2.3.10이상 또는3.0런타임
서버리스 일괄 워크로드 및 대화형 세션의 경우 필요한 역할은 런타임 버전에 따라 다릅니다. 런타임 3.0 이상에서는 기본적으로 최종 사용자 인증 정보를 사용합니다. 자세한 내용은 필수 역할을 참조하세요.
클러스터
간소화된 구성 속성을 사용하여 (권장) 또는 노트북에서 카탈로그 속성을 수동으로 지정하여 Iceberg 및 Jupyter 선택적 구성요소가 포함된 Managed Service for Apache Spark 클러스터를 만듭니다.
속성을 사용한 간소화된 구성 (권장)
카탈로그 속성을 사용하여 클러스터를 만듭니다.
gcloud dataproc clusters create CLUSTER_NAME \
  --project=PROJECT_ID \
  --region=REGION \
  --image-version=IMAGE_VERSION \
  --optional-components=ICEBERG,JUPYTER \
  --enable-component-gateway \
  --properties='dataproc:dataproc.lineage.enabled=true,dataproc:dataproc.lakehouse.catalog.CATALOG_NAME=projects/PROJECT_ID/catalogs/CATALOG_ID,spark:spark.sql.defaultCatalog=CATALOG_NAME'
다음을 바꿉니다.
CLUSTER_NAME: 클러스터 이름입니다.PROJECT_ID:Google Cloud 프로젝트 ID입니다.REGION: 클러스터의 Google Cloud리전(예:us-central1)IMAGE_VERSION: Managed Service for Apache Spark 이미지 버전(예:2.3-debian12) 지원되는 이미지 및 런타임 버전을 참고하세요.CATALOG_NAME: 로컬 Spark 카탈로그의 이름(예:iceberg_catalog)CATALOG_ID과 동일할 수 있습니다.CATALOG_ID: 시작하기 전에에서 만든 카탈로그의 ID입니다.
Lakehouse 런타임 카탈로그 Iceberg REST 카탈로그가 올바르게 작동하는 데는 dataproc:dataproc.lineage.enabled=true 속성이 필요하지 않습니다. 데이터 계보 예시에서 계보 추적을 위해 추가됩니다.
Jupyter 노트북 (Vertex AI Workbench 노트북 또는 클러스터에서 실행된 노트북)을 사용하여 클러스터에 연결하고 카탈로그 구성을 지정하지 않고 SparkSession를 만듭니다.
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("APP_NAME").getOrCreate()
APP_NAME을 Spark 애플리케이션의 이름으로 바꿉니다.
수동 구성
간소화된 구성 속성을 사용하지 않는 경우 --properties 플래그에 dataproc:dataproc.lakehouse.catalog. 없이 앞에서 설명한 대로 클러스터를 만들고 Jupyter 노트북에 연결한 후 다음과 같이 SparkSession를 수동으로 구성합니다.
import pyspark
from pyspark.context import SparkContext
from pyspark.sql import SparkSession

catalog_name = "CATALOG_NAME"

spark = SparkSession.builder.appName("APP_NAME") \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
다음을 바꿉니다.
CATALOG_NAME: 로컬 Spark 카탈로그의 이름(예:iceberg_catalog)APP_NAME: Spark 애플리케이션의 이름입니다.WAREHOUSE_PATH: 웨어하우스의 경로입니다. 여러 버킷 카탈로그 (권장)의 경우bl://projects/PROJECT_ID/catalogs/CATALOG_ID을 사용합니다. 단일 버킷 카탈로그의 경우gs://CLOUD_STORAGE_BUCKET_NAME을 사용합니다.PROJECT_ID: Google Cloud 프로젝트 ID
사용자 인증 정보 벤더 제공으로 구성
사용자 인증 정보 제공을 사용하려면 사용자 인증 정보 제공 모드의 카탈로그를 사용하고 SparkSession 빌더에 다음 줄을 추가하여 Iceberg REST 카탈로그 요청에 X-Iceberg-Access-Delegation 헤더를 vended-credentials 값으로 추가해야 합니다.
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials')
다음 예에서는 사용자 인증 정보 판매를 사용하여 SparkSession를 구성합니다.
from pyspark.sql import SparkSession

catalog_name = "CATALOG_NAME"

spark = SparkSession.builder.appName("APP_NAME") \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
간소화된 구성은 카탈로그에서 사용자 인증 정보 판매 모드를 사용하는 경우 이 헤더를 추가합니다. 자세한 내용은 Iceberg 문서의 RESTCatalog의 헤더 섹션을 참고하세요.
서버리스
간소화된 구성 속성 (권장)을 사용하거나 카탈로그 속성을 수동으로 지정하여 Managed Service for Apache Spark 서버리스에 PySpark 일괄 워크로드를 제출합니다.
속성을 사용한 간소화된 구성 (권장)
일괄 워크로드를 제출할 때 dataproc.lakehouse.catalog.CATALOG_NAME 속성 (dataproc: 프리픽스 제외)을 전달합니다.
gcloud dataproc batches submit pyspark PYSPARK_FILE \
  --project=PROJECT_ID \
  --region=REGION \
  --version=RUNTIME_VERSION \
  --properties="dataproc.lakehouse.catalog.CATALOG_NAME=projects/PROJECT_ID/catalogs/CATALOG_ID,spark.sql.defaultCatalog=CATALOG_NAME"
다음을 바꿉니다.
PYSPARK_FILE: PySpark 애플리케이션 파일에 대한gs://Cloud Storage 경로입니다.PROJECT_ID:Google Cloud 프로젝트 ID입니다.REGION: 일괄 워크로드의 리전입니다.RUNTIME_VERSION: Managed Service for Apache Spark 서버리스 런타임 버전(예:3.0) 필수 역할은 런타임 버전에 따라 다릅니다 (지원되는 이미지 및 런타임 버전 참조).CATALOG_NAME: 로컬 Spark 카탈로그의 이름(예:iceberg_catalog)CATALOG_ID과 동일할 수 있습니다.CATALOG_ID: 시작하기 전에에서 만든 카탈로그의 ID입니다.
PySpark 애플리케이션 파일에서 카탈로그 구성을 지정하지 않고 SparkSession를 만듭니다.
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("APP_NAME").getOrCreate()
수동 구성
간소화된 구성 속성을 사용하지 않는 경우 일괄 워크로드를 제출할 때 --properties 플래그에 카탈로그 속성을 지정합니다.
gcloud dataproc batches submit pyspark PYSPARK_FILE \
  --project=PROJECT_ID \
  --region=REGION \
  --version=RUNTIME_VERSION \
  --properties="\
spark.sql.defaultCatalog=CATALOG_NAME,\
spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,\
spark.sql.catalog.CATALOG_NAME.type=rest,\
spark.sql.catalog.CATALOG_NAME.uri=https://biglake.googleapis.com/iceberg/v1/restcatalog,\
spark.sql.catalog.CATALOG_NAME.warehouse=WAREHOUSE_PATH,\
spark.sql.catalog.CATALOG_NAME.header.x-goog-user-project=PROJECT_ID,\
spark.sql.catalog.CATALOG_NAME.rest.auth.type=org.apache.iceberg.gcp.auth.GoogleAuthManager,\
spark.sql.catalog.CATALOG_NAME.io-impl=org.apache.iceberg.gcp.gcs.GCSFileIO,\
spark.sql.extensions=org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions"
WAREHOUSE_PATH을 데이터 웨어하우스의 경로로 바꿉니다. 여러 버킷 카탈로그 (권장)의 경우 bl://projects/PROJECT_ID/catalogs/CATALOG_ID을 사용합니다.
단일 버킷 카탈로그의 경우 gs://CLOUD_STORAGE_BUCKET_NAME를 사용합니다.
사용자 인증 정보 자동 판매로 구성
사용자 인증 정보 판매를 사용하려면 사용자 인증 정보 판매 모드의 카탈로그를 사용하고 --properties 플래그에 다음 속성을 추가하여 Iceberg REST 카탈로그 요청에 X-Iceberg-Access-Delegation 헤더를 vended-credentials 값으로 추가해야 합니다.
spark.sql.catalog.CATALOG_NAME.header.X-Iceberg-Access-Delegation=vended-credentials다음 예시에서는 사용자 인증 정보 판매를 사용하여 일괄 워크로드를 제출합니다.
gcloud dataproc batches submit pyspark PYSPARK_FILE \
  --project=PROJECT_ID \
  --region=REGION \
  --version=RUNTIME_VERSION \
  --properties="\
spark.sql.defaultCatalog=CATALOG_NAME,\
spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,\
spark.sql.catalog.CATALOG_NAME.type=rest,\
spark.sql.catalog.CATALOG_NAME.uri=https://biglake.googleapis.com/iceberg/v1/restcatalog,\
spark.sql.catalog.CATALOG_NAME.warehouse=WAREHOUSE_PATH,\
spark.sql.catalog.CATALOG_NAME.header.x-goog-user-project=PROJECT_ID,\
spark.sql.catalog.CATALOG_NAME.rest.auth.type=org.apache.iceberg.gcp.auth.GoogleAuthManager,\
spark.sql.catalog.CATALOG_NAME.io-impl=org.apache.iceberg.gcp.gcs.GCSFileIO,\
spark.sql.catalog.CATALOG_NAME.header.X-Iceberg-Access-Delegation=vended-credentials,\
spark.sql.extensions=org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions"
카탈로그에서 사용자 인증 정보 자동 판매 모드를 사용하는 경우 간소화된 구성에서 이 헤더를 추가합니다. 자세한 내용은 Iceberg 문서의 RESTCatalog의 헤더 섹션을 참조하세요.
서버리스
DataprocSparkSession API를 사용하여 노트북에서 Managed Service for Apache Spark 서버리스 대화형 세션을 만듭니다. 이때 간소화된 구성 속성을 사용하거나 (권장) 카탈로그 속성을 수동으로 지정합니다.
속성을 사용한 간소화된 구성 (권장)
BigQuery Studio 노트북 또는 Vertex AI Workbench 노트북과 같이 dataproc-spark-connect 패키지가 설치된 노트북에서 세션을 만들 때 dataproc.lakehouse.catalog.CATALOG_NAME 속성(dataproc: 프리픽스 없음)을 전달합니다.
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session

catalog_name = "CATALOG_NAME"

session_config = Session()
session_config.runtime_config.version = 'RUNTIME_VERSION'

spark = DataprocSparkSession.builder.appName("APP_NAME") \
.dataprocSessionConfig(session_config) \
.config(f'dataproc.lakehouse.catalog.{catalog_name}', 'projects/PROJECT_ID/catalogs/CATALOG_ID') \
.config('spark.sql.defaultCatalog', catalog_name) \
.getOrCreate()
다음을 바꿉니다.
CATALOG_NAME: 로컬 Spark 카탈로그의 이름(예:iceberg_catalog)CATALOG_ID과 동일할 수 있습니다.RUNTIME_VERSION: Managed Service for Apache Spark 서버리스 런타임 버전(예:3.0) 필수 역할은 런타임 버전에 따라 다릅니다 (지원되는 이미지 및 런타임 버전 참조).APP_NAME: Spark 애플리케이션의 이름입니다.PROJECT_ID:Google Cloud 프로젝트 IDCATALOG_ID: 시작하기 전에에서 만든 카탈로그의 ID입니다.
세션 템플릿에서 이러한 속성을 설정할 수도 있습니다.
수동 구성
간소화된 구성 속성을 사용하지 않는 경우 세션을 만들 때 카탈로그 속성을 지정하세요.
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session

catalog_name = "CATALOG_NAME"

session_config = Session()
session_config.runtime_config.version = 'RUNTIME_VERSION'

spark = DataprocSparkSession.builder.appName("APP_NAME") \
.dataprocSessionConfig(session_config) \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
이 탭의 앞부분에 나오는 간소화된 구성 예시에 설명된 대로 RUNTIME_VERSION를 바꿉니다.
WAREHOUSE_PATH을 웨어하우스 경로로 바꿉니다. 여러 버킷 카탈로그 (권장)의 경우 bl://projects/PROJECT_ID/catalogs/CATALOG_ID를 사용합니다.
단일 버킷 카탈로그의 경우 gs://CLOUD_STORAGE_BUCKET_NAME를 사용합니다.
사용자 인증 정보 벤더 제공으로 구성
사용자 인증 정보 판매를 사용하려면 사용자 인증 정보 판매 모드의 카탈로그를 사용하고 세션 빌더에 다음 줄을 추가하여 Iceberg REST 카탈로그 요청에 X-Iceberg-Access-Delegation 헤더를 vended-credentials 값으로 추가해야 합니다.
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials')
다음 예시에서는 사용자 인증 정보 판매를 사용하여 세션을 만듭니다.
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session

catalog_name = "CATALOG_NAME"

session_config = Session()
session_config.runtime_config.version = 'RUNTIME_VERSION'

spark = DataprocSparkSession.builder.appName("APP_NAME") \
.dataprocSessionConfig(session_config) \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
카탈로그에서 사용자 인증 정보 자동 판매 모드를 사용하는 경우 간소화된 구성에서 이 헤더를 추가합니다. 자세한 내용은 Iceberg 문서의 RESTCatalog의 헤더 섹션을 참조하세요.
Spark SQL로 데이터 관리
Spark 세션을 구성한 후 Spark SQL을 사용하여 데이터 관리 작업을 실행합니다.
카탈로그 설정: dataproc.lakehouse.catalog. 속성은 Spark에 카탈로그를 등록하지만 기본 카탈로그로 설정하지는 않습니다. 이전 섹션의 예시에서는 정규화되지 않은 테이블 이름을 사용할 수 있도록 spark.sql.defaultCatalog(클러스터의 spark:spark.sql.defaultCatalog)를 설정합니다. 이 속성을 생략하는 경우 카탈로그 이름으로 테이블 이름을 정규화합니다(예: CATALOG_NAME.NAMESPACE_NAME.base_table).
네임스페이스를 만듭니다. Lakehouse 런타임 카탈로그 Iceberg REST 카탈로그에서 네임스페이스는 BigQuery 데이터 세트에 해당합니다.
spark.sql("CREATE NAMESPACE IF NOT EXISTS NAMESPACE_NAME") spark.sql("USE NAMESPACE_NAME")NAMESPACE_NAME을 네임스페이스 이름으로 바꿉니다(예:spark_lakehouse).Iceberg 형식으로 기본 테이블을 만들고 데이터를 삽입합니다.
spark.sql("DROP TABLE IF EXISTS base_table PURGE")
spark.sql("CREATE TABLE base_table (id LONG) USING iceberg")
spark.sql("INSERT INTO base_table VALUES 0, 1, 2, 3, 4")
spark.sql("SELECT * FROM base_table").show()
출력은 다음과 비슷합니다.
   +---+
   | id|
   +---+
   |  0|
   |  1|
   |  2|
   |  3|
   |  4|
   +---+
새 데이터용 테이블을 하나 더 만듭니다.
spark.sql("DROP TABLE IF EXISTS newdata PURGE")
spark.sql("CREATE TABLE newdata(id LONG) USING iceberg")
spark.sql("INSERT INTO newdata VALUES 3, 4, 5, 6")
spark.sql("SELECT * FROM newdata").show()
출력은 다음과 비슷합니다.
   +---+
   | id|
   +---+
   |  3|
   |  4|
   |  5|
   |  6|
   +---+
새 데이터를 기본 테이블에 병합합니다.
spark.sql("""MERGE INTO base_table USING newdata
           ON base_table.id = newdata.id
           WHEN MATCHED THEN
             UPDATE SET base_table.id = newdata.id
           WHEN NOT MATCHED THEN INSERT * """)
spark.sql("SELECT * FROM base_table").show()
출력은 다음과 비슷합니다.
   +---+
   | id|
   +---+
   |  0|
   |  1|
   |  2|
   |  3|
   |  4|
   |  5|
   |  6|
   +---+
기본 테이블의 레코드를 업데이트합니다.
spark.sql(
     "UPDATE base_table SET id = (id + 100) WHERE (id % 2 == 0)"
 )
spark.sql("SELECT * FROM base_table").show()
출력은 다음과 비슷합니다.
   +---+
   | id|
   +---+
   |  3|
   |104|
   |  5|
   |106|
   |100|
   |102|
   |  1|
   +---+
기본 테이블에서 레코드를 삭제합니다.
spark.sql("DELETE FROM base_table WHERE (id % 2 == 0)")
spark.sql("SELECT * FROM base_table").show()
출력은 다음과 비슷합니다.
   +---+
   | id|
   +---+
   |  3|
   |  5|
   |  1|
   +---+
이전 스냅샷 쿼리
스냅샷 ID를 쿼리하여 테이블의 이전 버전을 가져옵니다. 이 작업을 시간 이동이라고도 합니다.
MERGE,UPDATE,DELETE작업 전 테이블 버전의 스냅샷 ID를 검색합니다.snapshot_ids = spark.sql( "SELECT snapshot_id FROM `NAMESPACE_NAME`.`base_table`.snapshots" ).collect() oldest_snapshot_id = snapshot_ids[1]["snapshot_id"]NAMESPACE_NAME를 만든 네임스페이스로 바꿉니다.검색된 스냅샷 ID를 사용하여 테이블을 쿼리합니다.
df = (
     spark.read.format("iceberg")
     .option("versionAsOf", oldest_snapshot_id)
     .load("base_table")
 )
df.show()
출력에는
MERGE작업 후UPDATE또는DELETE작업 전의 테이블 상태가 표시됩니다.+---+ | id| +---+ | 0| | 1| | 2| | 3| | 4| | 5| | 6| +---+
데이터 계보 검색
Managed Service for Apache Spark 2.2 이상 이미지 버전을 사용하면 데이터 계보를 사용하여 Lakehouse 런타임 카탈로그 Iceberg REST 카탈로그 테이블 간의 데이터 이동을 추적할 수 있습니다.
데이터 계보 예시
소스 및 타겟 Iceberg 테이블을 만든 다음 데이터를 복사합니다.
spark.sql("DROP TABLE IF EXISTS source_table PURGE")
spark.sql("DROP TABLE IF EXISTS target_table PURGE")
spark.sql("CREATE TABLE source_table (id LONG) USING iceberg")
spark.sql("""CREATE TABLE target_table
  USING ICEBERG
  AS SELECT max(id) as top_id FROM source_table
  """)
Google Cloud 콘솔에서 Knowledge Catalog 검색 페이지로 이동합니다.
테이블 중 하나를 검색한 다음
Lineage탭을 클릭합니다.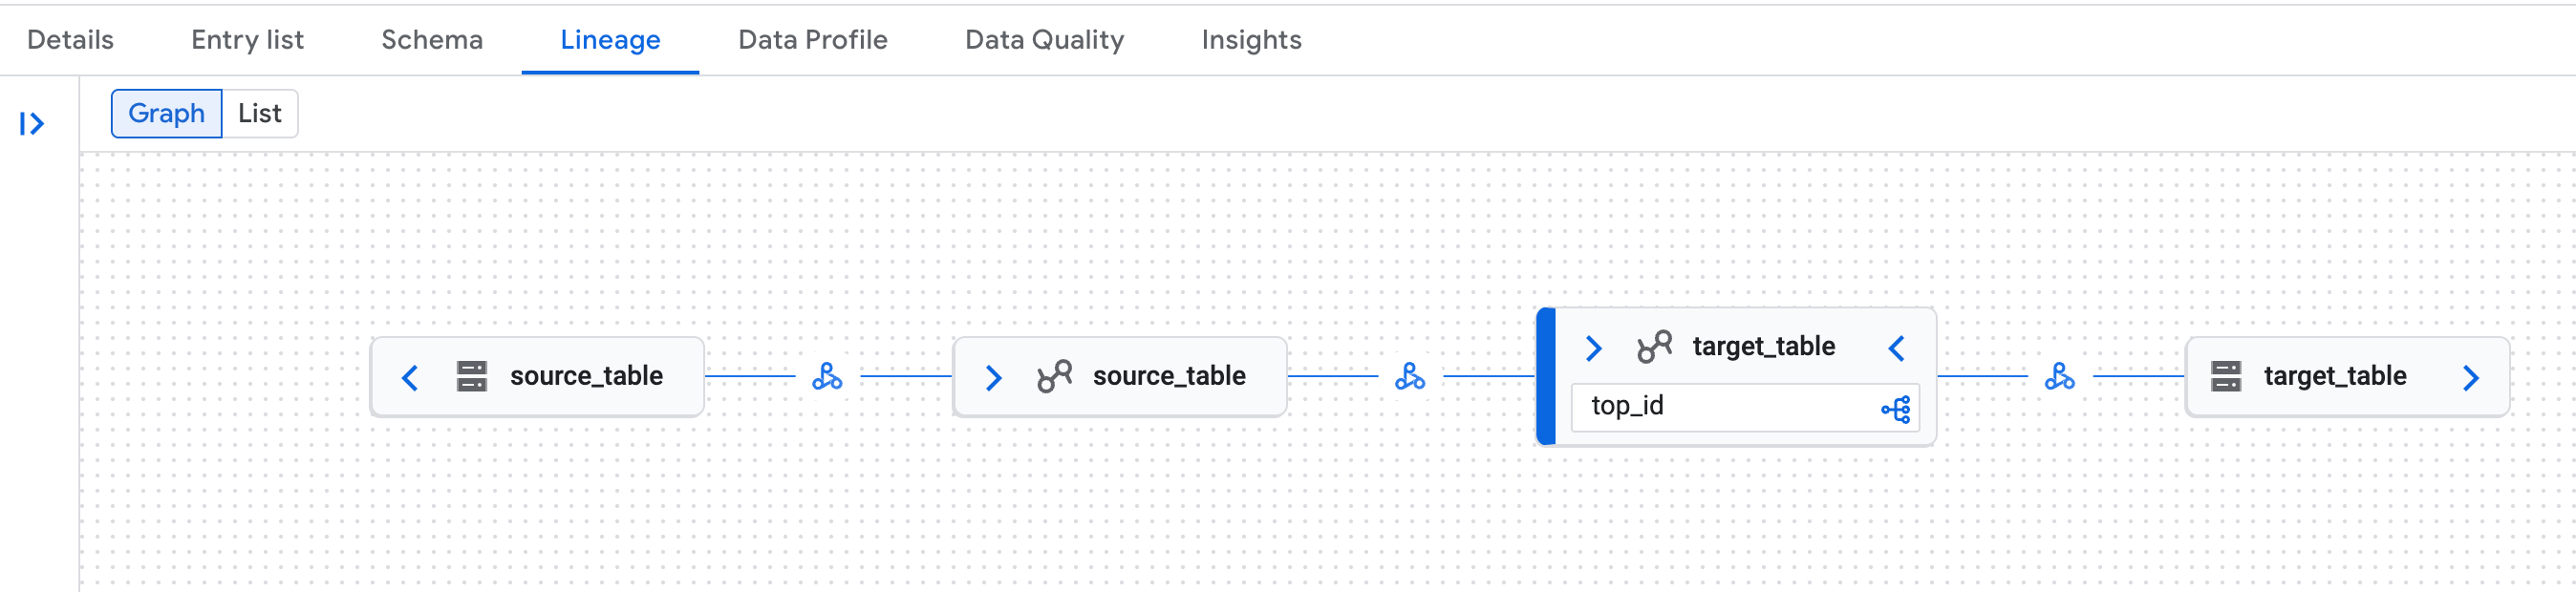
Google Cloud 콘솔의 Knowledge Catalog 페이지에 있는 데이터 계보 그래프의 예시 데이터 계보는 Lakehouse 런타임 카탈로그 Iceberg REST 카탈로그 테이블의 논리적 (Lakehouse 런타임 카탈로그 테이블) 및 물리적 (Cloud Storage) 표현을 모두 인식합니다.
데이터 계보 관련 알려진 문제
일부 Managed Service for Apache Spark 클러스터에서는 OpenLineage 라이브러리 문제로 인해 전체 데이터 계보가 생성되지 않을 수 있습니다. 이는 알려진 제한사항입니다. 워크로드에 영향을 미치는 경우 Google Cloud 지원팀에 문의하세요.
다음 단계
- Lakehouse 런타임 카탈로그 Iceberg REST 카탈로그에 대해 자세히 알아보세요.
- Spark로 페더레이션 카탈로그 쿼리
- Apache Iceberg의 기능을 살펴봅니다.
- Lakehouse 런타임 카탈로그에서 Iceberg 데이터를 쿼리하는 방법 알아보기
- 데이터 계보 및 Managed Service for Apache Spark에 대해 자세히 알아보세요.